
Apuntes · Capítulo 1Fundamentos
Qué es Internet y cómo medirla
Qué es Internet y cómo medirla
Abran una página web. En menos de lo que tarda un parpadeo, su laptop mandó un mensaje a una computadora que quizá está en otro continente, ese mensaje cruzó una docena de equipos que no conocen ni a ustedes ni a la página, y la respuesta volvió por un camino que tal vez ni siquiera es el mismo. Nadie coordinó ese viaje de principio a fin. Ningún equipo de los que tocó el mensaje sabe qué es una “página web”. Y funciona miles de millones de veces al día, sobre redes de miles de empresas distintas que compiten entre sí.
Este curso explica cómo es posible eso, y lo explica construyéndolo: van a capturar paquetes reales, configurar routers, conectar redes entre sí, provocar fallas y escribir en C un protocolo de transporte. Este primer capítulo da el mapa y las herramientas de medición que usaremos el resto del semestre.
Tiene dos partes. En la primera vemos qué es Internet: sus piezas, el servicio que da a las aplicaciones, qué es un protocolo, cómo se conectan los hogares, y la decisión de diseño más importante de todas, la conmutación de paquetes. Terminamos con la estructura real: una red de redes, con proveedores que se cobran entre sí. En la segunda vemos cómo se mide: de qué está hecho el retardo de un paquete, por qué aparecen las colas, qué limita el throughput y cómo se organiza todo en capas. No nos vamos a quedar en las fórmulas: cada una se comprueba con mediciones en una red que ustedes mismos levantan.
Si llevaron Sistemas Operativos, van a reconocer varias ideas. Una red, como un sistema operativo, comparte un recurso escaso entre muchos usuarios que no se conocen, y lo esconde detrás de una interfaz simple. Si no lo llevaron, basta con que sepan programar en C.
Ruta de lectura.
Antes de clase (obligatorio, unos 15 a 20 minutos). Sesión A: El curso en una página, Dos formas de describir Internet y Paquetes y store-and-forward. Sesión B: Las cuatro componentes del retardo hasta Calcularlos, y Las cinco capas de Internet.
En clase. Sesión A: El borde de la red, Conmutación de circuitos, Multiplexación estadística y Una red de redes. Sesión B: Medirlos: la topología de la semana, Colas y pérdida, Ver el retardo salto por salto con
traceroute, Throughput y Encapsulamiento.Después de clase. Repasen con el Resumen y los Ejercicios, y preparen el Laboratorio de la semana. Opcional: El modelo OSI como vocabulario, Cuando un salto intermedio tiene más RTT que uno posterior y Lo que verán en su captura. Para profundizar, las lecturas del libro y las gratuitas de la semana:
Este capítulo acompaña a Kurose y Ross, Computer Networking: A Top-Down Approach (9.ª ed.). Para la Sesión A, las secciones 1.1 What Is the Internet?, 1.2 The Network Edge y 1.3 The Network Core, y del libro abierto CS168 de Berkeley, Introduction y Designing Resource Sharing; como complemento, Links. Para la Sesión B, las secciones 1.4 Delay, Loss, and Throughput y 1.5 Protocol Layers and Their Service Models, y de CS168, Layers y Headers. El código del capítulo está en
code/week-01y se prueba conmake testdentro del contenedor del curso (env/run.sh).
El curso en una página
El curso tiene cinco partes. El calendario, las lecturas y las políticas están en el programa del curso; cada semana tiene su guía.
| Parte | Semanas | Tema |
|---|---|---|
| Fundamentos | 1–2 | Arquitectura de Internet, retardo, capas y sockets |
| Redes locales e IP | 3–4 | Enlace, Ethernet, VLANs, direccionamiento, forwarding, NAT, IPv6 |
| Routing | 5–7 | Algoritmos de routing, OSPF, BGP y políticas entre redes |
| Transporte y aplicaciones | 9–13 | Entrega confiable, TCP, congestión, DNS, HTTP, TLS 1.3, QUIC |
| Redes modernas | 14–15 | Data centers, SDN, Wi-Fi, 5G y seguridad de redes |
Por qué este orden. El libro de Kurose y Ross va de arriba hacia abajo: empieza por las aplicaciones y termina en el enlace. Nosotros lo leemos en otro orden, como los cursos de ETH Zürich y de UC Berkeley: después de un calentamiento con sockets, primero vemos cómo llega un paquete a su destino y después construimos lo que corre encima. La razón es práctica. Para probar un protocolo de transporte hace falta una red donde se pierdan paquetes, y para tener esa red hay que saber armarla. Por eso, cuando lleguemos a TCP en la semana 10, ustedes ya van a tener una red propia para romperla a gusto.
El proyecto. Un solo proyecto crece todo el semestre: Qhapaq Ñan, un
pequeño Internet inspirado en la red de caminos del Tahuantinsuyo. Cada equipo
opera un sistema autónomo, lo conecta con sus vecinos mediante BGP y publica
un servicio web que corre sobre rimay (“hablar” en quechua), un protocolo de
transporte escrito por el propio equipo. El detalle está en
projects/README.md. Esta semana se publica P0,
el calentamiento, con entrega en la semana 3.
El entorno. Todo corre en su laptop, sin equipos físicos: un contenedor Docker con el compilador, las herramientas y Containerlab, y cada router es otro contenedor con FRRouting. Se instala en el laboratorio de esta semana. Lo usamos desde el primer día, porque en redes una afirmación vale lo que vale su medición. En este capítulo, toda salida de terminal viene de una ejecución real; las suyas van a tener otras cifras, porque dependen de su computadora y de su conexión.
Dos formas de describir Internet
¿Qué es Internet? Hay dos respuestas correctas, y conviene tener las dos: una dice de qué está hecha y la otra para qué sirve.
Por sus piezas
Internet es una red de computadoras que conecta miles de millones de dispositivos en todo el mundo. Sus piezas son cuatro:
- Hosts, también llamados sistemas finales (end systems): los dispositivos en los bordes, donde corren las aplicaciones. Una laptop, un celular, un servidor en un data center, una cámara de seguridad.
- Enlaces (links): lo que une directamente a dos o más nodos. Fibra óptica, cobre, radio. Cada enlace tiene una velocidad de transmisión, en bits por segundo.
- Packet switches: equipos que reciben un paquete por un enlace y lo reenvían por otro. Hay dos tipos principales: los routers, que deciden con la dirección IP y suelen estar en el núcleo, y los switches de la capa de enlace, que deciden con la dirección MAC y suelen estar en las redes locales.
- Proveedores de Internet (ISPs): las organizaciones que operan todo lo anterior, y que se conectan entre sí. Una empresa de telefonía, una universidad, una empresa de nube.
El camino que sigue un paquete desde el host de origen hasta el de destino se llama ruta o camino (path). Los hosts se comunican mandando paquetes: trozos de datos con un encabezado que dice, entre otras cosas, a dónde van.
   host ─── router ─── router ─── router ─── host
    A    │          │          │          │    B
       enlace     enlace     enlace     enlace
Idea clave. Los routers del medio no ejecutan su aplicación. Toda la inteligencia de la aplicación está en los hosts, en los bordes. El núcleo solo mueve paquetes. Por eso se pudo inventar la Web, las videollamadas o los videojuegos en línea sin pedirle permiso a nadie ni cambiar un solo router. La semana 2 le pone nombre a este principio.
Por el servicio
La segunda descripción ignora el hardware. Para un programador, Internet es una infraestructura que da servicios a las aplicaciones. Una aplicación distribuida corre en varios hosts que intercambian datos, y le pide a Internet una sola cosa: “lleva estos bytes a ese programa en ese otro host”.
La aplicación hace ese pedido por una interfaz definida, la API de sockets, que programarán desde la semana 2. El contrato es parecido al del correo postal: ustedes ponen la carta en un sobre con la dirección y el formato que exige el correo, y no les importa por qué ciudades pasa. El servicio básico de Internet tiene además una particularidad: se llama best effort, “el mejor esfuerzo”. La red intenta entregar cada paquete, pero no promete que llegue, ni cuándo, ni en qué orden.
Esa promesa tan débil parece un defecto. Es la decisión que hizo posible todo
lo demás, y volveremos a ella la próxima semana. Si una aplicación necesita
más garantías, las construye en los hosts: TCP entrega bytes confiables y en
orden sobre una red que no promete nada. En la segunda mitad del curso ustedes
harán lo mismo con rimay.
Qué es un protocolo
Todo lo que pasa en Internet está gobernado por protocolos. La definición precisa es esta:
Un protocolo define el formato y el orden de los mensajes que se intercambian dos o más entidades, y las acciones que se toman al enviar o recibir un mensaje, o ante otro evento.
Las tres palabras importan. Veámoslas en una petición web real. Levantamos la
topología de esta semana, que explicamos más abajo, y curl en el host h1
le pide una página al servidor en h2. Con -v, curl muestra lo que envía
(>) y lo que recibe (<):
$ docker exec clab-w01-path-h1 sh -c "curl -sv -o /dev/null http://10.2.0.2/ 2>&1 | grep '^[<>]'"
> GET / HTTP/1.1
> Host: 10.2.0.2
> User-Agent: curl/8.14.1
> Accept: */*
>
< HTTP/1.0 200 OK
< Server: SimpleHTTP/0.6 Python/3.12.10
< Date: Mon, 02 Nov 2026 06:48:13 GMT
< Content-type: text/html
< Content-Length: 97
< Last-Modified: Mon, 02 Nov 2026 06:32:09 GMT
< - Formato. Una línea con método, ruta y versión; luego encabezados
Nombre: valor; luego una línea en blanco. Ese formato no es una convención opcional. Si cambia, el otro lado no entiende. - Orden. Primero habla el cliente. El servidor no dice nada hasta recibir una petición completa.
- Acciones. Según lo que recibe, el servidor hace algo distinto: manda el archivo, avisa que no existe, o rechaza el pedido.
Como HTTP es texto, podemos hablarlo a mano con nc, que abre una conexión y
manda lo que le demos. Probemos las acciones con dos pedidos distintos. Un
archivo que no existe:
$ printf 'GET /nada.html HTTP/1.0\r\n\r\n' | docker exec -i clab-w01-path-h1 nc -w 2 10.2.0.2 80 | head -1
HTTP/1.0 404 File not found
Y un método que el protocolo no contempla:
$ printf 'BORRAR / HTTP/1.0\r\n\r\n' | docker exec -i clab-w01-path-h1 nc -w 2 10.2.0.2 80 | head -2
HTTP/1.0 501 Unsupported method ('BORRAR')
Server: SimpleHTTP/0.6 Python/3.12.10
No hay nada mágico en la red: dos programas siguen reglas escritas. Esas reglas están publicadas, en su mayoría en los documentos llamados RFC, y por eso un cliente escrito por una persona se entiende con un servidor escrito por otra, sin que se hayan conocido. Aprender redes es, en buena parte, aprender qué protocolos hay y por qué están hechos así.
Error común. Decir “el protocolo TCP/IP” como si fuera uno solo. TCP e IP son dos protocolos distintos, de capas distintas y con trabajos distintos. Un router usa IP y no necesita saber nada de TCP. Más adelante los vamos a separar con una captura.
El borde de la red
Empecemos por lo que tienen a la mano. Los hosts, según lo que hacen en una aplicación, suelen ser clientes, como su laptop, o servidores, que hoy viven casi siempre en data centers. Lo que los conecta con el resto del mundo es la red de acceso (access network): el tramo entre el host y el primer router del camino, llamado edge router.
Redes de acceso
| Tecnología | Medio | ¿Compartido? | Velocidad típica de bajada |
|---|---|---|---|
| DSL | Par de cobre telefónico | No hasta la central; la velocidad cae con la distancia | Decenas de Mbps |
| Cable (HFC) | Fibra y cable coaxial | Sí, entre los vecinos del mismo tramo | Cientos de Mbps a 1 Gbps |
| Fibra al hogar (FTTH) | Fibra óptica | Sí, entre las casas del mismo splitter | Cientos de Mbps a varios Gbps |
| Wi-Fi | Radio, decenas de metros | Sí, entre todos los que usan el access point | Decenas a cientos de Mbps |
| Móvil (4G, 5G) | Radio, kilómetros | Sí, entre los usuarios de la celda | Decenas a cientos de Mbps |
Las cifras son órdenes de magnitud: dependen del plan, de la distancia y de los vecinos. Lo importante es entender tres ideas que se repiten:
- Medio compartido o dedicado. En fibra al hogar con red pasiva (PON), una sola fibra sale de la central y un splitter óptico la reparte entre muchas casas. Si contratan 500 Mbps, esa velocidad no está reservada para ustedes. Volveremos a esto en la multiplexación estadística: es justamente lo que hace barato el servicio.
- Asimetría. Muchos planes dan más velocidad de bajada que de subida, porque la mayoría de los usuarios descarga mucho más de lo que sube.
- El cuello de botella casi nunca es el que creen. Una laptop con plan de 500 Mbps conectada por un Wi-Fi saturado no recibe 500 Mbps.
Hoy es normal tener dos redes de acceso en cadena: su laptop llega por Wi-Fi a
un access point, y ese equipo sale por fibra hacia el ISP. Por eso, en casi
todo hogar, el primer salto de un traceroute es el equipo de la casa. Lo
veremos dentro de poco.
Medios físicos
Un bit viaja por un medio como una señal: luz en una fibra, voltaje en cobre, ondas de radio en el aire. Para este curso importan dos números de cada medio, y no son el mismo número:
- La velocidad de transmisión, en bits por segundo. Es cuántos bits por segundo se pueden poner en el medio. Depende de la tecnología, y por eso la misma fibra puede pasar de 1 Gbps a 100 Gbps cambiando los equipos de los extremos.
- La velocidad de propagación, en metros por segundo. Es cuán rápido viaja cada bit una vez que está en el medio. Depende de la física: en fibra y en cobre es de alrededor de 2×10⁸ m/s, y en el aire, cerca de 3×10⁸ m/s. Ninguna actualización de equipos la cambia.
La capa física la veremos en lo esencial en la semana 3.
En la práctica. Las velocidades de enlaces se dan en bits por segundo, con prefijos decimales: 100 Mbps son 100 000 000 bits por segundo. Los archivos se miden en bytes. Un plan de 100 Mbps descarga, como máximo, 12,5 MB por segundo. Confundir
bconBes un error de un factor de 8.
El núcleo de la red: conmutación de paquetes
El núcleo es la malla de routers y enlaces que conecta a las redes de acceso. La pregunta de diseño que lo define es: cuando muchos usuarios quieren usar los mismos enlaces, ¿cómo se reparte la capacidad? Hay dos respuestas clásicas. Internet usa la primera.
Paquetes y store-and-forward
En la conmutación de paquetes (packet switching), el host divide cada mensaje largo en paquetes, y cada paquete viaja por su cuenta a la máxima velocidad del enlace, sin reservar nada antes. Un paquete de L bits en un enlace de R bits/s tarda L/R segundos en salir.
Casi todos los routers y switches trabajan con store-and-forward: un router debe recibir el paquete completo antes de empezar a transmitirlo por el siguiente enlace. Tiene sentido: tiene que leer el encabezado, comprobar que llegó bien y decidir por dónde sale. Eso tiene un costo fácil de calcular.
Ejemplo. Un paquete de L = 1500 bytes cruza 3 enlaces de R = 100 Mbps, sin nadie más en la red. Ignoremos la distancia por ahora. Sale del host en L/R = 12 000 / 10⁸ = 0,12 ms. El primer router espera a tenerlo entero, tarda otros 0,12 ms en reenviarlo, y lo mismo el segundo. En N enlaces iguales, el retardo total es:
d = N · L / R = 3 · 0,12 ms = 0,36 ms¿Por qué dividir en paquetes, si cada uno pierde tiempo en cada router? Comparemos enviar 1 MB por esos mismos 3 enlaces de dos formas. Como un solo mensaje de 8 000 000 bits, cada enlace tarda 80 ms y el total es 3 · 80 = 240 ms. Como 667 paquetes de 1500 bytes, el primero llega a los 0,36 ms, y luego va llegando uno cada 0,12 ms, porque los paquetes viajan en fila, uno detrás de otro, como en una línea de montaje: (3 + 666) · 0,12 ms = 80,3 ms. Dividir hizo la entrega tres veces más rápida, y además, si se pierde un paquete, solo hay que repetir ese. El cálculo ignora los encabezados, que sí cuestan: lo veremos en la sección de encapsulamiento.
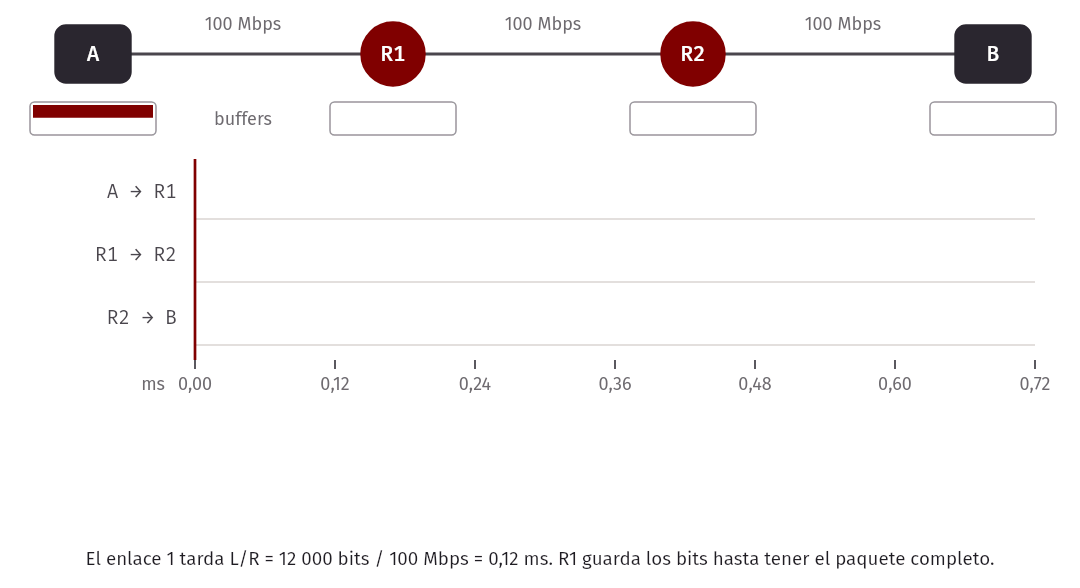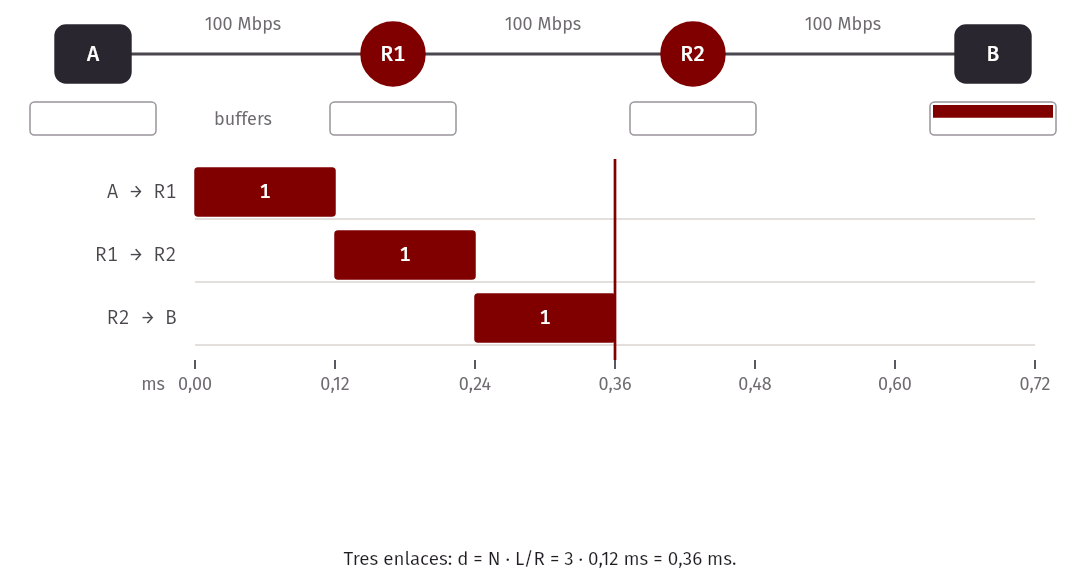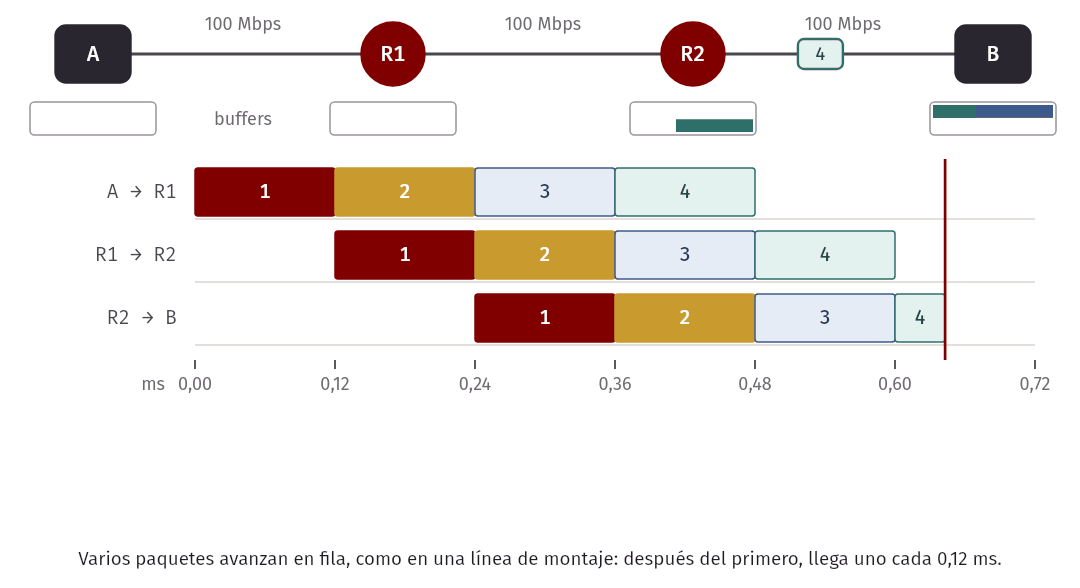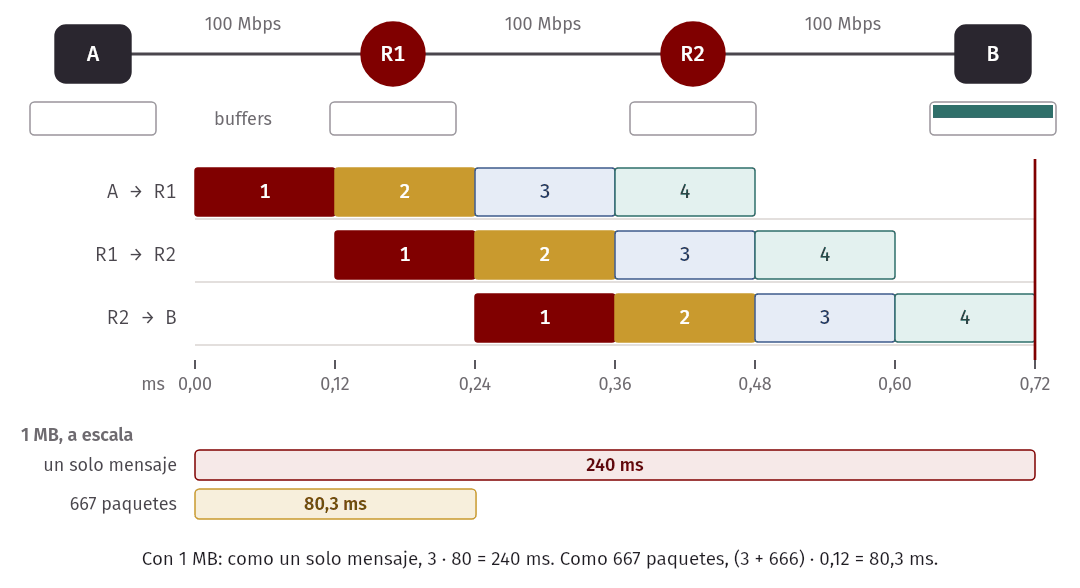
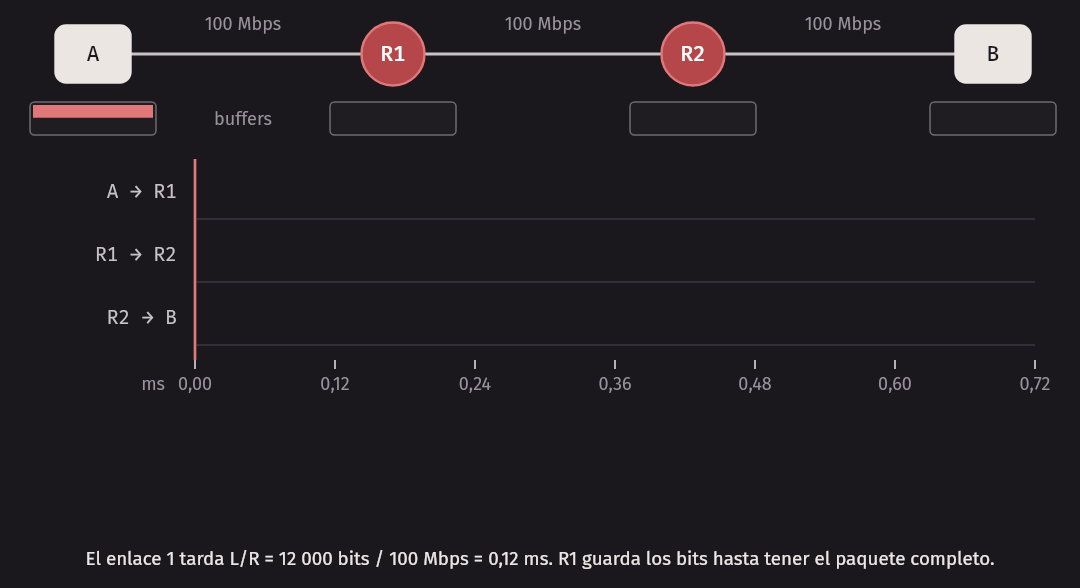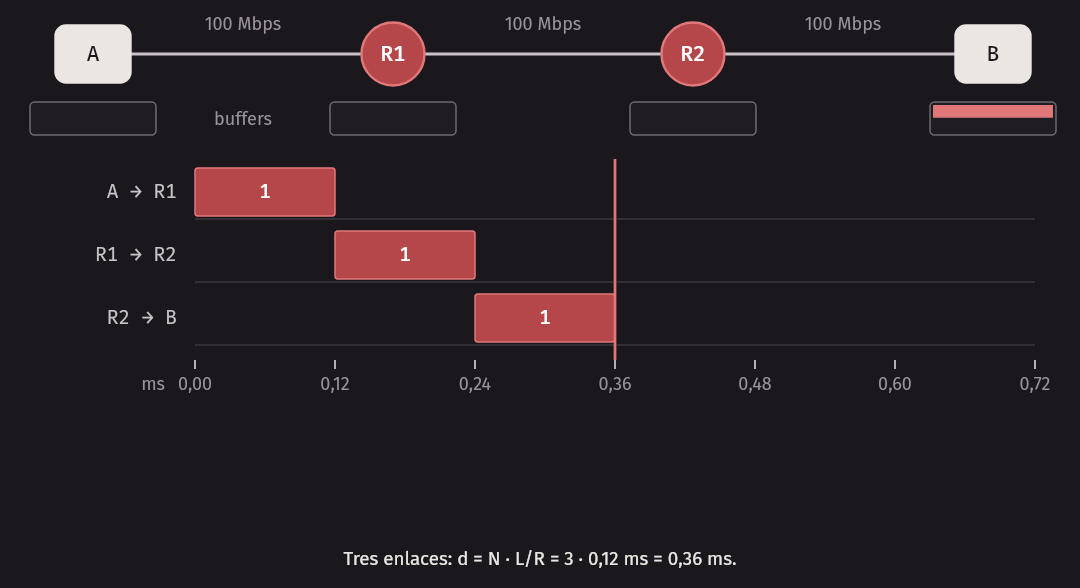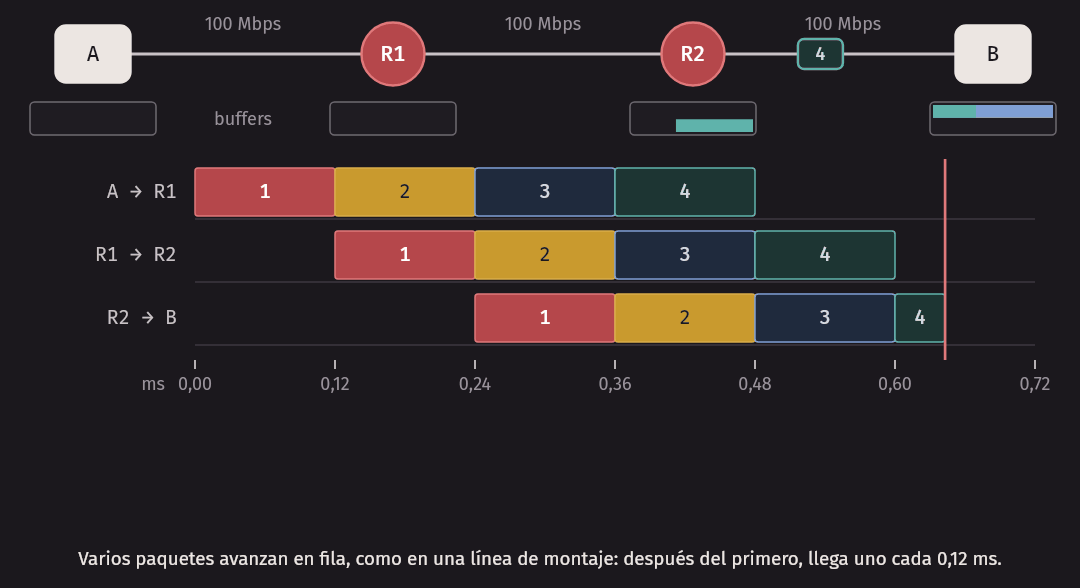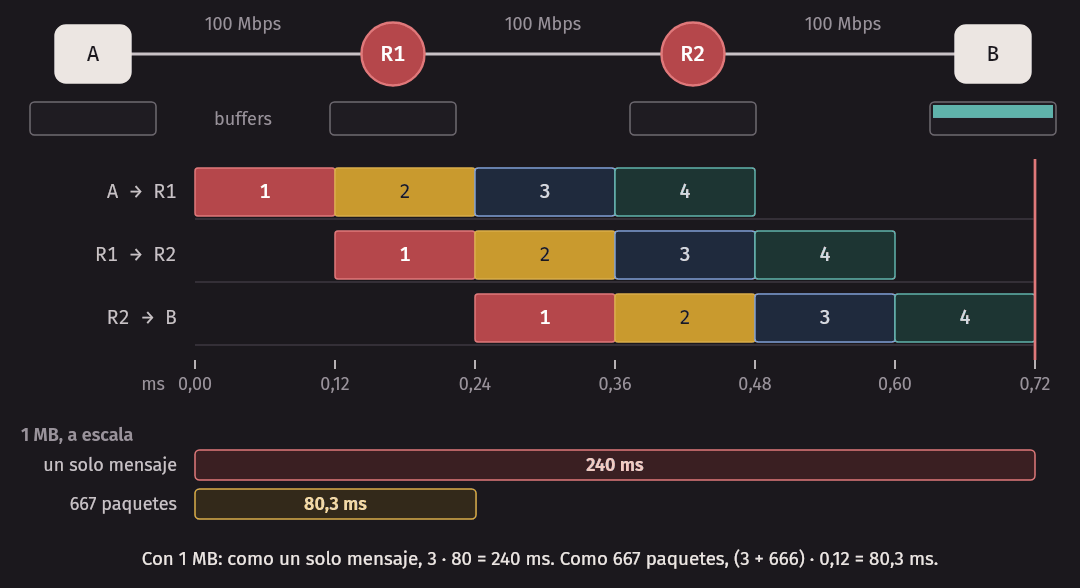
Estas cifras las vamos a medir. Más adelante, tres enlaces lentos van a dar el triple de retardo de transmisión que uno solo.
Colas y pérdida
Cada enlace de salida tiene un buffer, una memoria donde esperan los paquetes que no pueden salir todavía. Si llegan paquetes más rápido de lo que el enlace puede transmitir, se forma una cola, y los paquetes sufren un retardo de cola. Y como el buffer es finito, cuando se llena, el router descarta los que siguen. Esa es la pérdida de paquetes.
           paquetes que llegan                     buffer         enlace de salida
  100 Mbps ═════════════════╗                  ┌─────────────┐
                            ╠═══▶ forwarding ─▶│ ▓▓▓▓▓▓      │──▶ 15 Mbps
  100 Mbps ═════════════════╝                  └─────────────┘
                                                 si se llena, se descarta
Esto no es una falla de la red: es el precio de no reservar. La pérdida y las colas ocurren en el funcionamiento normal de Internet, y todo lo que estudiaremos sobre TCP existe para convivir con ellas.
Forwarding y routing
¿Cómo sabe un router por dónde sacar un paquete? Cada router tiene una
forwarding table, que asocia prefijos de direcciones de destino con
enlaces de salida. El router mira la dirección de destino del encabezado,
busca en la tabla y lo envía. Esta es la tabla de r2, un router de la
topología de esta semana:
$ docker exec clab-w01-path-r2 ip route
default via 172.90.1.1 dev eth0
10.0.12.0/24 dev eth1 proto kernel scope link src 10.0.12.2
10.0.23.0/24 dev eth2 proto kernel scope link src 10.0.23.2
10.1.0.0/24 nhid 19 via 10.0.12.1 dev eth1 proto 196 metric 20
10.2.0.0/24 nhid 20 via 10.0.23.3 dev eth2 proto 196 metric 20
172.90.1.0/24 dev eth0 proto kernel scope link src 172.90.1.6
La penúltima línea se lee así: para llegar a 10.2.0.0/24, salir por eth2
hacia el router vecino 10.0.23.3. Las líneas de eth0 y 172.90.1.0/24 son
de la red de administración de Containerlab, y no forman parte de la
topología. Estas rutas las escribimos a mano en un archivo. Internet no puede
hacer eso: las tablas las llenan protocolos de routing, que veremos en las
semanas 5 a 7.
Error común. Usar routing y forwarding como sinónimos. Routing decide los caminos y llena las tablas: es un trabajo de toda la red, que toma segundos o minutos. Forwarding mueve cada paquete usando esas tablas: es una decisión local de un router, que toma microsegundos o menos.
Conmutación de circuitos
La otra respuesta es la de la red telefónica clásica. En la conmutación de circuitos (circuit switching), antes de enviar nada, la red establece un circuito: reserva, en cada enlace del camino, una porción de la capacidad para esa comunicación y nadie más. Mientras dure, esa capacidad está garantizada. Y si no la usan, se desperdicia.
La capacidad de un enlace se reparte de dos formas:
- FDM (frequency-division multiplexing). Cada circuito recibe una banda de frecuencias todo el tiempo. Así se reparten las emisoras de una radio.
- TDM (time-division multiplexing). El tiempo se divide en frames de duración fija, y cada frame en slots. Cada circuito recibe un slot de cada frame, y usa toda la capacidad durante ese slot.
  FDM (frecuencia)                 TDM (tiempo), 4 circuitos
  ┌────────────────────── t        ┌───┬───┬───┬───┬───┬───┬───┬───┐
  │ circuito 4                     │ 1 │ 2 │ 3 │ 4 │ 1 │ 2 │ 3 │ 4 │  ▶ t
  │ circuito 3                     └───┴───┴───┴───┴───┴───┴───┴───┘
  │ circuito 2                     ◀──── frame ───▶
  │ circuito 1                     El slot 1 de cada frame es del circuito 1.
Ejemplo. Un enlace de 100 Mbps se reparte con TDM en 10 slots por frame, así que cada circuito tiene 10 Mbps. Enviar un archivo de 25 MB (200 Mbit) toma 20 s, más lo que tarde establecer el circuito, digamos 200 ms. Total: 20,2 s. No importa si los otros nueve circuitos están callados: su capacidad queda sin usar. Con conmutación de paquetes y el enlace libre, el mismo archivo tarda 2 s.
| Conmutación de paquetes | Conmutación de circuitos | |
|---|---|---|
| Reserva previa | Ninguna | Sí, en cada enlace |
| Uso de la capacidad | La toma quien la necesita | Fija: si no se usa, se pierde |
| Retardo | Variable: depende de las colas | Constante tras establecer el circuito |
| Pérdida por congestión | Posible | No, si se admitió el circuito |
| Si un enlace cae | Los paquetes pueden tomar otro camino | Se cae el circuito |
| Estado en el núcleo | Tablas de forwarding, no por conversación | Por cada circuito, en cada equipo del camino |
Si los circuitos dan garantías, ¿por qué Internet no los usa? Porque el tráfico de datos llega a ráfagas (bursts). Mientras leen una página, su laptop no manda casi nada, y al hacer clic pide mucho de golpe. Reservar para el pico es un desperdicio; reservar para el promedio no alcanza en el pico. Hagamos el cálculo.
Multiplexación estadística
Tomemos un enlace de 1 Gbps y usuarios que, cuando están activos, transmiten a 100 Mbps. Con circuitos, la cuenta es inmediata: caben 10 usuarios, sin importar cuánto usen lo reservado.
Ahora supongamos que cada usuario está activo solo el 10 % del tiempo, de forma independiente de los demás. Con paquetes no hay un tope fijo de usuarios: el problema solo aparece si, en un instante, hay más de 10 activos a la vez. ¿Qué tan probable es eso?
Si hay N usuarios y cada uno está activo con probabilidad p, el número de activos X sigue una distribución binomial:
P(X = k) = C(N, k) · pᵏ · (1 − p)^(N − k) P(X > 10) = Σ P(X = k), con k de 11 a Nmultiplex.c la calcula. Cada término de la
suma sale del anterior, para no calcular factoriales enormes:
// Devuelve P(X > limit) para X ~ Binomial(users, p), con 0 < p < 1.
// Cada término sale del anterior: P(k+1) = P(k) * (users-k)/(k+1) * p/(1-p).
static double tail_probability(int users, double p, int limit) {
    double term = pow(1 - p, users);
    double tail = 0;
    for (int k = 0; k <= users; k++) {
        if (k > limit) {
            tail += term;
        }
        term *= (double)(users - k) / (k + 1) * p / (1 - p);
    }
    return tail;
}
Corrámoslo con 40 usuarios, cuatro veces los que caben con circuitos:
$ ./multiplex 1000 100 0.1 40
con circuitos caben: 10 usuarios
con paquetes y 40 usuarios: en promedio 4.0 activos
P(mas de 10 activos a la vez) = 1.470e-03
Y con varias cantidades de usuarios, siempre con el mismo programa:
| Usuarios (N) | Activos en promedio | P(más de 10 activos) |
|---|---|---|
| 10 | 1,0 | 0 |
| 20 | 2,0 | 7,1 × 10⁻⁷ |
| 30 | 3,0 | 8,9 × 10⁻⁵ |
| 40 | 4,0 | 1,5 × 10⁻³ |
| 50 | 5,0 | 9,4 × 10⁻³ |
| 100 | 10,0 | 0,42 |
Con 40 usuarios, el enlace se pasa del límite solo el 0,15 % del tiempo. Y en ese 0,15 %, los paquetes no se pierden de inmediato: esperan en el buffer. A esto se le llama multiplexación estadística: compartir un recurso apostando a que no todos lo van a necesitar al mismo tiempo. Y la última fila avisa cuándo la apuesta deja de ser buena: con 100 usuarios el promedio ya llega a la capacidad, y casi la mitad del tiempo el enlace no alcanza.
Idea clave. La conmutación de paquetes admite más usuarios porque cada usuario pide su pico solo una fracción del tiempo. No hace aparecer capacidad: permite usar la que queda libre. Si todos transmitieran sin parar, es decir, con p cercano a 1, no habría ninguna ganancia, y los circuitos serían mejores porque por lo menos no habría colas.
Error común. Olvidar que el cálculo supone independencia. Si todos los usuarios se activan por la misma causa, como una final del mundial, el inicio de la matrícula en línea o un sismo, la probabilidad real es mucho mayor que la de la tabla. Las redes se saturan justo en esos momentos.
En la práctica. Es lo que los ISP llaman oversubscription: venden, en total, mucha más capacidad que la que tienen hacia el resto de Internet. Por eso su plan de fibra de 500 Mbps cuesta lo que cuesta, y por eso el servicio se puede poner lento en las horas de mayor uso.
¿En qué caso es peor la conmutación de paquetes? Cuando una aplicación necesita un retardo acotado y la red está cargada. Una llamada de voz manda poco, pero un paquete que llega 300 ms tarde ya no sirve de nada. Con un circuito eso no pasaría. La respuesta de Internet ha sido sobredimensionar enlaces y agregar mecanismos en los bordes, no volver a los circuitos.
Una red de redes
Falta la pregunta de quién conecta a quién. Las redes de acceso son miles, y su fibra llega a su barrio, no a Tokio. Armemos la estructura de Internet como un razonamiento de diseño, paso por paso.
Intento 1: todos con todos. Se conecta cada ISP de acceso con todos los demás. Con N redes se necesitan N(N − 1)/2 enlaces, y para decenas de miles de redes resultan cientos de millones de enlaces intercontinentales. Imposible.
Intento 2: un solo ISP global. Un ISP de tránsito con enlaces en todo el mundo, al que todos los ISP de acceso les pagan. Funciona, y justamente por eso aparecen competidores.
Lo que tenemos: competencia y jerarquía. Varios ISP globales, que deben conectarse entre sí para que sus clientes se puedan alcanzar. Debajo de ellos, ISP regionales que compran acceso a los globales y venden a los de acceso. Las piezas son estas:
| Pieza | Qué es |
|---|---|
| ISP de acceso | Conecta hogares, empresas o universidades. Paga a un proveedor. |
| ISP regional | Agrupa a varios ISP de acceso en una zona. Paga a un ISP mayor. |
| ISP de tránsito global (tier 1) | Red con alcance mundial. No paga a nadie para llegar a ninguna parte de Internet. |
| PoP (point of presence) | Grupo de routers de un proveedor, donde sus clientes se conectan. |
| Multi-homing | Conectarse a dos o más proveedores, para resistir fallas o negociar mejor. |
| Peering | Dos redes del mismo nivel se conectan directamente, normalmente sin pagarse. |
| IXP (Internet exchange point) | Lugar físico donde muchas redes se conectan a un mismo switch para hacer peering. |
| Red de contenido | Red privada de una empresa como Google, que lleva su tráfico cerca de los usuarios y se salta niveles de la jerarquía. |
                  ISP global ◀── peering ──▶ ISP global
                   ▲      ▲                    ▲     ▲
              paga │      └─────┐        ┌─────┘     │ paga
                   │            │        │           │
              ISP regional ◀─▶ [ IXP ] ◀─▶ ISP regional ◀── red de contenido
                 ▲    ▲                     ▲
            paga │    │                     │ paga
                 │    │                     │
            ISP de   ISP de             ISP de
            acceso   acceso             acceso
Las flechas tienen un sentido económico: el cliente le paga al proveedor por el tráfico que este le transporta. Dos redes hacen peering cuando ambas salen ganando, porque si no, cada una tendría que pagarle a un proveedor por llevar ese mismo tráfico. Por eso existen los IXP. En el Perú, varias redes se conectan entre sí en el NAP Perú, de modo que el tráfico entre dos ISP peruanos no tiene por qué salir del país.
Idea clave. Internet no tiene dueño ni centro. Son decenas de miles de redes independientes, llamadas sistemas autónomos, cada una con su propio negocio. Los caminos que siguen sus paquetes los deciden, en buena medida, contratos entre empresas, no la distancia. Esto se ve en un
traceroute, y en la semana 6 lo van a configurar ustedes mismos con BGP.
Las cuatro componentes del retardo
Con esto termina el mapa y empieza la medición. Un paquete viaja de router en router, y en cada nodo sufre cuatro retardos. Sus nombres y sus causas hay que saberlos de memoria:
d_nodal = d_proc + d_cola + d_trans + d_prop router A router B
┌───────────────────────────────┐
│ procesar ─▶ cola ─▶ transmitir│─ ─ ─ ─ ─ propagar ─ ─ ─ ─ ─▶ │
└───────────────────────────────┘
d_proc d_cola d_trans d_prop| Retardo | Qué es | De qué depende | Valor típico |
|---|---|---|---|
| Procesamiento (d_proc) | Leer el encabezado, buscar en la tabla, revisar errores | Del router | Microsegundos o menos |
| Cola (d_cola) | Esperar a que salgan los que llegaron antes | De la carga del enlace | De cero a milisegundos, o más |
| Transmisión (d_trans) | Poner todos los bits del paquete en el enlace: L/R | Del tamaño del paquete y de la velocidad del enlace | Microsegundos a milisegundos |
| Propagación (d_prop) | Lo que tarda un bit en cruzar el enlace: d/s | De la distancia y del medio | De nanosegundos a cientos de milisegundos |
Donde L es el tamaño en bits, R la velocidad en bits/s, d la distancia en metros y s la velocidad de propagación en metros/s.
Hay que separar bien las dos últimas. Imaginen a cien personas que salen por una puerta angosta, de una en una, y caminan hasta otro edificio. El tiempo que tardan en cruzar la puerta todas ellas, desde la primera hasta la última, depende de cuántas son y de qué tan ancha es la puerta: esa es la transmisión. Lo que tarda cada una en caminar hasta el otro edificio depende de la distancia y de su paso: esa es la propagación. Una puerta más ancha no acorta el camino, y un edificio más cerca no hace más ancha la puerta.
Error común. Confundir retardo de transmisión con retardo de propagación. El primero depende del tamaño del paquete y de la velocidad del enlace, y no sabe nada de la distancia. El segundo depende de la distancia, y no sabe nada del paquete. “Mi enlace es de 1 Gbps” no dice nada sobre la propagación: un enlace de 1 Gbps entre Lima y Tokio sigue teniendo decenas de milisegundos de retardo.
Calcularlos
delay.c hace las dos cuentas. Lo importante de
ese programa son dos líneas:
    double transmission = bits / rate;
    double propagation = meters / speed;
Ejemplo 1: Lima a Miami. Un paquete de 1500 bytes en un enlace de 100 Mbps. La distancia en línea recta es de unos 4200 km, calculada con la fórmula del círculo máximo a partir de las coordenadas de las dos ciudades. Un cable real es más largo. En fibra, s ≈ 2×10⁸ m/s:
$ ./delay 1500 100 4200
transmision L/R =      0.120 ms
propagacion d/s =     21.000 ms
domina la propagacion, 175.0 veces mayor
A mano: L/R = 12 000 bits / 10⁸ bits/s = 0,12 ms, y d/s = 4,2×10⁶ m / 2×10⁸ m/s = 21 ms.
Ejemplo 2: un enlace lento y corto. El mismo paquete en un enlace de 1 Mbps de 1 km:
$ ./delay 1500 1 1
transmision L/R =     12.000 ms
propagacion d/s =      0.005 ms
domina la transmision, 2400.0 veces mayor
Ninguno de los dos retardos domina siempre: depende del enlace. Esta conclusión tiene consecuencias prácticas. Los enlaces rápidos y largos, como los del núcleo, están dominados por la propagación, y ya no hay forma de mejorarlos, porque la velocidad de la luz no se negocia. En cambio, los enlaces lentos y cortos, como un Wi-Fi malo, están dominados por la transmisión, y aumentar R sí ayuda.
¿Cuántos bits caben en el cable? Multiplicando velocidad por retardo de propagación se obtiene el producto bandwidth-delay: en el enlace a Miami, 100 Mbps × 21 ms = 2,1 Mbit, unos 262 KB. Esos son los bits que están “en vuelo” dentro de la fibra en cada instante. Un paquete de 1500 bytes ocupa menos del 1 % del cable. Este número va a ser central cuando diseñemos ventanas deslizantes en la semana 9.
Medirlos: la topología de la semana
Para comprobarlo necesitamos una red donde nosotros decidamos cada velocidad y
cada retardo. Es la topología
path.clab.yml: dos hosts y tres
routers en fila.
    h1 ────────── r1 ────────── r2 ────────── r3 ────────── h2
 10.1.0.2    10.1.0.1      10.0.12.2     10.0.23.3      10.2.0.2
                  10.0.12.1      10.0.23.2     10.2.0.1
Cada nodo es un contenedor, y cada enlace, un par de interfaces virtuales. Se
levanta con make up. Cada nodo tiene un frr.conf con su dirección y sus
rutas, escritas a mano por ahora:
frr defaults traditional
hostname r2
interface eth1
 ip address 10.0.12.2/24
interface eth2
 ip address 10.0.23.2/24
ip route 10.1.0.0/24 10.0.12.1
ip route 10.2.0.0/24 10.0.23.3
Sin configurar nada más, los enlaces son rapidísimos y sin distancia, porque todos los nodos viven en la misma computadora:
$ docker exec clab-w01-path-h1 ping -c 3 10.2.0.2
PING 10.2.0.2 (10.2.0.2): 56 data bytes
64 bytes from 10.2.0.2: seq=0 ttl=61 time=0.310 ms
64 bytes from 10.2.0.2: seq=1 ttl=61 time=0.069 ms
64 bytes from 10.2.0.2: seq=2 ttl=61 time=0.080 ms

--- 10.2.0.2 ping statistics ---
3 packets transmitted, 3 packets received, 0% packet loss
round-trip min/avg/max = 0.069/0.153/0.310 ms
ping envía un paquete que el destino devuelve, y mide el RTT (round-trip
time): lo que tarda en ir y volver. Para simular un enlace real usamos tc
con netem, una función del kernel de Linux que frena lo que sale por una
interfaz. Un retardo de 21 ms en cada sentido se ve así:
tc qdisc replace dev eth2 root netem delay 21msComo tc controla lo que sale de una interfaz, un enlace necesita una
regla en cada extremo. La función set_link de
experiments.py pone las dos.
Y ahora el experimento. Mandamos ping de distintos tamaños, y para cada
tamaño nos quedamos con el RTT mínimo de 40 intentos, porque el mínimo
descarta las colas y el ruido de la computadora. Probamos tres casos: un
enlace a 5 Mbps; tres enlaces a 5 Mbps; y un enlace a 5 Mbps más un enlace
“largo” de 21 ms por sentido, sin límite de velocidad.
$ python3 experiments.py size
RTT mínimo en ms, según los bytes de datos de ping

caso                                       64     400     800    1200    1472   R estimada
un enlace a 5 Mbps                       1.56    1.88    3.36    5.61    5.67      4.8 Mbps
tres enlaces a 5 Mbps                    5.63    8.88   11.66   16.84   18.05      5.3 Mbps
un enlace a 5 Mbps y cable de 21 ms     44.89   45.15   46.87   48.54   49.80      4.4 Mbps
Las cifras dependen de la máquina, pero la forma debería repetirse. Hay tres cosas que leer.
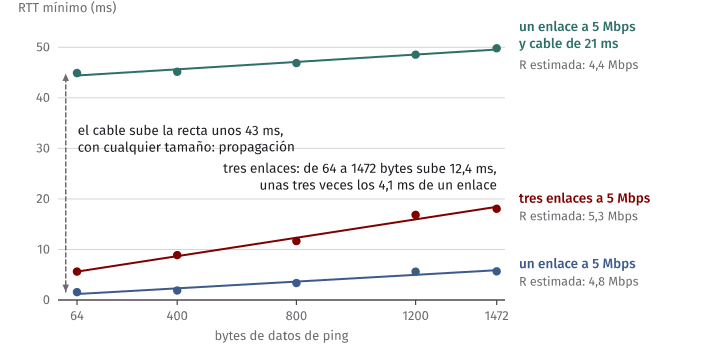
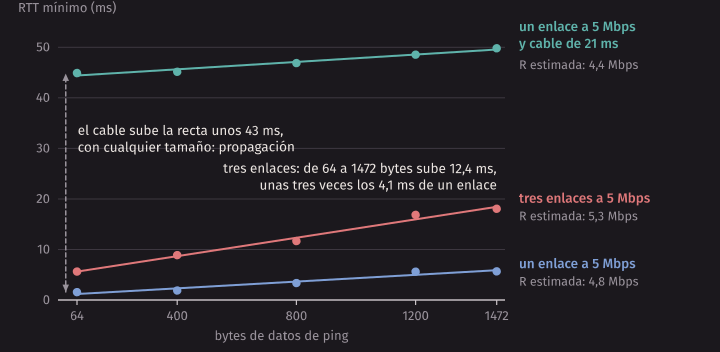
Primero: el RTT crece en línea recta con el tamaño. Un ping con S bytes
de datos produce un frame de S + 42 bytes: 8 del encabezado ICMP, 20 de IP y
14 de Ethernet. Cruza el enlace lento dos veces, ida y vuelta. La teoría
predice:
RTT(S) = RTT₀ + 2 · (S + 42) · 8 / RDel tamaño 64 al 1472, la teoría dice que el RTT debe subir 2 · 1408 · 8 / 5×10⁶ = 4,5 ms, y lo medido es 5,67 − 1,56 = 4,1 ms. La pendiente es tan confiable que sirve para medir R: ajustamos una recta y despejamos R. Esa es la última columna: 4,8 Mbps, cuando configuramos 5. Con esta idea funcionan algunas herramientas para estimar la capacidad de un enlace sin acceso al enlace.
Segundo: tres enlaces, tres veces la pendiente. Con tres enlaces lentos, la subida es 18,05 − 5,63 = 12,4 ms, unas tres veces 4,1 ms. Eso es store-and-forward, medido: cada enlace agrega su propio L/R, porque cada nodo espera el paquete completo antes de seguir, tal como dice la fórmula N · L/R.
Tercero: la propagación no depende del tamaño. Comparen la primera y la tercera fila. Agregar el cable sube el RTT lo mismo para todos los tamaños:
| Bytes de datos | 64 | 400 | 800 | 1200 | 1472 |
|---|---|---|---|---|---|
| Diferencia entre filas (ms) | 43,3 | 43,3 | 43,5 | 42,9 | 44,1 |
Unos 43 ms siempre: los 42 ms de ida y vuelta configurados más un poco de sobrecosto. Transmisión y propagación se separan limpiamente, porque son fenómenos distintos.
Error común. Creer que
RTT₀es cero en esta topología. Los 64 bytes dan 1,56 ms aunque la transmisión teórica sea 2 · 106 · 8 / 5×10⁶ = 0,34 ms. El resto, más o menos 1,2 ms, lo agrega la propia emulación contc: sin reglas, el RTT era de menos de 0,1 ms. Por eso comparamos diferencias y pendientes, no cifras absolutas. Es un hábito útil para cualquier medición: entender qué parte del número viene de lo que se quiere medir y qué parte del instrumento.
Un detalle de honestidad: netem no transmite bits más lento; retiene el paquete el tiempo que tardaría y luego lo deja pasar. Para el paquete el efecto es el mismo, y por eso sirve para comprobar las fórmulas, pero es una emulación. Es lo que usaremos durante todo el curso para simular enlaces.
Colas y pérdida
De los cuatro retardos, el de cola es el único que cambia de un paquete a otro. Por eso no se describe con un número sino con estadísticas, y es lo que hace difícil el diseño de redes.
Intensidad de tráfico
Supongamos que todos los paquetes tienen L bits, que el enlace transmite a R bits/s y que llegan en promedio a paquetes por segundo a la cola. Los bits llegan a una tasa La, y salen a una tasa R. Su cociente es la intensidad de tráfico (traffic intensity), a la que llamaremos ρ:
ρ = L · a / REs un número sin unidades, y la regla de oro sale directo de él:
- Si ρ > 1, llegan más bits de los que pueden salir. La cola crece sin límite, hasta llenar el buffer. Ningún buffer lo arregla.
- Si ρ ≤ 1, la cola depende de cómo lleguen los paquetes, no solo de cuántos.
Idea clave. Nunca diseñen un sistema para trabajar con ρ > 1. Tampoco apunten a trabajar justo debajo de 1: el retardo se dispara mucho antes de llegar ahí.
Cómo llegan importa
queue_sim.c simula la cola de salida de un
router con paquetes iguales. Mide el tiempo en unidades de L/R, el tiempo de
transmitir un paquete, para que el resultado valga para cualquier enlace. El
núcleo son unas pocas líneas: backlog es el trabajo pendiente en el enlace.
Entre dos llegadas baja, y cada paquete que entra espera exactamente lo que
encuentra y suma 1.
    for (long i = 0; i < cfg->packets; i++) {
        backlog -= next_gap(cfg, i, &state);
        if (backlog < 0) {
            backlog = 0;
        }
        // Con paquetes iguales, ceil(backlog) es cuántos hay en el buffer.
        if (cfg->buffer > 0 && ceil(backlog) >= cfg->buffer) {
            dropped++;
            continue;
        }
        total_delay += backlog;
        if (backlog > max_delay) {
            max_delay = backlog;
        }
        backlog += 1;
        sent++;
    }
Partamos del caso más ordenado: un paquete cada 1/ρ unidades, perfectamente periódico. Cuando llega uno, el anterior ya salió:
$ for r in 0.10 0.50 0.80 0.90 0.95 0.99; do ./queue_sim periodic $r; done
rho=0.10  retardo_medio=      0.00  retardo_max=      0.00  perdida=  0.0%
rho=0.50  retardo_medio=      0.00  retardo_max=      0.00  perdida=  0.0%
rho=0.80  retardo_medio=      0.00  retardo_max=      0.00  perdida=  0.0%
rho=0.90  retardo_medio=      0.00  retardo_max=      0.00  perdida=  0.0%
rho=0.95  retardo_medio=      0.00  retardo_max=      0.00  perdida=  0.0%
rho=0.99  retardo_medio=      0.00  retardo_max=      0.00  perdida=  0.0%
¡Sin cola, incluso al 99 %! Ahora el extremo opuesto: ráfagas de 10 paquetes, con la misma intensidad media. El primero de cada ráfaga no espera; el segundo espera 1; el décimo, 9. El promedio es (0 + 1 + … + 9)/10 = 4,5, sin importar ρ:
$ for r in 0.10 0.50 0.90; do ./queue_sim burst:10 $r; done
rho=0.10  retardo_medio=      4.50  retardo_max=      9.00  perdida=  0.0%
rho=0.50  retardo_medio=      4.50  retardo_max=      9.00  perdida=  0.0%
rho=0.90  retardo_medio=      4.50  retardo_max=      9.00  perdida=  0.0%
Con ρ = 0,10, un enlace casi vacío, hay retardo de cola. Las colas no vienen solo de tener mucho tráfico. Vienen también de que el tráfico no llega ordenado.
El caso realista está en medio: llegadas al azar, independientes unas de otras. Se modelan como un proceso de Poisson, y para esta cola, en la teoría de colas conocida como M/D/1, hay una fórmula cerrada, que aquí usamos sin demostrar:
espera media = ρ / (2 (1 − ρ)) · L/R$ for r in 0.10 0.50 0.80 0.90 0.95 0.99 1.20; do ./queue_sim poisson $r; done
rho=0.10 retardo_medio= 0.06 retardo_max= 4.27 perdida= 0.0%
rho=0.50 retardo_medio= 0.50 retardo_max= 12.50 perdida= 0.0%
rho=0.80 retardo_medio= 1.99 retardo_max= 30.50 perdida= 0.0%
rho=0.90 retardo_medio= 4.48 retardo_max= 58.62 perdida= 0.0%
rho=0.95 retardo_medio= 9.45 retardo_max= 100.80 perdida= 0.0%
rho=0.99 retardo_medio= 50.42 retardo_max= 455.11 perdida= 0.0%
rho=1.20 retardo_medio= 831098.19 retardo_max=1666501.40 perdida= 0.0%| ρ | Simulación | Fórmula | Espera en un enlace de 100 Mbps con paquetes de 1500 bytes |
|---|---|---|---|
| 0,10 | 0,06 | 0,06 | 0,007 ms |
| 0,50 | 0,50 | 0,50 | 0,06 ms |
| 0,80 | 1,99 | 2,00 | 0,24 ms |
| 0,90 | 4,48 | 4,50 | 0,54 ms |
| 0,95 | 9,45 | 9,50 | 1,1 ms |
| 0,99 | 50,42 | 49,50 | 6,1 ms |
La última columna es la simulación multiplicada por L/R = 0,12 ms. Aquí está la lección central de este capítulo:
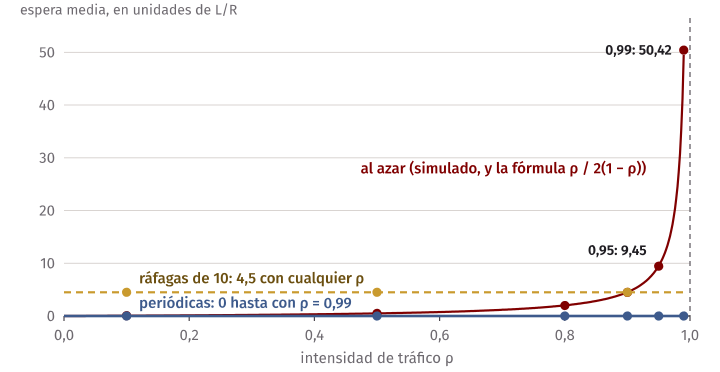
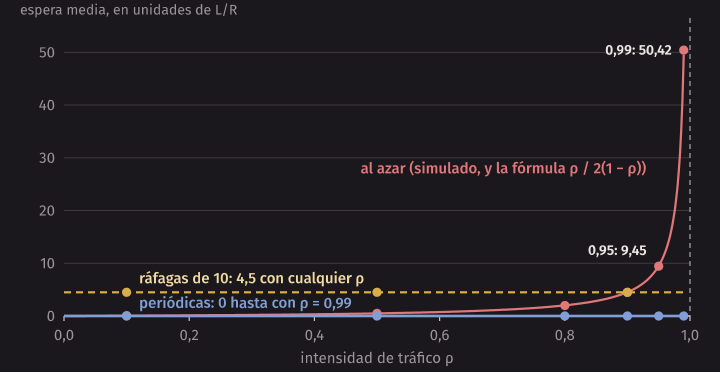
Al pasar de ρ = 0,5 a 0,9, la carga crece menos del doble y el retardo se multiplica por nueve. Del 0,95 al 0,99, un 4 % más de tráfico multiplica el retardo por más de cinco. Cerca de 1, la curva se va al infinito.
¿Y con ρ > 1? La línea rho=1.20 de arriba da un retardo absurdo, porque
el simulador tenía un buffer infinito. Veamos qué pasa con esa cola al simular
durante más tiempo:
$ for n in 1000 10000 100000 1000000; do ./queue_sim poisson 1.2 0 $n; done
rho=1.20  retardo_medio=     56.87  retardo_max=    123.28  perdida=  0.0%
rho=1.20  retardo_medio=    805.84  retardo_max=   1684.66  perdida=  0.0%
rho=1.20  retardo_medio=   8339.84  retardo_max=  16654.45  perdida=  0.0%
rho=1.20  retardo_medio=  82595.93  retardo_max= 164563.24  perdida=  0.0%
Diez veces más paquetes, diez veces más retardo: la espera no converge a ningún valor. Eso es lo que significa “crece sin límite”.
Buffer finito. Un router real tiene B lugares. El retardo de cola queda acotado por B · L/R, porque nadie puede encontrar más de B paquetes delante, y lo que no cabe se descarta. Para ρ > 1 hay además una predicción exacta: el enlace saca 1 por unidad de tiempo y entran ρ, así que debe sobrar una fracción 1 − 1/ρ:
$ for r in 0.50 0.90 1.00 1.20 2.00; do ./queue_sim poisson $r 100; done
rho=0.50  retardo_medio=      0.50  retardo_max=     12.50  perdida=  0.0%
rho=0.90  retardo_medio=      4.48  retardo_max=     58.62  perdida=  0.0%
rho=1.00  retardo_medio=     49.12  retardo_max=     99.00  perdida=  0.5%
rho=1.20  retardo_medio=     96.34  retardo_max=     99.00  perdida= 16.7%
rho=2.00  retardo_medio=     98.37  retardo_max=     99.00  perdida= 50.0%
Con ρ = 1,2 la pérdida es 1 − 1/1,2 = 16,7 %, y con ρ = 2, justo la mitad. Fíjense en que los paquetes que sí pasan esperan casi el buffer entero: perder paquetes y tener mucho retardo vienen juntos. Un buffer enorme cambia pérdida por retardo, y ese problema tiene nombre, bufferbloat, que estudiaremos en la semana 11.
Error común. Pensar que si ρ < 1 no hay cola. La simulación con ráfagas muestra colas con ρ = 0,1. La condición ρ < 1 solo garantiza que la cola no crezca sin límite.
Medirlo en la topología
Ahora con paquetes de verdad. Dejamos el enlace r1-r2 a 50 Mbps con un
buffer de 200 paquetes y mandamos UDP con iperf3, un generador de tráfico, a
distintas intensidades. Mientras tanto, medimos el RTT con ping. Calculamos
ρ con los bytes que de verdad cruzan el enlace: 1400 de datos más 42 de
encabezados, 1442 en total.
$ python3 experiments.py queue
Enlace r1-r2 a 50 Mbps, buffer de 200 paquetes, UDP de h1 a h2

carga                   rho   RTT prom.   RTT max.   pérdida UDP
sin carga              0.00     2.04 ms    2.23 ms             -
regular                0.50     1.58 ms    2.56 ms          0.0%
regular                0.80     2.04 ms    5.25 ms          0.0%
regular                0.95     2.18 ms    5.52 ms          0.0%
regular                1.20    46.59 ms   47.05 ms         16.1%
ráfagas de 100         0.50     9.40 ms   23.79 ms          0.0%
Las cifras dependen de la máquina y de lo que esté corriendo en ella, y diferencias de un milisegundo son ruido: por eso “sin carga” sale más alto que con ρ = 0,5. Pero las cifras grandes salen de las cuentas:
iperf3envía casi periódicamente, y por eso con ρ = 0,95 casi no hay cola. Es la fila “periódica” del simulador.- Con ρ = 1,2 el buffer se llena. Un
pingespera 200 paquetes de 1442 bytes a 50 Mbps: 200 · 1442 · 8 / 5×10⁷ = 46,1 ms. Se midieron 46,6 ms. Y la pérdida predicha es 16,7 %; se midió 16,1 %. - Las ráfagas hacen cola con ρ = 0,5. Es la misma cantidad de tráfico que la fila regular de ρ = 0,5, en grupos de 100 paquetes. Una ráfaga tarda 100 · 1442 · 8 / 5×10⁷ = 23,1 ms en salir, y el peor RTT fue de 23,8 ms.
En la práctica. Por esto una videollamada se corta cuando alguien en la casa inicia una descarga grande, aunque la velocidad contratada “alcance”. La descarga llena el buffer del equipo de salida, y la voz hace la misma cola. El problema no es de velocidad sino de retardo de cola. Este experimento se puede hacer en casa: dejen corriendo
pinga un servidor cercano e inicien una descarga.
Ver el retardo salto por salto con traceroute
ping da el RTT de todo el camino. Para verlo por tramos existe traceroute,
un programa escrito por Van Jacobson en 1987 que aprovecha un campo de IP de
una forma muy ingeniosa.
Todo paquete IP lleva un TTL (time to live). Cada router le resta 1, y si
llega a 0, descarta el paquete y le avisa al origen con un mensaje ICMP Time
Exceeded. El campo existe para que un paquete no dé vueltas para siempre si
hay un ciclo en el camino. traceroute envía paquetes con TTL 1, luego con
TTL 2, y así sucesivamente, a un puerto UDP que probablemente nadie usa:
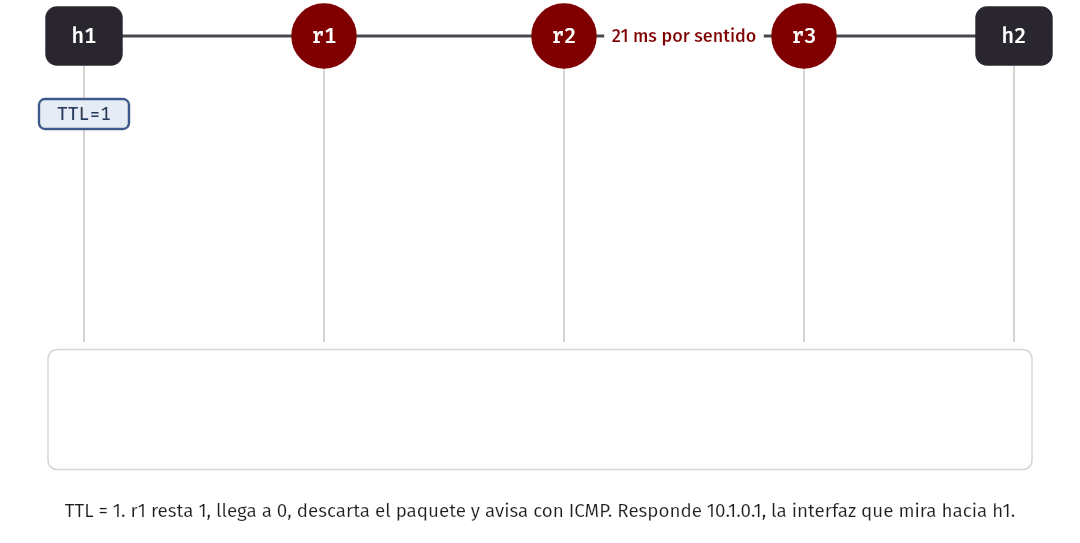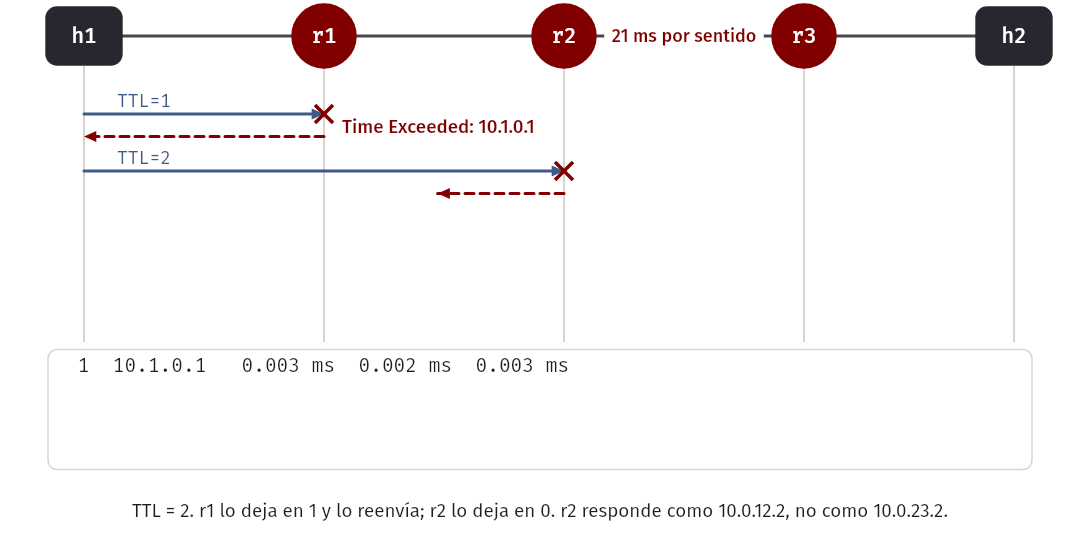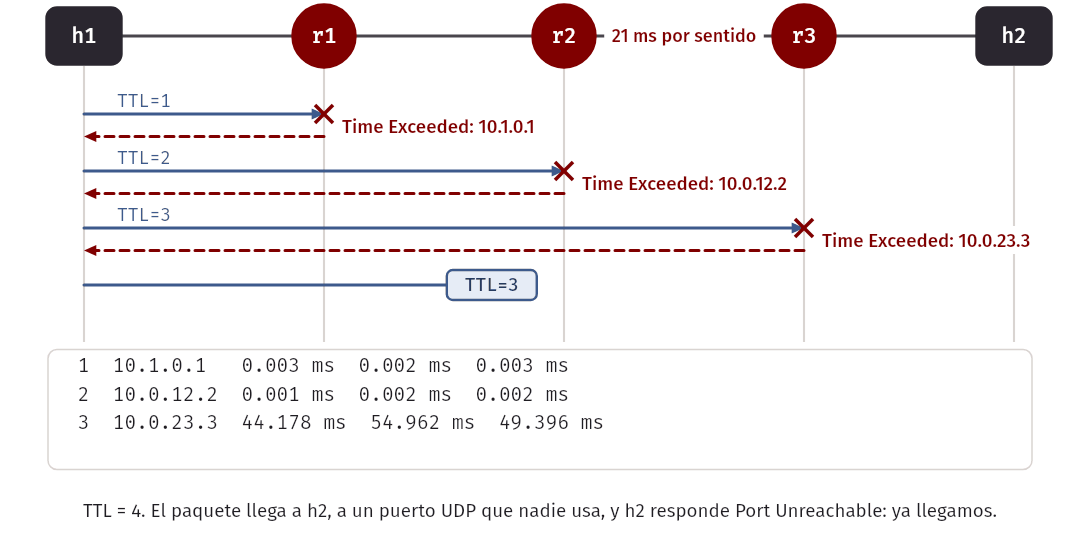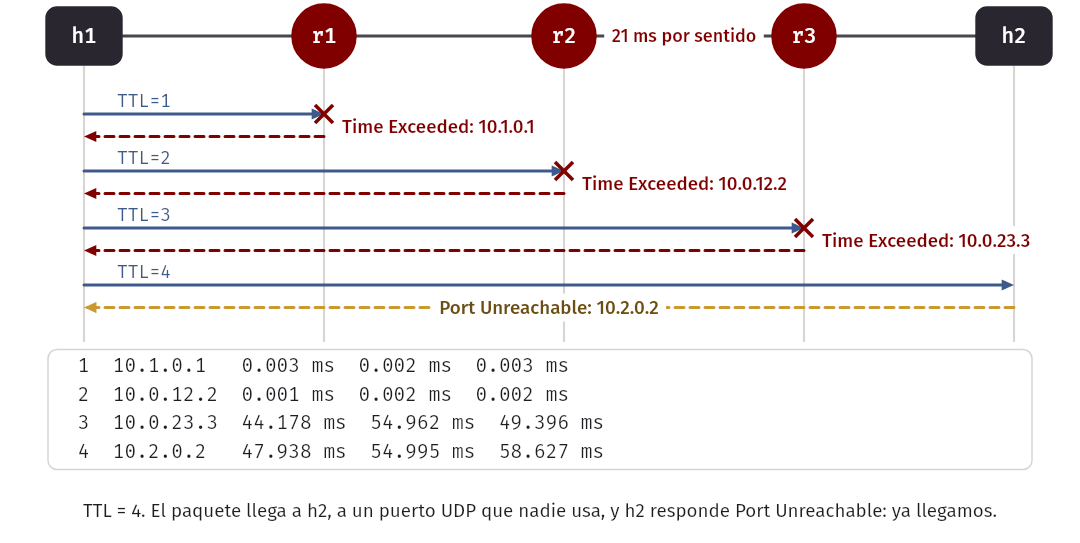
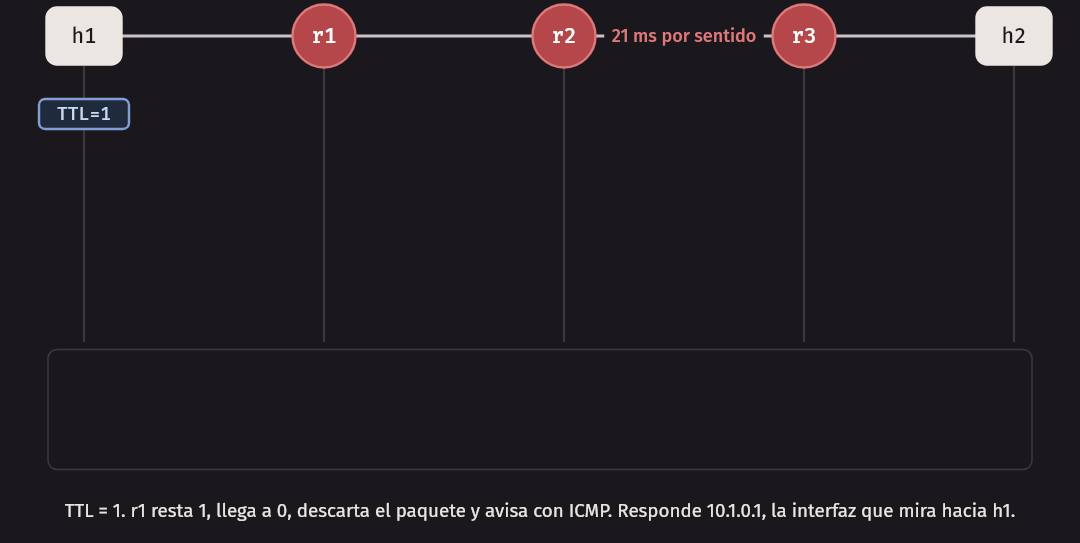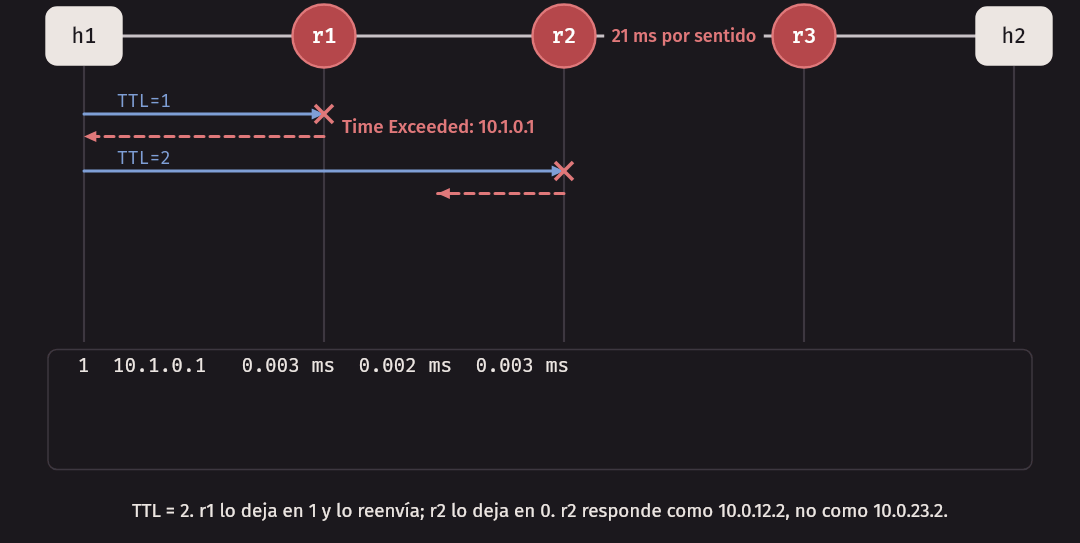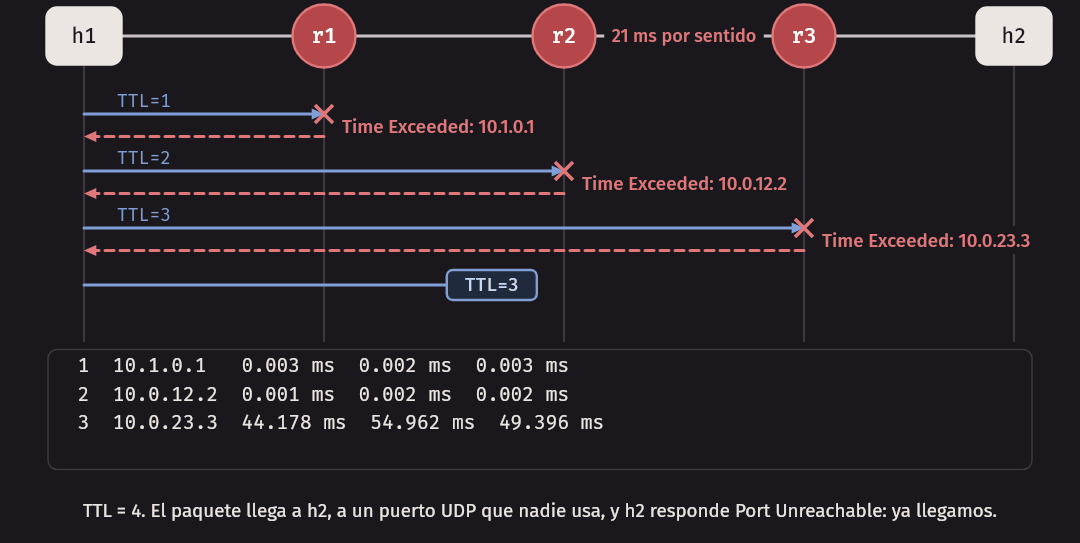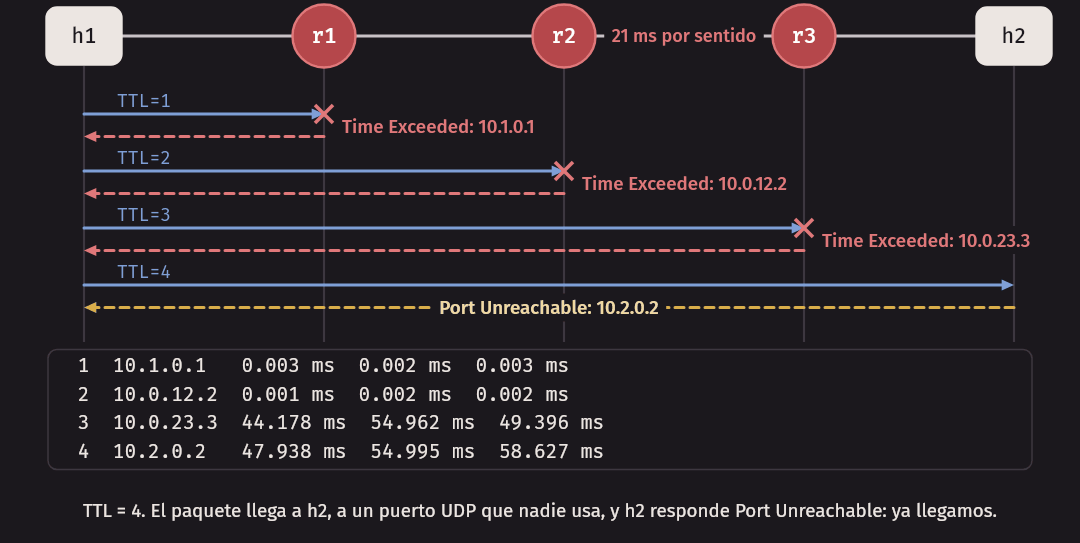
Cada respuesta revela la dirección de un router, y el tiempo hasta ella da el
RTT hasta ese salto. Por defecto se mandan tres paquetes por salto, y de ahí
las tres cifras. Ustedes van a escribir su propia versión en P0, con
sockets, en las próximas dos semanas. ICMP lo estudiamos en la semana 4.
El tracert de Windows usa ICMP Echo en lugar de UDP, y lo demás funciona igual.
En la topología
Con el enlace r2-r3 configurado con 21 ms por sentido, igual que nuestro
enlace teórico a Miami:
$ python3 experiments.py cable
Enlace r2-r3 con 21 ms por sentido

traceroute to 10.2.0.2 (10.2.0.2), 30 hops max, 46 byte packets
 1  10.1.0.1  0.003 ms  0.002 ms  0.003 ms
 2  10.0.12.2  0.001 ms  0.002 ms  0.002 ms
 3  10.0.23.3  44.178 ms  54.962 ms  49.396 ms
 4  10.2.0.2  47.938 ms  54.995 ms  58.627 ms
Se lee directamente: el salto 3 cruza el enlace largo. Del salto 2 al 3 el RTT
sube unos 44 ms, y después ya no vuelve a bajar. Fíjense en que la dirección
que responde en cada salto es la de la interfaz por donde sale el mensaje
de error, de regreso hacia h1. En este camino, que es una sola línea, coincide
con la interfaz por donde entró el paquete: r2 aparece como 10.0.12.2, no
como 10.0.23.2. Un router tiene una dirección por interfaz. En la semana 4
veremos un caso en el que no coinciden.
En Internet
Este traceroute real se corrió desde una conexión doméstica en el Perú, en
la terminal de la computadora, hacia la Universidad de Ciudad del Cabo. Las
distancias de esta sección las calculamos desde Lima, con la fórmula del
círculo máximo.
$ traceroute -q 3 -w 2 -m 14 www.uct.ac.za
traceroute to cms-vip-prd.uct.ac.za (137.158.159.192), 14 hops max, 40 byte packets
 1  192.168.18.1 (192.168.18.1)  3.211 ms  2.693 ms  2.269 ms
 2  10.178.0.1 (10.178.0.1)  4.838 ms  38.222 ms  5.658 ms
 3  10.10.7.38 (10.10.7.38)  5.392 ms  5.528 ms  5.332 ms
 4  10.10.7.37 (10.10.7.37)  5.588 ms  5.875 ms  6.289 ms
 5  45.5.68.102 (45.5.68.102)  6.232 ms  5.754 ms  5.746 ms
 6  8.243.120.5 (8.243.120.5)  10.167 ms  6.497 ms  6.092 ms
 7  * * *
 8  4.68.38.70 (4.68.38.70)  82.491 ms  83.350 ms  82.815 ms
 9  ce-2-0-2.a02.miamfl02.us.ce.gin.ntt.net (129.250.200.114)  82.401 ms  82.054 ms  82.488 ms
10  et-0-0-1-66.rt04.bb.ampath.net (170.39.8.30)  82.700 ms  82.417 ms  82.540 ms
11  187-185-103-190.ampath.net (190.103.185.187)  241.758 ms  241.256 ms  241.834 ms
12  et-0-0-1-0-cpt7-pe1.net.tenet.ac.za (155.232.64.70)  242.202 ms  241.673 ms  241.905 ms
13  154.114.124.1 (154.114.124.1)  242.017 ms  241.578 ms  242.574 ms
14  * * *
Mucho que leer aquí:
- Salto 1: el equipo de la casa, con una dirección privada. Saltos 2 a 4: dentro del ISP, que usa también direcciones privadas en su red interna. Las direcciones privadas se ven en la semana 4.
- Del salto 6 al 8, el RTT pasa de 6 a 82 ms. Salimos del país. El salto 9
lleva
miamflen el nombre, lo que sugiere Miami, Florida. Recuerden nuestro cálculo: el RTT mínimo teórico a Miami, en línea recta, es de 42 ms. Medimos unos 76 ms de aumento: el cable no va en línea recta y el camino tiene equipos en medio. La física da un piso, no una predicción. - Del salto 10 al 11, de 82 a 241 ms. Un salto de 159 ms. La distancia en línea recta de Miami a Ciudad del Cabo es de unos 12 300 km, lo que da un RTT mínimo de 123 ms, así que el aumento es consistente con cruzar el Atlántico. Eso es lo que pregunta el laboratorio: ahí hay un cable submarino.
- Los nombres cuentan el negocio.
ntt.netes un ISP de tránsito global,ampath.netes un punto de intercambio de redes académicas en Miami, ytenet.ac.zaes la red académica de Sudáfrica. Es la red de redes, en pantalla. Y un camino de Lima a Sudáfrica pasa por Florida, aunque en línea recta son 9800 km y por Miami son más de 16 000: los caminos los deciden los contratos y los cables que existen. - Los asteriscos del salto 7 significan que no llegó respuesta. Ese router quizá no responde a estos paquetes, pero el salto 8 muestra que sí los reenvía.
Error común. Tomar el nombre de un router como su ubicación.
187-185-103-190.ampath.netresponde con 241 ms, lo que descarta que esté en Miami, aunque la dirección sea de AMPATH: el nombre dice de quién es la dirección, y una dirección de un enlace puede estar en el extremo lejano de ese enlace. Los nombres son pistas. Hay que contrastarlas con la física.
Lo que la física permite deducir
Un RTT medido pone un techo a la distancia: un paquete no puede ir más rápido que la luz en fibra. Eso sirve para detectar algo muy común. Esta traza fue hacia la Universidad de Oxford:
$ traceroute -n -q 3 -w 2 -m 22 www.ox.ac.uk
traceroute: Warning: www.ox.ac.uk has multiple addresses; using 104.20.34.13
traceroute to www.ox.ac.uk.cdn.cloudflare.net (104.20.34.13), 22 hops max, 40 byte packets
 1  * 192.168.18.1  9.475 ms *
 2  10.178.0.1  6.548 ms  7.354 ms  5.593 ms
 3  10.10.7.38  4.307 ms  5.538 ms  5.942 ms
 4  10.10.7.37  4.235 ms  5.727 ms  6.067 ms
 5  45.5.68.102  19.363 ms  6.193 ms  5.330 ms
 6  8.243.120.5  7.020 ms  6.027 ms  6.591 ms
 7  200.189.213.218  55.616 ms  55.279 ms  54.944 ms
 8  * 8.243.135.46  56.057 ms  54.746 ms
 9  198.41.228.7  57.195 ms  53.699 ms
    198.41.228.5  56.785 ms
10  104.20.34.13  55.218 ms  53.657 ms  55.314 ms
De Lima a Oxford hay unos 10 100 km en línea recta, así que el RTT no puede
bajar de 101 ms. Se midieron 55 ms. El servidor que respondió no está en
Inglaterra. La propia salida lo explica: el nombre pasa a
www.ox.ac.uk.cdn.cloudflare.net. Es una red de distribución de contenido
(CDN), que atiende desde un servidor más cercano. Lo mismo al revés:
www.pucp.edu.pe resolvió a
lbl-homepucp-721506431.us-east-1.elb.amazonaws.com, un balanceador en una
región de nube de Estados Unidos. Un sitio “.pe” no tiene por qué estar en el
Perú, ni un “.uk” en el Reino Unido.
Cuando un salto intermedio tiene más RTT que uno posterior
Esta traza fue hacia la propia UNI:
$ traceroute -n -q 3 -w 2 -m 22 www.uni.edu.pe
traceroute to www.uni.edu.pe (45.80.81.43), 22 hops max, 40 byte packets
 1  192.168.18.1  3.840 ms  2.146 ms  3.034 ms
 2  10.178.0.1  5.419 ms  5.760 ms  6.906 ms
 3  10.10.7.38  3.962 ms  5.333 ms  4.955 ms
 4  10.10.7.37  5.571 ms  6.202 ms  5.114 ms
 5  181.177.224.6  5.601 ms  5.040 ms  6.637 ms
 6  45.5.68.100  11.603 ms  5.765 ms  6.462 ms
 7  45.183.47.179  5.896 ms  4.633 ms  6.118 ms
 8  10.2.17.222  50.047 ms  39.485 ms  40.203 ms
 9  10.2.18.14  6.389 ms  6.353 ms  6.635 ms
10  * * *
(Del salto 11 al 22, igual que el 10.) ¡El salto 8 tarda 40 ms y el 9, más
lejos, tarda 6! Si cada salto suma retardo, ¿cómo puede bajar? Porque el RTT
de cada línea es de un viaje distinto, y el paquete del salto 8 hizo algo
que el del salto 9 no hizo: obligó al router 8 a generar un mensaje ICMP.
Reenviar paquetes lo hace el hardware rápido del router. Generar un error lo
hace su procesador común, con baja prioridad, cuando puede. El paquete del
salto 9, en cambio, atravesó ese mismo router sin demora. Corrida unos minutos
después, la misma traza dio en el salto 8 83.456 ms 5.461 ms 5.729 ms.
Además, la respuesta puede volver por un camino distinto al de ida, y con su
propio retardo. traceroute solo ve el camino de ida. Y puede haber routers
que no aparecen: una traza a la Universidad de Tokio pasó en un solo salto de
6 a 260 ms, y el router que respondió tenía Osaka en el nombre. Es muy
improbable que un solo enlace una Lima con Osaka: lo más probable es que haya
equipos intermedios que no restan el TTL, por ejemplo dentro de un túnel.
Idea clave. Para leer un
traceroute: si el RTT sube en un salto y sigue alto en todos los siguientes, ahí hay distancia o cola real. Si sube solo en un salto y luego baja, es ese router tardando en contestar, y no dice nada sobre el camino.
Error común. Correr
traceroutehacia Internet dentro del contenedor del curso. Docker Desktop no deja ver los saltos intermedios, y se ve solo esto:$ docker exec redes traceroute -n -m 5 -w 1 www.uni.edu.pe traceroute to www.uni.edu.pe (45.80.81.43), 5 hops max, 60 byte packets 1 * * * 2 * * * 3 * * * 4 * * * 5 * * *Córranlo en la terminal de su computadora, y usen
tracerten Windows. Dentro de las topologías del curso sí funciona.
Throughput
El retardo responde a “¿cuánto tarda un paquete?”. La otra pregunta es “¿cuánto tarda mi archivo?”. Para eso está el throughput: la tasa, en bits por segundo, a la que el receptor recibe los datos. Puede ser instantáneo, en un momento dado, o promedio: un archivo de F bits que tarda T segundos da F/T.
El cuello de botella
Un camino con varios enlaces de velocidades R₁, R₂, …, Rₙ, sin nadie más usándolo, tiene un throughput de:
throughput = min(R₁, R₂, ..., Rₙ)La razón es la misma de una tubería con tramos de distinto grosor: lo que sale no puede ser más de lo que deja pasar el tramo más angosto. Ese enlace se llama el cuello de botella (bottleneck). Si un enlace rápido alimenta a uno lento, los paquetes se acumulan en la cola de la entrada del lento, y salen a su ritmo. Si es al revés, llegan separados y nunca hay cola.
Ejemplo. Un camino con enlaces de 1 Gbps, 50 Mbps y 200 Mbps, y un archivo de 1 GB:
$ ./bottleneck 1000 1000 50 200
cuello de botella: enlace 2, a 50 Mbps
tiempo para 1000 MB: 160.00 s
A mano: 1 GB = 8×10⁹ bits, y 8×10⁹ / 5×10⁷ = 160 s. El orden de los enlaces no importa, y cambiar el de 1 Gbps por uno de 10 Gbps no acelera nada.
Con TCP, en la topología, movemos el enlace de 50 Mbps por el camino:
$ python3 experiments.py bottleneck
TCP de h1 a h2, 5 s, throughput en el receptor

 r1-r2  r2-r3  r3-h2       medido
    50    200    200    47.6 Mbps
   200     50    200    47.7 Mbps
   200    200     50    45.8 Mbps
   200    200    200   187.9 Mbps
    20    200    200    18.9 Mbps
No importa dónde esté el cuello de botella. Lo medido es algo menor que el mínimo, y la razón es predecible: de cada frame de 1514 bytes, solo 1448 son datos de la aplicación; el resto son encabezados de Ethernet, IP y TCP. 1448/1514 de 50 Mbps son 47,8 Mbps. Esa tasa de datos útiles se suele llamar goodput, para distinguirla de lo que corre por el enlace.
En un enlace compartido
Si el núcleo se comparte, el enlace más lento no siempre es el de acceso. Con un servidor que sube a Rs, un cliente que baja a Rc, y un enlace común de R por el que pasan n flujos que reciben partes iguales:
throughput por flujo = min(Rs, Rc, R / n)Un cliente con 100 Mbps de bajada, un servidor con 1 Gbps de subida y un enlace troncal de 10 Gbps. Con 50 flujos, a cada uno le tocarían 200 Mbps en el troncal, y el cuello de botella es el acceso del cliente: 100 Mbps. Con 200 flujos, a cada uno le tocan 50 Mbps: el cuello de botella se movió al núcleo. En la práctica, el núcleo suele estar sobredimensionado, y el cuello de botella suele estar en el acceso, pero no siempre. El reparto equitativo tampoco sale gratis: lo tiene que conseguir el control de congestión, y lo estudiaremos en la semana 11.
Retardo o throughput
Una transferencia toma, aproximadamente, un RTT más el tamaño dividido entre el throughput. ¿Cuál de los dos importa más? Depende de qué tan grande es lo que se envía. En un camino a Miami, con RTT de 42 ms y 50 Mbps:
| Qué se envía | F / throughput | RTT | Qué domina |
|---|---|---|---|
| 1 KB, como una respuesta DNS | 0,16 ms | 42 ms | El retardo |
| 1 MB, como una foto | 160 ms | 42 ms | El throughput |
| 1 GB, como una película | 160 s | 42 ms | El throughput |
Error común. Creer que un plan más rápido siempre mejora la experiencia. Pasar de 100 Mbps a 1 Gbps no cambia casi nada al abrir páginas ni en un videojuego en línea, porque esos intercambios son muchos y pequeños, y los domina el RTT. Mejora descargas grandes. “Rápido” significa dos cosas distintas.
Capas
Internet tiene hardware de miles de fabricantes, cientos de protocolos y aplicaciones que cambian cada año. Para manejar esa complejidad, sus diseñadores organizaron todo en capas (layers).
La idea es esta: cada capa da un servicio a la de arriba, usando el servicio de la de abajo y agregando algo propio. Ninguna capa necesita saber cómo funcionan las demás; solo necesita su interfaz. Es lo mismo que hace una API en un programa. Y tiene el mismo beneficio: se puede cambiar lo que hay dentro de una capa sin tocar las otras. Cuando su casa pasó de cobre a fibra, ninguna aplicación cambió. Cuando salió HTTP/3, ningún cable cambió.
Las cinco capas de Internet
| # | Capa | Servicio que da | Unidad de datos | Ejemplos |
|---|---|---|---|---|
| 5 | Aplicación | Lo que el usuario quiere: páginas, nombres, correo | Mensaje | HTTP, DNS, SMTP |
| 4 | Transporte | Llevar datos entre procesos en dos hosts | Segmento | TCP, UDP |
| 3 | Red | Llevar datagramas entre hosts, a través de muchas redes | Datagrama | IP, y los protocolos de routing |
| 2 | Enlace | Llevar frames entre nodos vecinos, en un solo enlace | Frame | Ethernet, Wi-Fi |
| 1 | Física | Mover bits por el medio | Bit | Fibra, cobre, radio |
Lean la columna del servicio de abajo hacia arriba. La física mueve bits, pero no sabe dónde empieza un mensaje. Enlace agrupa bits en frames y los lleva un salto. Red encadena muchos saltos para ir de host a host, y es la única capa que atraviesa todas las redes. Transporte distingue, dentro de un host, a qué programa va cada dato. Y aplicación es lo que el usuario ve.
Error común. Pensar que las capas son partes de un solo programa. Las capas son una forma de organizar responsabilidades. Físicamente, en un host, la aplicación está en su programa, transporte y red en el sistema operativo, enlace y física en la tarjeta de red y su driver. La frontera entre aplicación y transporte es, de hecho, la frontera entre su programa y el kernel: es la API de sockets.
Las capas también tienen costos. Hay trabajos que se repiten, como la detección de errores, que existe en enlace y en transporte. Y a veces una capa necesita información que otra esconde. Algunos desarrollos recientes, como QUIC, reorganizan estas fronteras, y por eso los vemos en la semana 13. Pero como primer mapa de una red, este modelo se usa todos los días.
El modelo OSI como vocabulario
En los años 70 y 80, la organización ISO propuso un modelo de siete capas: OSI (Open Systems Interconnection). Agrega dos entre aplicación y transporte:
| OSI | Qué hace | En Internet |
|---|---|---|
| 7 Aplicación | Aplicación | |
| 6 Presentación | Formato de los datos: cifrado, compresión, codificación | Lo resuelve la aplicación, si le hace falta |
| 5 Sesión | Sincronizar y recuperar diálogos largos | Lo resuelve la aplicación, si le hace falta |
| 4 Transporte | Transporte | |
| 3 Red | Red | |
| 2 Enlace de datos | Enlace | |
| 1 Física | Física |
Internet no lo sigue tal cual por dos razones. La práctica: TCP/IP ya funcionaba y se había extendido mientras se terminaba de definir OSI. La de diseño: no todas las aplicaciones necesitan presentación y sesión, así que no tiene sentido obligarlas a todas. Si una aplicación quiere cifrar, usa TLS. Y si le preguntan en qué capa de OSI va TLS, verán que no hay una respuesta limpia.
OSI sobrevive como vocabulario, porque sus números son la forma en que se habla en el trabajo. Un “switch de capa 2” decide con direcciones MAC. Un “problema de capa 3” es de IP o de routing. Un “load balancer de capa 4” mira puertos, y uno “de capa 7” mira HTTP. El número 5 o el 6 casi no se oye. Por eso, aunque “aplicación” sea nuestra capa 5, se le dice “capa 7”.
Encapsulamiento
¿Cómo se organizan físicamente las capas en un paquete? Con encapsulamiento (encapsulation): al bajar, cada capa toma lo que le da la de arriba, sin mirarlo, y le pone adelante su propio encabezado (header). Lo que recibe se llama payload de esa capa.
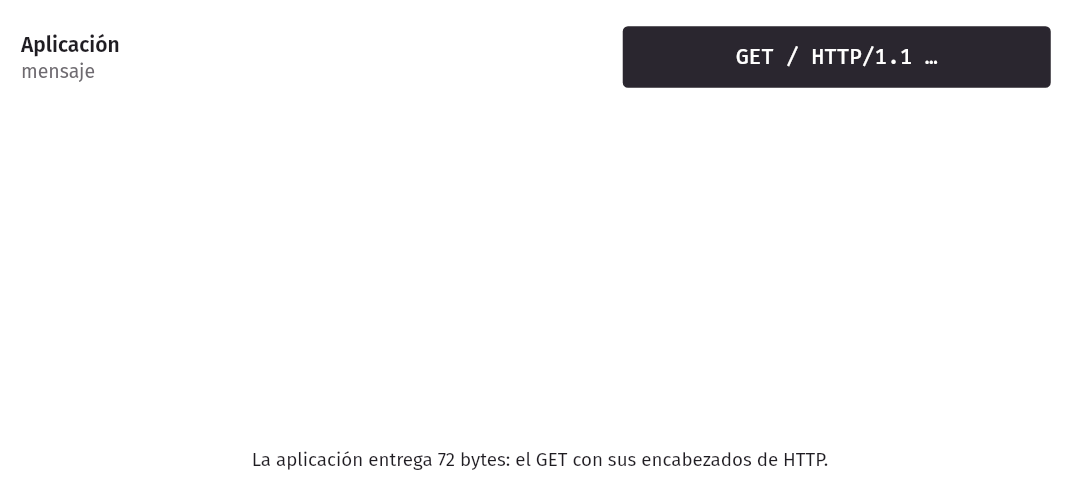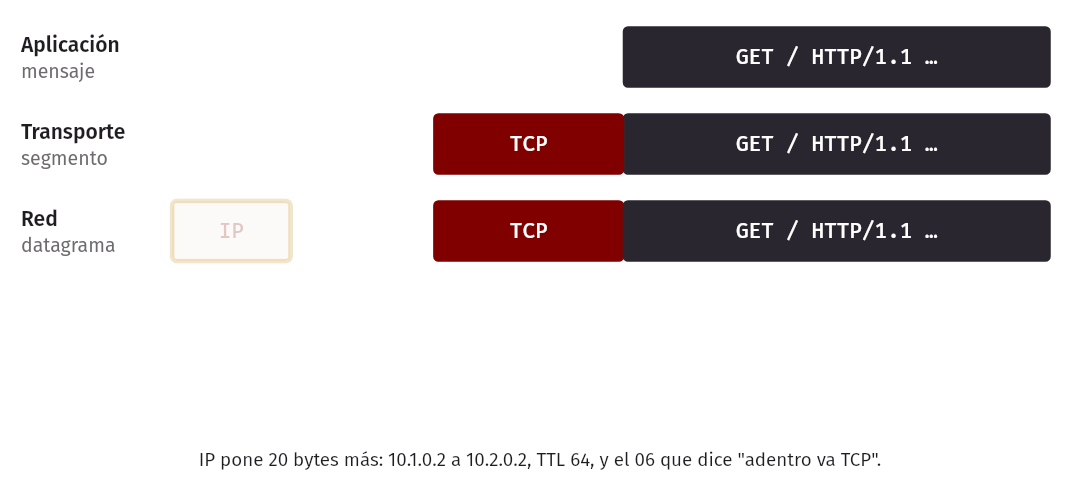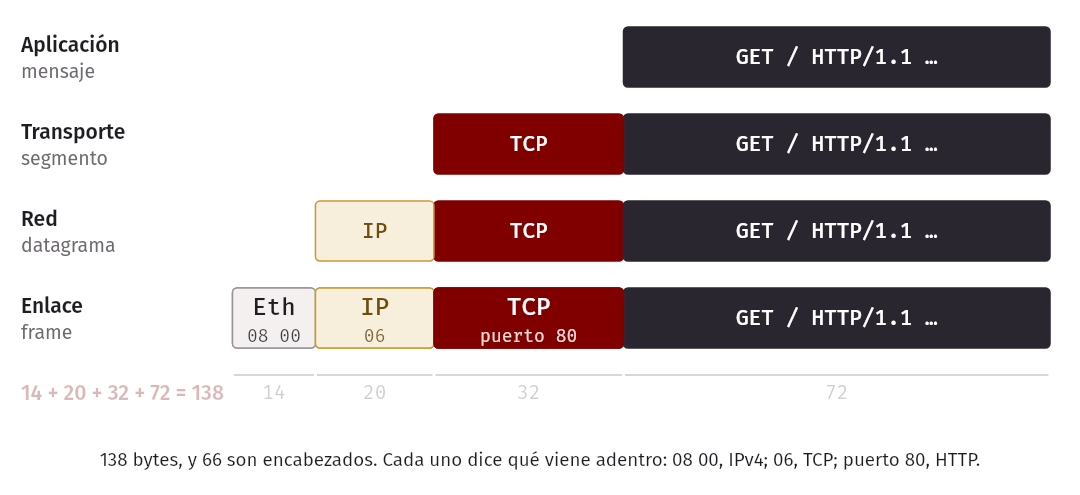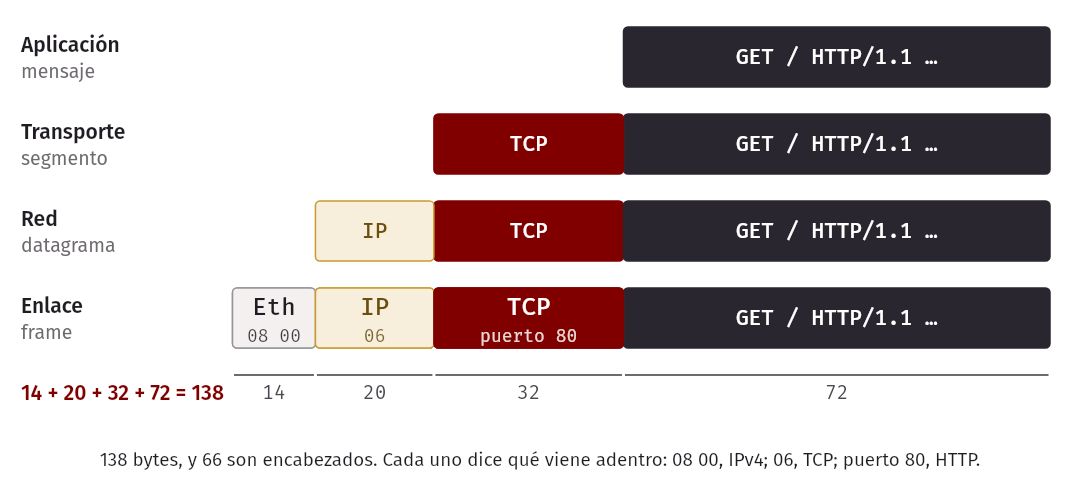
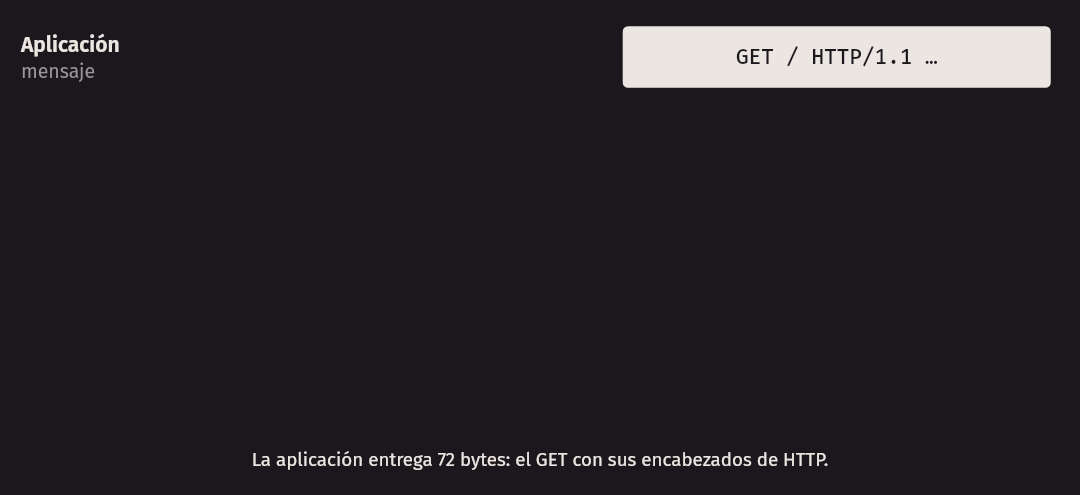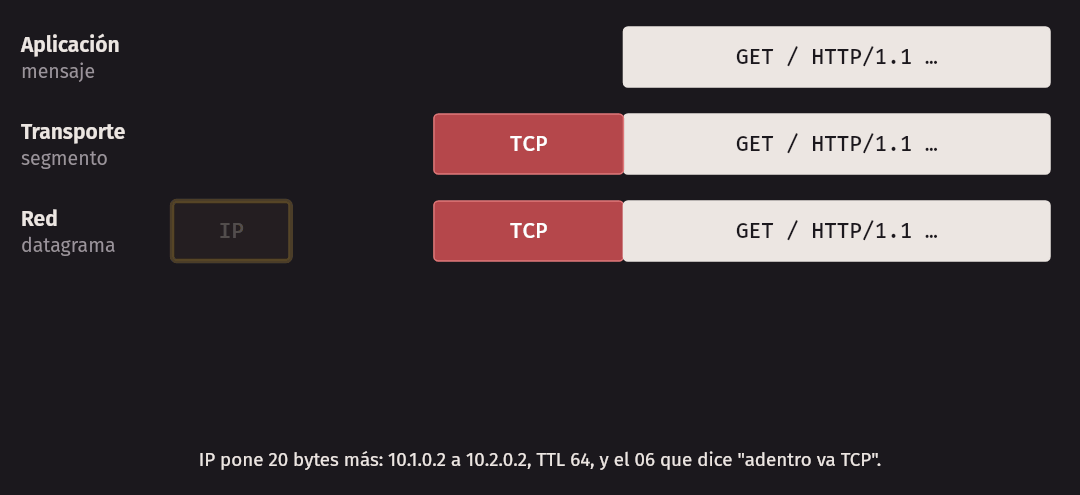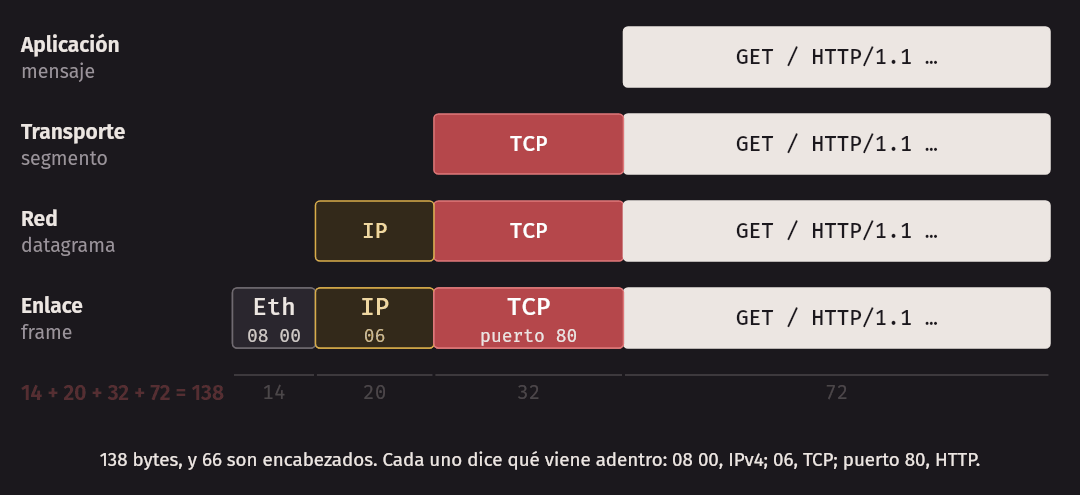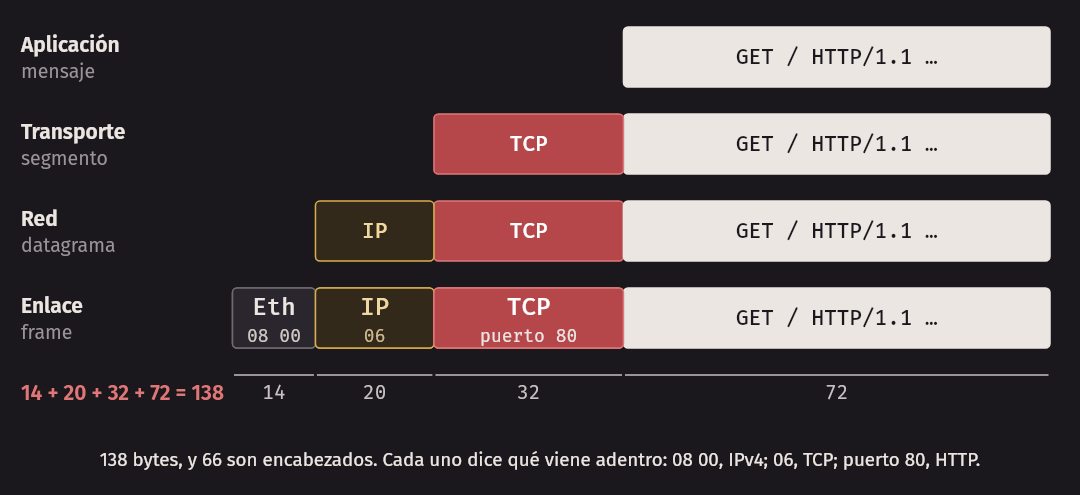
En el destino se hace al revés: cada capa quita su encabezado, lo usa para decidir qué hacer y le pasa el resto a la de arriba. Es como poner una carta en un sobre, ese sobre en otro sobre más grande, y este en una caja. Quien abre el último sobre no se entera de cómo viajó la caja.
Un paquete real, byte por byte
Capturamos el pedido web de la topología con tcpdump, en la interfaz eth1
de r1, junto a h1. Una captura de tráfico guarda los bytes de cada
frame tal como pasan por una interfaz, y tshark, la versión de terminal de
Wireshark, los muestra:
$ tshark -r captures/near-h1.pcap
    1   0.000000     10.1.0.2 → 10.2.0.2     TCP 74 50028 → 80 [SYN] Seq=0 Win=64240 Len=0 MSS=1460 SACK_PERM TSval=763789872 TSecr=0 WS=128
    2   0.000095     10.2.0.2 → 10.1.0.2     TCP 74 80 → 50028 [SYN, ACK] Seq=0 Ack=1 Win=65160 Len=0 MSS=1460 SACK_PERM TSval=1503310180 TSecr=763789872 WS=128
    3   0.000103     10.1.0.2 → 10.2.0.2     TCP 66 50028 → 80 [ACK] Seq=1 Ack=1 Win=64256 Len=0 TSval=763789872 TSecr=1503310180
    4   0.000168     10.1.0.2 → 10.2.0.2     HTTP 138 GET / HTTP/1.1
    5   0.000181     10.2.0.2 → 10.1.0.2     TCP 66 80 → 50028 [ACK] Seq=1 Ack=73 Win=65152 Len=0 TSval=1503310181 TSecr=763789873
    6   0.001803     10.2.0.2 → 10.1.0.2     TCP 252 HTTP/1.0 200 OK
    7   0.001812     10.1.0.2 → 10.2.0.2     TCP 66 50028 → 80 [ACK] Seq=73 Ack=187 Win=64128 Len=0 TSval=763789874 TSecr=1503310182
    8   0.002067     10.2.0.2 → 10.1.0.2     HTTP 163 HTTP/1.0 200 OK  (text/html)
    9   0.002075     10.1.0.2 → 10.2.0.2     TCP 66 50028 → 80 [ACK] Seq=73 Ack=284 Win=64128 Len=0 TSval=763789874 TSecr=1503310182
   10   0.002114     10.1.0.2 → 10.2.0.2     TCP 66 50028 → 80 [FIN, ACK] Seq=73 Ack=284 Win=64128 Len=0 TSval=763789874 TSecr=1503310182
   11   0.002971     10.2.0.2 → 10.1.0.2     TCP 66 80 → 50028 [FIN, ACK] Seq=284 Ack=74 Win=65152 Len=0 TSval=1503310183 TSecr=763789874
   12   0.002975     10.1.0.2 → 10.2.0.2     TCP 66 50028 → 80 [ACK] Seq=74 Ack=285 Win=64128 Len=0 TSval=763789875 TSecr=1503310183
¡Doce paquetes para pedir una página de 97 bytes! Los tres primeros abren la
conexión: es el handshake de TCP. Luego van el pedido, la respuesta y sus
confirmaciones, y los últimos cierran la conexión. Todo eso se estudia en la
semana 10. Por ahora, miremos el paquete 4, que lleva el GET, con -x, que
muestra sus bytes:
$ tshark -r captures/near-h1.pcap -Y http.request -x
0000  aa c1 ab b6 cc 2d aa c1 ab 1a 08 3d 08 00 45 00   .....-.....=..E.
0010  00 7c 8c ca 40 00 40 06 99 ab 0a 01 00 02 0a 02   .|..@.@.........
0020  00 02 c3 6c 00 50 88 69 7a 1a d1 e7 d6 00 80 18   ...l.P.iz.......
0030  01 f6 65 c8 00 00 01 01 08 0a 2d 86 82 31 59 9a   ..e.......-..1Y.
0040  b1 64 47 45 54 20 2f 20 48 54 54 50 2f 31 2e 31   .dGET / HTTP/1.1
0050  0d 0a 48 6f 73 74 3a 20 31 30 2e 32 2e 30 2e 32   ..Host: 10.2.0.2
0060  0d 0a 55 73 65 72 2d 41 67 65 6e 74 3a 20 63 75   ..User-Agent: cu
0070  72 6c 2f 38 2e 31 34 2e 31 0d 0a 41 63 63 65 70   rl/8.14.1..Accep
0080  74 3a 20 2a 2f 2a 0d 0a 0d 0a                     t: */*....
A la derecha se reconoce el texto del pedido. Todo lo que está antes son los encabezados. Cortémoslo en capas:
| Bytes | Capa | Hexadecimal | Significado |
|---|---|---|---|
| 0–5 | Enlace | aa c1 ab b6 cc 2d |
MAC de destino: la del siguiente salto, r1, no la de h2 |
| 6–11 | Enlace | aa c1 ab 1a 08 3d |
MAC de origen: h1 |
| 12–13 | Enlace | 08 00 |
Lo que va adentro es IPv4 |
| 14 | Red | 45 |
Versión 4; encabezado de 5 × 4 = 20 bytes |
| 16–17 | Red | 00 7c |
Largo total del datagrama: 124 bytes |
| 22 | Red | 40 |
TTL = 64 |
| 23 | Red | 06 |
Lo que va adentro es TCP |
| 26–29 | Red | 0a 01 00 02 |
IP de origen: 10.1.0.2 |
| 30–33 | Red | 0a 02 00 02 |
IP de destino: 10.2.0.2 |
| 34–35 | Transporte | c3 6c |
Puerto de origen: 50028 |
| 36–37 | Transporte | 00 50 |
Puerto de destino: 80 |
| 46 | Transporte | 80 |
Encabezado de 8 × 4 = 32 bytes |
| 66–137 | Aplicación | 47 45 54 ... |
GET / HTTP/1.1 y lo demás: 72 bytes |
Noten el patrón: cada encabezado dice qué viene adentro. Ethernet dice
“IPv4” y IP dice “TCP”. TCP dice “puerto 80”, y con ese número el sistema
operativo sabe a qué programa dárselo. Así funciona el encapsulamiento al
subir. Y noten que los números de varios bytes van con el byte más
significativo primero: es el orden de red (network byte order), y por eso
en P0 tendrán que usar htons.
La suma cierra: 14 + 20 + 32 + 72 = 138 bytes. De ellos, 66 son encabezados, casi la mitad. Para un paquete grande de 1448 bytes de datos, en cambio, son cerca del 4 %. Esa es la diferencia entre throughput y goodput de la sección anterior.
El programa layers.c hace ese mismo corte, para
cada paquete. No copia los bytes a una struct, porque una struct de C no
garantiza el formato ni el orden de bytes. Lee cada campo por su posición:
// Los campos de red van con el byte más significativo primero.
static uint32_t read_be16(const uint8_t *p) {
    return (uint32_t)p[0] << 8 | p[1];
}
Y calcula los tamaños desde los campos que acabamos de ver: (ip[0] & 0x0f) * 4 es el largo de IP, y (transport[12] >> 4) * 4 el de TCP.
$ ./layers captures/near-h1.pcap
   1 total=74    enlace=14 ip=20 tcp=40 app=0 ttl=64 10.1.0.2 > 10.2.0.2 [S]
   2 total=74    enlace=14 ip=20 tcp=40 app=0 ttl=61 10.2.0.2 > 10.1.0.2 [SA]
   3 total=66    enlace=14 ip=20 tcp=32 app=0 ttl=64 10.1.0.2 > 10.2.0.2 [A]
   4 total=138   enlace=14 ip=20 tcp=32 app=72 ttl=64 10.1.0.2 > 10.2.0.2 [PA]
   5 total=66    enlace=14 ip=20 tcp=32 app=0 ttl=61 10.2.0.2 > 10.1.0.2 [A]
   6 total=252   enlace=14 ip=20 tcp=32 app=186 ttl=61 10.2.0.2 > 10.1.0.2 [PA]
   7 total=66    enlace=14 ip=20 tcp=32 app=0 ttl=64 10.1.0.2 > 10.2.0.2 [A]
   8 total=163   enlace=14 ip=20 tcp=32 app=97 ttl=61 10.2.0.2 > 10.1.0.2 [PA]
   9 total=66    enlace=14 ip=20 tcp=32 app=0 ttl=64 10.1.0.2 > 10.2.0.2 [A]
  10 total=66    enlace=14 ip=20 tcp=32 app=0 ttl=64 10.1.0.2 > 10.2.0.2 [FA]
  11 total=66    enlace=14 ip=20 tcp=32 app=0 ttl=61 10.2.0.2 > 10.1.0.2 [FA]
  12 total=66    enlace=14 ip=20 tcp=32 app=0 ttl=64 10.1.0.2 > 10.2.0.2 [A]
Aparecen los 97 bytes de la página, en el paquete 8. Y otra cosa interesante:
los paquetes que vienen de h2 llegan con TTL 61. Salieron con 64 y cruzaron
tres routers.
Qué lee cada equipo
Un host lee todas las capas. Los equipos del medio no: solo lo que necesitan para hacer su trabajo.
     h1                 router                switch                 h2
 ┌─────────┐                                                     ┌─────────┐
 │aplicación│                                                     │aplicación│
 │transporte│                                                     │transporte│
 │   red    │       ┌─────────┐                                   │   red    │
 │  enlace  │       │   red   │         ┌─────────┐               │  enlace  │
 │  física  │       │  enlace │         │  enlace │               │  física  │
 └─────────┘        │  física │         │  física │               └─────────┘
└─────────┘ └─────────┘- Un switch llega hasta la capa de enlace. Mira la MAC de destino y decide por qué puerto sale el frame. No sabe qué es una dirección IP. Lo estudiaremos en la semana 3.
- Un router llega hasta la capa de red. Abre el frame, mira la IP de destino, busca en su tabla, resta 1 al TTL, y arma un frame nuevo para el siguiente enlace. No lee ni TCP ni HTTP.
Esto se puede comprobar. Capturamos el mismo pedido a los dos lados de los
tres routers: junto a h1 y junto a h2:
$ python3 experiments.py web
El primer paquete de h1 a h2, visto a cada lado de los tres routers

campo         junto a h1          junto a h2
eth.src       aa:c1:ab:1a:08:3d   aa:c1:ab:41:cc:1f     cambia
eth.dst       aa:c1:ab:b6:cc:2d   aa:c1:ab:91:f6:4b     cambia
ip.ttl        64                  61                    cambia
ip.src        10.1.0.2            10.1.0.2
ip.dst        10.2.0.2            10.2.0.2
ip.checksum   0x99ed              0x9ced                cambia
tcp.seq_raw   2288613913          2288613913
tcp.len       0                   0

Capturas en captures/; ábranlas en Wireshark o con ./layers
Leamos qué cambió y qué no:
- Las direcciones MAC cambian por completo. Tiene sentido: cada enlace tiene su propio frame, con las MAC de los dos vecinos de ese enlace. Las MAC valen un salto.
- Las direcciones IP no cambian. Identifican a los extremos, de principio a fin. (Hay una excepción famosa, NAT, en la semana 4.)
- El TTL baja en 3, uno por router.
- El checksum de IP cambia. Debe hacerlo: protege al encabezado, y el TTL
cambió. Y sube justo en
0x0300, porque el TTL está en el byte alto de su palabra de 16 bits, y se le restaron 3. Cada router lo actualiza. - TCP no cambia. El número de secuencia es el mismo: ningún router lo tocó. TCP e IP son protocolos distintos.
Idea clave. Las capas no son solo una forma de explicar: se ven en los bytes. El mensaje de un extremo llega intacto al otro, los encabezados de red se ajustan en cada salto, y los de enlace se reemplazan. Esto contesta qué lee un router y qué lee un switch.
En la práctica. Muchos equipos reales sí miran más arriba de su capa. Un firewall y un NAT leen puertos, y un load balancer de capa 7 lee HTTP. Se llaman middleboxes, y rompen la limpieza del modelo. También son la razón por la que es tan difícil desplegar un protocolo de transporte nuevo en Internet, como veremos con QUIC.
Lo que verán en su captura
En el laboratorio van a capturar con -i any dentro del contenedor, y eso se
ve algo distinto. Esta captura se hizo pidiéndole http://example.com al
mundo real, desde el contenedor del curso en Docker Desktop sobre macOS:
$ tcpdump -i any -c 40 -w /tmp/web.pcap host example.com &
$ curl -s -o /dev/null -w '%{http_code} %{remote_ip}\n' http://example.com
200 104.20.23.154
$ tshark -r /tmp/web.pcap
    1   0.000000 192.168.65.3 → 104.20.23.154 TCP 80 56462 → 80 [SYN] Seq=0 Win=65495 Len=0 MSS=65495 SACK_PERM TSval=3301887626 TSecr=0 WS=128
    2   0.056315 104.20.23.154 → 192.168.65.3 TCP 80 80 → 56462 [SYN, ACK] Seq=0 Ack=1 Win=65408 Len=0 MSS=65495 SACK_PERM TSval=2734159769 TSecr=3301887626 WS=128
    3   0.056344 192.168.65.3 → 104.20.23.154 TCP 72 56462 → 80 [ACK] Seq=1 Ack=1 Win=65536 Len=0 TSval=3301887683 TSecr=2734159769
    4   0.056402 192.168.65.3 → 104.20.23.154 HTTP 147 GET / HTTP/1.1
    5   0.056508 104.20.23.154 → 192.168.65.3 TCP 72 80 → 56462 [ACK] Seq=1 Ack=76 Win=65280 Len=0 TSval=2734159769 TSecr=3301887683
    6   0.115925 104.20.23.154 → 192.168.65.3 HTTP 1008 HTTP/1.1 200 OK  (text/html)
(Se muestran las primeras líneas, de un total de 11.) Y con el programa de esta semana:
$ ./layers /tmp/web.pcap
   1 total=80    enlace=20 ip=20 tcp=40 app=0 ttl=64 192.168.65.3 > 104.20.23.154 [S]
   2 total=80    enlace=20 ip=20 tcp=40 app=0 ttl=64 104.20.23.154 > 192.168.65.3 [SA]
   3 total=72    enlace=20 ip=20 tcp=32 app=0 ttl=64 192.168.65.3 > 104.20.23.154 [A]
   4 total=147   enlace=20 ip=20 tcp=32 app=75 ttl=64 192.168.65.3 > 104.20.23.154 [PA]
Hay tres cosas que no se ven así en una red común, y conviene saber por qué:
El encabezado de enlace tiene 20 bytes, y no es Ethernet. Con -i any,
tcpdump escucha en todas las interfaces a la vez, y no todas son Ethernet.
Por eso el kernel entrega un pseudo-encabezado, Linux cooked capture, que
Wireshark muestra como Linux cooked capture v2 o SLL2. Ese encabezado
nunca viajó por ningún cable: lo inventa el sistema al capturar. Por eso no
hay direcciones MAC de destino.
La red de Docker Desktop no es la red de Internet. El servidor parece
estar a TTL 64 y anuncia MSS=65495, igual que el contenedor. Y el ACK del
paquete 5 llega a los 0,1 ms del GET, mientras que la respuesta tarda 60 ms.
Ese comportamiento indica que el otro extremo de esta conexión TCP es Docker
Desktop, que después abre otra conexión hacia el servidor real. Por eso aquí
se pueden estudiar las capas, pero no el camino, y por eso traceroute sale
vacío. En Linux nativo o en WSL2 pueden ver algo distinto.
Hay frames más grandes que 1500 bytes. Como la interfaz de este contenedor
tiene una MTU de 65 535 bytes, una respuesta grande puede aparecer en un solo
paquete de varios KB: en una corrida con HTTPS vimos un frame de 5151 bytes.
Además, las interfaces modernas juntan o parten segmentos en el sistema
operativo, antes de que tcpdump los vea. Lo que se captura no siempre es
lo que pasa por el cable. En la topología de esta semana fijamos la MTU en
1500, para que se parezca a una red real.
Error común. Olvidar lo que comparte el contenedor. El contenedor del curso corre con
--network host, es decir, en la red de la máquina donde corre Docker, y-i anyve también el tráfico de otros contenedores. Con el filtroport 80 or port 443y otros contenedores descargando datos, una de nuestras capturas llegó a 428 MB en 8 segundos. Si les pasa, filtren por destino, como arriba, conhost example.com, y en Wireshark, conip.addr == ....
Laboratorio de la semana
El laboratorio prepara el entorno y usa las herramientas del capítulo. Las actividades de captura se basan en los laboratorios de Wireshark de Kurose y Ross.
1. Entorno. Instalen Docker y Wireshark siguiendo
labs/README.md. Desde la carpeta del curso, levanten el
contenedor con env/run.sh y corran la comprobación. Todas las líneas deben
decir ok:
$ env/smoke/check.sh
ok    compilador de C
ok    Containerlab levanta la red
ok    OSPF converge
ok    ping de router a router
ok    tc netem
ok    iperf3
ok    nftables
ok    WireGuard
Control de congestión disponible: reno cubic
2 y 3. traceroute real. En la terminal de su computadora, fuera del
contenedor, corran traceroute, o tracert en Windows, hacia un sitio del
Perú y hacia otro de otro continente. Comparen cuántos saltos hay y en qué
salto aparece el mayor aumento del RTT, y traten de ubicar un cable submarino.
Usen lo que aprendieron: si el aumento se mantiene en los saltos siguientes,
es real, y un cálculo de d/s les dice si es razonable. Si el sitio resulta
estar en una CDN, busquen otro: el de una universidad suele servir.
4. Captura. Dentro del contenedor, capturen una petición web y ábranla en Wireshark:
tcpdump -i any -w web.pcap port 80 or port 443 &
sleep 1
curl -s -o /dev/null http://example.com
sleep 2      # tcpdump entrega lo capturado por tandas; sin esta espera, el archivo queda vacío
kill %1
5. Las capas. En Wireshark, tomen un paquete del pedido y expandan sus
capas, que aquí serán Linux cooked capture v2, IP, TCP y HTTP. Anoten el
tamaño de cada encabezado, y comprueben la suma contra el tamaño del frame.
Pueden comparar con ./layers web.pcap.
6. Cálculo a mano. Calculen el retardo de transmisión de un paquete de
1500 bytes en un enlace de 100 Mbps y compárenlo con el de propagación entre
Lima y Miami. Verifiquen con ./delay 1500 100 4200.
7. P0. Lean el enunciado de P0.
Empiecen a pensar en traza, su traceroute propio: ya saben cómo funciona.
Para seguir. Todas las mediciones del capítulo se pueden repetir. Con esta
secuencia pueden cambiar los parámetros de experiments.py y ver qué pasa:
cd code/week-01
make            # compila los programas
make up         # levanta la topología
python3 experiments.py cable       # también: size, bottleneck, queue, web
make down       # destruye la topología y su red
make test compila, levanta la topología, comprueba las afirmaciones de este
capítulo y destruye todo, aunque algo falle. Tarda un par de minutos. Sus
márgenes son amplios porque una laptop no es un laboratorio de medición:
revisan tendencias, no cifras. Pasa así:
$ make test
...
Ran 43 tests in 119.168s

OK
Resumen
- Internet se puede describir por sus piezas (hosts, enlaces, routers y switches, ISPs) o por su servicio: una infraestructura best effort a la que las aplicaciones acceden por la API de sockets.
- Un protocolo define el formato y el orden de los mensajes, y las acciones que se toman.
- Las redes de acceso conectan los hosts al primer router. Muchas son de medio compartido. Velocidad de transmisión y velocidad de propagación son números distintos.
- La conmutación de paquetes no reserva nada: cada paquete usa toda la capacidad cuando le toca, y hay colas y pérdida. La conmutación de circuitos reserva capacidad, con FDM o TDM. Con store-and-forward, N enlaces iguales cuestan N · L/R.
- La multiplexación estadística permite más usuarios cuando el tráfico llega a ráfagas: en un enlace de 1 Gbps caben 10 circuitos de 100 Mbps, y con paquetes, 40 usuarios activos un 10 % del tiempo superan el límite solo el 0,15 % del tiempo, si son independientes.
- Internet es una red de redes: ISP de acceso, regionales y de tránsito, IXP y redes de contenido. El cliente le paga al proveedor, y los contratos influyen en los caminos.
- El retardo nodal es procesamiento + cola + transmisión (L/R) + propagación (d/s). Transmisión depende de tamaño y velocidad; propagación, de la distancia.
- La intensidad de tráfico ρ = La/R gobierna la cola. Con ρ > 1 crece sin límite, y sobra una fracción 1 − 1/ρ. Cerca de 1, el retardo se dispara. Con ráfagas, hay cola incluso con ρ bajo.
tracerouteusa el TTL e ICMP para revelar el camino. Un aumento de RTT que persiste es real, y uno que desaparece es un router lento para contestar.- El throughput de un camino lo limita su cuello de botella: min(R₁, …, Rₙ). Para mensajes chicos domina el RTT, y para grandes, el throughput.
- Las capas (aplicación, transporte, red, enlace, física) dividen responsabilidades, y el encapsulamiento agrega un encabezado por capa. OSI, con siete capas, sobrevive como vocabulario.
- Un switch lee hasta enlace y un router hasta red. En cada salto, las MAC se reemplazan, el TTL baja, y las IP, TCP y la aplicación no cambian.
Ejercicios
-
Unidades. Un plan de Internet anuncia 300 Mbps. ¿Cuántos segundos tarda como mínimo un archivo de 1,5 GB? Una aplicación informa una descarga a 18 MB/s. ¿Es mucho o poco para ese plan? ¿Qué parte de la capacidad está usando?
-
Transmisión y propagación. Un paquete de 1000 bytes cruza un enlace de 10 Mbps de 2000 km, con una velocidad de propagación de 2×10⁸ m/s. Calculen los retardos de transmisión y de propagación. ¿Cuál domina? ¿A partir de qué velocidad del enlace la propagación es mil veces mayor? Comprueben con
./delay. -
Protocolo a mano. Con la topología arriba y
python3 experiments.py webya corrido, para queh2tenga el servidor, usenncdesdeh1para pedir/index.htmlconHEADen vez deGET. ¿En qué se diferencia la respuesta? ¿Qué pasa si mandan un pedido sin la línea en blanco final? Expliquen ambos resultados en términos de formato, orden y acciones. -
Store-and-forward. Se envía un mensaje de 10 Mbit por 4 enlaces de 20 Mbps, sin nadie más en la red, ignorando la propagación y los encabezados. Calculen el tiempo total si se envía (a) como un solo paquete y (b) en paquetes de 10 000 bits. Luego escriban la fórmula general con M bits, N enlaces, tamaño de paquete L y velocidad R. ¿Qué le pasa al tiempo si L se hace muy pequeño, cuando cada paquete además lleva un encabezado de 40 bytes?
-
Circuitos contra paquetes. Un enlace de 1 Gbps se reparte con TDM en 20 slots. Establecer un circuito toma 300 ms. ¿Cuánto tarda en enviarse un archivo de 100 MB? ¿Cuánto tarda con conmutación de paquetes si el enlace está libre? ¿Y si hay otros 19 usuarios enviando todo el tiempo y se reparten el enlace en partes iguales? Expliquen cuándo es peor cada alternativa.
-
Multiplexación. Con 3 usuarios, cada uno activo con probabilidad p = 0,2, y un enlace que solo atiende a uno a la vez, calculen a mano P(X > 1). Luego usen
./multiplexcon un enlace de 1 Gbps, usuarios de 100 Mbps y p = 0,1, y encuentren el mayor N para el que P(X > 10) sigue por debajo de 1 %. ¿Qué pasa con ese N si p sube a 0,2? ¿Por qué la independencia es la suposición más peligrosa de este cálculo? -
Cola. A un enlace de 10 Mbps llegan al azar 800 paquetes por segundo de 1250 bytes. Calculen ρ. Con la fórmula de la cola M/D/1, calculen la espera media en milisegundos, y comprueben con
./queue_sim. ¿Qué pasa si los paquetes llegan al doble de tasa y el buffer es de 50 paquetes? Calculen, antes de correrlo, la pérdida y el retardo máximo. -
Predecir antes de medir. Modifiquen en
experiments.pyel caso desizepara usar un enlace de 2 Mbps y escriban antes cuánto debe valer la subida de RTT de 64 a 1472 bytes. Midan. Hagan lo mismo para un buffer de 100 paquetes enqueue: ¿qué RTT y qué pérdida esperan con ρ = 1,5? ¿Se acerca lo medido? Si no, ¿qué parte explica el instrumento? -
Leer un
traceroute. Esta traza salió de la misma conexión del capítulo; se muestran los saltos 6 a 13. Expliquen: (a) por qué es poco probable que el aumento del salto 6 al 7 sea un solo enlace físico; (b) cuál es el RTT mínimo teórico de Lima a Tokio, con una distancia en línea recta de 15 500 km; (c) cómo interpretarían que el salto 11 no responda pero el 13 sí.traceroute to www.u-tokyo.ac.jp (210.152.243.234), 22 hops max, 40 byte packets 6 8.243.120.5 6.662 ms 13.521 ms 5.667 ms 7 4.69.215.94 260.937 ms 260.187 ms 260.647 ms 8 8.245.34.46 258.649 ms 260.845 ms 260.248 ms 9 163.139.136.69 258.888 ms 261.575 ms 163.139.136.67 260.303 ms 10 202.79.80.158 261.154 ms 262.355 ms 260.365 ms 11 * * * 12 * * * 13 158.205.121.23 270.427 ms 158.205.121.24 270.553 ms 269.364 ms -
Cuello de botella. Un camino tiene enlaces de 1 Gbps, 50 Mbps y 200 Mbps. ¿Cuál es el throughput máximo? ¿Cuánto tarda un archivo de 1 GB? Si mejoran el enlace de 50 Mbps a 500 Mbps, ¿cuánto tarda ahora? ¿Cuánto se gana si, en cambio, el enlace de 1 Gbps sube a 10 Gbps? Si el enlace de 200 Mbps pasa a compartirse entre 5 flujos iguales, ¿dónde queda el cuello de botella?
-
Encabezados. Para una aplicación que envía por TCP sobre IPv4 y Ethernet, con las opciones de timestamps de TCP, como en la captura: (a) ¿qué fracción del frame son datos, si cada mensaje lleva 1448 bytes? ¿Y si lleva 10 bytes? (b) Una aplicación de voz manda 50 paquetes por segundo de 160 bytes de audio, por UDP con 12 bytes más de otro encabezado. ¿Qué velocidad consume en el enlace, y qué parte de ella es audio?
-
Dentro del paquete. ¿Qué encabezados debe leer un router para hacer su trabajo? ¿Y un switch? Luego, con la topología arriba: (a) capturen en
r2, y comprueben con./layersque el TTL de los paquetes deh1es 62 eneth2. (b) Agreguen alayers.cuna opción que imprima los puertos de TCP y de UDP. Agreguen una prueba atest_programs.py, usando el paquete sintéticobuild_ipv4_tcp. (c) Expliquen, sin mirar el código de TCP, por qué untraceroutepuede mostrar un RTT más alto en un salto intermedio que en uno posterior.