
Apuntes · Capítulo 2Fundamentos
Principios de diseño y sockets
Principios de diseño y sockets
La semana pasada vimos de qué está hecha Internet: bordes, núcleo, enlaces, colas y capas.
Medimos retardos y seguimos paquetes con traceroute. Falta contestar dos preguntas que van
juntas. La primera es por qué Internet tiene esta forma, con un núcleo que promete tan poco y
unos extremos que hacen casi todo el trabajo. La segunda es práctica: si los extremos hacen el
trabajo, y ustedes escriben programas para los extremos, ¿cómo le habla un programa a la red?
Este capítulo tiene dos partes. En la Sesión A estudiamos los principios de diseño: el servicio best effort de IP, el argumento end-to-end, el modelo de reloj de arena y la idea de fate sharing. Cada principio se prueba con un experimento: dañamos un archivo en un intermediario, y luego matamos un router a la mitad de una conexión. También vemos la historia que llevó a estos principios y a las alternativas que perdieron: ATM y Frame Relay. Cerramos con quién define Internet y cómo se lee un RFC.
En la Sesión B escribimos programas en C con la API de sockets: un servidor y un cliente con
TCP, otro par con UDP, y un servidor que atiende a varios clientes a la vez con poll. Dos
errores se llevan buena parte del tiempo, porque son los que más se cometen en la práctica:
creer que un recv devuelve un mensaje completo y no revisar lo que devuelve send.
Los dos temas se conectan. TCP entrega un stream de bytes sin fronteras, UDP no avisa si algo se perdió y su programa tiene que defender cada caso porque el núcleo de la red no lo hará por ustedes. Eso que en la Sesión B parece una molestia es la decisión de diseño de la Sesión A vista desde el teclado.
Ruta de lectura.
Antes de clase (obligatorio, unos 15 a 20 minutos). Sesión A: Lo que IP promete: best effort sin el experimento, la introducción de El principio end-to-end con El caso: una transferencia cuidadosa de un archivo, y El modelo de reloj de arena. Sesión B: Procesos, puertos y sockets y El orden de los bytes.
En clase. Sesión A: Verlo con un experimento, El gateway de MIT, Cuándo sí conviene una ayuda en la red, Fate sharing: dónde vive el estado, ATM y Frame Relay: las alternativas que perdieron y Quién define Internet: la IETF y los RFC. Sesión B: Un servidor y un cliente con TCP, Error común:
recvno devuelve un mensaje, Error común:sendtambién escribe menos, UDP: datagramas, sin conexión y Atender a varios clientes.Después de clase. Repasen con el Resumen y los Ejercicios, y preparen el Laboratorio: un cliente y un servidor en C. Opcional: De ARPANET a la Web, Un solo hilo con
pollySO_REUSEADDRyAddress already in use. Para profundizar, las lecturas del libro y las gratuitas de la semana:Sesión A: Kurose y Ross, secciones 1.7 History of Computer Networking and the Internet y 4.5 Architectural Principles of the Internet; CS168, Network Architecture; Saltzer, Reed y Clark, End-to-End Arguments in System Design, secciones 1 y 2 (Introduction y End-to-end caretaking). Sesión B: Kurose y Ross, secciones 2.1 Principles of Network Applications y 2.6.1–2.6.2 Socket Programming with UDP and TCP; Beej, Guide to Network Programming, secciones What is a Socket?, IP Addresses, structs, and Data Munging, System Calls or Bust y Client-Server Background. El código del capítulo está en
code/week-02y se prueba conmake testdentro del contenedor del curso (env/run.sh).
Lo que IP promete: best effort
Empecemos por el contrato. Cuando un host le entrega un paquete a IP, ¿qué le garantiza la red?
Definición. Un servicio best effort es aquel en el que la red hace lo posible: intenta llevar cada datagrama a su destino, sin ninguna garantía sobre si llega, cuándo llega, en qué orden llega respecto de los demás o cuántas copias llegan.
IP no promete nada de lo siguiente, y cada punto ocurre en redes reales:
| Lo que puede pasar | Por qué pasa |
|---|---|
| Un paquete se pierde | Una cola se llenó, un enlace cayó o un router lo descartó |
| Un paquete tarda mucho | Encontró colas largas; el retardo no tiene un máximo |
| Dos paquetes llegan al revés | Tomaron caminos distintos, o un balanceo los separó |
| Un paquete llega dos veces | Una capa de abajo lo retransmitió porque se perdió la confirmación |
| Un paquete llega con bits cambiados | IPv4 revisa solo su cabecera, no los datos que lleva |
Suena a una mala oferta. ¿Quién compraría un servicio así? La respuesta es que este contrato tan pequeño tiene dos virtudes enormes.
Es fácil de cumplir. Casi cualquier tecnología de enlace puede transportar datagramas sin garantías: Ethernet, Wi-Fi, fibra, un enlace satelital, una red celular. IP no le pide a ninguna de ellas que tenga circuitos, entrega confiable ni reserva de ancho de banda. Por eso Internet pudo crecer uniendo redes que no se parecían entre sí, administradas por gente que no se conocía.
No decide por las aplicaciones. Una llamada de voz prefiere perder un paquete a recibirlo tarde. Una transferencia de archivos prefiere esperar a perder un byte. Un videojuego solo quiere la posición más reciente. Si la red impusiera un único comportamiento, sería el correcto para algunas aplicaciones e inadecuado para otras. La red no sabe qué quiere cada aplicación y no intenta adivinarlo.
La comparación clásica es con la red telefónica, que hace lo contrario: un núcleo muy elaborado, con circuitos y calidad garantizada, y un teléfono muy simple en el borde. Esa red hace excelentemente una cosa. Agregarle un servicio nuevo requería cambiar el núcleo, es decir, convencer a la empresa telefónica. En Internet, para crear una aplicación nueva basta con instalar un programa en dos computadoras. Nadie le pidió permiso a ningún operador para inventar la Web, ni el correo electrónico, ni las videollamadas.
Idea clave. Una red simple permitió crear aplicaciones que nadie había previsto, porque crear una no requería cambiar la red. La inteligencia está en los extremos, y los extremos son de ustedes.
Verlo con un experimento
Vamos a comprobar ese contrato. La topología de la semana,
fate.clab.yml, une dos hosts con dos caminos. El camino por
r2 es el preferido; el camino por r3 tiene un costo mayor y queda de reserva:
                    10.2.12.0/24   r2   10.2.24.0/24
                   +--------------(  )--------------+
 h1 ----------- r1 |                                | r4 ----------- h2
 10.2.1.10         +--------------(  )--------------+         10.2.4.10
                    10.2.13.0/24   r3   10.2.34.0/24
Los routers aprenden las rutas con OSPF, un protocolo que estudiaremos en la semana 5. Por ahora
es una caja negra que llena las tablas. Levantamos la topología desde code/week-02/:
$ make deploy
$ docker exec clab-w02-fate-h1 traceroute -n -q 1 10.2.4.10
traceroute to 10.2.4.10 (10.2.4.10), 30 hops max, 46 byte packets
 1  10.2.1.1  0.003 ms
 2  10.2.12.2  0.002 ms
 3  10.2.24.4  0.001 ms
 4  10.2.4.10  0.003 ms
OSPF necesita algunos segundos para converger, así que si recién levantaron la red, el camino
puede salir por r3 o no salir. Ahora empeoramos el enlace entre r1 y r2: con tc netem,
agregamos un retardo variable (5 ms, con 3 ms de variación) y 10 % de pérdida en la salida
eth2 de r1. Es una configuración de laboratorio; imita un enlace malo.
$ docker exec clab-w02-fate-r1 tc qdisc add dev eth2 root netem delay 5ms 3ms loss 10%El programa seq_send.c envía datagramas UDP numerados, y
seq_recv.c cuenta lo que llega. UDP es una capa muy delgada
sobre IP, así que lo que vemos es prácticamente el servicio de IP tal cual:
$ docker exec clab-w02-fate-h2 /lab/seq_recv 9001 1000 1500      # en una terminal
$ docker exec clab-w02-fate-h1 /lab/seq_send 10.2.4.10 9001 1000 200 1000      # en otra
enviados: 1000 datagramas de 200 bytes
escuchando en el puerto 9001
recibidos: 903 de 1000
perdidos: 97
fuera de orden: 210
repetidos: 0
tamaño de cada recv: 200 bytes, 0 distintosSe perdió alrededor del 10 % que configuramos (cada corrida da un número algo distinto: 97, 109
y 106 en tres corridas seguidas), y unos 200 datagramas llegaron después de otro con un número
mayor. El retardo variable los desordenó. La red hizo su mejor esfuerzo y nadie le avisó a
nadie: ni seq_send se enteró ni seq_recv recibió un error.
Sobre ese mismo enlace malo, enviamos 102 400 bytes por TCP con
chunk_send.c. El receptor,
chunk_recv.c, comprueba cada byte contra un patrón conocido:
$ docker exec clab-w02-fate-h1 /lab/chunk_send 10.2.4.10 9002 102400 1
enviados: 1 llamadas a send, 102400 bytes
escuchando en el puerto 9002
recv: 22 llamadas, 102400 bytes, menor 1040, mayor 20272
bytes fuera de lugar: 0Llegó todo y en orden. La red es la misma y pierde lo mismo. La diferencia es que TCP, que corre solo en los dos hosts, retransmite y reordena. Ningún router de ese camino sabe qué es una retransmisión de TCP. Con esto ya vemos el reparto: abajo, una red que no promete; arriba, en los extremos, los programas que construyen las garantías. Veamos por qué conviene repartirlo así.
$ docker exec clab-w02-fate-r1 tc qdisc del dev eth2 rootEl principio end-to-end
El artículo de Saltzer, Reed y Clark es de 1981, y su versión revisada, de 1984. Es uno de los textos más citados de redes y se lee en una tarde. Su pregunta es general: dada una función, como la entrega confiable, ¿en qué nivel del sistema conviene ponerla? Su respuesta, en sus palabras:
“The function in question can completely and correctly be implemented only with the knowledge and help of the application standing at the end points of the communication system. Therefore, providing that questioned function as a feature of the communication system itself is not possible. (Sometimes an incomplete version of the function provided by the communication system may be useful as a performance enhancement.)”
Definición. El argumento end-to-end dice que una función que solo se puede hacer completa y correctamente con el conocimiento de la aplicación en los extremos no se puede ofrecer como una función de la red. La red puede dar una versión incompleta, pero solo como una mejora de desempeño, nunca como requisito para que el resultado sea correcto.
La frase tiene tres partes, y las tres importan. Veámoslas con el ejemplo del artículo.
El caso: una transferencia cuidadosa de un archivo
Queremos copiar un archivo del disco de la computadora A al disco de la computadora B, sin daños. Hagamos la lista de lo que puede fallar:
- El disco de A devuelve datos incorrectos.
- Un programa tiene un error al copiar datos a un buffer: el sistema de archivos, la aplicación o la pila de red, en A o en B.
- El procesador o la memoria tienen una falla transitoria mientras copian.
- La red pierde, cambia o duplica un paquete.
- Uno de los hosts se cae a la mitad, y no se sabe cuánto alcanzó a hacer.
Supongamos que construimos una red perfecta, con checksums y retransmisiones en cada salto, que elimina la amenaza 4 por completo. ¿Puede la aplicación dejar de preocuparse? No: las otras cuatro siguen ahí, y están fuera de la red. Para defenderse de ellas, la aplicación tiene que hacer una comprobación de extremo a extremo: cuando B termina de escribir, lee el archivo de su disco, calcula un checksum y lo compara con el de A. Si no coinciden, repite la transferencia.
Y aquí está el centro del argumento: esa comprobación también cubre la amenaza 4. Si la aplicación igual tiene que hacerla, el esfuerzo de la red por ser perfecta no agrega corrección. Lo único que puede cambiar es cuántas veces hay que reintentar. Por eso es un asunto de desempeño.
El gateway de MIT
El artículo cuenta un caso real, que merece su propio apartado. Una red de MIT, con varias redes locales unidas por gateways, usaba un checksum de paquete en cada salto. Los programadores confiaron en que la red era segura. Pero los datos no estaban protegidos mientras estaban guardados en cada gateway, y uno de ellos desarrolló una falla: al copiar de un buffer de entrada a uno de salida, intercambiaba un par de bytes, alrededor de una vez por millón de bytes. Durante un tiempo, pasaron por ese gateway muchos archivos fuente de un sistema operativo y algunos se dañaron. Sus dueños tuvieron que compararlos a mano con listados antiguos.
Podemos reproducirlo. flaky_relay.c es un intermediario que
recibe por una conexión TCP, copia a otra e intercambia un par de bytes cada cierta cantidad de
bytes:
        // Aquí los datos no están protegidos por ningún checksum de TCP.
        for (ssize_t i = 0; every > 0 && i + 1 < n; i++) {
            if (--countdown == 0) {
                char tmp = buf[i];
                buf[i] = buf[i + 1];
                buf[i + 1] = tmp;
                countdown = every;
                damaged++;
            }
        }
Pasamos por él un archivo de 3 MB con una falla por millón de bytes. Corremos un receptor con
nc en el puerto 9211, el intermediario en el 9210, y enviamos:
$ head -c 3000000 /dev/urandom > /tmp/original.bin
$ nc -l 9211 > /tmp/copia.bin &
$ build/flaky_relay 9210 127.0.0.1 9211 1000000 &
escuchando en el puerto 9210
$ nc -N 127.0.0.1 9210 < /tmp/original.bin
copiados 3000000 bytes, 2 pares intercambiados
$ sha256sum /tmp/original.bin /tmp/copia.bin
7cf1fd53c59dd66e65eb4aa9acb5eadfc6feae65cf56244108d79d8a0d8e1b94  /tmp/original.bin
7c40dbb326e3aa7e4a0b1e2ba754d529706f15dd1a870fa97b18fc695959d774  /tmp/copia.bin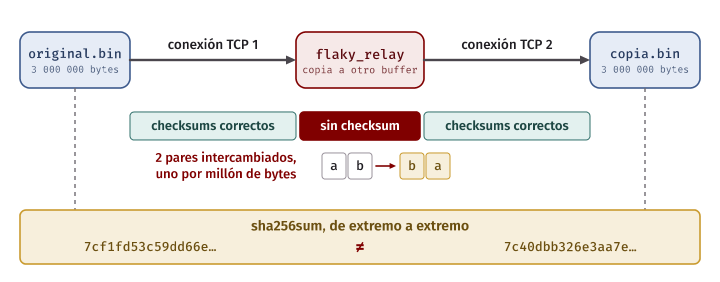
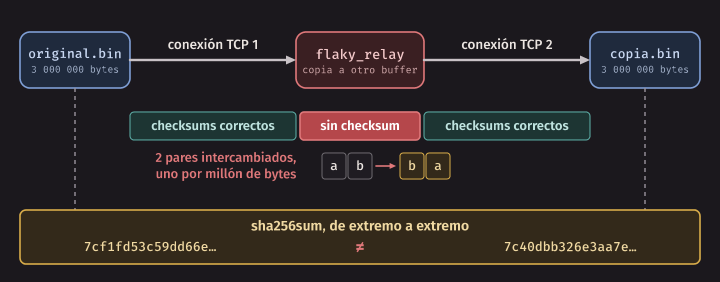
Noten lo que pasó. TCP no reportó ningún error: las dos conexiones terminaron bien, con todos
sus checksums correctos y sus 3 000 000 bytes en orden. Y sin embargo el archivo está dañado.
Cada conexión protegió los datos mientras estaban dentro de ella; el daño ocurrió entre las
dos, donde ningún checksum miraba. La comprobación de sha256sum, de un extremo a otro, sí lo
detectó. Si el intermediario no daña nada (último argumento en 0), los dos hash coinciden:
$ nc -l 9211 > /tmp/copia.bin &
$ build/flaky_relay 9210 127.0.0.1 9211 0 &
escuchando en el puerto 9210
$ nc -N 127.0.0.1 9210 < /tmp/original.bin
copiados 3000000 bytes, 0 pares intercambiados
$ sha256sum /tmp/original.bin /tmp/copia.bin
7cf1fd53c59dd66e65eb4aa9acb5eadfc6feae65cf56244108d79d8a0d8e1b94  /tmp/original.bin
7cf1fd53c59dd66e65eb4aa9acb5eadfc6feae65cf56244108d79d8a0d8e1b94  /tmp/copia.bin
Error común. “Uso TCP, así que mis datos llegan intactos”. TCP protege los bytes entre sus dos extremos contra errores que su checksum, de 16 bits, llega a detectar. No protege un archivo de un disco a otro, ni lo que un proxy o un balanceador hagan en el medio. Si los datos importan, la aplicación agrega su propia comprobación.
En la práctica. Por eso los sitios de descarga publican un SHA-256 junto a cada archivo, los gestores de paquetes verifican firmas,
gitidentifica cada objeto por su hash y las bases de datos ponen un checksum en cada página de disco. No desconfían de TCP: saben que TCP es solo un tramo del camino.
Cuándo sí conviene una ayuda en la red
Sería un error concluir que la red no debe hacer nada. El propio artículo lo aclara: la ayuda en la red es una decisión de ingeniería por desempeño. Hagamos la cuenta que justifica esa frase.
Un archivo ocupa N paquetes y cada paquete se pierde con probabilidad p, de forma independiente. Si solo los extremos pueden reintentar, y lo hacen con el archivo completo, la probabilidad de que un intento salga bien es (1 − p) elevado a N, y el número esperado de intentos es su inverso. Con N = 1000 y p = 0,01:
probabilidad de éxito por intento = 0,99 ^ 1000 ≈ 0,000043
intentos esperados                = 1 / 0,000043 ≈ 23 000
El tiempo de transferencia crece de forma exponencial con el tamaño del archivo. Hay dos arreglos, y el argumento end-to-end no elige entre ellos:
- Reintentar por pedazos desde los extremos. Es lo que hace TCP: retransmite solo lo que falta, y el costo vuelve a ser razonable. Sigue siendo una función de los extremos.
- Mejorar el enlace que falla. Wi-Fi retransmite cada frame en el propio enlace, porque un enlace de radio puede perder mucho más que uno de cobre y corregirlo ahí es más rápido: el frame vuelve a salir en milisegundos, sin esperar un RTT completo por todo el camino.
Con Wi-Fi, TCP se sigue encargando de la corrección. El enlace solo hace que TCP tenga que intervenir menos. Si el enlace fallara, nada se rompería: solo iría más lento. Eso es exactamente “una versión incompleta como mejora de desempeño”. El artículo agrega dos advertencias sobre poner una función abajo: todas las aplicaciones la pagan, aunque no la necesiten, y el nivel de abajo tiene menos información para hacerla bien. Una llamada de voz sobre un enlace que retransmite demasiado recibe sus datos tarde, cuando ya no le sirven.
El argumento se aplica a más cosas que la confiabilidad:
| Función | ¿Por qué tiene que estar en los extremos? | Ayuda posible en la red |
|---|---|---|
| Entrega confiable | Solo el extremo sabe si los datos llegaron bien a su destino final | Retransmisión en un enlace malo |
| Cifrado | Si la red cifra, la red ve los datos y hay que confiar en ella | Cifrado de enlace (WPA en Wi-Fi), contra quien escucha en ese tramo |
| Eliminar duplicados | Un extremo también duplica, si reintenta tras una caída | Ninguna necesaria |
| Confirmar la entrega | Que un paquete llegó al host no significa que la aplicación lo procesó | Ninguna necesaria |
La última fila sorprende a muchos. Un ACK de TCP dice que el kernel de B recibió los bytes. No dice que el programa los haya leído, ni que el pago se haya registrado, ni que el disco los haya guardado. Si la aplicación necesita saberlo, la propia aplicación tiene que confirmarlo.
Idea clave. Es un argumento, no un teorema: no prohíbe nada. Pide hacerse una pregunta antes de poner una función en la red: ¿de todas formas la tendrán que hacer los extremos? Si es así, lo que se ponga abajo solo se justifica por desempeño, y hay que medir si vale lo que cuesta.
El modelo de reloj de arena
Sigamos con la forma de la pila de protocolos. La semana pasada la dibujamos como una torre de capas. Si en cada capa anotamos los protocolos que existen, sale otra figura:
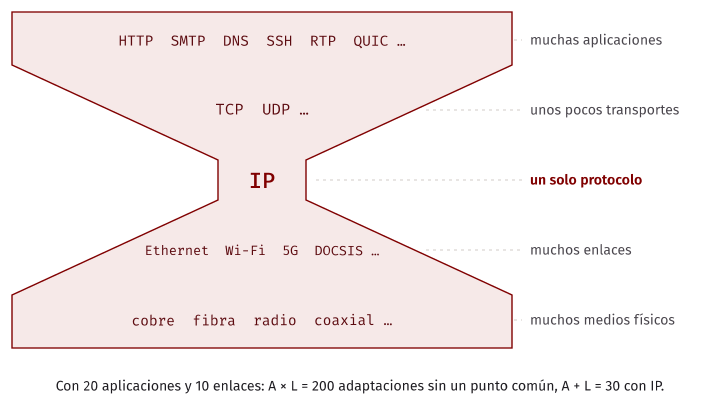
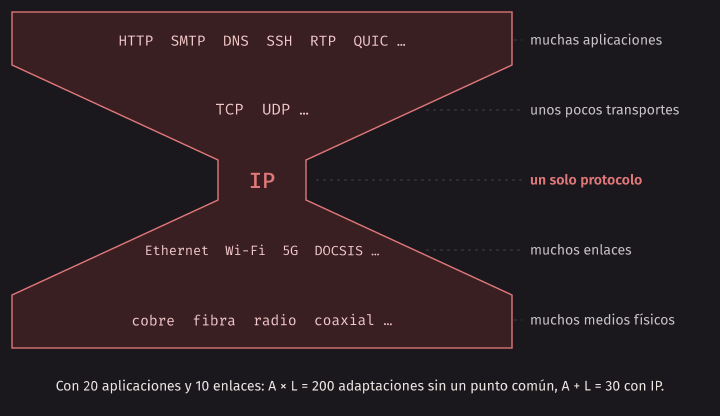
Muchas opciones arriba, muchas abajo y un solo protocolo en el centro. Es un reloj de arena, y su parte central, la más angosta, se llama narrow waist: la cintura del reloj. Todo el que quiera estar en Internet tiene que hablar IP. Todo lo demás es opcional.
¿Por qué esa forma es tan útil? Por una cuenta simple. Con A aplicaciones y L tecnologías de enlace, sin un punto en común, cada aplicación tendría que saber usar cada enlace: A × L adaptaciones. Con una capa común, cada aplicación se escribe una vez contra IP, y cada enlace se adapta una vez a IP: A + L. Con 20 aplicaciones y 10 enlaces, son 200 contra 30. Y cuando alguien inventa un enlace nuevo, todas las aplicaciones existentes funcionan sobre él el mismo día, sin cambiar una línea.
El ejemplo extremo es RFC 1149, una broma del 1 de abril que define IP sobre palomas mensajeras. Es una broma, pero está bien razonada: si un medio lleva un datagrama de A a B, por malo que sea, IP puede funcionar sobre él. Eso es lo que le pide IP a un enlace.
El precio se paga en el centro. Como todos dependen de la cintura, cambiarla es carísimo. IPv6 se publicó en los años noventa (RFC 8200 es su versión actual), y la transición sigue en curso. Mientras tanto, arriba y abajo de IP se han reemplazado casi todas las tecnologías más de una vez. Lo mismo está pasando con la segunda capa más angosta: desplegar un transporte nuevo es tan difícil, porque los middleboxes del camino solo dejan pasar TCP y UDP, que QUIC se construyó sobre UDP. Lo veremos en la semana 13.
Error común. “TCP/IP es un protocolo”. Son dos, y su separación es una de las decisiones de diseño más importantes de la historia de Internet. La cintura es IP. TCP corre encima, solo en los hosts, y es reemplazable: una aplicación puede usar UDP o, con el tiempo, otra cosa, sin tocar un router.
Fate sharing: dónde vive el estado
Cuando una conexión TCP está activa, hay datos que describen ese estado: qué bytes ya se enviaron, cuáles se confirmaron, cuáles hay que reenviar y qué tamaño tiene la ventana. Alguien tiene que guardarlos. ¿Dónde?
David Clark, en un artículo de 1988 sobre la filosofía de diseño de los protocolos de DARPA, llamó fate sharing a la respuesta.
Definición. Fate sharing es guardar el estado de una comunicación en los extremos que la usan, de modo que ese estado solo se pierda si muere la propia entidad que lo necesita. Si un extremo muere, se pierde la conexión, pero de todas formas ya no tenía a quién servirle.
La alternativa es guardar una copia en la red. Entonces, si cae un equipo intermedio, la conexión se pierde aunque los dos extremos estén perfectos, y los extremos no pueden hacer nada al respecto. El objetivo original de la red de DARPA era sobrevivir a la pérdida de partes de la red, y por eso esta decisión tuvo prioridad sobre otras.
La distinción que importa es entre dos clases de estado:
| Router IP | Host | |
|---|---|---|
| Estado de routing y forwarding | Sí: una entrada por prefijo, no por conexión | Una tabla pequeña |
| Estado de cada conexión | No | Sí: secuencia, ventana, buffers, temporizadores |
| Si se pierde | Se reconstruye conversando con los vecinos | Se pierde la conexión |
El tamaño de la tabla de un router depende de cuántos destinos existen, y no de cuántas conversaciones pasan por él. Tampoco es difícil de recuperar: otro router se la puede enseñar.
El experimento: matar un router
Ahora comprobamos todo esto. Primero, ¿qué sabe cada nodo sobre una conexión activa? Dejamos a
chunk_send enviando durante unos segundos, y preguntamos con ss -tn, que lista los sockets
TCP del nodo:
$ docker exec clab-w02-fate-h1 ss -tn
State Recv-Q Send-Q Local Address:Port  Peer Address:Port
ESTAB 0      0          10.2.1.10:58496    10.2.4.10:9000
$ docker exec clab-w02-fate-r1 ss -tn
State Recv-Q Send-Q Local Address:Port Peer Address:Port
h1 conoce la conexión. r1, que está reenviando cada uno de sus paquetes en ese mismo
instante, no tiene ningún socket que la describa. Lo único que r1 tiene es esta línea, que no
menciona ni a h1 ni al puerto 9000:
$ docker exec clab-w02-fate-r1 ip route show 10.2.4.0/24
10.2.4.0/24 nhid 25 via 10.2.12.2 dev eth2 proto ospf metric 20
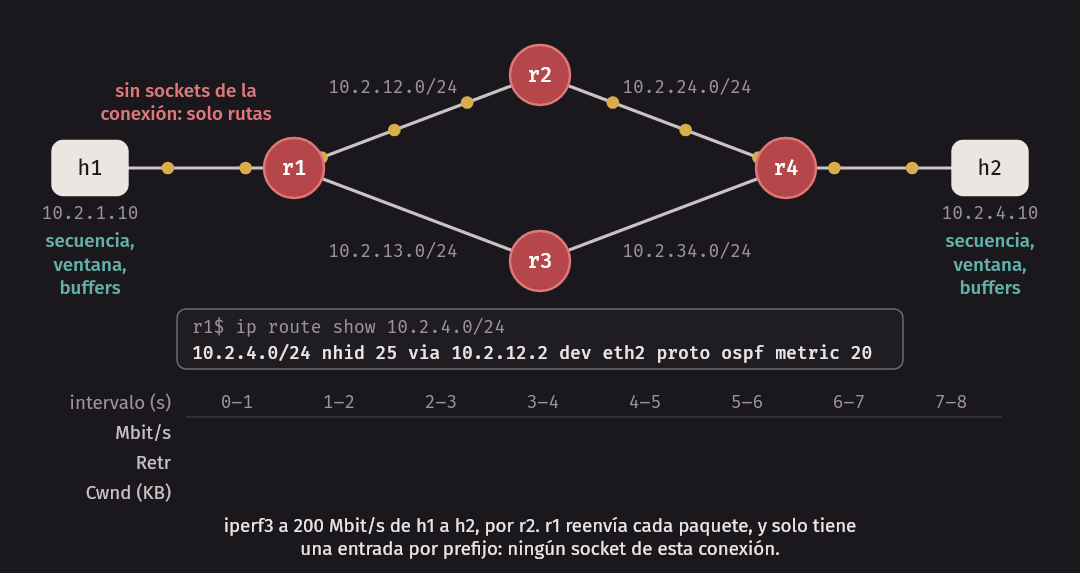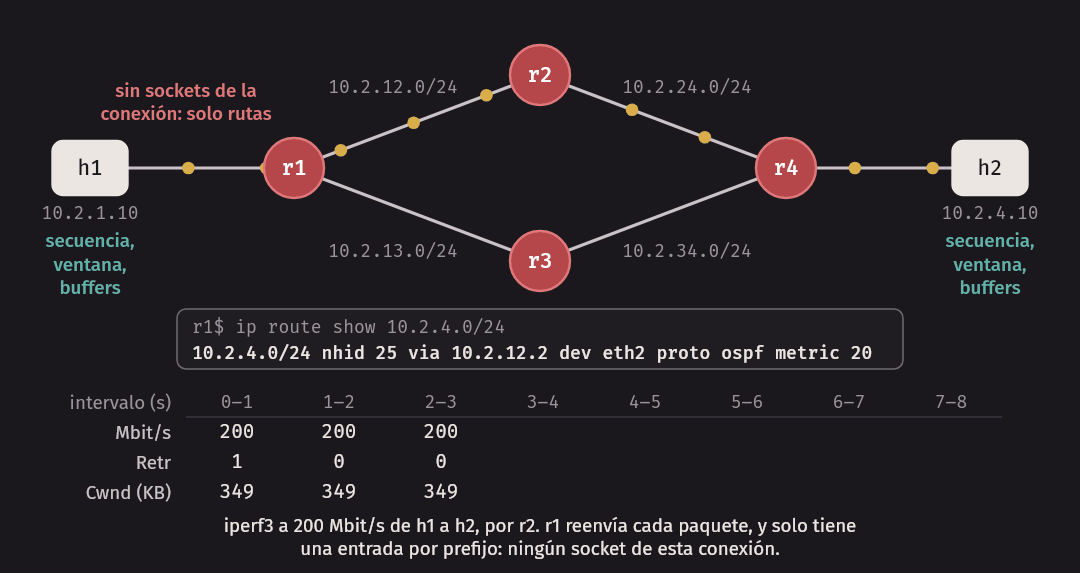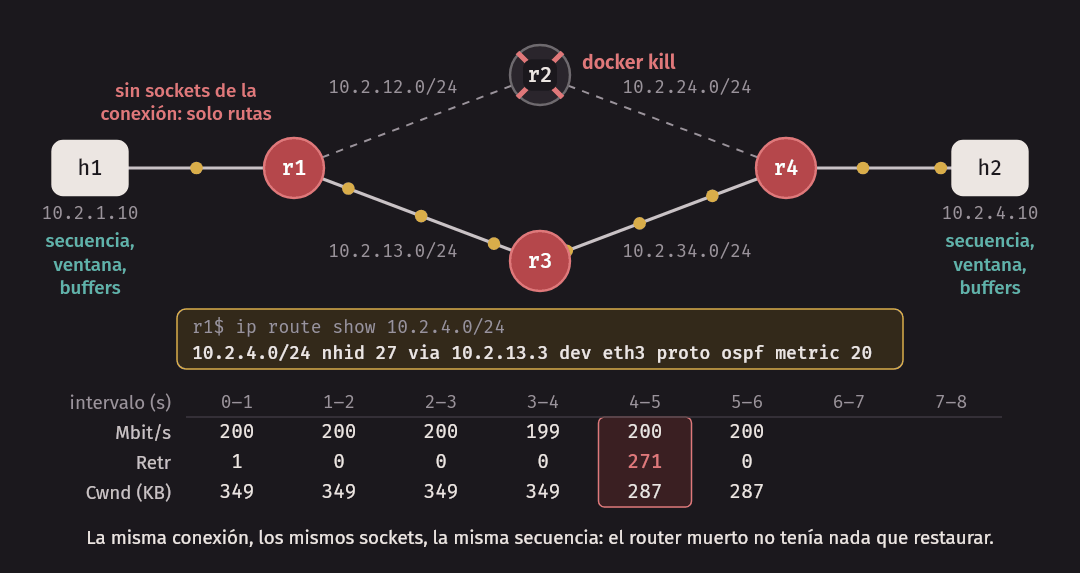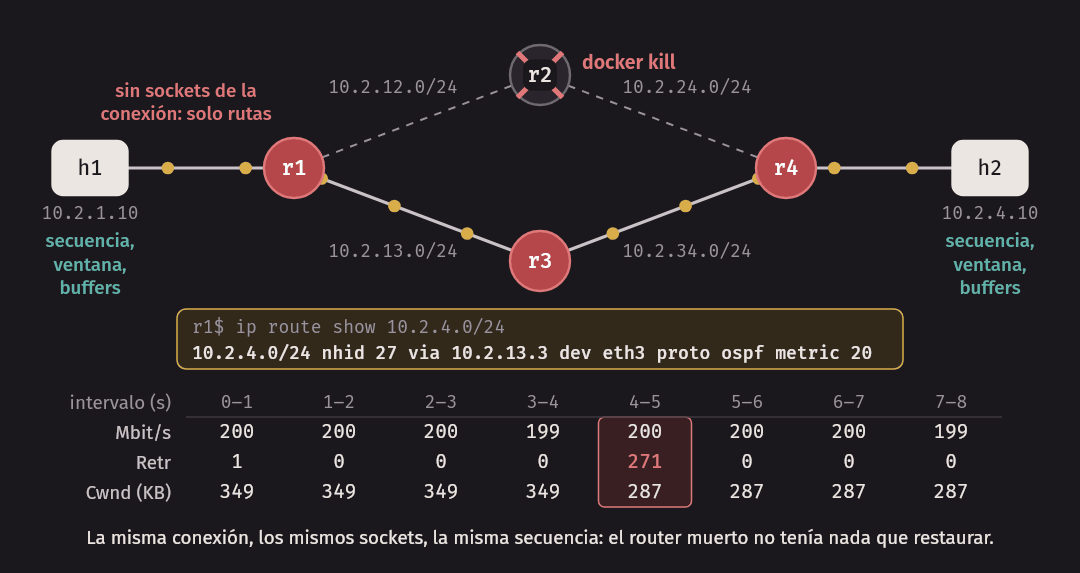
Ahora la prueba de verdad. Corremos iperf3 durante 8 segundos a 200 Mbit/s, y a los 4 segundos
matamos el contenedor de r2, el router por donde pasa todo el tráfico:
$ docker exec clab-w02-fate-h2 iperf3 -s -1 -p 5201 &
$ docker exec clab-w02-fate-h1 iperf3 -c 10.2.4.10 -p 5201 -t 8 -i 1 -f m -b 200M &
$ sleep 4; docker kill clab-w02-fate-r2
[ ID] Interval Transfer Bitrate Retr Cwnd
[ 5] 0.00-1.00 sec 23.9 MBytes 200 Mbits/sec 1 349 KBytes
[ 5] 1.00-2.00 sec 23.9 MBytes 200 Mbits/sec 0 349 KBytes
[ 5] 2.00-3.00 sec 23.9 MBytes 200 Mbits/sec 0 349 KBytes
[ 5] 3.00-4.00 sec 23.8 MBytes 199 Mbits/sec 0 349 KBytes
[ 5] 4.00-5.00 sec 23.9 MBytes 200 Mbits/sec 271 287 KBytes
[ 5] 5.00-6.00 sec 23.9 MBytes 200 Mbits/sec 0 287 KBytes
[ 5] 6.00-7.00 sec 23.9 MBytes 200 Mbits/sec 0 287 KBytes
[ 5] 7.00-8.00 sec 23.8 MBytes 199 Mbits/sec 0 287 KBytes
- - - - - - - - - - - - - - - - - - - - - - - - -
[ ID] Interval Transfer Bitrate Retr
[ 5] 0.00-8.00 sec 191 MBytes 200 Mbits/sec 272 sender
[ 5] 0.00-8.00 sec 191 MBytes 200 Mbits/sec receiverLa conexión ni se enteró, o casi. La columna Retr cuenta retransmisiones: en el intervalo en
que murió r2, TCP tuvo que reenviar 271 segmentos, y siguió con la misma conexión, los mismos
sockets y los mismos números de secuencia. El router muerto no tenía nada de esa conexión, así
que no hubo nada que restaurar. Solo hizo falta otro camino, y OSPF lo instaló en r1:
$ docker exec clab-w02-fate-r1 ip route show 10.2.4.0/24
10.2.4.0/24 nhid 27 via 10.2.13.3 dev eth3 proto ospf metric 20
$ docker exec clab-w02-fate-h1 traceroute -n -q 1 10.2.4.10
traceroute to 10.2.4.10 (10.2.4.10), 30 hops max, 46 byte packets
 1  10.2.1.1  0.005 ms
 2  10.2.13.3  0.002 ms
 3  10.2.34.4  0.002 ms
 4  10.2.4.10  0.002 ms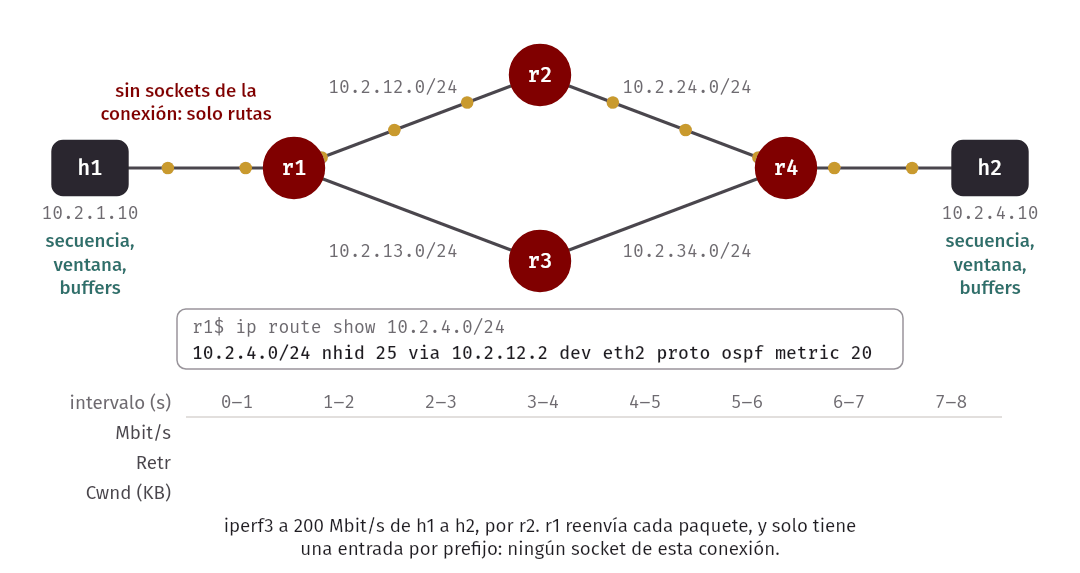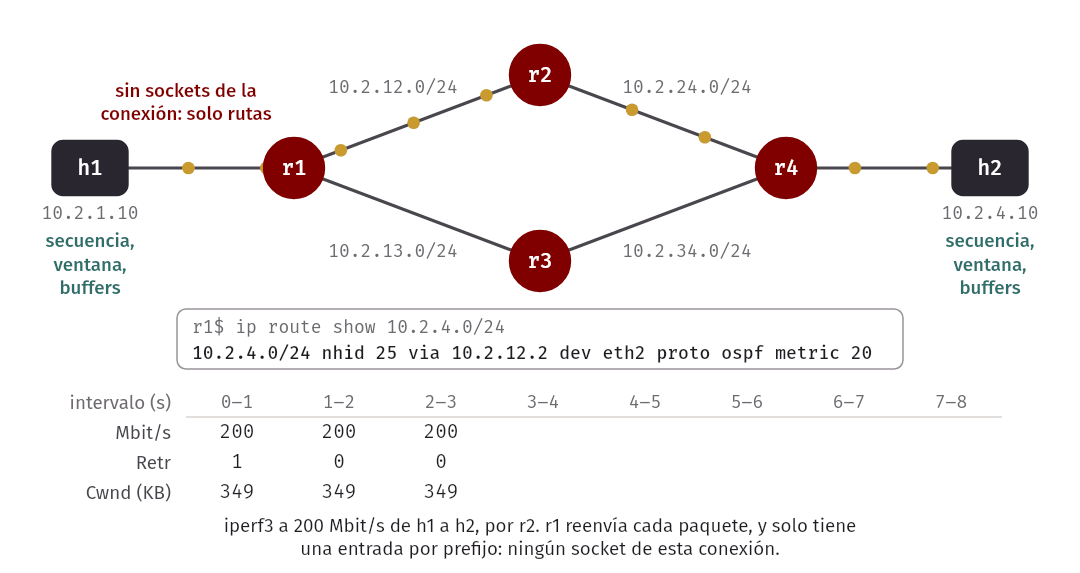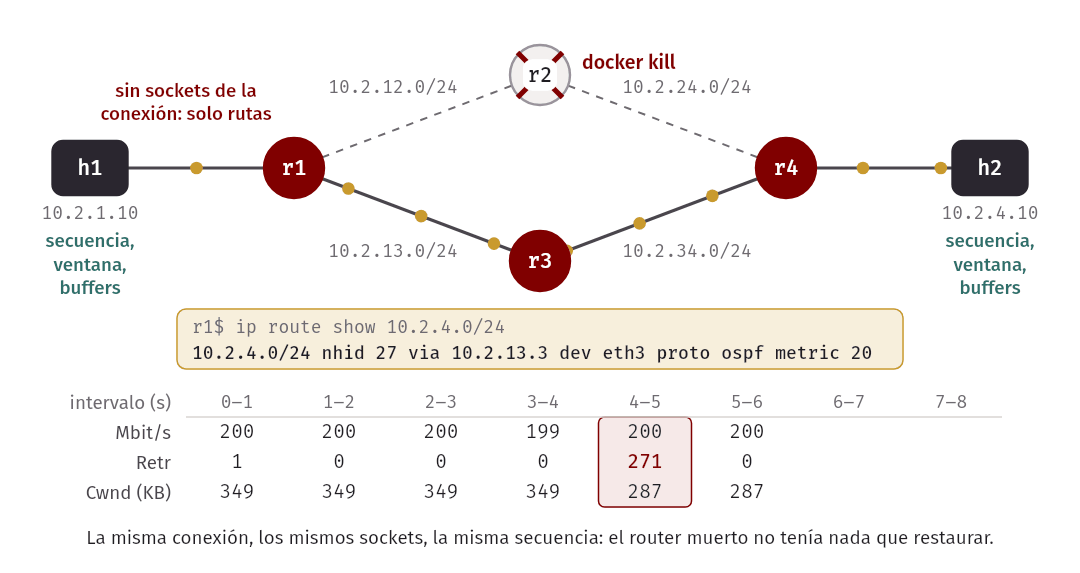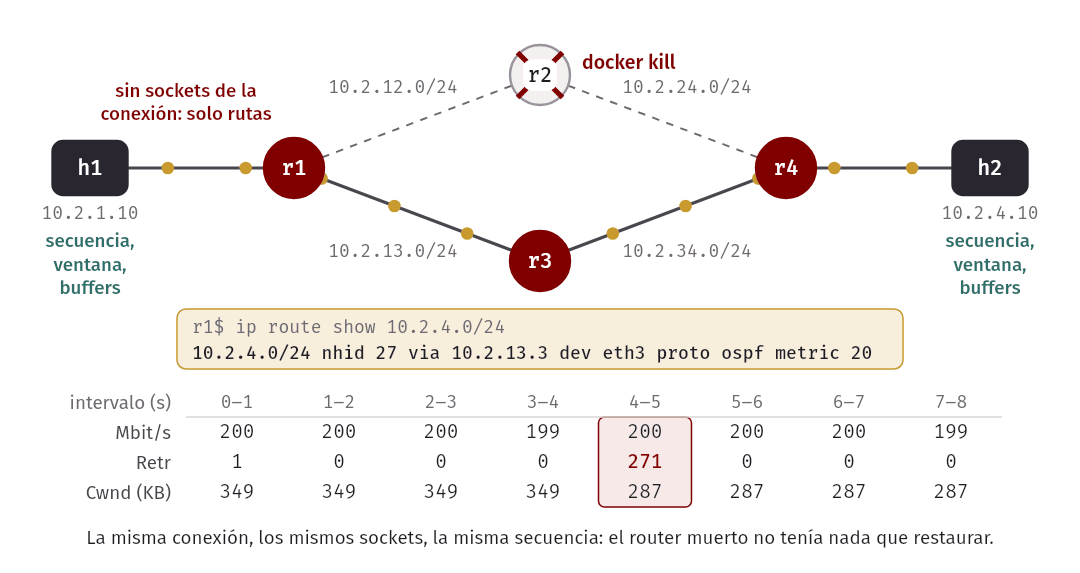
La recuperación fue tan rápida porque aquí un enlace caído se detecta al instante y la red es muy pequeña. En una red grande puede tomar más, y las cifras dependen de su computadora. La conclusión no depende de eso: la conexión sobrevive a cualquier falla que deje algún camino, si los paquetes vuelven a pasar antes de que TCP se rinda.
¿Y si muere un extremo? Matamos el proceso receptor en h2, en medio de un envío:
$ docker exec clab-w02-fate-h1 /lab/chunk_send -g 50 10.2.4.10 9003 1000 200
send: Broken pipe
La conexión muere, y en este caso se entera rápido porque el kernel de h2, que sigue vivo,
responde con un reset en nombre del proceso muerto. El caso más difícil es una máquina que deja
de responder sin avisar. Lo imitamos con una regla de firewall en h2, que descarta todo lo que
entra:
$ docker exec clab-w02-fate-h2 nft add table inet dead
$ docker exec clab-w02-fate-h2 nft 'add chain inet dead in { type filter hook input priority 0; policy drop; }'
$ docker exec clab-w02-fate-h1 ss -tno dst 10.2.4.10
State Recv-Q Send-Q Local Address:Port  Peer Address:Port
ESTAB 0      40000      10.2.1.10:56400    10.2.4.10:9004 timer:(on,1.003ms,3)
$ docker exec clab-w02-fate-h1 ss -tno dst 10.2.4.10
State Recv-Q Send-Q Local Address:Port  Peer Address:Port
ESTAB 0      71056      10.2.1.10:56400    10.2.4.10:9004 timer:(on,4.665ms,5)
Seis segundos después, los datos sin confirmar (Send-Q) crecieron de 40 000 a 71 056 bytes, y
el último número de timer subió de 3 a 5: es la cuenta de retransmisiones. Pero chunk_send
sigue como si nada: sus llamadas a send devuelven éxito, porque send solo significa “lo
copié a un buffer local”. Pasarán varios minutos antes de que TCP se rinda. Si su aplicación
necesita enterarse antes, tiene que implementar sus propios plazos, lo cual es otra vez el
argumento end-to-end.
En la práctica. No todo el núcleo está libre de estado por conexión. Un NAT, un firewall con estado o un load balancer sí llevan una tabla de conexiones, y si se reinician, las conexiones que pasan por ellos se cortan aunque los hosts estén bien. Los veremos en las semanas 4 y 15. Son una excepción al principio, y es justamente por eso que causan los problemas que causan.
Al terminar, destruyan la topología, porque r2 y h2 quedaron dañados:
$ make destroyDe ARPANET a la Web
Estos principios no se escribieron de una vez. Salieron de una historia de cuarenta años, y conviene conocerla al menos a grandes rasgos. El libro de Kurose y Ross la cuenta en la sección 1.7.
| Año | Hecho | Por qué importa |
|---|---|---|
| 1961–1965 | Kleinrock, Baran y Davies trabajan por separado en la conmutación de paquetes | Davies acuña la palabra packet; Baran busca redes que resistan daños |
| 1969 | ARPANET conecta sus primeros cuatro nodos: UCLA, SRI, UCSB y Utah | Primera red grande de paquetes. RFC 1 se publica ese mismo año |
| 1970–1973 | NCP, correo electrónico, ALOHAnet, Ethernet | Aparecen otras redes, muy distintas entre sí |
| 1974 | Cerf y Kahn publican una arquitectura para interconectar redes | La idea de internet: redes distintas, unidas por gateways simples |
| 1978 | TCP se separa en TCP e IP | Las aplicaciones de tiempo real no querían la confiabilidad: nace el espacio para UDP |
| 1983 | ARPANET pasa de NCP a TCP/IP el 1 de enero | Internet como la conocemos, con todos usando IP |
| 1985–1986 | NSFNET conecta universidades | Internet sale del mundo militar |
| 1989–1991 | Berners-Lee crea la Web en CERN | HTTP y HTML llegan sin pedirle nada a la red: la cintura angosta en acción |
| 1995 | NSFNET deja de operar su red troncal | Internet pasa a ser comercial, con ISP en competencia |
Noten la fila de 1978, porque es el argumento end-to-end antes de que tuviera nombre: al principio TCP hacía todo, y quienes hacían pruebas con voz descubrieron que no querían sus retransmisiones. Separar IP de TCP dejó una capa mínima a la que todos tienen que adherirse, y arriba, cada uno elige.
ATM y Frame Relay: las alternativas que perdieron
En los años noventa, muchos ingenieros serios pensaban que el futuro de las redes no era IP. Las empresas telefónicas tenían un plan: ATM (Asynchronous Transfer Mode), una red integrada para voz, video y datos, con calidad garantizada. Entender por qué no fue así aclara los principios mejor que cualquier definición.
Circuitos virtuales
ATM y Frame Relay usan circuitos virtuales (virtual circuits).
Definición. Un circuito virtual es un camino fijo a través de la red, establecido antes de enviar datos. Cada switch del camino guarda una entrada para ese circuito. Cada paquete lleva una etiqueta corta y cada switch la usa para decidir la salida.
La etiqueta solo tiene significado en un enlace, y cada switch la reescribe. Un ejemplo con dos circuitos, en un switch de tres puertos:
 Tabla del switch S (una fila por circuito activo)

 Entra por | etiqueta |  Sale por | etiqueta nueva
 ----------+----------+-----------+---------------
 puerto 1  |    22    |  puerto 3 |     31
 puerto 2  |    22    |  puerto 3 |     47

 Un paquete con etiqueta 22 que entra por el puerto 2 sale por el 3 con etiqueta 47.
Compárenlo con IP:
| Datagrama de IP | Circuito virtual | |
|---|---|---|
| Antes de enviar | Nada | Señalización: se reserva un camino en todos los switches |
| Qué lleva cada paquete | Dirección completa de destino | Etiqueta corta |
| Estado en cada equipo intermedio | Por prefijo; no depende de las conexiones | Una entrada por circuito |
| Búsqueda | Longest prefix match | Índice exacto de una tabla |
| Orden de llegada | No garantizado | Mismo camino: en orden |
| Calidad garantizada | Difícil | Natural: se reserva al establecer |
| Si cae un equipo intermedio | Los paquetes siguientes toman otro camino | Se cae el circuito; hay que establecerlo de nuevo |
La última fila es el experimento que acabamos de hacer, en su otra versión. Con circuitos virtuales, la red guarda estado de cada conversación y, por lo tanto, comparte su destino con ella. No hay fate sharing.
Celdas de 53 bytes
ATM se distingue por transportar celdas de tamaño fijo: 53 bytes, de los que 5 son cabecera y 48 son datos. ¿Por qué un número tan raro? Porque fue un compromiso. Las empresas de telefonía de América querían 64 bytes de datos, y las de Europa, 32. Se partió la diferencia y quedó en 48.
El motivo de que fueran pequeñas era la voz. Una llamada telefónica digital genera 64 kbit/s, y hay que esperar a llenar una celda antes de enviarla:
48 bytes × 8 bits/byte / 64 000 bits/s = 0,006 s = 6 msCeldas cortas también significaban que un paquete largo no bloqueaba por mucho tiempo a una voz que venía detrás, en una época de enlaces lentos. Y el tamaño fijo facilitaba construir switches rápidos en hardware.
Los costos son igual de claros. Con 5 bytes de cabecera por cada 53, 5/53 ≈ 9,4 % de la capacidad se va en cabeceras, lo que se llamó el cell tax. Y un paquete IP de 1500 bytes se parte en más de 30 celdas: si se pierde una sola, el paquete completo es inútil, pero la red sigue llevando las demás celdas hasta el final.
Frame Relay
Frame Relay es más modesto. Fue popular entre empresas durante los años noventa para unir sucursales, como sucesor simplificado de X.25. También usa circuitos virtuales, normalmente permanentes y contratados con el operador, identificados por una etiqueta llamada DLCI. A diferencia de ATM, sus frames son de tamaño variable. X.25 corregía errores en cada salto, y Frame Relay eliminó esa corrección, dejándola a los extremos, porque las líneas digitales ya casi no tenían errores. Es decir, se movió justo en la dirección del argumento end-to-end.
Por qué se impuso IP
No hubo un solo motivo, y la mayoría son consecuencias de los principios anteriores:
- Cada circuito tenía un costo en la red. El estado por conexión escala con las conversaciones. Establecer un circuito para cada pedido corto de una página Web, que dura una fracción de segundo, no tiene sentido.
- La Web llegó sin pedir permiso. El tráfico que explotó fue de datos, que no necesitaba las garantías por las que ATM cobraba. Un buen enlace con mucha capacidad resultó más barato que un enlace con reservas.
- IP corre sobre cualquier cosa. IP se transportó sobre ATM y Frame Relay, y siguió igual cuando estos desaparecieron. La cintura angosta hizo a los enlaces reemplazables. No al revés.
- Ethernet creció más rápido y más barato. Pasó de 10 Mbit/s a 100 Mbit/s, luego a 1 Gbit/s y 10 Gbit/s, sin celdas ni circuitos, y salió de la red local para llegar a las redes metropolitanas.
- Las razones técnicas de ATM envejecieron. Con enlaces de gigabits, un paquete largo se transmite en microsegundos, así que la cola de la voz deja de ser un problema de tamaño de celda. Y el hardware aprendió a hacer longest prefix match a esa velocidad.
¿Qué lugar ocupan hoy? Frame Relay está retirado o en retiro en casi todos los operadores. ATM sobrevivió durante años en lugares poco visibles, como los accesos ADSL. Pero la idea de las etiquetas no murió: MPLS, muy usado hoy en las redes de operadores, reenvía por etiquetas por caminos preestablecidos, debajo de IP. La diferencia es importante: en MPLS, las etiquetas se ponen debajo de IP para ofrecer ingeniería de tráfico y VPNs, y una falla se resuelve dentro de la red de un operador. IP sigue en el medio, de extremo a extremo.
Idea clave. ATM era técnicamente coherente y estaba mejor pensado para la voz. Perdió porque optimizaba para el servicio que ya existía, en vez de permitir los que todavía no existían. Es una lección de diseño: la red que promete poco fue la que más cosas pudo llevar.
Quién define Internet: la IETF y los RFC
Internet no tiene dueño, pero sus protocolos sí tienen quien los escriba. La IETF (Internet Engineering Task Force) es una organización abierta, formada desde 1986, sin membresía formal: cualquiera se suscribe a la lista de correo de un grupo de trabajo y participa. Se describe con una frase de David Clark, de 1992: “We reject kings, presidents and voting. We believe in rough consensus and running code.” No se vota: se busca un consenso aproximado, y se valora que el protocolo ya funcione en código real.
Otras organizaciones cubren otras piezas: el IEEE define Ethernet y Wi-Fi (familia 802), la W3C define estándares de la Web como CSS, el WHATWG mantiene HTML, e ICANN/IANA administra direcciones, nombres y números de protocolo.
Los documentos de la IETF se llaman RFC (Request for Comments). Se publican desde 1969. Un RFC publicado nunca se cambia. Si hay que corregirlo, se publica otro con un número nuevo. Por eso conviene saber leer su encabezado. Este es el de la especificación actual de TCP:
Internet Engineering Task Force (IETF)                      W. Eddy, Ed.
STD: 7                                                       MTI Systems
Request for Comments: 9293                                   August 2022
Obsoletes: 793, 879, 2873, 6093, 6429, 6528,
           6691
Updates: 1011, 1122, 5961
Category: Standards Track
ISSN: 2070-1721
Se lee así:
Obsoletes: 793, ...Este documento reemplaza a esos. Todavía verán citado el RFC 793, de 1981; hoy la referencia es RFC 9293. Antes de confiar en un RFC, miren en su página si otro ya lo reemplazó.Updates: ...Cambia una parte de esos, pero no los reemplaza.CategoryStandards Track es para los estándares. Informational y Experimental no lo son. Algunos RFC muy citados son solo informativos.STD: 7Tiene categoría de Internet Standard, el nivel más alto. Los números STD apuntan siempre al documento vigente.
Para leer uno, no empiecen por la primera página y sigan hasta la última. Lean el resumen y la introducción, busquen la sección que les interesa con la búsqueda de su navegador y miren las figuras de los formatos. Las cabeceras se dibujan en ASCII, con una regla de bits arriba. El RFC 768, de UDP, tiene solo tres páginas y es buen lugar para empezar:
$ curl -s https://www.rfc-editor.org/rfc/rfc768.txt | sed -n 31,43p
                  0      7 8     15 16    23 24    31
                 +--------+--------+--------+--------+
                 |     Source      |   Destination   |
                 |      Port       |      Port       |
                 +--------+--------+--------+--------+
                 |                 |                 |
                 |     Length      |    Checksum     |
                 +--------+--------+--------+--------+
                 |
                 |          data octets ...
                 +---------------- ...

                      User Datagram Header Format
Una última convención. En los RFC, algunas palabras en mayúsculas tienen un significado exacto, que definen RFC 2119 y RFC 8174: MUST es obligatorio, SHOULD es lo recomendado salvo que haya una buena razón y se entiendan las consecuencias, y MAY es opcional. Cuando un RFC dice que un receptor MUST ignorar algo, un programa que no lo ignore está mal, aunque funcione en su prueba.
En la práctica. Cuando su programa no se lleva bien con otro, el RFC es quien resuelve la discusión. Es la razón por la que un programa de un equipo puede hablar con el de otro equipo que nunca conoció. En P5 ustedes implementarán parte de HTTP leyendo sus RFC.
Procesos, puertos y sockets
Pasamos a la Sesión B. Hasta aquí hablamos de hosts, pero quienes se comunican de verdad no son los hosts sino los procesos: un navegador y un servidor Web, cada uno en su computadora.
La mayoría de las aplicaciones sigue una arquitectura cliente-servidor. El servidor está siempre encendido, en una dirección conocida, esperando. El cliente inicia la comunicación cuando lo necesita. Hay otras arquitecturas, como peer-to-peer, en la que los nodos hacen ambos papeles, pero incluso ahí, en cada conversación, un proceso espera y otro inicia.
El socket
Definición. Un socket es la interfaz entre un proceso y el transporte de su sistema operativo. Para el programa, es un descriptor de archivo: un entero sobre el que llama a
sendy arecv. Lo que hay debajo, en el kernel, son los buffers y el estado de la conexión.
Es la frontera entre lo que ustedes controlan y lo que no. Arriba del socket el programa decide todo. Abajo, el sistema operativo y la red hacen lo que pueden, y ustedes solo pueden elegir el transporte y unos pocos parámetros.
      host A                                   host B
 +--------------+                         +--------------+
 |   proceso    |    control de ustedes   |   proceso    |
 +------+-------+                         +------+-------+
 ~~~~ socket ~~~~                         ~~~~ socket ~~~~
 +------+-------+                         +------+-------+
 | TCP o UDP    |    control del sistema  | TCP o UDP    |
 | IP, enlace   |                         | IP, enlace   |
 +------+-------+                         +------+-------+
        +---------- la red, sin garantías -------+
El puerto
La dirección IP lleva el paquete hasta un host, pero ¿para cuál de sus procesos es? Un puerto es un número de 16 bits que identifica a un socket dentro de un host. Por eso un servidor se identifica con una dirección y un puerto.
| Rango | Nombre | Uso |
|---|---|---|
| 0–1023 | Bien conocidos (well-known) | Servicios estándar: 22 (SSH), 53 (DNS), 80 (HTTP), 443 (HTTPS). Requieren permisos especiales |
| 1024–49151 | Registrados | Aplicaciones que los registran ante IANA |
| 49152–65535 | Dinámicos | Puertos temporales que elige el sistema para los clientes |
Un cliente casi nunca elige su puerto. Se lo asigna el sistema, de un rango que depende de la configuración y no siempre coincide con el de la tabla. El valor por defecto de Linux, en un nodo de la topología, y el de esta máquina, en el contenedor del curso, son distintos:
$ docker exec clab-w02-fate-h1 cat /proc/sys/net/ipv4/ip_local_port_range
32768	60999
$ cat /proc/sys/net/ipv4/ip_local_port_range
55000	65535
Una conexión TCP se identifica con cuatro números: dirección y puerto de origen, dirección y puerto de destino. Por eso un servidor en el puerto 80 puede tener miles de conexiones a la vez, todas con el mismo puerto local.
Qué le pide una aplicación al transporte
Las aplicaciones necesitan cuatro cosas de su transporte, en distintas medidas. Internet les ofrece TCP y UDP, y solo una de esas cuatro es una promesa fuerte:
| Necesidad | Quién la necesita | TCP | UDP |
|---|---|---|---|
| Confiabilidad | Archivos, correo, Web | Sí: todo, en orden, una vez | No |
| Throughput | Video | Sin garantía; se reparte con el control de congestión | Sin garantía; envía lo que el programa le pida |
| Tiempo | Voz, juegos | Sin garantía; una retransmisión agrega retardo | Sin garantía, pero nada lo retrasa a propósito |
| Seguridad | Casi todo | No, se agrega con TLS arriba | No, se agrega arriba (QUIC ya lo trae) |
TCP además tiene conexión (hay un handshake antes de enviar datos), control de flujo (no ahoga al receptor) y control de congestión (no ahoga a la red). UDP no tiene nada de eso: solo agrega los puertos y un checksum a IP. Vean la tabla con calma: ni TCP ni UDP garantizan throughput o tiempo. Esto es el best effort de la Sesión A, visto desde arriba. Una videollamada funciona porque la aplicación se adapta, no porque la red le prometa algo.
El orden de los bytes
Antes de escribir un programa, hay un detalle que arruina programas de red. Un entero de varios bytes se puede guardar en dos órdenes: con el byte más significativo primero (big-endian) o con el menos significativo primero (little-endian). Las laptops y computadoras actuales, en x86-64 y en ARM, usan little-endian. Los protocolos de Internet usan big-endian, y por eso se le llama orden de red.
Cuatro funciones hacen la conversión. Se leen en inglés: htons es host to network short, y
ntohl es network to host long, donde short son 16 bits y long son 32, sin importar lo
que long signifique en C:
| Función | De | A | Tamaño |
|---|---|---|---|
htons |
host | red | 16 bits (puertos) |
ntohs |
red | host | 16 bits |
htonl |
host | red | 32 bits (direcciones IPv4) |
ntohl |
red | host | 32 bits |
byte_order.c imprime los bytes de la memoria. El resultado de
las líneas “en memoria” depende del procesador; esta salida es de una máquina little-endian:
$ build/byte_order
9002 en memoria:       2a 23
htons(9002):           23 2a
0x0a020110 en memoria: 10 01 02 0a
htonl(0x0a020110):     0a 02 01 10
sizeof(struct wrong_header) = 4, aunque sus campos suman 3
cabecera en 3 bytes:   07 23 2a
El número 9002 es 0x232a en hexadecimal. En la memoria de esta máquina, el byte 2a va
primero. En la red debe ir primero 23. Si se olvidan htons, su servidor escucha en otro
puerto: el 0x2a23, que es el 10787. Sin ningún error. En una máquina big-endian, htons no
hace nada y el programa sin conversión funcionaría; por eso se llaman siempre, para que el
programa sea correcto en cualquier procesador.
Error común. Copiar una
structa la red. La línea desizeofmuestra por qué no se hace:wrong_headertiene unuint8_ty unuint16_t, pero ocupa 4 bytes, porque el compilador agrega un relleno para alinear el segundo campo. Otro compilador o procesador podría armarla diferente. Un formato de red se define byte a byte y se arma campo por campo, como en la última línea de la salida, que tiene exactamente los tres bytes esperados.
Un servidor y un cliente con TCP
Vamos a escribir un servicio de conteo, una versión de red del comando wc. El cliente le envía
un texto al servidor, y el servidor responde cuántos bytes, palabras y líneas recibió. No es un
programa útil, pero tiene lo que nos interesa: el servidor debe leer todo lo que llega, sin
saber cuánto es, y responde con algo distinto de lo que recibió.
La secuencia de llamadas es esta:
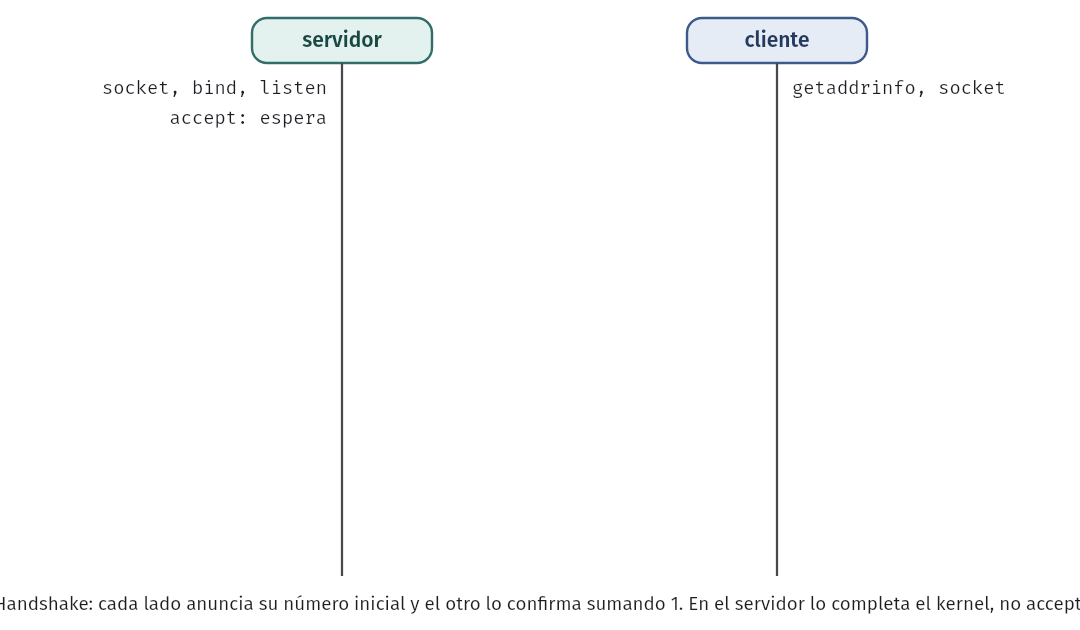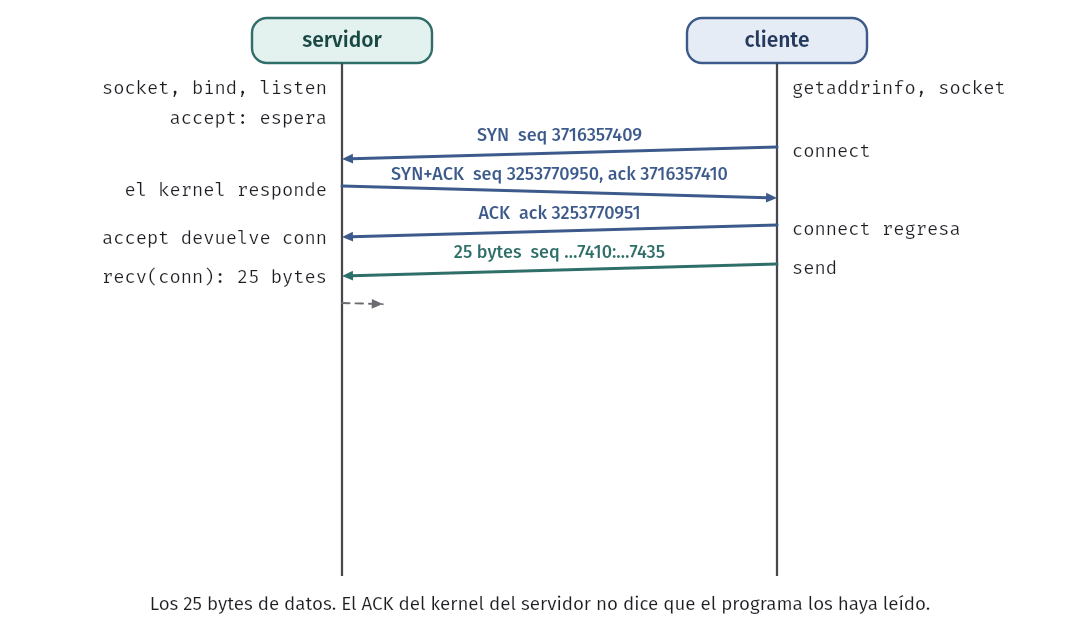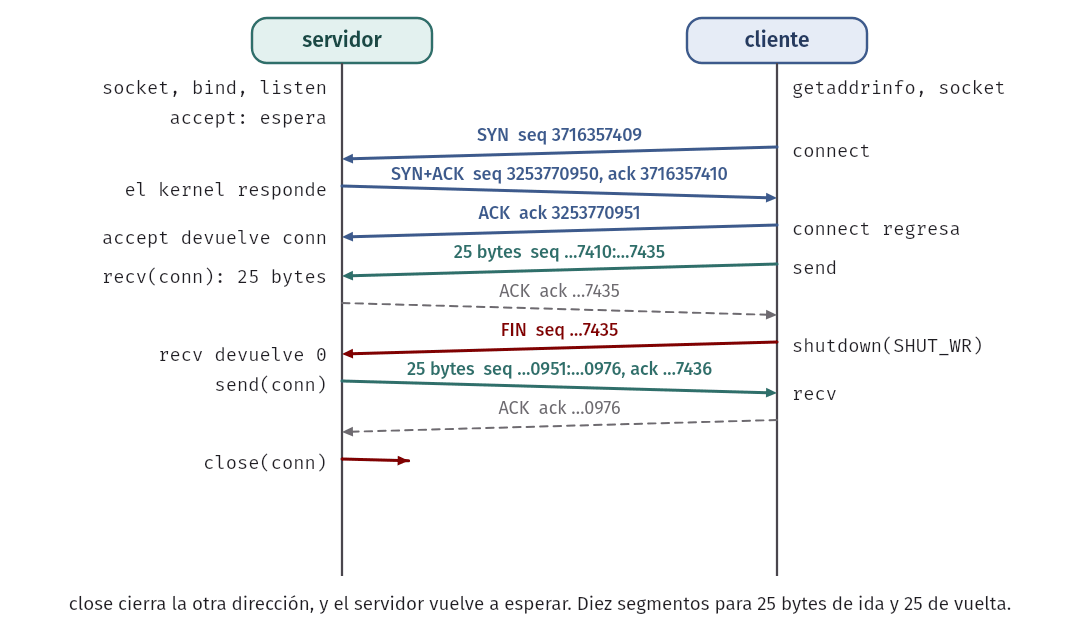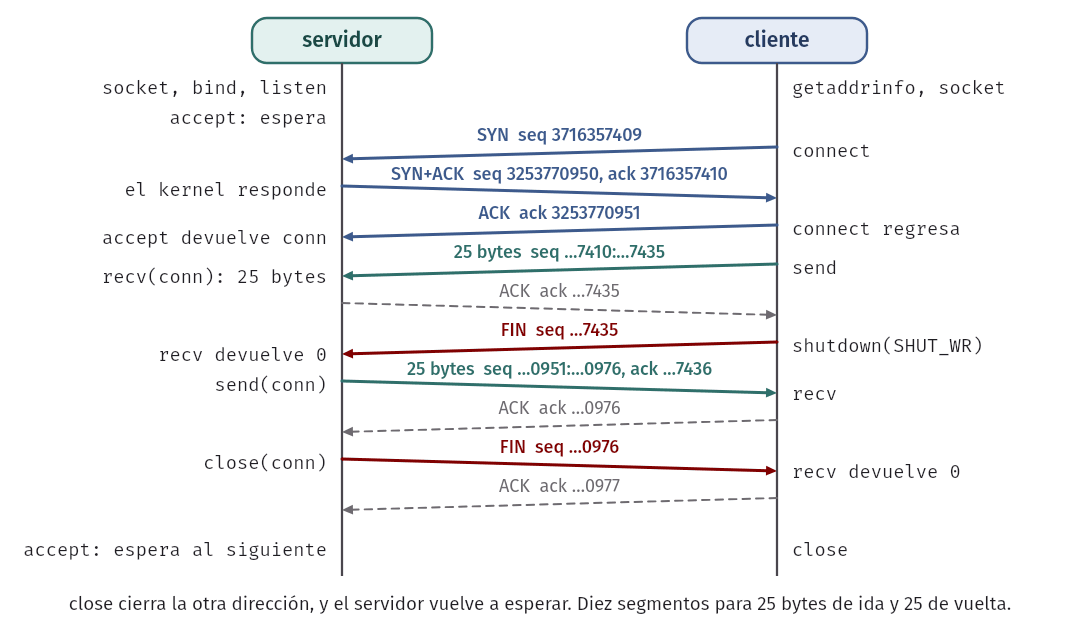
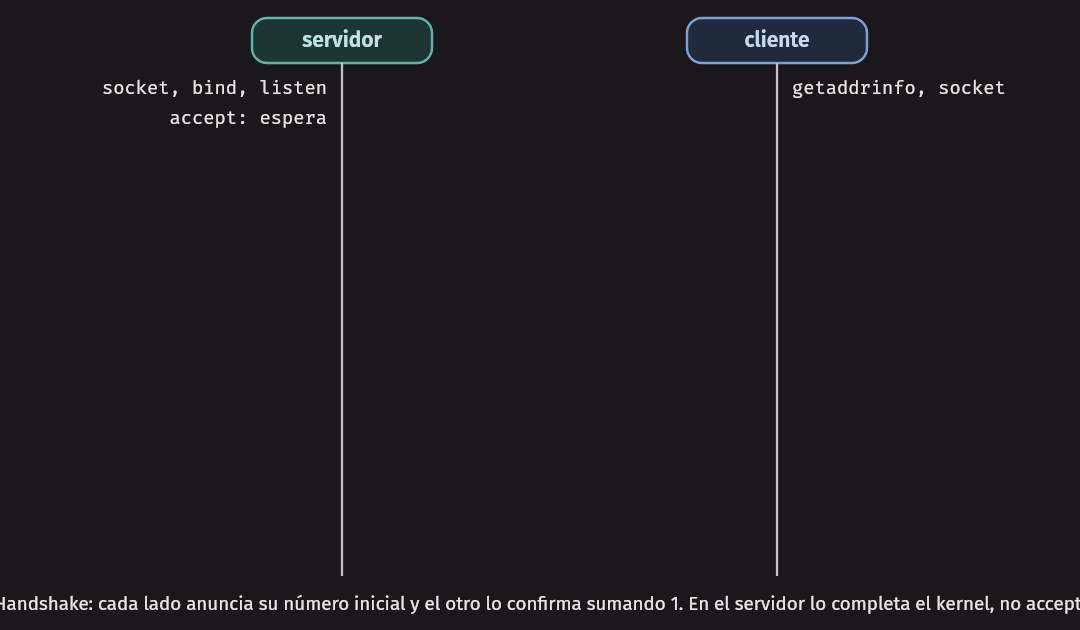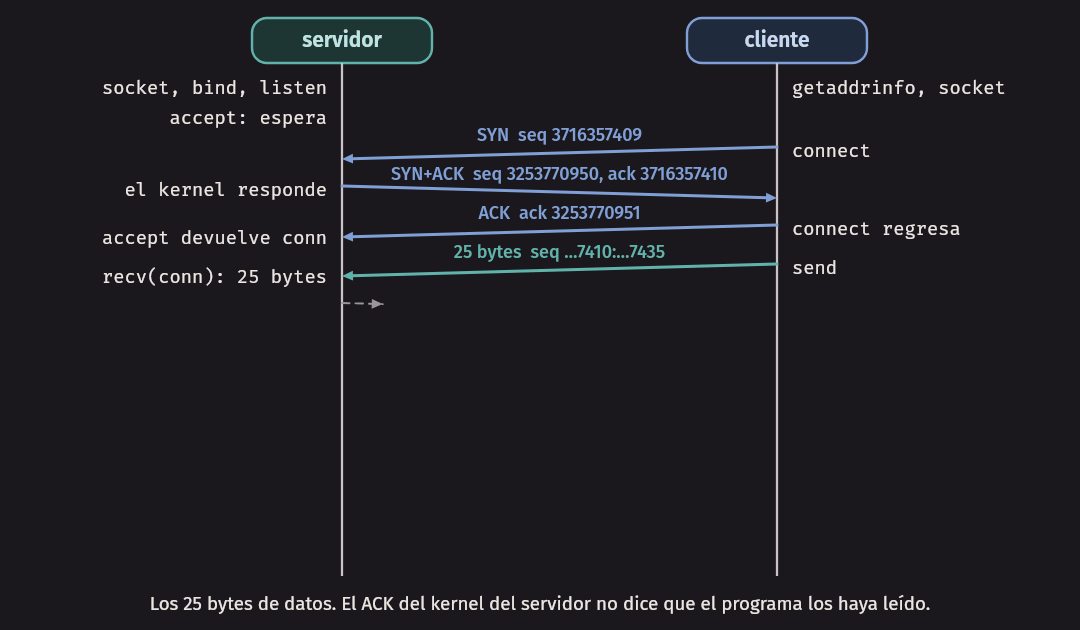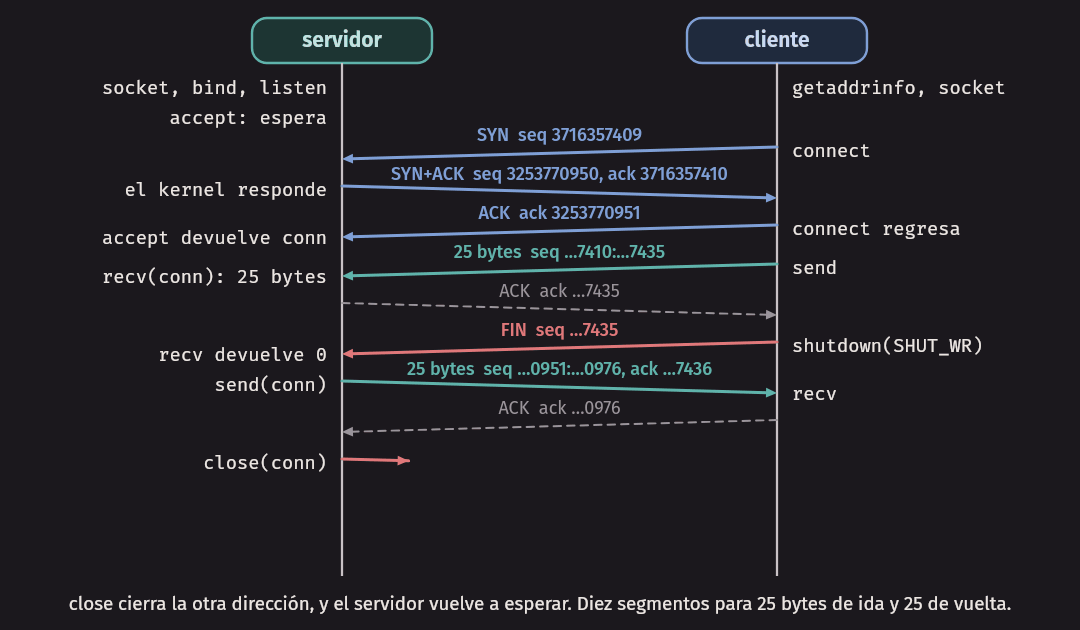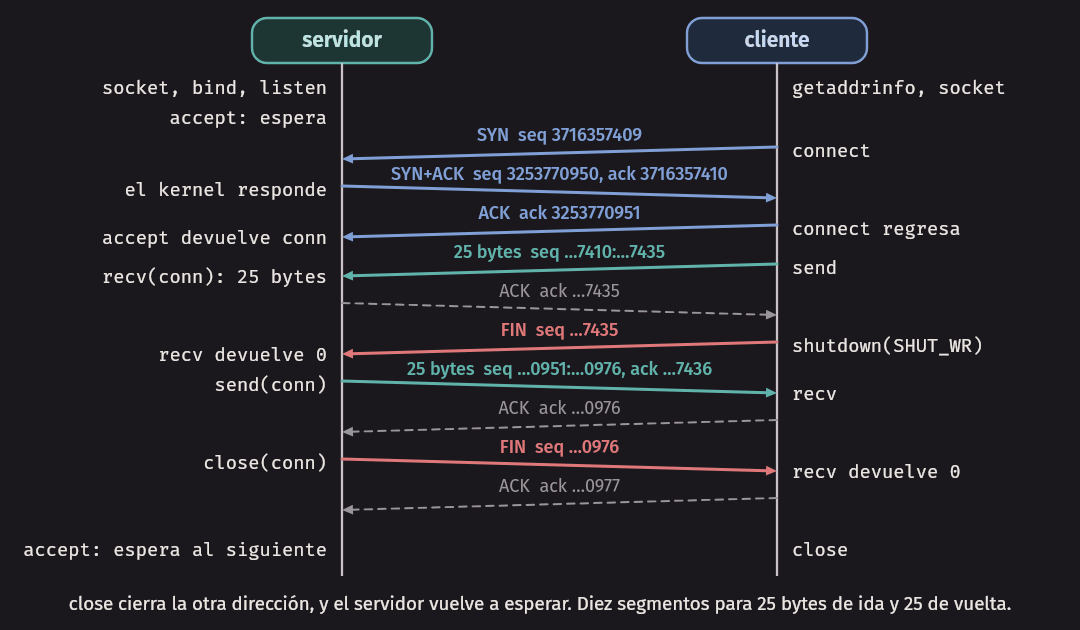
El servidor
Este es el principio de wc_server.c. parse_port valida el
argumento:
    // 1. Un socket TCP sobre IPv4.
    int listener = socket(AF_INET, SOCK_STREAM, 0);
    if (listener == -1) {
        perror("socket");
        return EXIT_FAILURE;
    }

    // 2. Permitir reusar el puerto aunque queden conexiones en TIME_WAIT.
    int on = 1;
    if (setsockopt(listener, SOL_SOCKET, SO_REUSEADDR, &on, sizeof on) == -1) {
        perror("setsockopt");
        return EXIT_FAILURE;
    }

    // 3. Asociarlo a un puerto, en todas las interfaces. Orden de red.
    struct sockaddr_in addr;
    memset(&addr, 0, sizeof addr);
    addr.sin_family = AF_INET;
    addr.sin_addr.s_addr = htonl(INADDR_ANY);
    addr.sin_port = htons(port);
    if (bind(listener, (struct sockaddr *)&addr, sizeof addr) == -1) {
        perror("bind");
        return EXIT_FAILURE;
    }

    // 4. Marcarlo como pasivo: desde aquí el kernel completa handshakes.
    if (listen(listener, 16) == -1) {
        perror("listen");
        return EXIT_FAILURE;
    }
Cada llamada hace una cosa concreta:
socket(AF_INET, SOCK_STREAM, 0)pide un socket de IPv4 (AF_INET) y de tipo stream, que significa TCP. Todavía no tiene puerto ni dirección.bindasocia el socket a un puerto local.INADDR_ANYsignifica “en cualquier interfaz de este host”. El cast astruct sockaddr *existe porque la API es genérica: sirve para IPv4, IPv6 y otras familias.listenconvierte el socket en pasivo: ya no se usará para enviar, sino para recibir conexiones. El 16 limita la cola de conexiones establecidas que todavía nadie aceptó.
Falta el ciclo principal:
    // 5. Un socket nuevo por cada conexión; listener sigue escuchando.
    for (;;) {
        struct sockaddr_in peer;
        socklen_t peer_len = sizeof peer;
        int conn = accept(listener, (struct sockaddr *)&peer, &peer_len);
        if (conn == -1) {
            perror("accept");
            continue;
        }
Idea clave.
acceptdevuelve un socket nuevo, y ese es el que sirve para hablar con el cliente. El socket original sigue escuchando. Un servidor con mil clientes tiene mil y un sockets: uno que escucha y mil conexiones.
Podemos verlo mientras el servidor atiende a un cliente, con ss. Hay tres líneas, porque aquí
el cliente está en la misma máquina y ss muestra también su lado:
$ ss -tan "( sport = :9302 or dport = :9302 )"
State  Recv-Q Send-Q Local Address:Port  Peer Address:Port
LISTEN 0      16           0.0.0.0:9302       0.0.0.0:*
ESTAB  0      0          127.0.0.1:9302     127.0.0.1:58098
ESTAB  0      0          127.0.0.1:58098    127.0.0.1:9302
La segunda línea es el socket de accept. Tiene el mismo puerto local que el que escucha, 9302:
lo que lo diferencia es el otro extremo. El 16 de la primera línea es el tope de la cola que le
dimos a listen.
El trabajo con cada cliente está en wc_service.c:
int wc_serve_client(int conn) {
    struct wc_counts counts = {0};
    char buf[4096];
    for (;;) {
        ssize_t n = recv(conn, buf, sizeof buf, 0);
        if (n == -1) {
            if (errno == EINTR) {
                continue;
            }
            perror("recv");
            return -1;
        }
        if (n == 0) {
            break;  // fin del stream: el cliente ya no enviará más
        }
        wc_update(&counts, buf, (size_t)n);
    }
Lo que devuelve recv
Esta tabla hay que saberla de memoria:
recv devuelve |
Significa | Qué hacer |
|---|---|---|
n > 0 |
Hay n bytes, que pueden ser menos de los pedidos |
Procesarlos y seguir leyendo |
0 |
El otro extremo cerró su dirección de envío: no habrá más datos | Terminar |
-1 con errno == EINTR |
Una señal interrumpió la llamada | Repetir |
-1 con ECONNRESET |
El otro extremo abortó la conexión | Cerrar el socket; informar |
-1 con otro errno |
Otro error | Informar y cerrar |
0 no es un error: es el final normal de un stream. Es la única manera de saber que una
transmisión terminó. Un recv que no se revisa, y un 0 tratado como “nada todavía”, produce un
bucle infinito que consume toda la CPU.
El cliente
El cliente de wc_client.c usa getaddrinfo, que convierte un
nombre y un servicio en direcciones listas para usar. Es lo que hace que el programa funcione
con un nombre de dominio, con una dirección numérica, con IPv4 y con IPv6, sin una línea de
código específica para cada caso:
    struct addrinfo hints;
    memset(&hints, 0, sizeof hints);
    hints.ai_family = AF_UNSPEC;      // IPv4 o IPv6
    hints.ai_socktype = SOCK_STREAM;  // TCP

    struct addrinfo *results;
    int err = getaddrinfo(host, port, &hints, &results);
    if (err != 0) {
        fprintf(stderr, "getaddrinfo: %s\n", gai_strerror(err));
        return -1;
    }

    int fd = -1;
    for (struct addrinfo *ai = results; ai != NULL; ai = ai->ai_next) {
        fd = socket(ai->ai_family, ai->ai_socktype, ai->ai_protocol);
        if (fd == -1) {
            perror("socket");
            continue;
        }
        if (connect(fd, ai->ai_addr, ai->ai_addrlen) == 0) {
            break;
        }
        perror("connect");
        close_checked(fd);
        fd = -1;
    }
    freeaddrinfo(results);
    return fd;
Tres detalles:
getaddrinfodevuelve una lista. Un nombre puede tener varias direcciones, y se prueban en orden hasta que una funcione.getaddrinfono usaerrno. Devuelve su propio código de error, y se traduce congai_strerror. Por eso aquí no se usaperror.- El cliente no llama a
bind. Al hacerconnect, el kernel elige un puerto libre.
Después de enviar todo, el cliente avisa que terminó, pero sin cerrar el socket, porque aún tiene que leer la respuesta:
    // Avisamos que ya no enviaremos más; el socket sigue abierto para recibir.
    if (shutdown(fd, SHUT_WR) == -1) {
        perror("shutdown");
        close_checked(fd);
        return EXIT_FAILURE;
    }
shutdown(fd, SHUT_WR) hace que TCP envíe un FIN: es un cierre a medias. Del lado del
servidor, recv devuelve 0. Es el primer ejemplo de una solución al problema central que
veremos en un momento: ¿cómo sabe el servidor dónde termina el mensaje? Aquí, porque la
dirección del cliente al servidor se cierra.
Correrlo y ver el handshake
$ make
$ build/wc_server 9202 &
escuchando en el puerto 9202
$ printf 'hola mundo\nsegunda linea\n' | build/wc_client 127.0.0.1 9202
cliente 127.0.0.1:62470
bytes=25 words=4 lines=2
Con el puerto 0, el sistema elige uno libre, y el programa lo imprime. Es lo que hacen las
pruebas para no chocar con nadie. Ahora capturemos el tráfico. Estamos en la interfaz lo, en
la que también pasa el tráfico de otros programas, así que siempre se usa un filtro por puerto:
$ tcpdump -i lo -nn -S 'tcp port 9202'Esta es la captura de otra corrida igual, con el cliente en otro puerto temporal. Cortamos las marcas de tiempo, las opciones y el IP del inicio de cada línea, para que se lea mejor:
127.0.0.1.57616 > 127.0.0.1.9202: Flags [S], seq 3716357409, win 65495, options [mss 65495,...], length 0
127.0.0.1.9202 > 127.0.0.1.57616: Flags [S.], seq 3253770950, ack 3716357410, win 65483, options [mss 65495,...], length 0
127.0.0.1.57616 > 127.0.0.1.9202: Flags [.], ack 3253770951, win 512, length 0
127.0.0.1.57616 > 127.0.0.1.9202: Flags [P.], seq 3716357410:3716357435, ack 3253770951, win 512, length 25
127.0.0.1.9202 > 127.0.0.1.57616: Flags [.], ack 3716357435, win 512, length 0
127.0.0.1.57616 > 127.0.0.1.9202: Flags [F.], seq 3716357435, ack 3253770951, win 512, length 0
127.0.0.1.9202 > 127.0.0.1.57616: Flags [P.], seq 3253770951:3253770976, ack 3716357436, win 512, length 25
127.0.0.1.57616 > 127.0.0.1.9202: Flags [.], ack 3253770976, win 512, length 0
127.0.0.1.9202 > 127.0.0.1.57616: Flags [F.], seq 3253770976, ack 3716357436, win 512, length 0
127.0.0.1.57616 > 127.0.0.1.9202: Flags [.], ack 3253770977, win 512, length 0
Las tres primeras líneas son el handshake: [S] es SYN, [S.] es SYN más ACK, y [.] es
un ACK solo. Cada lado anuncia su número de secuencia inicial, y el otro lo confirma sumando 1.
Ninguna de estas líneas llevó datos (length 0). Después:
- La línea 4 son los 25 bytes (
seqde 3716357410 a 3716357435), con[P.], PSH y ACK. - La línea 6 es el FIN del
shutdown. Noten que solo cierra una dirección: el servidor responde después, en la línea 7. - Las últimas dos líneas cierran la otra dirección.
¿Quién hace el handshake? connect lo dispara en el cliente y espera a que termine. En el
servidor lo hace el kernel: si el socket está en listen, el kernel completa el handshake
por su cuenta, y la conexión espera en una cola a que el programa llame a accept. Por eso
accept no tiene nada que ver con el handshake, salvo recoger su resultado. Lo comprobaremos en
un momento.
El MSS que anuncian es el tamaño máximo de datos por segmento: 65 495 en lo, cuyo MTU es
grande. Sobre los enlaces de 1500 bytes de la topología, el SYN anuncia otra cosa:
IP 10.2.1.10.49050 > 10.2.4.10.9000: Flags [S], seq 2944180868, win 64240, options [mss 1460,sackOK,TS val 1153463626 ecr 0,nop,wscale 7], length 01460 son los 1500 bytes de MTU menos los 20 de la cabecera IPv4 y los 20 de la cabecera TCP. Lo estudiaremos con cuidado en la semana 10.
Error común: recv no devuelve un mensaje
Llegamos al error más frecuente de la programación con sockets.
Definición. TCP ofrece un stream de bytes: una secuencia continua y ordenada de bytes, sin fronteras. TCP garantiza que recibirá los mismos bytes en el mismo orden. No garantiza que un
sendcorresponda a unrecv.
Medimos. chunk_send.c envía bloques con un send por bloque y
chunk_recv.c imprime cuánto devuelve cada recv. Enviamos
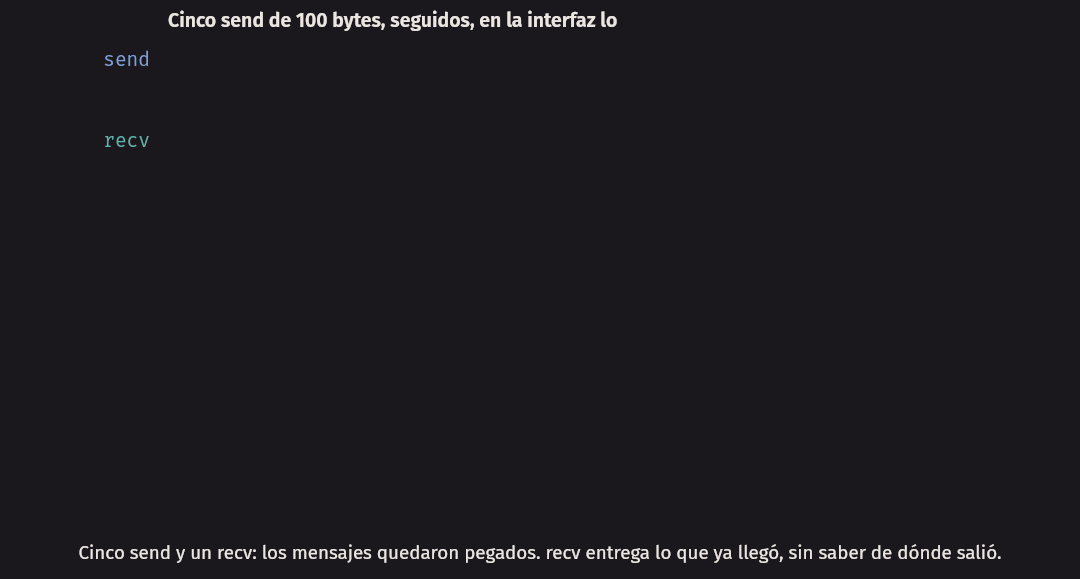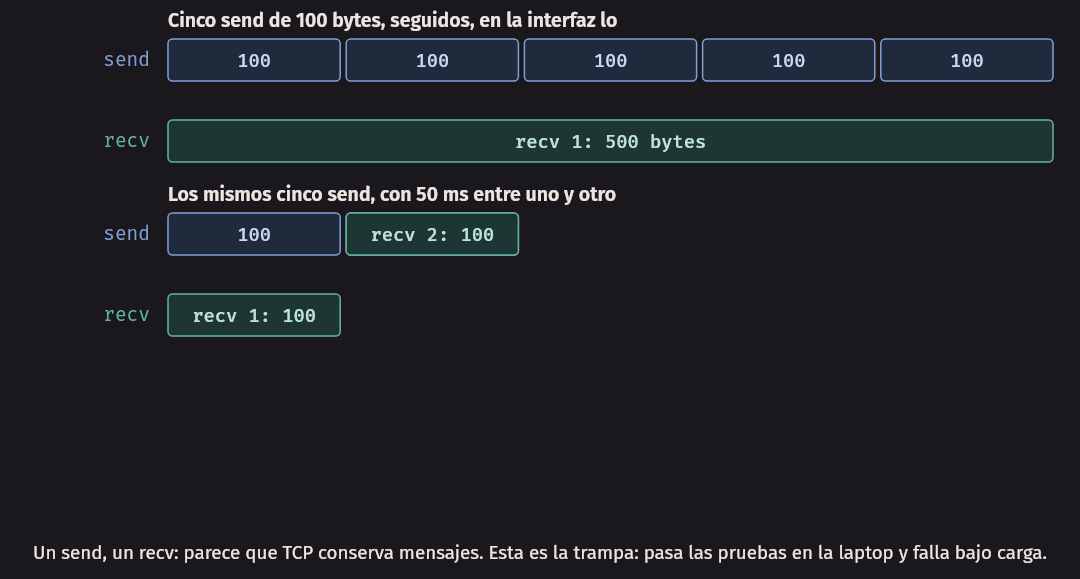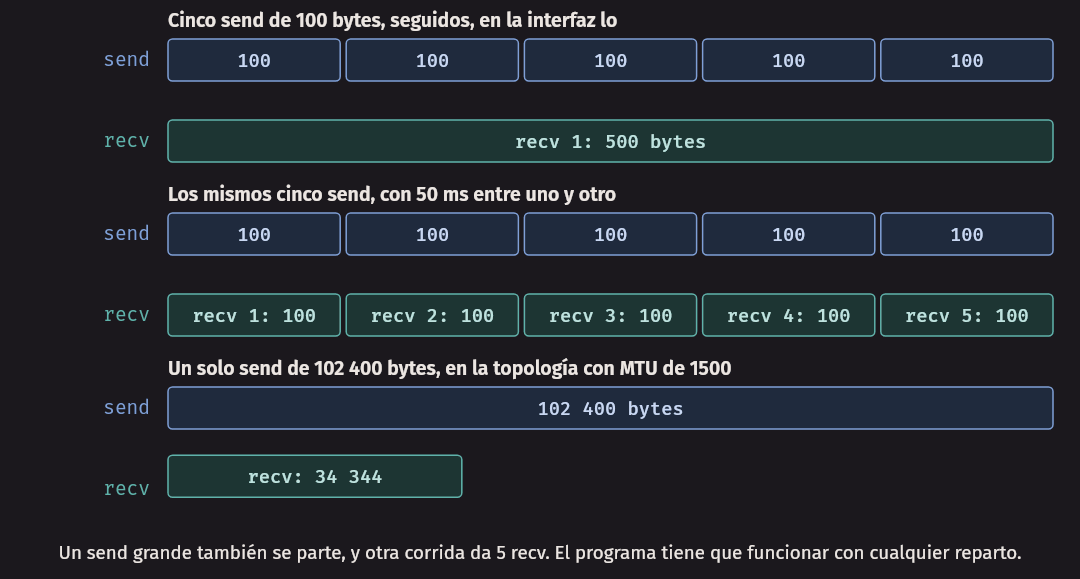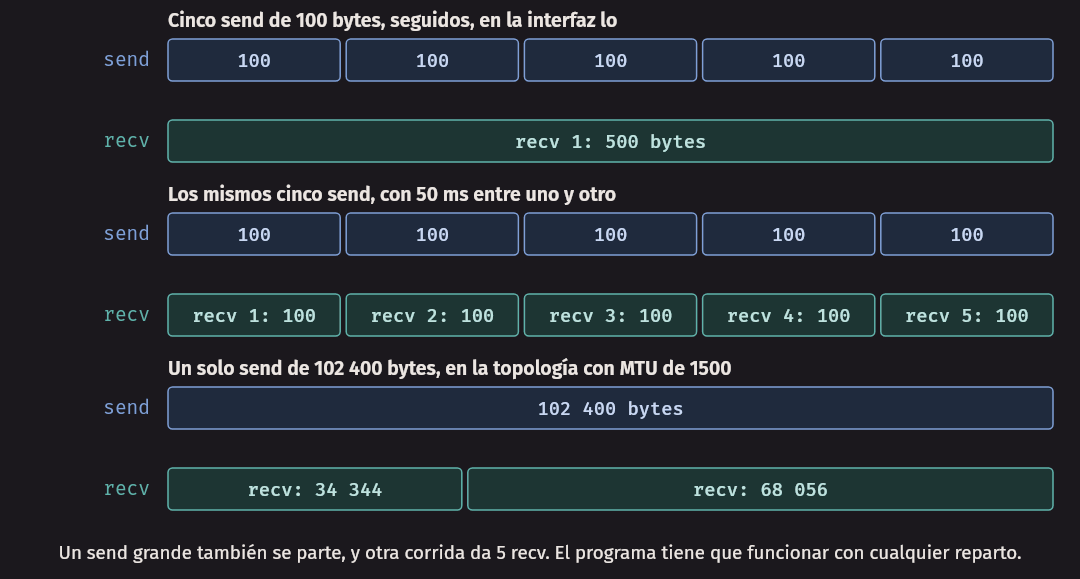
cinco bloques de 100 bytes:
$ build/chunk_recv -v 9204 &
escuchando en el puerto 9204
$ build/chunk_send 127.0.0.1 9204 100 5
enviados: 5 llamadas a send, 500 bytes
recv 1: 500 bytes
recv: 1 llamadas, 500 bytes, menor 500, mayor 500
bytes fuera de lugar: 0
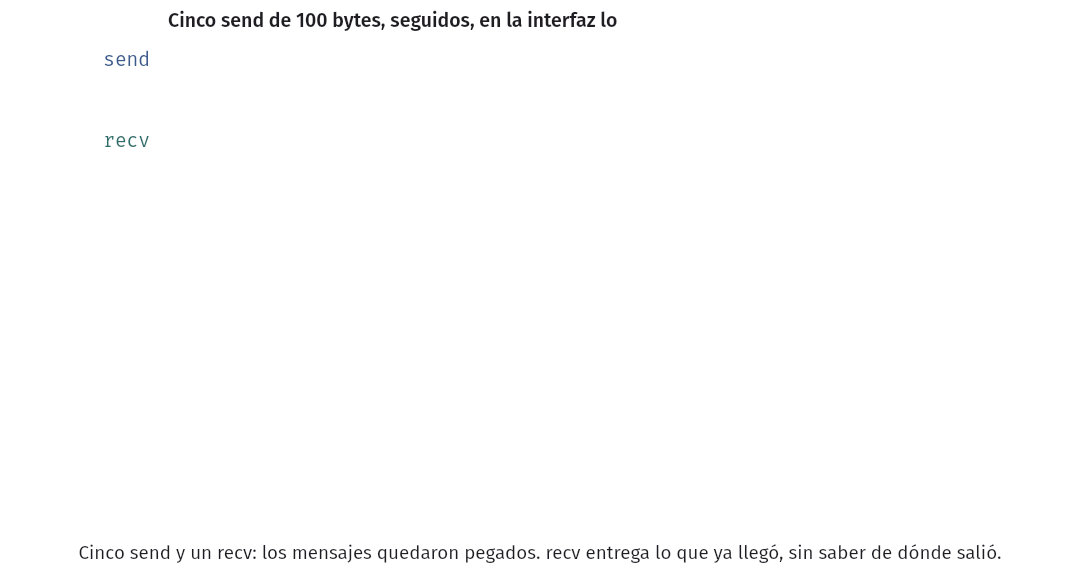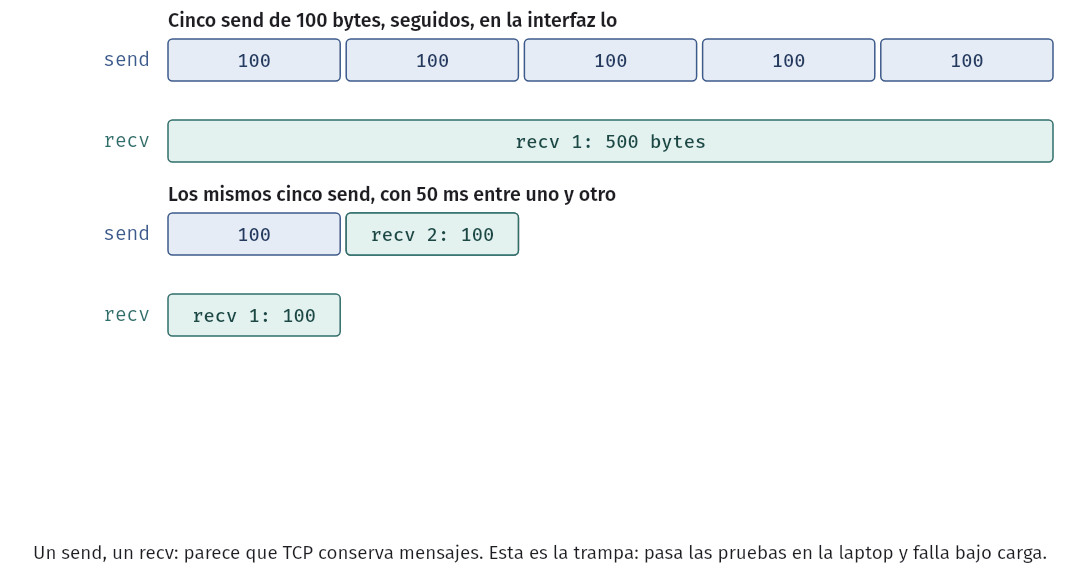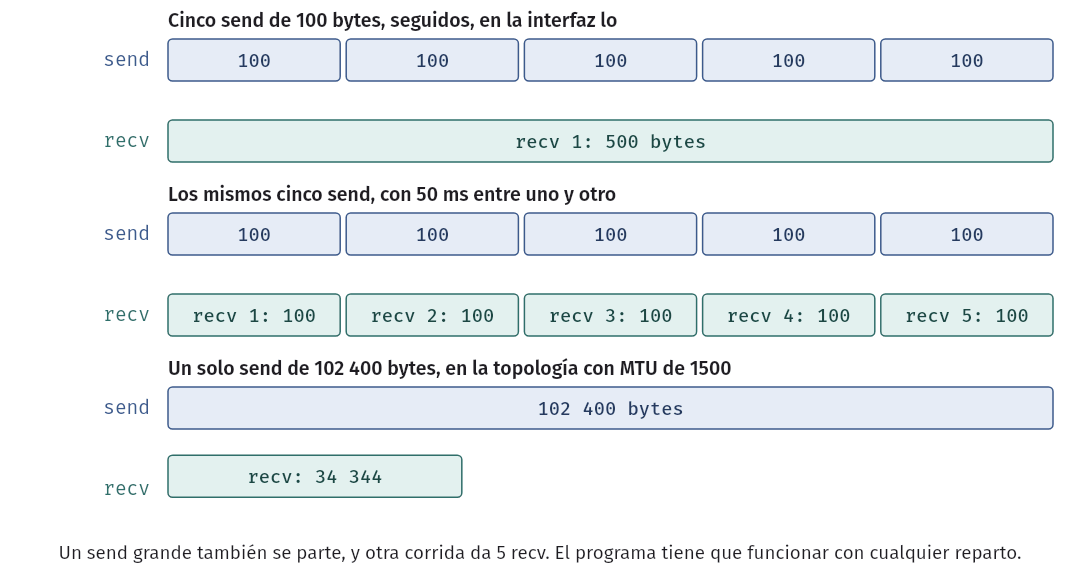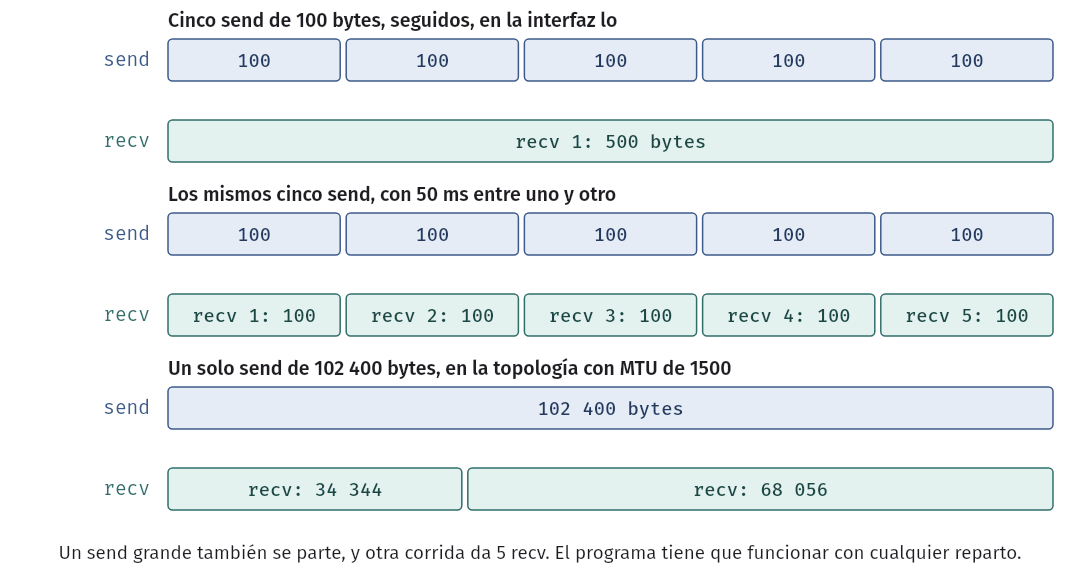
Cinco send y un recv, y los mensajes quedaron pegados. Ahora, lo contrario, con una pausa de
50 ms entre cada send:
$ build/chunk_recv -v 9205 &
escuchando en el puerto 9205
$ build/chunk_send -g 50 127.0.0.1 9205 100 5
recv 1: 100 bytes
recv 2: 100 bytes
recv 3: 100 bytes
recv 4: 100 bytes
recv 5: 100 bytes
enviados: 5 llamadas a send, 500 bytes
recv: 5 llamadas, 500 bytes, menor 100, mayor 100
bytes fuera de lugar: 0
Este resultado es la trampa. Un send y un recv: parece que TCP conserva los mensajes. Un
programa escrito así pasa todas sus pruebas en la laptop, donde el cliente escribe despacio, y
falla en producción, bajo carga.
Y un send grande también se puede partir. Enviamos 102 400 bytes con una sola llamada, en
distintas situaciones. El buffer de chunk_recv es de 1 MiB:
| Situación | Llamadas a recv que devuelven datos |
Menor | Mayor |
|---|---|---|---|
Interfaz lo |
1 | 102 400 | 102 400 |
| Topología, MTU de 1500 bytes | 2 | 34 344 | 68 056 |
| Topología, otra corrida | 5 | 7 240 | 40 544 |
| Topología, con 10 % de pérdida | 22 | 1 040 | 20 272 |
| Topología, con 10 % de pérdida, otra corrida | 25 | 1 448 | 23 168 |
Son mediciones reales, y dependen de la máquina y del momento. No hay un número correcto. La
misma llamada y los mismos bytes se reparten distinto cada vez. Esto responde una pregunta
frecuente de examen: si un cliente envía 3000 bytes con un solo send, ¿cuántos recv necesita
el servidor? Entre 1 y 3000. Cualquier valor es posible, y el programa tiene que funcionar
con todos.
Además, el tamaño del buffer de recv pone un piso. Con un buffer de 4096 bytes, como el de
wc_service.c, 102 400 bytes necesitan al menos 102 400 / 4096 = 25 llamadas. No importa cómo
lleguen.
Hay un bug muy parecido en un lugar menos obvio: contar palabras. Si un recv termina en hola mu y el siguiente empieza con ndo, contar las palabras de cada pedazo por separado da 3 en
vez de 2. Por eso wc_update guarda en su estado si el pedazo anterior terminó a la mitad de
una palabra:
void wc_update(struct wc_counts *counts, const char *buf, size_t n) {
    for (size_t i = 0; i < n; i++) {
        unsigned char c = (unsigned char)buf[i];
        counts->bytes++;
        if (c == '\n') {
            counts->lines++;
        }
        if (isspace(c)) {
            counts->in_word = false;
        } else if (!counts->in_word) {
            counts->in_word = true;
            counts->words++;
        }
    }
}
Idea clave. Cualquier cosa que analice un stream tiene que poder detenerse en cualquier byte y seguir después. Si el protocolo necesita mensajes, los mensajes los pone su programa: TCP no los ve.
Cómo poner fronteras: framing
Delimitar los mensajes dentro de un stream se llama framing. Hay cuatro formas de hacerlo:
| Método | Cómo se sabe dónde termina | Ejemplo | Ventajas y riesgos |
|---|---|---|---|
| Cerrar la conexión | recv devuelve 0 |
HTTP/1.0, wc_server |
Muy simple. Un solo mensaje por conexión. Si el emisor muere, su kernel igual envía FIN: un mensaje cortado parece completo |
| Tamaño fijo | Cada mensaje mide k bytes | Celdas de ATM, chunk_recv -x |
Muy simple. Solo sirve si todos miden igual |
| Delimitador | Un byte especial, como \n |
SMTP, cabeceras de HTTP, tally_server |
Se lee con herramientas de texto. Los datos no pueden contener el delimitador, salvo que se escape |
| Largo al inicio | Una cabecera dice cuántos bytes siguen | TLS, HTTP/2, DNS sobre TCP | Datos arbitrarios. Hay que validar el largo |
Los dos primeros se ven en los programas de esta sección. Para los otros necesitamos una
herramienta: leer exactamente n bytes. Es recv_all, de
io_util.c:
ssize_t recv_all(int fd, void *buf, size_t n) {
    char *p = buf;
    size_t got = 0;
    while (got < n) {
        ssize_t r = recv(fd, p + got, n - got, 0);
        if (r == -1) {
            if (errno == EINTR) {
                continue;
            }
            perror("recv");
            return -1;
        }
        if (r == 0) {
            break;  // el otro extremo cerró
        }
        got += (size_t)r;
    }
    return (ssize_t)got;
}
Si devuelve menos de n, el otro extremo cerró a la mitad. No hay que tratar eso igual que un
mensaje completo. Con registros de tamaño fijo, la opción -x de chunk_recv reconstruye los
mensajes, sin importar cómo lleguen:
$ build/chunk_recv -v -x 100 9206 &
escuchando en el puerto 9206
$ build/chunk_send 127.0.0.1 9206 100 5
enviados: 5 llamadas a send, 500 bytes
registro 1: 100 bytes
registro 2: 100 bytes
registro 3: 100 bytes
registro 4: 100 bytes
registro 5: 100 bytes
recv_all: 5 llamadas, 500 bytes, menor 100, mayor 100
bytes fuera de lugar: 0
Es el mismo envío que antes llegó pegado en un recv de 500 bytes.
Un formato con largo al inicio
Un formato con largo al inicio se describe como una tabla de campos, como en un RFC. Un ejemplo muy usado es TLV (type, length, value). Es el que usarán en el laboratorio:
| Campo | Tamaño | Contenido |
|---|---|---|
kind |
1 byte | Tipo de registro |
length |
2 bytes | Largo de value, sin signo y en orden de red |
value |
length bytes |
Los datos |
Para leer un registro, se lee primero la cabecera de tamaño fijo con recv_all, luego se
convierte length con ntohs y después se lee value, también con recv_all. El mensaje de 5
bytes hola\n, con kind igual a 1, viaja como 8 bytes:
 01  00 05  68 6f 6c 61 0a
 ^   ^----  ^-------------
 |   |      value: "hola\n"
 |   length: 5, en orden de red
 kind: 1
Hay tres decisiones que conviene pensar al diseñar un formato de este tipo:
- El tamaño de
lengthfija el máximo. Con 2 bytes, un registro llega a 65 535 bytes. Es un límite por construcción. - El largo viene de la red, y no se debe creer. Con un campo de 4 bytes, alguien puede
anunciar 4 GiB. Si el programa llama a
malloccon ese número, le entrega la memoria al atacante. Se valida contra un máximo definido antes de reservar nada. - Hay que definir qué pasa cuando algo no calza. ¿Qué se hace con un
kinddesconocido? ¿Y si el cliente se va a la mitad de un registro? Esto es parte del protocolo, y debe escribirse.
En la práctica. En P0 usarán estas ideas con un formato y un programa distintos, y con el agregado difícil de combinarlas con
poll. Allí no se puede usarrecv_all, porque se quedaría esperando a un cliente mientras los demás no reciben atención. Lean el enunciado después de la sección depoll.
Error común: send también escribe menos
El problema simétrico: send devuelve cuántos bytes aceptó, y pueden ser menos de los pedidos.
send no envía nada por la red: copia los bytes a un buffer del kernel, y TCP los envía
cuando puede. Si el buffer está lleno porque el receptor no lee o porque la red va lenta, hay
dos casos. Un socket no bloqueante copia lo que quepa y regresa. Un socket bloqueante espera,
normalmente hasta copiar todo, pero puede regresar antes si una señal lo interrumpe o si se
configuró un plazo. short_send.c conecta un socket a un
receptor que nunca lee y pide enviar 8 MiB:
$ build/short_send
no bloqueante, 1.ª llamada: se pidieron 8388608 bytes y send devuelve 2625195
no bloqueante, 2.ª llamada: send devuelve -1, errno = Resource temporarily unavailable
bloqueante con SO_SNDTIMEO: se pidieron 8388608 bytes y send devuelve 2625195
El número depende de los buffers del sistema; su computadora mostrará otro. La primera llamada
copió cerca de 2,6 MB. La segunda no pudo copiar nada y devolvió EAGAIN, cuyo texto es el que
ven. Si el programa ignorara ese valor, perdería más de 5 MB sin enterarse. Por eso todos los
programas de la semana envían con send_all:
int send_all(int fd, const void *buf, size_t n) {
    const char *p = buf;
    size_t left = n;
    while (left > 0) {
        // MSG_NOSIGNAL: si el otro extremo cerró, recibimos EPIPE y no la señal
        // SIGPIPE, que por defecto mataría al proceso.
        ssize_t sent = send(fd, p, left, MSG_NOSIGNAL);
        if (sent == -1) {
            if (errno == EINTR) {
                continue;
            }
            perror("send");
            return -1;
        }
        p += sent;
        left -= (size_t)sent;
    }
    return 0;
}
Recuerden también el experimento de la máquina colgada: que send tenga éxito no significa
que los datos llegaron. Solo significa que quedaron en un buffer local.
Error común. Escribir a un socket cuyo otro extremo cerró genera la señal
SIGPIPE, que por defecto termina el proceso, sin ningún mensaje. Un cliente que se desconecta en mal momento tumbaría al servidor. Se evita conMSG_NOSIGNALen cadasend, o ignorando la señal consigaction.
Y en general: toda llamada se revisa. Estos son los errores que van a ver:
errno |
Mensaje de perror |
Causa habitual |
|---|---|---|
ECONNREFUSED |
Connection refused | Nadie escucha en ese puerto |
EADDRINUSE |
Address already in use | bind a un puerto ocupado |
ECONNRESET |
Connection reset by peer | El otro extremo abortó la conexión |
EPIPE |
Broken pipe | Se escribió en una conexión ya cerrada |
ETIMEDOUT |
Connection timed out | TCP se rindió tras muchos reintentos |
EAGAIN |
Resource temporarily unavailable | No hay espacio o datos, en un socket no bloqueante o con plazo |
EINTR |
Interrupted system call | Una señal interrumpió la llamada; se repite |
UDP: datagramas, sin conexión
UDP tiene otra API porque ofrece otro servicio. No hay listen ni accept, porque no hay
conexión. Un mismo socket habla con todos. time_server.c
responde a cada datagrama con la hora:
    // No hay listen ni accept: un solo socket recibe de todos los clientes.
    for (;;) {
        char request[512];
        struct sockaddr_in peer;
        socklen_t peer_len = sizeof peer;
        ssize_t n = recvfrom(fd, request, sizeof request, 0,
                             (struct sockaddr *)&peer, &peer_len);
recvfrom entrega los datos y además la dirección de quien los envió. Así contesta el
servidor: no llama a accept porque no existe una conexión que aceptar, y sabe a quién
responder porque cada datagrama trae su origen. La respuesta usa esa misma dirección:
        // Cada datagrama lleva su destino: la dirección de quien preguntó.
        if (sendto(fd, reply, strlen(reply), 0,
                   (struct sockaddr *)&peer, peer_len) == -1) {
            perror("sendto");
        }
$ build/time_server 9207 &
escuchando en el puerto 9207
$ build/time_client 127.0.0.1 9207
enviados 5 bytes
datagrama de 5 bytes desde 127.0.0.1:59227
hora: 06:57:20 UTCLa línea de datagrama la imprime el servidor, porque corre en la misma terminal.
UDP sí conserva las fronteras
UDP tiene una diferencia que simplifica la vida: un sendto es un datagrama, y un recvfrom
devuelve un datagrama entero. Si el buffer es muy chico, el resto se descarta. En la medición
con pérdidas, cada recv devolvió exactamente 200 bytes, lo mismo que se envió: tamaño de cada recv: 200 bytes, 0 distintos. No hace falta framing, y por eso un datagrama es un mensaje. El
precio ya lo vimos: 97 datagramas perdidos y 210 fuera de orden, sin que nadie avisara. Si la
aplicación necesita algo de eso, ella misma lo implementa. Es lo que hará rimay en P3.
| TCP | UDP | |
|---|---|---|
| Unidad | Stream de bytes | Datagrama |
| Fronteras de mensaje | No | Sí |
| Conexión | Handshake, accept, un socket por cliente |
No; un socket para todos |
| Pérdida | La oculta, retransmitiendo | La deja pasar |
| Orden | Garantizado | No |
| Control de congestión | Sí | No; es responsabilidad del programa |
| Lectura típica | Bucle hasta completar | Un recvfrom, un mensaje |
| Plazo para esperar | Opcional | Casi siempre hace falta |
¿Por qué alguien elegiría UDP? Porque no todas las aplicaciones quieren lo que TCP impone. DNS hace una pregunta y recibe una respuesta: un handshake sería un RTT de más. Una llamada de voz prefiere perder una muestra que recibirla tarde. Y QUIC necesita un sustrato sobre el cual construir su propio transporte, sin el permiso de ningún kernel ni router.
Con el servidor apagado
Probemos un experimento que parece ilógico. Apagamos el servidor y corremos el cliente:
$ build/time_client -w 500 127.0.0.1 9207
enviados 5 bytes
sin respuesta después de 500 ms
sendto tuvo éxito. Claro: igual que en TCP, enviar solo significa entregar los bytes al
sistema, y sin handshake nadie preguntó si había alguien. El cliente solo se da cuenta porque se
cansó de esperar. Sin el plazo de SO_RCVTIMEO, recv esperaría para siempre. Por eso este
programa lo configura.
Ahora, la misma prueba con -c, que llama a connect antes de enviar:
$ build/time_client -c -w 500 127.0.0.1 9207
enviados 5 bytes
recv: Connection refused
connect en UDP no envía nada a la red. Solo guarda en el socket una dirección por defecto y
filtra lo que llega, para aceptar solo de ella. Pero tiene otro efecto. Miremos lo que viajó en
las dos corridas:
IP 127.0.0.1.59814 > 127.0.0.1.9207: UDP, length 5
IP 127.0.0.1 > 127.0.0.1: ICMP 127.0.0.1 udp port 9207 unreachable, length 41
IP 127.0.0.1.63717 > 127.0.0.1.9207: UDP, length 5
IP 127.0.0.1 > 127.0.0.1: ICMP 127.0.0.1 udp port 9207 unreachable, length 41
La red hizo lo mismo en ambos casos. El host destino recibió el datagrama, no encontró un socket en ese puerto, y respondió con un mensaje ICMP port unreachable. La diferencia es qué hace el kernel del cliente con ese ICMP:
- Sin
connect, el socket podría estar hablando con muchos destinos a la vez. La API desendtoyrecvfromno tiene cómo decirle al programa a cuál de ellos se refiere el error. Por eso, Linux lo descarta, salvo que se pida otra cosa con opciones avanzadas. - Con
connect, el socket tiene un único destino, y el error se puede atribuir sin ambigüedad. El kernel lo guarda y lo entrega en la siguiente llamada sobre el socket, seasendorecv, comoECONNREFUSED.
Noten el orden en la salida: send tuvo éxito y el error apareció en recv, que es la llamada
siguiente. No es un error de ese send, sino de uno anterior.
Error común. Creer que
connectda confiabilidad a UDP. No agrega ninguna: no hay handshake, ni retransmisión, ni garantía. El aviso depende de que un ICMP regrese, y muchos firewalls los filtran. En Internet, un servidor apagado puede verse igual que uno lento: silencio. La única forma segura de saber que alguien recibió un datagrama es que responda.
¿Cuántas cosas no hizo UDP?
Revisen el orden de llamadas de time_server.c: socket, bind, recvfrom, sendto. Y
compárenlo con el servidor TCP. Eso es todo el protocolo: RFC
768 tiene tres páginas, y la cabecera que vimos arriba
solo agrega al datagrama de IP los puertos, el largo y un checksum. RFC 768 lo dice en su
introducción: “delivery and duplicate protection are not guaranteed”.
Atender a varios clientes
wc_server atiende a un cliente a la vez. Cuando llega un segundo, el kernel completa su
handshake, y su conexión queda en la cola de accept, sin que nadie lo atienda. Medimos: un
cliente A queda conectado durante 3 segundos sin terminar, y mientras tanto otro cliente B envía
hola:
$ build/wc_server 9302 &
escuchando en el puerto 9302
$ (sleep 3) | nc -N 127.0.0.1 9302 &
cliente 127.0.0.1:55196
$ time (echo hola | build/wc_client 127.0.0.1 9302)
bytes=0 words=0 lines=0
cliente 127.0.0.1:55206
bytes=5 words=1 lines=1

real	0m2.698s
user	0m0.000s
sys	0m0.003s
B tardó 2,7 segundos en recibir una respuesta que el servidor calcula en microsegundos. La línea bytes=0 es la respuesta para A, que terminó primero, y recién entonces el servidor imprime cliente para B. B ya estaba conectado todo ese tiempo: su connect regresó de inmediato, porque el handshake lo hizo el kernel. Un cliente
lento, o malicioso, detiene a todos los demás. Con Internet como red, esto no es aceptable. Hay
tres soluciones clásicas.
Un proceso por cliente
wc_fork_server.c llama a fork después de cada accept.
El hijo atiende a ese cliente y termina:
        pid_t pid = fork();
        if (pid == -1) {
            perror("fork");
            close_checked(conn);
            continue;
        }
        if (pid == 0) {
            // Hijo: solo necesita la conexión.
            close_checked(listener);
            int rc = wc_serve_client(conn);
            close_checked(conn);
            _exit(rc == 0 ? EXIT_SUCCESS : EXIT_FAILURE);
        }
        // Padre: solo necesita el socket que escucha.
        close_checked(conn);
La misma medición:
$ build/wc_fork_server 9302 &
escuchando en el puerto 9302
$ (sleep 3) | nc -N 127.0.0.1 9302 &
$ time (echo hola | build/wc_client 127.0.0.1 9302)
bytes=5 words=1 lines=1

real	0m0.002s
user	0m0.000s
sys	0m0.001s
bytes=0 words=0 lines=0
Noten el close en ambos: después de fork, padre e hijo tienen copias del descriptor. La
conexión no se cierra hasta que se cierran todas, y un descriptor olvidado en el padre impediría
que el cliente reciba su FIN. Noten también que ignoramos SIGCHLD, para no dejar procesos
zombis.
Es simple y aísla a los clientes: un error de memoria en un hijo no afecta a los demás. Pero cada cliente cuesta un proceso, y los procesos no comparten memoria. Un total común a todos, como el del servidor que viene a continuación, no se podría guardar en una variable.
Un hilo por cliente
Es parecido, usando pthread_create en vez de fork. Los hilos cuestan menos y comparten la
memoria, lo que resuelve el problema de la variable común pero crea otro: hay que protegerla con
un mutex. Su curso de sistemas operativos les da las herramientas. No lo usamos en esta clase:
el código de red es igual y no aporta nada nuevo.
Un solo hilo con poll
La tercera opción es muy distinta. Un solo hilo y una sola llamada que espera por todos los sockets a la vez.
Definición.
pollrecibe un arreglo de descriptores, cada uno con los eventos que nos interesan, y se bloquea hasta que al menos uno tenga algo. Al regresar, marca en cadareventslo que ocurrió. SiPOLLINestá activo, unrecvsobre ese descriptor no se bloqueará.
Lo usamos en tally_server.c, un marcador compartido con un
protocolo de líneas de texto, en el que \n es el delimitador. SUMA 5 agrega al total común y
TOTAL lo consulta. Y esta es la parte más importante de un servidor con poll, porque es lo
que cambia respecto de un servidor con hilos:
// Lo que el servidor recuerda de cada conexión. Con un solo hilo no hay una
// pila por cliente: la línea a medio llegar tiene que guardarse aquí.
struct client {
    char line[MAX_LINE];
    size_t used;
};
En un servidor por proceso o por hilo, el “dónde iba” de cada cliente se guarda solo: es la pila
y la línea de código en la que está esperando. Aquí no. Si recv devuelve SU, no podemos
quedarnos esperando el resto, porque otros clientes necesitan atención. Hay que guardar los dos
bytes en la estructura del cliente, volver a poll, y seguir cuando llegue más. Por eso,
programar con poll es programar una máquina de estados. Este es el ciclo:
    for (;;) {
        // Dormir hasta que algún socket tenga algo. Es el único punto de espera.
        if (poll(fds, count, -1) == -1) {
            if (errno == EINTR) {
                continue;
            }
            perror("poll");
            return EXIT_FAILURE;
        }

        // Recorremos de atrás hacia adelante: quitar un cliente mueve al último
        // a su lugar, y ese ya fue revisado.
        for (nfds_t i = count; i-- > 1;) {
            if ((fds[i].revents & (POLLIN | POLLERR | POLLHUP)) == 0) {
                continue;
            }
            char buf[512];
            ssize_t n = recv(fds[i].fd, buf, sizeof buf, 0);
            if (n == -1 && errno == EINTR) {
                continue;
            }
            if (n == -1) {
                perror("recv");
            }
            if (n <= 0 || handle_bytes(fds[i].fd, &clients[i], buf, (size_t)n) == -1) {
                close_checked(fds[i].fd);
                count--;
                fds[i] = fds[count];
                clients[i] = clients[count];
            }
        }
Cada recv lee una vez, lo que haya, y regresa. Nunca hay un bucle que espere a completar
algo. El socket que escucha también está en el arreglo, porque una conexión nueva se anuncia con
POLLIN. handle_bytes agrega los bytes al buffer del cliente y atiende cada línea completa.
Una corrida con dos clientes:
$ build/tally_server 9302 &
escuchando en el puerto 9302
Dos clientes corren a la vez. A suma 5, espera un segundo y pregunta el total. B suma 10 a la mitad de esa espera:
$ (echo 'SUMA 5'; sleep 1; echo TOTAL; sleep 1) | nc -N 127.0.0.1 9302    # cliente A
total 5
total 15
$ (sleep 0.5; echo 'SUMA 10'; sleep 1) | nc -N 127.0.0.1 9302 # cliente B
total 15Un total común, sin mutex: como hay un solo hilo, nadie más puede tocar la variable mientras
se usa.
Falta un peligro. ¿Qué pasa si un cliente no lee sus respuestas? En algún momento su buffer se
llena, y un send normal se bloquearía, deteniendo el único hilo y con él a todos los
clientes. tally_server elige una política simple:
// Envía sin bloquear. Si el cliente no lee y su buffer se llenó, se le corta:
// un cliente lento no puede detener a los demás. Otra política sería guardar
// la respuesta y esperar POLLOUT. Devuelve 0, o -1 si hay que cerrar.
static int reply_to(int fd, const char *text) {
    size_t len = strlen(text);
    ssize_t sent = send(fd, text, len, MSG_DONTWAIT | MSG_NOSIGNAL);
    if (sent == -1) {
        if (errno != EAGAIN && errno != EWOULDBLOCK) {
            perror("send");
        }
        return -1;
    }
    return (size_t)sent == len ? 0 : -1;
}
Cortar al cliente está bien para un marcador con respuestas de pocos bytes, pero no para un
servicio que deba entregar todo aunque el cliente sea lento. Entonces hay que guardar lo
pendiente en un buffer por cliente, pedir POLLOUT en events y seguir enviando cuando el
socket tenga espacio. El comentario lo dice, y es lo que tendrán que hacer ustedes en P0.
Error común. Dentro de un servidor con
poll, cualquier llamada que se bloquee detiene a todos:recv_all, unsendsobre un socket bloqueante con el buffer lleno, unsleep. La regla es que en un mismo ciclo se hace solo lo que no espera.
En la práctica.
pollrevisa todo el arreglo en cada llamada, y su costo crece con el número de sockets. Con miles de conexiones, los servidores de verdad usanepollen Linux okqueueen BSD y macOS, con la misma idea. Además, el socket que escucha se suele marcar como no bloqueante, porque un cliente puede abortar la conexión entre el aviso depolly la llamada aaccept, y eseacceptse quedaría esperando. Nuestro ejemplo no lo hace, para mantenerse corto. Nginx y Redis siguen este modelo; una base de datos como PostgreSQL usa un proceso por conexión.
| Un proceso por cliente | Un hilo por cliente | Un hilo con poll |
|
|---|---|---|---|
| Dónde vive el estado del cliente | Pila y memoria del proceso | Pila del hilo | Una estructura que ustedes mantienen |
| Costo de cada cliente | Alto | Medio | Lo que ocupe su estructura |
| Estado común | Difícil: requiere memoria compartida | Fácil, con mutex | Fácil, sin mutex |
| Un error de memoria | Afecta a un cliente | Afecta a todos | Afecta a todos |
| Usa varios núcleos de CPU | Sí | Sí | No, salvo con varios procesos |
| Una llamada que se bloquea | Solo afecta a ese cliente | Solo afecta a ese cliente | Detiene a todos |
| Dificultad de programar | Baja | Media, por la sincronización | Media, por la máquina de estados |
SO_REUSEADDR y Address already in use
Todos ustedes verán este error. Reinician su servidor y:
bind: Address already in use¿Quién tiene ese puerto, si el servidor anterior ya murió? La conexión que dejó. Cuando un lado de una conexión TCP cierra primero, su socket no desaparece. Se queda un tiempo en el estado TIME_WAIT, en caso de que el último ACK se haya perdido y al otro lado le toque reenviar su FIN, y para que los segmentos atrasados de esta conexión no se confundan con los de otra nueva que use los mismos puertos. En Linux, dura 60 segundos.
reuse_demo.c atiende a un cliente, cierra primero y termina.
El programa ya no existe, pero la conexión sigue allí:
$ build/reuse_demo -r 9222 &
escuchando en el puerto 9222
$ nc -d 127.0.0.1 9222
chau
$ ss -tan state time-wait '( sport = :9222 )'
Recv-Q Send-Q Local Address:Port Peer Address:Port
0      0          127.0.0.1:9222    127.0.0.1:57682
Sin SO_REUSEADDR, no se puede volver a hacer bind a ese puerto durante un minuto. Con la
opción en los dos servidores, sí:
$ build/reuse_demo 9222
bind: Address already in use
$ build/reuse_demo -r 9222 &
escuchando en el puerto 9222
Ese último servidor sigue esperando a un cliente, y lo usamos más abajo.
Dos precisiones, que salen de medir en Linux y que muchos textos omiten:
Los dos sockets deben tener la opción. La conexión en TIME_WAIT hereda la opción del socket
que la creó. Si el primer servidor corrió sin SO_REUSEADDR, un segundo servidor que sí la
tenga también falla:
$ build/reuse_demo 9232 &
escuchando en el puerto 9232
$ nc -d 127.0.0.1 9232
chau
$ build/reuse_demo -r 9232
bind: Address already in use
Por eso va en todo servidor desde la primera versión, antes de bind, como en wc_server.c. Si
olvidan ponerla, agregarla no arregla la corrida que ya pasó: toca esperar el minuto.
La opción no permite compartir un puerto en uso. Si otro proceso está escuchando, no ayuda:
$ build/reuse_demo -r 9222
bind: Address already in use
Este es el otro caso de la tabla de Solución de problemas del laboratorio:
un programa anterior sigue corriendo en segundo plano. Se busca con ss -ltnp 'sport = :9222',
que muestra qué proceso lo tiene.
Idea clave. En el servidor del ejemplo de
wc,wc_clientes quien cierra primero. Por eso TIME_WAIT suele quedar del lado del cliente, en un puerto temporal, sin molestar a nadie. El problema aparece cuando el servidor cierra primero, y sobre todo cuando lo matan con conexiones abiertas.
Laboratorio: un cliente y un servidor en C
Trabajen dentro del contenedor, en code/week-02/. La guía de la semana enumera los pasos. Como
P0 pide un servicio de eco, en este laboratorio trabajamos sobre el servicio de conteo y la
sala, que ejercitan lo mismo con otros programas. Sus archivos están en
lab/: cada uno es un esqueleto que compila y que imprime
falta implementar. Los comprueban con:
$ make test-labFallará hasta que terminen. make test corre el resto de los programas de la semana, y toma alrededor de un minuto, porque levanta la topología.
Las pruebas lanzan sus programas, así que hay un contrato que cumplir:
- Los servidores reciben
<puerto>como argumento, y las pruebas les pasan 0. Lo primero que imprimen debe ser la línea que daprint_bound_port, deio_util.c, después detcp_listen(o debind, con UDP). Así las pruebas se enteran del puerto. - El
Makefileenlazaio_util.cywc_service.ccon cada programa delab/. Pueden usarsend_all,recv_all,tcp_listenywc_update. - Cada paso indica los textos exactos que revisan las pruebas:
recv: N,bytes=... words=... lines=...ysin respuesta.
Paso 1. Correr y capturar. Compilen con make y corran wc_server y wc_client como en
este capítulo. Capturen con tcpdump -i lo -nn -S 'tcp port 9202', identifiquen el handshake y
los dos FIN. Respondan: ¿qué lado cerró primero? ¿Qué número de secuencia corresponde al primer
byte de datos, y por qué es el siguiente al del SYN?
Paso 2. 100 KB y un contador. En lab/wc_big_client.c, cambien el cliente para que envíe
102 400 bytes (o los que indique el tercer argumento) en una sola llamada a send_all. En
lab/wc_counting_server.c, copien el servidor y agreguen un contador de llamadas a recv que
devuelven datos; por cada cliente, impriman una línea recv: N antes de responder. Córranlo varias veces. Luego, cambien el tamaño del buffer y vuelvan a medir. ¿Por qué con un buffer de 4096 bytes el mínimo es 25? Déjenlo en 4096 al terminar, porque las pruebas revisan ese mínimo.
Paso 3. Un formato con largo al inicio. El servicio de conteo solo atiende un pedido por
conexión, porque usa el cierre como frontera. Cámbienlo para que atienda varios por conexión, en
lab/wcf_server.c y lab/wcf_client.c, con registros de este formato:
| Campo | Tamaño | Contenido |
|---|---|---|
kind |
1 byte | 1 = TEXT, 2 = COUNTS, 3 = ERROR |
length |
2 bytes | Largo de value, sin signo y en orden de red |
value |
length bytes |
Según kind |
Las reglas son estas:
- Por cada TEXT, el servidor responde un COUNTS, cuyo
valueson tres enteros de 4 bytes en orden de red: bytes, palabras y líneas de ese registro. - Si
kindno es 1, responde un ERROR, con un texto envalue, y cierra la conexión. - Si un cliente se va a la mitad de un registro, el servidor no se cae, y atiende al siguiente.
wcf_clientenvía cada línea de la entrada estándar como un TEXT, e imprimebytes=... words=... lines=....
Pueden probar su servidor sin tener todavía el cliente. El comando siguiente envía hola\n y
muestra la respuesta, que debe contener exactamente estos bytes: 02, el largo 00 0c (12) y
los tres contadores 5, 1 y 1. La segunda prueba manda un kind igual a 9.
$ printf '\001\000\005hola\n' | nc -N 127.0.0.1 9302 | hexdump -C
00000000  02 00 0c 00 00 00 05 00  00 00 01 00 00 00 01     |...............|
0000000f
$ printf '\011\000\002ab' | nc -N 127.0.0.1 9302 | hexdump -C
00000000  03 00 10 74 69 70 6f 20  64 65 73 63 6f 6e 6f 63  |...tipo desconoc|
00000010  69 64 6f                                          |ido|
00000013
Las pruebas envían registros byte por byte y varios registros en un solo send. Si su programa
supone que un recv trae un registro, no las pasará. El texto de ERROR puede ser otro.
Paso 4. La versión con UDP. Escriban lab/wc_udp_server.c, que por cada datagrama responde
con la misma línea de texto que wc_server, y lab/wc_udp_client.c, que envía la entrada
estándar en un solo datagrama. Con la opción -c, el cliente debe llamar a connect. Su
cliente debe esperar un segundo: si no hay respuesta, imprime sin respuesta y termina con
código 2. Ante un error termina con código 1, usando perror. Con el servidor apagado,
pruébenlo con y sin -c, capturen con tcpdump -i lo -nn 'udp port 9302 or icmp' y expliquen
por qué el cliente no se entera, salvo con connect. ¿Por qué aquí no hizo falta el formato del
paso 3?
Paso 5. Dos clientes con poll. En lab/room_server.c, escriban una sala de conversación:
cada línea completa que envía un cliente les llega a todos los demás, con el prefijo
[n] , donde n identifica al cliente que la envió (puede ser su descriptor). Los bytes de una
línea incompleta se guardan hasta que llegue el \n. Partan de tally_server.c. Prueben con
dos terminales que usen nc. Respondan: ¿qué hace su servidor si un cliente no lee nunca?
Justifíquenlo.
Paso 6. Avancen con P0. Se entrega la próxima semana. El enunciado y las pruebas públicas están en su carpeta.
Resumen
- IP ofrece un servicio best effort. No promete entrega, tiempo, orden ni unicidad. Por ser tan pequeño, corre sobre cualquier enlace y no decide por las aplicaciones.
- El argumento end-to-end: una función que solo se puede hacer bien con el conocimiento de los extremos se hace en los extremos. Lo que la red aporte es una mejora de desempeño, no un requisito de corrección. Un intermediario con una falla dañó un archivo mientras TCP reportaba éxito, y solo el hash de extremo a extremo lo detectó.
- El reloj de arena: muchas aplicaciones y muchos enlaces, con IP en el centro. Reduce las adaptaciones de A × L a A + L, a cambio de que la cintura sea muy difícil de cambiar.
- Fate sharing: el estado de una conexión vive en los extremos. Matamos un router a la mitad de una conexión, y la conexión siguió. Un router guarda estado por prefijo, no por conexión.
- ATM y Frame Relay usan circuitos virtuales: estado por circuito en cada equipo, etiquetas cortas y, en ATM, celdas de 53 bytes. Perdieron frente a IP sobre Ethernet, y MPLS conserva las etiquetas debajo de IP.
- La IETF escribe los RFC, que no se modifican: se reemplazan. Hay que mirar
ObsoletesyUpdates. - Un socket es la interfaz entre un proceso y el transporte. Servidor TCP:
socket,bind,listen,accept. Cliente:getaddrinfo,socket,connect.acceptdevuelve un socket nuevo. - Los campos de varios bytes viajan en orden de red. Se usan
htons,ntohs,htonlyntohl. Un formato se define byte a byte, nunca copiando unastruct. - TCP es un stream: no hay fronteras.
recvpuede devolver cualquier cantidad, ysendpuede escribir menos de lo pedido. Hay que leer y escribir en un bucle, y definir un formato: cierre, tamaño fijo, delimitador o largo al inicio. - UDP conserva las fronteras, sin conexión ni garantías. El servidor responde a la dirección
que trae cada datagrama. Sin
connect, un cliente no se entera del ICMP que le avisa que no hay nadie. Conconnect, el error llega en la llamada siguiente. - Para varios clientes: un proceso, un hilo o un solo hilo con
poll. Conpoll, el estado de cada cliente lo mantiene el programa, y ninguna llamada puede bloquearse. Address already in usesuele deberse a TIME_WAIT, y se evita conSO_REUSEADDR, activo en los dos servidores. La opción no permite compartir un puerto que otro proceso está escuchando.
Ejercicios
-
Best effort. Den un ejemplo de cada una de las cinco cosas que IP no promete, y digan qué capa o programa se haría cargo en una descarga de archivo por HTTP.
-
End-to-end. Den un ejemplo de una función que, según el principio end-to-end, no debería hacerse solo en la red, distinto de la entrega confiable. ¿Cuándo sí conviene una ayuda en la red? Justifiquen con una cuenta.
-
Una cuenta de confiabilidad. Un camino tiene 10 enlaces y en cada uno se pierde el 2 % de los paquetes, de forma independiente. (a) ¿Qué probabilidad tiene un paquete de llegar? (b) Si cada enlace retransmite una vez cuando pierde un paquete, ¿qué probabilidad tiene ahora? (c) En este segundo caso, ¿sigue haciendo falta una comprobación en los extremos? ¿Por qué?
-
Circuitos y datagramas. ¿Qué diferencia a un circuito virtual de ATM de un datagrama de IP? ¿Qué estado guarda cada router o switch en cada caso? Una red tiene 2000 prefijos y por un router pasan 50 000 conexiones simultáneas: ¿cuántas entradas tendría la tabla con IP y con circuitos virtuales, si cada conexión usa un circuito?
-
Celdas. (a) Un paquete IP de 1500 bytes viaja sobre ATM, sin ninguna otra cabecera. ¿Cuántas celdas ocupa y qué fracción de lo transmitido es cabecera de ATM? (b) Calculen cuánto se tarda en llenar una celda de 32 bytes de datos y una de 64, a 64 kbit/s. ¿Qué lado de la discusión prefería cada una, y por qué?
-
Leer un RFC. Abran RFC 768. (a) ¿Qué valor mínimo puede tener el campo
Lengthy por qué? (b) ¿Es obligatorio el puerto de origen? (c) ¿Qué significa un checksum igual a cero? Abran RFC 2119 y expliquen la diferencia entre SHOULD y MUST con un ejemplo inventado por ustedes. -
recv. (a) ¿Qué devuelverecvcuando el otro extremo cierra la conexión? ¿Y cuando hay un error? (b) Un cliente envía 3000 bytes con una sola llamada asend. ¿Cuántas llamadas arecvpuede necesitar el servidor? Justifiquen. (c) ¿Qué ocurre con este código sirecvdevuelve 0, y cómo lo arreglarían?char buf[100]; while (total < 100) { total += recv(fd, buf + total, 100 - total, 0); } -
Orden de bytes. Un programa hace
addr.sin_port = 8080;, sinhtons, en una máquina little-endian. ¿En qué puerto escucha realmente? Hagan la cuenta. Comprueben conss -ltnen el contenedor. -
UDP. (a) ¿Por qué un servidor UDP no llama a
accept? ¿Cómo sabe a quién responder? (b) Un cliente UDP envía dos datagramas de 100 bytes. ¿Puede unrecvfromcon un buffer de 500 bytes devolver 200? ¿Y uno con buffer de 50 devolver el resto en el siguiente? Compruébenlo con un programa. (c) Modifiquenseq_sendpara que envíe conconnecty prueben sin receptor. ¿En qué momento aparece el error? ¿Aparece siempre? -
Elegir un framing. Elijan entre delimitador y largo al inicio para cada caso, y justifiquen: (a) un protocolo que un humano prueba con
nc, (b) un servicio de transferencia de imágenes, (c) un protocolo de mensajes pequeños entre sensores. ¿Cómo tendrían que cambiar el formato del paso 3 para enviar archivos de 10 GB? ¿Qué validación agregarían? -
poll. Dos líneas detally_server.cimportan más de lo que parece. (a) ¿Por qué el arreglo se recorre desde el último cliente hacia el primero? Den un caso en que el recorrido hacia adelante se salte a un cliente. (b) Cambienreply_topara que usesendnormal, sinMSG_DONTWAIT, y escriban una prueba que muestre que un cliente que no lee detiene a los demás. (c) ¿Cuánta memoria usatally_serversi tieneMAX_CLIENTSclientes? ¿Por qué no crece con cada mensaje? -
Diseño. Quieren agregar a su sala del paso 5 un registro de lo conversado, que se escribe en un disco lento. ¿Qué problema tiene llamar a
writedentro del ciclo depoll? Comparen tres soluciones: un hilo aparte para el disco, un buffer en memoria que se vacía de a pocos, y un proceso por cliente. Luego, relacionen su respuesta con el argumento end-to-end: si el cliente quiere estar seguro de que el mensaje quedó guardado, ¿de qué le sirve un ACK de TCP?