
Apuntes · Capítulo 15Redes modernas
Seguridad de redes: amenazas, firewalls y VPNs
Seguridad de redes: amenazas, firewalls y VPNs
Durante catorce semanas armamos una red que funciona. Capturamos paquetes, configuramos switches y VLANs, conectamos sistemas autónomos con BGP, escribimos un transporte confiable y publicamos un servicio web sobre él. En casi todo ese camino dimos por sentado algo que ahora toca mirar de frente: que nadie en la red miente, nadie escucha lo que no le toca y nadie estorba a propósito. Ninguna de esas tres cosas es cierta en Internet.
Esta semana no agrega una capa nueva. Recorre las que ya conocemos y pregunta, en cada una, qué puede hacer alguien que quiere hacer daño, y qué defensa existe. ARP no autentica, y ya lo sabíamos desde la semana 3. IP deja falsificar la dirección de origen, y de ahí salen los ataques de amplificación de la semana 12 y los SYN flood de la semana 10. BGP cree lo que le dicen, como vimos en la semana 7. DNS responde sin firma, TLS protege el contenido pero no el nombre del servidor. La seguridad de redes no es un tema aparte: es releer todo el curso con otra pregunta.
Después de ese repaso, construimos dos defensas con las manos. En la Sesión A y en el
laboratorio levantamos un firewall con estado con nftables, que separa una red interna, una
DMZ y el mundo de afuera, y deja pasar solo lo que una política permite. Y levantamos una VPN:
primero IPsec a mano, para ver sus piezas, y después WireGuard, un diseño más simple que casi
todas las VPN nuevas usan. Capturamos el tráfico a cada lado del túnel para ver qué protege y qué
no, porque esa diferencia es la fuente del error más común sobre las VPN.
La Sesión B es la presentación de los proyectos: cada equipo muestra wasi respondiendo sobre
rimay en Qhapaq Ñan. Al final del capítulo hay un repaso guiado para el examen final.
Ruta de lectura.
Antes de clase (obligatorio, unos 15 a 20 minutos). Sesión A: La red de esta semana, Modelo de amenazas: quién, qué ve y qué puede cambiar, Capa de enlace: ARP spoofing, la introducción de Firewalls: sin estado y con estado con Zonas y DMZ, la de WireGuard: una VPN con menos piezas y Tres formas de proteger un camino. Sesión B: La Sesión B: presentación de los proyectos y el enunciado de P5.
En clase. Sesión A: Capa de red: IP spoofing y BCP 38, Capa de transporte: SYN flood y DoS, El firewall de la semana: el esqueleto y una regla, Antes y después: probarlo con
ncycurl, Ver el estado por dentro: conntrack y los contadores, IPsec: cifrado en la capa de red, Levantar el túnel, El handshake y los timers, Qué protege y qué no: la captura a los dos lados y Ejemplo resuelto: seguir un paquete por el firewall y el túnel. Sesión B: la presentación de los proyectos.Después de clase. Repasen con el Repaso guiado para el examen final, el Resumen y los Ejercicios, y preparen El laboratorio de la semana. Opcional: Zero trust, Sistemas de detección de intrusos, Identidad por clave: un origen que no corresponde y El costo de la VPN: MTU y throughput. Para profundizar, las lecturas del libro y las gratuitas de la semana:
Este capítulo acompaña a Kurose y Ross, Computer Networking: A Top-Down Approach (9.ª ed.). Para la Sesión A, las secciones 1.6 Networks Under Attack, 8.1 What Is Network Security?, 8.7 Network-Layer Security: IPsec and Virtual Private Networks y 8.9 Operational Security: Firewalls and Intrusion Detection Systems. Y las secciones 1 y 2 del artículo WireGuard: Next Generation Kernel Network Tunnel, de Jason A. Donenfeld. Complementarias: la sección 8.8 Securing Wireless LANs and 4G/5G Cellular Networks, y el RFC 4301, que define la arquitectura de IPsec. El código de la semana está en
code/week-15/.
La red de esta semana
Dos sitios de una misma organización, separados por una red que no es de ellos. En el sitio A
hay una red interna (las oficinas), una DMZ con un servidor web y un router fw que separa las
dos de afuera. En el sitio B hay otra red interna, detrás de gw2. Entre los dos está wan,
que hace de “Internet”, y ext, una máquina de afuera que nos sirve de atacante y de cliente
externo. La topología está en code/week-15/sitios/sitios.clab.yml.
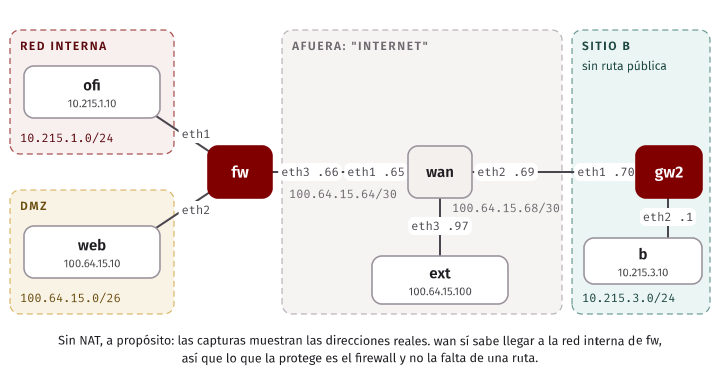
fw separa tres zonas: la red interna en eth1 (10.215.1.0/24, direcciones privadas), la DMZ
en eth2 (100.64.15.0/26, con dirección “pública” del mundo de Qhapaq Ñan) y afuera en
eth3. A propósito no hay NAT en esta red: queremos que las capturas muestren las
direcciones reales, para ver qué pasa de verdad. Y wan sí sabe llegar a la red interna de fw,
para que lo que la proteja sea el firewall y no la falta de una ruta. La red de b no tiene ruta
pública: solo se alcanza por el túnel que armamos más adelante.
Como en toda la parte práctica del curso, cada dirección, cada número de puerto y cada tiempo que aparece salió de una corrida real en esta topología. Los puertos de origen y los tiempos cambian en cada ejecución; las velocidades dependen de la computadora, y lo decimos cuando aparece una. El comportamiento no cambia. Levanten la red y tengan las claves listas:
cd code/week-15
make up
Modelo de amenazas: quién, qué ve y qué puede cambiar
Antes de defender algo hay que decir contra quién. En seguridad eso se llama modelo de amenazas: una descripción honesta de qué puede hacer el atacante. Sin esa descripción, “seguro” no quiere decir nada.
Definición. Un modelo de amenazas responde tres preguntas: quién es el adversario, qué puede observar de la red y qué puede modificar. Una defensa se evalúa siempre contra un modelo; la misma medida sirve contra un adversario y es inútil contra otro.
Las posiciones importan más que las personas. Conviene distinguir dos:
- Fuera del camino (off-path). El atacante puede enviar paquetes, y falsificar la dirección de origen, pero no ve el tráfico entre la víctima y su interlocutor. Tiene que adivinar lo que no ve: un número de secuencia, un ID de DNS, un puerto de origen. Ya lo medimos: en la semana 12, un envenenamiento de cache off-path tenía que acertar el ID de 16 bits y el puerto de origen, y por eso el puerto al azar lo volvía casi imposible.
- En el camino (on-path). El atacante ve el tráfico. Un Wi-Fi abierto, un router comprometido en el camino, el administrador de una red. No adivina nada: lee los números y responde primero. Contra este no sirven los trucos de la semana 12; hace falta criptografía.
Un tercer eje es qué puede hacer con lo que ve: un atacante pasivo solo escucha (sniffing); uno activo modifica, inyecta o bloquea paquetes. Un man-in-the-middle es un atacante activo y on-path a la vez: se pone en el medio, habla con cada lado haciéndose pasar por el otro.
Idea clave. No existe “seguro” a secas. Una medida protege contra un adversario con ciertas capacidades. El puerto al azar de DNS detiene a quien no ve el tráfico y no hace nada contra quien sí lo ve. TLS detiene a quien está en el camino pero no oculta con quién hablamos. La primera pregunta siempre es: ¿contra quién?
Conviene tener a la vista las metas clásicas de la seguridad, que ya nombramos con TLS en la semana 13 y que aquí usamos para clasificar ataques y defensas:
- Confidencialidad: solo el destinatario entiende el mensaje. Se rompe con sniffing.
- Integridad y autenticación: el mensaje llega sin cambios y de quien dice venir. Se rompe con spoofing y con man-in-the-middle.
- Disponibilidad: el servicio responde. Se rompe con un DoS.
Ataques por capa: un repaso del curso con otra pregunta
Esta sección recorre las capas que ya estudiamos. En cada una el ataque sale de una propiedad del protocolo que vimos funcionar, y la defensa también. No repetimos aquí los laboratorios de esas semanas; los nombramos para que el repaso sea un repaso.
Capa de enlace: ARP spoofing
En la semana 3 vimos que ARP no tiene autenticación: cualquier nodo de la red local puede responder “esa IP soy yo”. Un atacante en la misma red que la víctima responde a las consultas ARP del gateway con su propia MAC, y al revés, y queda en el medio de todo el tráfico local: un man-in-the-middle sin salir de la capa 2. Es un atacante on-path que se hace on-path.
La defensa es estructural, y ya la nombramos: separar dominios de broadcast con VLANs, de modo que el atacante solo pueda envenenar a los de su propio segmento, y en redes administradas, funciones del switch como DHCP snooping y Dynamic ARP Inspection, que descartan respuestas ARP que no concuerdan con lo que el switch vio por DHCP. Es una de las razones para separar redes con VLANs, como vimos en la semana 3.
Capa de red: IP spoofing y BCP 38
IP no verifica la dirección de origen de un datagrama. Quien controla una máquina puede escribir en el campo de origen la dirección que quiera. De ahí salen dos familias de ataques que ya vimos:
- El envenenamiento de cache de DNS off-path de la semana 12 dependía de que el atacante pudiera enviar respuestas con la dirección de origen del servidor autoritativo.
- Los ataques de amplificación de la semana 12: una pregunta chica con la dirección de origen
de la víctima, y un servidor le manda a ella una respuesta mucho más grande. Lo medimos con la
respuesta de
.pe: 43 bytes de pregunta, 384 de respuesta. Por UDP, sin handshake, nada le impide al atacante mentir sobre quién pregunta.
La defensa principal no la aplica la víctima, sino las redes de origen. El BCP 38 (RFC
2827) pide que cada red descarte en su borde los
paquetes cuya dirección de origen no le pertenece. Si todas lo hicieran, un atacante no podría
falsificar direcciones fuera de su propio bloque, y la amplificación con reflejo dejaría de
funcionar. En Linux esto se activa, para un router, con el reverse path filter: el kernel
descarta un paquete si la ruta de vuelta hacia su dirección de origen no sale por la interfaz por
la que llegó. El sysctl es net.ipv4.conf.<if>.rp_filter. En nuestros nodos viene en 0:
$ docker exec clab-w15-sitios-fw sysctl net.ipv4.conf.all.rp_filter
net.ipv4.conf.all.rp_filter = 0
Un operador que aplica BCP 38 lo pone en 1 (modo estricto) en las interfaces hacia sus clientes,
y entonces un cliente ya no puede mandar paquetes mintiendo sobre su dirección. (Hay un modo laxo,
2, que solo descarta orígenes sin ninguna ruta de vuelta; sirve cuando el routing es asimétrico,
pero no es el filtro de borde que pide el BCP 38 para un cliente.)
Lo que hace peligrosa a la amplificación es el factor de amplificación: cuántas veces más
grande es la respuesta que la pregunta. Con la respuesta de .pe, el factor es 384 / 43 ≈ 9: por
cada byte que el atacante gasta, la víctima recibe nueve. Un atacante con un enlace modesto, y con
muchos servidores reflectores, multiplica su tráfico por ese factor contra una víctima que nunca
pidió nada. Hay protocolos peores que DNS para esto —algunos servicios mal configurados daban
factores de decenas o centenas—, y la cuenta es siempre la misma:
tráfico contra la víctima ≈ tráfico del atacante × factor de amplificación × número de reflectoresPor eso la defensa tiene dos frentes: el BCP 38 impide falsificar el origen (y sin origen falso no hay reflejo), y los servidores que podrían servir de reflectores limitan a quién responden y a qué tasa. Ninguno basta solo; los dos juntos hacen que el ataque deje de rendir.
Idea clave. La falsificación de origen se arregla cerca del atacante, no cerca de la víctima. Ningún servicio puede distinguir, por sí solo, un paquete con origen falso de uno legítimo. Por eso el BCP 38 es una responsabilidad de cada red con el resto de Internet, igual que los filtros de prefijos de BGP de la semana 7: protegen a los demás, no a quien los aplica.
Capa de transporte: SYN flood y DoS
En la semana 10 montamos un SYN flood y vimos las SYN cookies defenderlo: el servidor deja de guardar estado por cada SYN a medio completar y codifica lo necesario en el número de secuencia. Recordamos el límite que señalamos entonces: las SYN cookies protegen la memoria del servidor, no el ancho de banda de su enlace. Un DoS por volumen —y más aún un DDoS, desde miles de máquinas a la vez— satura el enlace antes de llegar al servidor, y ahí la única defensa es filtrar antes, en la red del proveedor o en un servicio de mitigación. Eso es lo que prometimos “ver en la parte de seguridad”, y es parte de por qué los firewalls y los sistemas de detección viven en el borde de la red y no solo en el host.
Hay una tensión que conviene nombrar. Un firewall con estado, que ya guarda una entrada por
conexión, es él mismo un objetivo de DoS: un atacante que abre millones de conexiones a medias
puede llenar su tabla de conntrack, igual que llenaba la cola de SYN del servidor. Por eso en el
borde se combinan varias ideas que ya tienen nombre en el curso: límites de tasa (limit en
nftables), SYN cookies en los servidores, y descartar lo antes posible —cuanto más cerca del
atacante muere un paquete, menos recursos gasta en el camino—. No hay una sola defensa contra el
DoS: hay una cadena de ellas, y la más barata es la que actúa primero.
Capa de aplicación y de routing: lo que ya vimos
- Envenenamiento de DNS (semana 12): el ID y el puerto al azar frenan al atacante off-path; DNSSEC autentica las respuestas con firmas; DoT y DoH cifran el canal hasta el resolver.
- Hijack de BGP (semana 7): un AS origina o propaga un prefijo que no le toca. Las defensas son los filtros de prefijos del RFC 7454 y RPKI, que valida quién puede originar cada prefijo.
Error común. Pensar que la seguridad es una caja que se pone al final. Cada uno de estos ataques existe por una decisión de diseño de un protocolo —no autenticar, no cifrar, confiar en el vecino— que en su momento fue razonable. La defensa casi nunca cambia el protocolo: lo envuelve (TLS sobre TCP), lo valida desde afuera (RPKI, DNSSEC) o lo filtra (firewalls, BCP 38).
Firewalls: sin estado y con estado
Definición. Un firewall es un punto de la red donde el tráfico se inspecciona y se acepta o se descarta según una política. Un firewall sin estado (stateless) decide cada paquete por separado, mirando solo sus campos: direcciones, puertos, protocolo. Un firewall con estado (stateful) recuerda las conexiones que ya vio, y decide un paquete según la conexión a la que pertenece.
La diferencia importa mucho. Piensen en la regla que queremos casi siempre: “los de adentro pueden iniciar conexiones hacia afuera, pero los de afuera no pueden iniciar conexiones hacia adentro”. Con un firewall sin estado es incómodo: para dejar volver las respuestas de una conexión que salió, habría que aceptar todo el tráfico entrante que parezca una respuesta (por ejemplo, todo TCP con puerto de origen 80), y eso también deja entrar a un atacante que ponga 80 como puerto de origen. Un firewall con estado no tiene ese problema: deja volver un paquete solo si pertenece a una conexión que él vio salir.
En Linux, el que lleva la cuenta de las conexiones es conntrack, y nftables lo consulta con
ct state. Los estados que usamos:
new: el primer paquete de una conexión queconntrackno conocía.established: un paquete de una conexión que ya está en curso, en cualquiera de los dos sentidos.related: una conexión nueva pero ligada a una existente (por ejemplo, un error ICMP sobre un flujo conocido).invalid: un paquete queconntrackno puede ubicar en ninguna conexión. Casi siempre es basura o un intento de evadir el firewall, y se descarta.
Error común. Escribir
ct state != established,related dropcomo primera regla, pensando que descarta “lo que no es una respuesta”. Descarta también los paquetesnewlegítimos que sí queremos aceptar más abajo, y a veces losrelated. La forma correcta es al revés: primero se acepta lo establecido, después se decide qué conexiones nuevas se permiten. La regla que acepta va antes que las que filtran.
Zonas y DMZ
La política se escribe en términos de zonas, no de máquinas sueltas. Nuestra red tiene tres,
y cada una es una interfaz de fw:
- La red interna (
eth1): se confía en ella para iniciar conexiones hacia afuera, pero no se la expone. - La DMZ (demilitarized zone,
eth2): donde viven los servicios que sí deben ser accesibles desde afuera, como el servidor web. Está separada de la red interna a propósito: si alguien compromete el servidor público, queda en la DMZ y todavía tiene al firewall entre él y las oficinas. - Afuera (
eth3): nadie de confianza.
La política que queremos:
| De \ Hacia | Red interna | DMZ | Afuera |
|---|---|---|---|
| Red interna | — | sí | sí |
| DMZ | solo respuestas | — | sí |
| Afuera | no | solo al web, puertos 80/443 | — |
El firewall de la semana: el esqueleto y una regla
El firewall completo es el laboratorio de la semana: ustedes lo escriben en lab/firewall.nft.
Aquí vemos su estructura y una de sus reglas con detalle; el resto sale de la tabla de la
política de arriba. Es para nftables, el sucesor de iptables, con una sola tabla inet que
cubre IPv4 e IPv6. El esqueleto de la cadena de reenvío es siempre el mismo:
chain forward {
    type filter hook forward priority filter; policy drop;
    ct state established,related accept
    ct state invalid drop
    ...  # aquí van las reglas que abren cada camino de la tabla de la política
}
policy drop es la decisión por defecto: lo que no calce con ninguna regla se descarta. Es la
postura correcta de un firewall: denegar por defecto, permitir lo necesario. Lo que olviden
queda cerrado, no abierto. El orden sí importa: nftables aplica la primera regla que da un
veredicto, y un drop o un reject puesto antes de un accept lo anula. Las dos primeras reglas son las del párrafo anterior: aceptar lo establecido, descartar lo inválido. Van
primero a propósito, para que una respuesta no tenga que calzar con una regla de zona.
De las reglas que abren cada camino de la tabla, la más delicada es la única puerta de afuera
hacia adentro. No basta con “de eth3 a eth2”: hay que atar la regla a la dirección del
servidor y a sus puertos, porque es la superficie que queda expuesta a Internet:
iifname "eth3" oifname "eth2" ip daddr 100.64.15.10 tcp dport { 80, 443 } acceptSolo a la dirección del servidor web de la DMZ, solo en los puertos 80 y 443, solo desde afuera
hacia la DMZ. Las demás reglas —dejar salir a la red interna y a la DMZ, y dejar que la red
interna consulte la DMZ— siguen el mismo patrón, cada una con su iifname/oifname; y conviene
rechazar explícitamente (con reject) lo que venga de afuera hacia la red interna, en vez de
dejar que policy drop lo descarte en silencio: la diferencia la vemos abajo, y es la misma del
escenario ports de la semana 10.
Hay una segunda cadena que no hay que olvidar. input protege al propio router, que es
distinto del tráfico que lo atraviesa: empieza igual (denegar por defecto, aceptar lo
establecido, descartar lo inválido), deja administrar el router desde la red interna (ping y SSH),
y deja entrar por eth3 solo el UDP del túnel WireGuard que armamos más adelante
(udp dport 51820). Todo lo demás que vaya al router, se descarta.
Error común. Proteger solo
forwardy olvidarinput. Un firewall que filtra el tráfico que atraviesa pero deja abierto todo servicio del propio router (su SSH, su DNS, su panel de administración) tiene una puerta grande en el costado. Las dos cadenas son hooks distintos del mismo flujo:forwardes lo que pasa a través,inputes lo que termina en la máquina.
Sigamos un cliente legítimo de afuera que pide la página del servidor web, para ver qué regla lo
deja pasar. Su primer paquete es un SYN de ext hacia 100.64.15.10:80. En fw, entra por
eth3 y sale hacia eth2, así que lo evalúa la cadena forward: no es established todavía,
no es invalid, no calza con las tres primeras reglas de salida, y sí calza con
iifname "eth3" oifname "eth2" ip daddr 100.64.15.10 tcp dport { 80, 443 } accept. Pasa, y
conntrack anota la conexión. El SYN-ACK que vuelve del servidor, y todo el resto de la
conexión en los dos sentidos, calzan con ct state established,related accept, la primera regla:
no hace falta una regla de vuelta. Esa es la economía del firewall con estado: una regla abre la
conexión, y el estado se encarga del resto.
En la práctica. Esta misma política, con otros nombres, es la de casi toda la infraestructura moderna. Los security groups de una nube, las reglas de un load balancer o las network policies de Kubernetes son firewalls con estado escritos como “esta zona puede iniciar hacia esta otra, en estos puertos”. Cambia la sintaxis, no las ideas: denegar por defecto, permitir por zona y por puerto, y dejar que el estado siga las conexiones. Quien entiende este
firewall.nftentiende aquellas.
Antes y después: probarlo con nc y curl
Levantamos un servidor web en la DMZ y otro en la oficina, y antes de cargar el firewall fw
solo hace forwarding: afuera llega a todo.
$ python3 scenarios.py firewall
Antes del firewall (fw solo hace forwarding): afuera llega a todo.
    ext -> web (DMZ): 200
    ext -> ofi (red interna): 200
Cargamos el firewall con nft -f, editando el archivo, y repetimos:
Cargamos el firewall:
  fw# nft -f firewall.nft
Después del firewall:
    ext -> web (DMZ)   : 200
    ext -> ofi (interna): falla en 0.00 s
    ofi -> web (interna a DMZ): 200
La DMZ sigue accesible desde afuera; la red interna ya no; y desde adentro se sigue saliendo. Eso es exactamente la tabla de la política. Ahora la diferencia entre descartar y rechazar, midiendo cuánto tarda cada intento:
Tres resultados distintos, medidos con el tiempo de cada intento:
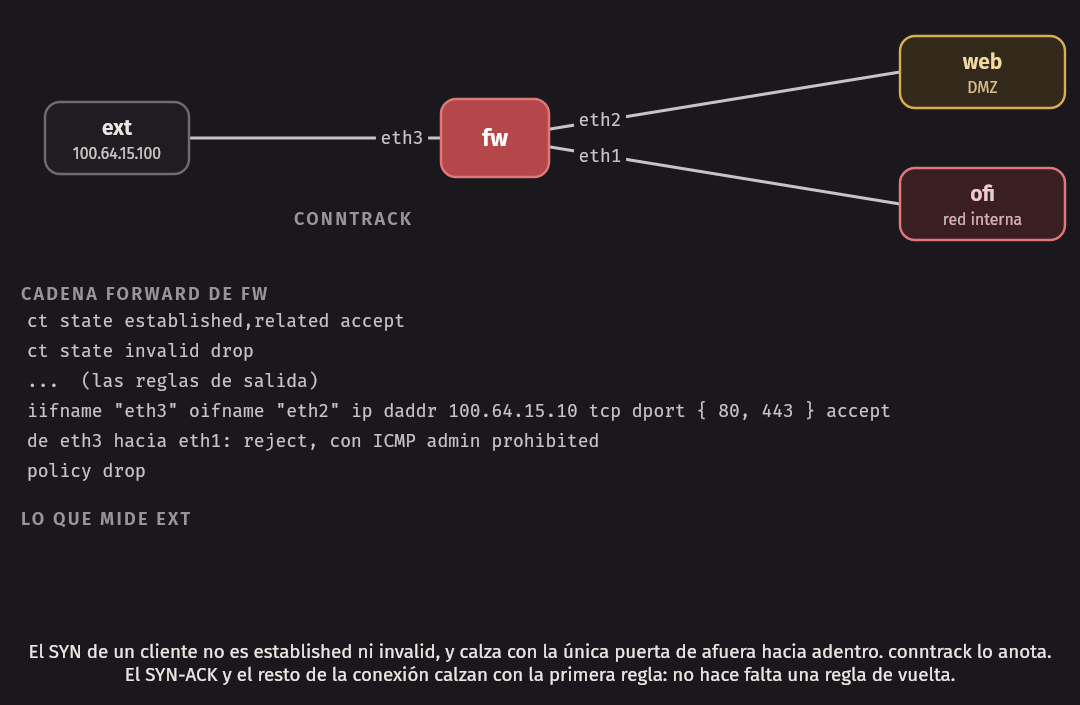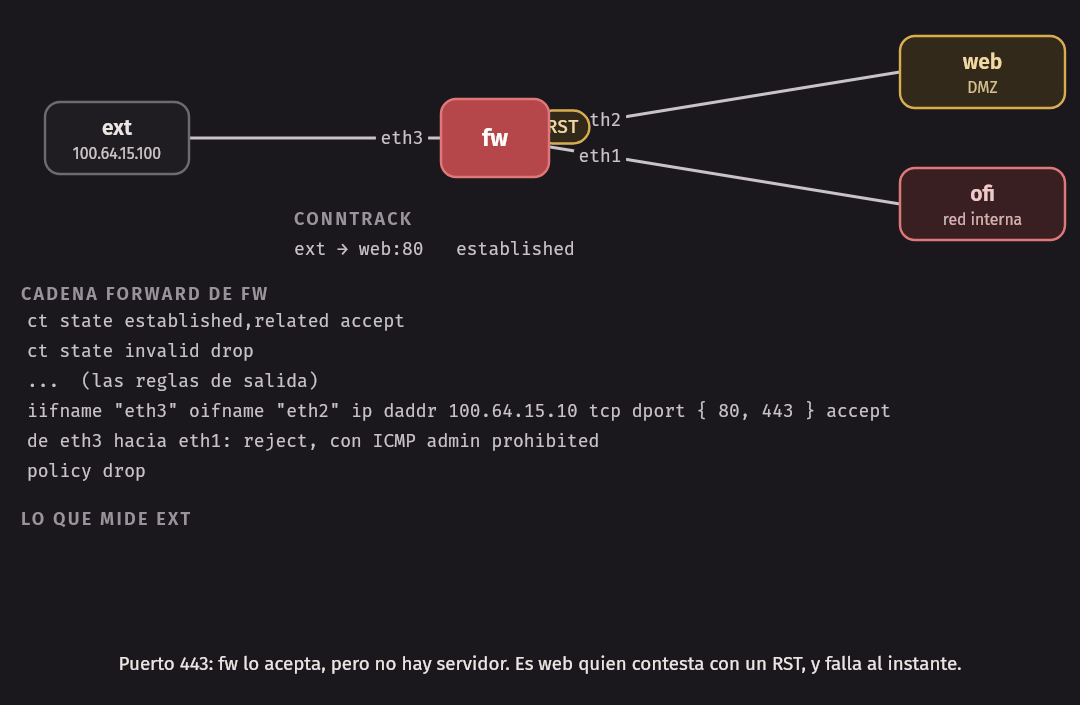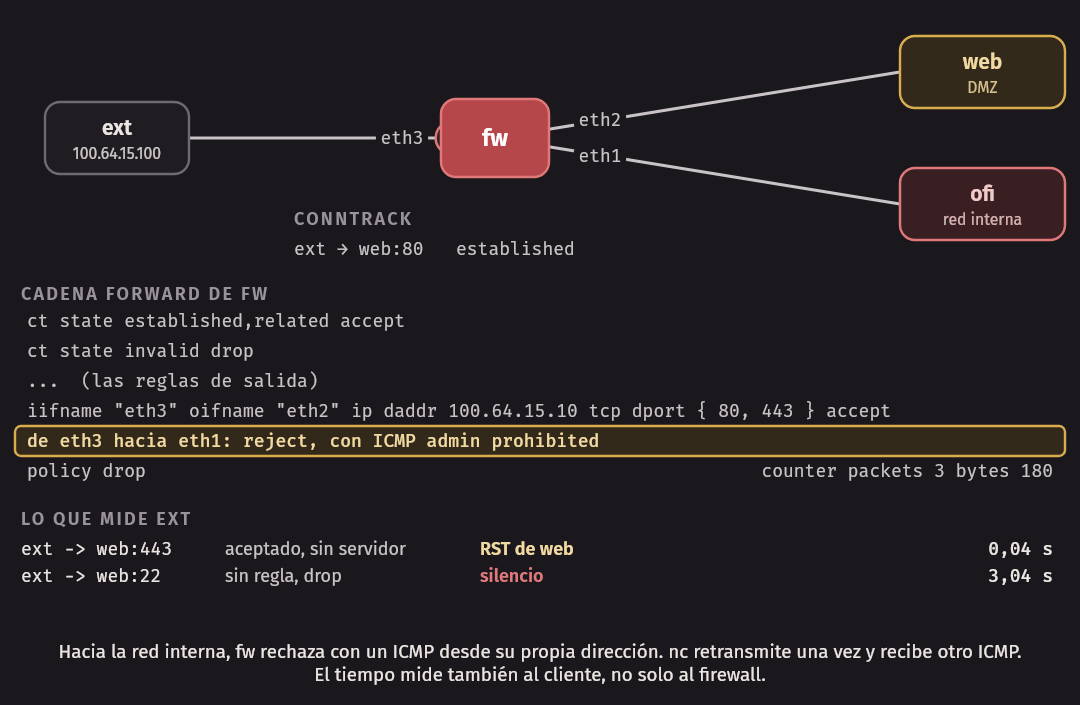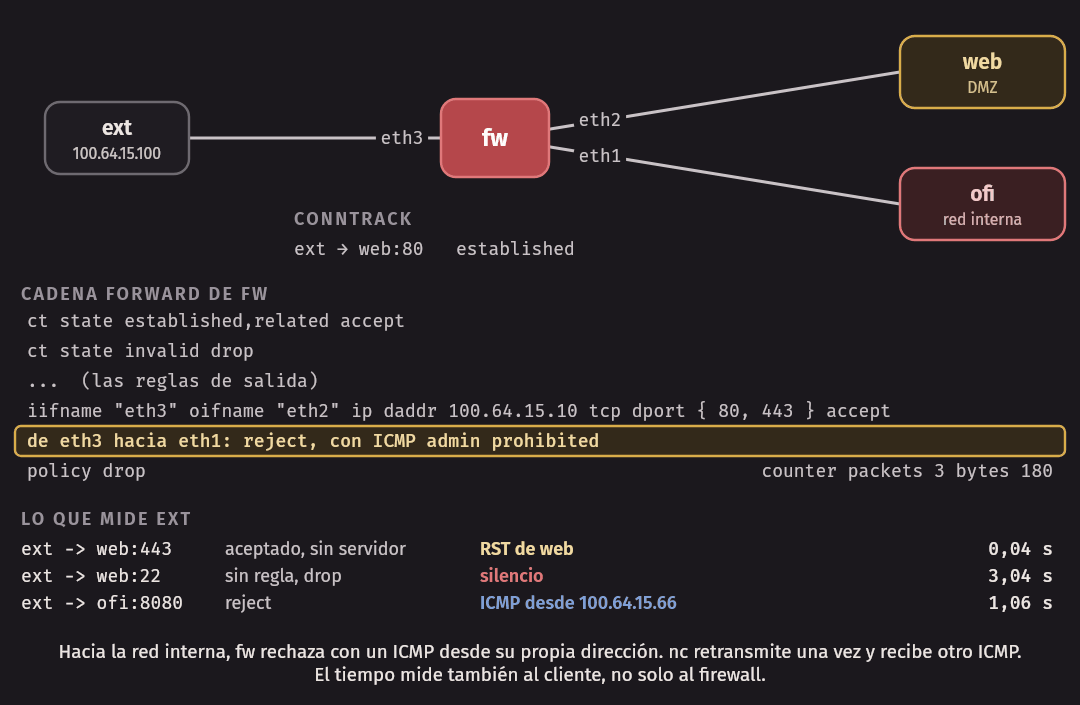
    ext -> web:443 (aceptado por fw, sin servidor): no conecta, 0.04 s
    ext -> web:22  (sin regla, drop en forward) : no conecta, 3.04 s
    ext -> ofi:8080 (red interna, reject)       : no conecta, 1.06 s
Una captura en ext dice qué pasó en cada caso (recortamos las opciones de TCP):
100.64.15.100.42203 > 100.64.15.10.443: Flags [S], seq 1033595322, ...
100.64.15.10.443 > 100.64.15.100.42203: Flags [R.], seq 0, ack 1033595323, win 0, length 0
100.64.15.100.41917 > 100.64.15.10.22: Flags [S], seq 174046449, ...
100.64.15.100.41917 > 100.64.15.10.22: Flags [S], seq 174046449, ...
100.64.15.100.41917 > 100.64.15.10.22: Flags [S], seq 174046449, ...
100.64.15.100.33287 > 10.215.1.10.8080: Flags [S], seq 1200128341, ...
100.64.15.66 > 100.64.15.100: ICMP host 10.215.1.10 unreachable - admin prohibited filter, length 68
100.64.15.100.33287 > 10.215.1.10.8080: Flags [S], seq 1200128341, ...
100.64.15.66 > 100.64.15.100: ICMP host 10.215.1.10 unreachable - admin prohibited filter, length 68
El puerto 443 lo acepta el firewall, pero no hay servidor escuchando, y el propio web contesta
con un RST: falla al instante. El puerto 22 sí tiene un servidor, pero no tiene regla: cae en
policy drop, el cliente no recibe nada, retransmite el SYN y nc se rinde a los tres segundos.
Hacia la red interna, fw contesta con un ICMP “admin prohibited”, enviado desde su propia dirección.
Llega enseguida, y curl falla en 0.00 s. nc tarda un segundo porque su conexión retransmitió
el SYN una vez y recibió un segundo ICMP: el tiempo mide también al cliente, no solo al firewall. Es
la distinción de la semana 10 entre un puerto cerrado (RST inmediato) y uno filtrado (silencio): un
firewall que descarta se ve, desde afuera, como un puerto filtrado.
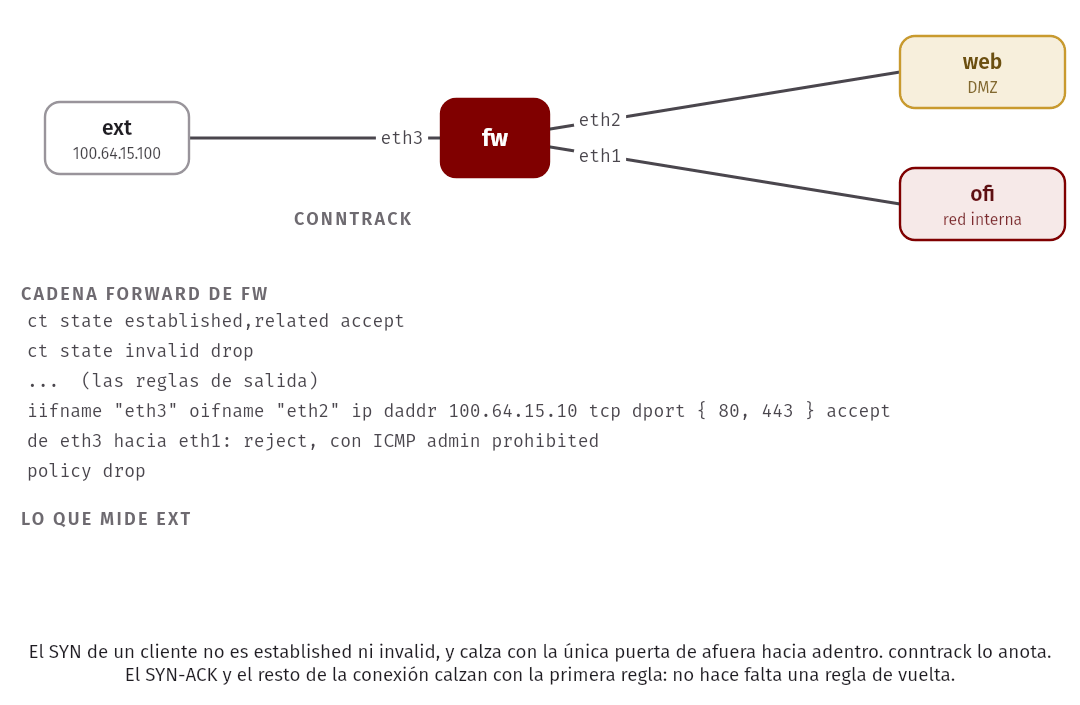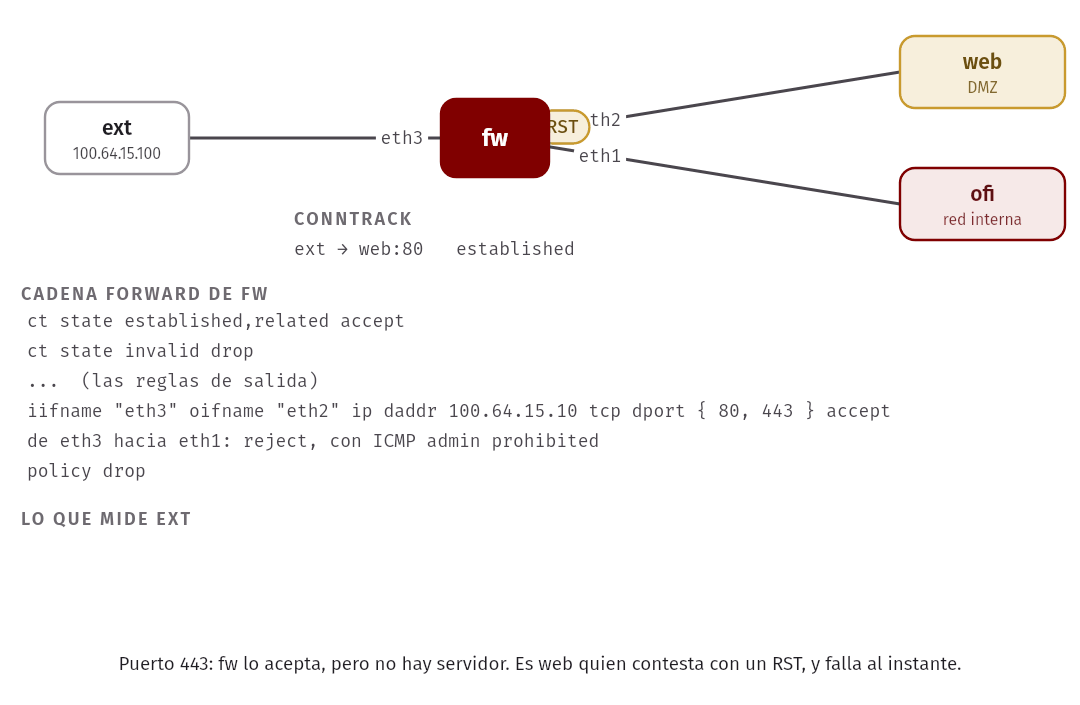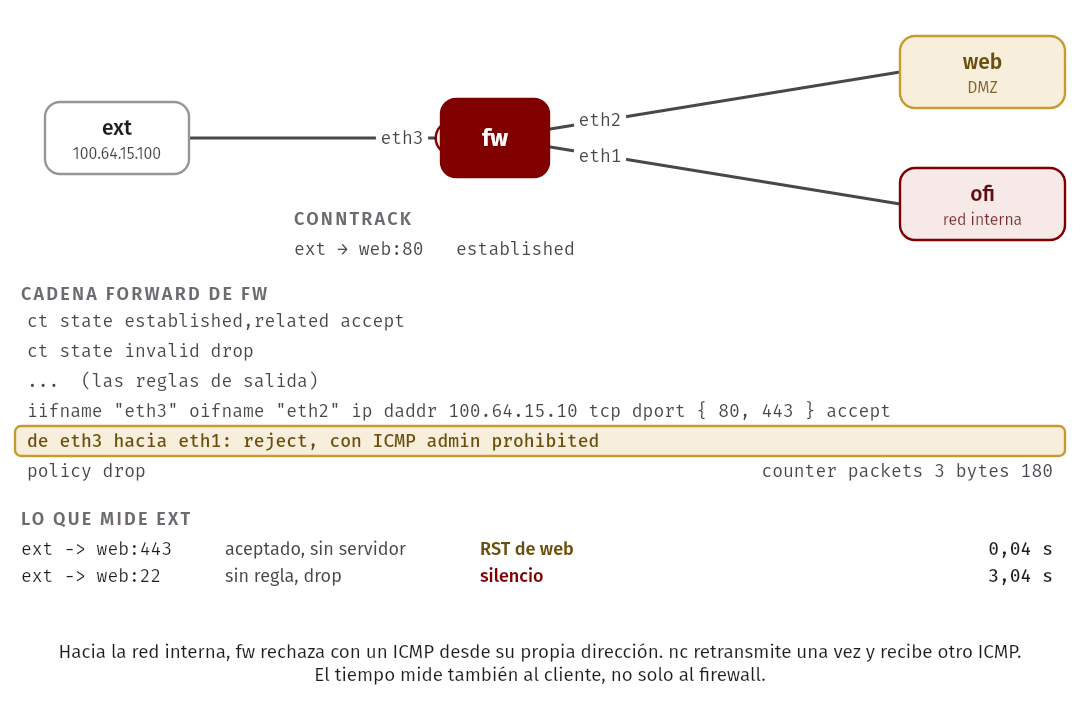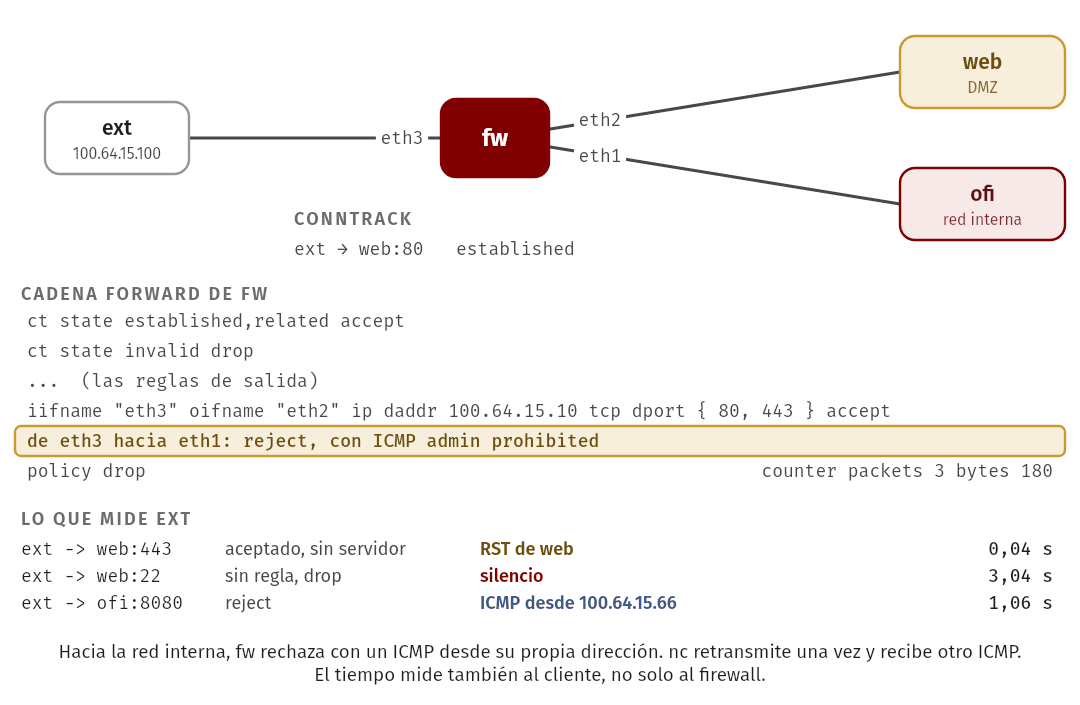
En la práctica. Que un firewall descarte en silencio o rechace con un ICMP es una decisión real. El silencio da menos información a quien escanea desde afuera (no sabe si hay algo ahí), al costo de que un cliente legítimo que se equivoca de puerto espera el timeout completo. El rechazo con ICMP hace lo contrario: falla rápido, pero confirma que el firewall está ahí. Nuestro firewall mezcla las dos: descarta en silencio los puertos sin regla de la DMZ, y rechaza con un ICMP los intentos de afuera hacia la red interna. No hay una respuesta única correcta; depende de a quién se le quiere dar, o negar, información.
Ver el estado por dentro: conntrack y los contadores
El firewall no es una caja opaca: se puede mirar lo que hace. Dos herramientas ayudan a depurar una política, y a convencerse de que hace lo que uno cree.
La primera es conntrack, la tabla de conexiones que nftables consulta con ct state. Cada
flujo que fw ve aparece como una entrada con sus dos sentidos, su estado y un temporizador que
se reinicia con cada paquete. Una conexión TCP establecida se ve con su estado y el tiempo que le
queda antes de expirar; una respuesta que vuelve por esa conexión calza como established y no
necesita ninguna regla propia. Cuando una política se comporta raro, conntrack -L suele mostrar
por qué: un flujo marcado [UNREPLIED] que nunca recibió respuesta, o uno que no aparece porque
el primer paquete se descartó.
La segunda son los contadores. Cada regla puede llevar un counter, y la regla final de
policy drop es un buen lugar para uno: cuenta exactamente lo que ninguna política dejó pasar.
Después de que, desde afuera, alguien intenta conectarse al puerto 22 de la DMZ —que no tiene
regla—, el contador del forward lo registra:
$ docker exec clab-w15-sitios-fw sh -c 'nft list chain inet fw forward | grep counter'
counter packets 3 bytes 180 comment "forward que no calza con ninguna politica"
Tres paquetes de 60 bytes: son los tres SYN de la captura anterior, el original y dos
retransmisiones, hasta que nc -w3 se rindió. El contador es la prueba de que esos paquetes
llegaron a fw y murieron ahí. En una red real, un contador que crece sin parar en la regla de
descarte es la primera señal de que algo, como un escaneo, está golpeando el firewall.
En la práctica. La diferencia entre “mi regla funciona” y “creo que mi regla funciona” son los contadores. Antes de dar por buena una política, generen el tráfico que debería bloquear y miren si el contador sube; y el que debería pasar, y miren si no sube. Una regla que nunca se dispara suele estar mal escrita, o puesta después de otra que ya atrapó el tráfico.
Zero trust
El diseño de zonas tiene un supuesto cómodo: que “adentro” es confiable. Durante años las redes se construyeron así, con un perímetro duro y un interior blando. El problema es que basta un equipo comprometido adentro —una laptop con malware, un servidor con una falla— para que el atacante esté dentro del perímetro, donde ya nadie lo revisa.
Definición. Zero trust es el principio de no confiar en alguien solo por estar dentro de la red. Cada acceso se autentica y se autoriza por su cuenta, sin importar desde dónde venga. No es un producto: es dejar de usar la posición en la red como si fuera una credencial.
En la práctica esto empuja la autenticación hacia cada servicio y cada conexión: TLS mutuo entre servicios internos, identidad por dispositivo y por usuario, y micro-segmentación en vez de una sola gran red interna. WireGuard, que vemos enseguida, encaja bien con esta idea: identifica a cada peer por su clave, no por su dirección.
Sistemas de detección de intrusos
Un firewall decide por una política fija. Un sistema de detección de intrusos (IDS) mira el
tráfico buscando patrones de ataque conocidos o comportamiento anómalo, y avisa; si además
bloquea, se llama IPS (sistema de prevención). Un IDS por firmas (como Snort o Suricata)
reconoce ataques conocidos; uno por anomalía aprende lo normal y marca lo que se sale. El costo
son los falsos positivos y los falsos negativos: ningún IDS los evita del todo. En nuestro
entorno no hay un IDS instalado, pero nftables ya trae las piezas con las que uno empieza:
counter para contar, limit para marcar tasas excesivas y meter para seguir muchas
direcciones a la vez. Un IDS real agrega el reensamblado de flujos, miles de firmas y el análisis
del contenido de la aplicación.
IPsec: cifrado en la capa de red
Un firewall decide quién pasa. No protege lo que viaja: entre fw y gw2, todo cruza wan, que
no es nuestra, y ahí cualquiera puede leer y modificar. Para eso existe una VPN (virtual
private network): un túnel cifrado que hace que dos redes separadas se comporten como una sola,
privada, sobre una red pública. Es la idea de túnel de la semana 4 —tratar una red entera como si
fuera un enlace— pero ahora con criptografía.
La forma estándar de hacer esto en la capa de red es IPsec, definido en el RFC 4301. IPsec no es un protocolo sino un marco con varias piezas:
- AH (Authentication Header): autentica el paquete e impide que lo modifiquen, pero no lo cifra. Protege integridad y origen, no confidencialidad.
- ESP (Encapsulating Security Payload): cifra y autentica la carga. Es lo que se usa casi siempre.
- Security association (SA): el estado de una dirección del túnel —qué algoritmo, qué clave, qué números de secuencia—. Hay una SA por sentido, identificada por un número llamado SPI.
- Modo transporte o modo túnel: en transporte se protege la carga del datagrama y se deja el encabezado IP original; sirve entre dos hosts. En túnel se protege el datagrama IP entero y se le pone un encabezado IP nuevo por fuera; es el que se usa entre dos sitios, porque oculta también las direcciones internas.
En un despliegue real, las claves no se escriben a mano: un demonio como strongSwan negocia las
SA con IKEv2, un protocolo de intercambio de claves. Aquí, para ver las piezas desnudas,
creamos las SA a mano con ip xfrm y claves fijas. (No hay un demonio de IKE en el entorno; lo
hacemos manual a propósito, y así se ve que IKE es justamente lo que nos ahorraríamos.)
Con ESP en modo transporte entre ext y wan, capturamos en el medio. Se ve el protocolo ESP
(número 50) y un SPI, y nada de la carga:
$ python3 scenarios.py ipsec
ESP en modo transporte (cifra la carga): clave manual, una SA por sentido.
...
  100.64.15.100 > 100.64.15.97: ESP(spi=0x00000201,seq=0x2), length 100
  100.64.15.97 > 100.64.15.100: ESP(spi=0x00000202,seq=0x2), length 100
El ping sigue funcionando entre los dos extremos, pero quien mira en wan no puede decir que
es un ping: ve dos SA (una por SPI, una por sentido) y bytes cifrados. Con AH, en cambio, el
mismo ping viaja legible, con una cabecera de autenticación por delante:
AH en modo transporte (autentica, NO cifra): el ICMP se lee, con cabecera AH.
  100.64.15.100 > 100.64.15.97: AH(length=4(24-bytes),spi=0x00000301,...): ICMP echo request, id 216, seq 0, length 64
  100.64.15.97 > 100.64.15.100: AH(length=4(24-bytes),spi=0x00000302,...): ICMP echo reply, id 216, seq 0, length 64
tcpdump lee ICMP echo request: AH no oculta nada, solo garantiza que nadie lo cambió y que
viene de quien comparte la clave. Y en modo túnel, el datagrama interno entero va cifrado
dentro de uno nuevo, por eso el paquete externo es más grande. Cambiando a mode tunnel en las
SA y las políticas, a mano, el total del paquete IP pasa de 120 a 140 bytes:
100.64.15.100 > 100.64.15.97: ESP(spi=0x00000401,seq=0x1), length 120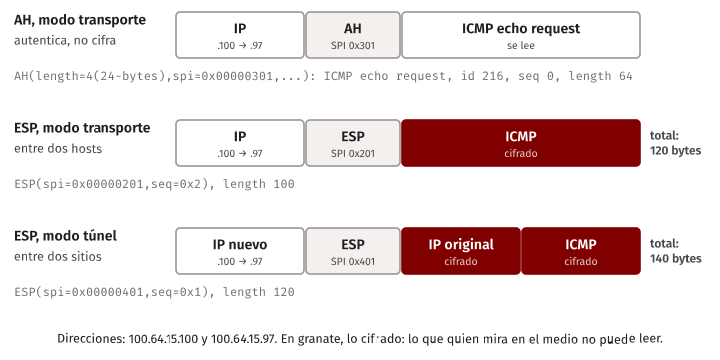
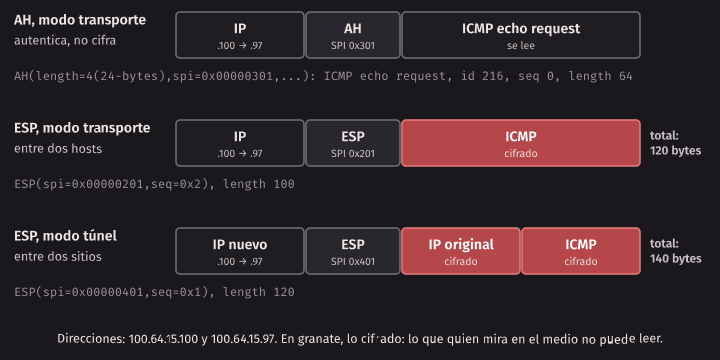
Idea clave. AH autentica, ESP cifra. Modo transporte protege la carga entre dos hosts; modo túnel protege el datagrama entero entre dos sitios y oculta las direcciones internas. Cuando se dice “una VPN IPsec sitio a sitio”, casi siempre es ESP en modo túnel.
Fíjense en los SPI de las capturas: 0x201 y 0x202 son las dos SA de ESP, una por sentido;
0x301 y 0x302, las de AH. Una SA es unidireccional por diseño: cada sentido tiene su clave,
su contador de secuencia —que crece y nunca se repite, para bloquear la repetición de un paquete
viejo— y su SPI, que es lo que el receptor usa para encontrar en su tabla con qué clave
descifrar. Un túnel completo son al menos dos SA.
Lo que no vimos, porque lo pusimos a mano, es de dónde salen las claves. En un despliegue real eso es trabajo de IKEv2: autentica a los dos extremos —con certificados o con una clave compartida—, negocia qué algoritmos usar, deriva las claves de sesión con forward secrecy, y las rota cada cierto tiempo. Es un protocolo grande, con su propia máquina de estados y su propio historial de vulnerabilidades. Nuestras claves fijas, en cambio, sí autentican —a quien tenga la clave—, pero no rotan y no están ligadas a la identidad de nadie: alguien que copie la clave es indistinguible de su owner. Sirven para ver AH y ESP, no para producción. Ese contraste —IKE hace mucho, y por eso pesa— es justo el punto de partida de WireGuard.
Error común. Confundir “tengo IPsec” con “estoy seguro”. IPsec con una pre-shared key débil, o con una suite de cifrado vieja negociada por IKE, protege poco. La fortaleza está en el intercambio de claves y en los algoritmos, no en la sigla. WireGuard responde a esto quitando la negociación: un solo conjunto de algoritmos, sin opción a equivocarse.
IPsec funciona y es correcto. Su problema, como vamos a ver, es la complejidad: el marco tiene
muchas opciones, AH y ESP, dos modos, IKEv1 e IKEv2, y una capa de transformación (xfrm)
separada de las reglas del firewall. Esa complejidad es la que WireGuard decide no tener.
WireGuard: una VPN con menos piezas
WireGuard nace de una observación incómoda, que su autor expone en la introducción del artículo: IPsec está correctamente diseñado —cada cosa en su capa, con rigor académico— y aun así es tan complejo que desplegarlo y, sobre todo, implementarlo sin errores, es prohibitivo. WireGuard rompe a propósito esa separación de capas limpia a cambio de algo mucho más simple de usar y de auditar: todo el código del kernel cabe en menos de 4000 líneas.
Las decisiones de diseño, de las secciones 1 y 2 del artículo:
- Una interfaz virtual, no una capa de transformación. WireGuard es una interfaz de red
—
wg0— que se configura con las herramientas de siempre (ip,wg). Las reglas de firewall se escriben sobre esa interfaz como sobre cualquier otra, con la garantía de que todo lo que sale porwg0va cifrado y autenticado, y todo lo que entra porwg0tiene un origen auténtico. - Identidad por clave pública. Cada peer se identifica por una clave pública Curve25519 de 32 bytes, al estilo de las claves de OpenSSH. No hay certificados ni autoridades: los dos extremos intercambian sus claves públicas por el medio que quieran (un correo, un chat), y eso basta.
- Cryptokey routing. El corazón del diseño. Cada peer tiene una lista de allowed-ips: las direcciones de origen que puede usar. Al enviar, WireGuard mira la dirección de destino y elige la clave del peer cuya lista la contiene. Al recibir, descifra, y solo acepta el paquete si su dirección de origen está en la lista del peer que firmó. La asociación clave-direcciones es toda la configuración de routing del túnel.
- Sin agilidad de algoritmos. WireGuard no negocia cifradores: usa Curve25519, ChaCha20, Poly1305 y BLAKE2s, y punto. Si algún día se rompe uno, todos actualizan. Esa rigidez elimina la clase entera de ataques de downgrade que arrastran TLS e IKE.
- Corre sobre UDP, en un solo puerto, y encapsula paquetes IP (capa 3). Un intercambio de claves de una sola ida y vuelta (1-RTT), basado en el framework Noise, levanta la sesión; y un conjunto de timers la mantiene sin que el administrador tenga que pensar en conexiones: desde afuera, la interfaz parece sin estado.
Levantar el túnel
Cada extremo necesita un par de claves. wg genkey crea la privada; wg pubkey deriva la
pública. El Makefile las crea en build/keys/ cuando corren make, con permisos restringidos,
y make clean las borra: así make clean && make test nunca reutiliza una clave vieja.
wg genkey | tee fw.key | wg pubkey > fw.pubConfiguramos wg0 en fw y en gw2. En fw, el peer es gw2 (dirección pública
100.64.15.70), y sus allowed-ips son la red interna del otro sitio (10.215.3.0/24) más la
dirección del túnel del peer:
fw#  wg set wg0 private-key fw.key listen-port 51820
fw#  wg set wg0 peer <gw2.pub> endpoint 100.64.15.70:51820 \
         allowed-ips 10.215.3.0/24,10.215.9.2/32 persistent-keepalive 25
fw#  ip addr add 10.215.9.1/30 dev wg0 ; ip link set wg0 up
fw#  ip route add 10.215.3.0/24 dev wg0
En gw2 es el espejo: el peer es fw, y sus allowed-ips son la oficina (10.215.1.0/24). Con
eso, y tras pasar un poco de tráfico, wg show reporta todo el estado del túnel en pocas líneas:
$ docker exec clab-w15-sitios-fw wg show
interface: wg0
  public key: 8hLvGNRwY7QuCiwB9IAjU8iWlXPv6RI2T640ssLrdG4=
  private key: (hidden)
  listening port: 51820

peer: Rzrh502FJ2FPXlFBThOdjXE8uiGG0RRzMqHwplJtHFM=
  endpoint: 100.64.15.70:51820
  allowed ips: 10.215.3.0/24, 10.215.9.2/32
  latest handshake: 8 seconds ago
  transfer: 1.07 KiB received, 1.16 KiB sent
  persistent keepalive: every 25 seconds
Fíjense en lo poco que hay: una clave propia y un puerto, y por cada peer su clave pública, su
endpoint, su lista de direcciones, cuándo fue el último handshake y cuántos bytes se movieron. No
hay número de conexión ni comandos de “conectar”: uno declara los peers y el túnel existe. Por eso
el artículo dice que, desde el punto de vista de la administración, la interfaz se comporta
como si fuera sin estado —aunque por dentro sí mantiene el estado de la sesión, como muestran las
líneas de handshake y transferencia—. La MTU de wg0 quedó en 1420, un número al que volvemos al
hablar del costo:
12: wg0: <POINTOPOINT,NOARP,UP,LOWER_UP> mtu 1420 qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000El handshake y los timers
Detrás de esa simplicidad hay un intercambio de claves y una máquina de timers que el administrador no toca. El detalle está en las secciones 5 y 6 del artículo, que no son lectura obligatoria. En lo que nos importa:
- Un handshake de una sola ida y vuelta (1-RTT). El iniciador manda un primer mensaje, el respondedor contesta uno, y con eso los dos derivan las claves de la sesión. El intercambio usa el framework Noise (variante IK): autentica a los dos extremos por su clave pública y da forward secrecy, porque las claves de sesión son efímeras y se tiran al rotar. Es el mismo objetivo que TLS 1.3 de la semana 13, con muchas menos piezas y sin certificados.
- Silencio por defecto. Una interfaz WireGuard no manda nada si no hay tráfico que enviar. No hay keepalives de protocolo, ni anuncios: callar es parte del diseño, y dificulta que alguien sepa siquiera que el túnel existe.
- El keepalive es opcional. Pusimos
persistent-keepalive 25porque detrás de un NAT la “fila” que abre el tráfico de salida se cierra tras unos segundos de silencio; un paquete vacío cada 25 s la mantiene abierta para que el otro extremo pueda iniciar. Sin NAT de por medio no haría falta. - La sesión se renueva sola. Tras unos minutos, o un volumen de datos, WireGuard rehace el handshake para rotar las claves. Si un mensaje de handshake se pierde, lo reintenta. Nada de esto aparece en la configuración.
Idea clave. WireGuard no tiene “conectar” ni “desconectar”. Uno declara los peers y sus direcciones, y el túnel existe cuando hay algo que mandar. El handshake, la rotación de claves y la reconexión pasan solos. Esa es la diferencia de uso más grande con IPsec, donde un demonio de IKE mantiene el estado de la sesión y hay que vigilarlo.
En la práctica. El endpoint de un peer se puede aprender del paquete que llega, no solo fijarlo de antemano (sección 2.1 del artículo). Como la identidad es la clave y no la dirección, un peer puede cambiar de red —de Wi-Fi a datos móviles, por ejemplo— y el túnel lo sigue: el otro extremo actualiza el endpoint al ver la nueva dirección de origen de un paquete bien autenticado. Es el roaming que hace a WireGuard cómodo en laptops y celulares.
Qué protege y qué no: la captura a los dos lados
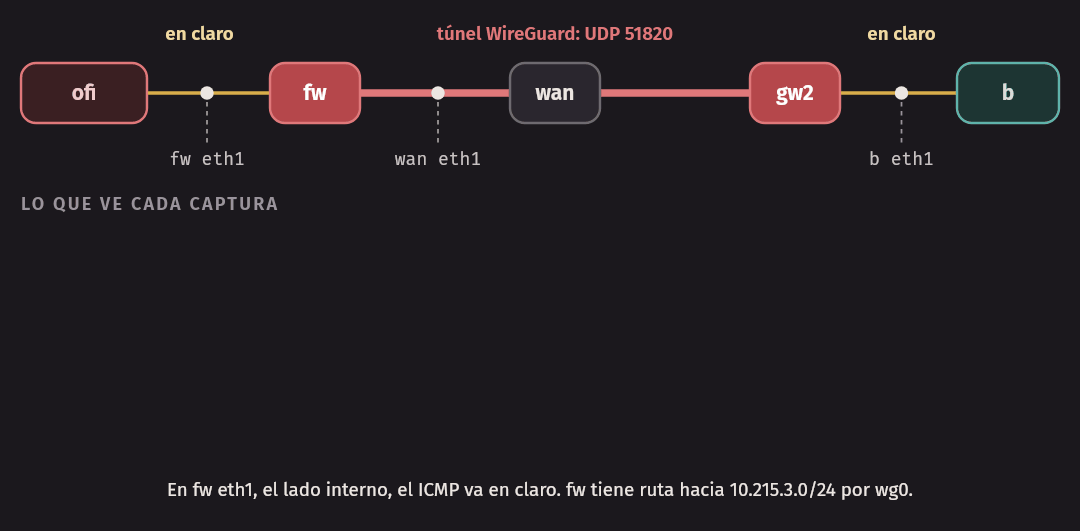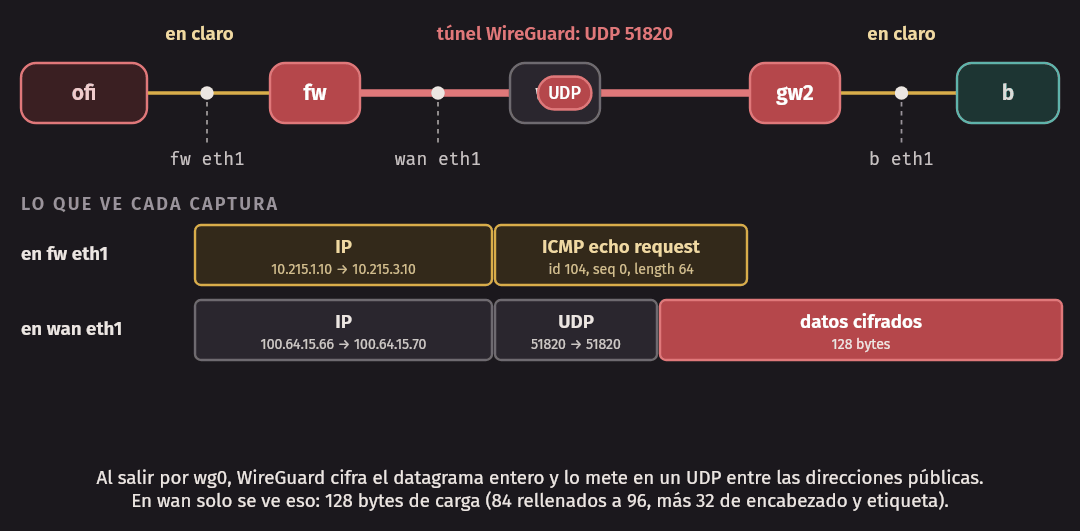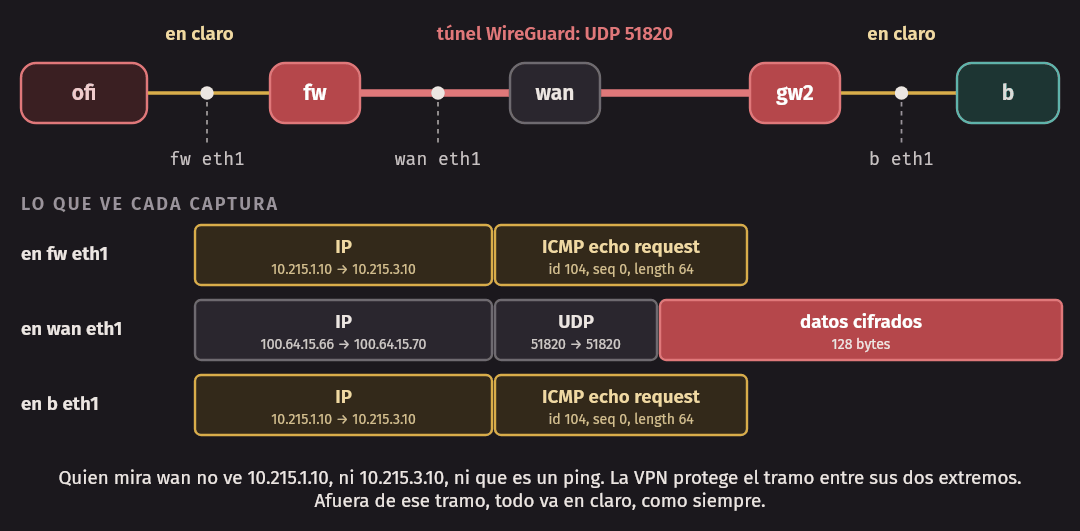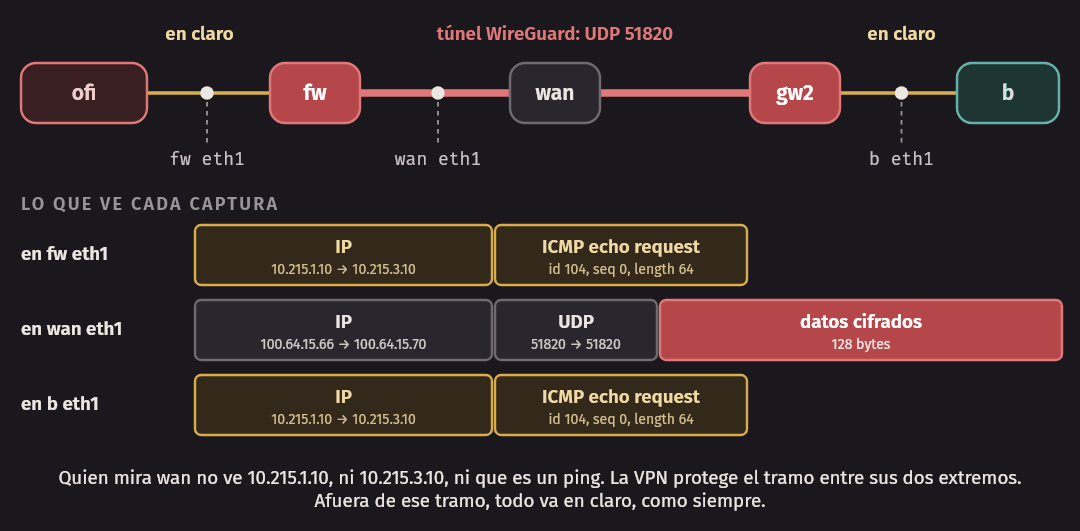
Esta es la parte importante de la semana. Un ping de la oficina al host b del otro sitio
funciona, aunque b no tenga ninguna ruta pública: viaja por el túnel. Lo capturamos en tres
puntos a la vez.
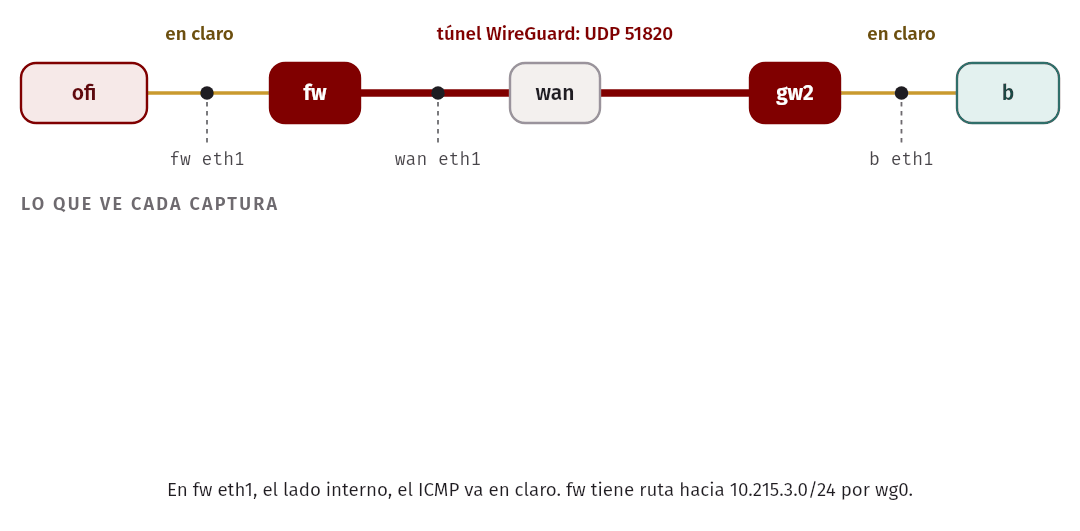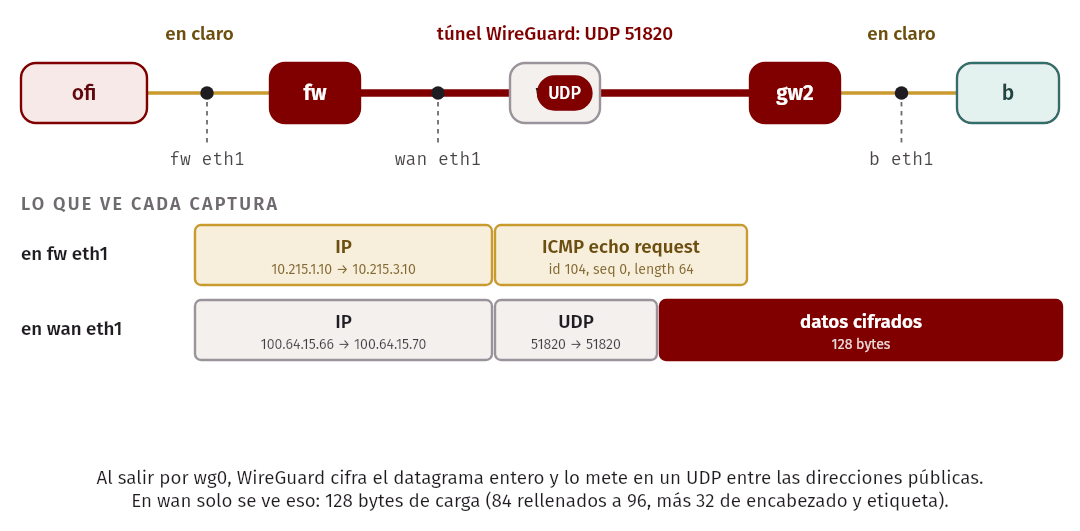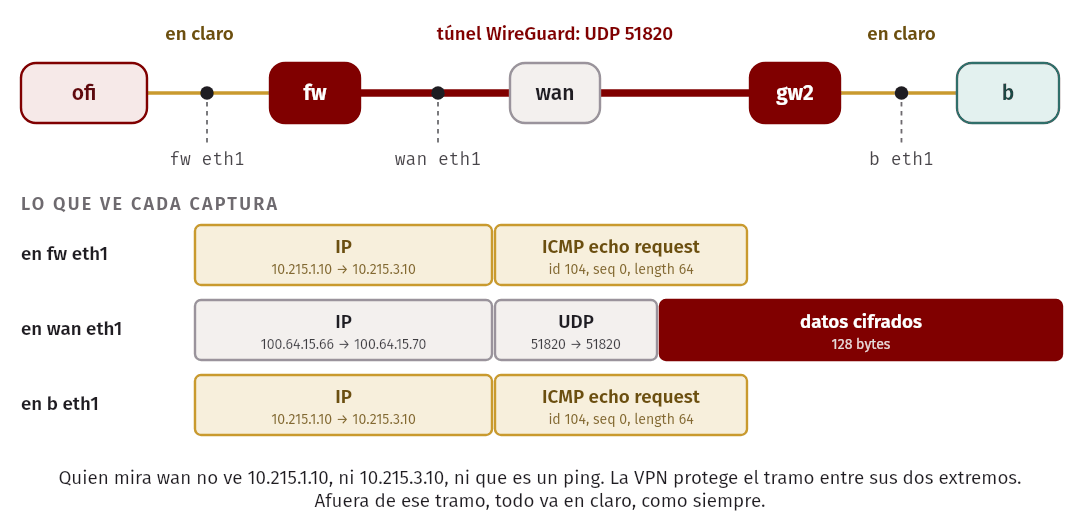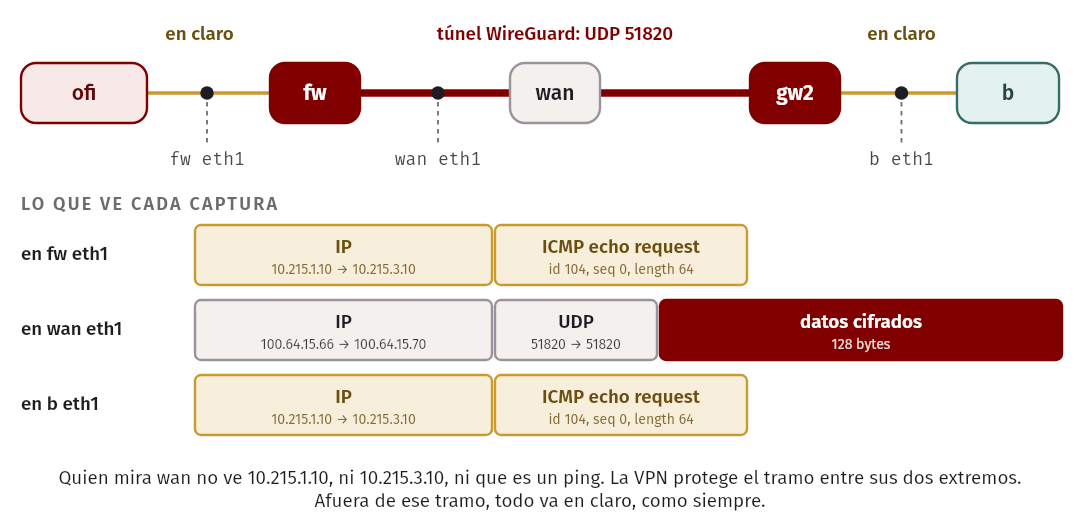
En fw eth1, el lado interno de salida, el ICMP va en claro:
  en fw eth1 (interno): ICMP en claro
IP 10.215.1.10 > 10.215.3.10: ICMP echo request, id 104, seq 0, length 64
IP 10.215.3.10 > 10.215.1.10: ICMP echo reply, id 104, seq 0, length 64
En wan eth1, en medio de la red ajena, no hay ningún ICMP: solo UDP al puerto 51820, cifrado,
entre las direcciones públicas de los dos routers:
  en wan eth1 (externo): UDP 51820, cifrado
IP 100.64.15.66.51820 > 100.64.15.70.51820: UDP, length 128
IP 100.64.15.70.51820 > 100.64.15.66.51820: UDP, length 128
Y en b eth1, el lado interno del destino, el ICMP vuelve a verse en claro:
  en b eth1 (interno, destino): ICMP en claro otra vez
IP 10.215.1.10 > 10.215.3.10: ICMP echo request, id 104, seq 0, length 64
Ese contraste es toda la lección. Entre los dos extremos del túnel, el tráfico va cifrado y
quien mira wan solo ve “dos direcciones hablan UDP por el puerto 51820”, sin las direcciones
internas, sin saber que es un ping. Fuera del túnel —en la red interna de cada sitio, o más
allá de b— el tráfico está en claro, como siempre.
Error común. Creer que una VPN hace anónimo o seguro a todo. Protege el tramo entre sus dos extremos. Lo que una VPN comercial hace es mover el extremo de salida a otro lugar: su proveedor ve todo lo que sale descifrado, igual que lo vería su ISP sin la VPN, y el servidor de destino sigue viendo una conexión en claro desde el extremo de la VPN. En nuestra captura, todo lo que pasa en la red de
bdespués de salir dewg0viaja sin cifrar. La VPN cambia quién puede ver su tráfico, no lo hace invisible.
Identidad por clave: un origen que no corresponde
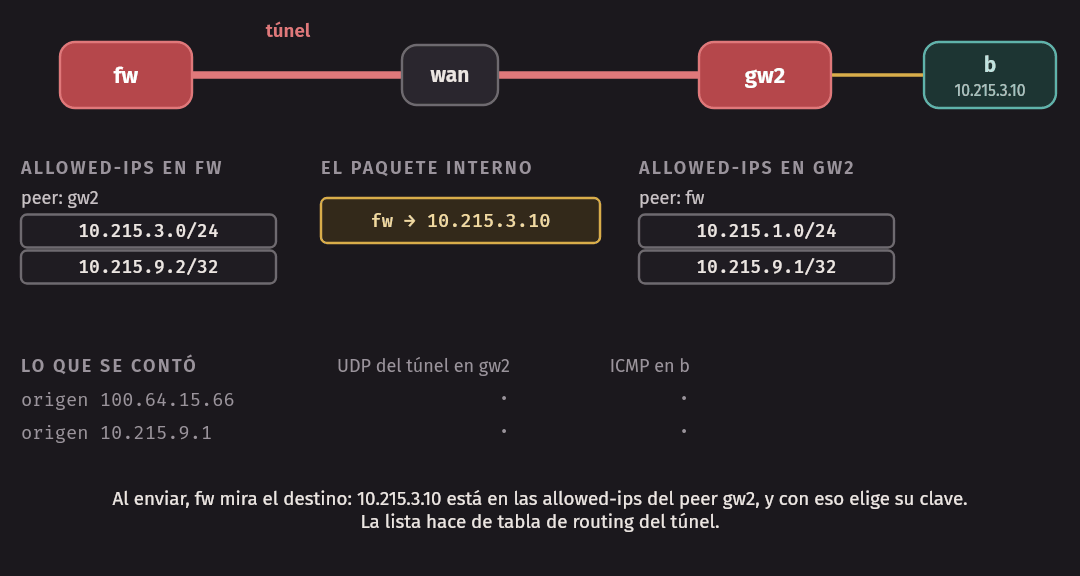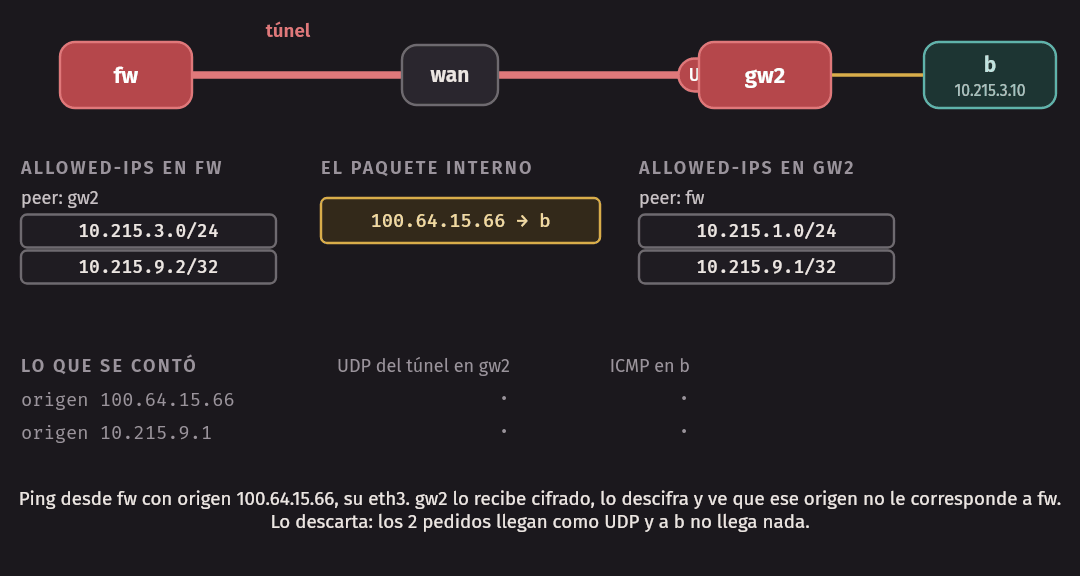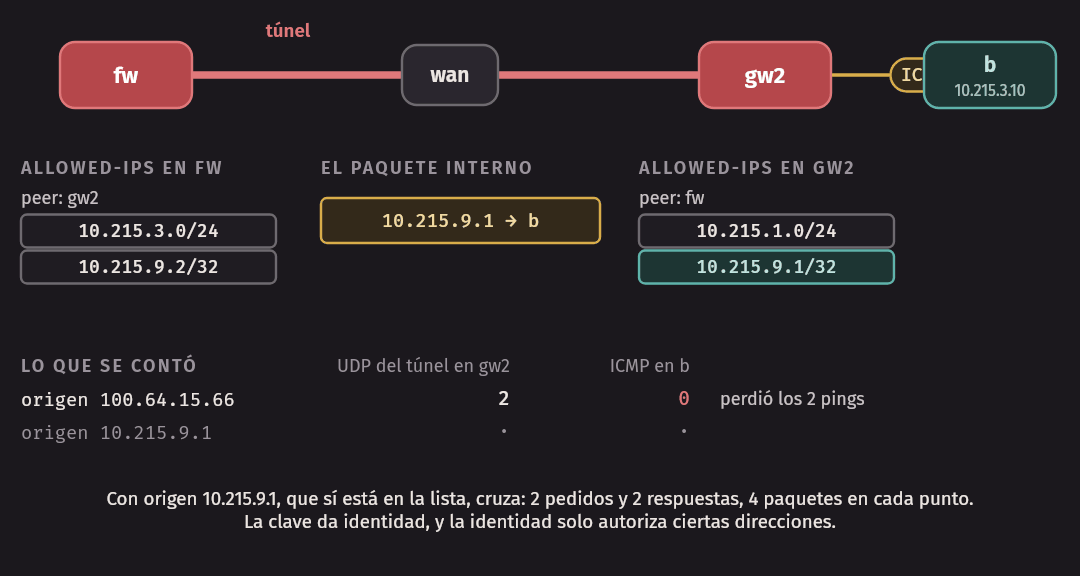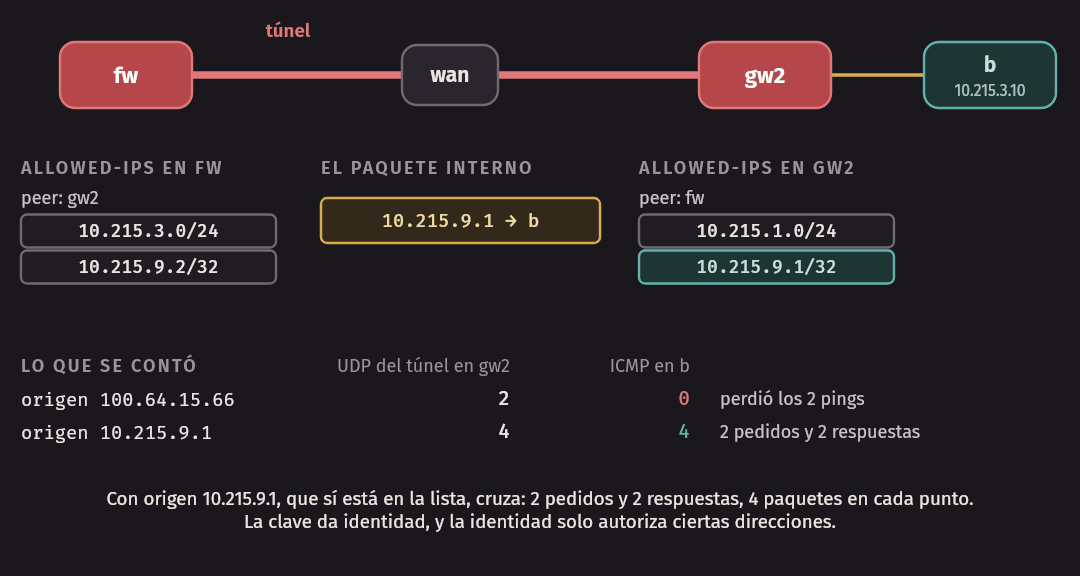
El cryptokey routing es también una defensa. gw2 solo acepta de fw paquetes cuyo origen esté
en su lista de allowed-ips:
$ python3 scenarios.py allowed
  gw2# wg show wg0 allowed-ips
2PtwHBSu04WEnQ7/rNNZUPmpw3W18K012xjpKAVapRI=	10.215.1.0/24 10.215.9.1/32
  origen 100.64.15.66: 2 packets transmitted, 0 packets received, 100% packet loss
    UDP del túnel en gw2: 2 paquetes; ICMP en b: 0 paquetes
  origen 10.215.9.1: 2 packets transmitted, 2 packets received, 0% packet loss
    UDP del túnel en gw2: 4 paquetes; ICMP en b: 4 paquetes
El escenario hace ping desde fw hacia b con dos orígenes. 100.64.15.66 es el eth3 de fw
y no está en la lista: el paquete llega cifrado a gw2 (los 2 UDP), gw2 lo descifra, ve que ese
origen no le corresponde al peer fw y lo descarta. A b no llega nada. 10.215.9.1 sí está en la
lista, y cruza: 2 pedidos y 2 respuestas, 4 paquetes en cada punto.
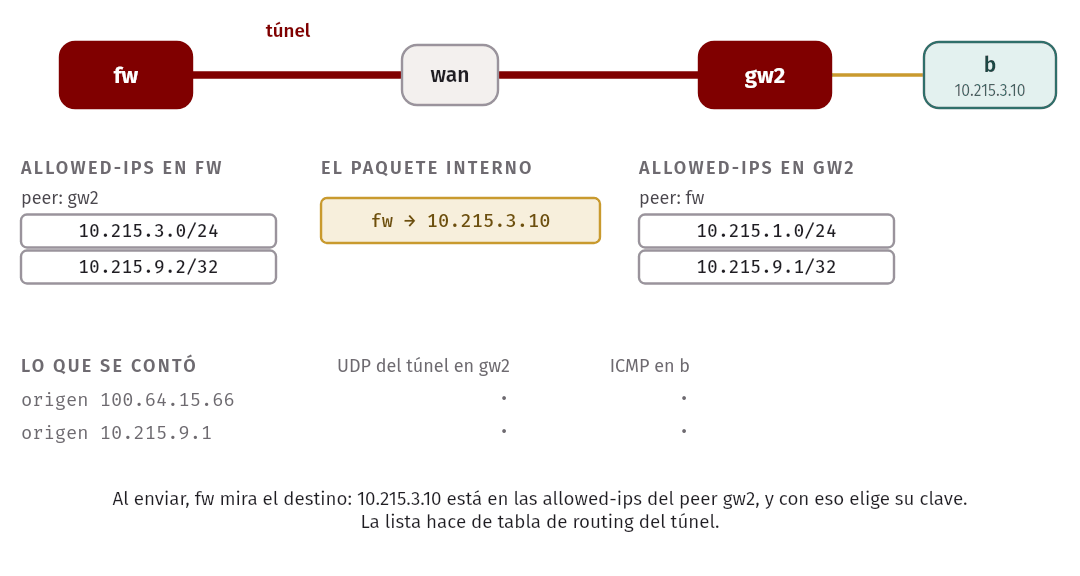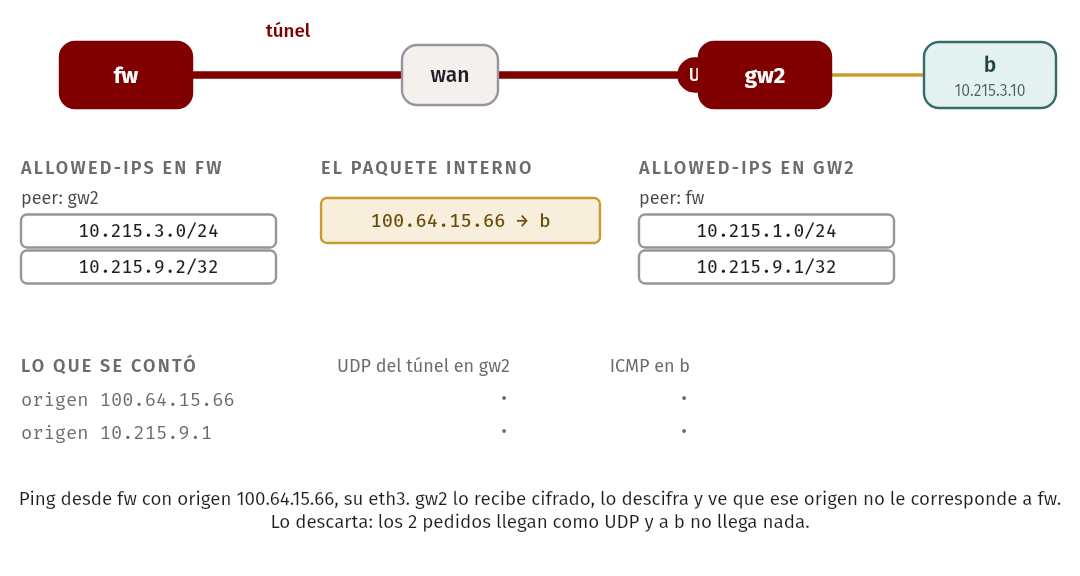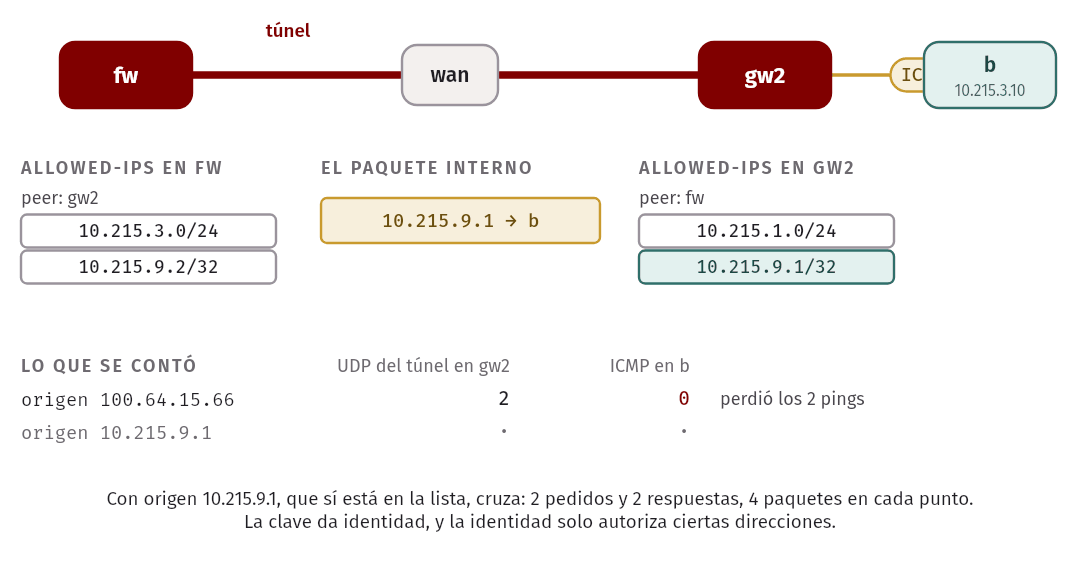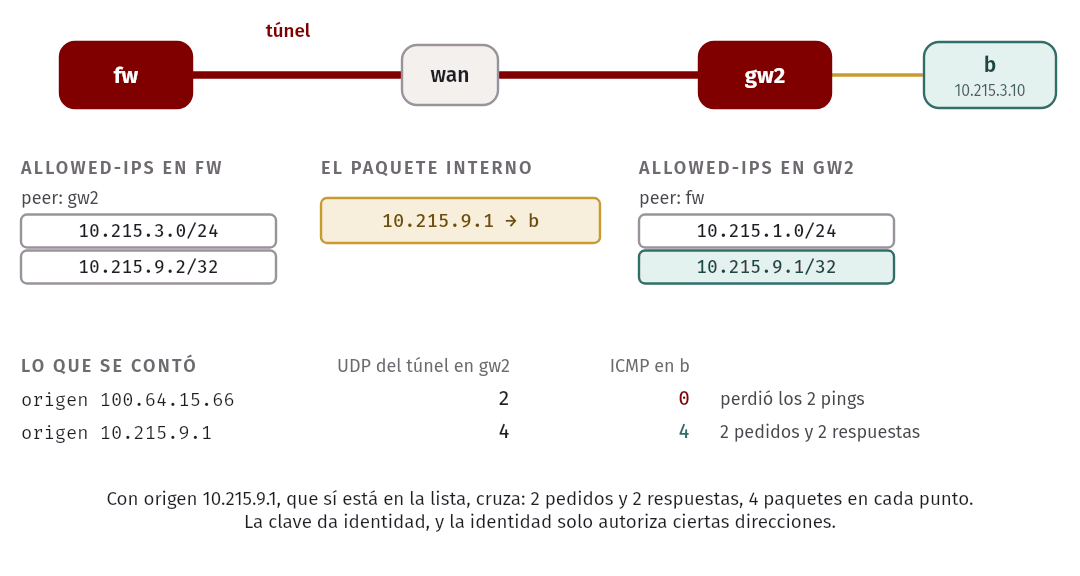
La clave da identidad, y la identidad solo autoriza ciertas direcciones. Es la sección 2 del
artículo hecha regla: “cualquier paquete que llegue por una interfaz de WireGuard tendrá un origen
auténtico”. Sobre eso, el firewall del otro sitio puede confiar en la dirección de origen de lo
que sale de wg0, algo que nunca puede hacer con el tráfico que llega de Internet.
El costo de la VPN: MTU y throughput
Una VPN no es gratis. Cuesta en tamaño de paquete y en throughput.
El tamaño primero. La sección 5.4.6 del artículo describe el mensaje de datos de WireGuard: un
encabezado de 16 bytes (tipo, un índice de receptor y un contador), la carga rellenada hasta un
múltiplo de 16 bytes, y la etiqueta de autenticación Poly1305 de 16 bytes. O sea, el UDP lleva
redondeo16(interno) + 32. Lo comprobamos variando el tamaño de un ping. Por defecto manda 56
bytes de datos, que con los 8 del ICMP y los 20 del IP hacen un datagrama interno de 84 bytes; con
-s 68 el interno es 96 (ya múltiplo de 16) y con -s 69, 97. Capturamos el UDP externo en el
medio:
$ python3 scenarios.py overhead
    -s 56: interno 84, afuera UDP, length 128
    -s 68: interno 96, afuera UDP, length 128
    -s 69: interno 97, afuera UDP, length 144
La cuenta: 84 y 96 se redondean a 96, y 96 + 32 = 128; 97 se redondea a 112, y 112 + 32 = 144.
El salto entre -s 68 y -s 69 es la prueba del relleno: un byte más de carga empuja el redondeo
al siguiente múltiplo de 16 y el paquete externo crece 16 bytes de golpe. Si el overhead fuera
constante, habría subido solo un byte.
A eso hay que sumarle, por fuera, los 20 bytes del nuevo encabezado IP y los 8 del UDP. Por eso la
MTU de wg0 es 1420: WireGuard reserva 80 bytes sobre los 1500 del enlace para su propio
peso en el peor caso (un encabezado externo IPv6, más el encabezado y la etiqueta). Un paquete que
entre al túnel más grande que eso no cabe. Lo interesante es cómo se entera el emisor: con
PMTUD, el descubrimiento de MTU del camino. Tras una transferencia grande de la oficina hacia
b, la oficina cachea la MTU del túnel en su ruta:
$ python3 scenarios.py pmtu
IP (tos 0xc0, ttl 64, id 19096, offset 0, flags [none], proto ICMP (1), length 576)
    10.215.1.1 > 10.215.1.10: ICMP 10.215.3.10 unreachable - need to frag (mtu 1420), length 556
	IP (tos 0x0, ttl 64, id 59619, offset 0, flags [DF], proto TCP (6), length 1500)
    10.215.1.10.41512 > 10.215.3.10.5301: Flags [.], seq 3218855649:3218857097, ack 2592732410, win 502, options [nop,nop,TS val 3576300894 ecr 58448353], length 1448
  ofi# ip route get 10.215.3.10
10.215.3.10 via 10.215.1.1 dev eth1 src 10.215.1.10 uid 0
    cache expires 596sec mtu 1420
fw recibió un segmento de 1500 bytes con el bit “no fragmentar” (DF). No cabía en wg0, así que
contestó con un ICMP que trae adentro el inicio del paquete que causó el problema. La oficina lo
guardó en su cache de rutas: de ahí la última línea.
De ahí sale una consecuencia práctica para los firewalls: si alguien bloquea esos ICMP, PMTUD se
rompe y las conexiones grandes se cuelgan sin motivo aparente. Es uno de los errores de
configuración más difíciles de diagnosticar. En esta topología el ICMP lo genera el propio
fw (su cadena output acepta por defecto), así que llega; pero cuando quien lo genera es un
router más allá del firewall, el ICMP entra como una conexión nueva ligada a un flujo conocido,
y es la regla ct state established,related accept la que lo deja pasar. Bloquear el tráfico
related es, justamente, una de las formas de romper PMTUD sin darse cuenta.
El throughput después. Para no mezclar efectos, medimos el mismo camino de cuatro saltos de dos formas: con rutas temporales que lo llevan sin cifrar, y por el túnel. Las cifras dependen de la computadora y de lo que esté corriendo al mismo tiempo:
$ python3 scenarios.py cost
    sin cifrar    7479 Mbits/sec
    por el túnel  1407 Mbits/sec
    sin cifrar    6823 Mbits/sec
    por el túnel  1158 Mbits/sec
    sin cifrar    5800 Mbits/sec
    por el túnel  1397 Mbits/sec
El túnel va unas cinco veces más lento en esta máquina. Los encabezados no lo explican. Con MTU 1420, un segmento lleva 1368 bytes de datos (1420 menos 40 de IP y TCP, y 12 de timestamps) en un paquete externo de 1480, o sea 92 % de datos; sin túnel son 1448 de 1500, 97 %. Esa diferencia cuesta cerca de un 5 %. El resto lo atribuimos al trabajo de CPU de cifrar y descifrar, sin haberlo medido por separado: aquí nada limita el enlace salvo la propia CPU. En un enlace lento mandaría el enlace y se notaría casi solo el 5 %. El ejercicio 10 les pide comprobarlo.
En la práctica. El MSS que cada extremo anuncia en el SYN no conoce el túnel:
by la oficina anuncian 1460, calculado con la MTU de 1500 de sus propias LAN. El ajuste a la MTU del túnel lo hace PMTUD en el camino. Cuando PMTUD no es confiable (ICMP filtrado en algún lado), los firewalls de VPN suelen bajar a mano el MSS de los SYN que los cruzan, al valor del túnel: es el MSS clamping. En nuestra red no hace falta, porque PMTUD funciona.
Tres formas de proteger un camino
A lo largo del curso vimos tres maneras de cifrar y autenticar el tráfico, en tres capas distintas. Conviene ponerlas lado a lado, porque la pregunta de examen y la de la vida real es la misma: ¿qué protege cada una, y hasta dónde?
| Capa | Qué protege | Qué deja ver | Autentica con | |
|---|---|---|---|---|
| TLS 1.3 (semana 13) | transporte (sobre TCP) | una conexión entre una aplicación y un servidor | direcciones, tamaños y el SNI | certificados y autoridades |
| IPsec | red | todo el tráfico IP entre dos extremos | las direcciones externas (en modo túnel, solo las de los routers) | certificados o clave compartida, vía IKE |
| WireGuard | red | todo el tráfico IP entre dos peers | que dos direcciones hablan UDP por un puerto | claves públicas intercambiadas fuera de banda |
Las tres dan confidencialidad, integridad y autenticación en su tramo, con forward secrecy. Las diferencias importan:
- TLS protege una conexión, no una red. Cada aplicación la usa por su cuenta; lo que no va por esa conexión no está protegido. Y como vimos en la semana 13, revela el SNI: quien observa la red sabe a qué sitio se conectan, aunque no qué piden.
- IPsec y WireGuard protegen el tráfico IP entero, de cualquier aplicación, sin que esta se entere. Por eso son la base de las VPN: hacen que dos redes se comporten como una. El costo es que trabajan por debajo de las aplicaciones, y no saben nada de ellas.
- Ninguna oculta que hay tráfico. Un observador siempre ve que dos direcciones intercambian datos cifrados, y cuántos. Esconder eso —la existencia misma de la comunicación— es un problema mucho más difícil, que estas herramientas no resuelven.
Idea clave. La pregunta no es “¿esto es seguro?”, sino “¿qué tramo protege, y qué sigue viendo quien observa la red?”. Para TLS, el tramo es una conexión y se ve el SNI. Para una VPN, el tramo llega hasta su otro extremo y se ven las direcciones públicas. Más allá de ahí, nada de esto ayuda.
Ejemplo resuelto: seguir un paquete por el firewall y el túnel
Juntemos todo en el ejercicio que el examen final suele pedir: seguir un paquete salto por salto,
diciendo en cada tramo qué encabezados tiene y qué direcciones quedan visibles. Tomamos el ping
de la oficina (10.215.1.10) al host b del otro sitio (10.215.3.10), con el firewall y el
túnel arriba. Lo que sigue sale de la captura en tres puntos de la sección anterior.
Tramo 1, red interna del sitio A (ofi → fw, visto en fw eth1). El paquete es un
datagrama IP normal, con las direcciones internas. fw lo recibe. Como su destino 10.215.3.0/24 tiene ruta por wg0, el firewall lo evalúa en la
cadena forward con oifname wg0: la regla iifname eth1 oifname wg0 accept lo deja pasar, y
conntrack anota la conexión para dejar volver la respuesta.
Tramo 2, la red ajena (fw → wan → gw2, visto en wan eth1). Al salir por wg0,
WireGuard cifra el datagrama interno entero y lo mete en un UDP entre las direcciones públicas
de los dos routers. El datagrama interno desaparece de la vista.
Quien observe wan solo ve esto: dos direcciones hablando UDP por el puerto 51820, con una carga
de 128 bytes (los 84 del ping interno, rellenados a 96 y con 32 bytes de encabezado y etiqueta
de WireGuard). No ve 10.215.1.10, ni 10.215.3.10, ni que es un ping.
Tramo 3, red interna del sitio B (gw2 → b, visto en b eth1). gw2 recibe el UDP,
descifra, comprueba que el origen interno está en la lista de allowed-ips del peer fw, y lo
reinyecta en su red. El datagrama vuelve a ser el original.
b responde, y todo pasa al revés: su respuesta entra a gw2, se cifra, cruza wan como UDP, y
fw la descifra y la entrega a ofi. En fw, la respuesta calza como established en
conntrack, así que no necesita una regla propia.
Ahora la extensión que el examen suele agregar: ¿y si el sitio A tuviera un NAT de salida,
como el de la semana 4? La clave está en el orden. El NAT y el túnel se aplican a tramos
distintos: el tráfico hacia b va por wg0 y no se traduce, porque para el NAT el destino
10.215.3.0/24 no es “afuera” sino la otra parte de la red privada, alcanzable por el túnel. Solo
el tráfico que sale de verdad hacia Internet (hacia eth3) pasaría por el NAT. Por eso, en un
router que hace las dos cosas, el orden de las tablas importa: primero decidir si un paquete va al
túnel, y recién después aplicar el NAT a lo que quede. Equivocar ese orden —mandar al NAT lo que
debía ir al túnel— es un error clásico que rompe la VPN sin que se caiga ningún enlace.
Idea clave. En cada salto, pregúntense tres cosas: ¿qué encabezados tiene el paquete?, ¿qué direcciones son visibles?, ¿qué decisión toma este nodo (forwarding, firewall, cifrar, traducir)? La respuesta cambia en cada tramo, y esa es toda la historia de cómo viaja un paquete por una red real.
El laboratorio de la semana
Trabajen en code/week-15/, dentro del contenedor del curso. El laboratorio tiene dos mitades:
el firewall y la VPN, sobre la misma topología de dos sitios.
cd code/week-15
make          # crea las claves de WireGuard
make up # levanta la topología- El firewall. Abran
lab/firewall.nft. Tiene la estructura y losTODO: completen las reglas para que de adentro se salga, la DMZ sea accesible solo en 80 y 443 desde afuera, y la red interna quede protegida. Cárguenlo condocker exec -i clab-w15-sitios-fw nft -f - < lab/firewall.nft. Editen el archivo, no usen el guardado en vivo del router. - Probar cada regla. Con
ncycurldesdeext,ofiyweb, comprueben la tabla de la política. Anoten, para cada prueba, qué esperaban y qué pasó. Fíjense en la diferencia entre un puerto que el firewall rechaza y uno aceptado sin servidor detrás. - El túnel. Con
scenarios.py wireguardo a mano, levanten WireGuard entrefwygw2. Confirmen conwg showel handshake, y con unpingdeofiabque la oficina alcanza el otro sitio. - Capturar los dos lados. Capturen en
fw eth1, enwan eth1y enb eth1a la vez, y comparen el paquete interno con el externo. Expliquen, con su captura, qué protege el túnel y qué no. - Medir el costo. Con
iperf3, comparen el throughput por el túnel contra un camino sin cifrar, y revisen la MTU cacheada conip route get. Repitan las mediciones; den tendencias, no cifras exactas.
Como el firewall de lab/ empieza con TODO, make test salta las pruebas del firewall
hasta que lo completen, igual que en las semanas 4 y 10 con el código del laboratorio. Las pruebas
del túnel y de IPsec corren de todas formas.
make test
make test crea las claves, levanta la topología, corre test_net.py y siempre la destruye,
incluso si algo falla. Las pruebas comprueban lo que afirman estos apuntes: que el firewall deja
la DMZ accesible y la red interna no, que la DMZ no abre conexiones hacia adentro, que las cadenas descartan por defecto, que en el medio del
túnel solo se ve UDP cifrado y no el ICMP interno, que un origen fuera de allowed-ips no se
enruta, que PMTUD cachea la MTU del túnel, y que ESP oculta la carga mientras AH no. Las
mediciones usan márgenes amplios a propósito: la red es compartida y ruidosa, y una prueba que
exija una cifra exacta fallaría sin que nada esté mal.
$ make test
...
Ran 17 tests in 70.967s
OK
make clean destruye la topología, borra las claves y las capturas, y quita el estado de
Containerlab, para que cada corrida empiece de cero.
La Sesión B: presentación de los proyectos
La Sesión B no es una clase: cada equipo presenta P5. Muestran wasi respondiendo sobre rimay
en Qhapaq Ñan, con su nombre en DNS, desde un host de otro AS, cruzando BGP. El docente corta
un enlace con otro camino disponible mientras se baja un archivo grande, y la transferencia debe
terminar correctamente: ahí se ve si rimay de verdad recupera la pérdida y si la red encuentra otro camino. Las
preguntas van sobre las decisiones de diseño y las mediciones —rimay frente a TCP—, no sobre el
código línea por línea. El enunciado y las reglas están en
projects/p5-wasi/README.md; aquí no los repetimos.
Repaso guiado para el examen final
El examen final (semana 16) cubre todo el curso, con énfasis en las semanas 9 a 15. El formato
está en exams/README.md. Este repaso no agrega temas: ordena lo que ya
vieron alrededor de las cosas que el examen suele pedir.
- Seguir un paquete, salto por salto, con túneles. La especialidad de esta semana. Tomen el
pingde la oficina ab: enfw eth1es10.215.1.10 -> 10.215.3.10, ICMP; al entrar awg0se cifra; enwanes100.64.15.66 -> 100.64.15.70, UDP 51820; al salir porwg0engw2vuelve a ser el ICMP interno. Sepan decir, en cada salto, qué encabezados hay y por qué. Combínenlo con lo de la semana 4: añadan un NAT y digan qué cambia. - Transporte y congestión (semanas 9 a 11). Go-Back-N y Selective Repeat a mano; el diagrama
de
cwndde Reno con una pérdida; el cálculo del RTO; por qué AIMD converge. Lean una captura de TCP: handshake, MSS, ACK duplicados, fast retransmit. - Aplicaciones (semanas 12 y 13). Una resolución de DNS de la raíz hacia abajo; qué autentica DNSSEC y qué cifra DoH; el handshake de TLS 1.3 y qué garantiza; por qué QUIC corre sobre UDP.
- Redes modernas (semanas 14 y 15). Por qué un data center usa Clos y ECMP reparte por flujo; qué separa SDN; y, de esta semana, para un ataque de cada capa, la defensa y su límite.
- Qué NO protege cada defensa. El examen pregunta límites: RPKI no valida el
AS_PATHcompleto; DNSSEC no da privacidad; TLS no oculta el SNI ni los tamaños; una VPN no protege más allá de su extremo; las SYN cookies no protegen el ancho de banda; el BCP 38 depende de que lo apliquen las otras redes. Tener esa lista clara vale varias preguntas.
La mejor preparación sigue siendo la del exams/README.md: resolver las preguntas de repaso de
cada guía, predecir lo que hará un laboratorio antes de correrlo, y releer su propio proyecto,
donde ya tomaron muchas de las decisiones que el examen pregunta.
Resumen
- Modelo de amenazas: toda defensa es contra un adversario con ciertas capacidades. Importa si está en el camino (ve el tráfico, no adivina) o fuera (no ve, tiene que adivinar), y si es pasivo o activo. “Seguro” sin decir contra quién no significa nada.
- Ataques por capa: ARP spoofing (enlace), IP spoofing y amplificación (red), SYN flood y DoS (transporte), envenenamiento de DNS (aplicación), hijack de BGP (routing). Casi todos salen de que un protocolo no autentica o no cifra, y casi todas las defensas envuelven, validan o filtran sin cambiar el protocolo.
- Firewall con estado: deniega por defecto, acepta lo establecido primero, y define la política
por zonas (interna, DMZ, afuera).
conntracksigue las conexiones;ct statelas consulta. Protegerinputademás deforward. Descartar se ve como filtrado. Rechazar da un error enseguida, pero con ICMP yEHOSTUNREACH, no con el RST y elECONNREFUSEDde un puerto cerrado. - Zero trust: no confiar en alguien solo por estar dentro de la red; autenticar cada acceso.
- IPsec: AH autentica, ESP cifra; modo transporte entre hosts, modo túnel entre sitios; una SA por sentido; IKE negocia las claves. Correcto pero complejo.
- WireGuard: una interfaz
wg0, identidad por clave pública, cryptokey routing con allowed-ips, sin agilidad de algoritmos, 1-RTT sobre UDP. Simple de usar y de auditar. - Qué protege una VPN: el tramo entre sus dos extremos. En el medio solo se ve UDP cifrado entre las direcciones públicas; fuera del túnel, todo va en claro. No hace anónimo ni seguro a todo.
- Costo de la VPN: MTU más chica (
wg01420; PMTUD la propaga, y el firewall no debe bloquear los ICMP que la anuncian) y menos throughput por el cifrado en CPU.
Ejercicios
- Expliquen, para el ataque de amplificación de la semana 12, por qué usa UDP y direcciones falsificadas, y por qué un ISP que aplica BCP 38 lo detiene mientras que el servidor víctima no puede. ¿Qué tendría que pasar en Internet para que la amplificación con reflejo desapareciera?
- Escriban, para un servidor web en una DMZ, las reglas de un firewall con estado que: deje entrar desde afuera solo a 80 y 443; deje al servidor iniciar conexiones de salida (para actualizaciones); y bloquee todo lo demás. Indiquen qué pasa, con sus reglas, si el servidor es comprometido e intenta conectarse a la red interna.
- ¿Qué diferencia hay entre el modo túnel y el modo transporte de IPsec? ¿Cuál se usa entre dos
sitios y por qué? Dibujen, para un
pingde10.215.1.10a10.215.3.10, cómo se ve el paquete en el medio con ESP en cada modo, y digan qué direcciones quedan visibles. - ¿Qué protege WireGuard y qué no? Usen la captura de los tres puntos del laboratorio para
justificar la respuesta, y expliquen qué ve exactamente alguien que observa
wan. - Para un ataque de cada capa vista en el curso (enlace, red, transporte, aplicación, routing), indiquen la defensa que estudiaron y una limitación concreta de esa defensa.
- En el laboratorio, carguen el firewall y luego quiten la regla
ct state established,related accept, dejando el resto. Predigan qué conexiones dejan de funcionar y por qué, y compruébenlo. ¿Por qué esa regla va primero y no al final? - Con el túnel arriba, agreguen en
fwuna regla que descarte los ICMPfragmentation neededhacia la oficina, e intenten una transferencia grande deofiab. ¿Qué pasa? Expliquen la relación con PMTUD y con la MTU de 1420 dewg0, y propongan dos formas de arreglarlo. - Comparen el número de
allowed-ipsde un peer de WireGuard con un filtro de prefijos de BGP de la semana 7: ¿en qué se parecen como mecanismo de “solo acepto estas direcciones de ti”? ¿Qué garantiza WireGuard, además, que un filtro de BGP no puede garantizar sobre el origen? - Un compañero afirma: “uso una VPN, así que mi navegación es anónima y segura”. Desármenlo con precisión: ¿qué tramo protege la VPN?, ¿qué ve su proveedor de VPN?, ¿qué sigue viendo el servidor de destino?, ¿y qué relación tiene esto con el SNI de TLS de la semana 13?
- Midan con
iperf3, repitiendo varias veces, el throughput por el túnel y por un camino directo equivalente. Reporten el rango de cada uno, no una cifra. ¿Cuánto del costo atribuyen al cifrado y cuánto a la MTU más chica? Diseñen una medición que separe los dos efectos, y digan qué esperarían. - Expliquen por qué un firewall debe filtrar la cadena
inputademás deforward. Den un ejemplo concreto de un servicio del propio router que quedaría expuesto si solo se protegeforward, y escriban la regla que lo cierra. - Zero trust: tomen la red de dos sitios del laboratorio y describan cómo cambiaría si no se
confiara en “estar adentro”. ¿Qué autenticarían entre
ofiyweb? ¿Qué papel jugaría una clave por servicio, y en qué se parece a lo que hace WireGuard entre los dos sitios?