
Apuntes · Capítulo 14Redes modernas
Data centers, SDN, Wi-Fi y 5G
Data centers, SDN, Wi-Fi y 5G
Hasta aquí hemos tratado a la red como algo que nadie controla del todo: un Internet hecho de miles de dueños, con enlaces que fallan, rutas que se negocian y hosts que se portan como quieren. Esta semana miramos dos extremos donde las reglas cambian.
El primero es el data center. Tiene un solo dueño, cientos de miles de servidores en un mismo edificio y distancias de metros. Como todo está bajo un solo control, se pueden tomar decisiones que en Internet serían imposibles: elegir la topología, repartir el tráfico por muchos caminos a la vez, montar redes virtuales encima de la red física, y hasta sacar la inteligencia de los routers y ponerla en un programa central. Es la Sesión A.
El segundo es la red sin cables. Allí el problema es el opuesto: el medio es compartido, la señal se debilita, rebota y se mezcla con ruido, y el equipo se mueve. Wi-Fi y 5G son dos respuestas muy distintas a ese problema. Antes de llegar a ellas, la Sesión B abre con el caso más exigente que existe hoy para una red de data center: entrenar modelos de IA, donde un solo flujo lento atrasa a miles de GPU.
La idea que une la semana ya la conocen: separar lo que antes iba junto. Separar la red virtual de la física (overlays). Separar el plano de control del plano de datos (SDN). Separar en 5G quien decide de quien transporta. Y, de paso, volverá algo de la semana 5: casi siempre, lo que tarda en una falla no es calcular, sino enterarse.
Todo lo que se muestra de la Sesión A salió de una topología de Containerlab que ustedes pueden levantar. Las cifras de velocidad dependen de la computadora, y como el hash tiene una semilla propia en cada red, qué spine le toca a cada flujo cambia en cada ejecución. El comportamiento no. De Wi-Fi y 5G no hay radios en un laptop: lo que medimos allí es un modelo o una emulación, y el texto lo dice cada vez.
Ruta de lectura.
Antes de clase (obligatorio, unos 15 a 20 minutos). Sesión A: Por qué un data center es distinto, la introducción de Clos y leaf-spine con Sobresuscripción, la introducción de ECMP: repartir por flujo, la de Overlays: una red virtual sobre la red física con VXLAN, y la de SDN: sacar la decisión del router con Match-action. Sesión B: Qué cambia sin cables.
En clase. Sesión A: La red de esta semana, BGP dentro del data center, La política de hash en Linux, Por qué no por paquete, Flujos grandes, Cuando cae un spine, Dos clientes con la misma dirección, El paquete, capa por capa, MTU: lo que cuestan 50 bytes y Qué se gana y qué se arriesga. Sesión B: Redes para entrenar modelos de IA, Wi-Fi, 5G, Movilidad y TCP sobre un enlace que pierde.
Después de clase. Repasen con el Resumen y los Ejercicios, y preparen El laboratorio de la semana y
make test. Opcional: Más grande: tres capas, Entropía: para qué sirve el puerto de origen, Caso: Google y Orion y Dos direcciones y un agente: IP móvil. Para profundizar, las lecturas del libro y las gratuitas de la semana:Este capítulo acompaña a Kurose y Ross, Computer Networking: A Top-Down Approach (9.ª ed.). Para la Sesión A, las secciones 4.4 Generalized Forwarding and SDN, 5.5 The SDN Control Plane, 6.5.2 VXLANs y 6.6 Data Center Networking, y los capítulos Topologies, Routing, Virtualization y Software-Defined Networking de CS168. Complementarias: RFC 7938, BGP en data centers, y RFC 7348, VXLAN. Para la Sesión B, las secciones 7.1 a 7.5 Wireless and Mobile Networks, y los capítulos Collective Operations, Wireless Links y Cellular de CS168. Complementarias: Congestion Control y Host Networking, también de CS168. El código de la semana está en
code/week-14/.
La red de esta semana
Dos spines, tres leaves y seis hosts. l1 y l2 son además la entrada de dos clientes de un data
center, a y b, que usaremos en la parte de overlays. Está en code/week-14/fabric/fabric.clab.yml.
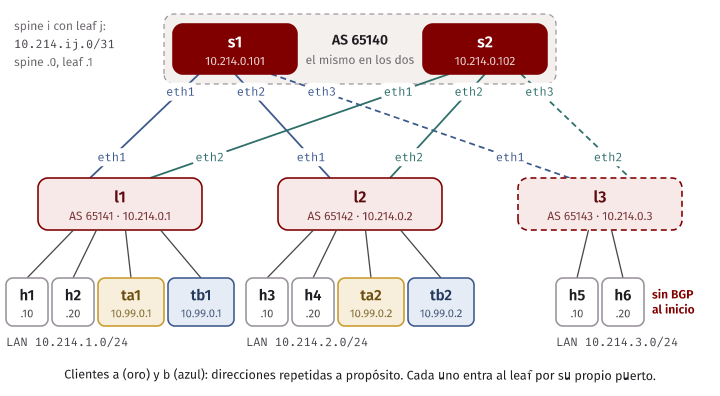
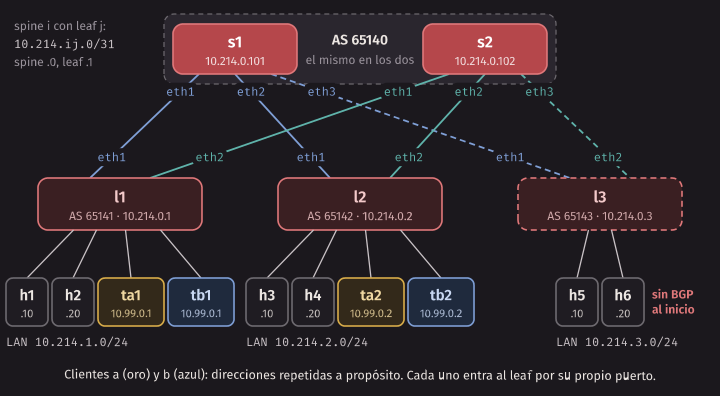
Cada leaf se conecta con cada spine, y los leaves no se conectan entre sí ni los spines entre sí. Las direcciones siguen un patrón para poder leerlas de memoria:
| Qué | Dirección | Ejemplo |
|---|---|---|
Enlace del spine i al leaf j |
10.214.ij.0/31: spine .0, leaf .1 |
s2-l1 es 10.214.21.0/31 |
LAN del leaf j |
10.214.j.0/24, con el leaf en .1 |
la de l2 es 10.214.2.0/24 |
| Hosts | .10 y .20 en su LAN |
h3 es 10.214.2.10 |
Loopback del leaf j |
10.214.0.j/32 |
l1 es 10.214.0.1 |
| Loopback de los spines | 10.214.0.101 y .102 |
|
Clientes a y b |
10.99.0.1 y 10.99.0.2, repetidas a propósito |
ta1 y tb1 son 10.99.0.1 |
El leaf l3 arranca sin BGP: configurarlo es el primer paso del laboratorio. Por eso, todo lo que
sigue usa l1 y l2, y los hosts h5 y h6 no alcanzan a nadie hasta que ustedes terminen.
Dentro del contenedor del curso, levanten la red y listen los escenarios:
cd code/week-14
make up
python3 scenarios.py
routeget Pregunta al kernel qué next hop usaría para 64 puertos de origen, con cada política.
predict ¿Acierta ip route get con el camino real de un flujo TCP? Con la política 1 y con la 3.
policy0 Hash solo con las direcciones IP (el valor de fábrica) y 16 flujos de h1 a h3.
policy1 Hash con la 5-tupla y los mismos 16 flujos.
elephants Dos flujos grandes con uplinks de 100 Mbit/s: chocando en un spine y separados.
perpacket Un flujo TCP por dos caminos con 2 ms de diferencia: por flujo y por paquete.
partial Se cae solo el enlace s1-l2: l1 deja de usar s1 para l2, y lo sigue usando para lo demás.
carrier Falla con aviso: se apagan las interfaces de s1. Los flujos que iban por él se cortan.
silent Falla silenciosa de s1 con temporizadores 3/9 (keepalive/hold).
silent_short Falla silenciosa de s1 con temporizadores 1/3.
silent_default Falla silenciosa de s1 con los temporizadores de fábrica, 60/180. Tarda unos cuatro minutos.
silent_bfd Falla silenciosa de s1 con BFD: 100 ms y multiplicador 3.
overlay Dos clientes con las mismas direcciones: VNI 100 y VNI 200, con VTEP en l1 y l2.
tenants Lo que ve cada cliente, y un ping de ta1 capturado en el underlay.
inner_ports Ocho flujos TCP dentro de un cliente: ¿cuántos puertos de origen externos se ven?
mtu Pings con DF desde un cliente, justo en el borde y en el tamaño completo, más un flujo TCP.
tenant_mtu Una salida: decirle a cada cliente que su MTU es 1450.
jumbo La otra salida, la de los data centers: darle más MTU al underlay.
warn VXLAN con MTU 1500 sobre un underlay de 1500: Linux avisa al cliente con ICMP.
entropy El túnel entre hosts con todos los puertos de origen externos, y con uno solo.
collective Un all-reduce entre cuatro hosts, sin y con un host atrasado.
wireless TCP sobre un último enlace de 100 Mbit/s y 40 ms de RTT, con y sin pérdida.
l3 Carga en l3 la configuración de BGP de lab/l3-bgp.conf.
vxlan Corre lab/vxlan.sh, que crea un túnel entre h2 y h6.
reset Vuelve al estado inicial.Cada escenario imprime los comandos que corre, y son los que ustedes harían a mano. En las salidas
de abajo los omitimos casi siempre. Un escenario no deshace el anterior: entre uno y otro, corran
python3 scenarios.py reset.
Los programas en C son pocos:
| Programa | Qué hace |
|---|---|
flow_probe.c |
Varios flujos UDP lentos, cada uno con su puerto: mide el hueco más largo de cada flujo |
df_ping.c |
Un ping con DF prendido y de tamaño exacto; el ping de los nodos no tiene esa opción |
ecmp_sim.c |
Cuentas de reparto por hash, sin red: balance, choques y qué se mueve si muere un camino |
ring_reduce.c |
Un all-reduce de verdad, en anillo sobre TCP |
dcf_sim.c |
Un modelo simplificado de CSMA/CA, ranura por ranura |
También hay dos herramientas en Python: sdn_ctl.py, un controlador de juguete, y tail_rounds.py,
la cuenta de por qué importa la peor latencia.
Por qué un data center es distinto
Definición. Un data center es un edificio con miles de servidores en racks, conectados por una red propia, dentro de la cual el operador controla todo: el hardware, la topología, los protocolos y a menudo también el software de los hosts.
En cada rack hay un switch arriba, el ToR (top of rack), y lo que importa es cómo se conectan los ToR entre sí. Antes de elegir una forma, hay que preguntarse qué tráfico va a llevar.
- Tráfico norte-sur: entra y sale del data center. Un cliente pide una página y el servidor le contesta.
- Tráfico este-oeste: queda entre servidores del mismo data center.
Una sola búsqueda del usuario (norte-sur, unos pocos KB) se convierte adentro en consultas a decenas de servicios, cachés y bases de datos (este-oeste). A eso se le suman copias de datos, migraciones de máquinas virtuales y trabajos de análisis. En un data center grande domina el este-oeste, y la red se diseña para eso.
Por qué un árbol con un núcleo enorme no alcanza
El diseño clásico era un árbol: ToR, luego un nivel de agregación y arriba un par de routers de núcleo muy grandes y caros.
                       [ núcleo ]            un equipo enorme: caro y difícil de reemplazar
                      /          \
                [ agregación ]  [ agregación ]
                 /    |    \      /    |    \
               ToR   ToR   ToR  ToR   ToR   ToR
Para el tráfico norte-sur funciona. Para el este-oeste tiene tres problemas:
- Cuello de botella. Todo lo que cruza entre dos ramas pasa por muy pocos enlaces, y estos tienen que ser cada vez más gruesos hacia arriba.
- El costo crece peor que el tamaño. Duplicar la capacidad del núcleo cuesta mucho más que el doble, y llega un punto en el que el equipo más grande del mercado ya no alcanza.
- Fallas grandes. Si cae un equipo del núcleo, se pierde una parte enorme de la capacidad.
Y spanning tree, si la red es de capa 2, empeora las cosas: como vimos en la semana 3, bloquea enlaces para evitar ciclos, justo los que necesitamos.
Idea clave. En vez de un equipo muy grande, muchos equipos baratos e iguales con muchos caminos entre ellos. La capacidad se consigue con cantidad, no con tamaño: es scale out, no scale up.
Clos y leaf-spine
Definición. Una red Clos arma una red de gran capacidad con varias etapas de switches pequeños, de modo que entre dos puntos hay muchos caminos. La idea es de Charles Clos, en 1953, y era para centrales telefónicas. La versión de dos capas que se usa en los data centers se llama leaf-spine:
- Los leaves son los ToR. Los servidores se conectan a ellos.
- Los spines solo conectan leaves.
- Cada leaf tiene un enlace a cada spine. No hay enlaces entre leaves ni entre spines.
De ahí salen tres propiedades que conviene leer en nuestra red:
- Dos leaves cualesquiera están a dos saltos (leaf, spine, leaf). Todos los caminos entre racks tienen el mismo largo, y la latencia es predecible.
- Hay tantos caminos como spines. Con dos spines, dos caminos. Con 16, dieciséis.
- Si se cae un spine se pierde 1/S de la capacidad, y no la conectividad. Con S = 2 es la mitad, con S = 16 es poco más del 6 %.
Crecer también es simple. ¿Más servidores? Más leaves, hasta agotar los puertos de cada spine. ¿Más capacidad entre racks? Más spines, hasta agotar los uplinks de cada leaf. Por eso, en una leaf-spine:
cantidad de spines  =  uplinks por leaf          (con un enlace a cada spine)
cantidad máxima de leaves  =  puertos por spine
Sobresuscripción
¿Cuántos uplinks debe tener un leaf? Si todos sus servidores quieren hablar con otros racks al mismo tiempo, ¿alcanza lo que tiene hacia arriba?
Definición. La sobresuscripción de un leaf es la capacidad hacia los servidores dividida entre la capacidad hacia los spines. Si da 1:1, los servidores pueden transmitir todos a la vez a toda velocidad hacia otros racks: es lo que se llama capacidad de bisección completa. Si da 3:1, en el peor caso a cada servidor le toca un tercio de su enlace.
Ejemplo resuelto. Un leaf tiene 48 puertos de 25 Gbps hacia servidores y 8 de 100 Gbps hacia spines. Los spines tienen 32 puertos de 100 Gbps.
hacia servidores:  48 × 25 Gbps  = 1200 Gbps
hacia spines:       8 × 100 Gbps =  800 Gbps
sobresuscripción:  1200 / 800    = 1,5 : 1

spines:            8   (un uplink a cada uno)
leaves máximos:    32  (un puerto de cada spine)
servidores:        32 × 48 = 1536
Para un 1:1 harían falta 12 uplinks de 100 Gbps: 1200 / 100. O sea, 12 spines en vez de 8, un 50 % más de spines. ¿Se justifica? Depende del tráfico, y por eso las sobresuscripciones modestas son comunes. La RFC 7938 observa que en la práctica se introduce en los ToR, y que limitarla a una sola capa les ahorra a las aplicaciones pensar en varios grupos de ancho de banda: dentro del rack, entre racks y entre clusters.
Error común. Calcular la sobresuscripción contando puertos. 48 puertos abajo y 8 arriba no es 6:1: hay que contar la capacidad. Los puertos de abajo y de arriba casi nunca son iguales.
Más grande: tres capas
Con dos capas, el tamaño máximo queda fijado por los puertos de cada spine. Para pasar ese techo se agrega
otra capa: una fat-tree de k puertos arma, con switches iguales de k puertos, k pods y (k/2)²
switches de núcleo. Se llega a k³/4 servidores con capacidad de bisección completa. Con k = 48:
servidores:  48³ / 4        = 27 648
switches:    5 × 48² / 4    =  2 880       (k² en los pods y k²/4 en el núcleo)
Veintisiete mil servidores con switches de 48 puertos, y ninguno especial. Eso es lo que el árbol con un núcleo enorme no podía hacer.
En la práctica. Nuestra red es una leaf-spine en miniatura y en software. Sus enlaces son pares veth dentro de una sola computadora: no dan los 100 Gbps de una tarjeta real, y su velocidad depende de la CPU. Por eso, cuando queremos ver un cuello de botella, lo creamos a mano con
tc.
BGP dentro del data center
Con muchos caminos entre racks, hay que elegir un protocolo de routing. Podría ser OSPF. Lo curioso es que muchas redes grandes usan BGP, el protocolo entre sistemas autónomos, dentro de un solo edificio y con un solo dueño. La RFC 7938 describe cómo y por qué. Sus razones, en corto:
- Más simple y con menos inundación. BGP se apoya en TCP en lugar de manejar sus propias adyacencias, y cada cambio inunda menos que en estado de enlace (link-state), donde todos reciben todo y recalculan.
- Control fino. Es fácil decidir qué se anuncia a quién, y un controlador externo puede inyectar rutas con una simple sesión de BGP.
- Un solo protocolo. No hace falta un protocolo interno además de BGP, que ya se necesita en el borde.
El esquema es este: sesiones eBGP de un salto, sobre cada enlace, con AS privados.
   Todos los spines:  AS 65140     (el mismo)
   Cada leaf:         su propio AS (65141, 65142, 65143)
¿Por qué los spines comparten AS, si es lo primero que uno cambiaría? Por dos consecuencias que vamos a
comprobar enseguida. Esta es la configuración de l1:
router bgp 65141
 bgp router-id 10.214.0.1
 ! Todavía sin políticas: en esta red cada ruta vale.
 no bgp ebgp-requires-policy
 ! Temporizadores cortos: keepalive 3 s, hold 9 s. El valor de fábrica es 60/180.
 timers bgp 3 9
 neighbor 10.214.11.0 remote-as 65140
 neighbor 10.214.11.0 description s1
 neighbor 10.214.11.0 advertisement-interval 0
 neighbor 10.214.11.0 timers connect 3
 neighbor 10.214.21.0 remote-as 65140
 neighbor 10.214.21.0 description s2
 neighbor 10.214.21.0 advertisement-interval 0
 neighbor 10.214.21.0 timers connect 3
 address-family ipv4 unicast
  network 10.214.1.0/24
  network 10.214.0.1/32
  ! Hasta 8 caminos de igual costo en la forwarding table.
  maximum-paths 8
 exit-address-family
Las líneas que importan esta semana son maximum-paths 8 y los temporizadores. Como en semanas anteriores,
apagamos ebgp-requires-policy porque aquí no estamos enseñando políticas: en una red real se le pondrían
filtros también dentro del data center.
Las sesiones se ven así:
$ docker exec clab-w14-fabric-l1 vtysh -c 'show bgp summary'

IPv4 Unicast Summary:
BGP router identifier 10.214.0.1, local AS number 65141 VRF default vrf-id 0
BGP table version 8
RIB entries 11, using 1408 bytes of memory
Peers 2, using 33 KiB of memory

Neighbor        V         AS   MsgRcvd   MsgSent   TblVer  InQ OutQ  Up/Down State/PfxRcd   PfxSnt Desc
10.214.11.0     4      65140         6         6        8    0    0 00:00:02            3        6 s1
10.214.21.0     4      65140         6         6        8    0    0 00:00:02            3        6 s2

Total number of neighbors 2
Y esta es la tabla de BGP para la LAN de l2, vista desde l1:
$ docker exec clab-w14-fabric-l1 vtysh -c 'show bgp ipv4 unicast 10.214.2.0/24'
BGP routing table entry for 10.214.2.0/24, version 7
Paths: (2 available, best #1, table default)
  Advertised to non peer-group peers:
  10.214.11.0 10.214.21.0
  65140 65142
    10.214.21.0 from 10.214.21.0 (10.214.0.102)
      Origin IGP, valid, external, multipath, best (Older Path)
      Last update: Mon Nov  2 16:16:37 2026
  65140 65142
    10.214.11.0 from 10.214.11.0 (10.214.0.101)
      Origin IGP, valid, external, multipath
      Last update: Mon Nov  2 16:16:37 2026
Lean las dos rutas. Tienen el mismo AS_PATH: 65140 65142. Eso es lo que hace posible el multipath: BGP
solo reparte entre rutas que empatan en el proceso de decisión hasta casi el final, y aquí empatan en todo,
incluido el AS del vecino. Siguen dos palabras: multipath, en las dos, y best, en una sola. BGP sigue
eligiendo una mejor ruta, que es la que anuncia a sus vecinos, pero instala en la forwarding table todas
las marcadas multipath.
Esa es la primera consecuencia del AS compartido. Si cada spine tuviera su propio AS, las rutas tendrían AS_PATH distintos y harían falta opciones extra para que BGP las considere iguales.
En la forwarding table del kernel se ve el resultado:
$ docker exec clab-w14-fabric-l1 ip route
10.214.0.2 nhid 23 proto bgp metric 20
	nexthop via 10.214.21.0 dev eth2 weight 1
	nexthop via 10.214.11.0 dev eth1 weight 1
10.214.0.101 nhid 24 via 10.214.11.0 dev eth1 proto bgp metric 20
10.214.0.102 nhid 18 via 10.214.21.0 dev eth2 proto bgp metric 20
10.214.1.0/24 dev br0 proto kernel scope link src 10.214.1.1
10.214.2.0/24 nhid 23 proto bgp metric 20
	nexthop via 10.214.21.0 dev eth2 weight 1
	nexthop via 10.214.11.0 dev eth1 weight 1
10.214.11.0/31 dev eth1 proto kernel scope link src 10.214.11.1
10.214.21.0/31 dev eth2 proto kernel scope link src 10.214.21.1
172.90.14.0/26 dev eth0 proto kernel scope link src 172.90.14.2
Dos líneas nexthop para 10.214.2.0/24. Para el loopback de un spine, en cambio, solo hay un camino. Un spine,
por su parte, tiene una sola ruta hacia cada leaf: la decisión de repartir se toma en el leaf.
$ docker exec clab-w14-fabric-s1 ip route
10.214.0.1 nhid 21 via 10.214.11.1 dev eth1 proto bgp metric 20
10.214.0.2 nhid 19 via 10.214.12.1 dev eth2 proto bgp metric 20
10.214.1.0/24 nhid 21 via 10.214.11.1 dev eth1 proto bgp metric 20
10.214.2.0/24 nhid 19 via 10.214.12.1 dev eth2 proto bgp metric 20
10.214.11.0/31 dev eth1 proto kernel scope link src 10.214.11.0
10.214.12.0/31 dev eth2 proto kernel scope link src 10.214.12.0
10.214.13.0/31 dev eth3 proto kernel scope link src 10.214.13.0
172.90.14.0/26 dev eth0 proto kernel scope link src 172.90.14.10
Si dejamos maximum-paths en 1 en l1, la tabla se queda con una sola línea, y el otro spine queda
sin usar para ese destino. make test lo comprueba.
Qué rutas no aparecen
La segunda consecuencia del AS compartido se ve cuando algo falla. Apagamos solo el enlace s1-l2, con
python3 scenarios.py partial:
10.214.2.0/24 nhid 18 via 10.214.21.0 dev eth2 proto bgp metric 20

% Network not in table
La primera línea es l1: hacia la LAN de l2 ya solo usa s2. Hacia todo lo demás sigue usando los dos spines. La
segunda línea es s1 diciendo que ya no conoce esa red. Piénsenlo: físicamente, s1 podría llegar a l2 por
s1 → l1 → s2 → l2. Sin embargo, no aprende esa ruta, porque el AS 65140 ya estaría en el AS_PATH y BGP descarta
cualquier ruta que contenga su propio AS. Es la misma detección de ciclos de la semana 6, usada aquí con
intención.
¿Y por qué querríamos perder esa ruta? Porque un camino que baja a un leaf y vuelve a subir no es un camino de verdad en una leaf-spine: el leaf sería tránsito entre spines, le quitaría capacidad a sus servidores y la latencia dejaría de ser predecible. La RFC 7938 lo plantea así: con un esquema de números de AS bien definido y la detección de ciclos de siempre, se controla el “BGP path hunting” (BGP explorando caminos cada vez más largos mientras converge), y esos caminos largos e indeseados se ignoran.
Idea clave. En esta red, BGP no se usa por sus políticas entre empresas, sino porque es simple, escala bien y se puede controlar. Con el mismo AS en los spines, el multipath sale solo y los caminos que dan la vuelta por un leaf no existen.
ECMP: repartir por flujo
Ya hay dos next hop en la tabla. Falta la pregunta de la semana: cuando llega un paquete, ¿por cuál se va?
Definición. ECMP (equal-cost multipath) es enviar el tráfico hacia un mismo destino por varios caminos de igual costo. Lo normal es decidir con una función hash, calculada sobre campos del encabezado del paquete, que da siempre el mismo resultado para los mismos campos.
¿Qué campos? Pensemos cada opción:
| Se decide con | Problema |
|---|---|
| Ronda de paquetes, sin hash | Un mismo flujo va por caminos distintos, y se desordena |
| Dirección de destino | Si muchos le hablan al mismo servidor, todos van por el mismo camino |
| Direcciones de origen y destino | Dos servidores con mucho tráfico entre ellos usan un solo camino |
| 5-tupla | Cada conexión va por su camino, y distintas conexiones se reparten |
La 5-tupla es la que identifica a un flujo: dirección de origen, dirección de destino, protocolo, puerto de origen y puerto de destino. Dos paquetes tienen la misma 5-tupla si y solo si son de la misma conexión. De ahí salen las dos propiedades que buscamos: dentro de un flujo no hay desorden, porque todos sus paquetes van por el mismo camino, y los flujos distintos se reparten, si el hash es bueno.
Como vieron con las tablas hash en otros cursos, el hash no reparte igual: reparte al azar. Con pocos flujos, el
azar se nota. Con ecmp_sim balance hacemos la cuenta, sin red:
$ bin/ecmp_sim balance 2 8 20000
2 caminos, 8 flujos: el camino más cargado lleva 1.27 veces lo justo en promedio (peor ensayo: 2.00)
$ bin/ecmp_sim balance 2 64 20000
2 caminos, 64 flujos: el camino más cargado lleva 1.10 veces lo justo en promedio (peor ensayo: 1.53)
$ bin/ecmp_sim balance 2 6400 2000
2 caminos, 6400 flujos: el camino más cargado lleva 1.01 veces lo justo en promedio (peor ensayo: 1.05)
$ bin/ecmp_sim balance 8 64 20000
8 caminos, 64 flujos: el camino más cargado lleva 1.53 veces lo justo en promedio (peor ensayo: 3.12)
$ bin/ecmp_sim balance 8 6400 2000
8 caminos, 6400 flujos: el camino más cargado lleva 1.05 veces lo justo en promedio (peor ensayo: 1.12)
“Peor ensayo: 2.00” con 2 caminos significa que, en alguna de las veinte mil pruebas, los 8 flujos cayeron en el mismo camino. Con miles de flujos pequeños, ECMP funciona muy bien. Con pocos flujos, o con muchos caminos, no tanto.
La política de hash en Linux
En Linux, qué campos entran al hash lo decide un sysctl, por espacio de red: net.ipv4.fib_multipath_hash_policy.
| Valor | Campos que usa |
|---|---|
| 0 (de fábrica) | Capa 3: direcciones de origen y destino |
| 1 | Capa 4: la 5-tupla |
| 2 | Capa 3, o la capa 3 interna si el paquete está encapsulado |
| 3 | Los que se pidan en fib_multipath_hash_fields |
La sorpresa es el valor de fábrica. Se puede preguntar al kernel qué haría con un paquete sin enviarlo, con ip route get, y
python3 scenarios.py routeget lo hace para 64 puertos de origen distintos, con TCP de h1 a h3:
  política 0: {'10.214.21.0': 64}
  política 1: {'10.214.11.0': 30, '10.214.21.0': 34}
  política 3: {'10.214.11.0': 39, '10.214.21.0': 25}
Con la política 0, los 64 flujos van por el mismo spine: entre h1 y h3 hay dos direcciones, y eso es lo único que entra al
hash. Por eso no cambiará nada aunque abran mil conexiones. Con las otras, se reparten más o menos a la mitad. Una consulta suelta se ve así:
$ docker exec clab-w14-fabric-l1 ip route get 10.214.2.10 from 10.214.1.10 iif br0 ipproto tcp sport 40000 dport 5201
10.214.2.10 from 10.214.1.10 via 10.214.11.0 dev eth1
    cache iif br0
El iif br0 importa: le dice al kernel que simule un paquete que entra por esa interfaz, o sea que l1 lo está reenviando.
Ahora con tráfico de verdad. policy0 y policy1 corren 16 flujos de iperf3 de h1 a h3 y leen cuánto mandó cada spine hacia
l2, con los contadores de /sys/class/net/*/statistics/tx_bytes. Tres corridas de cada una:
política 0
  s1 hacia l2:        0.0 MB    0.0 %
  s2 hacia l2:    21856.9 MB  100.0 %
  total: 41595 Mbit/s (depende de la computadora)
  s1 hacia l2:        0.0 MB    0.0 %
  s2 hacia l2:    15496.3 MB  100.0 %
  total: 29566 Mbit/s (depende de la computadora)
  s1 hacia l2:        0.0 MB    0.0 %
  s2 hacia l2:    13756.6 MB  100.0 %
  total: 26064 Mbit/s (depende de la computadora)
política 1
  s1 hacia l2:     5462.5 MB   54.9 %
  s2 hacia l2:     4484.0 MB   45.1 %
  total: 18843 Mbit/s (depende de la computadora)
  s1 hacia l2:     7246.4 MB   42.9 %
  s2 hacia l2:     9633.9 MB   57.1 %
  total: 32211 Mbit/s (depende de la computadora)
  s1 hacia l2:     4031.9 MB   35.2 %
  s2 hacia l2:     7412.0 MB   64.8 %
  total: 21716 Mbit/s (depende de la computadora)
(Las etiquetas política 0 y política 1 las agregamos aquí; cada corrida de un escenario imprime solo lo suyo.) La pregunta del laboratorio era: ¿se reparte igual? No. Con la
política 0 todo va por un lado: el 100 %. Con la política 1 se reparte, pero 35/65 no es 50/50, y aquí los totales ni siquiera cambian mucho porque los veth
no son el cuello de botella. Tampoco es seguro que en sus corridas el spine “cargado” sea s2: la semilla del hash cambia en cada red.
Error común. Probar ECMP con
ping. ICMP no tiene puertos, y variospingentre los mismos dos hosts van por el mismo camino. Unpingque funciona dice que ese camino funciona. Si el otro está roto, puede que no se enteren. Lo mismo ocurre con untraceroutesolo: muestra uno de los caminos, y no es que el otro no exista. En nuestra red, 16pingseguidos deh1ah3fueron todos por el mismo spine con las políticas 0, 1 y 3, ytraceroutecon 6 sondas por salto mostró un solo spine.
Una excepción: el hash que el paquete ya trae
Si son curiosos, van a intentar lo siguiente: elegir con ip route get un puerto de origen que va por s1, correr iperf3 --cport con ese
puerto, y comprobar con los contadores que de verdad pasó por s1. python3 scenarios.py predict lo hace para 12 flujos con cada política:
  política 1: ip route get acertó 5 de 12 flujos
  política 3: ip route get acertó 12 de 12 flujos
Con la política 3 y estos campos, ip route get no se equivoca. Con la política 1, acierta como quien tira una moneda. ¿Qué pasó? Que la documentación del
kernel la llama “5-tupla”, pero el código de net/ipv4/route.c (fib_multipath_hash) dice otra cosa:
/* short-circuit if we already have L4 hash present */
if (skb->l4_hash)
    return skb_get_hash_raw(skb) >> 1;
Si el paquete ya trae un hash de capa 4, se usa ese. Nuestros paquetes salen de un socket TCP del mismo kernel, cruzan un veth y llegan al leaf
conservando el hash que les puso el socket, que no se calcula con la 5-tupla. El resultado sigue siendo por flujo y sigue repartiendo, y por eso los
contadores se ven bien. Solo que no se puede predecir desde afuera con ip route get.
La política 3 no toma ese atajo, así que la usamos cuando necesitamos saber de antemano por dónde irá un flujo. Pedimos los campos con
fib_multipath_hash_fields=0x37: origen, destino, protocolo y los dos puertos.
En la práctica. En un equipo real el hash lo calcula el chip de forwarding, y cada fabricante tiene sus campos y su semilla. Si dos routers seguidos usan la misma función y la misma semilla, el segundo recibe solo flujos ya filtrados por el primero y no los reparte (se llama polarización). Por eso se configura una semilla distinta en cada equipo.
Ida y vuelta pueden ir por caminos distintos
Cada leaf calcula su propio hash, con su propia semilla. Nada obliga a que los datos de h1 a h3 y los ACK de h3 a h1 crucen el mismo spine. A TCP no le
importa: nunca le prometieron un camino simétrico. Sí importa cuando un firewall con estado está en un solo camino, o cuando uno intenta depurar con una
captura. Vamos a usar este dato en un momento, al contar cuántos flujos se ven afectados por una falla.
Por qué no por paquete
Repartir por paquete parece mejor: el reparto sería perfecto y un solo flujo grande podría usar todos los caminos. Entonces, ¿por qué no se hace?
Porque igual costo no significa igual latencia. BGP solo ve AS_PATH de igual largo. En un camino puede haber una cola más larga, un cable más largo o un equipo más lento. Si los paquetes de un flujo se alternan entre dos caminos con latencias distintas, llegan desordenados, y ustedes ya saben de la semana 10 lo que TCP hace con eso: lo trata como una posible pérdida.
Linux no reparte por paquete con estas rutas, pero podemos forzarlo con una regla de nft en l1 que le pone una marca alternada a cada paquete, con dos tablas de routing.
Limitamos cada uplink a 100 Mbit/s, y al camino por s2 le sumamos 2 ms. El escenario perpacket mide primero por flujo y luego por paquete:
l1# nft table ip w14steer { chain pre { type filter hook prerouting priority mangle; ip saddr 10.214.1.10 ip daddr 10.214.2.10 meta mark set numgen inc mod 2 offset 1; }; }Tres corridas, sin pérdidas programadas en ningún caso. “Fuera de orden” es el contador TcpExtTCPOFOQueue de h3, que suma cada segmento que TCP tuvo que guardar por haber llegado
antes de tiempo:
  por flujo:
        92 Mbit/s       0 retransmisiones      1513 fuera de orden en h3
  por paquete:
        22 Mbit/s    1393 retransmisiones      4600 fuera de orden en h3
  por flujo:
        91 Mbit/s       0 retransmisiones      1873 fuera de orden en h3
  por paquete:
        21 Mbit/s    1381 retransmisiones      4347 fuera de orden en h3
  por flujo:
        95 Mbit/s      20 retransmisiones       392 fuera de orden en h3
  por paquete:
        26 Mbit/s    1516 retransmisiones      5462 fuera de orden en h3
Con el doble de capacidad disponible, el flujo rinde menos de un tercio de lo que rendía por un solo camino, y más de mil retransmisiones aparecen donde no hubo pérdida programada. Dos milisegundos alcanzan: a 100 Mbit/s, en 2 ms pasan unos 17 segmentos de 1448 bytes. El receptor ve segmentos adelantados, el emisor interpreta que hubo pérdidas, retransmite cosas que ya llegaron y baja su ventana.
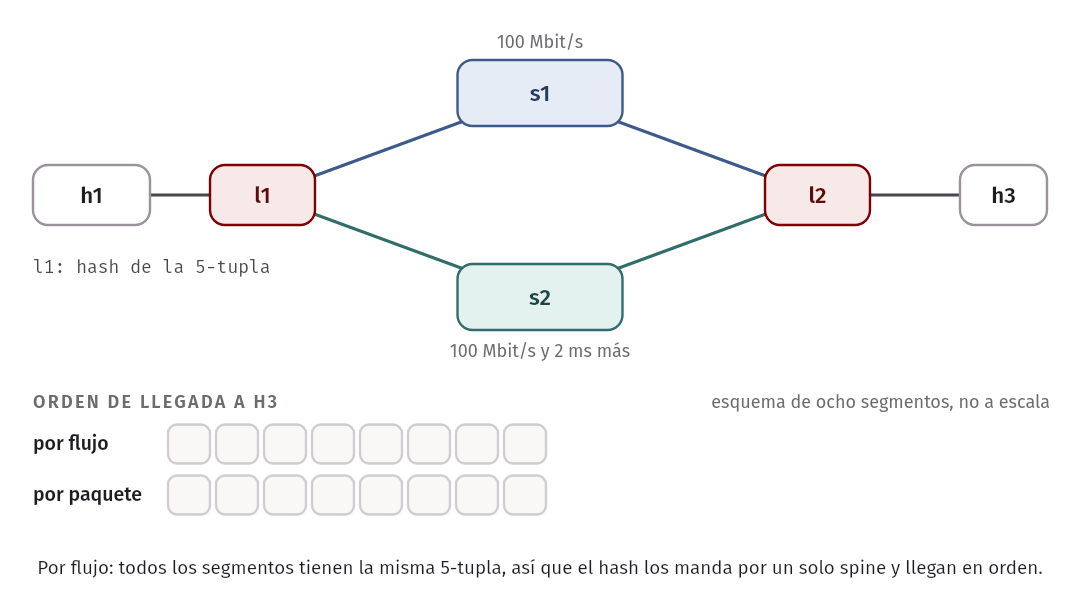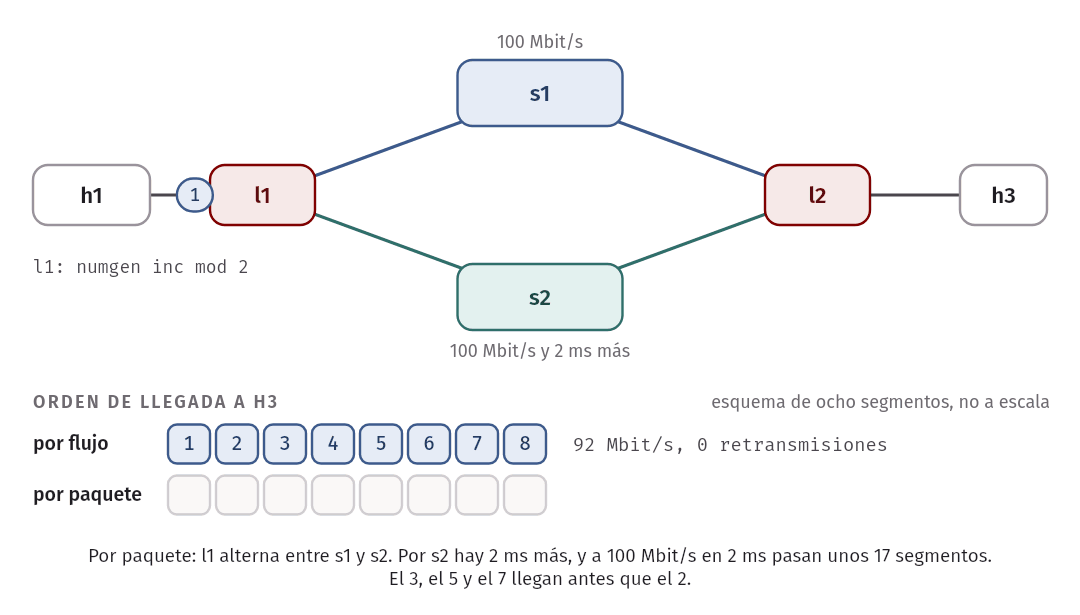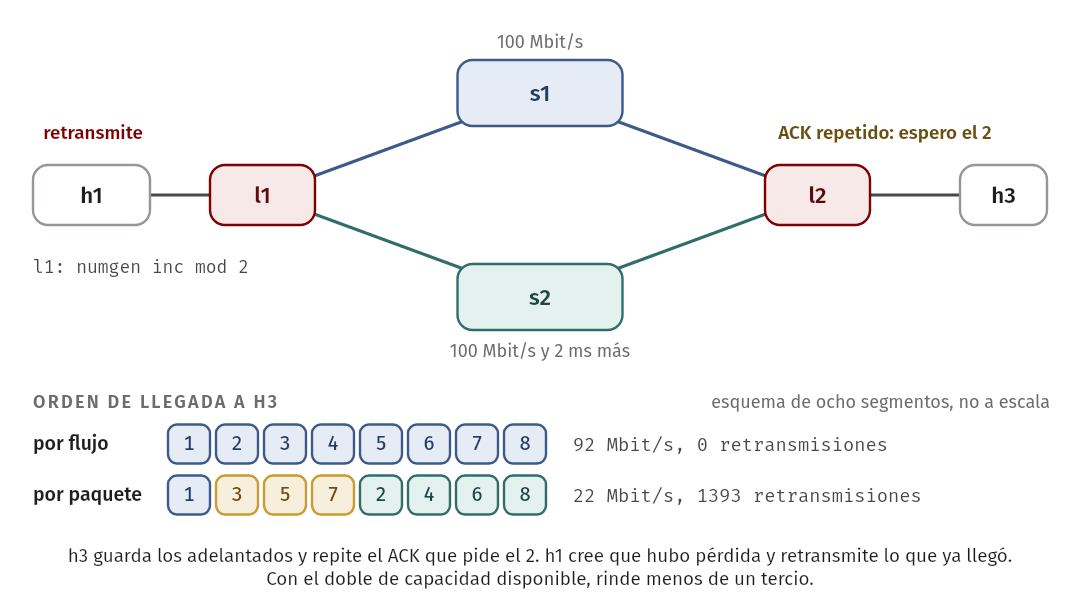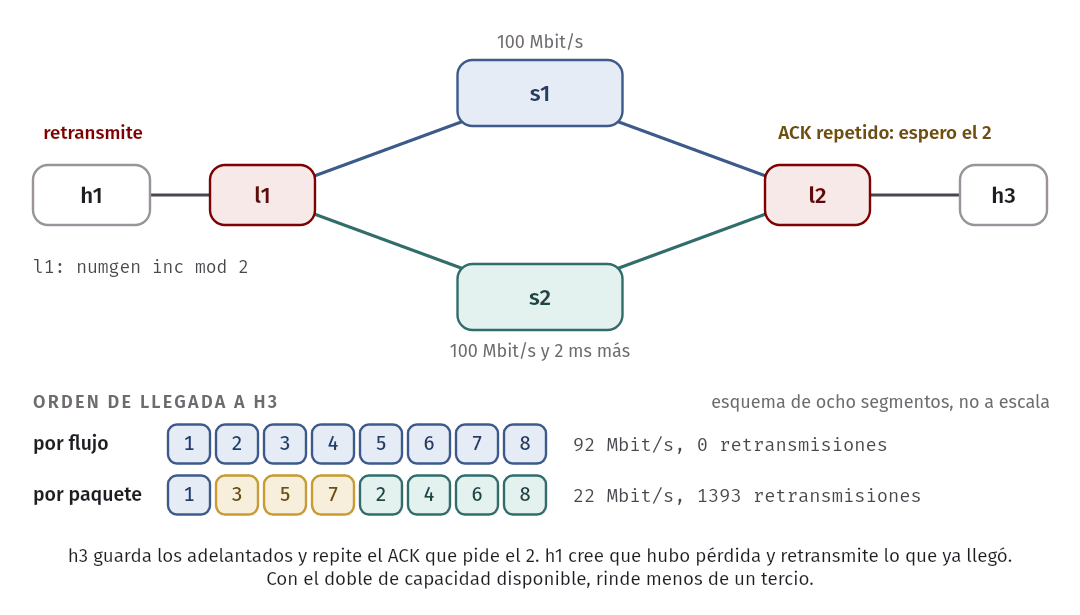
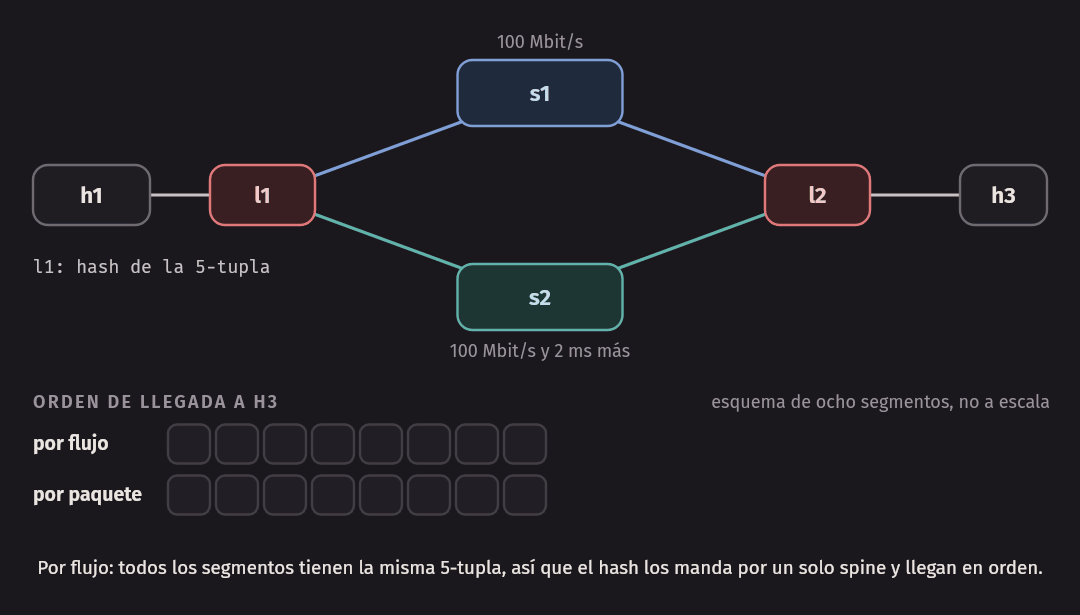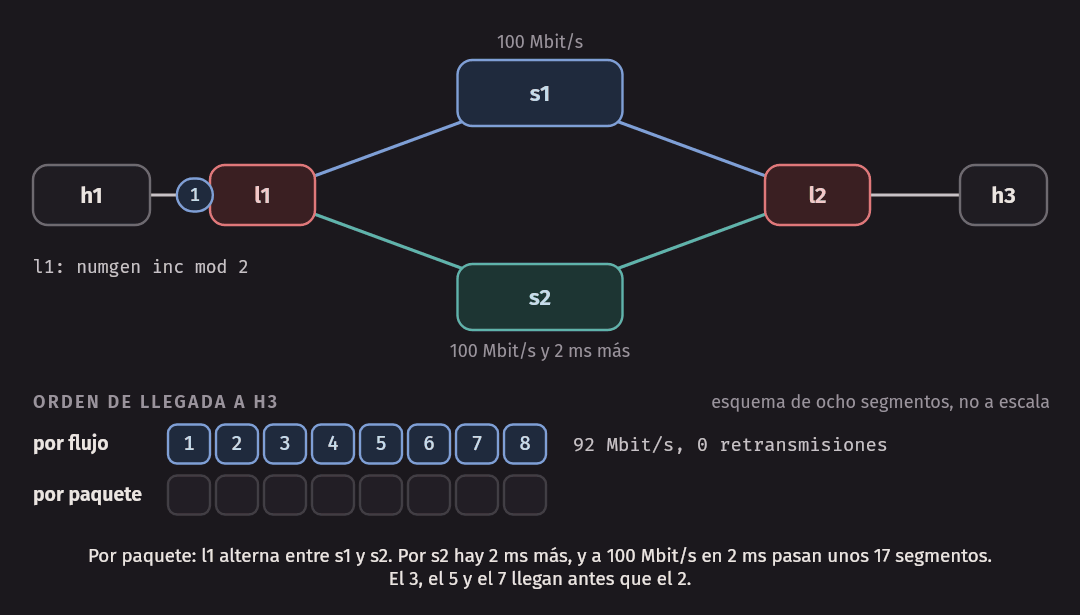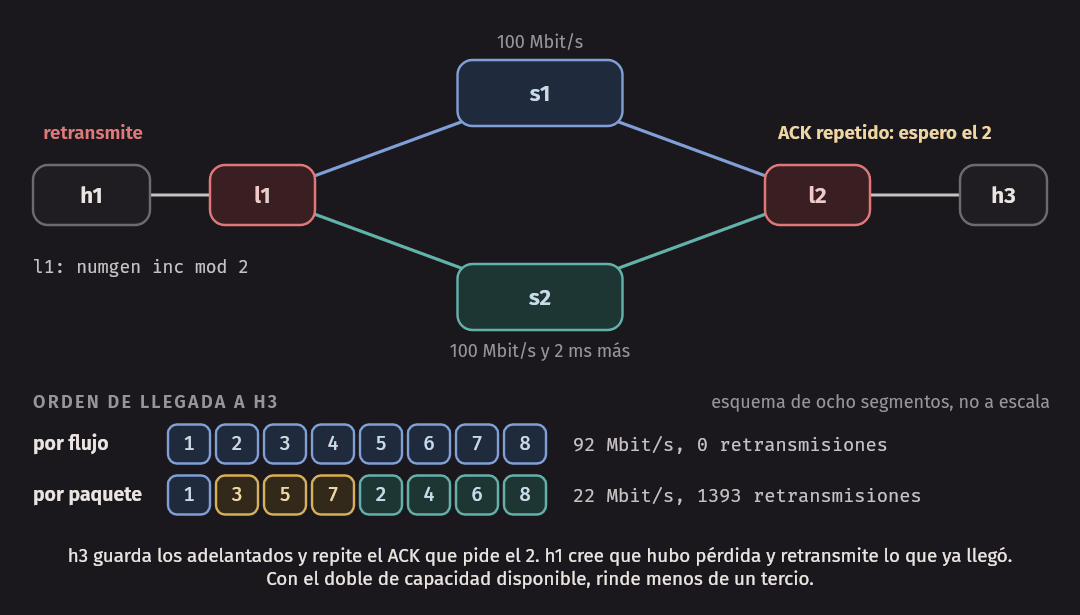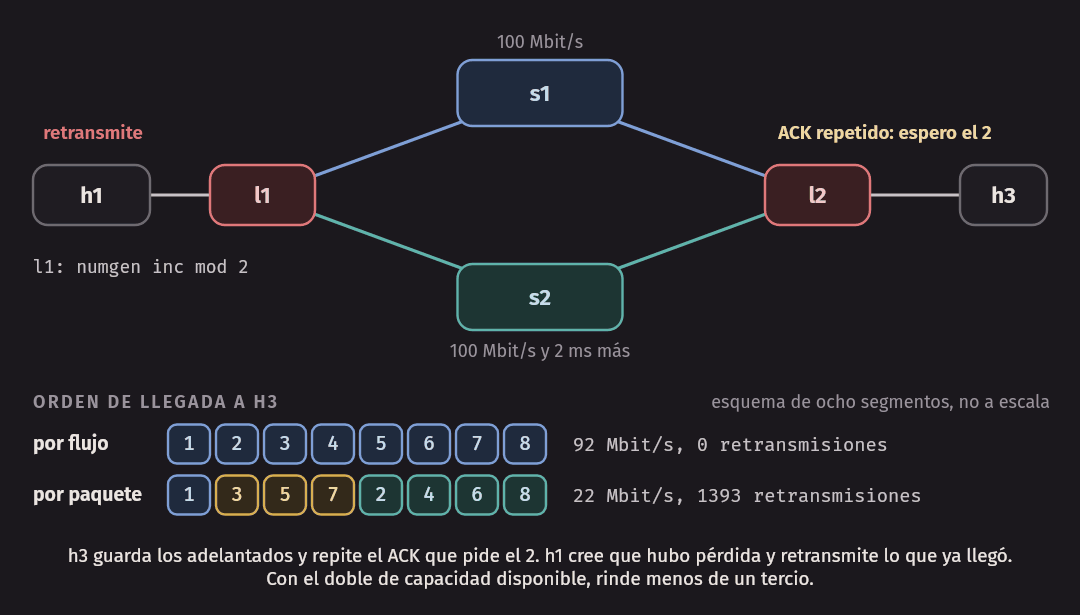
El contador de fuera de orden tampoco es cero por flujo: varió de una corrida a otra, y no sabemos del todo de dónde salen esos segmentos. Por eso la señal fuerte de esta medición son el throughput y las retransmisiones.
Idea clave. ECMP reparte por flujo para no desordenar. Es una decisión a favor de TCP, no de la red: reparte peor a cambio de no romper lo que corre encima.
Flujos grandes
Repartir por flujo tiene un costo. El hash cuenta flujos, no bytes. Un flujo que transfiere terabytes (un elefante) pesa para el hash lo mismo que una consulta de 2 KB (un ratón).
¿Qué pasa si dos elefantes caen en el mismo camino? elephants limita los uplinks de l1 a 100 Mbit/s, y con la política 3 elige puertos de origen que sabe a dónde van. Tres corridas:
  los dos por s1:       33.1 +   62.5 =   95.5 Mbit/s
  uno por cada spine:   95.6 +   95.6 =  191.2 Mbit/s
  los dos por s1:       53.1 +   42.5 =   95.6 Mbit/s
  uno por cada spine:   95.6 +   95.6 =  191.2 Mbit/s
  los dos por s1:       47.3 +   48.0 =   95.4 Mbit/s
  uno por cada spine:   95.4 +   95.4 =  190.9 Mbit/s
Los mismos dos flujos y la misma red: el doble de throughput o la mitad, según un hash. Y el otro spine, mientras tanto, está libre. ECMP no se entera, porque no mira la carga: solo mira encabezados.
¿Qué tan seguido pasa? Si cada flujo cae al azar, la cuenta es la del problema del cumpleaños. Con n caminos y k elefantes, la probabilidad de que ninguno choque es n! / ((n-k)! × n^k), y los caminos ocupados en promedio son n × (1 - (1 - 1/n)^k). El programa lo confirma:
$ bin/ecmp_sim elephant 2 2 200000
2 caminos, 2 flujos grandes: sin choques en 50.1 % de los ensayos; caminos ocupados en promedio 1.50; throughput total 75 % del ideal
$ bin/ecmp_sim elephant 4 4 200000
4 caminos, 4 flujos grandes: sin choques en 9.4 % de los ensayos; caminos ocupados en promedio 2.73; throughput total 68 % del ideal
$ bin/ecmp_sim elephant 8 8 200000
8 caminos, 8 flujos grandes: sin choques en 0.2 % de los ensayos; caminos ocupados en promedio 5.25; throughput total 66 % del ideal
$ bin/ecmp_sim elephant 8 4 200000
8 caminos, 4 flujos grandes: sin choques en 41.0 % de los ensayos; caminos ocupados en promedio 3.31; throughput total 83 % del ideal
Lean la de 8 y 8: con tantos caminos como elefantes, casi siempre hay choques (solo 0,2 % de las veces no los hay), y se pierde un tercio de la capacidad. Recuerden este número para la sección de IA.
¿Qué se hace al respecto? Varias cosas, y ninguna es gratis:
- Sobrar capacidad: enlaces mucho más rápidos que el flujo típico, para que los choques no duelan.
- Partir por ráfagas (flowlets): si un flujo hace una pausa más larga que la diferencia de latencia entre caminos, se puede cambiar de camino sin desordenar.
- Mirar la carga: equipos que tienen en cuenta la cola de cada enlace, o un controlador que mueve a los elefantes.
Qué se mueve cuando muere un camino
Otro detalle del hash. Cuando desaparece un next hop, los flujos que iban por él tienen que moverse: eso es inevitable. Pero ¿también se mueven los demás? Depende de cómo se pasa del hash al camino. Con módulo (hash % n), al cambiar n casi todo cambia de lugar. Con hash-threshold (RFC 2992, la idea que usa Linux), el espacio del hash se parte en regiones, y solo se corren los bordes. Con un esquema consistente, solo se mueve lo que estaba en el camino muerto.
$ bin/ecmp_sim rehash 2 1000000
2 caminos, muere uno; estaban en él: 50.0 % de los flujos
  módulo:         se mueven 49.9 %
  hash-threshold: se mueven 50.0 %
  rendezvous:     se mueven 50.0 %
$ bin/ecmp_sim rehash 4 1000000
4 caminos, muere uno; estaban en él: 25.0 % de los flujos
  módulo:         se mueven 75.0 %
  hash-threshold: se mueven 33.3 %
  rendezvous:     se mueven 24.9 %
$ bin/ecmp_sim rehash 8 1000000
8 caminos, muere uno; estaban en él: 12.5 % de los flujos
  módulo:         se mueven 87.4 %
  hash-threshold: se mueven 28.6 %
  rendezvous:     se mueven 12.5 %
Las cifras de hash-threshold son para un camino del medio, el que apaga ecmp_sim. Si muere uno de los extremos, las regiones de todos los demás se corren y, haciendo la cuenta, se mueve el 50 % de los flujos, sin importar cuántos caminos haya.
¿Por qué importa si un flujo se mueve a otro camino vivo? Por el desorden de la sección anterior: un flujo TCP que cambia de camino puede ver una ráfaga de segmentos desordenados. Y si detrás hay un balanceador que guarda estado por flujo, puede perder la conexión. En la red de este laboratorio, con dos spines, los tres esquemas dan lo mismo: los flujos del spine vivo no tienen a dónde más ir.
Cuando cae un spine
Paso 5 del laboratorio: apagar un spine, medir cuánto tarda en recuperarse y comparar con la semana 5. Ustedes ya saben lo que hay que preguntar: ¿la falla avisa o no avisa?
Para medir usamos flow_probe, que mantiene 16 flujos UDP de h1 a h3, cada uno con su puerto y un datagrama cada 20 ms, y al final dice cuál fue el hueco más largo de cada flujo. Solo medimos un sentido, y usamos UDP para no sumar el temporizador de TCP a lo que queremos ver. Usamos la política 1.
Falla con aviso. carrier apaga con ip link set down las tres interfaces de s1. Los leaves ven caer el carrier, y BGP tira la sesión al instante:
  flujos: 16; con corte: 0; sin corte: 16
  hueco máximo en los flujos sin corte: 34 ms
  flujos: 16; con corte: 0; sin corte: 16
  hueco máximo en los flujos sin corte: 29 ms
  flujos: 16; con corte: 0; sin corte: 16
  hueco máximo en los flujos sin corte: 31 ms
Contamos como corte un hueco de 150 ms o más. Si un datagrama va cada 20 ms, 30 ms no es un corte: como mucho se perdió uno. El tráfico cambió de spine más rápido de lo que estamos midiendo.
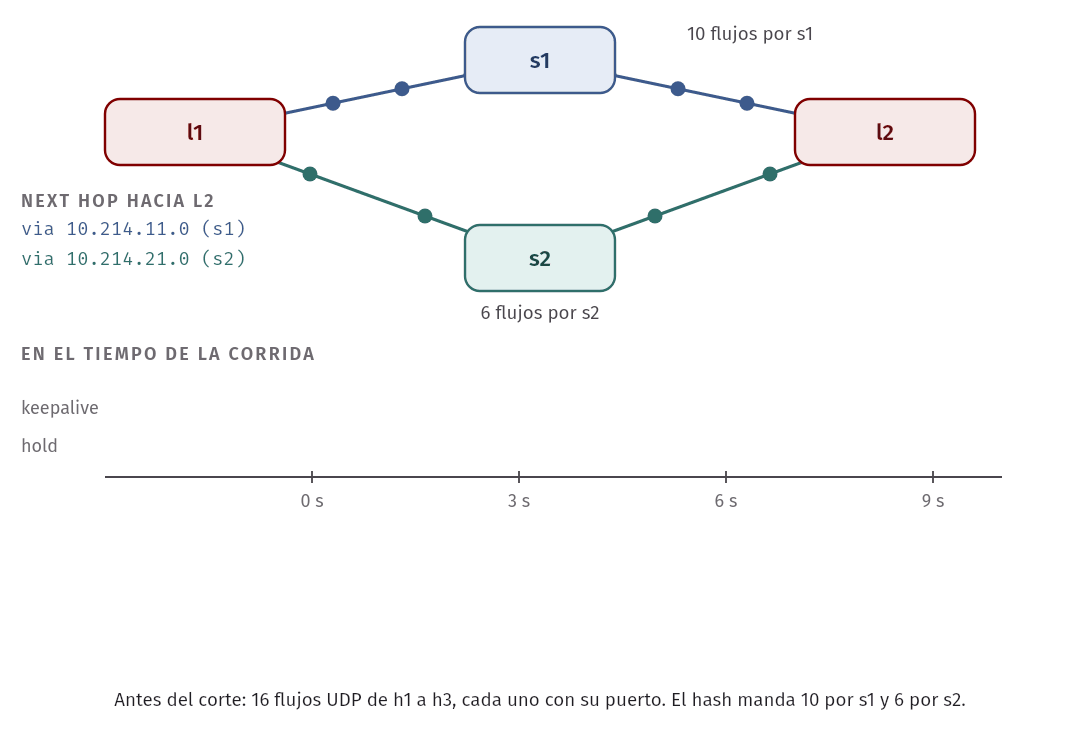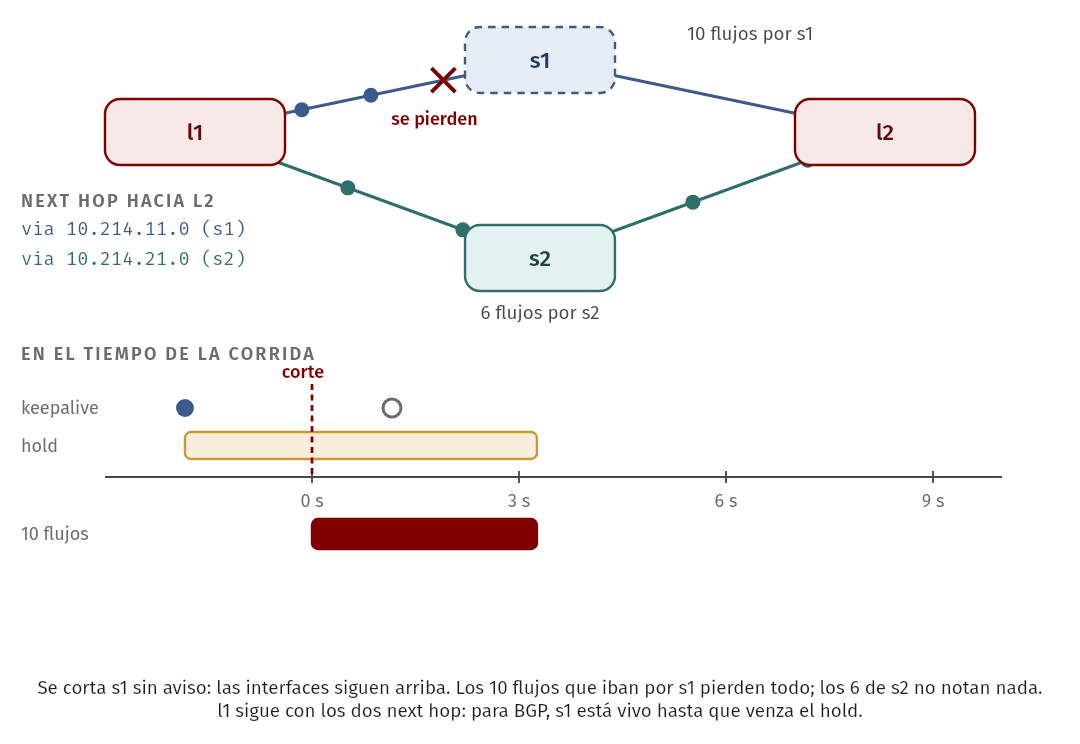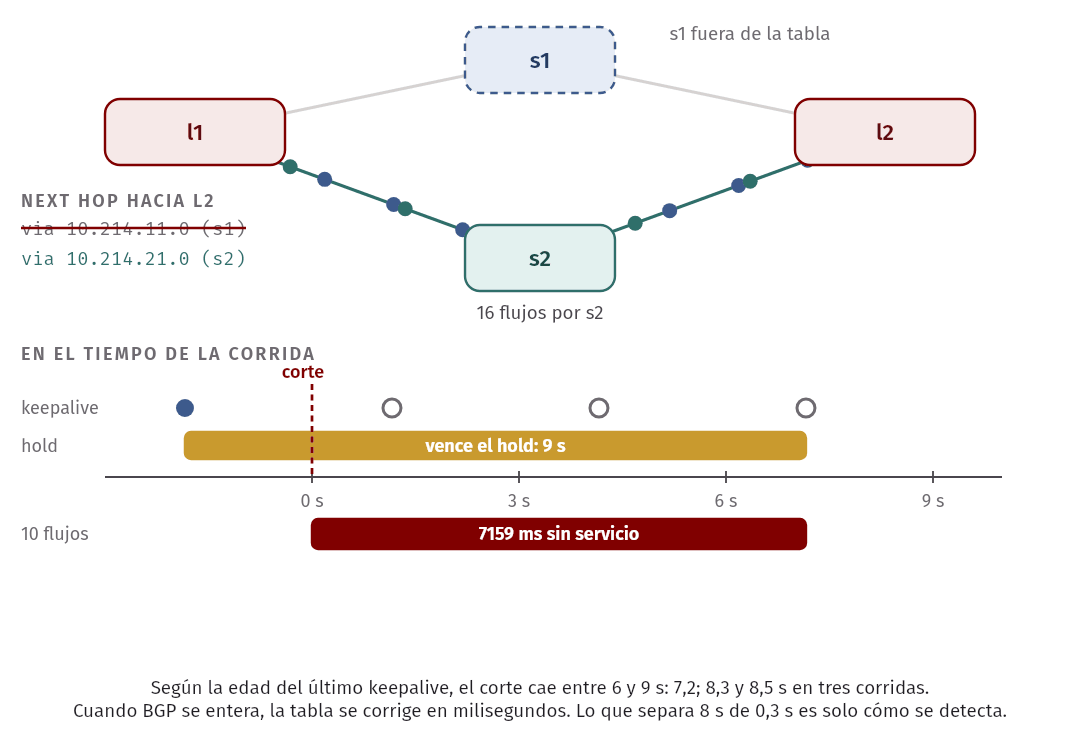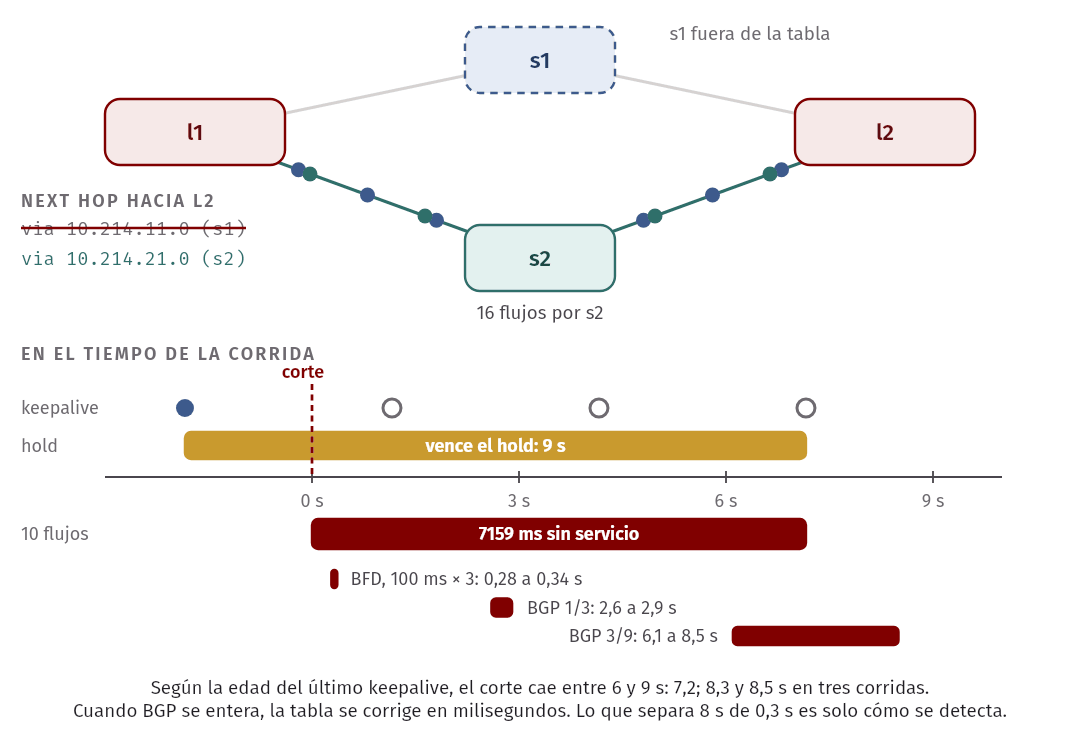
Falla silenciosa. Es la que de verdad importa. silent usa tc netem loss 100% en todas las interfaces de s1 y en las de los leaves hacia él. Las interfaces siguen arriba, y BGP solo puede enterarse cuando se agota el hold timer. Con keepalive de 3 s y hold de 9 s:
  flujos: 16; con corte: 10; sin corte: 6
  hueco en los flujos con corte: 7159 a 7159 ms
  hueco máximo en los flujos sin corte: 32 ms
  flujos: 16; con corte: 6; sin corte: 10
  hueco en los flujos con corte: 8500 a 8500 ms
  hueco máximo en los flujos sin corte: 30 ms
  flujos: 16; con corte: 11; sin corte: 5
  hueco en los flujos con corte: 8259 a 8259 ms
  hueco máximo en los flujos sin corte: 32 ms
Dos cosas para leer aquí, y las dos importan.
Primero, la falla no le pega a todos. Los flujos que iban por s2 no se enteran: su hueco máximo es de unos 30 ms, lo mismo que sin falla. Los que iban por s1 pierden 8 segundos completos. En una red así, una falla silenciosa se ve como un servicio que “a veces” anda lento o se cuelga, para una parte de los clientes. Es de lo más difícil de depurar.
Y la mitad es solo porque medimos un sentido. Una conexión TCP usa los dos, y cada leaf reparte por su cuenta: la conexión se corta si la ida o la vuelta pasan por el spine caído. Si los dos hash son independientes, sale ileso solo 1/2 × 1/2 = 1/4 de los flujos, y se afectan 3 de cada 4.
Segundo, el tiempo sale del hold timer. El último keepalive tiene una edad de entre 0 y 3 s cuando ocurre el corte, así que la detección cae entre 6 y 9 s. Es la misma cuenta de la semana 5, entre Dead − Hello y Dead.
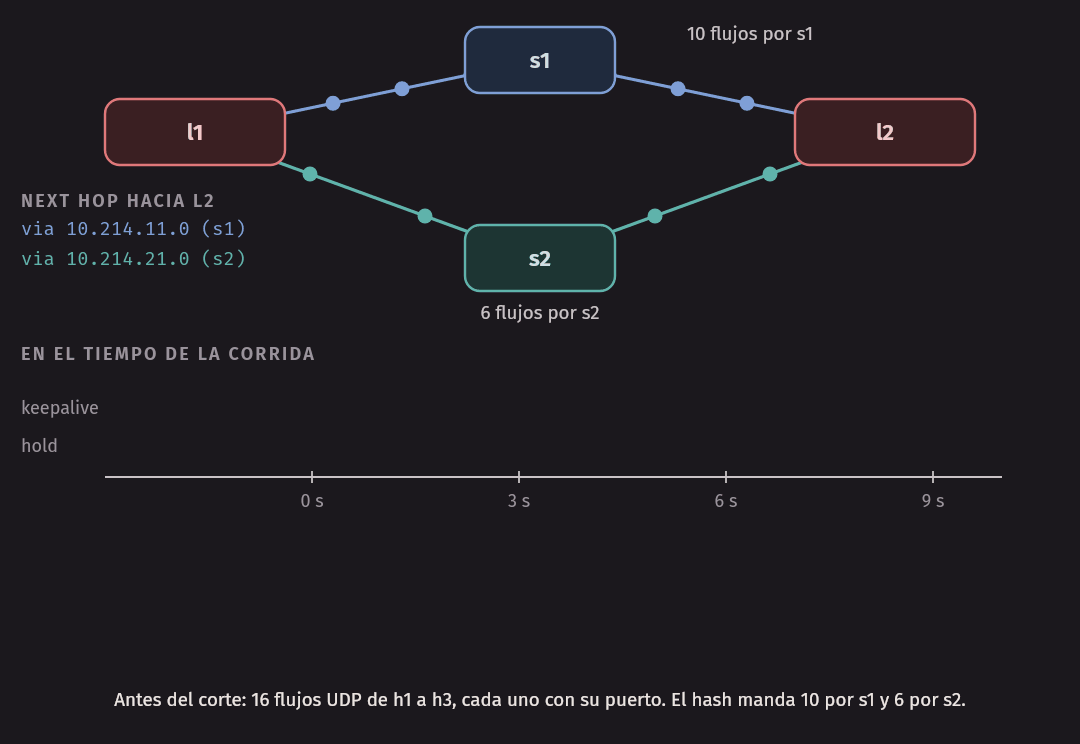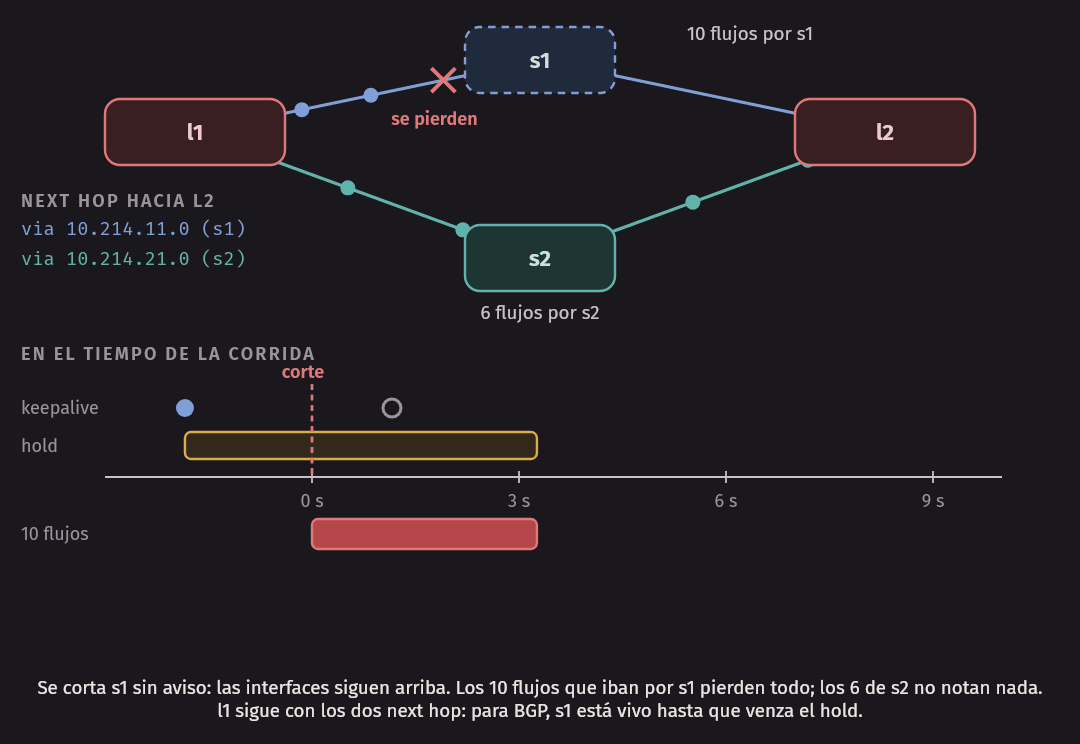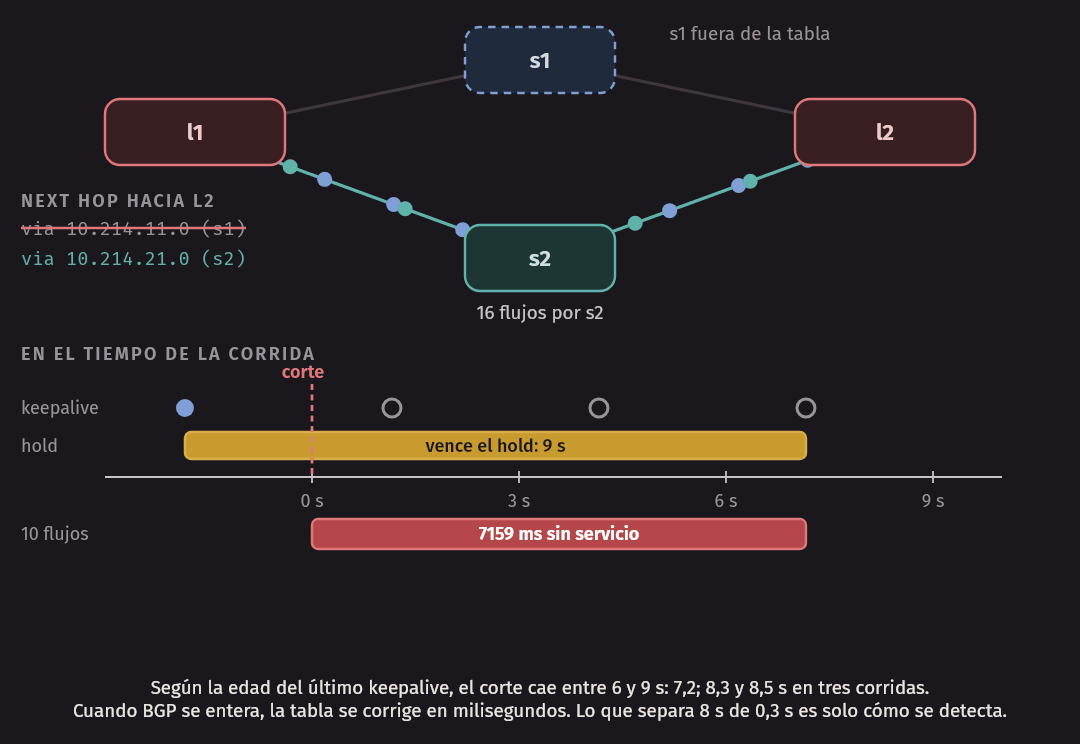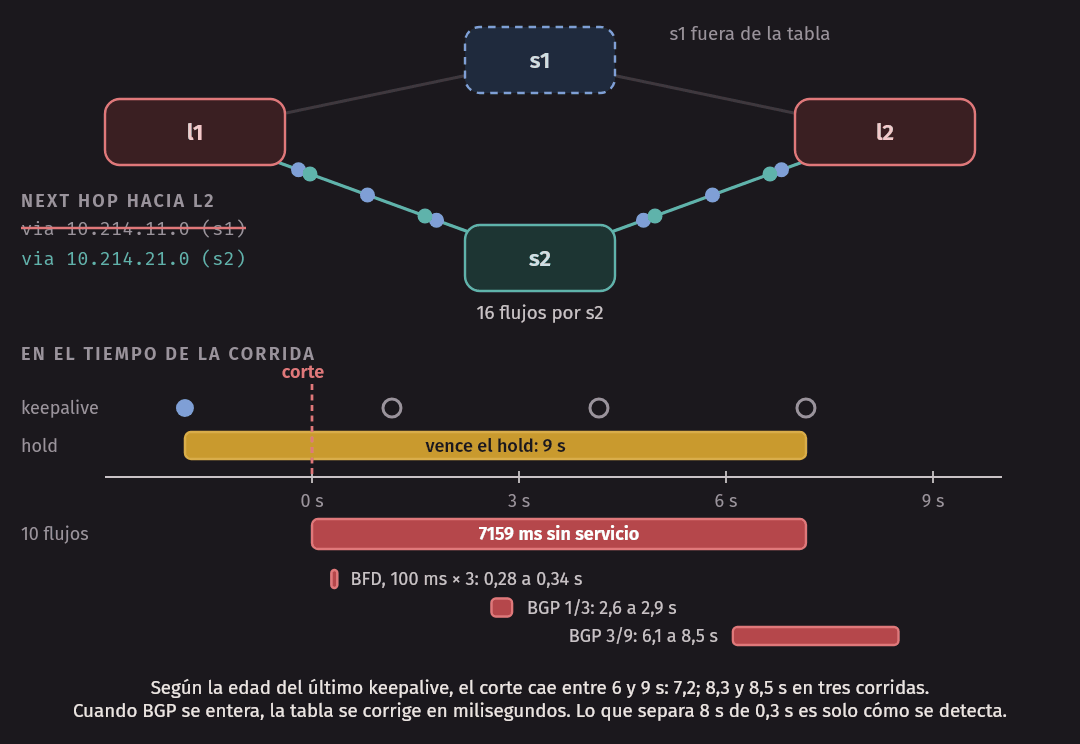
Con keepalive 1 y hold 3 (silent_short), y activando BFD (silent_bfd), obtuvimos lo siguiente. Junto a nuestras cifras van las de OSPF de la semana 5:
| Falla | Protocolo y temporizadores | Corte en los flujos afectados |
|---|---|---|
| Interfaz abajo | BGP, 3/9 | Ninguno visible: hueco máximo de 29 a 34 ms |
| Silenciosa | BGP, 60/180 (de fábrica) | 20 a 42 s; BGP se entera a unos 180 s (ver abajo) |
| Silenciosa | BGP, 3/9 | 6,1 s; 7,2 s; 8,3 s; 8,5 s |
| Silenciosa | BGP, 1/3 | 2,6 s; 2,7 s; 2,8 s; 2,9 s |
| Silenciosa | BFD, 100 ms × 3 | 0,28 s; 0,32 s; 0,34 s |
| Interfaz abajo | OSPF, 10/40 (semana 5) | 0 |
| Silenciosa | OSPF, 10/40 (semana 5) | 35 a 38 s |
| Silenciosa | OSPF, 2/8 (semana 5) | 7 a 8 s |
Las cifras dependen de la máquina y de la carga, pero el orden no.
Una sorpresa con los valores de fábrica
Con 60/180 esperábamos unos 120 a 180 s de corte. silent_default mide otra cosa:
  flujos: 16; con corte: 9; sin corte: 7
  hueco en los flujos con corte: 41760 a 41760 ms
  hueco máximo en los flujos sin corte: 61 ms
  a los   -3.9 s del corte: ARP de s1 DELAY; next hop hacia l2 en la tabla: 2
  a los   -2.7 s del corte: ARP de s1 REACHABLE; next hop hacia l2 en la tabla: 2
  a los   34.6 s del corte: ARP de s1 DELAY; next hop hacia l2 en la tabla: 2
  a los   39.5 s del corte: ARP de s1 PROBE; next hop hacia l2 en la tabla: 2
  a los   42.4 s del corte: ARP de s1 FAILED; next hop hacia l2 en la tabla: 2
  a los   53.5 s del corte: ARP de s1 INCOMPLETE; next hop hacia l2 en la tabla: 2
  a los  176.1 s del corte: ARP de s1 sin entrada; next hop hacia l2 en la tabla: 1
(Cortamos la salida: después, la entrada de ARP solo alterna entre INCOMPLETE y FAILED.)
BGP se enteró cuando debía, a los 176 s. El tráfico volvió mucho antes, con BGP todavía en Established y las dos rutas en la tabla. En otras corridas el corte duró 20,4 s, 22,3 s y 38,0 s. Lo que cambió justo en ese momento es la entrada de ARP de s1: el kernel dejó de recibir confirmaciones, la entrada pasó a DELAY, luego a PROBE, y al no recibir respuesta quedó en FAILED. Y net/ipv4/nexthop.c, al elegir dentro de un grupo de next hop como los que instala FRR, se salta los next hop cuyo vecino no es válido (nexthop_is_good_nh), y lo hace aunque fib_multipath_use_neigh esté en 0, como aquí.
Es decir, aquí hay un segundo detector, escondido, y muy lento y variable, porque el tiempo que una entrada se considera vigente es en parte al azar. Con 3/9 no se nota: BGP gana. Un router físico no tiene por qué comportarse así. Es otro motivo para medir en vez de suponer, y no apoyar el diseño en un efecto colateral.
BFD
BFD (Bidirectional Forwarding Detection) es un protocolo liviano, dedicado solo a responder “¿mi vecino sigue ahí?”. Lo prendemos con el daemon bfdd, que viene en la imagen y la topología activa en fabric/daemons. Con 100 ms y multiplicador 3:
$ docker exec clab-w14-fabric-l1 vtysh -c 'show bfd peer 10.214.11.0'
BFD Peer:
	peer 10.214.11.0 vrf default
		ID: 1222671694
		Remote ID: 2650022086
		Active mode
		Status: up
		Uptime: 3 second(s)
		Diagnostics: ok
		Remote diagnostics: ok
		Peer Type: configured
		RTT min/avg/max: 0/0/0 usec
		Local timers:
			Detect-multiplier: 3
			Receive interval: 100ms
			Transmission interval: 100ms
			Echo receive interval: 50ms
			Echo transmission interval: disabled
		Remote timers:
			Detect-multiplier: 3
			Receive interval: 100ms
			Transmission interval: 100ms
			Echo receive interval: 50ms
Detectar debería tardar 3 × 100 ms = 300 ms, y medimos de 280 a 339 ms: casi todo el corte es la detección. Y, en este caso, BGP le da el aviso de inmediato a la forwarding table.
Idea clave. Es la misma lección de la semana 5, y con otro protocolo: lo que tarda es enterarse. Cuando BGP se entera, la tabla se corrige en milisegundos. Lo que separa 8 s de 0,3 s es solo cómo se detecta.
En la práctica. Con un corte con aviso, el tráfico casi no lo nota, y por eso apagar una interfaz para “probar la convergencia” da números demasiado buenos. Con BFD hay un riesgo: si una computadora ocupada deja de enviar sus paquetes unos 300 ms, se cae una sesión sana. Los valores agresivos se usan cuando BFD corre en el hardware, o se suben si corre en la CPU.
Overlays: una red virtual sobre la red física
Hasta aquí, la red del data center conecta servidores. Pero quienes usan el data center piensan en otra cosa. Un cliente de una nube quiere una red propia: elegir sus direcciones, ponerles reglas, mover sus máquinas sin cambiarles la dirección. Y otro cliente, en el mismo rack, quiere lo mismo, con las mismas direcciones, porque 10.0.0.0/8 es de todos.
Eso no se puede hacer en una red física donde la dirección indica el lugar. La solución es la que vimos en la semana 4 con los túneles de IPv6: tratar a una red entera como si fuera un enlace.
Definición. Un overlay es una red virtual cuyos paquetes viajan encapsulados dentro de los de otra red, el underlay. El underlay los transporta sin mirar lo de adentro. Las máquinas del overlay no saben que hay un underlay.
 Underlay:  direcciones de los leaves o los hosts físicos. Routing normal, ECMP.
            No sabe nada de clientes. Solo sabe llegar a cada VTEP.

 Overlay:   direcciones de cada cliente. Cada cliente es una red aparte.
            No sabe nada de spines. Cree estar en una LAN.
Esto explica muchas cosas que ustedes usan sin mirar:
- Una VPC (“nube privada virtual”) es un overlay: las direcciones que elijan solo existen dentro de su red virtual, y es el hipervisor de cada servidor físico el que encapsula. Por eso pueden mover una máquina virtual a otro rack y que siga con su dirección.
- La red de Kubernetes también es casi siempre un overlay, o una red de esas características: cada pod tiene su dirección, que el underlay no conoce, y muchos plugins de red encapsulan el tráfico entre nodos con VXLAN.
La idea se repite: la dirección interna dice quién es, la externa dice dónde está.
VXLAN
VXLAN (RFC 7348) es uno de los formatos más usados. Empaqueta un frame Ethernet completo dentro de un datagrama UDP. El equipo que encapsula y desencapsula se llama VTEP (VXLAN tunnel endpoint). Puede ser el leaf, o el hipervisor de un servidor.
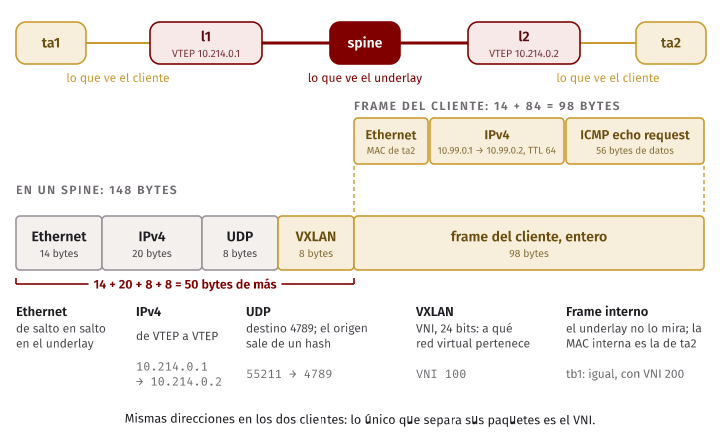
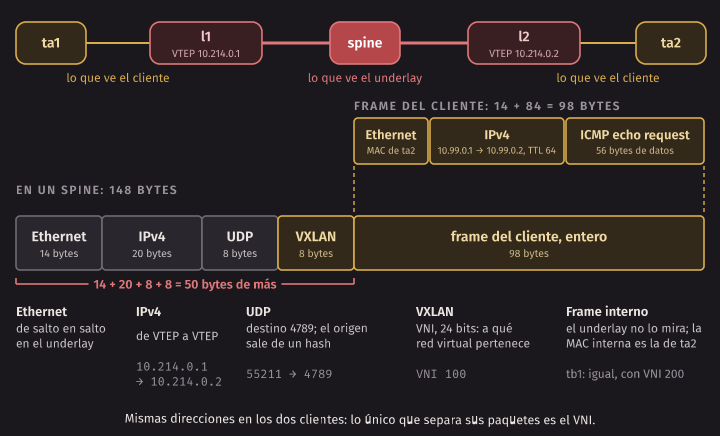
El campo clave es el VNI (VXLAN Network Identifier), de 24 bits: alcanza para unos 16 millones de redes virtuales. Lo comparan con los 12 bits de la VLAN de la semana 3, unas 4000 redes, y entienden por qué las VLAN no alcanzaron en una nube.
¿Por qué UDP, si no necesita entrega confiable, ni puertos, ni nada? Porque los routers del underlay ya saben hacer ECMP con UDP. Ya vamos a medir esa parte.
Dos clientes con la misma dirección
Con python3 scenarios.py overlay montamos un VTEP en l1 y otro en l2, con VNI 100 para el cliente a y VNI 200 para el b. En cada leaf son estos comandos, por cliente (aquí, el VNI 100 en l1):
ip link add vx100 type vxlan id 100 local 10.214.0.1 dstport 4789 srcport 49152 65535
ip link set vx100 mtu 1450
bridge fdb append 00:00:00:00:00:00 dev vx100 dst 10.214.0.2
ip link add br100 type bridge
ip link set vx100 master br100
ip link set eth5 master br100
ip link set vx100 up
ip link set br100 up
Es decir, en cada leaf, un bridge por cliente: un switch virtual que une el puerto del cliente con el VTEP. La línea de bridge fdb dice: a los frames que no sepas a dónde mandar, sácales una copia hacia este otro VTEP. Con eso, el broadcast de ARP llega al otro lado.
Las direcciones de ta1 y tb1 son iguales, y también las de ta2 y tb2. Las dos parejas se hablan:
$ docker exec clab-w14-fabric-ta1 ping -c 2 10.99.0.2
PING 10.99.0.2 (10.99.0.2): 56 data bytes
64 bytes from 10.99.0.2: seq=0 ttl=64 time=0.465 ms
64 bytes from 10.99.0.2: seq=1 ttl=64 time=0.132 ms

--- 10.99.0.2 ping statistics ---
2 packets transmitted, 2 packets received, 0% packet loss
round-trip min/avg/max = 0.132/0.298/0.465 ms

$ docker exec clab-w14-fabric-tb1 ping -c 2 10.99.0.2
PING 10.99.0.2 (10.99.0.2): 56 data bytes
64 bytes from 10.99.0.2: seq=0 ttl=64 time=0.534 ms
64 bytes from 10.99.0.2: seq=1 ttl=64 time=0.090 ms

--- 10.99.0.2 ping statistics ---
2 packets transmitted, 2 packets received, 0% packet loss
round-trip min/avg/max = 0.090/0.312/0.534 ms
¿Se habló cada uno con el suyo? La dirección 10.99.0.2 es la misma para los dos, pero la MAC que cada uno aprendió lo responde:
$ docker exec clab-w14-fabric-ta1 ip neigh
10.99.0.2 dev eth1 lladdr aa:c1:ab:1c:27:7a REACHABLE
$ docker exec clab-w14-fabric-ta2 cat /sys/class/net/eth1/address
aa:c1:ab:1c:27:7a

$ docker exec clab-w14-fabric-tb1 ip neigh
10.99.0.2 dev eth1 lladdr aa:c1:ab:24:d6:6b REACHABLE
$ docker exec clab-w14-fabric-tb2 cat /sys/class/net/eth1/address
aa:c1:ab:24:d6:6b
Cada cliente llegó a su máquina. Y el underlay no tiene ni idea de estas direcciones:
$ docker exec clab-w14-fabric-l1 ip route show 10.99.0.0/24
Esa línea vacía es la respuesta. l1 ni siquiera tiene ruta para 10.99.0.0/24, aunque es uno de sus VTEP. Para l1 esto es capa 2: un bridge.
El bridge del VTEP sí aprendió, igual que un switch de la semana 3, con una diferencia: a cada MAC remota le asocia también la dirección IP del VTEP donde está.
$ docker exec clab-w14-fabric-l1 bridge fdb show dev vx100
aa:c1:ab:1c:27:7a master br100
86:64:9b:de:c0:96 master br100
32:e8:89:6d:0a:18 vlan 1 master br100 permanent
32:e8:89:6d:0a:18 master br100 permanent
00:00:00:00:00:00 dst 10.214.0.2 self permanent
aa:c1:ab:1c:27:7a dst 10.214.0.2 self
86:64:9b:de:c0:96 dst 10.214.0.2 self
La línea aa:c1:ab:1c:27:7a dst 10.214.0.2 se lee así: la MAC de ta2 está detrás del VTEP 10.214.0.2. Esa asociación es el corazón de un overlay.
En la práctica. Aprender así, inundando y escuchando, es como funcionaba la VXLAN original. No escala bien en una nube: mucho broadcast copiado a muchos VTEP. Por eso se reemplaza por un plano de control: en lugar de aprender, un controlador le dice a cada VTEP dónde está cada MAC, o se distribuye con BGP (EVPN). Lo que sí se mantiene es el formato del paquete. Fíjense en la separación: el plano de datos es VXLAN, y el de control puede ser cualquiera.
El paquete, capa por capa
Capturamos en los spines (python3 scenarios.py tenants). Como no sabemos qué spine le toca, capturamos en los dos y leemos con tshark. Por cada paquete: dirección IP de origen y destino (externa e interna, separadas por coma), puertos UDP externos, VNI y tipo de ICMP:
10.214.0.1,10.99.0.1	10.214.0.2,10.99.0.2	55211	4789	100	8
10.214.0.2,10.99.0.2	10.214.0.1,10.99.0.1	55211	4789	100	0
10.214.0.1,10.99.0.1	10.214.0.2,10.99.0.2	55211	4789	100	8
10.214.0.2,10.99.0.2	10.214.0.1,10.99.0.1	55211	4789	100	0
Y el mismo ping desde tb1, en otro VNI:
10.214.0.1,10.99.0.1	10.214.0.2,10.99.0.2	200	8
10.214.0.2,10.99.0.2	10.214.0.1,10.99.0.1	200	0
Mismas direcciones externas e internas: lo único que los separa es el VNI. Un frame completo, con tshark -V y recortado:
Frame 1: 148 bytes on wire (1184 bits), 148 bytes captured (1184 bits)
    [Protocols in frame: eth:ethertype:ip:udp:vxlan:eth:ethertype:ip:icmp:data]
Ethernet II, Src: aa:c1:ab:4f:e4:e4 (aa:c1:ab:4f:e4:e4), Dst: aa:c1:ab:a1:b2:b0 (aa:c1:ab:a1:b2:b0)
Internet Protocol Version 4, Src: 10.214.0.1, Dst: 10.214.0.2
    Total Length: 134
    000. .... = Flags: 0x0
        .0.. .... = Don't fragment: Not set
    Time to Live: 64
    Protocol: UDP (17)
User Datagram Protocol, Src Port: 55211, Dst Port: 4789
    Length: 114
Virtual eXtensible Local Area Network
    Flags: 0x0800, VXLAN Network ID (VNI)
    VXLAN Network Identifier (VNI): 100
Ethernet II, Src: aa:c1:ab:e5:49:0f (aa:c1:ab:e5:49:0f), Dst: aa:c1:ab:1c:27:7a (aa:c1:ab:1c:27:7a)
Internet Protocol Version 4, Src: 10.99.0.1, Dst: 10.99.0.2
    Total Length: 84
    Time to Live: 64
    Protocol: ICMP (1)
Internet Control Message Protocol
    Type: 8 (Echo (ping) request)
    Data (56 bytes)
Comprueben los números. El frame interno mide 14 + 84 = 98 bytes, y el externo 148: justo los 50 bytes del dibujo. Y hay dos Ethernet y dos IP. La MAC interna de destino es la de ta2, que ningún spine conoce. El TTL interno es 64, aunque el paquete ya cruzó dos saltos del underlay: para el cliente, ta2 está en su misma LAN. Por eso el ping de arriba dice ttl=64, mientras que entre h1 y h3, con tres routers en medio, diría ttl=61.
MTU: lo que cuestan 50 bytes
Si el underlay tiene MTU de 1500, un frame encapsulado solo cabe si el paquete interno mide hasta 1450. A VXLAN le ponemos entonces MTU 1450, que es lo que el kernel calcula solo cuando se le dice dev eth1. Pero el cliente no sabe nada de esto. Su interfaz sigue en 1500:
$ docker exec clab-w14-fabric-ta1 ip link show eth1
30436: eth1@if30435: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UP mode DEFAULT group default
$ docker exec clab-w14-fabric-l1 ip link show vx100
13: vx100: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1450 qdisc noqueue master br100 state UNKNOWN mode DEFAULT group default qlen 1000
El ping de los nodos no permite elegir el bit DF, y por eso escribimos df_ping. Con python3 scenarios.py mtu:
  df_ping 1422 (paquete de 1450 bytes): pasa
  df_ping 1423 (paquete de 1451 bytes): no pasa
  df_ping 1472 (paquete de 1500 bytes): no pasa
  TCP de ta1 a ta2: 0 Mbit/s
El borde está exactamente donde dice la cuenta: 1450 pasa y 1451 no. Lean la última línea, porque es de lo más desconcertante que puede pasarles en una red. El ping funciona. El handshake de TCP funciona. La conexión se abre. Y no pasa ni un byte.
¿Por qué? El handshake lleva paquetes pequeños. Cada lado anuncia MSS 1460, porque su interfaz dice 1500. El primer segmento lleno llega al bridge de l1, que tendría que sacarlo por vx100, y no cabe. Un bridge es capa 2: descarta y no avisa. No manda ICMP, porque no es un router. Es el agujero negro de la semana 4, en versión peor: PMTUD no tiene de quién aprender.
Hay dos salidas. La primera, tenant_mtu, es decirle a cada máquina del cliente que su MTU es 1450:
  df_ping 1422 (paquete de 1450 bytes): pasa
  df_ping 1423 (paquete de 1451 bytes): no pasa
  df_ping 1472 (paquete de 1500 bytes): no pasa
  TCP de ta1 a ta2: 4806 Mbit/s
Los paquetes de más de 1450 siguen sin pasar, pero ahora el host lo sabe y TCP anuncia un MSS menor. Es lo que hacen muchas nubes y plugins de red: entregarles a los clientes una MTU un poco más chica, por DHCP. La otra salida, jumbo, es la que prefieren los data centers: darle más MTU al underlay. Con 1550 en los enlaces y VXLAN en 1500:
  df_ping 1422 (paquete de 1450 bytes): pasa
  df_ping 1423 (paquete de 1451 bytes): pasa
  df_ping 1472 (paquete de 1500 bytes): pasa
  TCP de ta1 a ta2: 5232 Mbit/s
El cliente tiene sus 1500 de siempre y no se entera de nada. Es lo que recomienda la RFC 7348: “VTEPs MUST NOT fragment”, y que la MTU de toda la red física sea suficiente. Los enlaces de un data center suelen configurarse con 9000 o algo más.
¿Y si a la interfaz VXLAN le dejamos MTU 1500 sobre un underlay de 1500? En Linux pasa algo interesante, con warn:
  df_ping 1472, primera vez: 1500 bytes: el host no lo envía (EMSGSIZE)
  ta1 ahora cree: 10.99.0.2 dev eth1 src 10.99.0.1 uid 0 cache expires 599sec mtu 1450
  df_ping 1472, otra vez: 1500 bytes: el host no lo envía (EMSGSIZE)
  TCP de ta1 a ta2: 5029 Mbit/s
El VTEP de Linux nota que el paquete no cabe en el underlay, y le manda a ta1 el ICMP que un bridge normal no manda. ta1 aprende una MTU de 1450 hacia ese destino, y TCP funciona. Es una cortesía de esta implementación. No cuenten con eso en un switch físico.
Error común. “El ping anda, así que la red está bien.” Un
pingde 56 bytes no prueba nada sobre la MTU. Si una conexión se abre y se cuelga al mandar datos grandes, sospechen de la MTU. En cualquier overlay o túnel, la pregunta obligada es: ¿dónde están los 50 bytes (o los que sean)?
Entropía: para qué sirve el puerto de origen
Ahora se encuentran las dos partes de la sesión. En el underlay, un leaf reparte con un hash de los encabezados. Pero si encapsulamos, los encabezados externos de todo lo que va de un VTEP a otro son los mismos: dos direcciones, UDP, 4789. ¿Se pierde ECMP?
Por eso VXLAN usa UDP, y por eso la RFC 7348 recomienda que el puerto de origen externo salga de un hash del frame interno. Flujos internos distintos llevan puertos externos distintos, y el underlay los puede repartir sin mirar adentro. Con 8 flujos TCP dentro del cliente a, en la captura de inner_ports:
puertos de origen externos distintos: 18Dieciocho, y no ocho, porque los 8 flujos de datos, el de control de iperf3 y sus respuestas se cuentan por separado en cada sentido.
Para medir el efecto en el reparto armamos el túnel entre dos hosts, h1 y h3, como lo haría un hipervisor, para que l1 sea un router que solo reenvía lo ya encapsulado. Con la política 3 en l1 y 16 flujos dentro del túnel, primero con el puerto externo normal y luego fijo en un solo valor. python3 scenarios.py entropy:
  puerto de origen externo según el flujo interno (49152 a 65535):
  s1 hacia l2:    4170.9 MB   26.8 %
  s2 hacia l2:   11388.5 MB   73.2 %
  puerto de origen externo fijo (50000):
  s1 hacia l2:   10708.8 MB  100.0 %
  s2 hacia l2:       0.0 MB    0.0 %
Sin esa variación, toda la red virtual se comporta como un solo flujo enorme. Con ella, ECMP reparte lo que hay adentro, aun sin poder leerlo. Se le llama entropía porque eso es lo que le da al hash: bits que cambian. El reparto de arriba, 27/73, es otra vez lo del azar con pocos flujos.
Idea clave. El overlay no rompe ECMP porque el puerto de origen externo le copia al underlay la identidad del flujo interno. Es el mismo problema de la 5-tupla, resuelto un nivel más abajo.
SDN: sacar la decisión del router
Volvamos a una idea de la semana 5. Un router hace dos trabajos: el plano de datos mueve cada paquete mirando la forwarding table, y el plano de control decide qué poner en esa tabla. En todo lo que vimos hasta ahora, ambos viven juntos en cada equipo, y el control está repartido: cada router habla con sus vecinos y calcula por su cuenta.
Definición. SDN (software-defined networking) es una forma de organizar la red en la que el plano de control está separado de los equipos y centralizado lógicamente en un controlador. Este tiene una vista global y programa las tablas de los equipos, a través de una interfaz definida. Los equipos solo aplican lo que les instalan.
“Centralizado lógicamente” no significa una sola computadora: suele ser un grupo de servidores replicados.
    Distribuido (OSPF, BGP)                       SDN

  [control]--[control]--[control]           [      controlador      ]
  [ datos ]  [ datos ]  [ datos ]              |       |        |
                                            [datos] [datos]  [datos]
Match-action
Si el control va a programar los equipos, ¿qué se programa? Hasta ahora, el forwarding era: mirar la dirección de destino, hallar el prefijo más largo y enviar. SDN lo generaliza.
Definición. En el forwarding generalizado cada regla tiene un match sobre cualquier campo de los encabezados, una acción y una prioridad. La primera regla (la de mayor prioridad) que coincide decide.
| Match | Acción | Equivale a |
|---|---|---|
IP de destino en 10.0.0.0/8 |
Enviar por el puerto 2 | Router |
MAC de destino aa:bb:... |
Enviar por el puerto 3 | Switch |
| TCP con puerto de destino 22 | Descartar | Firewall |
IP de origen 10.1.0.0/16 |
Reescribir la dirección y enviar | NAT |
La misma abstracción sirve para todos esos equipos: OpenFlow, del 2008, fue la interfaz que popularizó la idea.
Esta es la versión mínima. sdn_ctl.py es un controlador de juguete: lee una política y la instala en l1 como reglas de nftables, y de allí sale. No es OpenFlow, solo muestra la separación. La política es policy.txt:
# prioridad | match | acción. Gana la prioridad más alta. Lo que no coincide sigue a BGP.
100 | ip saddr 10.214.1.20 tcp dport 5201 | drop
 90 | tcp dport 5201 | via s1
 80 | tcp dport 5202 | via s2
Fíjense en lo que dice: “el tráfico al puerto 5201 va por s1 y el del 5202 por s2”. Eso no se puede expresar con una tabla que solo mira el destino. Después de python3 sdn_ctl.py install policy.txt, y de correr algo de tráfico:
5201 6153.14823459805 {'s1': 1609839048, 's2': 151}
5202 6071.025746016996 {'s1': 85, 's2': 1588739288}
$ docker exec clab-w14-fabric-h2 iperf3 -c 10.214.2.10 -p 5201 -t 1 --connect-timeout 1500
iperf3: error - unable to connect to server - server may have stopped running or use a different port, firewall issue, etc.: Operation timed out
La primera columna es el puerto, la segunda los Mbit/s, y después están los bytes que mandó cada spine. Todo fue por donde se pidió, sin usar BGP para esa decisión, y h2 quedó bloqueado solo hacia ese puerto. Las reglas tienen sus contadores:
table ip w14steer {
	chain pre {
		type filter hook prerouting priority mangle; policy accept;
		ip saddr 10.214.1.20 tcp dport 5201 counter packets 2 bytes 120 drop
		tcp dport 5201 counter packets 1068718 bytes 1594876911 meta mark set 0x00000001 accept
		tcp dport 5202 counter packets 1575156 bytes 2350774917 meta mark set 0x00000002 accept
	}
}
Esa es la tabla match-action, en un formato real. Y el contador importa: un controlador también lee estadísticas para decidir.
Qué se gana y qué se arriesga
Se gana la vista global. Un algoritmo distribuido solo ve lo que le cuentan sus vecinos. Un controlador conoce toda la red y el tráfico, y puede repartirlo de una forma que ningún router podría decidir solo: por ejemplo, separar a dos elefantes que chocan. Se gana también velocidad de cambio: si el control es software, se actualiza como software, sin esperar a que un estándar cambie o que el fabricante saque una versión.
Se arriesga lo contrario de lo que BGP resuelve. Un controlador es un punto delicado, y las reglas que instala le ganan a lo que sabe el router. Lo vemos con nuestra propia política: con la regla “5201 va por s1” instalada, cortamos s1 en silencio. BGP hace bien su trabajo:
$ docker exec clab-w14-fabric-l1 ip route show 10.214.2.0/24
10.214.2.0/24 nhid 18 via 10.214.21.0 dev eth2 proto bgp metric 20

$ docker exec clab-w14-fabric-h1 iperf3 -c 10.214.2.10 -p 5201 -t 1 --connect-timeout 1500
iperf3: error - unable to connect to server - server may have stopped running or use a different port, firewall issue, etc.: Operation timed out
La ruta ya no usa s1, y aun así el puerto 5201 no conecta, porque la regla sigue mandándolo allí. El tráfico al 5202 anda, a unos 5800 Mbit/s en la misma corrida. Nuestro controlador corrió una vez y ya no está. La ventaja es que su ausencia no detuvo a la red, porque el plano de datos sigue con lo que tiene. El problema es que nadie repara lo que dejó instalado. Un controlador real tiene que enterarse de la falla y reprogramar los equipos, y sus tiempos se agregan a los de detección.
Hay más: ¿y si el controlador se separa de los equipos por la misma falla que debe arreglar? La semana 7 vimos lo que pasó en Facebook cuando las herramientas de reparación dependían de la misma red.
Error común. Creer que SDN significa que no hay routing distribuido. SDN es una forma de organizar el plano de control, no un reemplazo obligatorio de los protocolos. Muchos data centers usan BGP y controladores a la vez: la RFC 7938 cuenta como ventaja de BGP justamente que un controlador se puede sumar con una sesión normal, para inyectar rutas. Y es común tener un controlador para el overlay (el mapa de cada red virtual) y BGP o algo propio para el underlay.
Caso: Google y Orion
Google es el ejemplo más conocido de SDN a gran escala. Orion, descrito en un artículo de NSDI 2021, es su control plane de segunda generación y controla sus redes de data center (Jupiter), de campus y su red privada de larga distancia (B4). Tres cosas del artículo para retener:
- No es un programa, son muchos. Es una constelación de microservicios (routing, configuración, gestión) que coordinan su estado a través de una base de datos central, el NIB (Network Information Base), con publicación y suscripción. Centralizado lógicamente, distribuido de verdad.
- Convive con el mundo. Los autores subrayan que ninguna red SDN opera aislada, y que tiene que interoperar con redes y protocolos tradicionales.
- El argumento más fuerte es de software. Pasar de protocolos a algoritmos, junto con esa arquitectura, permitió publicar versiones cada dos semanas. En los años de producción que reportan, mejoró 16 veces en escala, 50 veces la disponibilidad en Jupiter y 100 veces en B4, y hasta 40 veces en tiempo de convergencia. Son cifras de Google, sobre sus propias redes.
Para terminar con la Sesión A, la misma tabla de las semanas previas, ahora para las dos formas de organizar el plano de control:
| Distribuido | SDN | |
|---|---|---|
| Quién decide | Cada router, con lo que le cuentan | Un controlador, con vista global |
| Si cae la decisión | Cada router sigue por su cuenta | Los equipos siguen con lo instalado, sin reparar |
| Qué puede expresar | Lo que el protocolo permita | Lo que se pueda programar |
| Cambiar el comportamiento | Estándares, versiones del fabricante | Actualizar software propio |
| Dónde encaja | Entre empresas (BGP en Internet) | Bajo un solo dueño: data center y su WAN |
Redes para entrenar modelos de IA
Empieza la Sesión B. Si falta tiempo en clase, esta sección es la que se recorta; el resto de la sesión no depende de ella, aunque ayuda mucho a entender el diseño de las redes nuevas.
Un modelo grande se entrena en miles de GPU a la vez. No nos importa aquí qué calculan. Importa solo su forma de trabajar, que se repite millones de veces:
- Cada GPU calcula sobre su parte de los datos.
- Todas intercambian resultados. Nadie sigue hasta que termina el intercambio.
- Vuelta al paso 1.
Por eso el tráfico no se parece a nada de lo que hemos visto. Lo dice CS168 con claridad: se sabe de antemano quién habla con quién y cuánto, todos empiezan a la vez, y la operación se bloquea: hay que esperar a que todos terminen.
Operaciones colectivas: all-reduce
Definición. Una operación colectiva es un patrón de intercambio definido entre un grupo de nodos, que todos ejecutan a la vez. La más famosa es all-reduce: cada nodo tiene un vector, y al final todos tienen la suma, elemento por elemento, de todos los vectores.
Hay muchas formas de hacerla. La más simple de programar es el anillo: cada nodo le pasa al siguiente lo que recibió del anterior, y va sumando. En ring_reduce.c está completa, con n = 4 y 1 MB por vector:
  paso 1:    cada nodo le manda su propio vector al siguiente, y suma el que recibe
  paso 2:    le pasa al siguiente lo que recibió, y suma lo nuevo
  paso 3:    igual. Después de n-1 pasos, todos sumaron los n vectores.
Cada nodo envía (n - 1) × S bytes por ronda. Con S = 1 MB y n = 4, son 3 MB. Esta versión es la más fácil de leer, no la más eficiente: las bibliotecas reales suelen componer all-reduce con reduce-scatter seguido de all-gather, y en un anillo cada nodo envía solo unos 2 × S, sin importar n. Para lo que queremos mostrar, que todos esperan al más lento, da lo mismo. El anillo que usamos es h1 → h3 → h2 → h4 → h1, para que todos los saltos crucen un spine.
Hay un detalle de sockets que los va a morder si escriben algo así: enviar y recibir tienen que hacerse a la vez. Si todos hacen send del vector completo y después recv, los buffers de TCP se llenan, nadie está leyendo y el anillo entero se traba. Por eso el programa usa poll:
/* Envía out[] y recibe in[], los dos de size bytes, sin que uno bloquee al otro. */
static int exchange(int to_next, int from_prev, const unsigned char *out, unsigned char *in, size_t size) {
    size_t sent = 0, received = 0;
    while (sent < size || received < size) {
        struct pollfd fds[2] = {{.fd = sent < size ? to_next : -1, .events = POLLOUT},
                                {.fd = received < size ? from_prev : -1, .events = POLLIN}};
        if (poll(fds, 2, -1) < 0) {
Medimos con collective: 10 rondas sin problemas, y 10 con solo una interfaz limitada, la de salida de h4, a 100 Mbit/s. Mediana del tiempo por ronda, en cada nodo. Tres corridas:
  h1: mediana sin atraso    11.5 ms; con h4 a 100 Mbit/s   252.5 ms
  h3: mediana sin atraso    11.6 ms; con h4 a 100 Mbit/s   252.6 ms
  h2: mediana sin atraso    11.8 ms; con h4 a 100 Mbit/s   245.8 ms
  h4: mediana sin atraso    10.8 ms; con h4 a 100 Mbit/s   251.1 ms
  h1: mediana sin atraso    16.1 ms; con h4 a 100 Mbit/s   250.9 ms
  h3: mediana sin atraso    15.4 ms; con h4 a 100 Mbit/s   251.0 ms
  h2: mediana sin atraso    14.8 ms; con h4 a 100 Mbit/s   250.6 ms
  h4: mediana sin atraso    14.9 ms; con h4 a 100 Mbit/s   250.4 ms
  h1: mediana sin atraso     9.1 ms; con h4 a 100 Mbit/s   253.0 ms
  h3: mediana sin atraso     9.3 ms; con h4 a 100 Mbit/s   252.6 ms
  h2: mediana sin atraso     9.2 ms; con h4 a 100 Mbit/s   243.9 ms
  h4: mediana sin atraso     9.5 ms; con h4 a 100 Mbit/s   247.6 ms
Todos los nodos van unas 20 veces más lento, incluido h3, que ni envía a h4 ni recibe de él. Y el número se puede predecir: h4 tiene que enviar 3 MB por ronda, a 100 Mbit/s, y eso son 3 × 8 / 100 = 0,24 s. Medimos 0,25 s. La velocidad del trabajo completo es la del enlace más lento.
La peor latencia, no el promedio
Pasemos la misma idea a la latencia. Imaginen que cada flujo tarda 1 ms, y que con probabilidad 1 % le toca una mala suerte (una cola, un choque de ECMP, una retransmisión) y tarda 100 ms. Como cada ronda espera al más lento:
$ python3 tail_rounds.py 4 0.01 1 100
4 trabajadores, 1.00% lentos: promedio por trabajador 2.0 ms; promedio por ronda 4.9 ms; rondas lentas 4.0% (exacto: 3.9%)
$ python3 tail_rounds.py 10 0.01 1 100
10 trabajadores, 1.00% lentos: promedio por trabajador 2.0 ms; promedio por ronda 10.4 ms; rondas lentas 9.5% (exacto: 9.6%)
$ python3 tail_rounds.py 100 0.01 1 100
100 trabajadores, 1.00% lentos: promedio por trabajador 2.0 ms; promedio por ronda 63.8 ms; rondas lentas 63.4% (exacto: 63.4%)
$ python3 tail_rounds.py 1000 0.01 1 100
1000 trabajadores, 1.00% lentos: promedio por trabajador 2.0 ms; promedio por ronda 100.0 ms; rondas lentas 100.0% (exacto: 100.0%)
La cuenta exacta es 1 - (1 - p)^N. El promedio por trabajador nunca cambia: 2 ms, una cifra excelente. Pero con mil trabajadores, cada ronda tarda 100 ms: la peor latencia de un flujo se volvió el tiempo normal de todo el trabajo. Mientras tanto, todas esas GPU, las piezas más caras del edificio, están esperando.
Por qué esta carga le queda mal a ECMP
Junten lo que ya vieron. Un trabajo de entrenamiento tiene pocos flujos, enormes, entre las mismas direcciones, y que empiezan a la vez. Es el peor caso para repartir con un hash de encabezados: poca entropía y solo elefantes. Con 8 elefantes y 8 caminos, la cuenta anterior nos dio 0,2 % de corridas sin choques y un tercio de capacidad perdida, y aquí un choque no atrasa a un flujo: atrasa a toda la ronda.
Por eso las redes para IA hacen cosas que en otros lugares se evitarían:
- Repartir por paquete, con NIC y transportes que toleran el desorden. Es exactamente lo que vimos que no se debe hacer con TCP, pero el problema no era repartir: era el receptor.
- Evitar la pérdida. Con RDMA, la tarjeta de red mete los datos directo en la memoria de la GPU, sin pasar por la CPU. Una pérdida es muy cara allí, y se busca una red casi sin descartes, y con control de congestión que reaccione antes de llenar las colas (como ECN, de la semana 11).
- Elegir el patrón según la topología, porque se conoce de antemano: poner el anillo de manera que los vecinos estén en el mismo rack. Así, la red y el algoritmo se diseñan juntos.
Idea clave. En un trabajo colectivo el tiempo lo fija el peor flujo. Una red para IA se juzga por su latencia en el peor caso, no por el throughput promedio.
Qué cambia sin cables
Pasamos al otro extremo. Un enlace inalámbrico es un enlace de la semana 3, con el mismo trabajo por hacer, pero el medio hace casi todo más difícil.
Atenuación. La señal se debilita con la distancia, incluso en el vacío, porque se reparte en un frente cada vez mayor: en espacio libre, la potencia cae con el cuadrado de la distancia. Adentro de un edificio cae más rápido, por paredes y muebles. Un cable también atenúa, pero mucho menos y de manera predecible.
Multitrayecto. La señal rebota en paredes y objetos, y al receptor le llegan varias copias con retardos distintos, que se suman o se cancelan. Mover la mano unos centímetros puede cambiar la calidad, sin haberse alejado nada.
Ruido e interferencia. Otras redes, un microondas o un equipo Bluetooth usan las mismas bandas. A diferencia de un cable, el aire lo comparten todos.
Todo eso se resume en una cifra: la SNR (relación señal a ruido). A mayor SNR, menos errores por bit. Y para una misma SNR, una modulación más veloz comete más errores. Por eso un equipo de radio cambia de velocidad según la señal: si la señal baja, baja su velocidad para seguir entendiéndose. Ese “cambio de velocidad” también explica por qué un solo celular lejano puede afectar a toda una red Wi-Fi: mientras transmite, lento, ocupa el aire que usarían los demás.
En conjunto, la tasa de error es mucho mayor que en un cable, y además cambia de un segundo a otro.
Dos cosas que CSMA/CD no puede resolver
Terminal oculto. A y C están a ambos lados del access point B. Los dos llegan a B, pero no se oyen entre ellos.
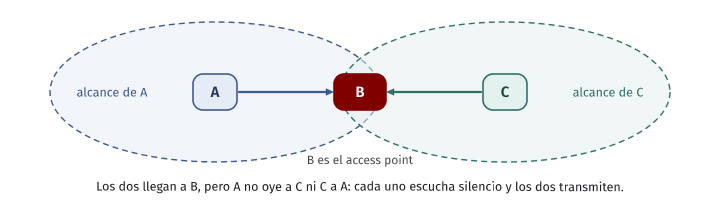
A escucha, no oye nada y transmite. C escucha, no oye nada (A está fuera de su alcance) y transmite. Chocan en B, y ninguno lo sabe. Escuchar antes de transmitir, que es lo que hacía CSMA en la semana 3, responde “¿hay silencio aquí?”. La pregunta correcta es “¿hay silencio en el receptor?”.
Terminal expuesto. Es lo contrario. B le transmite a A, y C le quiere transmitir a D, en el otro sentido. C oye a B y se calla, aunque los dos podrían transmitir a la vez sin molestar a ninguno de sus receptores. No hay pérdida, pero sí desperdicio.
Wi-Fi
Definición. Wi-Fi es el nombre comercial de la familia de estándares IEEE 802.11 de redes locales inalámbricas. Una estación y su access point (AP) forman un BSS (basic service set). El AP conecta el aire con el resto de la red, por lo general Ethernet.
Asociarse
Antes de enviar un solo dato, una estación tiene que elegir AP y asociarse:
- Escuchar. Cada AP envía cada poco tiempo un frame beacon con el nombre de la red (SSID) y su MAC (BSSID). La estación recorre los canales y escucha (exploración pasiva), o pregunta “¿quién está?” con un probe (exploración activa).
- Asociarse. Elige un AP, normalmente el de señal más fuerte, y le pide asociarse. Eso crea el estado en el AP: esa estación está aquí.
- Autenticarse. Si la red lo pide, se prueba quién es y se acuerdan claves. Lo cuenta la sección 8.8 de Kurose y Ross, lectura complementaria de la semana 15.
- Conseguir una dirección con DHCP, igual que en la semana 4. Para IP, esto ya es una LAN normal.
CSMA/CA
¿Por qué no detectar colisiones como Ethernet? Por dos razones, y las dos son físicas:
- Una radio no se oye más que a sí misma. Su propia señal, a pocos centímetros, es muchísimo más fuerte que la de otra estación que llega atenuada. Detectar otra señal mientras se transmite es muy costoso.
- Aunque pudiera, no le serviría: en el terminal oculto, la colisión ocurre en el receptor, y el emisor ni siquiera puede oírla.
Entonces, en vez de detectar, se evita, y se confirma. CSMA/CA hace esto:
 1. Escuchar. Si el canal está libre durante un tiempo (DIFS), transmitir.
 2. Si estaba ocupado, elegir un backoff al azar y contar ranuras
    solo mientras el canal esté libre. Se congela si alguien transmite.
 3. Al llegar a cero, enviar el frame ENTERO. No hay aborto a la mitad.
 4. El receptor, si el frame llegó bien, responde con un ACK tras una
    espera más corta (SIFS). Como es más corta, nadie se le adelanta.
 5. Si no llega el ACK, se supone una colisión: se duplica la ventana de
    backoff y se reintenta, hasta un límite. Con ACK, la ventana vuelve al mínimo.
Comparen con CSMA/CD. Ethernet, al detectar un choque, aborta enseguida, de modo que perdió poco. Wi-Fi no se entera hasta el final de que chocó, y por eso cada colisión le cuesta la transmisión completa. De ahí “evitar”: el backoff se elige antes de transmitir, incluso si el canal estaba ocupado, para que dos estaciones que esperaban a que termine un tercero no salten juntas al mismo tiempo.
El modelo de dcf_sim.c muestra qué pasa con la cantidad de estaciones. Es muy simple (el texto de arriba, sin velocidades ni tiempos exactos), así que sirve para comparar y no para predecir megabits:
$ bin/dcf_sim shared 1 10000000
  1 estaciones que se oyen: tiempo útil  95.2 %; intentos que chocan   0.0 %
$ bin/dcf_sim shared 2 10000000
  2 estaciones que se oyen: tiempo útil  91.6 %; intentos que chocan  10.7 %
$ bin/dcf_sim shared 5 10000000
  5 estaciones que se oyen: tiempo útil  83.7 %; intentos que chocan  26.5 %
$ bin/dcf_sim shared 10 10000000
 10 estaciones que se oyen: tiempo útil  77.8 %; intentos que chocan  36.4 %
$ bin/dcf_sim shared 20 10000000
 20 estaciones que se oyen: tiempo útil  71.5 %; intentos que chocan  45.8 %
$ bin/dcf_sim shared 50 10000000
 50 estaciones que se oyen: tiempo útil  62.9 %; intentos que chocan  57.2 %
Una sola estación tampoco llega al 100 %: gasta 7,5 ranuras de backoff en promedio por cada trama de 150. Con muchas, el tiempo útil baja, aunque de forma gradual: la ventana que se duplica va apagando la pelea.
RTS/CTS: reservar en el receptor
Para el terminal oculto, 802.11 tiene un recurso opcional: antes de un frame grande, pedir permiso.
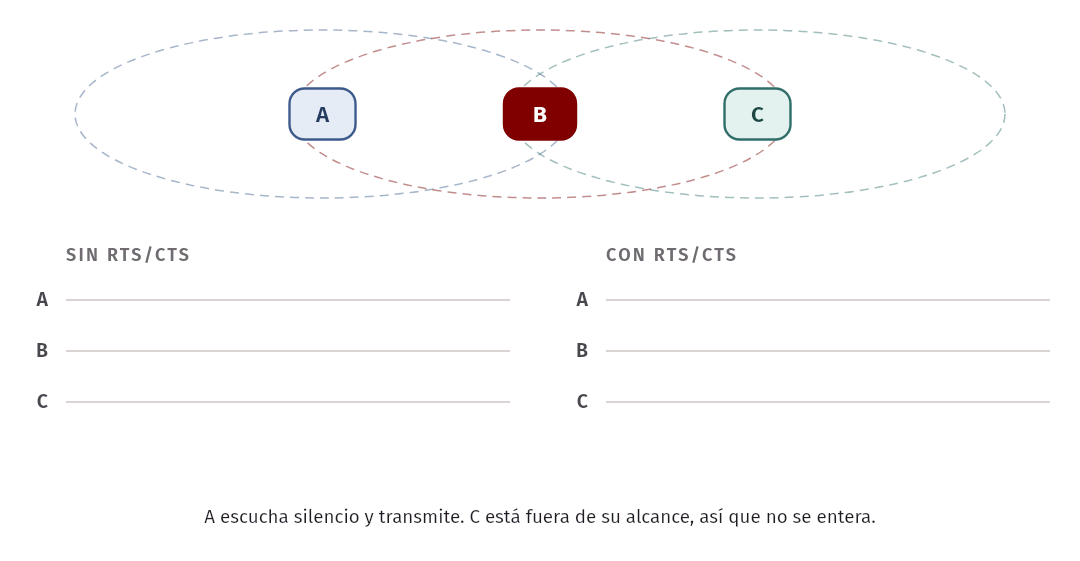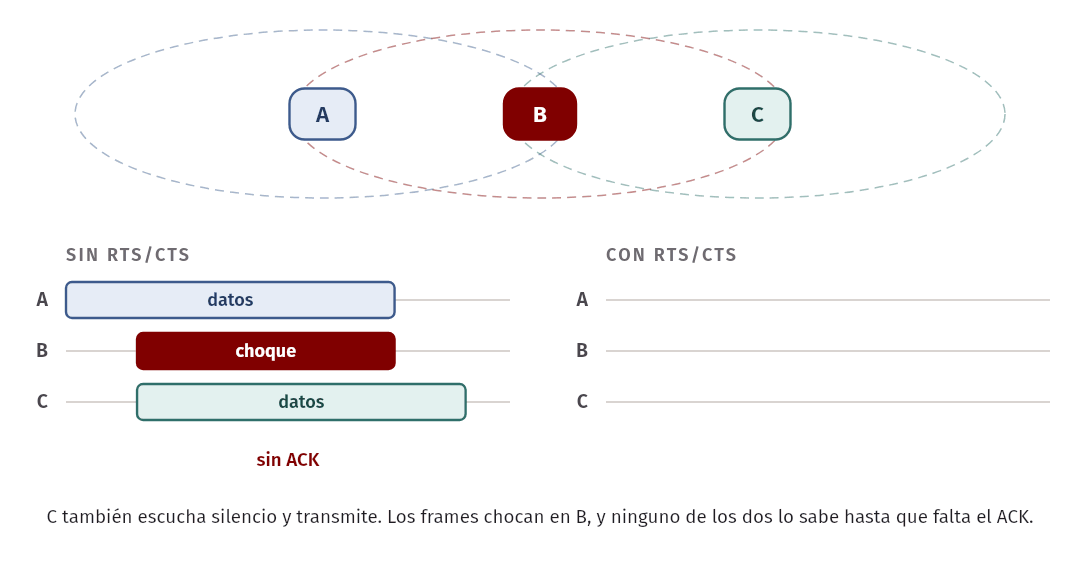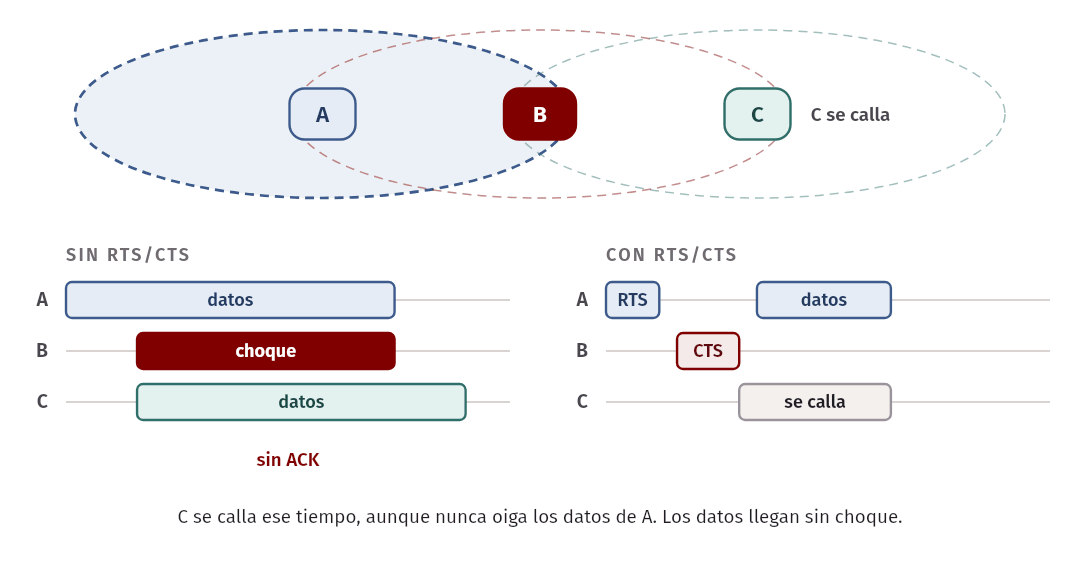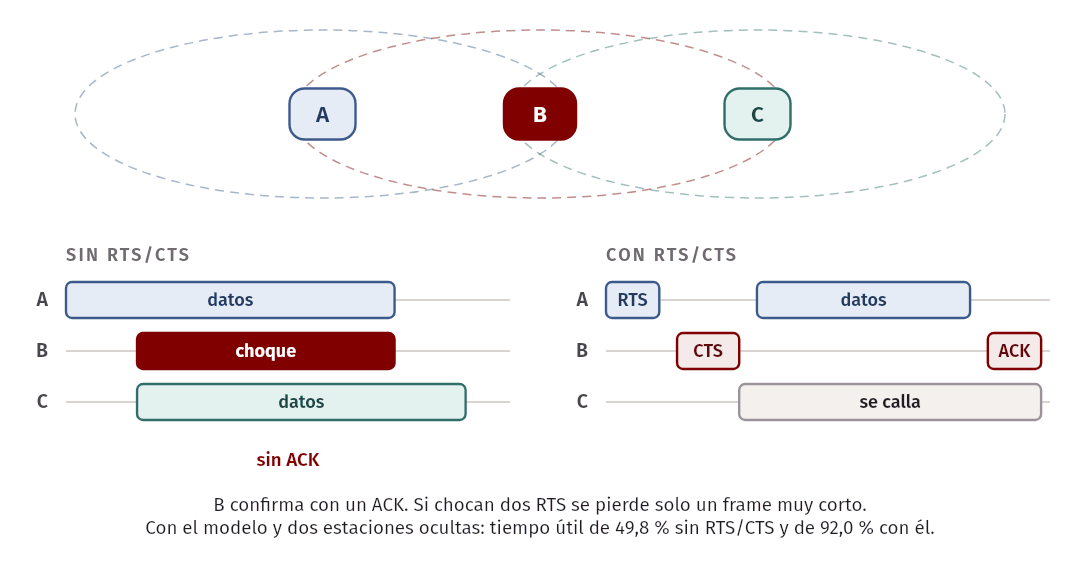
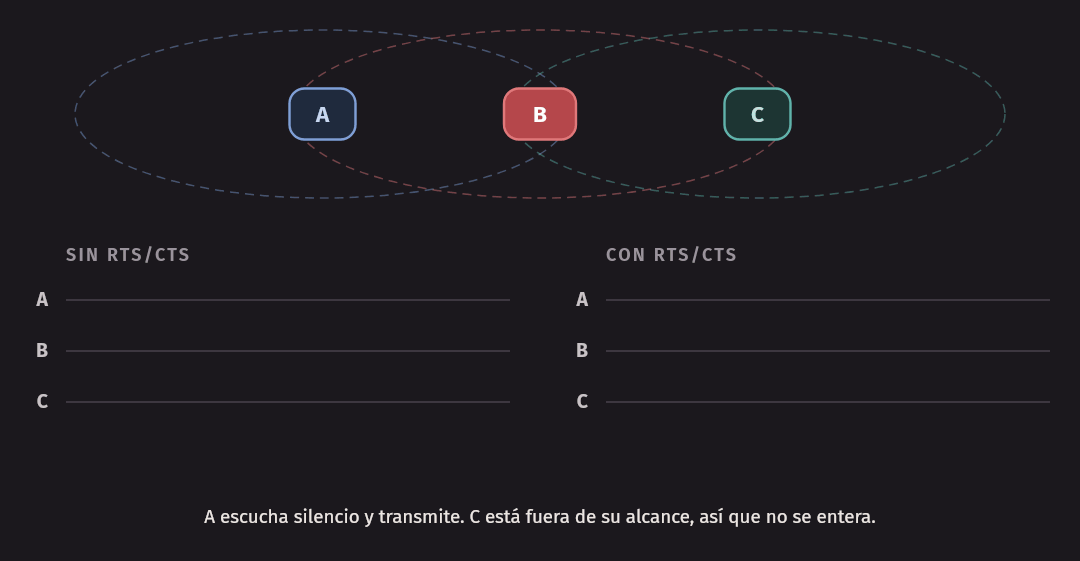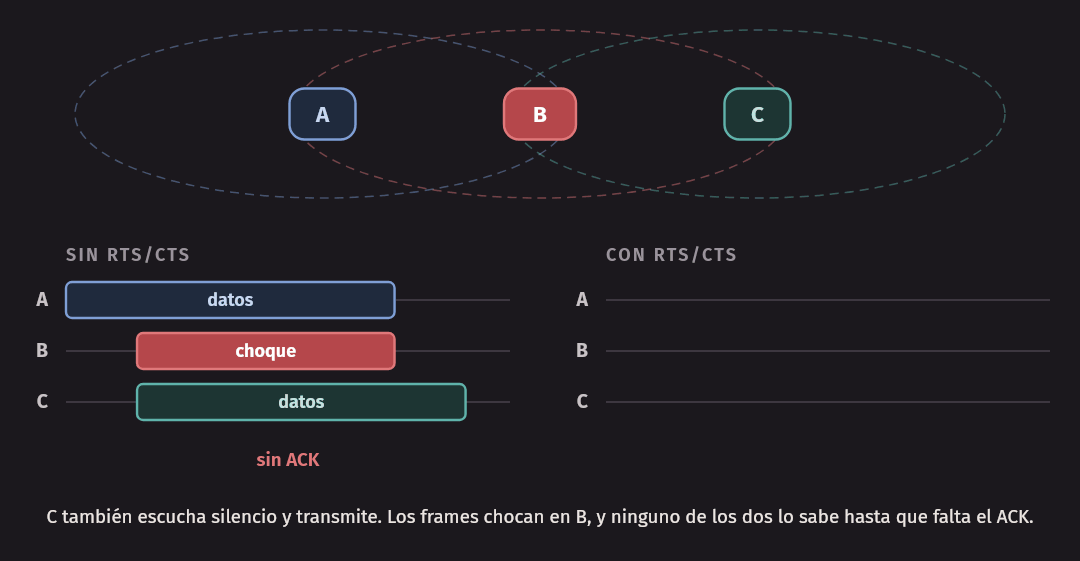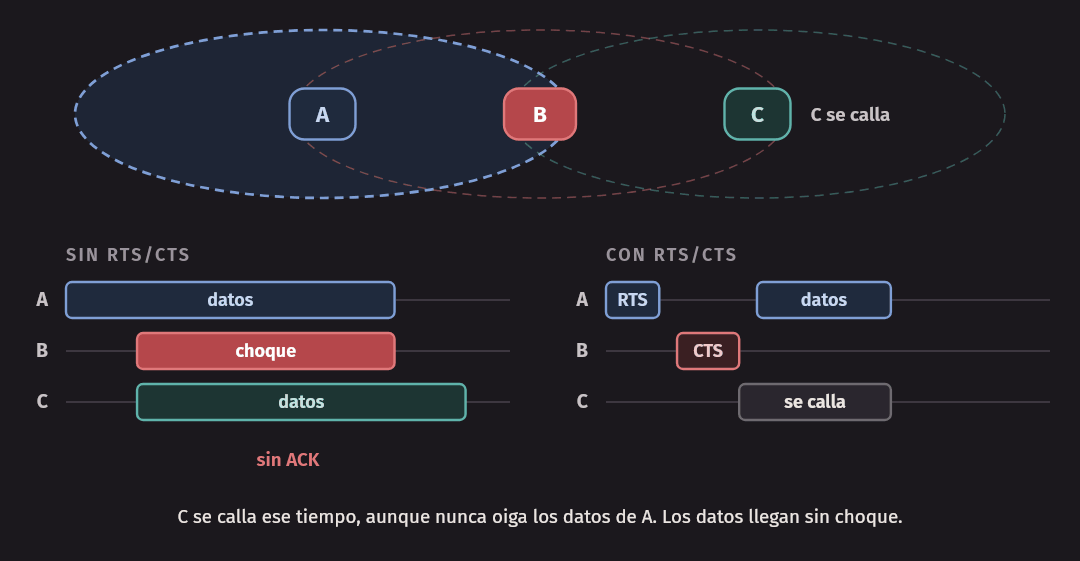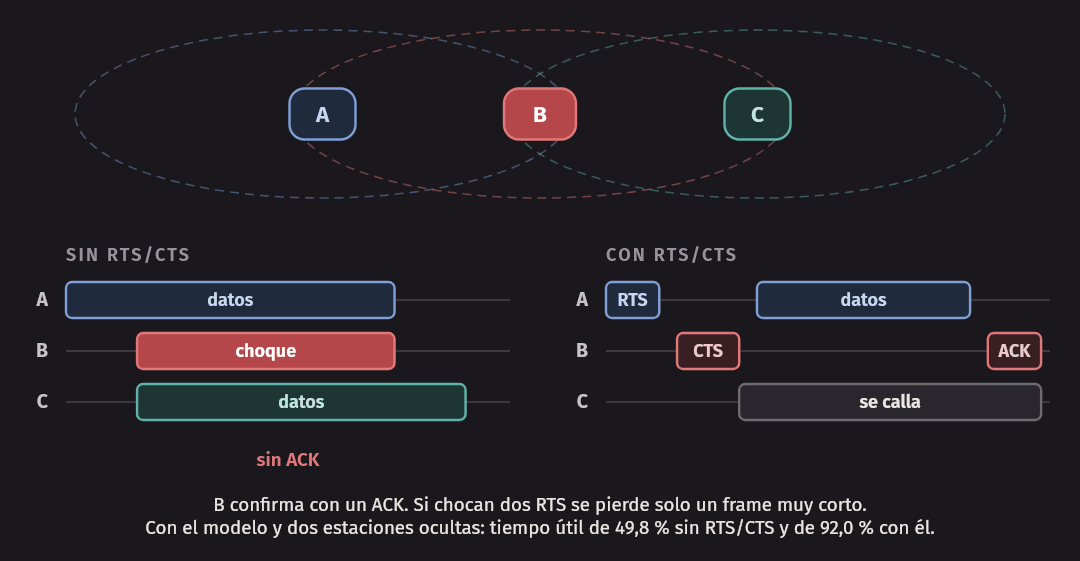
C no oye a A, pero sí a B. El CTS, que dice el tiempo reservado, hace que C se calle aunque nunca oiga los datos. Si dos RTS chocan, se pierde solo un frame muy corto, y no uno de datos. El costo es enviar dos frames de más antes de cada transmisión. Con el modelo y dos estaciones ocultas:
$ bin/dcf_sim hidden 10000000
2 estaciones ocultas, sin RTS/CTS: tiempo útil  49.8 %; intentos que chocan  55.0 %
$ bin/dcf_sim hidden_rts 10000000
2 estaciones ocultas, con RTS/CTS: tiempo útil  92.0 %; intentos que chocan  11.3 %
¿Por qué no se usa siempre? Porque si todos se oyen y los frames son pequeños, el costo no se justifica. Por eso se activa solo para frames sobre cierto tamaño.
¿Para qué un ACK en el enlace, si TCP ya los tiene?
Es la pregunta de repaso, y la respuesta tiene tres partes:
- La tasa de error. En un enlace de Ethernet, las pérdidas por errores son rarísimas: TCP puede encargarse de ellas. Por el aire, perder una de cada diez tramas es normal. Si el enlace pierde el 10 % y lo intenta hasta 3 veces en total, lo que se escapa es 0,1 × 0,1 × 0,1 = 0,1 %.
- El tiempo. Wi-Fi reintenta en microsegundos o milisegundos. TCP se entera al menos un RTT después, que puede ser de cientos de milisegundos.
- El malentendido. TCP cree que una pérdida es congestión. Si el enlace no la arregla, TCP baja su velocidad sin motivo, como medimos más abajo.
Es el argumento end-to-end de la semana 1, con todos sus matices: el extremo tiene que garantizar la entrega, y aun así a la capa baja le conviene ayudar.
En la práctica. Un frame 802.11 lleva tres direcciones que importan: la del receptor en el aire (el AP), la del transmisor en el aire (la estación) y la del destino de verdad (por ejemplo, la del router). El AP convierte ese frame en uno de Ethernet con dos direcciones, y el switch no sabe que hubo aire de por medio.
5G
Una red celular también lleva datos sin cables, pero con una decisión de diseño opuesta. Wi-Fi compite por el aire sin dueño. Una red celular es de un operador, que paga por sus frecuencias, y la torre decide quién transmite, cuándo y en qué frecuencia: se asignan bloques de tiempo y frecuencia a cada usuario. No hay colisiones de datos, porque hay reservas. Y es lo que le permite tener zonas de cobertura de kilómetros y cobrar por servicio.
Se compone de tres partes:
 teléfono (UE) ~~~aire~~~ gNB ---- túnel GTP-U ---- UPF ---- Internet
                          RAN                       |
                                                    | plano de usuario
             ---------------------------------------+----------------
                                    | plano de control
                    AMF (acceso y movilidad)   SMF (sesiones)
                    AUSF, UDM (autenticación, datos del suscriptor)
Núcleo 5G- UE (user equipment): el teléfono, con su SIM, que identifica al suscriptor.
- RAN (radio access network): las estaciones base, en 5G llamadas gNB. Manejan el aire y su scheduler reparte las frecuencias.
- Núcleo (core): conecta las torres con Internet y lleva la gestión. Se divide en plano de usuario (el UPF, que mueve paquetes) y plano de control: el AMF se encarga de que el teléfono entre y se mueva, el SMF crea las sesiones, y el AUSF y el UDM saben quién es cada suscriptor y qué contrató. CS168 los llama radio gateway, packet gateway, mobility manager y database, con razón: son roles fáciles de recordar, más allá de la sopa de siglas que cambia en cada generación.
La sesión de usuario
Un teléfono que se enciende hace esto:
- Encuentra una torre, escuchando las señales que emiten.
- Se registra y se autentica a través del AMF: prueba, con la clave de su SIM, que es quien dice ser. La red también se autentica ante él.
- Abre una sesión: la sesión PDU. El SMF elige un UPF y da una dirección IP al teléfono.
- Se arma el camino: el SMF programa un túnel GTP-U entre la gNB y el UPF, y una portadora de radio entre el teléfono y la torre.
Una vez armado, un paquete del teléfono entra a la gNB, que lo encapsula en UDP (GTP-U) y lo envía al UPF, que lo desencapsula y lo saca a Internet como un paquete normal. Dentro de ese túnel la dirección IP del teléfono no sirve para hacer routing en el núcleo: los routers solo ven las direcciones de los extremos del túnel.
¿Les suena? Es un overlay, con el mismo truco de la Sesión A: la dirección de adentro dice quién es, la de afuera dice dónde está.
Por qué la red se volvió software
Hasta 4G, las funciones del núcleo eran en buena medida cajas de fabricantes. En 5G están definidas como funciones de red que se ofrecen servicios entre sí con interfaces de estilo web, y pueden correr como software en servidores comunes, en un data center del operador. Tres consecuencias conocidas:
- Control y datos separados: es la idea de SDN, aplicada al celular. El SMF decide y programa, y los UPF mueven paquetes. Se pueden colocar UPF cerca del usuario, para bajar la latencia, sin mover el control.
- Network slicing: sobre la misma infraestructura, varias redes lógicas con garantías distintas, por ejemplo para celulares comunes y para sensores industriales.
- La RAN también: parte del procesamiento de radio se está moviendo de la torre a servidores generales, con interfaces abiertas entre partes.
Error común. Creer que 5G es solo “una radio más rápida”. Su radio es mejor, pero el cambio de arquitectura está en el núcleo: software, control separado y sesiones definidas para cada tipo de servicio.
Movilidad
¿Qué significa “moverse”, para una red? Depende de lo que tenga que cambiar. Si solo cambia el enlace, las capas de arriba no se enteran. Si cambia la dirección IP, se rompen las conexiones TCP, porque la 4-tupla de la semana 10 las identifica por esa dirección.
En Wi-Fi
Si una estación pasa de un AP a otro de la misma subred, conserva su IP. Se asocia con el AP nuevo, y queda por resolver que los switches de la LAN sigan enviándole frames al puerto antiguo, porque así lo aprendieron. La solución es muy simple: el AP nuevo envía un frame cuyo origen es la MAC de la estación, y los switches la aprenden de nuevo, tal como vimos en la semana 3.
Si el AP nuevo está en otra subred, DHCP le da otra dirección, y las conexiones se rompen. Por eso una red de campus suele ser una sola subred extensa para Wi-Fi, o usa túneles hasta un punto central. Y por eso QUIC, de la semana 13, le da tanta importancia a su migración de conexión: la identidad de la conexión ya no depende de la dirección.
En 5G
Durante un viaje en auto, el teléfono cambia de torre muchas veces, y su IP no cambia. Lo logra el túnel:
  Antes:     UE ~~ gNB vieja ==túnel== UPF ---- Internet
  Durante:   la gNB vieja reenvía a la nueva lo que aún le llega
  Después:   UE ~~ gNB nueva ==túnel== UPF ---- Internet     (mismo UPF, misma IP)
Los pasos del handover:
- El teléfono mide todo el tiempo la señal de torres cercanas e informa a la suya.
- La torre actual decide cambiarlo, y le pide a la nueva que prepare recursos.
- La torre vieja le dice al teléfono que cambie, con todos los datos que necesita para entrar a la nueva. Por eso un handover tarda mucho menos que encender el teléfono y buscar red (CS168 da 0,01 a 0,1 s frente a 10 a 100 s). Mientras tanto, lo que siga llegando a la torre vieja se le reenvía a la nueva.
- El SMF le pide al UPF que cambie el extremo del túnel. Para Internet, nada cambió: el UPF es el ancla de la dirección IP.
La comparación con Wi-Fi resume las filosofías:
| Wi-Fi | 5G | |
|---|---|---|
| Quién decide el cambio | La estación | La red, con las mediciones del teléfono |
| Acceso al medio | CSMA/CA, compitiendo | Reservas de tiempo y frecuencia |
| Espectro | Sin licencia, compartido | Con licencia, del operador |
| Se conserva la IP | En la misma subred | Sí: el UPF es el ancla |
| Alcance típico | Decenas de metros | Cientos de metros a kilómetros |
Dos direcciones y un agente: IP móvil
¿Y si se quisiera conservar la IP en cualquier red? Es la idea de un agente en la red de origen que recibe los paquetes y los envía por un túnel hasta donde esté el equipo. Las ideas son las mismas de 5G. La diferencia es que, en un celular, el operador es dueño de todo el camino y lo ha hecho funcionar en la práctica, mientras que a escala de Internet nunca se adoptó de manera amplia. Cuando un teléfono sale de su país (roaming), el operador visitado le da el servicio, y el de origen autoriza y cobra.
TCP sobre un enlace que pierde
Una última pregunta conecta esta sesión con la semana 11. TCP interpreta una pérdida como señal de congestión, pero en un enlace de radio una pérdida puede ser solo ruido. Entonces baja su ventana, aunque nadie esté congestionando nada.
No tenemos radio, pero sí podemos emular el último enlace con tc netem en l2, hacia h3: 100 Mbit/s, 40 ms de RTT y pérdida al azar. Tres corridas de python3 scenarios.py wireless, con CUBIC:
  sin pérdida                         94.5 Mbit/s      96 retransmisiones
  0,1 % de pérdida                    29.5 Mbit/s      18 retransmisiones
  1 % de pérdida                       6.4 Mbit/s      43 retransmisiones
  sin pérdida, con 4 ms de jitter     94.4 Mbit/s      34 retransmisiones
  sin pérdida                         94.4 Mbit/s     102 retransmisiones
  0,1 % de pérdida                    28.0 Mbit/s      28 retransmisiones
  1 % de pérdida                       6.8 Mbit/s      35 retransmisiones
  sin pérdida, con 4 ms de jitter     91.5 Mbit/s       2 retransmisiones
  sin pérdida                         94.4 Mbit/s     101 retransmisiones
  0,1 % de pérdida                    23.9 Mbit/s      18 retransmisiones
  1 % de pérdida                       5.4 Mbit/s      46 retransmisiones
  sin pérdida, con 4 ms de jitter     90.6 Mbit/s     101 retransmisiones
Lean el 1 %. El enlace pierde 1 de cada 100 paquetes, y TCP se queda con menos del 8 % de la capacidad. No es el 1 % lo que se fue: es el 92 %. Con 0,1 % se queda en menos de un tercio. En ningún caso hubo congestión: TCP redujo su ventana por un problema que reducirla no arregla.
La fórmula de Mathis, de la semana 11, predice el orden: 1,22 × 1448 × 8 / (0,040 × √0,01) da unos 3,5 Mbit/s con 1 %, y unos 11 con 0,1 %. CUBIC rinde algo mejor que esa cuenta, hecha para Reno, pero tiene la misma forma.
La última fila de cada corrida simula un enlace que repara sus pérdidas: un reintento se ve desde arriba como un paquete que demora un poco más, y lo emulamos con jitter. Sin pérdidas visibles, TCP llega a más de 90 Mbit/s en estas tres corridas. Es una emulación tosca, porque el jitter de netem también puede desordenar paquetes, y en otras corridas lo vimos bajar hasta unos 60 Mbit/s. Aun así queda muy por encima del 1 % de pérdida.
Por eso hay varias salidas, y ya las conocen:
- Recuperar en el enlace: el ACK y los reintentos de Wi-Fi, y en celular, los mecanismos de la RAN. Es la solución dominante.
- Partir la conexión: un proxy junto al enlace inalámbrico, con una conexión TCP a cada lado.
- No usar la pérdida como señal: BBR, de la semana 11, mira el ancho de banda y el RTT. Nuestro kernel no lo trae, así que no lo medimos.
La recuperación en el enlace también tiene un costo: el RTT se hace más variable, y si los reintentos son muchos, los paquetes pueden llegar desordenados o el RTO puede vencer antes de tiempo. Nada es gratis, y es una buena razón para que los enlaces mejoren su señal antes que su protocolo.
Idea clave. TCP no sabe por qué se perdió un paquete. Toda reacción a la pérdida supone congestión, y en un enlace inalámbrico esa suposición puede ser falsa. La capa de enlace esconde las pérdidas para que la suposición siga siendo verdad.
El laboratorio de la semana y make test
La carpeta code/week-14/ tiene una topología, los programas y las pruebas:
| Archivo | Qué es |
|---|---|
fabric/fabric.clab.yml |
La red leaf-spine de la semana |
fabric/daemons |
Los procesos de FRRouting, incluido bfdd |
scenarios.py |
Los escenarios: hash, fallas, overlay, trabajo colectivo, pérdida |
flow_probe.c, df_ping.c, ring_reduce.c |
Lo que corre en los nodos |
ecmp_sim.c, dcf_sim.c, tail_rounds.py |
Cuentas y modelos, sin red |
sdn_ctl.py, policy.txt |
El controlador de juguete y su política |
lab/l3-bgp.conf, lab/vxlan.sh |
Lo que ustedes completan |
test_fabric.py, test_tools.py |
Las pruebas |
Pasos del laboratorio. Para cada uno, antes de ejecutar, predigan el resultado.
- BGP.
make up.l3no habla BGP todavía: compruébenlo convtysh -c 'show bgp summary'y haciendo ping desdeh5. Completenlab/l3-bgp.confy cárguenlo conpython3 scenarios.py l3. Los datos están en los comentarios del archivo. Comprueben queh5llega ah1, y quel3ve dos caminos hacia las otras LAN. - Varios next hop. En
l1,ip routeyvtysh -c 'show bgp ipv4 unicast 10.214.3.0/24'. ¿Cuántas líneasnexthophay hacia cada LAN? ¿Cuál es el AS_PATH? ¿Por qué hay solo una hacia el loopback de un spine? - Flujos.
python3 scenarios.py policy0, varias veces. ¿Cuánto pasa por cada spine? ¿Por qué? - Política de hash.
policy1varias veces, yrouteget. ¿Se reparte igual? Prueben tambiénelephantsypredict. Corran eliperf3a mano con menos flujos (2, 4) y repitan: ¿qué tan seguido sale parejo? - Apagar un spine.
resety luegocarrier.resety luegosilent. Despuéssilent_shortysilent_bfd. Llenen una tabla con el tiempo sin servicio y compárenla con la de OSPF de la semana 5. ¿Por qué se cortan solo algunos flujos? ¿Cuál es el peor caso para una conexión TCP? - VXLAN. Completen
lab/vxlan.sh: un túnel entreh2yh6, con VNI 42. Cárguenlo conpython3 scenarios.py vxlan. Hagan ping entre10.42.0.1y10.42.0.2. Capturen eneth1deh6y encuentren, contshark -Vo en Wireshark, el frame interno. ¿Qué MTU quedó envx42? ¿Quién la calculó, y por qué ese valor? Comprueben que la captura muestra los 50 bytes de más. - Avancen con P5. Lo que hicieron aquí no se usa directamente en P5, pero cuando corten un enlace en la demostración, van a preguntarse lo mismo: ¿cómo se enteró la red, y cuánto tardó?
make test levanta la red, corre todo lo que afirman estos apuntes y comprueba las mediciones con márgenes amplios, nunca con cifras exactas. Destruye todo al terminar, aunque algo falle. Tarda unos seis minutos, según la máquina. Las pruebas de I_Lab se saltan hasta que quiten la línea TODO de sus archivos.
Error común. Olvidar
python3 scenarios.py resetentre pasos. Un escenario no deshace el anterior. Y no usenwrite memoryenvtysh: los archivosfrr.confestán montados en solo lectura. Si quieren cambiar algo de manera permanente, editen el archivo.
Resumen
- En un data center domina el tráfico este-oeste. Un árbol con un núcleo enorme se vuelve cuello de botella, caro y frágil.
- Clos / leaf-spine: cada leaf conectado con cada spine. Todos los caminos entre racks tienen el mismo largo. Más spines da más capacidad, más leaves da más servidores.
- Sobresuscripción = capacidad hacia los servidores / capacidad hacia los spines, contando capacidad y no puertos.
- BGP en el data center: eBGP de un salto, con el mismo AS en los spines y uno propio en cada leaf. El multipath sale solo, y los caminos que dan la vuelta por un leaf no existen.
- ECMP reparte por flujo con un hash de la 5-tupla. Por flujo, para no desordenar: medimos que por paquete, con solo 2 ms de diferencia, TCP rinde menos de un tercio.
- En Linux, el valor de fábrica de
fib_multipath_hash_policyusa solo direcciones IP: entre dos hosts, todo por un camino. El hash cuenta flujos, no bytes: dos elefantes en el mismo camino se quedan con la mitad, y ECMP no se entera. - Caída de un spine: con aviso, casi nada. Silenciosa, el tiempo que tarda en agotarse el hold timer o BFD, y solo para los flujos que iban por él. Lo que tarda es enterarse, igual que en OSPF.
- Overlay: red virtual encapsulada sobre un underlay. La dirección interna dice quién es, la externa dónde está. Así funcionan las VPC y gran parte de las redes de Kubernetes.
- VXLAN agrega 50 bytes y un VNI de 24 bits. Si no se ajusta la MTU, los paquetes grandes se pierden en silencio: el ping anda y la conexión se cuelga. El puerto de origen externo le da entropía a ECMP.
- SDN separa el plano de control y lo centraliza lógicamente. El forwarding generalizado es match-action. No reemplaza necesariamente a los protocolos: muchos data centers usan BGP y controladores. Orion es el caso de Google.
- En un trabajo colectivo, como all-reduce, cada ronda espera al más lento. Importa la peor latencia, y un solo enlace lento atrasa a todos.
- Sin cables hay atenuación, multitrayecto, ruido, terminal oculto y una tasa de error mucho mayor.
- Wi-Fi usa CSMA/CA: backoff antes de transmitir, frame completo y ACK en el enlace. No detecta colisiones porque una radio no puede oír mientras transmite, y porque la colisión ocurre en el receptor. RTS/CTS reserva el medio en el receptor.
- 5G: UE, RAN (gNB) y núcleo con control (AMF, SMF) separado de los datos (UPF). La sesión PDU es un túnel, y la red se volvió software.
- Movilidad: en Wi-Fi, dentro de la subred se conserva la IP. En 5G, el UPF es el ancla, y un handover solo mueve el extremo del túnel.
- TCP cree que toda pérdida es congestión. Con 1 % de pérdida de radio, medimos menos del 8 % de la capacidad. Por eso los enlaces inalámbricos retransmiten por su cuenta.
Ejercicios
- Una red leaf-spine tiene leaves con 48 puertos de 10 Gbps hacia servidores y 6 de 40 Gbps hacia spines. ¿Cuál es la sobresuscripción? ¿Cuántos spines tiene, si cada uplink va a uno distinto? Si los spines tienen 32 puertos, ¿cuántos servidores admite la red? ¿Cuántos uplinks de 40 Gbps harían falta para 1:1?
- Con
k = 16, ¿cuántos servidores admite una fat-tree y cuántos switches usa? ¿Cuántos caminos de igual costo hay entre dos servidores de pods distintos? (Piensen en cuántos núcleos pueden elegir). - ¿Por qué ECMP reparte por flujo y no por paquete? ¿Qué problema trae un flujo muy grande? Modifiquen
perpacketpara que la diferencia entre caminos sea de 0, 0,5 y 10 ms. Predigan primero qué le pasa al throughput y qué le pasa al contador de fuera de orden. Comprueben. - Con 3 elefantes y 2 caminos, calculen a mano la probabilidad de que todos caigan en el mismo camino, y el throughput total esperado, si cada flujo quiere un enlace entero. Comprueben con
ecmp_sim elephant 2 3 200000. ¿Por qué “sin choques” da 0? - A los spines de nuestra red les ponemos AS distintos (65140 y 65150). Predigan qué le pasa a la tabla de
l1: ¿cuántas líneasnexthoptendrá? ¿Qué cambia cuando se cae el enlace s1-l2? Comprueben editando losfrr.conf, y busquen en la documentación de FRRouting qué hacebgp bestpath as-path multipath-relax. - En
silent, el hueco cae entre 6 y 9 s. ¿Por qué no es siempre 9? Con keepalive 1 y hold 3, ¿qué rango esperan? Una conexión TCP entreh1yh3se corta si ida o vuelta pasan pors1. Sis1cae en silencio, ¿qué fracción de conexiones se afecta con 2 spines? ¿Y con 4 spines, cuando cae uno? Después, además del tiempo de detección, ¿qué más va a tardar la conexión en reponerse? (Recuerden el RTO de la semana 10). - ¿Qué agrega un encabezado VXLAN a cada paquete, y qué efecto tiene en la MTU? Si el underlay ofrece 9000, ¿cuál es la mayor MTU de cliente posible? Un compañero configura VXLAN sobre un túnel WireGuard (la semana 15 lo verá) y deja la MTU de cliente en 1500. ¿Qué síntomas espera? ¿Cómo lo comprobaría con
df_ping? - Dos clientes usan VXLAN con el mismo VNI por un error de configuración, y direcciones iguales. ¿Qué observarían? Háganlo: pongan
tb1ytb2en el VNI 100, y miren qué MAC aprendeta1y qué pasa con elping. - Un trabajo de entrenamiento se comunica en rondas con todas las GPU. ¿Por qué importa más la peor latencia que el promedio? Con 500 GPU, si cada una tiene 0,2 % de probabilidad de sufrir un atraso en cada ronda, ¿qué fracción de rondas se atrasa? Comprueben con
tail_rounds.py. ¿A cuánto habría que bajar esa probabilidad para que solo se atrase el 1 % de las rondas? - En
ring_reduce, ¿cuántos bytes envía cada nodo por ronda sin= 16 y el vector mide 1 MB? Si todos los enlaces son de 100 Gbps, ¿cuánto tarda una ronda, sin contar latencia? ¿Y si un nodo tiene un enlace de 10 Gbps? Modifiquencollectivepara limitar otro host a 200 Mbit/s y comparen con su cálculo. ¿Qué tendría de malo cambiar elpollpor unsendy unrecvseguidos? Pruébenlo con vectores chicos y con grandes. - ¿Por qué Wi-Fi usa ACK en el enlace si TCP ya los tiene? Un enlace pierde 30 % de sus frames y reintenta hasta 4 veces en total. ¿Qué pérdida ve TCP? Usen la fórmula de Mathis con 1448 bytes y 40 ms de RTT, y comparen el throughput con y sin esos reintentos. Luego, modifiquen
wirelesspara probar 0,5 % y compárenlo con su cuenta. - (Desafío) En
dcf_sim, cambienCW_MINa 2 y luego a 256, y repitan la tabla deshared. Expliquen qué pasa con el tiempo útil para pocas y para muchas estaciones. ¿Qué dice eso sobre la elección de una ventana fija? ¿Y sobre la duplicación?