
Apuntes · Capítulo 3Redes locales e IP
Enlace, Ethernet y VLANs
Enlace, Ethernet y VLANs
En la semana 2 escribieron programas que conversan por la red: un connect en un
extremo, un accept en el otro, y los bytes llegan. Desde ahí, la red parece un tubo.
Este capítulo abre el tubo por el tramo más corto: el salto entre dos equipos vecinos.
Antes de que un paquete cruce el mundo tiene que cruzar un cable, y ese cable tiene
problemas propios. Los bits se dañan, varios equipos pueden querer hablar a la vez, y el
host que envía debe averiguar la dirección física de su vecino antes de mandarle algo.
Bajamos a la capa de enlace (link layer) y, muy brevemente, a la capa física que tiene debajo. Vamos a seguir un orden de abajo hacia arriba, porque cada tema resuelve un problema que deja el anterior:
- La capa física mueve bits, pero con errores.
- Por eso hace falta agruparlos en frames y detectar los errores: paridad, checksum y CRC.
- Si el medio es compartido, hay que decidir quién transmite: acceso múltiple.
- Ethernet junta todo lo anterior y agrega direcciones MAC.
- Para usar esas direcciones hay que encontrarlas: ARP.
- Un switch conecta varios enlaces y aprende solo por dónde está cada MAC.
- Si los switches forman un ciclo, un solo broadcast tumba la red: spanning tree.
- Y si una sola red física debe comportarse como varias, usamos VLANs.
Casi todo lo vamos a ver funcionando. En el laboratorio arman un switch con un bridge de Linux, capturan ARP, miran cómo aprende el switch, separan la red en VLANs y encuentran la etiqueta 802.1Q dentro de un frame.
Ruta de lectura.
Antes de clase (obligatorio, unos 15 a 20 minutos). Sesión A: Dos tiempos que no hay que confundir, Qué hace la capa de enlace, y de Detección de errores, la introducción, Paridad y Checksum. Sesión B: la introducción de Acceso múltiple con Particionar el canal, Ethernet y, de ARP, Cómo funciona.
En clase. Sesión A: La capa física en lo esencial, CRC, Cuál detecta qué y Por qué el enlace usa CRC y el transporte un checksum. Sesión B: Acceso aleatorio: ALOHA, Acceso aleatorio: CSMA, CSMA/CD en la Ethernet original, Un intercambio real, Switches, Spanning tree y VLANs.
Después de clase. Repasen con el Resumen y los Ejercicios, y preparen El laboratorio de esta semana. Opcional: Tomar turnos, Los bytes de ARP, ARP a mano, en C y Un paquete a través de VLANs, en tres capturas. Para profundizar, las lecturas del libro y las gratuitas de la semana:
Este capítulo acompaña a Kurose y Ross, Computer Networking: A Top-Down Approach (9.ª ed.). Para la Sesión A, las secciones 1.2.2 Physical Media, 6.1 Introduction to the Link Layer y 6.2 Error-Detection and -Correction Techniques, junto con CS168, Links. Para la Sesión B, las secciones 6.3 Multiple Access Links and Protocols y 6.4 Switched Local Area Networks, junto con CS168, Ethernet, Layer 2 Routing y ARP. Complementaria: RFC 826, ARP. El código del capítulo está en
code/week-03y se prueba conmake testdentro del contenedor del curso. Las instrucciones del entorno están enlabs/README.md.
La capa física en lo esencial
La capa física mueve bits de un lado a otro de un enlace (link), que es lo que une directamente a dos o más nodos. No sabe qué significan esos bits ni dónde empieza un mensaje. Solo convierte bits en una señal, la pone en un medio de transmisión (transmission medium) y, al otro lado, convierte la señal de nuevo en bits. No vamos a estudiar señales en detalle, pero sí necesitamos entender qué limita a cada medio, porque de ahí salen las decisiones de las capas de arriba.
Medios guiados y no guiados
Un medio es guiado si la señal viaja dentro de algo sólido: un cable de cobre o una fibra. Es no guiado si se propaga por el aire o el vacío.
| Medio | Señal | Alcance y velocidad típicos | Qué lo limita |
|---|---|---|---|
| Par trenzado de cobre | Eléctrica | 1 a 10 Gb/s, hasta 100 m | Atenuación e interferencia |
| Cable coaxial | Eléctrica | Hasta varios Gb/s compartidos, en redes de cable | Atenuación; el medio se comparte entre vecinos |
| Fibra multimodo | Luz | 10 a 100 Gb/s, de 100 m a unos cientos de metros | Dispersión: los modos de luz llegan en momentos distintos |
| Fibra monomodo | Luz | 100 Gb/s o más, decenas de km sin amplificar | Atenuación, muy baja; dispersión |
| Radio local (Wi-Fi) | Ondas de radio | Cientos de Mb/s a varios Gb/s, decenas de metros | Paredes, distancia, interferencia, medio compartido |
| Radio celular | Ondas de radio | Decenas de Mb/s a más de 1 Gb/s, cientos de metros a km | Distancia, espectro disponible, usuarios por celda |
| Satélite | Ondas de radio | Decenas a cientos de Mb/s | Retardo de propagación, clima, cielo despejado |
Las cifras son órdenes de magnitud, no especificaciones: cambian con cada generación de equipos. Lo que conviene recordar son las causas.
- Atenuación. La señal se debilita con la distancia. En cobre se pierde mucho más que en fibra: por eso el par trenzado se queda en 100 m y una fibra monomodo llega a decenas de kilómetros sin amplificar.
- Interferencia. Otras señales se suman a la nuestra. El par trenzado está trenzado justamente para que el ruido externo afecte por igual a los dos hilos y se cancele al restarlos. La luz en una fibra no sufre interferencia electromagnética.
- Medio compartido. En el cobre de una Ethernet moderna cada enlace es de dos equipos. En radio, todos los que están cerca comparten el mismo aire. Esto crea el problema de acceso múltiple de la Sesión B.
Idea clave. El medio decide la tasa de errores. En una fibra los errores son rarísimos; en un enlace de radio son el día a día. Por eso Ethernet solo detecta errores, mientras Wi-Fi además retransmite en la capa de enlace.
Ancho de banda, modulación y codificación
La palabra bandwidth (ancho de banda) tiene dos significados que conviene separar:
- En señales, es el rango de frecuencias que usa un enlace, y se mide en hertz. Un canal Wi-Fi de 20 MHz tiene 20 MHz de ancho de banda.
- En redes, se usa para la tasa de bits, en bits por segundo. Es lo que decimos al hablar de “un enlace de 1 Gb/s”.
Los dos están relacionados. Modulación es la forma de representar bits cambiando una propiedad de la señal: su amplitud, su frecuencia o su fase. Un símbolo es uno de los estados que la señal puede tomar durante un instante. Si hay más estados posibles, cada símbolo lleva más bits: con 2 estados lleva 1 bit, con 16 lleva 4, y con 256 (lo que se llama 256-QAM) lleva 8. Pero los estados quedan más cerca entre sí y el ruido los confunde con mayor facilidad. Por eso un celular cambia de modulación según la calidad de la señal.
Shannon puso un límite a todo esto. La capacidad máxima de un canal, sin importar cuán ingeniosa sea la modulación, es
C = B · log2(1 + S/N)donde B es el ancho de banda en hertz y S/N es la relación entre la potencia de la
señal y la del ruido. Por ejemplo, un canal de 20 MHz con una relación señal a ruido de
30 dB (S/N = 1000, porque 30 dB = 10^(30/10)) permite como mucho
20 × 10^6 × log2(1001) ≈ 199 Mb/s. Para subir esa cifra hay dos caminos: más espectro
o mejor señal. Por eso los operadores pagan tanto por el espectro.
La codificación agrega reglas sobre qué bits se ponen en el medio. Sirve para que el receptor pueda mantener su reloj sincronizado (necesita ver cambios en la señal) y, en algunos casos, para corregir errores. Tiene un costo: la tasa en el medio es mayor que la tasa útil. La Ethernet de 10 Gb/s por fibra, por ejemplo, usa la codificación 64b/66b: agrega 2 bits por cada 64, de modo que en la fibra hay 10,3125 Gb/s para entregar 10 Gb/s útiles.
En la práctica. Cuando un enlace “de 1 Gb/s” entrega unos 950 Mb/s en una medición con TCP, no hay nada malo. Cada frame de 1500 bytes de datos ocupa 1538 bytes en el cable y, de esos 1500, TCP e IP se llevan 40. Quedan 1460/1538 ≈ 95 % del enlace. Sacaremos esas cuentas con el formato de Ethernet en la Sesión B.
Dos tiempos que no hay que confundir
De la semana 1 ya conocen estos dos retardos. Los repetimos porque el acceso múltiple depende de la relación entre ellos.
- Tiempo de transmisión: lo que tarda en salir el frame completo. Es
L / R, conLen bits yRen bits por segundo. 1500 bytes a 1 Gb/s son 12 µs. - Tiempo de propagación: lo que tarda un bit en llegar al otro lado. Es
d / v, conv≈ 2 × 10^8 m/s en cobre y fibra. 100 m son 0,5 µs.
La velocidad del enlace no cambia la propagación: un enlace más rápido pone los bits más juntos, pero no los hace viajar más rápido.
Qué hace la capa de enlace
La capa física nos deja una corriente de bits con errores entre dos equipos. La capa de enlace convierte eso en algo más útil: una forma de entregar un paquete completo al vecino. Su unidad de datos es el frame (también se le dice trama). Un frame encapsula un datagrama de la capa de red, igual que un sobre contiene una carta.
Sus servicios son estos, y no todas las tecnologías dan todos:
- Framing. Indicar dónde empieza y termina cada frame, y agregar un header con direcciones y un campo para detectar errores.
- Acceso al medio. Decidir quién puede transmitir si el medio es compartido.
- Entrega entre vecinos. Hacer llegar el frame al otro extremo de este enlace, nada más. Lo que pasa después ya es responsabilidad de otro enlace.
- Detección de errores. Descartar frames dañados en lugar de entregarlos.
- Entrega confiable, opcional. Retransmitir los frames perdidos. Wi-Fi lo hace, porque pierde mucho. Ethernet no: en un cable los errores son tan raros que el costo no se justifica y se deja a TCP.
La idea importante es el alcance. IP entrega de un extremo al otro de Internet; el enlace entrega solo hasta el siguiente equipo. Un datagrama que viaja de Lima a Tokio cruza decenas de enlaces distintos, quizá Wi-Fi, Ethernet, fibra de larga distancia. En cada uno viaja dentro de un frame distinto, con sus propias direcciones, y esos frames nacen y mueren en cada salto. Lo veremos con una captura real al final del capítulo.
Idea clave. La capa de enlace trabaja de un salto a la vez. Cada router desenvuelve el frame que llega, mira el datagrama y lo envuelve en un frame nuevo para el siguiente enlace.
Cómo marcar dónde empieza un frame
El receptor recibe bits: ¿cómo sabe dónde empieza un frame? Hay tres técnicas clásicas.
- Contar. El header dice cuántos bytes vienen. Es simple, pero si ese campo se daña se pierde el rumbo y no se sabe dónde buscar el siguiente frame.
- Marcas especiales. Un byte reservado indica el inicio y el fin. Si ese byte aparece entre los datos, se le antepone un byte de escape y el receptor lo quita. Es lo que se llama byte stuffing. PPP funciona así.
- Violar la codificación. Usar una señal que no representa ningún dato válido.
Ethernet usa un preámbulo: 7 bytes de 10101010, que permiten sincronizar el reloj
del receptor, y un byte de inicio, 10101011, que marca el comienzo. Entre frames tiene
que quedar un silencio mínimo, y la señal misma indica cuándo termina el frame.
Dónde vive
La mayor parte de la capa de enlace está en la tarjeta de red (network interface card, NIC): un chip que calcula el CRC, arma y revisa frames y copia los datos a la memoria del host. Solo una parte corre en el driver del sistema operativo. Por eso la capa de enlace es la frontera entre software y hardware, y por eso se pueden usar algoritmos como el CRC, que son baratos en hardware. En el curso no tenemos NIC físicas: cada nodo tiene interfaces virtuales (veth) y todo lo hace el kernel. Ese detalle va a explicar algunas cosas de las capturas.
Detección de errores
La detección de errores (error detection) responde a una pregunta: ¿llegó el frame
tal como salió? El modelo es el siguiente. El emisor tiene D bits de datos y calcula
con ellos unos bits redundantes, EDC (error-detection code). Envía los dos juntos. El
receptor recibe D' y EDC', que pueden haber cambiado, y comprueba si coinciden.
emisor:    D  →  calcula EDC  →  envía D, EDC
                                     │  enlace con errores
receptor:                            ▼
           recibe D', EDC'  →  ¿EDC' coincide con el EDC de D'?
Conviene leer bien lo que garantiza. Si la comprobación falla, hubo un error. Si la comprobación pasa, probablemente no lo hubo: siempre hay patrones de error que no se notan. Un buen método hace que esos patrones sean muy improbables, y el costo se paga en bits extra y en cálculo.
También importa el tipo de error. En muchos enlaces los errores no llegan aislados sino en ráfagas (bursts): un golpe de ruido daña varios bits seguidos. Un método que resiste errores sueltos pero no ráfagas sirve de poco.
Paridad
Es el método más simple. Con paridad par, se agrega un bit de modo que la cantidad total de unos sea par.
datos:     1 0 1 1 0 0 1   (cuatro unos)
paridad:   0
enviado:   1 0 1 1 0 0 1 0
El receptor cuenta los unos. Si salen impares, hubo un error. Pero si cambian dos bits, la cuenta sigue siendo par y nadie se entera: la paridad detecta solo una cantidad impar de errores. Si los errores llegan en ráfagas, una ráfaga larga tiene cerca del 50 % de probabilidad de pasar inadvertida.
La paridad bidimensional ordena los bits en una matriz y agrega un bit de paridad por fila y otro por columna.
             paridad de fila
1 0 1 0  |  0                       1 0 1 0  |  0
1 1 1 1  |  0     se daña un bit    1 1 0 1  |  0   ← esta fila falla
0 1 1 0  |  0     ──────────────►   0 1 1 0  |  0
─────────                           ─────────
0 0 1 1  |  0                       0 0 1 1  |  0
                                        ▲ esta columna falla
Si se daña un solo bit, fallan una fila y una columna, y su cruce dice cuál es. Así que no solo se detecta el error: se corrige. Esa capacidad de reparar sin retransmitir se llama corrección de errores hacia adelante (forward error correction, FEC). Vale la pena en enlaces donde retransmitir es muy lento (un satélite) o imposible (una transmisión a miles de receptores). Este esquema también detecta cualquier error de 2 o de 3 bits, aunque no puede corregirlos. Con 4 bits en las esquinas de un rectángulo, todas las filas y columnas siguen pares y el error pasa.
Checksum
Un checksum trata los datos como una secuencia de números y los suma. El checksum de Internet, que usan IPv4, UDP y TCP, divide los datos en palabras de 16 bits, las suma con acarreo circular (lo que se pasa de 16 bits se vuelve a sumar abajo) y envía el complemento a uno del resultado. Por ejemplo, con dos palabras:
  0x4500
+ 0x0054
--------
  0x4554    complemento: 0xBAAB, que es lo que se envía
El receptor suma todo, checksum incluido, y debe obtener 0xFFFF. Se calcula con unas
pocas líneas de software, que recorren los datos una sola vez. Es barato. Pero es débil,
como veremos: como la suma es conmutativa, si dos palabras se intercambian el resultado
es el mismo. Volveremos a usarlo al ver transporte.
CRC
El CRC (cyclic redundancy check) es el método que usan Ethernet y Wi-Fi. Parece más complicado que un checksum, pero es solo una división.
Definición. Emisor y receptor acuerdan un generador G de r + 1 bits, cuyo
primer bit es 1. Para los datos D, el emisor elige r bits R de modo que la cadena
D seguida de R sea divisible exactamente entre G. El receptor divide lo que recibe
entre G. Si el residuo no es cero, hubo un error.
Aritmética módulo 2. Toda la cuenta se hace sin acarreos: sumar y restar son lo mismo, y los dos son XOR.
  1011        1011
+ 0101      - 0101
------      ------
  1110        1110
Dividir se hace igual que a mano en la escuela, pero con XOR en vez de resta. El generador “cabe” en cualquier grupo que empiece con 1.
Por qué el residuo sirve. Agregar r ceros a D es multiplicar por 2^r. La
cadena que se envía es T = D·2^r XOR R. Queremos que T sea múltiplo de G, así que
R tiene que ser el residuo de dividir D·2^r entre G. Como restar y sumar son lo
mismo, al “sumarle” el residuo lo estamos quitando, y la división queda exacta.
Ejemplo resuelto. Datos D = 1101011 y generador G = 1001. Como G tiene 4 bits,
r = 3. Se agregan tres ceros a los datos y se divide. El programa
crc.c muestra cada paso: la línea de arriba es el estado
actual y la de abajo es el generador, alineado con el primer 1 que queda.
$ build/crc 1101011 1001
  1101011000
  1001  (XOR en la posición 0)
  0100011000
   1001  (XOR en la posición 1)
  0000111000
      1001  (XOR en la posición 4)
  0000011100
       1001  (XOR en la posición 5)
  0000001110
        1001  (XOR en la posición 6)
  0000000111
CRC (r = 3 bits): 111
se transmite: 1101011111
Los últimos tres bits, 111, son el CRC. El receptor recibe 1101011111, lo divide tal
cual, sin agregar nada, y obtiene residuo cero.
$ build/crc -c 1101011111 1001
  1101011111
  1001  (XOR en la posición 0)
  0100011111
   1001  (XOR en la posición 1)
  0000111111
      1001  (XOR en la posición 4)
  0000011011
       1001  (XOR en la posición 5)
  0000001001
        1001  (XOR en la posición 6)
  0000000000
residuo: 000
sin errores detectados
Si un bit cambia en el camino, el residuo deja de ser cero:
$ build/crc -c 1101011011 1001
  ...
residuo: 100
ERROR detectado
Para usarlo ustedes, compilen con make dentro de code/week-03. Conviene que hagan la
cuenta a mano con otros datos y comparen con el programa.
Qué errores detecta. Lo más claro es verlo con polinomios. Una cadena de bits es un
polinomio con coeficientes 0 o 1: 1001 es x^3 + 1. Si lo enviado es T y el error
es un patrón E (con un 1 en cada bit dañado), el receptor recibe T XOR E. Como T
es múltiplo de G, el residuo solo depende de E:
Un error pasa inadvertido si y solo si
Ees múltiplo deG.
De ahí salen las garantías. Un CRC de r bits, con un generador que empieza y termina
en 1:
- Detecta siempre cualquier ráfaga de hasta
rbits, y por lo tanto cualquier error de un solo bit. Una ráfaga de largob ≤ resx^kpor un polinomio de gradob - 1 < r. ComoGtermina en 1, no comparte factores conx^k: para ser múltiplo deG, tendría que serlo el otro factor. Y eso es imposible, porque su grado es menor que el deG. - Detecta cualquier cantidad impar de errores, si
Gtiene ax + 1como factor. Es el caso de1001, porquex^3 + 1 = (x + 1)(x^2 + x + 1). - Si los bits se dañan al azar, pasa inadvertida una fracción cercana a
1/2^rde los patrones posibles.
Las pruebas de test_crc.py revisan estas afirmaciones
con G = 1001 en todos los patrones de error posibles para la palabra de 10 bits del
ejemplo.
1001 sirve para aprender, pero es un mal generador. El error 1001, dos bits a
distancia 3, es múltiplo de sí mismo y por lo tanto no se detecta. Aquí lo vemos,
con ese patrón desplazado tres posiciones sobre la palabra del ejemplo:
$ build/crc -c 1100010111 1001
  ...
residuo: 000
sin errores detectados
Los bits 3 y 6 están dañados y el receptor cree que todo está bien. Elegir un buen generador es un problema matemático serio. Por eso nadie los inventa: se usan los de los estándares.
CRC-32. Ethernet usa un CRC de 32 bits. Su generador es el polinomio de grado 32
cuyo valor es 0x04C11DB7 (sin contar el bit más alto). Detecta cualquier ráfaga de
hasta 32 bits, y solo deja pasar del orden de 1 de cada 2^32 (unos 4 mil millones) de
los patrones al azar. Se implementa en hardware con un registro de desplazamiento y unas
compuertas XOR, sin costo apreciable por bit.
Cuál detecta qué
Para comparar, el programa detect.py daña frames
aleatorios de 64 bytes de distintas formas y cuenta cuántos daños no detecta cada
método, usando el zlib.crc32 de Python para el CRC-32.
$ python3 detect.py
20000 intentos por fila, frames de 64 bytes. Daños NO detectados:
daño                        paridad  checksum   crc32
1 bit                             0         0       0
2 bits                        20000       616       0
ráfaga de 16 bits              9957         0       0
ráfaga de 32 bits             10033         1       0
ráfaga de 100 bits             9958         1       0
intercambio de palabras       20000     20000       0
La semilla es fija, así que el resultado se repite. Cada fila tiene su historia:
- 2 bits. La paridad falla el 100 % de las veces. El checksum falla en 616 de 20 000, cerca de 1/32: pasa cuando los dos bits caen en la misma posición de dos palabras de 16 bits (probabilidad 1/16) y cambian en sentidos opuestos, uno de 0 a 1 y el otro de 1 a 0 (probabilidad 1/2). Así la suma no cambia.
- Ráfagas. La paridad falla cerca de la mitad. El checksum casi siempre detecta.
- Intercambio de palabras. Dos palabras de 16 bits cambian de lugar. Ni la paridad ni el checksum lo notan, porque la suma no depende del orden. Este daño no es teórico: una memoria o un driver con errores puede causarlo.
Que el CRC-32 marque 0 en toda la columna no significa que sea infalible. Con 20 000 intentos y una probabilidad de 1 en 4 mil millones, lo esperable es cero.
Por qué el enlace usa CRC y el transporte un checksum
Si el CRC es mucho mejor, ¿por qué TCP y UDP siguen con un checksum más débil?
- Dónde se calcula. En el enlace, el CRC lo calcula un chip, y hacerlo en hardware es casi gratis. El transporte se diseñó para correr en software, en computadoras de los años 70 y 80, donde un CRC bit por bit salía caro y una suma salía barata.
- Qué protege cada uno. El CRC protege un enlace, y se recalcula en cada salto. Un error que ocurra dentro de un router (al copiar en memoria, por ejemplo) no lo ve ningún CRC, porque el router recalcula uno nuevo y correcto sobre datos ya dañados. El checksum de transporte, en cambio, va de extremo a extremo. Es el argumento end-to-end de la semana 2: algunas garantías solo se pueden dar en los extremos.
- Los errores que le llegan. Como los enlaces ya filtraron casi todos los errores de transmisión, el checksum solo es una segunda red, y no necesita ser excelente.
Los dos juntos cubren cosas distintas: el CRC detecta muy bien los errores del cable, y el checksum detecta, aunque no tan bien, lo que pasa entre los extremos.
Error común. Creer que un frame con CRC correcto garantiza datos correctos para la aplicación. El CRC solo dice que este enlace no dañó el frame. Si la aplicación necesita certeza, tiene que verificar por su cuenta, por ejemplo con un hash del archivo.
Acceso múltiple
Empezamos la Sesión B con el problema de los enlaces de broadcast: varios nodos comparten un solo medio y lo que uno transmite lo reciben todos. Es lo que ocurre en el aire de Wi-Fi, en el cable coaxial de una red de cable y en la Ethernet original. Si dos nodos transmiten a la vez, las señales se mezclan y nadie entiende nada: hay una colisión (collision).
Un protocolo de acceso múltiple (multiple access) es el conjunto de reglas para
decidir quién transmite. Y no hay un canal aparte para coordinarse: las reglas usan el
mismo medio. Lo ideal, para un canal de R bits por segundo, sería esto:
- Si un solo nodo quiere transmitir, lo hace a
R. - Si quieren
Mnodos, cada uno obtiene en promedioR/M. - Sin un coordinador central que pueda fallar.
- Simple y barato.
Hay tres familias, que se diferencian en cómo reparten el canal.
Particionar el canal
Se divide el canal en pedazos fijos y cada nodo recibe el suyo.
- TDM (time-division multiplexing). El tiempo se parte en ranuras, y cada nodo tiene las suyas, por turnos fijos.
- FDM (frequency-division multiplexing). Cada nodo usa una banda de frecuencias distinta.
- CDMA (code-division multiple access). Todos usan a la vez la misma banda, con códigos que permiten separarlos.
No hay colisiones y el reparto es justo. Pero fallan con el requisito 1: un nodo solo,
en un canal con 10 ranuras, usa una ranura y deja las otras nueve vacías, y llega a
R/10 aunque nadie más quiera transmitir. Es muy buena opción con mucha carga constante
y mala con tráfico en ráfagas, que es lo habitual en redes de datos. Es el mismo
argumento de la semana 1 entre conmutación de circuitos y de paquetes.
Acceso aleatorio: ALOHA
Aquí no hay reparto. Cada nodo transmite a toda velocidad, y si hay colisión, espera un tiempo aleatorio y vuelve a intentar. La aleatoriedad es lo que evita que los mismos dos nodos vuelvan a chocar para siempre.
ALOHA nació en la Universidad de Hawái, alrededor de 1970, para unir por radio
terminales repartidos por las islas. Su versión ranurada divide el tiempo en ranuras
del tamaño de un frame, y las transmisiones empiezan solo al inicio de una ranura. Si
hubo colisión, en cada ranura siguiente el nodo reintenta con probabilidad p.
¿Qué fracción del canal se aprovecha? Supongamos N nodos activos, y que cada uno
transmite en una ranura con probabilidad p. Una ranura se aprovecha si exactamente
uno transmite. La probabilidad es
S = N · p · (1 - p)^(N-1)Derivando se ve que el máximo está en p = 1/N. Sea G = N·p la carga ofrecida: los
intentos de transmisión por ranura. Con N grande, (1 - 1/N)^(N-1) tiende a 1/e, y
queda:
S = G · e^(-G) máximo en G = 1: S = 1/e ≈ 0.368En el mejor caso se aprovecha el 37 % del canal. El resto son ranuras vacías (otro 37 %) y colisiones.
En ALOHA puro no hay ranuras: se transmite apenas hay algo que enviar. Eso duplica
el período de riesgo. Un frame que empieza en t choca con cualquier otro que haya
empezado en el tiempo de frame anterior, y también con cualquiera que empiece durante su
propia transmisión. Por eso:
S = G · e^(-2G) máximo en G = 1/2: S = 1/(2e) ≈ 0.184Podemos revisar estas fórmulas con una simulación. aloha.c
simula 50 nodos en el caso ranurado (400 000 ranuras) y, en el caso puro, 400 000
intentos en instantes al azar. Las dos columnas de sim vienen de la simulación; las
otras dos, de la fórmula.
$ build/aloha
   G | ranurado sim  G*e^-G | puro sim  G*e^-2G
0.10 |        0.091   0.090 |    0.082    0.082
0.25 |        0.196   0.195 |    0.152    0.152
0.50 |        0.304   0.303 |    0.184    0.184
0.75 |        0.358   0.354 |    0.168    0.167
1.00 |        0.372   0.368 |    0.135    0.135
1.50 |        0.336   0.335 |    0.074    0.075
2.00 |        0.271   0.271 |    0.036    0.037
3.00 |        0.145   0.149 |    0.007    0.007
Las columnas de sim usan un generador con semilla fija, y por eso el resultado es
igual en cualquier máquina. Las diferencias en el caso ranurado se deben a que la
fórmula G·e^(-G) supone N infinito, y simulamos 50 nodos.
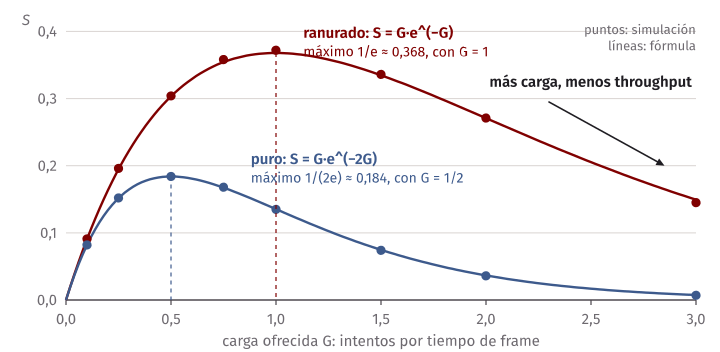
Lo más importante de la tabla es qué pasa a la derecha del máximo: si se ofrece más
carga, se obtiene menos. Con G = 3, casi todo son colisiones. Una red de acceso
aleatorio sobrecargada no se queda en su máximo, sino que colapsa. Volveremos a ver esta
forma en control de congestión.
Acceso aleatorio: CSMA
ALOHA tiene un defecto de mala educación: transmite aunque otro esté hablando. CSMA (carrier sense multiple access) agrega dos reglas que aplicamos en una conversación:
- Escuchar antes de hablar. Si el canal está ocupado, se espera.
- Dejar de hablar si otro empezó (detección de colisión, CD). Si uno detecta otra señal mientras transmite, corta.
Si todos escuchan antes de hablar, ¿por qué sigue habiendo colisiones? Por el retardo de propagación. Si A empieza a transmitir, B, a cierta distancia, sigue oyendo silencio hasta que le llegue la señal, y puede empezar también. Cuanto mayor sea el retardo de propagación respecto al tiempo de transmisión, peor.
tiempo   A                                    B
  │      │██  A empieza                       │
  │      │███                                 │   B oye silencio y empieza
  │      │████                             ███│
  │      │█████▓▓                       ▓▓████│   las señales se cruzan
  ▼      │██▓▓▓▓▓▓                     ▓▓▓▓▓██│   A y B detectan la colisión
CSMA/CD en la Ethernet original
CSMA/CD es el protocolo de la Ethernet clásica, con un cable compartido. Una tarjeta de red hace esto:
- Toma un frame para enviar. Si el canal está libre, empieza. Si está ocupado, espera a que se libere y entonces empieza.
- Mientras transmite, escucha. Si termina sin detectar nada, el frame salió bien.
- Si detecta otra señal, deja de transmitir y envía una breve señal de interferencia (jam), para que todos noten la colisión.
- Espera un tiempo aleatorio, según el retroceso exponencial binario (binary exponential backoff), y vuelve al paso 1.
El retroceso se calcula así. Después de la colisión número n de un frame, se elige K
al azar en {0, 1, …, 2^m - 1}, con m = min(n, 10), y se espera K × 512 tiempos de
bit. Tras 16 intentos, se descarta el frame.
| Colisión | Valores posibles de K |
Espera máxima a 10 Mb/s |
|---|---|---|
| 1.ª | 0, 1 | 51,2 µs |
| 2.ª | 0 a 3 | 153,6 µs |
| 3.ª | 0 a 7 | 358,4 µs |
| 10.ª en adelante | 0 a 1023 | 52,4 ms |
La idea es elegante: nadie necesita saber cuántos nodos están compitiendo. Con pocas colisiones se reintenta rápido. Si los choques siguen, el rango crece, y cada intento se separa más, hasta que uno gana.
¿Por qué hay un tamaño mínimo de frame? Para que el emisor sepa que hubo colisión, tiene que seguir transmitiendo cuando la señal del otro extremo vuelva. En el peor caso, eso tarda dos tiempos de propagación. La Ethernet de 10 Mb/s fijó 512 bits (64 bytes), que tardan 51,2 µs en salir: un frame más corto podría terminar antes de que el emisor oiga la colisión, y creería que todo salió bien. A 2 × 10^8 m/s, 51,2 µs de ida y vuelta dan unos 5 km de ida, y los retardos de los repetidores reducían ese máximo a unos 2.5 km. Esa es la razón de los 64 bytes, que siguen en el estándar.
Eficiencia. Si a = d_prop / d_trans, la fracción aprovechada de CSMA/CD es
aproximadamente 1 / (1 + 5a). Con frames de 1500 bytes a 10 Mb/s (d_trans = 1200 µs)
y d_prop = 10 µs, da 96 %. Es mucho mejor que ALOHA, porque una colisión se interrumpe
pronto y no se pierde el tiempo de un frame entero. Ahora vemos por qué los dos tiempos
importan: cuando a tiende a 0, las colisiones casi no cuestan.
En la práctica. Wi-Fi también es acceso aleatorio, pero con CSMA/CA, de collision avoidance. Un equipo de radio no puede oír a otros mientras transmite, porque su propia señal es mucho más fuerte. Por eso no detecta colisiones: intenta evitarlas y usa acuses de recibo. Lo estudiaremos en la semana 14.
Tomar turnos
La tercera familia intenta lo mejor de las otras dos.
- Polling. Un nodo maestro invita a los demás, por turnos, a transmitir. Elimina las colisiones, pero el maestro es un punto único de falla y las invitaciones consumen tiempo.
- Token passing. Un mensaje especial, el token, pasa de nodo en nodo. Solo quien tiene el token transmite. No hay maestro, pero un token perdido obliga a un procedimiento de recuperación.
| Familia | Ejemplos | Solo un nodo activo | Muchos nodos activos | Colisiones |
|---|---|---|---|---|
| Particionar | TDM, FDM, CDMA | Mal: obtiene R/N |
Bien: reparto justo | No |
| Acceso aleatorio | ALOHA, CSMA/CD, CSMA/CA | Bien: obtiene R |
Peor | Sí |
| Tomar turnos | Polling, token passing | Casi R |
Bien | No |
Las redes reales mezclan estas ideas. Una red de cable (DOCSIS), por ejemplo, reparte el coaxial por frecuencias, usa ranuras de tiempo asignadas por el equipo del proveedor y permite pedir esas ranuras con acceso aleatorio.
¿Y hoy en Ethernet?
La Ethernet con un cable compartido ya no existe en la práctica. Hoy cada host tiene un cable propio hasta un switch, con un par de hilos o de fibras para cada dirección (full-duplex). Nadie comparte nada: no puede haber colisiones. CSMA/CD simplemente no se usa, aunque el formato de frame siga siendo el de 1980. Solo sobrevive como modo opcional para equipos que trabajan en half-duplex, y las velocidades de 10 Gb/s en adelante ya ni siquiera lo incluyen.
Idea clave. Un switch resolvió el acceso múltiple por eliminación: convirtió un medio compartido en muchos enlaces punto a punto. El problema sigue vivo en el aire (Wi-Fi, 5G), donde compartir el medio es inevitable.
Ethernet
Ethernet nació en 1973 en Xerox PARC, con Bob Metcalfe y David Boggs, y sigue dominando las redes cableadas. Pasó de 2,94 Mb/s a 800 Gb/s, de un cable coaxial compartido a fibra y a switches. Casi todo cambió, salvo una cosa: el formato del frame. Esa es la razón de que sobreviviera: cada velocidad nueva sigue hablando con las capas de arriba de la misma manera.
El formato del frame
bytes:   8          6        6        2        46 a 1500       4
      ┌──────────┬────────┬────────┬───────┬───────────────┬─────┐
      │preámbulo │destino │ origen │ Ether │     datos     │ FCS │
      │  y SFD   │  MAC   │  MAC   │ Type  │               │ CRC │
      └──────────┴────────┴────────┴───────┴───────────────┴─────┘
└───────── lo que se ve en una captura ──────┘- Preámbulo y SFD (8 bytes). Sincronizan al receptor. La tarjeta de red los quita.
- Dirección de destino y de origen (6 bytes cada una). Direcciones MAC.
- EtherType (2 bytes). Dice a qué protocolo de arriba entregar los datos:
0x0800IPv4,0x0806ARP,0x86DDIPv6. Es la multiplexación de la capa de enlace, igual que los puertos en el transporte. - Datos (46 a 1500 bytes). El datagrama. Los 1500 son la MTU clásica de Ethernet. Si hay menos de 46, se rellena con ceros hasta llegar a 46 (padding).
- FCS, frame check sequence (4 bytes). El CRC-32, calculado sobre las direcciones, el EtherType y los datos.
Sin contar el preámbulo, un frame mide entre 64 y 1518 bytes. Es el mínimo que venía de CSMA/CD.
El servicio que da Ethernet es sin conexión y no confiable. No hay handshake antes de enviar. El receptor no devuelve ningún ACK: si un frame llega dañado, lo descarta sin avisar. Si los datos eran de TCP, TCP notará el hueco y retransmitirá.
Tampoco hay un campo TTL: un frame que da vueltas en un ciclo no muere nunca. Eso nos va a dar un buen problema en un rato.
En la práctica. Con el formato podemos calcular lo que queda para los datos. Por cada frame de 1500 bytes de datos, en el cable hay 8 de preámbulo, 14 de direcciones y EtherType, 4 de FCS y 12 de silencio obligatorio entre frames: 1538 en total. En un enlace de 1 Gb/s, la tasa máxima de datos de IP es 1500/1538 × 1 Gb/s ≈ 975 Mb/s.
Las variantes de Ethernet tienen nombres como 1000BASE-T o 10GBASE-LR: la velocidad
(1000 Mb/s, 10 Gb/s), BASE por banda base y el medio (T par trenzado; LR, fibra
monomodo de largo alcance). Para las capas de arriba, todas son iguales.
Direcciones MAC
Una dirección MAC tiene 48 bits y se escribe en hexadecimal: 02:00:00:00:00:01.
Identifica una interfaz, no un equipo: una laptop con Wi-Fi y cable tiene dos.
Los fabricantes compran bloques: los primeros 24 bits (el OUI) identifican al fabricante, y los otros 24 los asigna él, de modo que en principio cada tarjeta sale de fábrica con una MAC única. Dos bits del primer byte tienen un significado especial:
- El bit menos significativo (I/G) indica una dirección de grupo. Si vale 1, el frame va
a varios receptores. La dirección de broadcast
ff:ff:ff:ff:ff:ff, todos unos, es un caso particular. - El siguiente bit (U/L) indica una dirección administrada localmente, si vale 1: alguien la puso a mano, y no viene de un fabricante.
En el laboratorio les dimos a los hosts direcciones como 02:00:00:00:00:01. Ese 02
tiene el bit U/L en 1 y el I/G en 0: es una dirección unicast administrada localmente.
Usamos direcciones fijas para que las salidas de estos apuntes coincidan con las suyas.
Una tarjeta de red normalmente acepta los frames dirigidos a su MAC, al broadcast y a
sus grupos, y descarta el resto sin molestar al sistema operativo. tcpdump la pone en
modo promiscuo para ver todo lo que llega.
MAC frente a IP
Si cada interfaz ya tiene una dirección, ¿para qué dos? Porque hacen trabajos distintos.
| Dirección MAC | Dirección IP | |
|---|---|---|
| Capa | Enlace | Red |
| Tamaño | 48 bits | 32 bits (IPv4), 128 (IPv6) |
| Estructura | Plana: el valor no dice dónde está | Jerárquica: el prefijo dice en qué red está |
| Alcance | Un enlace o una red local | Toda la Internet |
| Quién la asigna | El fabricante | El administrador de la red, o DHCP |
| Cambia al mudarse | No | Sí |
| Analogía | DNI: identifica, sin decir dónde vive | Dirección postal: dice cómo llegar |
La MAC es plana: 02:00:00:00:00:01 no da ninguna pista sobre su ubicación. Por eso
un switch tiene que aprender por dónde está cada una, con una entrada por cada MAC. Eso
funciona para miles de direcciones, pero no para los miles de millones de Internet. La
IP es jerárquica, así que un router puede resolver con una sola entrada a toda una
red.
Hay otra razón. Si solo existiera IP, una tarjeta de red tendría que interrumpir al sistema operativo por cada frame que pasa, solo para saber si es para ella. Y si solo existiera MAC, no podríamos cambiar de red sin cambiar de identidad, y la capa de red quedaría atada a una tecnología. Con dos niveles, IP funciona sobre cualquier enlace.
ARP
Ya tenemos el problema planteado. Un host quiere enviar un datagrama a 10.203.0.2, que
está en su misma subred. Para armar el frame necesita la MAC del destino, y solo sabe su
IP. ARP (Address Resolution Protocol, RFC 826) resuelve esa traducción: dada una IP
de la red local, ¿qué MAC le corresponde?
Cómo funciona
- El host A revisa su tabla ARP (una cache). Si tiene la IP, usa esa MAC y listo.
- Si no, envía una consulta: un frame a la dirección de broadcast con el mensaje
“¿quién tiene
10.203.0.2? Avísenle a10.203.0.1”. - Todos los nodos de la red local reciben la consulta. Solo el owner de esa IP responde.
- La respuesta va en unicast, directo a quien preguntó: “
10.203.0.2está en02:00:00:00:00:02”. - A guarda el dato en su tabla por un tiempo y envía el datagrama que tenía en espera.
¿Por qué se pregunta por broadcast y se responde por unicast? La pregunta se hace a gritos porque A no sabe a quién dirigirla: justo eso es lo que está averiguando. La respuesta no necesita gritar, porque la pregunta ya traía la MAC de A. Molestar a todos una segunda vez no serviría de nada.
ARP no necesita configuración: una tabla ARP se llena sola. Tampoco está exactamente en
una capa: sus mensajes van dentro de un frame de Ethernet, con EtherType 0x0806, pero
contienen direcciones IP. Se suele poner en la frontera entre red y enlace.
Error común. Creer que ARP pasa por routers o que funciona con cualquier IP. ARP solo llega hasta donde llega un broadcast, es decir, hasta el borde de la red local. Si un host necesita la MAC de una IP en otra subred, se equivoca de pregunta. Ya vamos a ver qué pregunta correcta hace.
Un intercambio real
Vamos a verlo. La topología del laboratorio tiene un switch sw1 y cuatro hosts, con
direcciones de 10.203.0.1 a 10.203.0.4.
   h1             h2              h3              h4
10.203.0.1     10.203.0.2      10.203.0.3      10.203.0.4
…:00:01        …:00:02         …:00:03         …:00:04
    \ eth1        | eth2          | eth3         / eth4
     \            |               |             /
      └───────────┴──────  sw1  ──┴────────────┘
                       (bridge br0)
Se levanta con make lan, dentro de code/week-03, y se entra a cada nodo con
docker exec. En adelante escribimos h1$ comando para abreviar
docker exec clab-w03-lan-h1 comando. Si el comando lleva tuberías, en la terminal hay
que envolverlo: docker exec clab-w03-lan-h1 sh -c '...'.
Al empezar, la tabla ARP de h1 está vacía en eth1, la interfaz de la red de datos.
Cada nodo tiene además eth0, la red de administración de Containerlab, que no es parte
del laboratorio.
h1$ ip -br addr show eth1
eth1@if3476      UP             10.203.0.1/24
h1$ ip neigh show dev eth1
Dejamos tcpdump escuchando en h1 y hacemos ping a h2. Los tcpdump con & se
dejan en otra terminal, o se lanzan con docker exec -d, y se detienen con Ctrl+C o con
pkill tcpdump. Al leer el archivo, la opción -e muestra las MAC y -t oculta la
hora, para que las líneas quepan.
h1$ tcpdump -U -n -i eth1 -w /tmp/arp.pcap "arp or icmp" &
h1$ ping -c 2 10.203.0.2
PING 10.203.0.2 (10.203.0.2): 56 data bytes
64 bytes from 10.203.0.2: seq=0 ttl=64 time=0.193 ms
64 bytes from 10.203.0.2: seq=1 ttl=64 time=0.186 ms

--- 10.203.0.2 ping statistics ---
2 packets transmitted, 2 packets received, 0% packet loss
round-trip min/avg/max = 0.186/0.189/0.193 ms
h1$ tcpdump -t -e -n -r /tmp/arp.pcap
02:00:00:00:00:01 > ff:ff:ff:ff:ff:ff, ethertype ARP (0x0806), length 42: Request who-has 10.203.0.2 tell 10.203.0.1, length 28
02:00:00:00:00:02 > 02:00:00:00:00:01, ethertype ARP (0x0806), length 42: Reply 10.203.0.2 is-at 02:00:00:00:00:02, length 28
02:00:00:00:00:01 > 02:00:00:00:00:02, ethertype IPv4 (0x0800), length 98: 10.203.0.1 > 10.203.0.2: ICMP echo request, id 83, seq 0, length 64
02:00:00:00:00:02 > 02:00:00:00:00:01, ethertype IPv4 (0x0800), length 98: 10.203.0.2 > 10.203.0.1: ICMP echo reply, id 83, seq 0, length 64
02:00:00:00:00:01 > 02:00:00:00:00:02, ethertype IPv4 (0x0800), length 98: 10.203.0.1 > 10.203.0.2: ICMP echo request, id 83, seq 1, length 64
02:00:00:00:00:02 > 02:00:00:00:00:01, ethertype IPv4 (0x0800), length 98: 10.203.0.2 > 10.203.0.1: ICMP echo reply, id 83, seq 1, length 64
El orden es exactamente lo que dijimos. Primero la consulta, a ff:ff:ff:ff:ff:ff.
Luego la respuesta, en unicast. Recién entonces sale el primer ping. El segundo ping ya
no necesita ARP. Y las dos tablas quedan llenas.
h1$ ip neigh show dev eth1
10.203.0.2 lladdr 02:00:00:00:00:02 REACHABLE
h2$ ip neigh show dev eth1
10.203.0.1 lladdr 02:00:00:00:00:01 DELAY
h2 nunca hizo una consulta y aun así ya conoce a h1. No fue magia: la consulta traía
la IP y la MAC de quien preguntaba, y el RFC 826 le permite aprovecharlas si va a
responder. Es un ahorro razonable, porque probablemente h2 tenga que contestarle
pronto.
Los estados son del kernel de Linux. REACHABLE significa que la entrada se confirmó
hace poco. Tras unos 30 s sin confirmación pasa a STALE, y la próxima vez que se use,
a DELAY y luego a PROBE, hasta comprobar que el vecino sigue ahí. h2 aparece en
DELAY porque la entrada salió de una consulta, sin confirmar, y ya la usó para
responder. Una tabla ARP no es permanente: si un equipo cambia de MAC, el resto se
entera pronto.
Los bytes de ARP
Veamos el mismo frame byte por byte.
h1$ tcpdump -t -e -n -xx -r /tmp/arp.pcap arp
02:00:00:00:00:01 > ff:ff:ff:ff:ff:ff, ethertype ARP (0x0806), length 42: Request who-has 10.203.0.2 tell 10.203.0.1, length 28
	0x0000:  ffff ffff ffff 0200 0000 0001 0806 0001
	0x0010:  0800 0604 0001 0200 0000 0001 0acb 0001
0x0020: 0000 0000 0000 0acb 0002| Bytes | Valor | Significado |
|---|---|---|
| 0–5 | ff:ff:ff:ff:ff:ff |
Destino del frame: broadcast |
| 6–11 | 02:00:00:00:00:01 |
Origen del frame: h1 |
| 12–13 | 0x0806 |
EtherType: ARP |
| 14–15 | 0x0001 |
Tipo de hardware: Ethernet |
| 16–17 | 0x0800 |
Tipo de protocolo: IPv4 |
| 18, 19 | 6, 4 |
Largo de una MAC y de una IPv4 |
| 20–21 | 0x0001 |
Operación: 1 consulta, 2 respuesta |
| 22–27 | 02:00:00:00:00:01 |
MAC de quien pregunta |
| 28–31 | 0a cb 00 01 |
IP de quien pregunta: 10.203.0.1 |
| 32–37 | 00:00:00:00:00:00 |
MAC buscada: todavía se desconoce |
| 38–41 | 0a cb 00 02 |
IP buscada: 10.203.0.2 |
ARP se diseñó para cualquier combinación de enlace y red. De ahí los campos de tipo y de largo, aunque hoy casi siempre valen lo mismo.
Error común. Ver
length 42y pensar que contradice el mínimo de 64 bytes. La captura no ve todo. El mínimo de 64 bytes incluye el relleno y los 4 bytes del FCS, y esos los pone la tarjeta de red. Aquí no hay tarjeta: entre dos interfaces veth, el kernel pasa el frame sin relleno y sin FCS. En un cable real, este frame saldría con 18 bytes de relleno y 4 de FCS: 42 + 18 + 4 = 64. Tampoco es raro vermtu 9500en las salidas: Containerlab pone esa MTU en sus enlaces. Los 1500 bytes son el valor de la Ethernet clásica.
ARP a mano, en C
El programa arp_probe.c hace a mano lo que el kernel
hace antes de enviar un paquete a un vecino. Abre un socket AF_PACKET, en el que lo
que se envía ya es un frame completo, y arma los 42 bytes campo por campo. Como dice la
guía de estilo, no se copia una struct a la red: cada campo se escribe en su posición
y con su orden de bytes.
memset(frame, 0xff, 6);                 /* destino: broadcast */
memcpy(frame + 6, my_mac, 6);           /* origen */
put_u16(frame + 12, ETHERTYPE_ARP);     /* EtherType */

uint8_t *arp = frame + ETH_HEADER_LEN;
put_u16(arp + 0, 1);                    /* tipo de hardware: Ethernet */
put_u16(arp + 2, ETHERTYPE_IP);         /* tipo de protocolo: IPv4 */
arp[4] = 6;                             /* largo de una dirección de hardware */
arp[5] = 4;                             /* largo de una dirección de protocolo */
put_u16(arp + 6, ARP_OP_REQUEST);
memcpy(arp + 8, my_mac, 6);             /* quién pregunta */
memcpy(arp + 14, my_ip, 4);
memset(arp + 18, 0, 6);                 /* MAC buscada: todavía no se conoce */
memcpy(arp + 24, target_ip, 4);
Se compila con enlace estático, porque corre dentro de los nodos, que no tienen las
bibliotecas del contenedor del curso, y queda montado en ellos como
/usr/local/bin/arp_probe.
h1$ arp_probe eth1 10.203.0.4
frame enviado (42 bytes):
ff ff ff ff ff ff 02 00 00 00 00 01 08 06
00 01 08 00 06 04 00 01 02 00 00 00 00 01
0a cb 00 01 00 00 00 00 00 00 0a cb 00 04
respuesta en 0.047 ms, la MAC del vecino es 02:00:00:00:00:04
frame recibido (42 bytes):
02 00 00 00 00 01 02 00 00 00 00 04 08 06
00 01 08 00 06 04 00 02 02 00 00 00 00 04
0a cb 00 04 02 00 00 00 00 01 0a cb 00 01
h1$ arp_probe eth1 10.203.0.99
frame enviado (42 bytes):
ff ff ff ff ff ff 02 00 00 00 00 01 08 06
00 01 08 00 06 04 00 01 02 00 00 00 00 01
0a cb 00 01 00 00 00 00 00 00 0a cb 00 63
sin respuesta en 1000 ms
Los bytes coinciden con los de la tabla. El tiempo depende de la máquina. Y fíjense en la línea final: si la IP no existe, nadie contesta y ARP no devuelve ningún error. El que pregunta solo sabe que nadie respondió. Un ping a esa IP mostraría el mismo silencio.
En la práctica. ARP no tiene autenticación. Cualquier nodo de la red local puede responder “esa IP soy yo” y quedarse con el tráfico de otro. Esa es la base del ataque de ARP spoofing, que retomaremos en la semana 15. Es una de las razones para separar redes con VLANs.
Hacia otra subred: se busca al gateway
Ahora, la pregunta importante. Un host con la IP 10.203.110.1/24 quiere enviar a
10.203.120.2, que está en otra subred. ¿De quién busca la MAC?
No de 10.203.120.2. Esa consulta nunca recibiría respuesta: el destino no está en esta
red, y los broadcasts no cruzan routers. El host decide así:
- Compara el destino con su propia subred, usando su máscara. No coincide.
- Mira su tabla de rutas. La ruta que corresponde tiene un gateway: el router de
salida, digamos
10.203.110.254. - Busca con ARP la MAC del gateway.
- Arma un frame con destino a la MAC del router y dentro pone un datagrama con destino a la IP final.
Lo veremos en una captura real al final, en la sección de VLANs. Allí, ip neigh de
h1 no muestra a 10.203.120.2: muestra solo a su gateway, aunque acaba de
intercambiar paquetes con 10.203.120.2.
Idea clave. La dirección IP dice a dónde va el paquete al final. La dirección MAC dice a qué vecino se lo paso ahora. Por eso la IP de destino se mantiene de extremo a extremo y la MAC de destino cambia en cada salto.
Switches
Con un solo cable compartido, todos oyen todo. Con un switch, cada host tiene su propio enlace, y el switch lleva cada frame solo por donde hace falta. Es la pieza central de una red local moderna.
Antes: hubs
Un hub era una caja con varios puertos que trabajaba en la capa física. Cada bit que entraba por un puerto salía por todos los demás. No entendía frames, no tenía tabla y no podía guardar nada. Eléctricamente, un hub era un cable compartido con más conectores: dos hosts que transmitían a la vez colisionaban. Hoy solo interesan como historia, porque ayudan a entender qué aportó un switch.
Qué hace un switch
Un switch recibe un frame completo, mira la MAC de destino y lo reenvía solo por el puerto que corresponde. Tiene una cola por puerto, de modo que varios frames pueden ir hacia un mismo destino sin colisionar: esperan. Hace forwarding (decidir por qué puerto sale) y filtering (decidir que un frame no sale por ninguno). Para eso usa su forwarding table (también llamada FDB, MAC table o tabla de conmutación). Cada entrada dice:
(dirección MAC, puerto, tiempo desde la última vez que se vio)¿Quién llena esa tabla? Nadie: el switch aprende solo, mirando las direcciones de
origen. Un frame que entra por el puerto 3 con origen X prueba que X está por el
puerto 3. Eso es todo el truco. El algoritmo completo es corto:
Cuando llega un frame por el puerto p, con origen S y destino D:

  aprender:  anotar que S está por el puerto p, con tiempo 0
  buscar D en la tabla:
    si D es broadcast o no está:  enviarlo por todos los puertos, menos p  (flooding)
    si D está por el puerto p:    descartarlo                              (filtering)
    si D está por otro puerto q:  enviarlo solo por q                      (forwarding)

  periódicamente: borrar las entradas que no se han visto hace mucho tiempo
Por esto un switch no necesita configuración: se conecta y funciona. Un host tampoco
necesita saber que existe. Es transparente: no cambia los frames y los hosts no se
dirigen a él. El borrado de entradas viejas permite que la red se adapte si un host se
muda a otro puerto. En un bridge de Linux, el tiempo es de 300 s: ageing_time 30000 en
la salida de ip -d link, en centésimas de segundo.
Aprendiendo en vivo
El bridge de Linux hace exactamente esto: es un switch por software. En la topología del
laboratorio, sw1 tiene br0, con los cuatro puertos dentro. Al inicio, su tabla no
tiene ninguna entrada aprendida. bridge fdb show también lista entradas permanent
(las MAC de sus propios puertos), y por eso las filtramos.
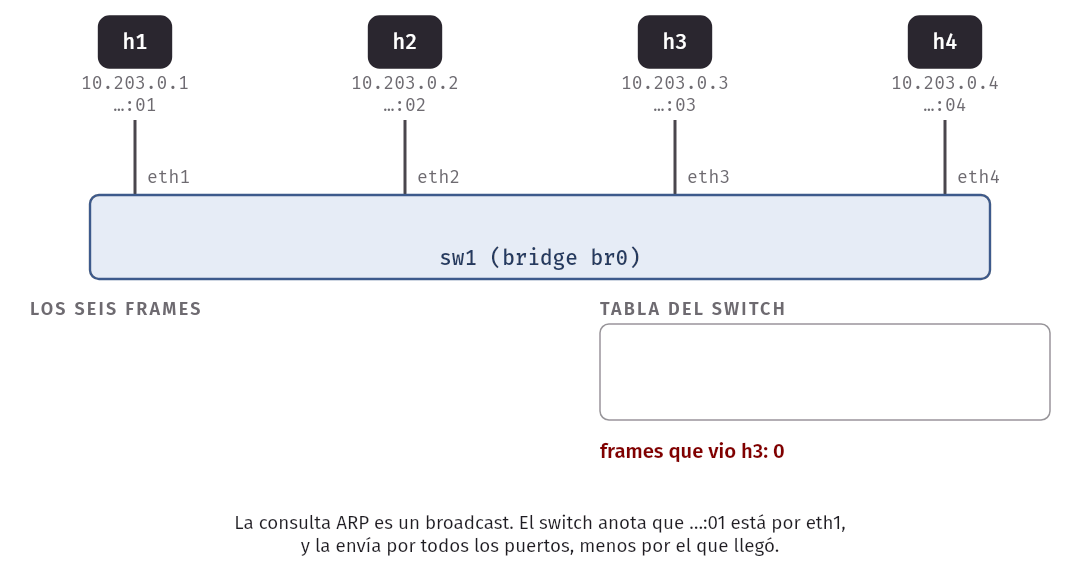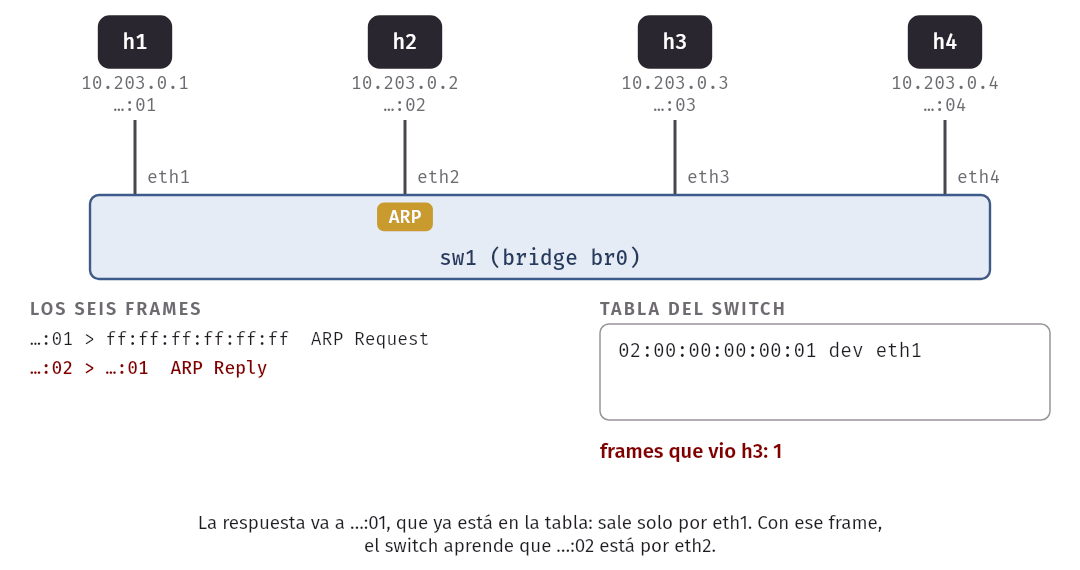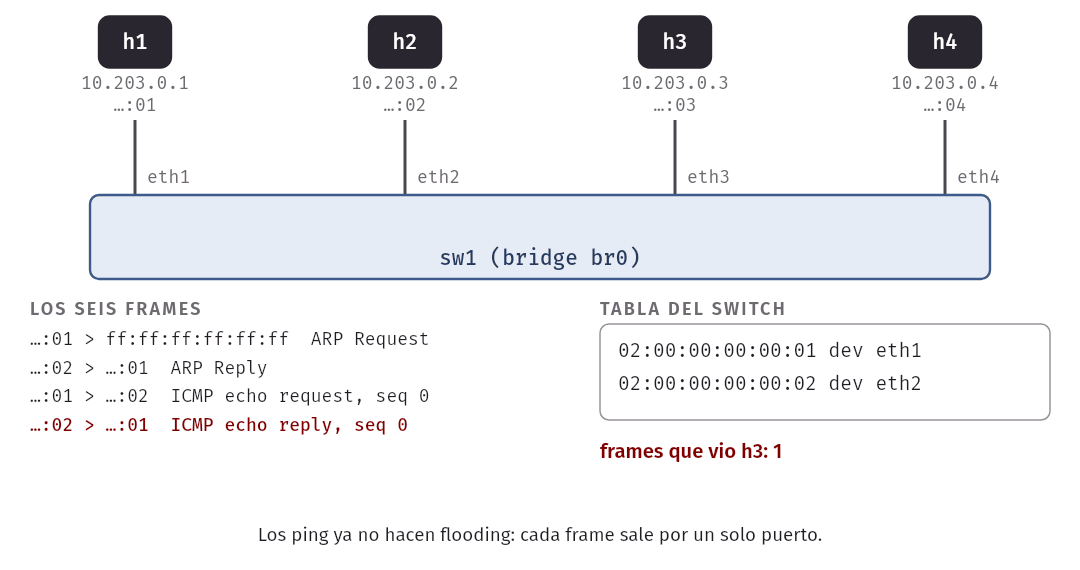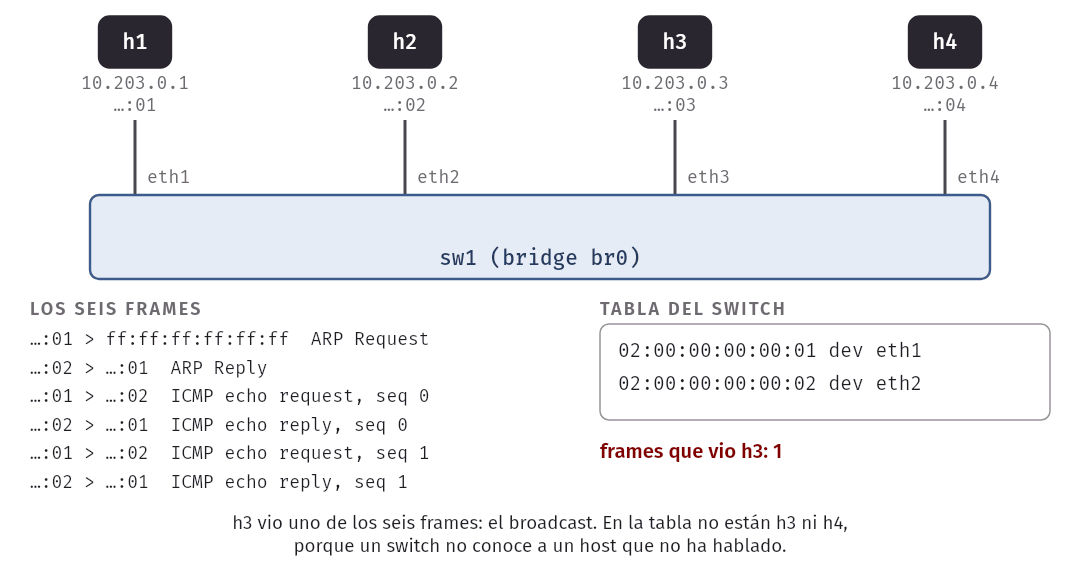
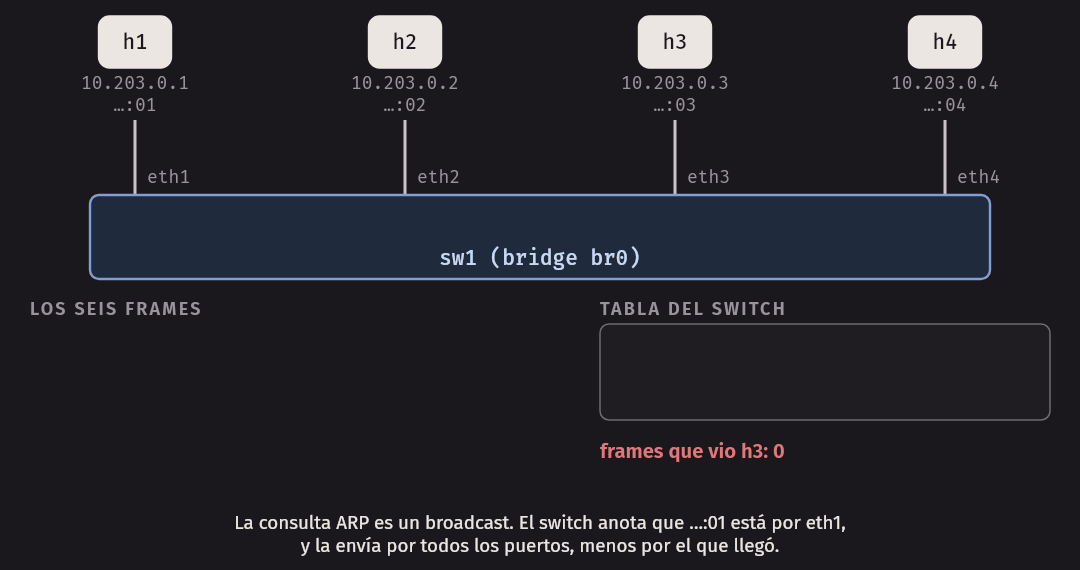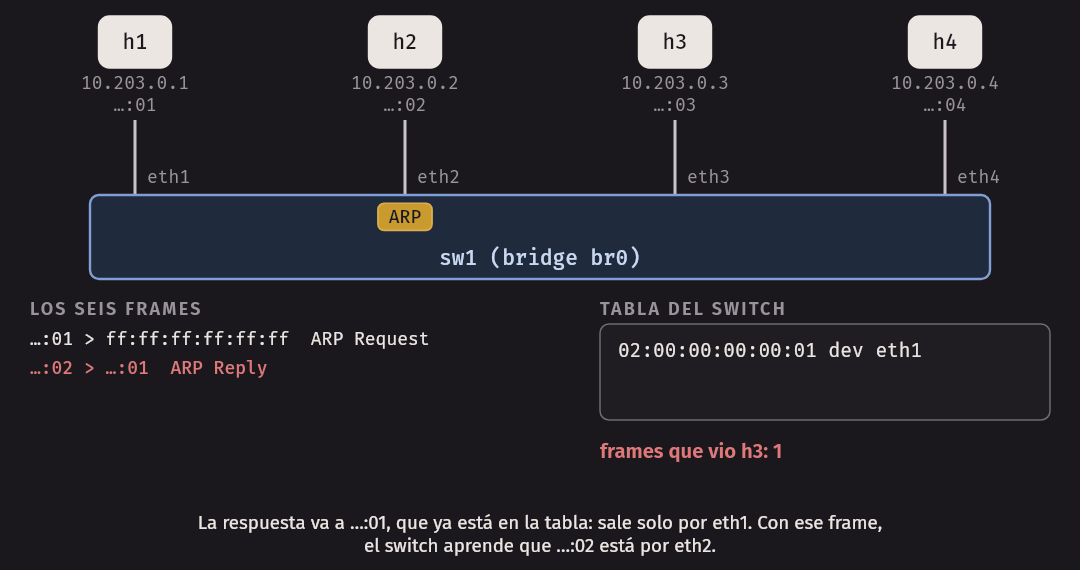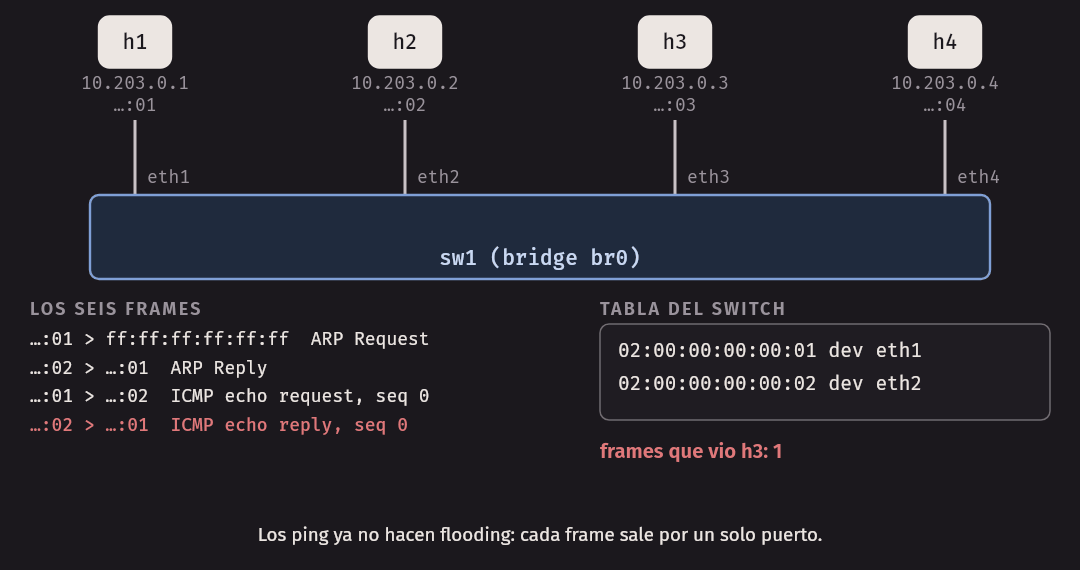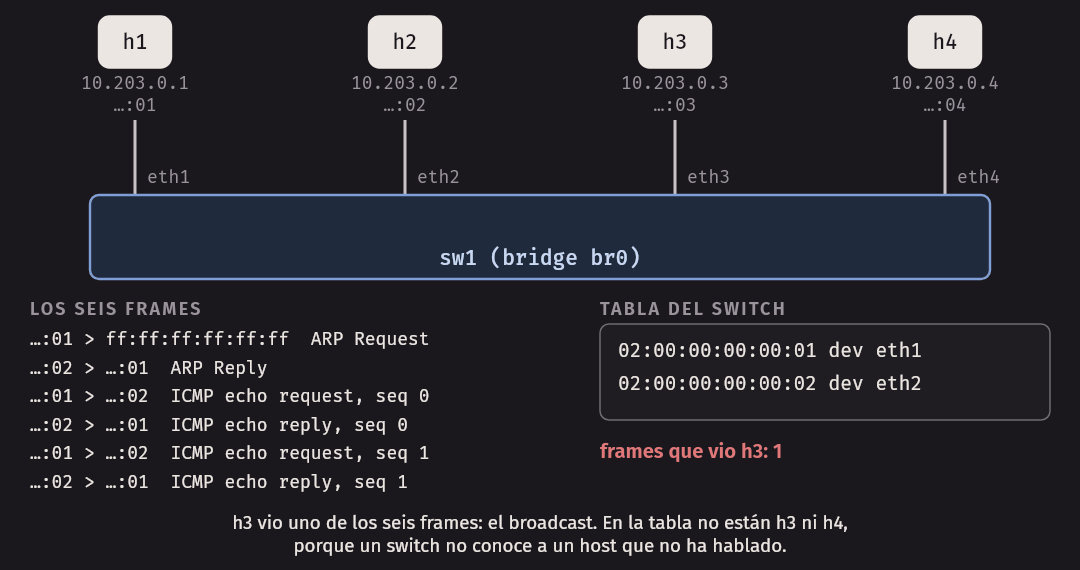
sw1$ bridge fdb show br br0 | grep -v permanentAntes de seguir, hagan una predicción. h1 hace ping a h2. La consulta ARP es un
broadcast, así que debe salir por todos los puertos. La respuesta, que va a h1, se
envía cuando el switch ya vio a h1, de modo que solo sale por eth1. ¿Qué debe ver
h3? Solo la consulta. Lo comprobamos dejando un tcpdump en h3 durante el mismo
ping de la sección anterior:
h3$ tcpdump -U -t -e -n -l -i eth1 "arp or icmp"
02:00:00:00:00:01 > ff:ff:ff:ff:ff:ff, ethertype ARP (0x0806), length 42: Request who-has 10.203.0.2 tell 10.203.0.1, length 28
Exactamente eso: una línea, de seis frames que hubo en total. Tampoco quedó registrado en su tabla ARP, porque el mensaje no era para él. Y la tabla del switch ya aprendió:
h3$ ip neigh show dev eth1
sw1$ bridge fdb show br br0 | grep -v permanent
02:00:00:00:00:01 dev eth1 master br0
02:00:00:00:00:02 dev eth2 master br0
h1 y h2 están ahí. h3 y h4 no, porque todavía no han transmitido nada. Un switch
no conoce a un host que no ha hablado.
Flooding de un destino desconocido
El flooding no es solo para broadcasts. Si un frame va en unicast a una MAC que no está
en la tabla, tampoco queda otra opción. Para verlo, vaciamos la tabla del switch, pero
no la tabla ARP de h1. Así, h1 enviará directamente en unicast a una MAC que el
switch ha olvidado.
sw1$ ip link set br0 type bridge fdb_flush
h3$ tcpdump -U -t -e -n -l -i eth1 icmp &
h1$ ping -c 3 10.203.0.2
3 packets transmitted, 3 packets received, 0% packet loss
round-trip min/avg/max = 0.040/0.051/0.070 ms
h3$ (salida de tcpdump)
02:00:00:00:00:01 > 02:00:00:00:00:02, ethertype IPv4 (0x0800), length 98: 10.203.0.1 > 10.203.0.2: ICMP echo request, id 119, seq 0, length 64
Entre h1 y h2 hubo seis frames, y h3 vio uno solo: el primer echo request, que iba
dirigido a la MAC de h2. Lo recibió porque el switch no sabía dónde estaba h2. La
respuesta de h2 le enseñó al switch su ubicación, y h3 no volvió a ver nada. Su
tarjeta habría descartado ese frame en un uso normal; lo vemos porque tcpdump la pone
en modo promiscuo.
Si no aprendiera: un hub
Un bridge de Linux con ageing_time 0 olvida cada dirección al instante y hace flooding
de todo. Es la forma más cercana a un hub que podemos tener aquí. (No es un hub de
verdad: guarda y reenvía frames y no tiene colisiones.)
sw1$ ip link set br0 type bridge ageing_time 0
h3$ tcpdump -U -t -e -n -l -i eth1 icmp &
h1$ ping -c 2 10.203.0.2
2 packets transmitted, 2 packets received, 0% packet loss
round-trip min/avg/max = 0.046/0.050/0.054 ms
h3$ (salida de tcpdump)
02:00:00:00:00:01 > 02:00:00:00:00:02, ethertype IPv4 (0x0800), length 98: 10.203.0.1 > 10.203.0.2: ICMP echo request, id 127, seq 0, length 64
02:00:00:00:00:02 > 02:00:00:00:00:01, ethertype IPv4 (0x0800), length 98: 10.203.0.2 > 10.203.0.1: ICMP echo reply, id 127, seq 0, length 64
02:00:00:00:00:01 > 02:00:00:00:00:02, ethertype IPv4 (0x0800), length 98: 10.203.0.1 > 10.203.0.2: ICMP echo request, id 127, seq 1, length 64
02:00:00:00:00:02 > 02:00:00:00:00:01, ethertype IPv4 (0x0800), length 98: 10.203.0.2 > 10.203.0.1: ICMP echo reply, id 127, seq 1, length 64
sw1$ ip link set br0 type bridge ageing_time 30000
Ahora h3 ve toda la conversación ajena. Con un switch normal, un host no ve el tráfico
unicast de los demás, y esto mejora tanto el rendimiento como, en cierta medida, la
privacidad.
Filtering: el destino está por donde llegó
¿Qué hace un switch si el destino está en el mismo puerto por donde llegó el frame? Lo
descarta: ese frame ya llegó, o va a llegar, sin ayuda. Esto se da cuando hay otro
switch de por medio. En la topología de dos switches de la sección de VLANs (antes de
configurar las VLANs), h1 y h2 están en sw1, y h3 y h4 en sw2. Si sw2 ya
aprendió que h2 está por su puerto hacia sw1, y sw1 por alguna razón hace flooding
de un frame para h2, entonces el frame llega a sw2 por el mismo puerto donde está
h2. Debe descartarlo, y h4 no debe ver nada. Si sw2 no conoce a h2, hace
flooding y h4 sí lo ve.
(sw2 ya conoce a h2 por eth3, y se vacía solo la tabla de sw1)
h1$ ping -c 1 -W 1 10.203.110.2 | tail -2
1 packets transmitted, 1 packets received, 0% packet loss
round-trip min/avg/max = 0.072/0.072/0.072 ms
h4$ wc -l < /tmp/f.txt
0

(se vacían las tablas de sw1 y de sw2)
h1$ ping -c 1 -W 1 10.203.110.2 | tail -2
1 packets transmitted, 1 packets received, 0% packet loss
round-trip min/avg/max = 0.073/0.073/0.073 ms
h4$ wc -l < /tmp/f.txt
1
h4$ cut -c1-100 /tmp/f.txt
06:40:15.181990 02:00:00:00:00:01 > 02:00:00:00:00:02, ethertype IPv4 (0x0800), length 98: 10.203.11
/tmp/f.txt guarda la salida de un tcpdump que h4 deja corriendo con el filtro
icmp. Llegó el frame solo cuando sw2 no conocía a h2.
La prueba test_2_same_port_destination_is_filtered de
test_campus.py repite este experimento. Para que los
dos estén en la misma subred, le agrega por un momento a h2 la dirección
10.203.110.2.
Dominios de colisión y de broadcast
Dos conceptos para ordenar lo anterior.
- Un dominio de colisión es el conjunto de nodos cuyas transmisiones pueden chocar entre sí. Un hub junta a todos en uno solo. Un switch full-duplex deja a cada enlace en el suyo, sin colisiones posibles.
- Un dominio de broadcast es el conjunto de nodos a los que llega un broadcast. Un switch no lo separa: hace flooding de los broadcasts. Un router sí lo separa, y una VLAN también.
| Equipo | Capa | Separa colisión | Separa broadcast | Configuración | Reenvía según |
|---|---|---|---|---|---|
| Hub | Física | No | No | Ninguna | Nada: repite bits |
| Switch | Enlace | Sí | No | Ninguna | MAC de destino |
| Router | Red | Sí | Sí | Direcciones y routing | IP de destino |
Switches frente a routers
Los dos son equipos de almacenar y reenviar, pero se ubican en capas distintas.
| Switch | Router | |
|---|---|---|
| Tabla | Aprendida sola, MAC por MAC | Rutas por prefijo, de un protocolo de routing |
| Escala | Miles de MAC: toda dirección es una entrada | Toda Internet, porque agrupa por prefijo |
| Topología | Solo un árbol, sin ciclos | Cualquiera, y usa caminos alternativos |
| Broadcast | Hace flooding | Lo corta |
| Modifica el frame | No | Sí: frame nuevo, y baja el TTL |
| Configurar | Casi nada | Bastante |
En la práctica. Un switch es la solución simple para una red de unos cientos de hosts. Una red muy grande no puede ser un solo dominio de broadcast: los broadcasts de ARP consumirían a todos, y la tabla crecería sin control. Por eso una red grande se divide en subredes unidas por routers. Y por eso existen equipos que hacen las dos cosas, que se llaman switches de capa 3.
Spanning tree
Ahora que sabemos cómo funciona un switch, conectemos varios. Por redundancia, tiene todo el sentido hacer un ciclo: si un cable se corta, queda otro camino. Pero el algoritmo de aprendizaje supone que no hay ciclos, y si los hay, el resultado es catastrófico.
El problema: la tormenta de broadcast
Un broadcast llega a un switch, que hace flooding por todos los demás puertos, y cada copia llega al siguiente switch, que hace lo mismo. En un ciclo, las copias vuelven a su origen y siguen dando vueltas. Y Ethernet no tiene TTL: ningún frame muere por sí solo. Si el ciclo está bien conectado, además, se multiplican. Es una tormenta de broadcast.
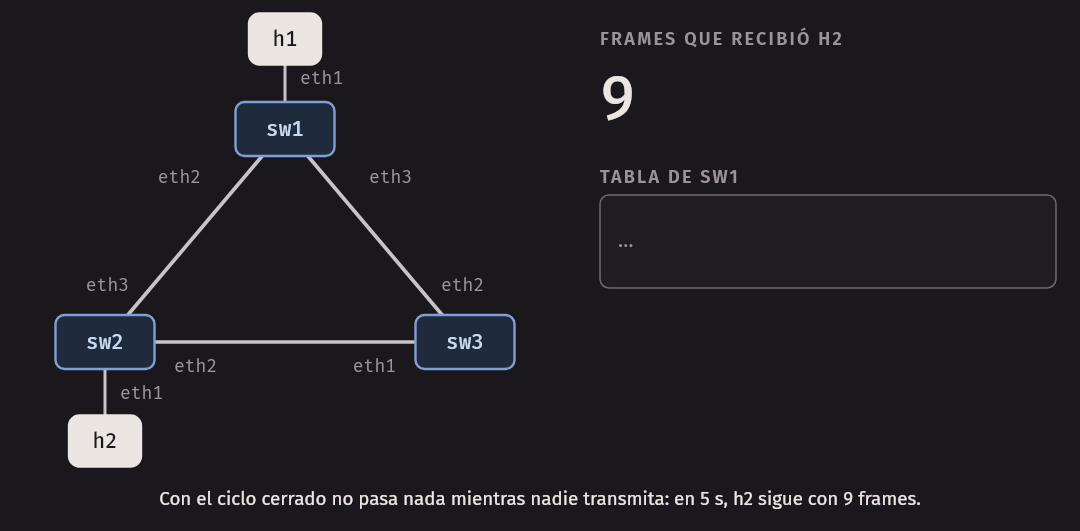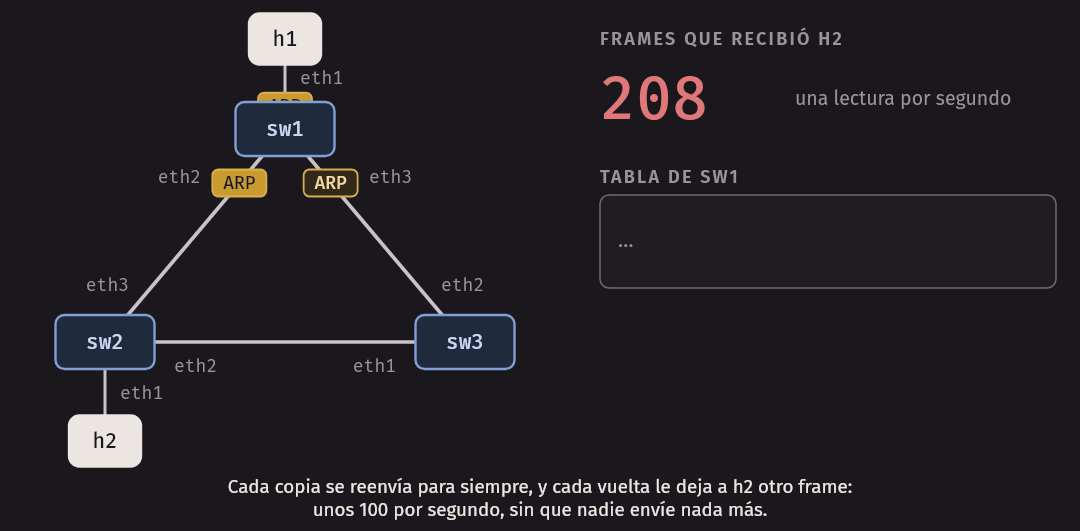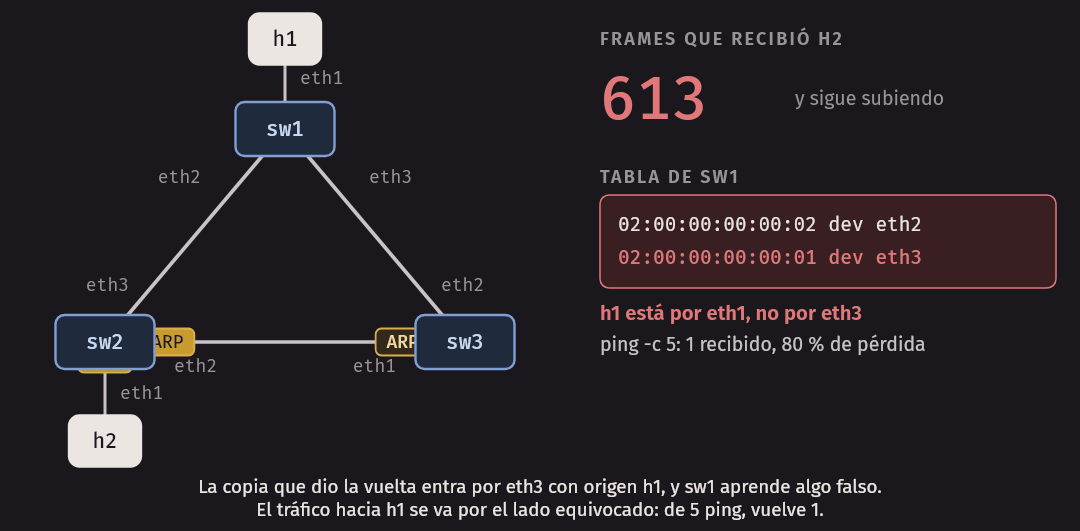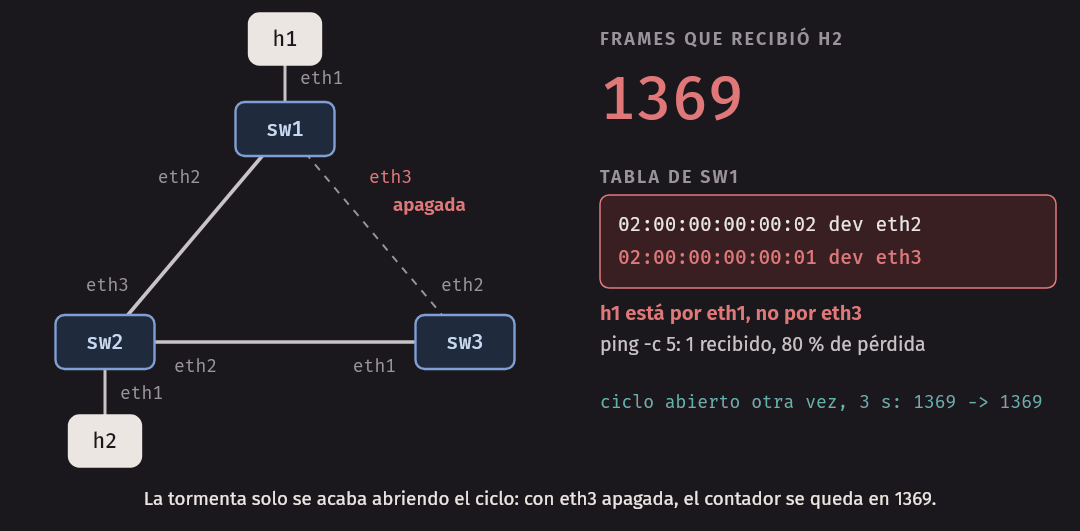
Tenemos una topología para verlo: tres switches en triángulo, con h1 en sw1 y h2
en sw2. Al levantarse, el ciclo está abierto (eth3 de sw1 está apagada).
                 h1
                  │ eth1
                 sw1
           eth2 /   \ eth3 (apagada al inicio)
               /     \
         eth3 /       \ eth2
            sw2 ───── sw3
             │  eth2 eth1
        eth1 │
             h2
Le agregamos un retardo de 5 ms a cada enlace entre switches. Es una decisión de
seguridad para sus laptops. En una primera prueba, con retardo en un solo sentido de
cada enlace, un solo switch usó más de la mitad de un procesador y h2 recibió más de
un millón de frames por segundo. Con 5 ms en los dos sentidos circulan pocos cientos por
segundo, y las cifras que siguen dependen de eso y de su máquina: en un enlace real, una
tormenta llega hasta saturarlo.
Se levanta con make loop. Esperen unos 10 segundos, para que pasen los mensajes que
aparecen al iniciar. Vamos a contar los frames que recibe h2 en
/sys/class/net/eth1/statistics/rx_packets. Con el ciclo abierto, todo está tranquilo,
y al cerrar el ciclo tampoco pasa nada todavía: nadie ha enviado un broadcast.
h1$ ping -c 2 -W 1 10.203.0.2
2 packets transmitted, 2 packets received, 0% packet loss
round-trip min/avg/max = 12.720/20.054/27.388 ms

ciclo abierto, 5 s sin tráfico: 8 -> 9
sw1$ ip link set eth3 up
ciclo cerrado, 5 s sin tráfico: 9 -> 9
Un ciclo no hace daño mientras nadie transmita. Ahora vaciamos las tablas ARP de h1 y
h2, y h1 hace un solo ping, que provoca una sola consulta ARP.
h1$ ping -c 1 -W 1 10.203.0.2
1 packets transmitted, 0 packets received, 100% packet loss
rx de h2 = 208
rx de h2 = 308
rx de h2 = 411
rx de h2 = 509
rx de h2 = 613
Los contadores se tomaron a intervalos de un segundo, sin que nadie enviara nada más. La
tasa no baja: unos 100 frames por segundo, para siempre. El ping falló, y conviene
preguntarse por qué, si la red está llena de copias. Veamos qué recibe h2:
h2$ tcpdump -U -t -e -n -l -i eth1
02:00:00:00:00:01 > ff:ff:ff:ff:ff:ff, ethertype ARP (0x0806), length 42: Request who-has 10.203.0.2
02:00:00:00:00:02 > 02:00:00:00:00:01, ethertype ARP (0x0806), length 42: Reply 10.203.0.2 is-at 02:
02:00:00:00:00:01 > ff:ff:ff:ff:ff:ff, ethertype ARP (0x0806), length 42: Request who-has 10.203.0.2
02:00:00:00:00:02 > 02:00:00:00:00:01, ethertype ARP (0x0806), length 42: Reply 10.203.0.2 is-at 02:
02:00:00:00:00:01 > 02:00:00:00:00:02, ethertype IPv4 (0x0800), length 98: 10.203.0.1 > 10.203.0.2:
02:00:00:00:00:02 > 02:00:00:00:00:01, ethertype IPv4 (0x0800), length 98: 10.203.0.2 > 10.203.0.1:
02:00:00:00:00:01 > ff:ff:ff:ff:ff:ff, ethertype ARP (0x0806), length 42: Request who-has 10.203.0.2
(Cortamos las líneas a 100 columnas.) Son la misma consulta una y otra vez, con su
respuesta. Y el problema es peor que el flooding. Miren la tabla de sw1:
sw1$ bridge fdb show br br0 | grep 02:00
02:00:00:00:00:02 dev eth2 master br0
02:00:00:00:00:01 dev eth3 master br0
h1 está conectado a eth1 de sw1, pero sw1 cree que está por eth3. La copia que
dio la vuelta llegó por eth3 con origen h1, y el switch aprendió, de buena fe, algo
falso. Las tablas quedan envenenadas: el tráfico unicast hacia h1 se va por el
lado equivocado, y por eso casi ningún ping vuelve:
h1$ ping -c 5 -W 1 10.203.0.2
5 packets transmitted, 1 packets received, 80% packet loss
round-trip min/avg/max = 10.487/10.487/10.487 ms
La tormenta no para por sí sola. Solo se acaba si se abre el ciclo:
sw1$ ip link set eth3 down
ciclo abierto otra vez, 3 s: 1369 -> 1369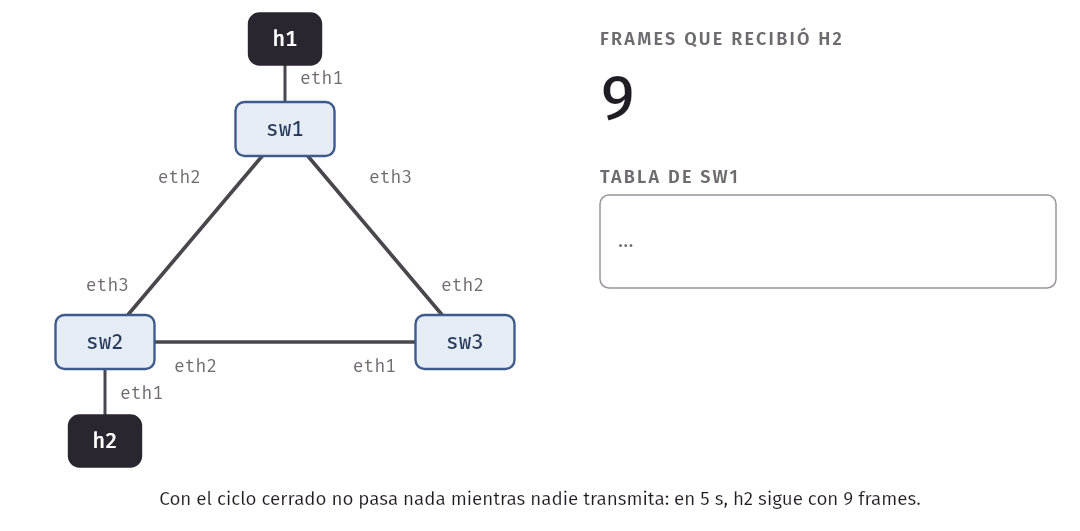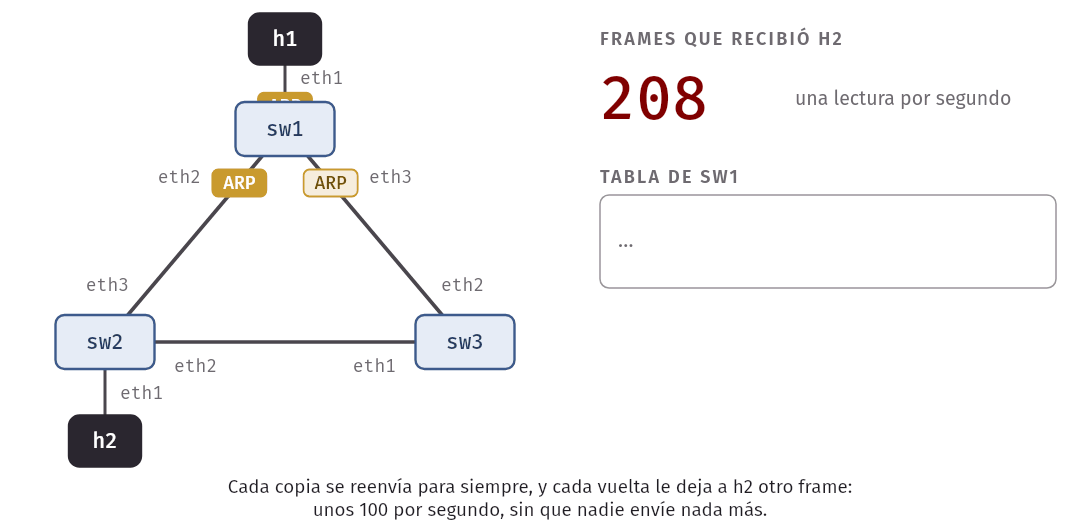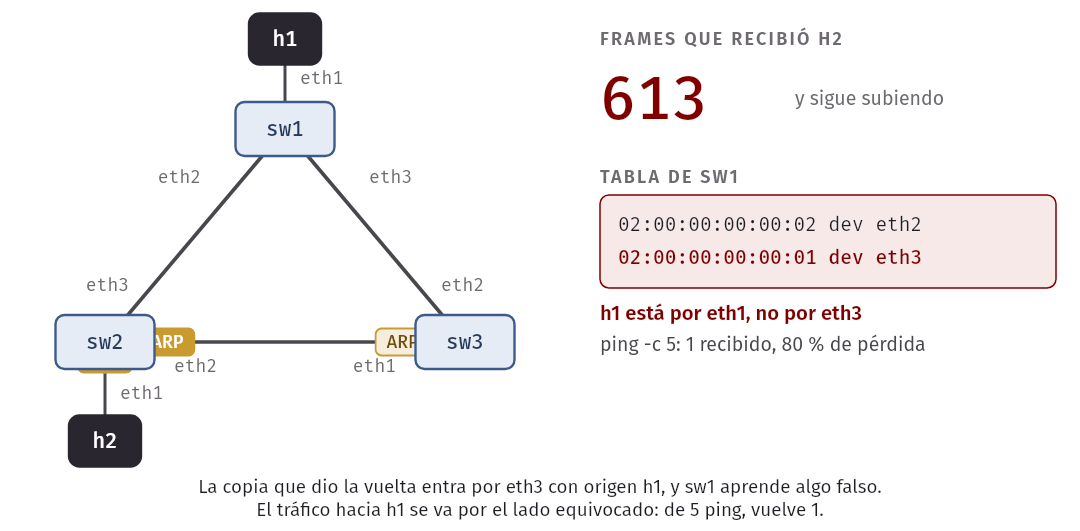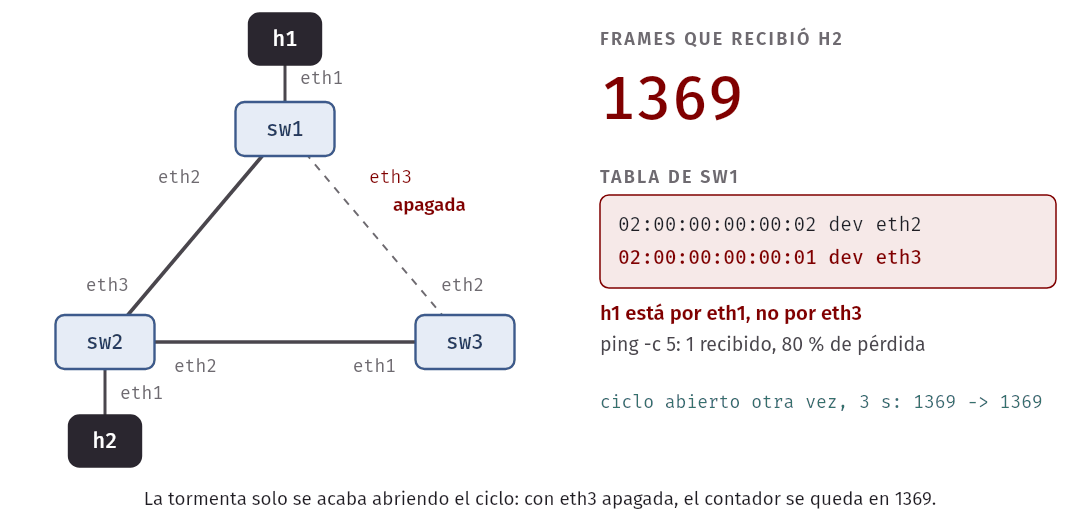
Error común. Pensar que más enlaces entre switches siempre dan más confiabilidad. Sin spanning tree, un cable de más puede tumbar una red: basta que alguien conecte dos puertos de un switch con un mismo cable. Es una de las fallas clásicas en una oficina.
La solución: desactivar enlaces, sin quitarlos
Si el algoritmo necesita un árbol, démosle un árbol. El Spanning Tree Protocol (STP, IEEE 802.1D), diseñado por Radia Perlman en 1985, hace que los switches apaguen por sí solos los puertos justos para que no queden ciclos, conservando la conexión entre todos. Si un enlace falla, reactivan alguno. Los puertos apagados son el repuesto.
Los switches se envían mensajes llamados BPDU (bridge protocol data units), en frames a una dirección multicast especial. Con ellos, de forma distribuida, hacen tres cosas:
- Eligen una raíz. Cada switch tiene un identificador: una prioridad configurable seguida de su MAC. Gana el menor, con la prioridad como criterio principal.
- Cada switch que no es raíz elige su puerto raíz: el de menor costo total hacia la raíz. Un empate se resuelve a favor del vecino con menor identificador.
- Cada enlace elige un puerto designado: el del extremo más cercano a la raíz. Un empate también lo resuelve el menor identificador.
Todo puerto que no sea raíz ni designado se bloquea: no reenvía tráfico ni aprende, aunque sigue escuchando BPDU.
Apliquemos el algoritmo a nuestro triángulo antes de ejecutarlo. Pusimos prioridades
fijas: 4096 para sw1, 8192 para sw2 y 12288 para sw3.
- Raíz:
sw1, la de menor prioridad. - Puertos raíz:
sw2:eth3ysw3:eth2, los directos asw1(costo 2 cada uno, contra 4 por el otro lado). - Enlaces con
sw1: sus dos puertos son designados, porque es la raíz. - Enlace
sw2–sw3: los dos extremos están a costo 2. Empate, y gana el menor identificador:sw2. Por tantosw2:eth2es designado, ysw3:eth1se bloquea.
Activamos STP en los tres, volvemos a cerrar el ciclo y le damos unos segundos para
converger. Cada identificador aparece en hexadecimal: 1000 es 4096, 2000 es 8192 y
3000 es 12288.
sw1$ ip link set br0 type bridge stp_state 1      (también en sw2 y sw3)
sw1$ ip link set eth3 up

sw1$ bridge link
3585: eth2@if3584:  mtu 9500 master br0 state forwardin
3582: eth3@if3583:  mtu 9500 master br0 state forwardin
3586: eth1@if3587:  mtu 9500 master br0 state forwardin
bridge_id 1000.AA:C1:AB:5D:BD:C7 designated_root 1000.AA:C1:AB:5D:BD:C7 root_port 0 root_path_cost 0

sw2$ bridge link
3584: eth3@if3585:  mtu 9500 master br0 state forwardin
3580: eth2@if3581:  mtu 9500 master br0 state forwardin
3588: eth1@if3589:  mtu 9500 master br0 state forwardin
bridge_id 2000.AA:C1:AB:0F:A2:F9 designated_root 1000.AA:C1:AB:5D:BD:C7 root_port 3 root_path_cost 2

sw3$ bridge link
3581: eth1@if3580:  mtu 9500 master br0 state blocking
3583: eth2@if3582:  mtu 9500 master br0 state forwardin
bridge_id 3000.AA:C1:AB:A1:D1:2D designated_root 1000.AA:C1:AB:5D:BD:C7 root_port 2 root_path_cost 2
(Las líneas están cortadas a 55 columnas, y la última de cada bloque viene de
ip -d link show br0.) Las MAC cambian en cada despliegue, porque son las que
Containerlab asigna al azar a los puertos de los switches. Lo que predijimos sale tal
cual: sw3:eth1 está en blocking, y los tres coinciden en quién es la raíz. Un ping
ya no provoca una tormenta: h2 recibe solo un puñado de frames.
h1$ ping -c 2 -W 1 10.203.0.2
2 packets transmitted, 2 packets received, 0% packet loss
round-trip min/avg/max = 13.940/21.060/28.181 ms
con stp: 1373 -> 1377
Los BPDU se pueden ver. La raíz los envía cada hello-time (2 s) y cada switch los
retransmite hacia abajo:
sw3$ tcpdump -t -n -l -v -c 1 -i eth2 stp
STP 802.1d, Config, Flags [Topology change], bridge-id 1000.aa:c1:ab:5d:bd:c7.8003, length 35
	message-age 0.00s, max-age 20.00s, hello-time 2.00s, forwarding-delay 2.00s
	root-id 1000.aa:c1:ab:5d:bd:c7, root-pathcost 0
Cuando un enlace falla
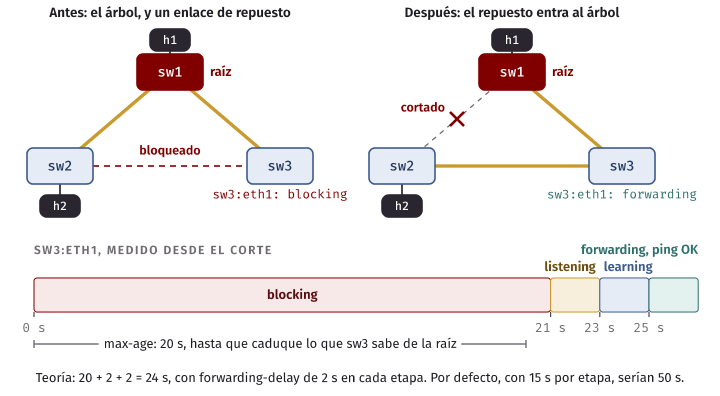
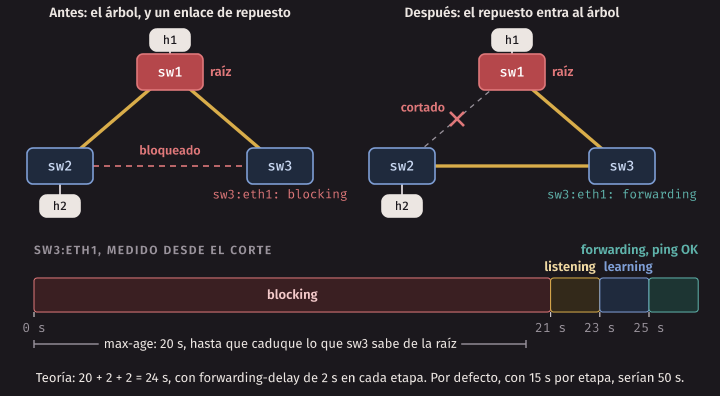
Cortemos el enlace sw1–sw2. Eso deja a h2 aislado, salvo por el enlace
sw2–sw3, que está bloqueado. Medimos cuánto tarda en volver.
sw1$ ip link set eth2 down
t=0 s  sw3:eth1 state blocking
t=21 s  sw3:eth1 state listening
t=23 s  sw3:eth1 state learning
t=25 s  sw3:eth1 state forwarding
t=25 s  ping OK
Casi medio minuto sin red, y tiene una explicación exacta. El STP clásico es lento a propósito, y sus temporizadores aparecen en el BPDU de arriba:
- max-age (20 s).
sw3guarda la información de la raíz por su puerto bloqueado y la considera válida hasta que caduque.sw2le avisa enseguida que perdió su camino, perosw3ignora esos BPDU por ser peores que lo que ya tiene. Espera los 20 s. - forwarding-delay (2 s aquí, 15 s por defecto). Antes de reenviar, un puerto pasa por listening, sin aprender ni reenviar, y luego por learning, aprendiendo sin reenviar. Cada etapa dura este tiempo. Su función es dar tiempo a que todos los switches se enteren: si un puerto empezara a reenviar de inmediato, se podría formar un ciclo durante la transición.
Total: 20 + 2 + 2 = 24 s, con el margen de nuestro segundero. Con los valores por defecto, que usan 15 s por etapa, serían 50 s. La medición depende de cuándo vence cada temporizador, pero no de la velocidad de la máquina.
En la práctica. Un corte de 30 a 50 s era inaceptable, y por eso se creó RSTP (802.1w), que negocia con sus vecinos y converge normalmente en segundos, o en menos. El bridge de Linux dentro del kernel, que es lo que usamos, solo tiene el STP clásico; RSTP en Linux requiere un programa aparte. En un data center moderno ni siquiera se usa uno ni otro: se prefiere routing de capa 3 con varios caminos activos a la vez, como veremos en la semana 14. STP desperdicia los enlaces que bloquea.
Idea clave. STP no quita el ciclo del cable: quita el ciclo del tráfico. Todo reenvío entre switches sigue un árbol y los enlaces restantes quedan de repuesto. Esto contrasta con un router, que tiene TTL y puede usar cualquier topología.
VLANs
Tenemos un switch con cuatro hosts. Imaginen que en una empresa pertenecen a dos áreas, y sus datos no deberían mezclarse. Los broadcasts de una no tienen por qué molestar a la otra. Podríamos comprar dos switches, pero las áreas cambian, y entonces habría que mover cables. Además, si en cada piso hay gente de las dos áreas, harían falta dos cables entre pisos.
Una VLAN (virtual LAN) es una red lógica separada dentro de una misma red física. El switch trata cada VLAN como si fuera un switch aparte: un frame que entra por un puerto de una VLAN solo sale por puertos de esa misma VLAN. Cada VLAN es su propio dominio de broadcast.
Puertos access y trunk
Un puerto de un switch con VLANs puede ser de dos tipos.
- Access. Pertenece a una sola VLAN y se conecta a un host. El host no sabe nada de VLANs: sus frames salen y llegan como siempre, sin ninguna marca. El switch recuerda a qué VLAN pertenece el puerto.
- Trunk. Lleva varias VLANs por un solo enlace, y conecta switches entre sí o un switch con un router. Aquí hay que indicar a qué VLAN pertenece cada frame.
Para ello existe la etiqueta 802.1Q. Es un campo de 4 bytes que se inserta en el frame después de las direcciones.
frame sin etiqueta:
┌─────────┬────────┬───────────┬───────────┬─────┐
│ destino │ origen │ EtherType │   datos   │ FCS │
└─────────┴────────┴───────────┴───────────┴─────┘

frame con etiqueta:
┌─────────┬────────┬────────┬─────┬───────────┬───────────┬─────┐
│ destino │ origen │ 0x8100 │ TCI │ EtherType │   datos   │ FCS │
└─────────┴────────┴────────┴─────┴───────────┴───────────┴─────┘
                    2 bytes  2 bytes

TCI (16 bits):   PCP (3 bits)  │  DEI (1 bit)  │  VID (12 bits)
prioridad descartable número de VLAN0x8100ocupa el lugar donde iría el EtherType. Así, un equipo que no entiende VLANs ve un protocolo que no conoce y deja el resto en paz.- VID es el número de VLAN. Con 12 bits hay 4096 valores. El 0 y el 4095 están reservados, y quedan 4094 VLANs.
- PCP es una prioridad de calidad de servicio y DEI marca si el frame se puede descartar primero.
Como el frame cambió, el FCS se recalcula al poner o al quitar la etiqueta. El tamaño máximo sube de 1518 a 1522 bytes.
Un switch trabaja así. Un frame que entra por un puerto access recibe por dentro la VLAN de ese puerto. Si sale por un puerto access de la misma VLAN, sale sin marca. Si sale por un trunk, se le pone la etiqueta. Al entrar por un trunk se lee la etiqueta. Y la forwarding table es por pareja (VLAN, MAC): el aprendizaje de cada VLAN es independiente.
Configurar VLANs en un bridge de Linux
Volvemos a la topología de un switch, con h1 y h2 en la VLAN 110, y h3 y h4 en
la 120. Los cuatro siguen en la misma subred 10.203.0.0/24: es a propósito, para ver
qué hace la VLAN por sí sola. El script es
vlan/lan_sw1.sh:
ip link set br0 type bridge vlan_filtering 1

for port in eth1 eth2; do
  bridge vlan add dev $port vid 110 pvid untagged
  bridge vlan del dev $port vid 1
done

for port in eth3 eth4; do
  bridge vlan add dev $port vid 120 pvid untagged
  bridge vlan del dev $port vid 1
done
vlan_filtering 1activa las VLANs. Sin esto, el bridge las ignora.vid 110permite la VLAN 110 en el puerto.pvid(port VLAN ID) indica que un frame sin etiqueta que entra por este puerto pertenece a esa VLAN.untaggedindica que al salir por este puerto se le quita la etiqueta.
Un puerto con pvid untagged es, en resumen, un puerto access. Se borra la VLAN 1
porque Linux la pone en todo puerto por defecto. Se aplica sin copiar el archivo dentro
del nodo, desde code/week-03:
$ docker exec -i clab-w03-lan-sw1 sh -e < vlan/lan_sw1.sh
sw1$ bridge vlan show
port              vlan-id
eth1              110 PVID Egress Untagged
eth2              110 PVID Egress Untagged
eth3              120 PVID Egress Untagged
eth4              120 PVID Egress Untagged
br0               1 PVID Egress Untagged
La fila de br0 se refiere al puerto interno del propio bridge, que no usamos: el
switch no tiene IP.
Vaciamos las tablas, y ya podemos probar. Dentro de cada VLAN, todo funciona. Entre VLANs, no:
h1$ ping -c 2 -W 1 10.203.0.2 | tail -2
2 packets transmitted, 2 packets received, 0% packet loss
round-trip min/avg/max = 0.082/0.148/0.214 ms
h1$ ping -c 2 -W 1 10.203.0.3 | tail -2
--- 10.203.0.3 ping statistics ---
2 packets transmitted, 0 packets received, 100% packet loss
h3$ ping -c 2 -W 1 10.203.0.4 | tail -2
2 packets transmitted, 2 packets received, 0% packet loss
round-trip min/avg/max = 0.119/0.158/0.197 ms
h1$ ip neigh show dev eth1
10.203.0.2 lladdr 02:00:00:00:00:02 REACHABLE
10.203.0.3 FAILED
sw1$ bridge fdb show br br0 | grep -v permanent
02:00:00:00:00:01 dev eth1 vlan 110 master br0
02:00:00:00:00:02 dev eth2 vlan 110 master br0
02:00:00:00:00:03 dev eth3 vlan 120 master br0
02:00:00:00:00:04 dev eth4 vlan 120 master br0
h1 y h3 están en la misma subred IP y en el mismo switch físico, y no pueden hablar.
La consulta ARP de h1 no llega a h3, porque es un broadcast de la VLAN 110 y solo
sale por sus puertos: el estado queda en FAILED. Cada entrada de la tabla del switch
ahora tiene una VLAN.
Esto también limita lo que un equipo le puede hacer a otro. Desde otra VLAN no se ven los broadcasts ni se puede responder un ARP falso. Por eso las VLANs se usan también para separar cámaras o impresoras del resto de la red. Pero no son un firewall: en cuanto se conectan con un router, pasa todo lo que el router deje pasar.
Pasar de una VLAN a otra: hace falta un router
Error común. Creer que una VLAN, por sí sola, da comunicación entre redes. Una VLAN hace exactamente lo contrario: separa. Dos VLANs son dos redes distintas, tan separadas como si estuvieran en switches sin conexión. Para que un paquete pase de una a otra, hace falta un router, y cada VLAN necesita su propia subred IP.
Si un router tuviera una interfaz física por VLAN, necesitaríamos muchos cables. Una forma ingeniosa de ahorrarlos es usar un solo cable en modo trunk hasta el router, y crear en él una subinterfaz por VLAN. A cada subinterfaz se le asigna una IP, que es el gateway de esa VLAN. Esto se conoce como router-on-a-stick.
Para este paso usamos otra topología (make campus): dos switches, un trunk entre ellos
y un router colgado de sw2. Hay una VLAN que se reparte entre los dos switches, para
que el trunk tenga un trabajo real.
                                     r1  eth1.110 10.203.110.254
                                     │   eth1.120 10.203.120.254
                                     │ eth1
                                     │ trunk (110 y 120)
                                     │ eth4
  h1 ──eth1── sw1 ──eth3══════eth3── sw2 ──eth1── h3
  h2 ──eth2──┘       trunk (110 y 120)  └──eth2── h4

  h1  10.203.110.1   VLAN 110          h3  10.203.110.3   VLAN 110
  h2  10.203.120.2   VLAN 120          h4  10.203.120.4   VLAN 120
Cada host ya tiene su dirección y su gateway:
h1$ ip route
default via 10.203.110.254 dev eth1
10.203.110.0/24 dev eth1 proto kernel scope link src 10.203.110.1
172.90.3.64/26 dev eth0 proto kernel scope link src 172.90.3.72
Antes de configurar nada, no hay router todavía: la consulta ARP por el gateway se queda sin respuesta.
h1$ ping -c 1 -W 1 10.203.120.2 | tail -2
--- 10.203.120.2 ping statistics ---
1 packets transmitted, 0 packets received, 100% packet loss
h1$ ip neigh show dev eth1
10.203.110.254 INCOMPLETE
Un trunk es un puerto en el que se permiten varias VLANs, sin pvid ni untagged.
Sus frames salen con etiqueta. Si por ese puerto entra un frame sin etiqueta, se
descarta, porque ya no tiene VLAN por defecto. La configuración de sw2 es
vlan/campus_sw2.sh:
ip link set br0 type bridge vlan_filtering 1

bridge vlan add dev eth1 vid 110 pvid untagged
bridge vlan del dev eth1 vid 1
bridge vlan add dev eth2 vid 120 pvid untagged
bridge vlan del dev eth2 vid 1

for port in eth3 eth4; do
  bridge vlan add dev $port vid 110
  bridge vlan add dev $port vid 120
  bridge vlan del dev $port vid 1
done
Y en el router, vlan/campus_r1.sh crea una
subinterfaz por VLAN sobre el trunk. El nombre eth1.110 es solo una convención; lo que
manda es type vlan id 110.
ip link add link eth1 name eth1.110 type vlan id 110
ip link add link eth1 name eth1.120 type vlan id 120
ip addr add 10.203.110.254/24 dev eth1.110
ip addr add 10.203.120.254/24 dev eth1.120
ip link set eth1.110 up
ip link set eth1.120 up
Lo que envía eth1.110 sale por eth1 con la etiqueta 110. Lo que llega a eth1 con
la etiqueta 110 aparece en eth1.110 sin ella. Para el resto del router, son dos
interfaces comunes. Aplicamos los scripts:
$ docker exec -i clab-w03-campus-sw1 sh -e < vlan/campus_sw1.sh
$ docker exec -i clab-w03-campus-sw2 sh -e < vlan/campus_sw2.sh
$ docker exec -i clab-w03-campus-r1  sh -e < vlan/campus_r1.sh
sw2$ bridge vlan show
port              vlan-id
eth1              110 PVID Egress Untagged
eth2              120 PVID Egress Untagged
eth3              110
                  120
eth4              110
                  120
br0               1 PVID Egress Untagged
r1$ ip -br addr show | grep eth1
eth1.110@eth1    UP             10.203.110.254/24
eth1.120@eth1    UP             10.203.120.254/24
eth1@if3549      UP
r1$ vtysh -c 'show ip route connected' | tail -4
IPv4 unicast VRF default:
C>* 10.203.110.0/24 is directly connected, eth1.110, weight 1, 00:00:01
C>* 10.203.120.0/24 is directly connected, eth1.120, weight 1, 00:00:01
C>* 172.90.3.64/26 is directly connected, eth0, weight 1, 00:00:10
El router tiene una ruta directa a cada subred, sin ningún protocolo de routing. En los
trunks, las VLANs permitidas aparecen sin PVID ni Untagged. No hizo falta activar el
forwarding de IP en r1: sysctl net.ipv4.ip_forward ya vale 1 en los nodos del
laboratorio.
Un paquete a través de VLANs, en tres capturas
Vaciamos las tablas de los hosts y de los switches, y hacemos un ping de h1 (VLAN 110)
a h2 (VLAN 120), mientras capturamos en varios sitios.
h1$ ping -c 1 -W 1 10.203.120.2
PING 10.203.120.2 (10.203.120.2): 56 data bytes
64 bytes from 10.203.120.2: seq=0 ttl=63 time=0.455 ms

--- 10.203.120.2 ping statistics ---
1 packets transmitted, 1 packets received, 0% packet loss
round-trip min/avg/max = 0.455/0.455/0.455 ms
Lo que ve h1. Su frame va hacia el router, y sin etiqueta: h1 no sabe nada de
VLANs.
h1$ tcpdump -t -e -n -r /tmp/c.pcap
02:00:00:00:00:01 > ff:ff:ff:ff:ff:ff, ethertype ARP (0x0806), length 42: Request who-has 10.203.110.254 tell 10.203.110.1, length 28
02:00:00:00:00:fe > 02:00:00:00:00:01, ethertype ARP (0x0806), length 42: Reply 10.203.110.254 is-at 02:00:00:00:00:fe, length 28
02:00:00:00:00:01 > 02:00:00:00:00:fe, ethertype IPv4 (0x0800), length 98: 10.203.110.1 > 10.203.120.2: ICMP echo request, id 94, seq 0, length 64
02:00:00:00:00:fe > 02:00:00:00:00:01, ethertype IPv4 (0x0800), length 98: 10.203.120.2 > 10.203.110.1: ICMP echo reply, id 94, seq 0, length 64
Esta es la respuesta a la pregunta de antes. h1 quiere llegar a 10.203.120.2, pero
con ARP buscó a 10.203.110.254, su gateway. Y el frame con el ping tiene la MAC del
router como destino, y la IP de h2 adentro. Su tabla ARP confirma que nunca oyó hablar
de la MAC de h2:
h1$ ip neigh show dev eth1
10.203.110.254 lladdr 02:00:00:00:00:fe REACHABLE
Lo que ve h2. Otro frame, sin etiqueta, con el origen cambiado.
h2$ tcpdump -t -e -n -r /tmp/c.pcap
02:00:00:00:00:fe > ff:ff:ff:ff:ff:ff, ethertype ARP (0x0806), length 42: Request who-has 10.203.120.2 tell 10.203.120.254, length 28
02:00:00:00:00:02 > 02:00:00:00:00:fe, ethertype ARP (0x0806), length 42: Reply 10.203.120.2 is-at 02:00:00:00:00:02, length 28
02:00:00:00:00:fe > 02:00:00:00:00:02, ethertype IPv4 (0x0800), length 98: 10.203.110.1 > 10.203.120.2: ICMP echo request, id 94, seq 0, length 64
02:00:00:00:00:02 > 02:00:00:00:00:fe, ethertype IPv4 (0x0800), length 98: 10.203.120.2 > 10.203.110.1: ICMP echo reply, id 94, seq 0, length 64
Comparen el echo request en los dos lados:
| MAC origen | MAC destino | IP origen | IP destino | TTL | |
|---|---|---|---|---|---|
Visto en h1 |
…:01 (h1) |
…:fe (r1) |
10.203.110.1 | 10.203.120.2 | 64 |
Visto en h2 |
…:fe (r1) |
…:02 (h2) |
10.203.110.1 | 10.203.120.2 | 63 |
Las direcciones IP no cambiaron y las MAC sí, porque el frame nació y murió en cada
enlace. El TTL bajó en 1 al pasar por r1. Lo comprobamos con tcpdump -v, que muestra
ttl 64 en h1 y ttl 63 en h2. Es la idea clave de este capítulo en una sola
tabla.
Lo que ve el trunk entre sw1 y sw2. Esta es la captura más interesante.
sw1$ tcpdump -t -e -n -r /tmp/c.pcap
02:00:00:00:00:01 > ff:ff:ff:ff:ff:ff, ethertype 802.1Q (0x8100), length 46: vlan 110, p 0, ethertype ARP (0x0806), Request who-has 10.203.110.254 tell 10.203.110.1, length 28
02:00:00:00:00:fe > 02:00:00:00:00:01, ethertype 802.1Q (0x8100), length 46: vlan 110, p 0, ethertype ARP (0x0806), Reply 10.203.110.254 is-at 02:00:00:00:00:fe, length 28
02:00:00:00:00:01 > 02:00:00:00:00:fe, ethertype 802.1Q (0x8100), length 102: vlan 110, p 0, ethertype IPv4 (0x0800), 10.203.110.1 > 10.203.120.2: ICMP echo request, id 94, seq 0, length 64
02:00:00:00:00:fe > ff:ff:ff:ff:ff:ff, ethertype 802.1Q (0x8100), length 46: vlan 120, p 0, ethertype ARP (0x0806), Request who-has 10.203.120.2 tell 10.203.120.254, length 28
02:00:00:00:00:02 > 02:00:00:00:00:fe, ethertype 802.1Q (0x8100), length 46: vlan 120, p 0, ethertype ARP (0x0806), Reply 10.203.120.2 is-at 02:00:00:00:00:02, length 28
02:00:00:00:00:fe > 02:00:00:00:00:02, ethertype 802.1Q (0x8100), length 102: vlan 120, p 0, ethertype IPv4 (0x0800), 10.203.110.1 > 10.203.120.2: ICMP echo request, id 94, seq 0, length 64
02:00:00:00:00:02 > 02:00:00:00:00:fe, ethertype 802.1Q (0x8100), length 102: vlan 120, p 0, ethertype IPv4 (0x0800), 10.203.120.2 > 10.203.110.1: ICMP echo reply, id 94, seq 0, length 64
02:00:00:00:00:fe > 02:00:00:00:00:01, ethertype 802.1Q (0x8100), length 102: vlan 110, p 0, ethertype IPv4 (0x0800), 10.203.120.2 > 10.203.110.1: ICMP echo reply, id 94, seq 0, length 64
Hay tres cosas para notar.
- Cada frame lleva su etiqueta. Los tamaños son 46 y 102, en lugar de 42 y 98: los 4 bytes de 802.1Q.
- El mismo ping cruza el trunk dos veces.
h1yh2están conectados al mismo switch,sw1. Pero están en VLANs distintas, de modo que el echo request sube haciar1por el trunk con la etiqueta 110, y vuelve por el mismo cable con la etiqueta 120. Es el precio de un router colgado: ese tramo se recorre de ida y de vuelta. - Nadie cruza de VLAN sin pasar por
r1. El cambio de 110 a 120 ocurre solo en el router.
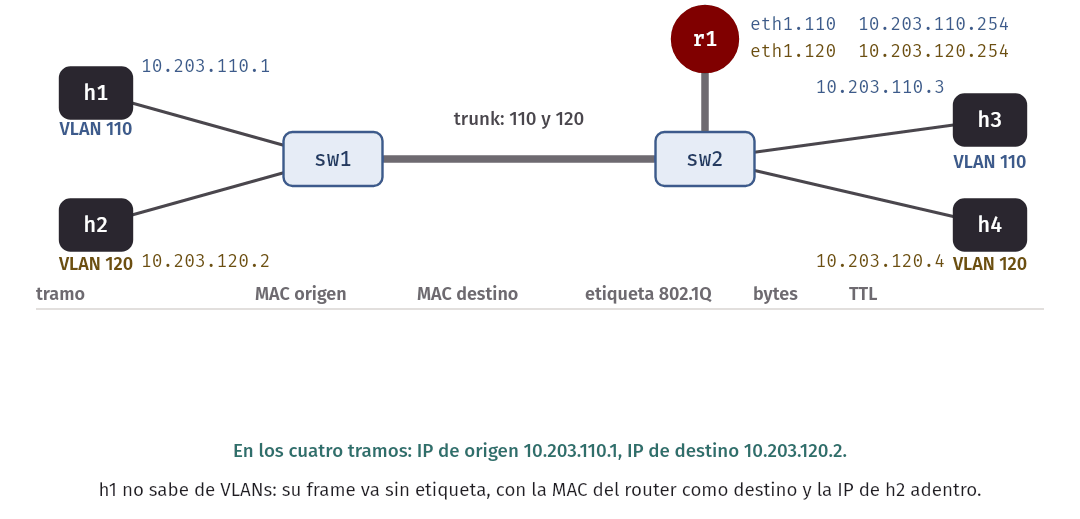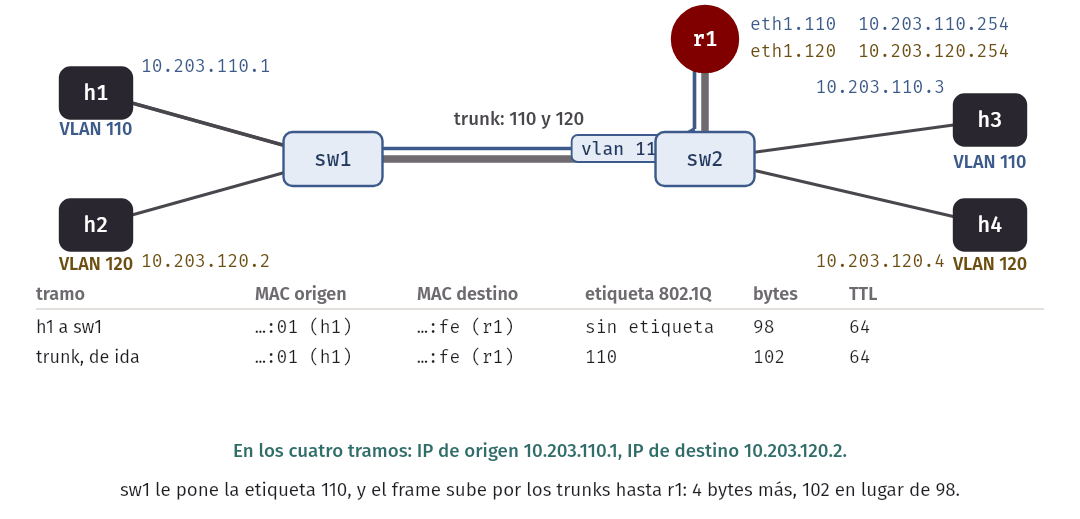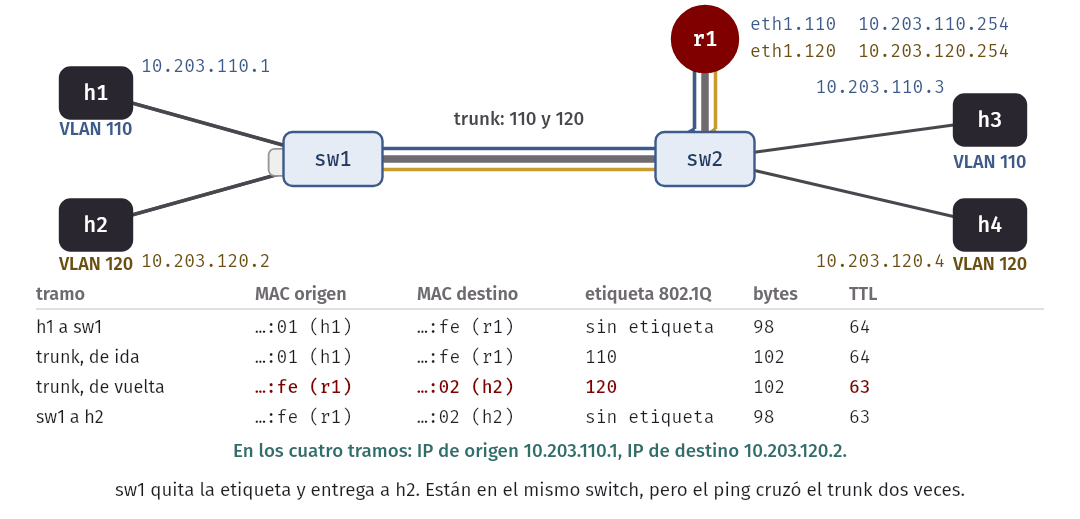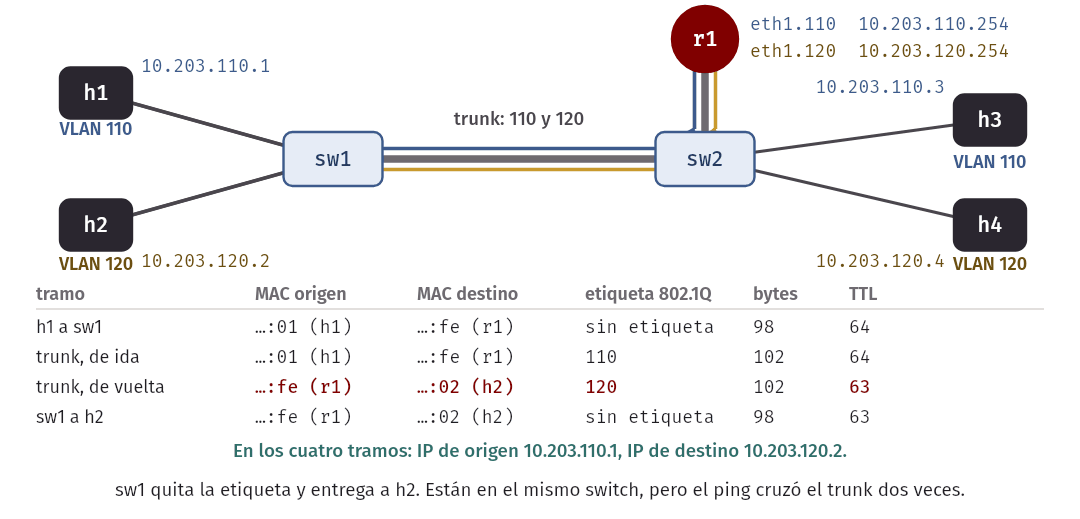
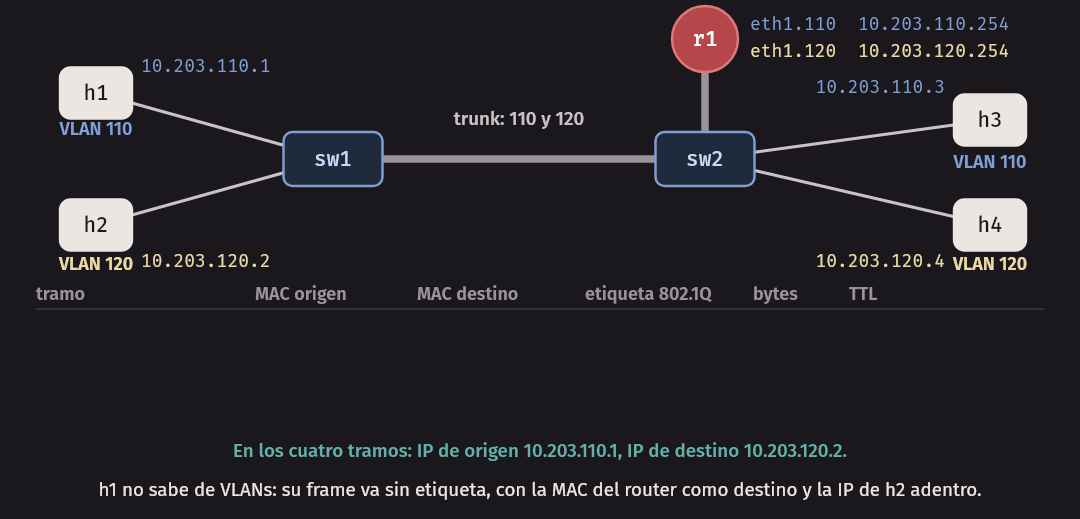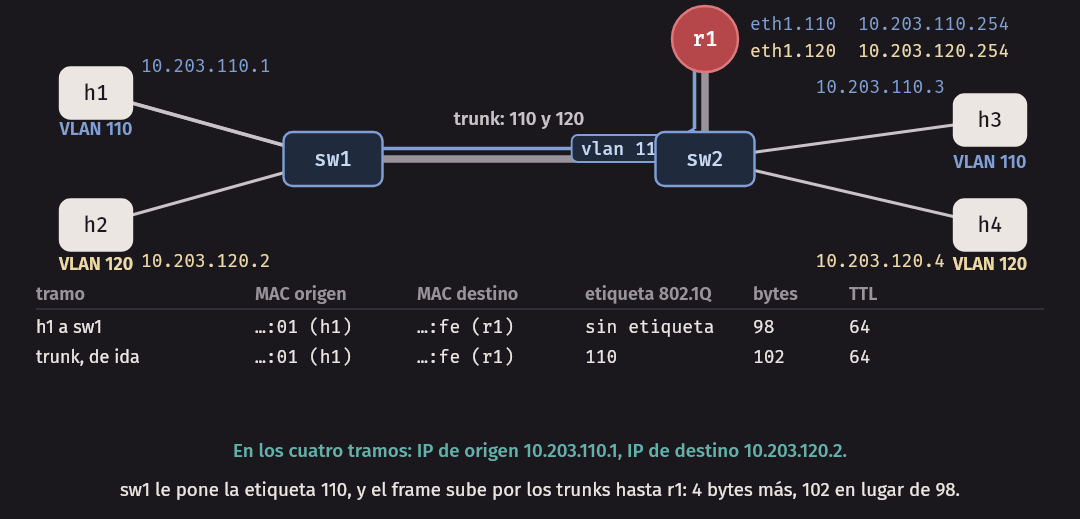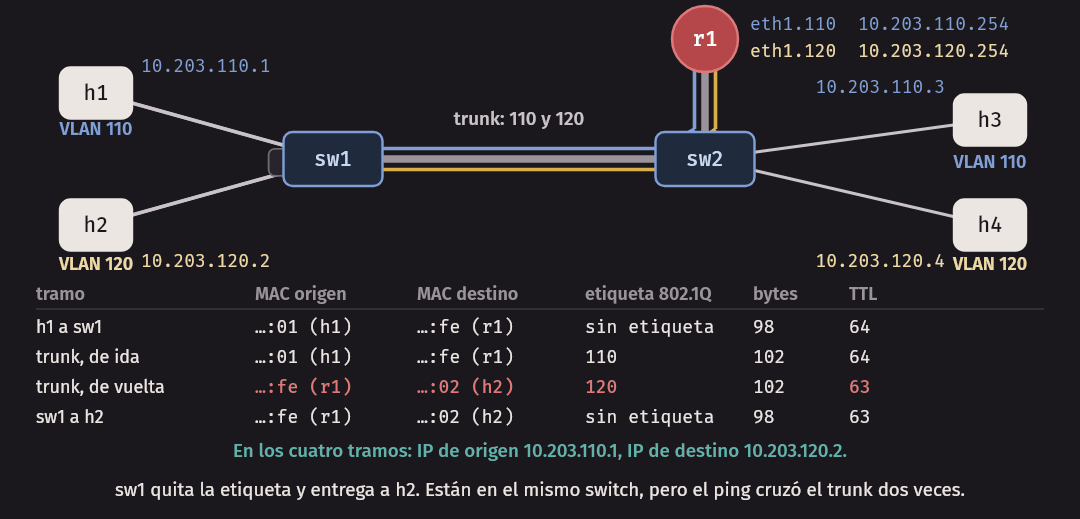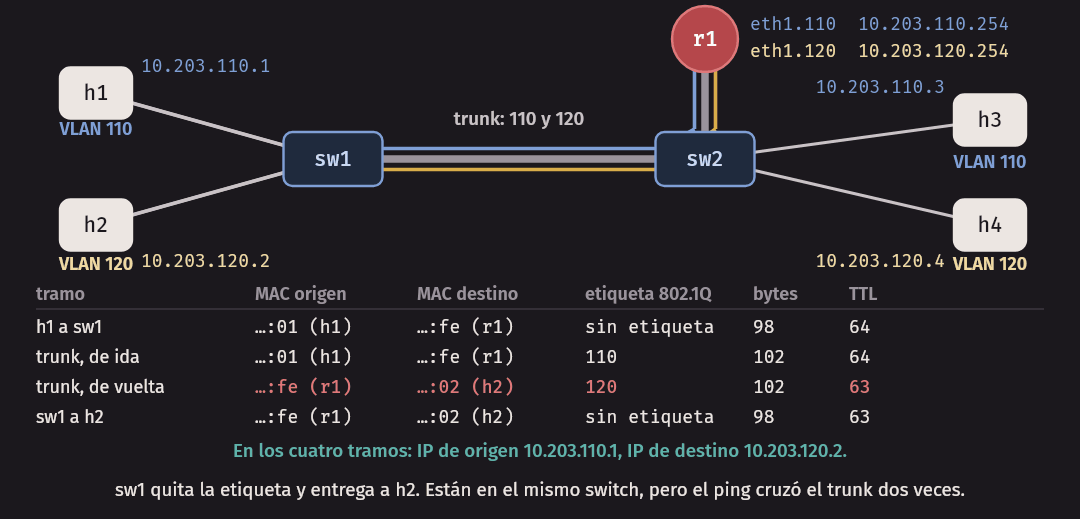
Y estos son los bytes:
sw1$ tcpdump -t -e -n -xx -c 1 -r /tmp/c.pcap "vlan and icmp"
02:00:00:00:00:01 > 02:00:00:00:00:fe, ethertype 802.1Q (0x8100), length 102: vlan 110, p 0, ethertype IPv4 (0x0800), 10.203.110.1 > 10.203.120.2: ICMP echo request, id 94, seq 0, length 64
	0x0000:  0200 0000 00fe 0200 0000 0001 8100 006e
	0x0010:  0800 4500 0054 38fe 4000 4001 0612 0acb
Después de las dos MAC vienen 8100 (el TPID) y 006e. 0x006e es 110. PCP y DEI
están en 0. Sigue 0800, el EtherType real. Wireshark lo explica igual; también se
puede usar tshark, dentro del contenedor del curso, sobre el mismo archivo:
$ docker cp clab-w03-campus-sw1:/tmp/c.pcap .
$ tshark -r c.pcap -Y 'icmp.type == 8' -O vlan
Frame 3: 102 bytes on wire (816 bits), 102 bytes captured (816 bits)
Ethernet II, Src: 02:00:00:00:00:01 (02:00:00:00:00:01), Dst: 02:00:00:00:00:fe (02:00:00:00:00:fe)
802.1Q Virtual LAN, PRI: 0, DEI: 0, ID: 110
    000. .... .... .... = Priority: Best Effort (default) (0)
    ...0 .... .... .... = DEI: Ineligible
    .... 0000 0110 1110 = ID: 110
    Type: IPv4 (0x0800)
Internet Protocol Version 4, Src: 10.203.110.1, Dst: 10.203.120.2
Internet Control Message Protocol
Lo que ve r1. En eth1, lo mismo que en el trunk. En la subinterfaz, en cambio,
la etiqueta ya no está.
r1$ tcpdump -t -e -n -r /tmp/d.pcap icmp
02:00:00:00:00:01 > 02:00:00:00:00:fe, ethertype IPv4 (0x0800), length 98: 10.203.110.1 > 10.203.120.2: ICMP echo request, id 94, seq 0, length 64
02:00:00:00:00:fe > 02:00:00:00:00:01, ethertype IPv4 (0x0800), length 98: 10.203.120.2 > 10.203.110.1: ICMP echo reply, id 94, seq 0, length 64
Error común. Filtrar un archivo de captura con
icmpy creer que no hay tráfico. En un trunk, los bytes del frame llevan la etiqueta, y por eso el filtro debe servlan and icmp. Sobre/tmp/c.pcap, el filtroicmpsolo no devuelve nada. Al capturar en vivo,icmpsí los muestra, porque el kernel entrega la etiqueta aparte del frame. Conviene saberlo para no perder una hora.
Por último, la tabla de los switches demuestra lo que dijimos sobre la pareja (VLAN, MAC):
sw1$ bridge fdb show br br0 | grep -v permanent
02:00:00:00:00:02 dev eth2 vlan 120 master br0
02:00:00:00:00:01 dev eth1 vlan 110 master br0
02:00:00:00:00:04 dev eth3 vlan 120 master br0
02:00:00:00:00:fe dev eth3 vlan 120 master br0
02:00:00:00:00:fe dev eth3 vlan 110 master br0
La MAC del router (…:fe) aparece dos veces, una en cada VLAN. Las dos
subinterfaces de r1 usan la misma MAC, y el switch las trata como dos entradas
diferentes. El traceroute también muestra al router como un salto entre las dos VLANs,
aunque los dos hosts estén a un metro:
h1$ traceroute -n -q 1 10.203.120.4
traceroute to 10.203.120.4 (10.203.120.4), 30 hops max, 46 byte packets
 1  10.203.110.254  0.003 ms
 2  10.203.120.4  0.003 ms
Los hosts h1 y h3, en cambio, están en la misma VLAN aunque en distintos switches:
no aparecen saltos entre ellos, porque para IP son vecinos.
Una VLAN que falta en un trunk
Es la falla más común cuando se trabaja con VLANs. Quitemos la VLAN 120 del trunk de
sw1.
sw1$ bridge vlan del dev eth3 vid 120
h1$ ping -c 1 -W 1 10.203.120.254 | tail -2
1 packets transmitted, 1 packets received, 0% packet loss
round-trip min/avg/max = 0.083/0.083/0.083 ms
h2$ ping -c 1 -W 1 10.203.120.254 | tail -2
--- 10.203.120.254 ping statistics ---
1 packets transmitted, 0 packets received, 100% packet loss
h1 funciona y h2 no, y por el mismo cable. El enlace está arriba, la VLAN 110 pasa y
la VLAN 120 no: el error está en la lista de VLANs permitidas. El script de comprobación
del laboratorio, que veremos enseguida, detecta este caso:
$ make check
ok     sw1 tiene el filtrado de VLANs activo
ok     sw2 tiene el filtrado de VLANs activo
FALLA  el trunk de sw1 lleva 110 y 120, sin la VLAN 1
ok     el trunk de sw2 hacia r1 lleva 110 y 120, sin la VLAN 1
ok     h1 llega a h3 (misma VLAN, por el trunk)
FALLA  h2 llega a h4 (misma VLAN, por el trunk)
ok     h1 llega a su gateway
FALLA  h1 llega a h2 pasando por r1
ok     traceroute de h1 a h4 pasa por el gateway
Error común. Dar por hecho que un mismo número de VLAN “conecta” dos switches. El número solo tiene sentido si la VLAN está permitida en todos los trunks del camino. Cuando una VLAN falla y las demás no, lo primero es revisar
bridge vlan showen cada switch por donde pasa.
En la práctica. Una red real tiene más opciones que el router colgado. Un switch de capa 3 hace routing entre VLANs por hardware, sin dar la vuelta por un cable. Los switches también intercambian la lista de VLANs por protocolos, y en los trunks suele haber una VLAN nativa que va sin etiqueta. En las redes de los data centers modernos, las VLANs no alcanzan: 4094 son pocas para miles de clientes, y se usan overlays como VXLAN, de la semana 14.
El laboratorio de esta semana
El laboratorio se hace en code/week-03/, dentro del contenedor del curso. Compilen
primero con make.
| Archivo | Para qué |
|---|---|
topo/lan.clab.yml |
Un switch y cuatro hosts: pasos 1 a 3 |
topo/campus.clab.yml |
Dos switches, un trunk y un router: paso 4 |
topo/loop.clab.yml |
Tres switches en triángulo: la demostración de spanning tree |
vlan/ |
Los scripts de VLANs que usa este capítulo |
lab/reto_*.sh |
Lo que ustedes escriben para el reto |
check_lab.py |
Revisa la topología campus ya configurada |
Paso 1: ARP. Levanten la red con make lan. Esperen unos segundos, y miren
ip neigh show dev eth1 en un host. Dejen tcpdump en él, hagan ping a un vecino, y
capturen el intercambio ARP. Vacíen la tabla con ip neigh flush dev eth1 para
repetirlo. Para abrir la captura en Wireshark, cópienla con docker cp.
En la práctica. En los primeros segundos de una topología pueden aparecer mensajes
router solicitationde IPv6, en especial en interfaces recién creadas. No tienen que ver con el laboratorio. Por eso capturamos con un filtro comoarp or icmp.
Paso 2: aprendizaje. Miren la tabla del switch con
bridge fdb show br br0 | grep -v permanent. Antes de hacer un ping, escriban qué
puertos van a recibir el primer frame. Compruébenlo con tcpdump en otro host. Luego
repitan el experimento de flooding: vacíen la tabla del switch, pero no la tabla ARP del
host.
Paso 3: VLANs. Apliquen el script vlan/lan_sw1.sh y comprueben qué pings dejan de
funcionar. Capturen en un host de la otra VLAN mientras falla la consulta ARP: ¿le
llega?
Paso 4: trunk y router. Destruyan la anterior con make destroy y levanten
make campus. Apliquen los tres scripts de vlan/, léanlos línea por línea, y corran:
$ make check
ok     sw1 tiene el filtrado de VLANs activo
ok     sw2 tiene el filtrado de VLANs activo
ok     el trunk de sw1 lleva 110 y 120, sin la VLAN 1
ok     el trunk de sw2 hacia r1 lleva 110 y 120, sin la VLAN 1
ok     h1 llega a h3 (misma VLAN, por el trunk)
ok     h2 llega a h4 (misma VLAN, por el trunk)
ok     h1 llega a su gateway
ok     h1 llega a h2 pasando por r1
ok     traceroute de h1 a h4 pasa por el gateway
Luego, capturen en eth3 de sw1 y encuentren la etiqueta 802.1Q en Wireshark: el
campo VID de un ping entre VLANs debe aparecer con los dos valores.
Reto. Mover a h4 a una nueva VLAN 130, con la subred 10.203.130.0/24 y gateway
10.203.130.254, sin que esa VLAN vaya hacia sw1, que no la necesita. Escriban los
comandos en lab/reto_sw2.sh, lab/reto_r1.sh y lab/reto_h4.sh, y aplíquenlos sobre
la topología ya configurada, con
docker exec -i clab-w03-campus-sw2 sh -e < lab/reto_sw2.sh, y así en cada nodo.
Comprueben con make check-reto.
Paso 5: entregas. Esta semana se entrega P0 y se publica P1, Tu red. Léanlo: P1 usa VLANs, trunks y un router, pero en una red distinta, y con sus propias reglas. Lo de este capítulo son las herramientas, no la solución.
Al terminar, make clean destruye las topologías y sus redes de Docker. make test
corre todas las pruebas de la semana: los programas en C, las afirmaciones sobre CRC y
ALOHA, y cada experimento de este capítulo con sus topologías. Tarda unos minutos, y al
final no deja nada corriendo. La prueba del reto se omite si no está la carpeta de
soluciones.
En la práctica. Si una topología no se levanta, revisen la sección de solución de problemas de
labs/README.md. Para saber qué dejaron corriendo:docker ps --filter name=clab-w03.
Resumen
- La capa física mueve bits, con límites que dependen del medio: atenuación, interferencia, medio compartido. La capacidad de un canal tiene un máximo teórico, dado por Shannon.
- La capa de enlace entrega frames entre vecinos, un salto a la vez. Sus servicios son framing, acceso al medio, entrega y detección de errores.
- Paridad detecta errores impares; paridad bidimensional corrige uno. El
checksum es barato, pero no ve palabras intercambiadas. El CRC es una división
módulo 2, detecta toda ráfaga de hasta
rbits, y su costo es casi nulo en hardware. - El enlace usa CRC, en cada salto y en hardware. El transporte usa un checksum, de extremo a extremo y por software. Protegen cosas diferentes.
- El acceso múltiple tiene tres familias: particionar, acceso aleatorio, tomar turnos. ALOHA ranurado aprovecha como mucho el 37 % del canal y ALOHA puro el 18 %; CSMA/CD mejora mucho esa cifra si la propagación es corta frente a la transmisión.
- En una Ethernet conmutada y full-duplex no hay colisiones, y CSMA/CD no se usa. Permanece el frame: MAC, EtherType, datos de 46 a 1500 bytes y CRC-32.
- Una MAC es plana y dice a qué vecino; una IP es jerárquica y dice a dónde va el paquete al final. La MAC cambia en cada salto, y la IP no.
- ARP encuentra la MAC de una IP de la red local. Pregunta por broadcast, porque no sabe a quién dirigirse; responde por unicast, porque sí sabe. Para otra subred, se busca la MAC del gateway.
- Un switch aprende de las direcciones de origen, y hace forwarding, filtering o flooding según su tabla. No necesita configuración.
- Sin un árbol, una tormenta de broadcast puede tumbar la red. STP bloquea puertos hasta dejar un árbol, y vuelve a calcularlo si algo falla, aunque el STP clásico tarda decenas de segundos.
- Una VLAN separa dominios de broadcast dentro de un mismo equipo físico. Los puertos access van sin etiqueta y los trunk con etiqueta 802.1Q. Para pasar de una VLAN a otra hace falta un router.
Ejercicios
- Calculen a mano el CRC de los datos
1011010con el generador1001. Comprueben conbuild/crc. Luego cambien un bit de la palabra resultante y revísenla conbuild/crc -c. - Un CRC usa
G = 1011. a) ¿Cuántos bits tiene el CRC? b) ¿Qué ráfagas detecta siempre? c) ¿Tiene ax + 1como factor? (Pista: un polinomio tiene ese factor si y solo si tiene una cantidad par de unos.) ¿Qué significa eso para los errores de tres bits? Compruébenlo con un error concreto. - Una matriz de paridad bidimensional de 4 × 4 llega con una fila y dos columnas que fallan. ¿Cuántos bits dañados puede haber, como mínimo? ¿Se puede corregir el error? Justifiquen. Den un ejemplo de un error de 4 bits que no se detecte.
- En
detect.py, agreguen una fila para un daño que invierte el orden de los 64 bytes del frame. Antes de correrlo, predigan cuántos daños no detecta cada método. Para el checksum, piensen qué le pasa a cada palabra de 16 bits y, por lo tanto, a la suma. ¿Sus predicciones se cumplen? - En ALOHA ranurado hay 10 nodos, y cada uno transmite con probabilidad
p = 0.1. a) ¿Qué fracción de las ranuras tiene un frame exitoso? b) ¿Cuántas quedan vacías? c) ¿Cuántas tienen colisión? d) Sipsube a0.3, ¿qué pasa? Calculen, y compárenlo con la columna dealoha.cque corresponda. - Dos tarjetas de red de 100 Mb/s, con CSMA/CD, colisionan por tercera vez consecutiva.
a) ¿Cuántos valores puede tomar
K? b) ¿Qué probabilidad hay de que elijan el mismo valor? c) ¿Cuánto es lo máximo que puede esperar cada una? d) ¿Por qué dejaría de ser un problema con un switch full-duplex? - Un frame de Ethernet lleva un ping de 56 bytes de datos: 8 de ICMP y 20 de IP encima.
a) ¿Cuánto mide el frame sin FCS? Compárenlo con el
lengthde las capturas. b) ¿Cuál es el tamaño de un frame con un mensaje ICMP de 8 bytes en total, sin datos, en un cable real? ¿Hay relleno? ¿Cuánto? c) ¿Qué fracción del cable aprovechan los datos de IP en ese caso? - En
make lan, sin VLANs, hagan queh1haga ping ah2y luego ah3. Escriban qué va a contener la tabla del switch y la tabla ARP de cada host, antes de comprobarlo. Luego, cambien el cable deh2: apagueneth2desw1y expliquen qué tendría que pasar para que el switch aprenda una nueva ubicación. ¿Qué pasa con la entrada si nadie vuelve a usar esa MAC? - Un host con IP
10.203.5.7/24y gateway10.203.5.1quiere enviar un paquete a10.203.6.9. Describan cada frame que aparece, con sus MAC de origen y destino, en estos dos enlaces: del host al router y del router al destino. ¿Cuántas veces se usa ARP si las dos tablas están vacías? ¿Qué cambia si el destino es10.203.5.9? - Cuatro switches forman un cuadrado:
s1–s2–s3–s4–s1. Sus prioridades son 1000, 2000, 3000 y 4000 (identificadores distintos), y todos los enlaces tienen el mismo costo. Determinen la raíz, el puerto raíz de cada uno, los puertos designados y cuál puerto se bloquea. ¿Qué pasa si se corta el enlaces1–s2? Con los temporizadores por defecto, ¿cuánto tarda en reanudarse el tráfico? Comprueben el resultado adaptandotopo/loop.clab.yml, sin quitar los retardos. - En
make campus, después de configurar las VLANs, provoquen un broadcast desdeh1: una consulta ARP por una dirección que no existe (ping -c 1 -W 1 10.203.110.77). a) ¿A qué enlaces llega? ¿Con qué etiqueta? b) ¿Llega ah2, que está en el mismo switch? c) Comprueben capturando ensw1:eth3,h2yh3. d) Si se pone la VLAN 110 comopvid untaggedeneth3de los dos switches, ¿qué cambia en la captura y qué sigue funcionando? - (Desafío) Escriban un programa en C parecido a
arp_probe.c, que escuche conAF_PACKETen una interfaz y lleve una tabla propia con la última MAC vista por cada IP, leyendo los ARP que pasan. Debe avisar cuando una IP cambie de MAC. Pruébenlo conmake lan: desde otro host, usenip link set eth1 address ...para cambiar una MAC, y provoquen una consulta. ¿Por qué un detector así no puede saber cuál de las dos MAC es la legítima? ¿Cómo cambia lo que se ve si se configuran VLANs?