
Apuntes · Capítulo 4Redes locales e IP
IP, forwarding y NAT
IP, forwarding y NAT
La semana pasada nos quedamos dentro de una sola red local. Ethernet lleva un frame de una interfaz a otra del mismo enlace, ARP traduce una dirección IP en una dirección MAC, y un switch reparte los frames sin que nadie lo configure. También vimos el límite de todo eso: para pasar de una VLAN a otra hace falta un router. Esta semana entramos a esa pieza que faltaba.
La capa de red (network layer) resuelve un problema distinto al del enlace: llevar un paquete desde un host hasta otro que puede estar al otro lado del mundo, cruzando redes que no se conocen entre sí y que usan tecnologías diferentes. Lo hace con muy poco. Un formato común de paquete, el datagrama IP. Un plan de direcciones que se puede resumir. Y en cada router, una decisión que se toma paquete por paquete: ¿por cuál interfaz sale este datagrama? Esa decisión se llama forwarding y es el hilo de la primera parte.
En la Sesión A leemos un datagrama IPv4 campo por campo, dividimos redes con CIDR, aplicamos longest prefix match y abrimos un router para ver dónde se forman las colas. En la Sesión B vemos los protocolos que hacen usable a IP: ICMP para los errores, DHCP para obtener una dirección, NAT para compartir una dirección pública e IPv6 para el día después de que se acabaron las direcciones de 32 bits. Terminamos siguiendo un paquete real desde que un host pide su dirección hasta que llega a un servidor externo, con cada encabezado a la vista.
Todo lo que se muestra aquí salió de dos topologías de Containerlab que ustedes pueden levantar. Las direcciones MAC, los tiempos y los identificadores cambian en cada ejecución. Lo que no cambia es lo que queremos aprender a leer.
Ruta de lectura.
Antes de clase (obligatorio, unos 15 a 20 minutos). Sesión A: Forwarding y routing: dos planos, la introducción de El datagrama IPv4, Subredes y máscaras, CIDR, Agregación y La regla. Sesión B: la introducción de ICMP, la de DHCP y, de NAT, Sin NAT, no funciona y La traducción.
En clase. Sesión A: Un datagrama de verdad, El checksum, a mano, Fragmentación, los ejemplos resueltos de Direccionamiento y de Agregación y longest prefix match, y Dentro de un router. Sesión B: Los tres errores, en vivo,
traceroute, La tabla de traducción, Conexiones entrantes, IPv6 y Recorrido completo de un paquete.Después de clase. Repasen con Salto por salto: qué cambia, el Resumen y los Ejercicios, y preparen El laboratorio de la semana y
make test. Opcional: Scheduling, Lo quetracerouteno dice, Las críticas y Convivencia de IPv4 e IPv6. Para profundizar, las lecturas del libro y las gratuitas de la semana:Este capítulo acompaña a Kurose y Ross, Computer Networking: A Top-Down Approach (9.ª ed.). Para la Sesión A, las secciones 4.1 Overview of Network Layer, 4.2 What’s Inside a Router?, 4.3.1 IPv4 Datagram Format y la parte de CIDR de la 4.3.2 IPv4 Addressing. Para la Sesión B, las secciones 4.3.2 (DHCP), 4.3.3 Network Address Translation, 4.3.4 IPv6 y 5.6 (ICMP). Lecturas libres de CS168: IP Header, Addressing, Router Hardware, DHCP y NAT. Complementarias: RFC 791 (IP), RFC 4632 (CIDR), RFC 792 (ICMP), RFC 2131 (DHCP), RFC 1918 (direcciones privadas) y RFC 8200 (IPv6). El código de la semana está en
code/week-04/.
Forwarding y routing: dos planos
Un router hace dos trabajos que conviene separar desde el primer minuto.
Forwarding es la acción local: llega un datagrama por una interfaz, el router mira su dirección de destino, la busca en una tabla y lo saca por la interfaz que la tabla indica. Pasa una vez por cada paquete, así que tiene que ser muy rápido: en un router de un ISP, unos pocos nanosegundos por paquete, y por eso se hace en hardware.
Routing es la decisión global: calcular qué caminos existen en toda la red y llenar las tablas de todos los routers. Pasa cuando cambia la topología o llega información nueva. Toma de milisegundos a minutos y se hace en software, con protocolos que veremos en las próximas semanas: OSPF y BGP.
La comparación clásica es la de un viaje por carretera. Forwarding es lo que hacen ustedes en cada cruce: mirar el letrero y doblar. Routing es lo que se hizo antes de salir: mirar el mapa y planear la ruta.
| Forwarding | Routing | |
|---|---|---|
| Pregunta | ¿Por cuál interfaz sale este paquete? | ¿Qué caminos hay hacia cada destino? |
| Alcance | Un router | Toda la red |
| Frecuencia | Cada paquete | Cuando algo cambia |
| Tiempo típico | Nanosegundos | Milisegundos a minutos |
| Se hace en | Hardware, o el kernel de un router de software | Software |
| Plano | Plano de datos (data plane) | Plano de control (control plane) |
Los dos planos se comunican por un solo lugar, la forwarding table. El plano de control la escribe; el plano de datos la lee.
            plano de control
   +-------------------------------+
   |  OSPF, BGP o rutas a mano     |   FRRouting en nuestros laboratorios
   +---------------+---------------+
                   | instala rutas
                   v
          +-----------------+
 entrada  | forwarding table|  salida
 ------>  |   (plano de     |  ------>     el kernel de Linux en nuestros
          |     datos)      |              laboratorios
          +-----------------+
Esta semana el plano de control somos nosotros: escribimos las rutas a mano. Las semanas 5 y 6 lo reemplazan por protocolos, y el plano de datos sigue igual.
Idea clave. Un router puede seguir haciendo forwarding aunque su protocolo de routing esté caído: la tabla ya está escrita. Y si la tabla está mal, el protocolo puede estar perfecto y los paquetes igual se pierden. Cuando algo falla, la primera pregunta es en cuál de los dos planos está el problema.
El modelo de servicio de IP
¿Qué le promete IP a quien le entrega un datagrama? Casi nada. Hará su mejor esfuerzo (best effort) por entregarlo, pero un datagrama se puede perder, llegar duplicado, llegar desordenado o tardar lo que tarde. No hay conexión ni estado por flujo en los routers: cada datagrama se decide por su cuenta.
Parece poco, y es una decisión de diseño que ya discutimos en la semana 2. Una capa de red simple se puede construir sobre casi cualquier enlace, y deja los problemas difíciles, como la entrega confiable, a los extremos. Los protocolos de transporte de la Parte 4 existen justamente porque IP no promete más.
El datagrama IPv4
Un datagrama IPv4 tiene un encabezado de al menos 20 bytes, seguido de los datos. El encabezado se escribe en filas de 32 bits:
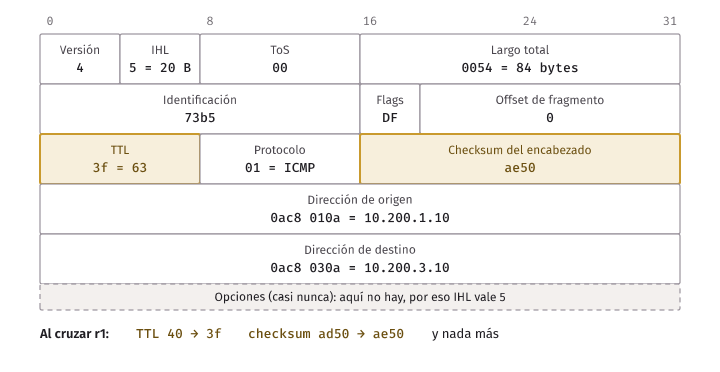
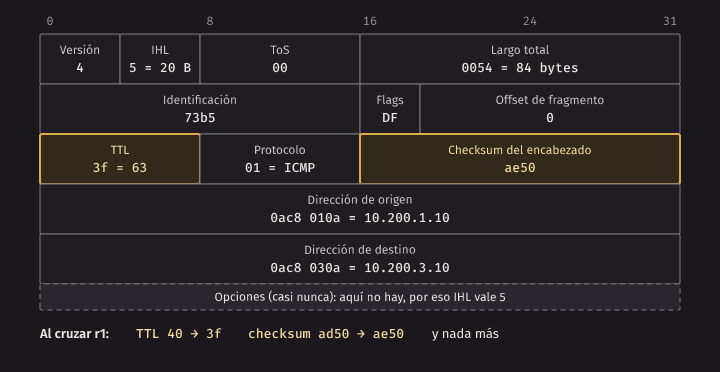
Campo por campo:
- Versión (4 bits): vale 4. Es lo primero que un router lee para saber cómo interpretar el resto.
- IHL (4 bits): largo del encabezado, contado en palabras de 4 bytes. Sin opciones vale 5, o sea 20 bytes. Hace falta porque las opciones hacen variable el encabezado.
- ToS (8 bits): hoy se divide en DSCP (6 bits, la clase de servicio que se pide) y ECN (2 bits, una señal de congestión que veremos en la semana 11).
- Largo total (16 bits): encabezado más datos, en bytes. El máximo es 65 535.
- Identificación, flags y offset: sirven para fragmentar; los vemos más abajo.
- TTL (8 bits): time to live. Cada router le resta 1 y, si llega a 0, descarta el datagrama y avisa al origen con ICMP. Evita que un datagrama dé vueltas para siempre si hay un ciclo en las tablas. El RFC 791 lo definía en segundos, pero en la práctica cuenta saltos (hops).
- Protocolo (8 bits): a quién se le entregan los datos al llegar. 1 es ICMP, 6 es TCP, 17 es UDP. Es el pegamento entre capas, como el EtherType en Ethernet.
- Checksum (16 bits): detecta errores solo en el encabezado.
- Direcciones (32 bits cada una): origen y destino. El router decide con la de destino.
- Opciones: existen en el formato, pero casi no se usan. Un router las procesa por una vía lenta, y muchos descartan los datagramas que las traen.
Un datagrama de verdad
Levantemos la primera topología: tres routers en triángulo, con un host en cada LAN.
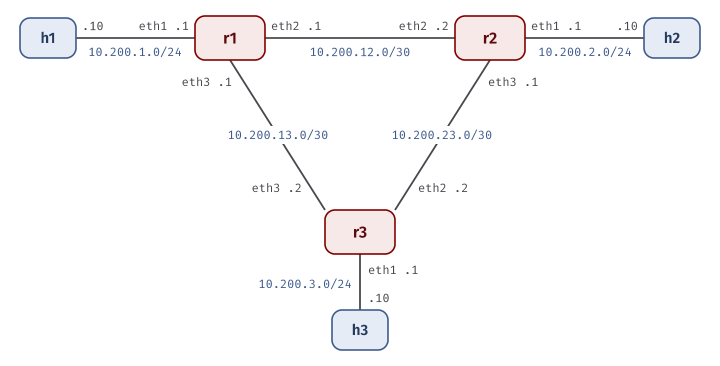
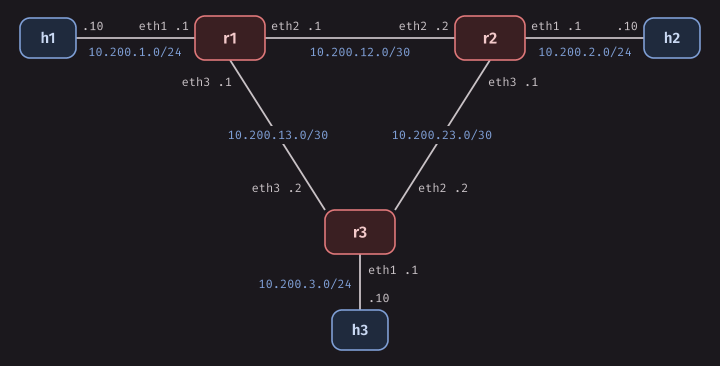
make up-fwd
docker exec clab-w04-fwd-r1 tcpdump -l -n -x -c 1 -i eth3 'icmp[icmptype]==icmp-echo'
En otra terminal, docker exec clab-w04-fwd-h1 ping -c1 10.200.3.10 genera el
paquete. La opción -x de tcpdump muestra los bytes. Capturamos el mismo
datagrama a la entrada y a la salida de r1:
[r1.eth1]
06:45:44.672717 IP 10.200.1.10 > 10.200.3.10: ICMP echo request, id 153, seq 0, length 64
	0x0000:  4500 0054 73b5 4000 4001 ad50 0ac8 010a
	0x0010:  0ac8 030a 0800 5973 0099 0000 e30f bae3
	...
[r1.eth3]
06:45:44.672729 IP 10.200.1.10 > 10.200.3.10: ICMP echo request, id 153, seq 0, length 64
	0x0000:  4500 0054 73b5 4000 3f01 ae50 0ac8 010a
	0x0010:  0ac8 030a 0800 5973 0099 0000 e30f bae3
	...
Lo que tcpdump -x muestra empieza en el encabezado IP, sin el de Ethernet. Los
primeros 20 bytes son el encabezado. Podemos leerlos a mano o con
ipv4_header.c, un programa de la carpeta de la semana que recorre los bytes
uno por uno. Hace lo que la guía de estilo exige para cualquier formato de red:
nunca copiar una struct sobre los bytes, sino leer cada campo en su posición y
armarlo en orden de red. El programa corre en el contenedor del
curso, y tcpdump en el router, de modo que se conectan con un pipe:
docker exec clab-w04-fwd-r1 tcpdump -l -n -x -c 1 -i eth3 'icmp[icmptype]==icmp-echo' | ./ipv4_header. Con la segunda captura:
versión      4
encabezado   20 bytes
ToS          DSCP 0, ECN 0
largo total  84 bytes
id           0x73b5
flags        DF=1 MF=0
offset       0 (0 bytes)
TTL          63
protocolo    1 (ICMP)
checksum     0xae50
origen       10.200.1.10
destino      10.200.3.10
El largo total de 84 bytes son 20 del encabezado IP, 8 del encabezado ICMP y los
56 de datos que ping envía por defecto. Las direcciones también se leen a
simple vista: 0ac8 010a son los bytes 10, 200, 1 y 10.
Qué cambió al cruzar el router
Comparen las dos capturas. Solo cambiaron dos cosas:
| Campo | En eth1 |
En eth3 |
|---|---|---|
| TTL | 40 (64) |
3f (63) |
| Checksum | ad50 |
ae50 |
El TTL bajó en 1 y, como el TTL es parte del encabezado, el checksum tuvo que recalcularse. Las direcciones, la identificación y los datos son idénticos.
El checksum, a mano
El checksum de IPv4 es la suma de complemento a uno de las palabras de 16 bits
del encabezado, con el campo de checksum en cero, y luego complementada.
Hagámoslo con el encabezado de eth1:
   4500
 + 0054
 + 73b5
 + 4000
 + 4001
 + 0000   (el campo de checksum, en cero para calcular)
 + 0ac8
 + 010a
 + 0ac8
 + 030a
 -------
  152ae   la suma se pasa de 16 bits
   52ae + 1 = 52af    el acarreo se suma de vuelta
 ~52af = ad50         el complemento: es lo que dice la captura
Quien recibe el paquete suma todo, incluido el checksum. Si no hubo errores, el
resultado es ffff.
Fíjense en el cambio de la captura. El TTL y el protocolo forman la palabra
4001. Al bajar el TTL queda 3f01, que es 0100 menos. La suma baja en
0100, y su complemento sube en 0100: de ad50 a ae50. Un router no
necesita volver a sumar todo el encabezado; le basta con ese ajuste. En un
router rápido eso importa.
Idea clave. El checksum de IP protege solo el encabezado, y cambia en cada salto porque el TTL cambia. No garantiza que los datos estén intactos: de eso se encargan el CRC de cada enlace y el checksum del transporte. IPv6 lo eliminó, como veremos.
Fragmentación
Cada enlace tiene un MTU (maximum transmission unit): el tamaño máximo de datagrama que puede llevar un frame. En Ethernet son 1500 bytes. ¿Qué pasa si un datagrama de 1428 bytes llega a un enlace con MTU 600?
IPv4 tiene dos respuestas y las dos se pueden ver. Si el datagrama permite fragmentarse, el router lo parte. Si trae encendido el bit DF (don’t fragment), lo descarta y avisa.
En nuestra topología bajamos el MTU del enlace entre r1 y r3:
docker exec clab-w04-fwd-r1 ip link set eth3 mtu 600
docker exec clab-w04-fwd-r3 ip link set eth3 mtu 600
Hay que cambiarlo en los dos extremos: una interfaz también rechaza los frames que recibe por encima de su MTU.
Primero, con DF. Linux marca DF por defecto, así que un ping de 1400 bytes
de datos sale con ese bit. r1 no puede pasarlo y responde con ICMP. Esto se ve
en h1:
06:46:23.261412 IP (tos 0x0, ttl 64, id 51977, offset 0, flags [DF], proto ICMP (1), length 1428)
    10.200.1.10 > 10.200.3.10: ICMP echo request, id 216, seq 0, length 1408
06:46:23.261431 IP (tos 0xc0, ttl 64, id 48930, offset 0, flags [none], proto ICMP (1), length 576)
    10.200.1.1 > 10.200.1.10: ICMP 10.200.3.10 unreachable - need to frag (mtu 600), length 556
	IP (tos 0x0, ttl 64, id 51977, offset 0, flags [DF], proto ICMP (1), length 1428)
    10.200.1.10 > 10.200.3.10: ICMP echo request, id 216, seq 0, length 1408
El ping falla, pero h1 aprendió algo: el mensaje dice cuál es el MTU del
enlace. El kernel lo recuerda como el MTU del camino (path MTU) hacia ese
destino:
$ docker exec clab-w04-fwd-h1 ip route get 10.200.3.10
10.200.3.10 via 10.200.1.1 dev eth1 src 10.200.1.10 uid 0
    cache expires 592sec mtu 600
Este mecanismo se llama path MTU discovery. Si repetimos el ping, funciona, y
la fragmentación ya la hace h1 mismo, antes de enviar. Tampoco va DF en
los fragmentos:
06:46:31.392860 IP (tos 0x0, ttl 64, id 54599, offset 0, flags [+], proto ICMP (1), length 596)
    10.200.1.10 > 10.200.3.10: ICMP echo request, id 236, seq 0, length 576
06:46:31.392866 IP (tos 0x0, ttl 64, id 54599, offset 576, flags [+], proto ICMP (1), length 596)
    10.200.1.10 > 10.200.3.10: ip-proto-1
06:46:31.392866 IP (tos 0x0, ttl 64, id 54599, offset 1152, flags [none], proto ICMP (1), length 276)
    10.200.1.10 > 10.200.3.10: ip-proto-1
Ahora, sin DF. Para que el router fragmente de verdad, hay que pedirle al
kernel de h1 que no marque DF. Eso se hace con una opción de socket; en este
experimento enviamos un datagrama UDP de 1400 bytes con IP_MTU_DISCOVER en
IP_PMTUDISC_DONT. Después de borrar el MTU aprendido con ip route flush cache, salen de h1 1428 bytes en un solo datagrama:
06:46:38.659856 IP (tos 0x0, ttl 64, id 19220, offset 0, flags [none], proto UDP (17), length 1428)
    10.200.1.10.54364 > 10.200.3.10.9999: UDP, length 1400
y por eth3 de r1 salen tres:
06:46:38.659869 IP (tos 0x0, ttl 63, id 19220, offset 0, flags [+], proto UDP (17), length 596)
    10.200.1.10.54364 > 10.200.3.10.9999: UDP, length 1400
06:46:38.659869 IP (tos 0x0, ttl 63, id 19220, offset 576, flags [+], proto UDP (17), length 596)
    10.200.1.10 > 10.200.3.10: ip-proto-17
06:46:38.659870 IP (tos 0x0, ttl 63, id 19220, offset 1152, flags [none], proto UDP (17), length 276)
    10.200.1.10 > 10.200.3.10: ip-proto-17
Saquemos las cuentas. El MTU es 600 y el encabezado ocupa 20, así que caben 580 bytes de datos. Pero el offset se guarda en unidades de 8 bytes, de modo que cada fragmento menos el último debe llevar un múltiplo de 8: 576. Los datos originales son 1408 bytes (8 de UDP y 1400 de carga), y se reparten así:
| Fragmento | Datos | Largo total | offset en bytes |
Valor del campo offset | flags |
|---|---|---|---|---|---|
| 1 | 576 | 596 | 0 | 0 | MF |
| 2 | 576 | 596 | 576 | 72 | MF |
| 3 | 256 | 276 | 1152 | 144 | ninguno |
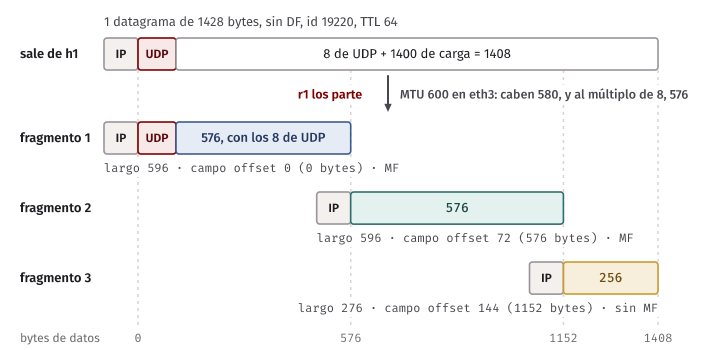
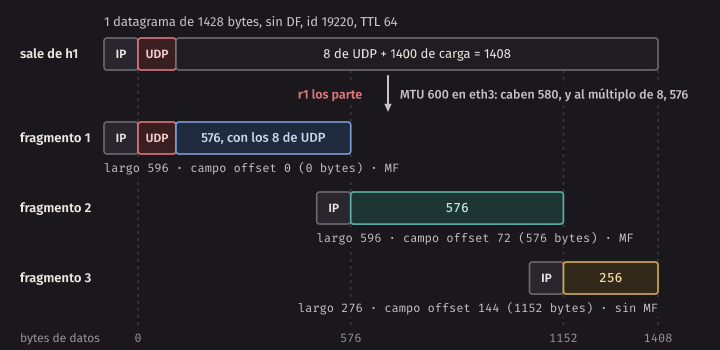
tcpdump muestra el offset ya multiplicado por 8, y marca MF (more fragments)
con +. Los tres fragmentos llevan el mismo id: así los reconoce el destino,
que es el único que vuelve a armar el datagrama. Solo el primero trae el
encabezado UDP; por eso tcpdump no ve puertos en los otros dos y escribe
ip-proto-17.
Error común. Decir que “el router fragmenta” como regla general. Hoy lo normal es al revés: el origen marca DF, descubre el MTU del camino y hace paquetes que quepan. Los routers fragmentan solo lo que no trae DF. Fragmentar es caro, y si se pierde un solo fragmento hay que retransmitir el datagrama entero. Además, los fragmentos sin puertos complican a los firewalls y a los NAT.
En la práctica. Si un firewall descarta los mensajes ICMP “need to frag”, el origen nunca se entera del MTU y sus paquetes grandes desaparecen sin aviso, mientras que los pequeños pasan. Es el clásico “el ping funciona, pero la página se queda colgada”. Se llama path MTU black hole, y es una razón para no bloquear todo ICMP.
Límite de esta topología. Containerlab pone MTU 9500 en sus enlaces si no se le indica otra cosa. Nuestros archivos
.clab.ymlpidenmtu: 1500en cada enlace para que todo se parezca a Ethernet. Si en otro laboratorio venmss 9460en una captura de TCP, esa es la razón.
Direccionamiento
Una dirección IPv4 tiene 32 bits y se escribe como cuatro bytes en decimal:
10.200.1.10. Una precisión importante: la dirección identifica una interfaz,
no una máquina. Por eso r1 tiene tres direcciones, una por cada enlace.
Subredes y máscaras
Una subred (subnet) es un conjunto de interfaces que se alcanzan
directamente, sin pasar por un router. Todas comparten los primeros bits de su
dirección. Esos bits son el prefijo, y los demás identifican a la interfaz
dentro de la subred. La notación 10.200.1.0/24 dice que los primeros 24 bits
son el prefijo. Lo mismo se escribe como máscara: 24 unos seguidos de 8
ceros, o sea 255.255.255.0.
La máscara sirve para calcular. dirección AND máscara da la red:
10.200.1.10    00001010 11001000 00000001 00001010
255.255.255.0  11111111 11111111 11111111 00000000
---------------------------------------------------- AND
10.200.1.0     00001010 11001000 00000001 00000000
Esto es lo primero que hace un host para enviar un datagrama: comparar la red del destino con la suya. Si coinciden, el destino está en su enlace y basta buscar su MAC con ARP. Si no, se lo manda al router por defecto (default gateway), y busca con ARP la MAC del router. Eso conecta directamente con la semana pasada.
Con h bits de host, una subred tiene 2^h direcciones, y se reservan dos en
cada una: la primera (todos los bits de host en 0) nombra la red, y la última
(todos en 1) es el broadcast de la subred. Quedan 2^h − 2 para hosts. Hay dos
excepciones: en un /31, pensado para enlaces entre dos routers (RFC 3021), se
usan las dos direcciones; y un /32 nombra una sola interfaz.
CIDR
Al inicio, IP tenía clases: A (/8), B (/16) y C (/24). Una empresa con
2000 hosts no cabía en una clase C (254), así que pedía una clase B de 65 534
direcciones y desperdiciaba casi todas. Y las tablas de los routers crecían sin
control. CIDR (Classless Inter-Domain Routing, RFC 4632) quitó esa
restricción: un prefijo puede tener cualquier largo.
Ejemplo resuelto: dividir 10.20.0.0/22 en cuatro subredes
Tenemos un /22 y queremos 4 subredes iguales. Para distinguir 4 cosas hacen
falta 2 bits (2² = 4), que se le toman a la parte de host. El prefijo pasa de 22
a 24.
El bloque tiene 2^(32−22) = 1024 direcciones, y cada subred, 2^(32−24) = 256. Los bits que cambian están en el tercer byte:
tercer byte de 10.20.0.0/22 = 000000|00
                              ------ -- estos dos bits eligen la subred
                              fijo

00 -> 10.20.0.0/24
01 -> 10.20.1.0/24
10 -> 10.20.2.0/24
11 -> 10.20.3.0/24
El programa cidr.c de la semana hace la misma cuenta. Úsenlo para verificar,
no para reemplazar el cálculo a mano, que es lo que tienen que aprender a hacer:
$ ./cidr 10.20.0.0/22
prefijo    10.20.0.0/22
máscara    255.255.252.0
total      1024 direcciones
broadcast  10.20.3.255
hosts      10.20.0.1 - 10.20.3.254 (1022)
$ ./cidr 10.20.0.0/22 4
10.20.0.0/22 en 4 subredes de /24 (256 direcciones cada una):
  10.20.0.0/24       hosts 10.20.0.1 - 10.20.0.254 (254)
  10.20.1.0/24       hosts 10.20.1.1 - 10.20.1.254 (254)
  10.20.2.0/24       hosts 10.20.2.1 - 10.20.2.254 (254)
  10.20.3.0/24       hosts 10.20.3.1 - 10.20.3.254 (254)
La máscara 255.255.252.0 se entiende mirando el tercer byte: 252 es
11111100, seis unos, que con los 16 bits de los dos primeros bytes hacen 22.
Ejemplo resuelto: subredes de distinto tamaño
Casi nunca hacen falta subredes iguales. Dentro de 10.200.70.0/24 necesitamos
una LAN de 60 hosts, otra de 28, otra de 12 y un enlace entre dos routers. El
método es: ordenar de mayor a menor, redondear a la potencia de 2 que alcance
(recordando restar las dos direcciones reservadas) y asignar en orden. Cada
bloque empieza en un múltiplo de su tamaño.
| Necesidad | Hacen falta | Bloque | Prefijo | Rango | Hosts útiles |
|---|---|---|---|---|---|
| LAN de 60 | 62 | 64 | 10.200.70.0/26 |
.0 a .63 |
62 |
| LAN de 28 | 30 | 32 | 10.200.70.64/27 |
.64 a .95 |
30 |
| LAN de 12 | 14 | 16 | 10.200.70.96/28 |
.96 a .111 |
14 |
| Enlace | 2 | 4 | 10.200.70.112/30 |
.112 a .115 |
2 |
Sobran .116 a .255. Al planificar, cuenten también la interfaz del router,
que ocupa una dirección de cada LAN, y dejen espacio para crecer: renumerar una
red después es mucho más caro que desperdiciar unas direcciones hoy.
Error común. Empezar un bloque en cualquier lugar.
10.200.70.70/27no es una subred: sus bits de host no están en cero. Una subred/27debe empezar en un múltiplo de 32. Si van asignando de mayor a menor, esto sale solo.
En la práctica. En P1 van a escribir un plan de direcciones parecido para su propia red, con el bloque que les toca. El método es este; los tamaños y las decisiones son suyos, y hay que justificarlos.
Direcciones con significado especial
| Bloque | Para qué sirve |
|---|---|
0.0.0.0/8 |
“Esta red”. 0.0.0.0 como origen significa “todavía no tengo dirección”. Se ve en DHCP. |
10.0.0.0/8, 172.16.0.0/12, 192.168.0.0/16 |
Privadas (RFC 1918). No tienen ruta en Internet. |
100.64.0.0/10 |
Espacio compartido para el NAT de los proveedores (RFC 6598). En este curso, las direcciones “públicas” de Qhapaq Ñan. |
127.0.0.0/8 |
Loopback: la propia máquina. |
169.254.0.0/16 |
Link-local: un host la toma si no consiguió una dirección. |
224.0.0.0/4 |
Multicast. |
255.255.255.255 |
Broadcast en el enlace local. Se ve en DHCP. |
Agregación y longest prefix match
¿Por qué importa tanto que los prefijos se puedan resumir? Porque ningún router puede tener una entrada por cada host de Internet. Una forwarding table tiene prefijos.
Agregación
Si r5 llega por la misma interfaz a estas cuatro redes, puede guardarlas en
una sola entrada:
10.200.0.0/24   tercer byte 000000|00
10.200.1.0/24   tercer byte 000000|01
10.200.2.0/24   tercer byte 000000|10
10.200.3.0/24   tercer byte 000000|11
                            ^^^^^^ 16 + 6 = 22 bits en común

resumen: 10.200.0.0/22
Esto se llama agregación de rutas y es lo que permite que Internet tenga del orden de un millón de prefijos en vez de miles de millones de entradas. Un proveedor anuncia un solo bloque grande, y lo que hay adentro no le importa a nadie de afuera.
Solo funciona con bloques alineados. 10.200.1.0/24 y 10.200.2.0/24 no se
pueden resumir en un /23, aunque sean consecutivos: un /23 empieza en un
tercer byte par, así que 10.200.1.0 queda en un /23 y 10.200.2.0 en el
siguiente.
La regla
Pero la agregación crea un problema. Supongan que uno de esos /24 se muda a
otro proveedor. El bloque /22 todavía llega al proveedor anterior, y el /24
debe ir a otra parte. Las dos rutas coinciden con la misma dirección. ¿Cuál se
usa?
Definición. Longest prefix match: de todas las entradas de la tabla que contienen a la dirección de destino, se elige la de prefijo más largo.
La intuición es que un prefijo más largo es información más específica. “Lima,
Rímac, jirón Trujillo” le gana a “Lima”. Con esta regla, el resumen y la
excepción conviven sin problema. También por eso 0.0.0.0/0, la ruta por
defecto, coincide con todo y solo gana cuando no hay nada mejor.
Ejemplo resuelto: una tabla de cuatro entradas
| Prefijo | Siguiente salto |
|---|---|
10.200.0.0/16 |
A |
10.200.4.0/22 |
B |
10.200.5.0/24 |
C |
0.0.0.0/0 |
D |
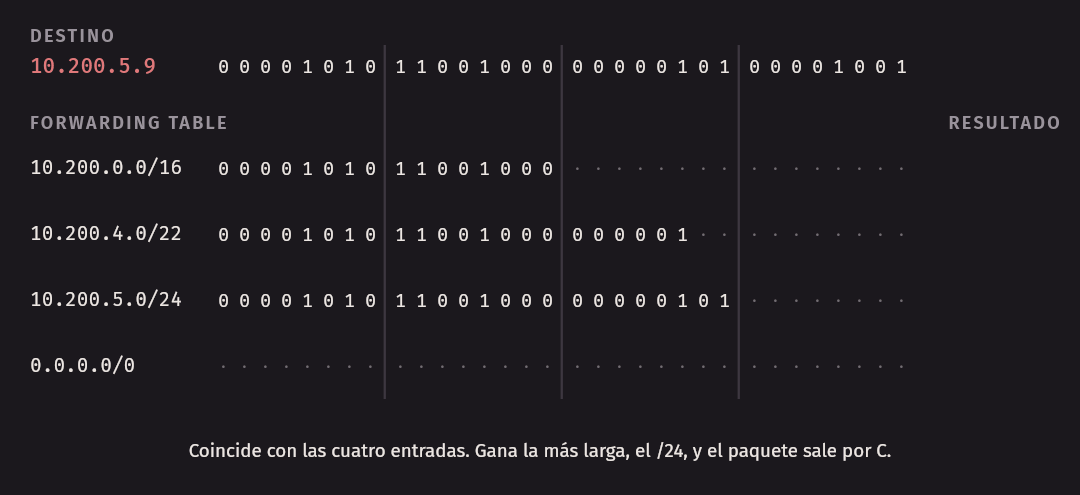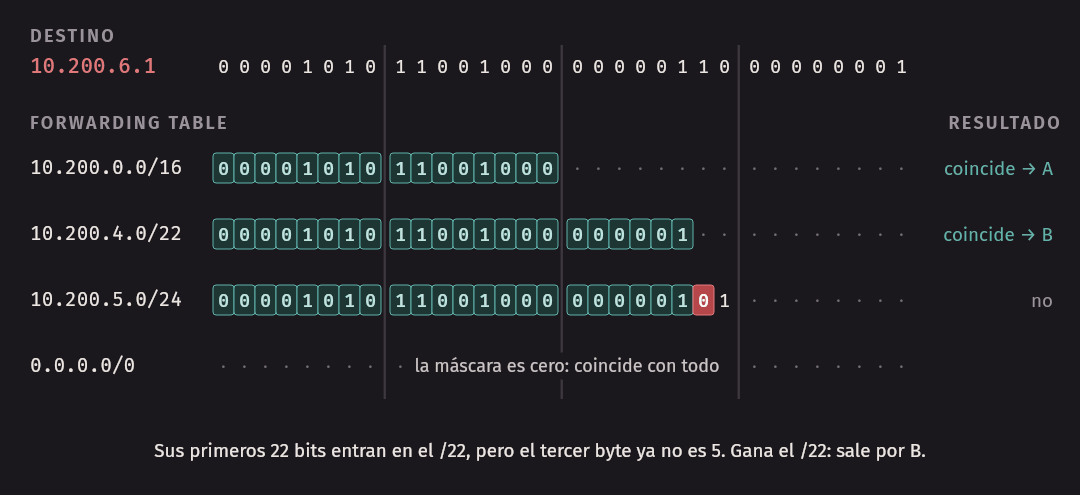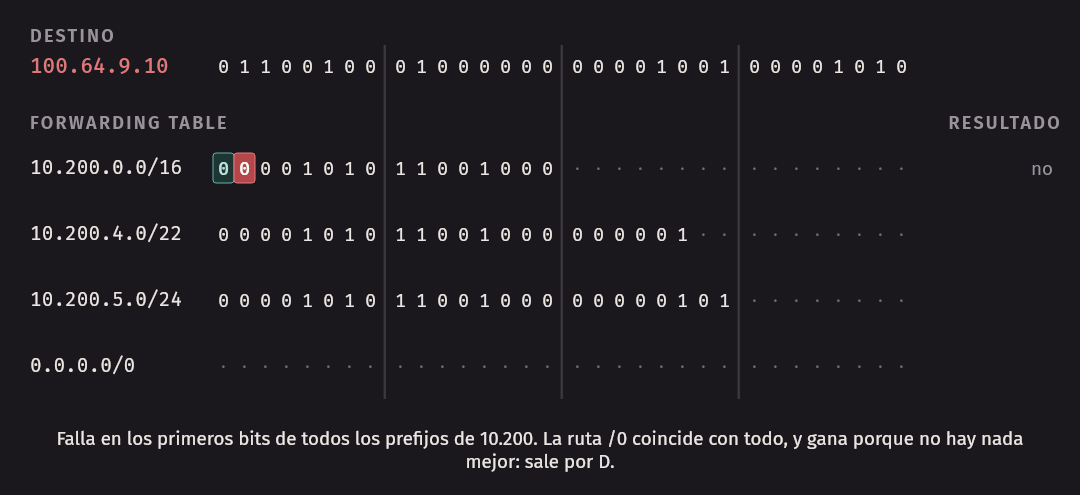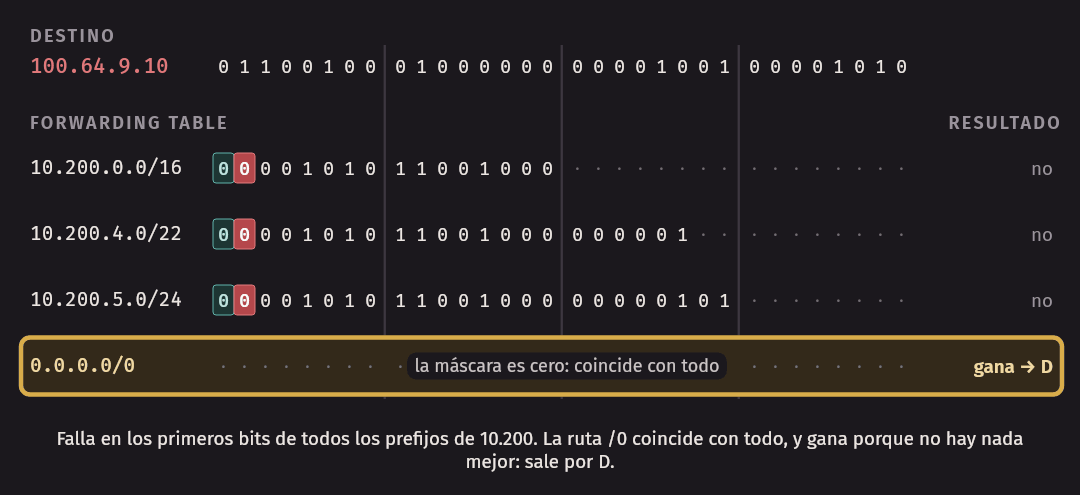
¿Por dónde sale 10.200.5.9? Su tercer byte es 5, en binario 00000101.
/16: los primeros dos bytes son10.200. Coincide./22: seis bits del tercer byte.000001en el prefijo (4 es00000100) y000001en la dirección. Coincide./24: tercer byte 5 en los dos. Coincide./0: siempre coincide.
Coinciden las cuatro y gana la más larga, el /24: sale por C. Con
10.200.6.1, el tercer byte es 00000110: aún empieza con 000001 y entra en
el /22, pero no en el /24. Sale por B.
lpm.c hace exactamente esto. Lee la tabla de table.txt:
$ ./lpm table.txt 10.200.5.9 10.200.6.1 10.200.9.1 100.64.9.10
10.200.5.9
  coincide  10.200.0.0/16 -> A
  coincide  10.200.4.0/22 -> B
  coincide  10.200.5.0/24 -> C
  coincide  0.0.0.0/0 -> D
  gana      10.200.5.0/24 -> C
10.200.6.1
  coincide  10.200.0.0/16 -> A
  coincide  10.200.4.0/22 -> B
  coincide  0.0.0.0/0 -> D
  gana      10.200.4.0/22 -> B
10.200.9.1
  coincide  10.200.0.0/16 -> A
  coincide  0.0.0.0/0 -> D
  gana      10.200.0.0/16 -> A
100.64.9.10
  coincide  0.0.0.0/0 -> D
  gana      0.0.0.0/0 -> D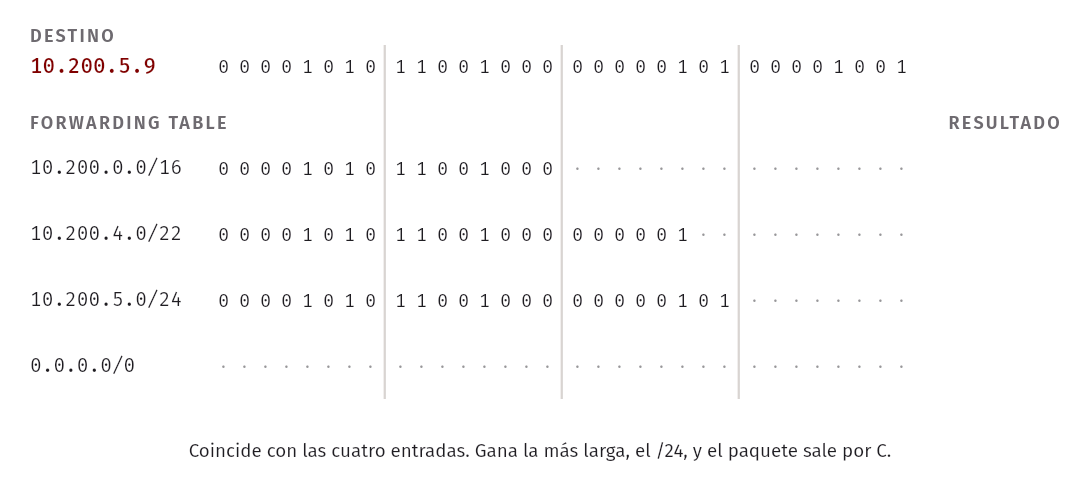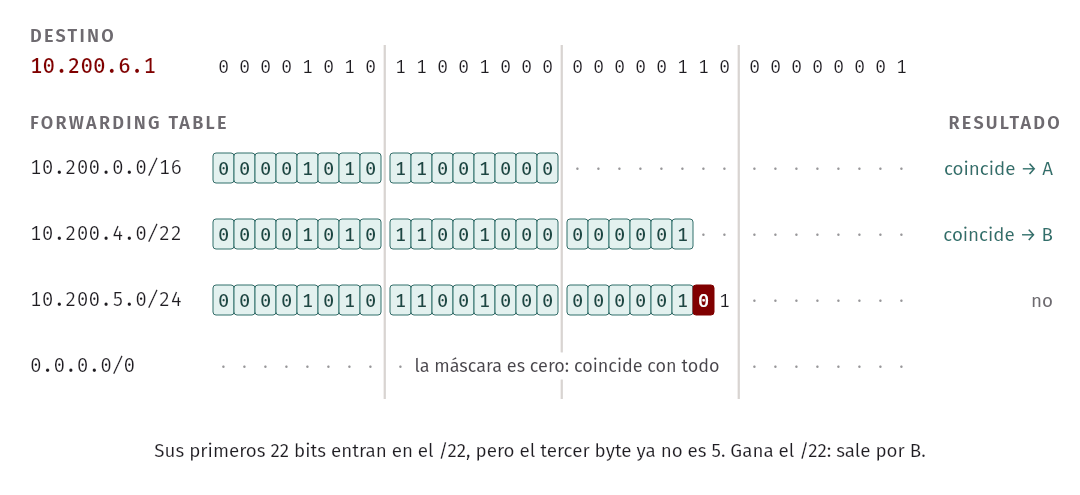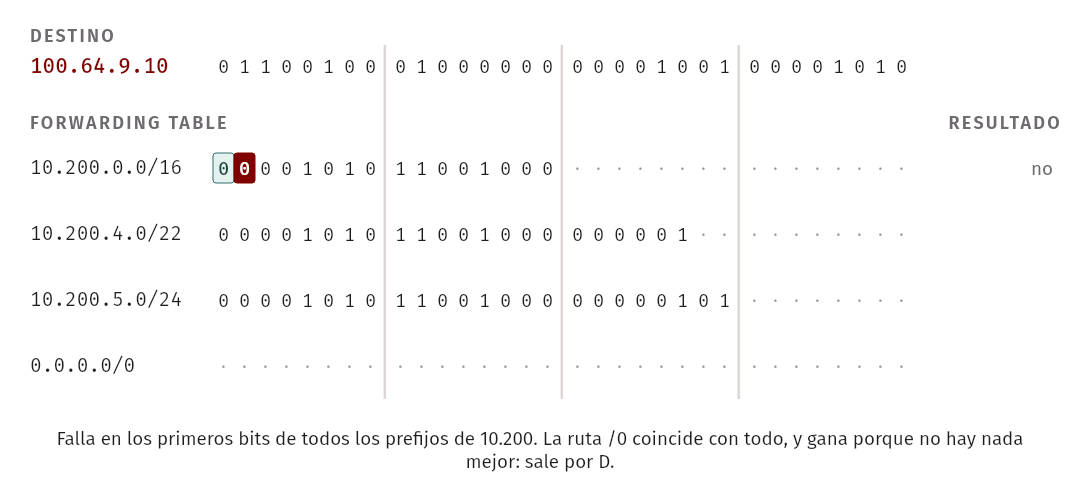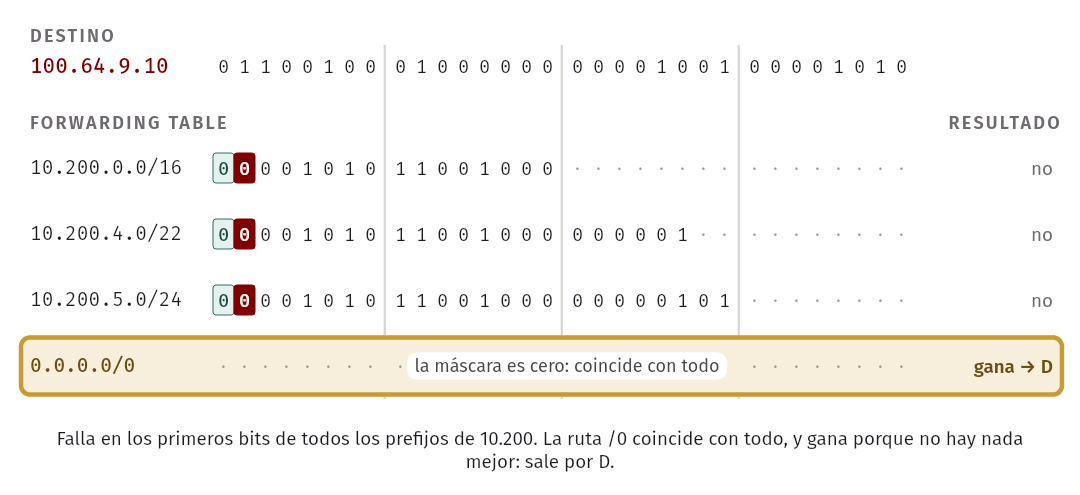
El corazón del programa son estas líneas:
for (int i = 0; i < count; i++) {
    const struct route *route = &table[i];
    if ((addr & route->mask) == route->network
        && (best == NULL || route->length > best->length)) {
        best = route;
    }
}
La condición de coincidencia es la misma cuenta con AND de antes. La máscara
de /0 es cero, así que cualquier dirección coincide. Y el programa revisa toda
la tabla, sin importar el orden: una de las pruebas de make test invierte el
archivo y exige el mismo resultado.
Error común. Elegir la ruta “más general” o la primera de la tabla. Ninguna de las dos: siempre gana el prefijo más largo, esté donde esté. Tampoco cuenta la distancia ni el costo: esas métricas sirven para elegir entre rutas al mismo prefijo.
En la práctica. Esa búsqueda lineal revisa todas las entradas por cada paquete, y con un millón de prefijos en la tabla un router no llegaría ni a miles de paquetes por segundo. El hardware usa TCAM, una memoria que compara una clave con todas sus entradas al mismo tiempo y devuelve la más prioritaria. El software, como el kernel de Linux, usa árboles (tries) que recorren la dirección bit a bit, y el costo ya no depende del número de rutas sino de los 32 bits. El ejercicio 7 les pide escribir uno.
Lo mismo en un router
Veamos la tabla de r1 tal como queda al levantar la topología. Tiene sus redes
directamente conectadas y una sola ruta estática, puesta en fwd/r1/frr.conf:
$ docker exec clab-w04-fwd-r1 ip route
10.200.1.0/24 dev eth1 proto kernel scope link src 10.200.1.1
10.200.3.0/24 nhid 16 via 10.200.13.2 dev eth3 proto 196 metric 20
10.200.12.0/30 dev eth2 proto kernel scope link src 10.200.12.1
10.200.13.0/30 dev eth3 proto kernel scope link src 10.200.13.1
172.90.4.0/25 dev eth0 proto kernel scope link src 172.90.4.5
La última línea es la red de gestión, la que usa Containerlab para administrar
los contenedores; no es parte de nuestra topología. Y un detalle importante del
archivo .clab.yml: cada nodo borra su ruta por defecto hacia esa red al
arrancar. Sin eso, lo que un router no sabe a dónde mandar saldría hacia Docker en vez
de fallar, y no veríamos ningún error.
El comando ip route get le pregunta a la forwarding table qué haría con una
dirección:
$ docker exec clab-w04-fwd-r1 ip route get 10.200.3.10
10.200.3.10 via 10.200.13.2 dev eth3 src 10.200.13.1 uid 0
    cache
$ docker exec clab-w04-fwd-r1 ip route get 10.200.2.10
RTNETLINK answers: Network unreachable
Para 10.200.2.10 no hay ruta, y lo que pasa con ese paquete lo vemos en la
sección de ICMP. Ahora agreguemos a r1 una ruta más específica: el host
10.200.3.10 irá por r2, mientras el resto de su LAN sigue por el enlace
directo. (Este paso supone que ya agregaron las rutas que faltan en r2, que es
lo primero del laboratorio.)
docker exec clab-w04-fwd-r1 vtysh -c 'conf t' -c 'ip route 10.200.3.10/32 10.200.12.2'Las dos rutas conviven, y la decisión depende de la dirección:
$ docker exec clab-w04-fwd-r1 ip route show 10.200.3.0/24
10.200.3.0/24 nhid 16 via 10.200.13.2 dev eth3 proto 196 metric 20
$ docker exec clab-w04-fwd-r1 ip route show 10.200.3.10
10.200.3.10 nhid 25 via 10.200.12.2 dev eth2 proto 196 metric 20
$ docker exec clab-w04-fwd-r1 ip route get 10.200.3.10
10.200.3.10 via 10.200.12.2 dev eth2 src 10.200.12.1 uid 0
    cache
$ docker exec clab-w04-fwd-r1 ip route get 10.200.3.11
10.200.3.11 via 10.200.13.2 dev eth3 src 10.200.13.1 uid 0
    cache
vtysh es la consola de FRRouting, nuestro plano de control. ip route muestra
lo que quedó instalado en el kernel, nuestro plano de datos. Allí se ve la
división de la primera sección, en dos comandos.
Dentro de un router
Ya sabemos qué decide un router. Ahora veamos cómo está hecho uno para decidirlo a cientos de gigabits por segundo por puerto.
                     +--------------------+
                     | procesador de      |   plano de control:
                     | routing (software) |   escribe las tablas
                     +---+------------+---+
                         |  tablas    |
              +----------v----+  +----v----------+
  entrada --> | puerto de     |  |               |  --> salida
              | entrada:      |  |               |
              | lookup y cola |  |   fabric de   |  puerto de salida:
              +---------------+  |  conmutación  |  cola y scheduling
              +---------------+  |               |
  entrada --> | puerto de     |  |               |  --> salida
              | entrada       |  |               |
              +---------------+  +---------------+
Puertos de entrada. Terminan el enlace físico, reciben el frame, verifican el CRC y le sacan el encabezado de Ethernet. Luego viene el paso clave: cada puerto tiene una copia de la forwarding table y hace el lookup allí mismo, para no tener que consultar a nadie. Resta el TTL, ajusta el checksum y deja el datagrama listo para cruzar.
Fabric de conmutación. Conecta los puertos de entrada con los de salida. Hay tres diseños clásicos:
| Diseño | Cómo funciona | Límite |
|---|---|---|
| Memoria | Una CPU copia el datagrama a memoria y luego a la salida | El ancho de banda de la memoria, y se cruza dos veces |
| Bus | Un bus compartido que todos los puertos ven | Pasa un datagrama a la vez |
| Red de interconexión (crossbar y otras) | Una malla que une pares de puertos a la vez | Dos entradas no pueden ir a la misma salida al mismo tiempo |
Puertos de salida. Guardan los datagramas en una cola hasta que el enlace pueda transmitirlos, eligen cuál sigue, ponen el encabezado de enlace y lo transmiten.
Procesador de routing. Corre los protocolos de routing y el software de gestión. Calcula las tablas y se las pasa a los puertos. Es una CPU común: lo que corre aquí es lo que llamamos plano de control. Los mensajes dirigidos al propio router, como un ping a su dirección, también suelen terminar aquí, y por eso un router puede responder lento a un ping aunque esté haciendo forwarding sin problema.
En la práctica. En nuestros laboratorios, un “router” es un contenedor de Linux. El kernel hace forwarding en software, y el fabric es, en el fondo, memoria y una CPU. No hay TCAM ni crossbar, pero la lógica es la misma: tabla, lookup, cola de salida.
Dónde se forman las colas
Si el fabric es tan rápido como la suma de las entradas, nunca se acumula nada al entrar. Las colas aparecen a la salida, cuando llegan datos para un enlace más rápido de lo que este puede transmitirlos. Es la misma cola de la semana 1, y ahora sabemos dónde vive.
Si el fabric es más lento, aparecen también a la entrada, y con un efecto molesto: head of the line blocking. Un datagrama al frente de la cola espera porque su salida está ocupada, y todos los de atrás esperan con él, aunque sus salidas estén libres. La solución común es tener en cada entrada una cola por cada salida (virtual output queues).
Cuando un buffer se llena, hay que descartar algo. Una cola de salida grande pierde menos, pero agrega retardo: es el bufferbloat que estudiaremos en la semana 11.
Una cola, medida
Veámoslo en la topología. Creamos un cuello de botella en r1: 10 Mbit/s hacia
r3, con un buffer limitado. La herramienta es tc, el control de tráfico de
Linux, y tbf (token bucket filter) es el limitador:
docker exec clab-w04-fwd-r1 tc qdisc add dev eth3 root handle 1: tbf \
    rate 10mbit burst 16kb limit 256kb
Con la red tranquila, un ping de h1 a h3 tarda una fracción de
milisegundo. Luego llenamos el enlace con iperf3 y volvemos a medir. Los
números dependen de la máquina; tres repeticiones en la computadora del curso
dieron esto:
| Repetición | RTT promedio sin carga | RTT promedio con iperf3 |
Cola en r1 (paquetes) |
|---|---|---|---|
| 1 | 0,145 ms | 177,939 ms | 154 |
| 2 | 0,054 ms | 178,672 ms | 143 |
| 3 | 0,049 ms | 178,785 ms | 144 |
La salida de tc muestra la cola en ese instante, en la repetición 1:
$ docker exec clab-w04-fwd-r1 tc -s qdisc show dev eth3
qdisc tbf 1: root refcnt 15 rate 10Mbit burst 16Kb lat 197ms
 Sent 6296487 bytes 4186 pkt (dropped 9, overlimits 11001 requeues 0)
 backlog 233156b 154p requeues 0
Hay 233 156 bytes esperando. A 10 Mbit/s, eso se tarda 233 156 × 8 / 10⁷ ≈ 187
ms en transmitir, muy cerca del retardo que medimos. El RTT subió más de mil veces y el enlace no cambió: todo ese retardo es tiempo en una
cola. Los dropped son los paquetes que no cupieron, y son la señal que TCP usa
para bajar la velocidad.
Scheduling
Una vez que hay cola, alguien decide qué sale primero:
- FIFO: en orden de llegada. Es lo que acabamos de medir.
- Prioridad: los paquetes se clasifican en clases, y siempre sale primero el de la clase más alta que tenga algo en cola. Una clase alta puede dejar sin servicio a las demás.
- Round robin y weighted fair queueing (WFQ): se atiende a las clases por turnos, y cada una recibe una fracción garantizada del enlace, según su peso.
Podemos probar prioridad estricta. Agregamos, debajo del limitador, una
disciplina prio con tres bandas, y marcamos con nftables los paquetes ICMP
para la banda más alta:
docker exec clab-w04-fwd-r1 tc qdisc add dev eth3 parent 1:1 handle 10: prio
docker exec clab-w04-fwd-r1 nft add table ip qos
docker exec clab-w04-fwd-r1 nft add chain ip qos mark_icmp \
    '{ type filter hook forward priority 0; }'
docker exec clab-w04-fwd-r1 nft add rule ip qos mark_icmp \
    ip protocol icmp meta priority set 10:1
Con el mismo iperf3 encima, el ping ya no espera:
8 packets transmitted, 8 packets received, 0% packet loss
round-trip min/avg/max = 0.037/0.117/0.217 ms
class prio 10:1 parent 10:
 Sent 784 bytes 8 pkt (dropped 0, overlimits 0 requeues 0)
 backlog 0b 0p requeues 0
class prio 10:2 parent 10:
 Sent 6090187 bytes 4032 pkt (dropped 0, overlimits 0 requeues 0)
 backlog 364874b 241p requeues 0
La banda de TCP, 10:2, sigue con 241 paquetes en cola. La banda de ICMP,
10:1, está vacía: cada ping se adelanta a todos. Es exactamente lo que se
hace en una red que lleva voz, aunque ahí se clasifica por el campo DSCP del
encabezado y no por el protocolo.
Idea clave. Una cola no se puede evitar si llega más de lo que sale, pero sí se puede decidir a quién le toca esperar. Ese es el poder, y el riesgo, de que un router pueda tratar distinto a los paquetes. Es el centro del debate sobre neutralidad de red.
Salto por salto: qué cambia
Cerremos la Sesión A con la pregunta central de esta parte del curso. Un
datagrama cruza h1 → r1 → r3 → h3. ¿Qué cambia en cada salto? Capturamos el
mismo ping en tres enlaces con tcpdump -e, que también muestra el encabezado
de Ethernet:
[h1.eth1]
06:45:37.586934 aa:c1:ab:ab:19:72 > aa:c1:ab:93:e2:1d, ethertype IPv4 (0x0800), length 98: (tos 0x0, ttl 64, id 27682, offset 0, flags [DF], proto ICMP (1), length 84)
    10.200.1.10 > 10.200.3.10: ICMP echo request, id 147, seq 0, length 64
[r1.eth3]
06:45:37.586949 aa:c1:ab:28:28:61 > aa:c1:ab:ed:eb:db, ethertype IPv4 (0x0800), length 98: (tos 0x0, ttl 63, id 27682, offset 0, flags [DF], proto ICMP (1), length 84)
    10.200.1.10 > 10.200.3.10: ICMP echo request, id 147, seq 0, length 64
[r3.eth1]
06:45:37.586956 aa:c1:ab:6c:6f:c8 > aa:c1:ab:d2:bb:08, ethertype IPv4 (0x0800), length 98: (tos 0x0, ttl 62, id 27682, offset 0, flags [DF], proto ICMP (1), length 84)
    10.200.1.10 > 10.200.3.10: ICMP echo request, id 147, seq 0, length 64
Con las direcciones MAC de esa ejecución, armamos la tabla:
| Enlace | MAC de origen | MAC de destino | IP de origen | IP de destino | TTL |
|---|---|---|---|---|---|
h1–r1 |
…ab:19:72 (h1) |
…93:e2:1d (r1 eth1) |
10.200.1.10 |
10.200.3.10 |
64 |
r1–r3 |
…28:28:61 (r1 eth3) |
…ed:eb:db (r3 eth3) |
10.200.1.10 |
10.200.3.10 |
63 |
r3–h3 |
…6c:6f:c8 (r3 eth1) |
…d2:bb:08 (h3) |
10.200.1.10 |
10.200.3.10 |
62 |
Tres cosas para ver. Las direcciones IP no cambian: dicen de dónde viene y a
dónde va el datagrama. Las direcciones MAC cambian en cada enlace: dicen
quién envía y quién recibe en este tramo. El router saca el datagrama del frame
que llegó, decide y lo mete en un frame nuevo. Y el TTL baja en 1 en cada
router, con su checksum recalculado. Por último, el id sigue igual: es el
mismo datagrama.
Error común. Creer que la dirección MAC de destino es la del host final. En un
tcpdumpenh1, la MAC de destino es la der1, y el destino IP es el deh3. Son los dos niveles de la semana 3 y de esta, uno dentro del otro: IP dice el destino final, y Ethernet, el próximo paso.
Y nadie obliga a la respuesta a pasar por los mismos routers. Lo vemos en la Sesión B.
ICMP
IP no promete entregar nada, pero sería cruel que nadie avisara cuando algo falla. ICMP (Internet Control Message Protocol, RFC 792) es el canal por el que routers y hosts se envían mensajes de error y de diagnóstico.
ICMP viaja dentro de IP, con protocolo 1, como si fuera un protocolo de transporte. Se suele decir que es parte de la capa de red, porque IP lo necesita para funcionar, pero sus mensajes son datos de IP. Un mensaje tiene un tipo, un código y un checksum. Los de error llevan además el comienzo del datagrama que causó el problema: el encabezado IP y al menos los primeros 8 bytes de sus datos, que alcanzan para ver los puertos de TCP o UDP. Así, el origen sabe a qué conexión se refiere.
| Tipo | Código | Nombre | Quién lo envía, y cuándo |
|---|---|---|---|
| 8 | 0 | Echo request | ping |
| 0 | 0 | Echo reply | El destino, en respuesta |
| 3 | 0 | Network unreachable | Un router sin ruta |
| 3 | 1 | Host unreachable | El último router, si ARP no obtiene respuesta |
| 3 | 3 | Port unreachable | El destino, si nadie escucha en ese puerto UDP |
| 3 | 4 | Fragmentation needed | Un router, si un datagrama con DF no cabe |
| 11 | 0 | Time exceeded | Un router, si el TTL llega a 0 |
Nunca se envía un error ICMP sobre otro error ICMP, ni sobre un broadcast, ni sobre un fragmento que no sea el primero. Si no, un problema podría multiplicar los mensajes en vez de informarlos. Los routers también limitan cuántos envían por segundo.
Los tres errores, en vivo
Todos estos se capturaron en h1. Primero, sin ruta. r1 no sabe llegar a
la LAN de h2, y responde desde su propia dirección:
06:45:18.095443 IP (tos 0x0, ttl 64, id 12592, offset 0, flags [DF], proto ICMP (1), length 84)
    10.200.1.10 > 10.200.2.10: ICMP echo request, id 92, seq 0, length 64
06:45:18.095510 IP (tos 0xc0, ttl 64, id 12583, offset 0, flags [none], proto ICMP (1), length 112)
    10.200.1.1 > 10.200.1.10: ICMP net 10.200.2.10 unreachable, length 92
	IP (tos 0x0, ttl 64, id 12592, offset 0, flags [DF], proto ICMP (1), length 84)
    10.200.1.10 > 10.200.2.10: ICMP echo request, id 92, seq 0, length 64
Observen la tercera línea en adelante: tcpdump decodifica el datagrama
original, que viene adentro del error. (ping de BusyBox no imprime este error,
solo dice que hubo 100 % de pérdida. Por eso capturamos.)
Host que no existe. La ruta está y el paquete llega hasta r3, pero
10.200.3.99 no responde a ARP. r3 lo intenta y se rinde:
06:45:59.892490 IP (tos 0x0, ttl 64, id 18971, offset 0, flags [DF], proto ICMP (1), length 84)
    10.200.1.10 > 10.200.3.99: ICMP echo request, id 180, seq 0, length 64
06:46:02.946888 IP (tos 0xc0, ttl 63, id 54499, offset 0, flags [none], proto ICMP (1), length 112)
    10.200.13.2 > 10.200.1.10: ICMP host 10.200.3.99 unreachable, length 92
	IP (tos 0x0, ttl 62, id 18971, offset 0, flags [DF], proto ICMP (1), length 84)
    10.200.1.10 > 10.200.3.99: ICMP echo request, id 180, seq 0, length 64
Lleva 3 segundos de espera: son los reintentos de ARP. La copia interna tiene
ttl 62, porque así estaba el datagrama cuando r3 se rindió. El error en sí
viene con ttl 63: salió de r3 con 64 y cruzó r1.
Nadie en ese puerto. El host existe, pero ninguna aplicación escucha en el puerto UDP 9999. Quien responde es el propio destino:
06:46:08.994519 IP (tos 0x0, ttl 64, id 37373, offset 0, flags [DF], proto UDP (17), length 33)
    10.200.1.10.35713 > 10.200.3.10.9999: UDP, length 5
06:46:08.994630 IP (tos 0xc0, ttl 62, id 42321, offset 0, flags [none], proto ICMP (1), length 61)
    10.200.3.10 > 10.200.1.10: ICMP 10.200.3.10 udp port 9999 unreachable, length 41
	IP (tos 0x0, ttl 62, id 37373, offset 0, flags [DF], proto UDP (17), length 33)
    10.200.1.10.35713 > 10.200.3.10.9999: UDP, length 5
Quien envía el error dice mucho sobre dónde está el problema: el primer router, el último o el destino mismo. Esa es la información con la que se diagnostica una red.
traceroute
traceroute no tiene ningún protocolo propio. Es un truco inteligente con dos
errores de ICMP. Envía datagramas UDP a un puerto alto, seguramente sin uso, con
TTL 1, luego 2, luego 3:
- El primer router que recibe un datagrama con TTL 1 le resta 1, lo descarta y envía Time exceeded. Su dirección de origen revela quién es.
- Cuando el TTL alcanza, el datagrama llega al destino, y este responde Port unreachable. Esa es la señal de que se terminó.
Ya usaron traceroute en P0, y lo escribieron ustedes mismos. Ahora veamos lo
que pasa por debajo, con una sola sonda por salto (-q1) y capturando en r1:
$ docker exec clab-w04-fwd-h1 traceroute -n -q1 -w1 10.200.3.10
traceroute to 10.200.3.10 (10.200.3.10), 30 hops max, 46 byte packets
 1  10.200.1.1  0.003 ms
 2  10.200.13.2  0.002 ms
 3  10.200.3.10  0.000 ms
06:46:16.067892 IP 10.200.1.10.50136 > 10.200.3.10.33435: UDP, length 18
06:46:16.067920 IP 10.200.1.1 > 10.200.1.10: ICMP time exceeded in-transit, length 54
06:46:16.067945 IP 10.200.1.10.50136 > 10.200.3.10.33436: UDP, length 18
06:46:16.067969 IP 10.200.13.2 > 10.200.1.10: ICMP time exceeded in-transit, length 54
06:46:16.067979 IP 10.200.1.10.50136 > 10.200.3.10.33437: UDP, length 18
06:46:16.067992 IP 10.200.3.10 > 10.200.1.10: ICMP 10.200.3.10 udp port 33437 unreachable, length 54Cada sonda usa otro puerto de destino, y el error ICMP lo trae de vuelta en su
copia del original: así traceroute empareja respuestas con sondas. Los tiempos
que muestra aquí son ínfimos porque todos los nodos comparten el kernel de una
misma computadora; no se les puede sacar nada.
¿Qué pasa si un router no envía el error? Esa es la pregunta de repaso.
Probémoslo: en r3 descartamos con nftables los Time exceeded de salida, con
la ruta /32 por r2 activa para que el camino tenga cuatro saltos.
$ docker exec clab-w04-fwd-h1 traceroute -n -w1 10.200.3.10
traceroute to 10.200.3.10 (10.200.3.10), 30 hops max, 46 byte packets
 1  10.200.1.1  0.003 ms  0.005 ms  0.002 ms
 2  10.200.12.2  0.001 ms  0.002 ms  0.002 ms
 3  *  *  *
 4  10.200.3.10  0.003 ms  0.002 ms  0.002 ms
El router sigue haciendo forwarding sin problema: el salto 4 responde. Los asteriscos quieren decir “no me llegó respuesta”, no que el paquete se perdió. Muchos routers de Internet están configurados así.
Lo que traceroute no dice
Con esa misma ruta /32 y sin el filtro, el camino de h1 a h3 es este:
$ docker exec clab-w04-fwd-h1 traceroute -n -w1 10.200.3.10
traceroute to 10.200.3.10 (10.200.3.10), 30 hops max, 46 byte packets
 1  10.200.1.1  0.004 ms  0.003 ms  0.004 ms
 2  10.200.12.2  0.001 ms  0.003 ms  0.002 ms
 3  10.200.13.2  0.001 ms  0.004 ms  0.002 ms
 4  10.200.3.10  0.000 ms  0.003 ms  0.001 ms
Miren el salto 3. El paquete viene de r2 y entra a r3 por eth2, cuya
dirección es 10.200.23.2. Pero traceroute muestra 10.200.13.2, la de
eth3. Y es que r3, para enviar el Time exceeded, elige como origen la
dirección de la interfaz por la que sale ese mensaje, y el destino del
mensaje es h1, al que r3 llega por eth3. Linux actúa así por defecto (lo
cambia el sysctl icmp_errors_use_inbound_ifaddr), y muchos routers hacen algo
parecido. Por eso, traceroute les dice qué routers hay, pero no por cuál
interfaz entró el paquete. De hecho, parece que el camino va de r2 a
10.200.13.2, dos direcciones que ni siquiera comparten enlace.
También hay un camino de vuelta que traceroute no muestra: es el de otro
traceroute, en sentido contrario.
$ docker exec clab-w04-fwd-h3 traceroute -n -w1 10.200.1.10
traceroute to 10.200.1.10 (10.200.1.10), 30 hops max, 46 byte packets
 1  10.200.3.1  0.003 ms  0.003 ms  0.003 ms
 2  10.200.12.1  0.001 ms  0.003 ms  0.002 ms
 3  10.200.1.10  0.002 ms  0.004 ms  0.002 ms
De h3 a h1 son tres saltos, no cuatro: la ruta específica solo está en r1,
y r3 sigue yendo directo. El mismo salto 2 muestra el efecto de antes: r1
recibió el paquete por eth3, pero responde con 10.200.12.1, porque ahora a
h3 lo alcanza por eth2. Comprobémoslo capturando en r2 y en r3 un solo
ping de h1 a h3:
[r2.eth3]
06:45:25.922052 IP 10.200.1.10 > 10.200.3.10: ICMP echo request, id 122, seq 0, length 64

[r3.eth3]
06:45:25.922069 IP 10.200.3.10 > 10.200.1.10: ICMP echo reply, id 122, seq 0, length 64
El pedido pasa por r2. La respuesta, por el enlace directo. Esto es routing
asimétrico, y en Internet es lo normal: cada router decide solo, y lo que
decide uno no obliga a nadie.
Idea clave. Forwarding se decide salto por salto y solo mira el destino. Por eso, un cambio en un router afecta los caminos que pasan por él, y nada más. Un
traceroutemuestra la ida, y solo eso. Cuando un usuario reclama “la vuelta es lenta”, hay que medir desde el otro lado.
DHCP
Para hablar con IP, un host necesita saber cuatro cosas: su dirección, la máscara, el router por defecto y, normalmente, un servidor de nombres. Nadie escribe eso a mano en una laptop. DHCP (Dynamic Host Configuration Protocol, RFC 2131) se las entrega al conectarse.
El problema tiene gracia: ¿cómo pide una dirección alguien que todavía no tiene
una, a un servidor del que no conoce ni la dirección? Enviando a todos, desde
nadie. DHCP corre sobre UDP (puerto 67 en el servidor y 68 en el cliente), y sus
primeros mensajes salen desde 0.0.0.0 hacia 255.255.255.255, en un frame con
destino ff:ff:ff:ff:ff:ff.
 cliente                                                servidor
    |  DISCOVER  (origen 0.0.0.0, destino broadcast)        |
    | ----------------------------------------------------> |
    |                     OFFER  (te ofrezco .100, 600 s)   |
    | <---------------------------------------------------- |
    |  REQUEST   (quiero .100, del servidor .1)             |
    | ----------------------------------------------------> |
    |                     ACK    (es tuya por 600 s)        |
    | <---------------------------------------------------- |
¿Por qué REQUEST también va por broadcast, si el cliente ya conoce al
servidor? Porque en una red puede haber más de un servidor, y todos hicieron su
oferta. Al ver el REQUEST, que nombra al elegido, los demás saben que su
oferta no se aceptó y liberan esa dirección. Es más: el cliente aún no ha
confirmado nada y sigue sin poder usar la dirección como origen.
La dirección es una concesión (lease) con plazo. Si el cliente sigue usándola, la renueva antes de que venza, directamente con su servidor; si desaparece, la dirección vuelve a estar libre. Si el servidor está en otra subred, un DHCP relay en el router reenvía los mensajes, porque un broadcast no cruza routers.
En vivo
Usamos la segunda topología, nat/nat.clab.yml:
   a1 ---+
   a2 ---+-- sw --- gw ======= isp --- ext
   a3 ---+
     10.200.50.0/24   100.64.0.0/30   100.64.9.0/24
a3 arranca sin dirección IPv4. Como la imagen de los routers no trae un
servidor DHCP, gw corre nat/dhcp_server.py, unas cien líneas de Python
escritas para esta clase. El cliente sí es real: udhcpc, de BusyBox.
make up-nat
docker exec -d clab-w04-nat-gw sh -c 'python3 /opt/dhcp_server.py eth1 \
    10.200.50.1 10.200.50.100 10.200.50.110 > /tmp/dhcp.log 2>&1'
docker exec clab-w04-nat-a3 udhcpc -i eth1 -n -q -f
udhcpc: started, v1.36.1
udhcpc: broadcasting discover
udhcpc: broadcasting select for 10.200.50.100, server 10.200.50.1
udhcpc: lease of 10.200.50.100 obtained from 10.200.50.1, lease time 600Con tcpdump -e -v en el puerto del switch hacia a3, los dos primeros
mensajes se ven así (recortamos el pedido de parámetros):
06:48:16.014844 aa:c1:ab:37:a1:5c > ff:ff:ff:ff:ff:ff, ethertype IPv4 (0x0800), length 342: (tos 0x0, ttl 64, id 0, offset 0, flags [none], proto UDP (17), length 328)
    0.0.0.0.68 > 255.255.255.255.67: BOOTP/DHCP, Request from aa:c1:ab:37:a1:5c, length 300, xid 0xc944a441, Flags [none]
	  Client-Ethernet-Address aa:c1:ab:37:a1:5c
	  Vendor-rfc1048 Extensions
	    Magic Cookie 0x63825363
	    DHCP-Message (53), length 1: Discover
	    ...
06:48:16.015045 aa:c1:ab:db:70:c5 > ff:ff:ff:ff:ff:ff, ethertype IPv4 (0x0800), length 310: (tos 0x0, ttl 64, id 22671, offset 0, flags [DF], proto UDP (17), length 296)
    10.200.50.1.67 > 255.255.255.255.68: BOOTP/DHCP, Reply, length 268, xid 0xc944a441, Flags [none]
	  Your-IP 10.200.50.100
	  Server-IP 10.200.50.1
	  Client-Ethernet-Address aa:c1:ab:37:a1:5c
	  Vendor-rfc1048 Extensions
	    Magic Cookie 0x63825363
	    DHCP-Message (53), length 1: Offer
	    Server-ID (54), length 4: 10.200.50.1
	    Lease-Time (51), length 4: 600
	    Subnet-Mask (1), length 4: 255.255.255.0
	    Default-Gateway (3), length 4: 10.200.50.1
Hay cuatro cosas para leer aquí. tcpdump dice Request y Reply en la
primera línea de cada mensaje porque esos son los códigos de operación de BOOTP,
el protocolo del cual viene DHCP. El tipo real de mensaje está en la opción
53. Después, el xid es el identificador de la transacción: el cliente
reconoce con él la respuesta a su pedido. Luego, Your-IP es la dirección
ofrecida, y el resto llega como opciones. Por último, como el mensaje es un
broadcast, a2 también lo ve:
06:48:16.014878 aa:c1:ab:37:a1:5c > ff:ff:ff:ff:ff:ff, ethertype IPv4 (0x0800), length 342: 0.0.0.0.68 > 255.255.255.255.67: BOOTP/DHCP, Request from aa:c1:ab:37:a1:5c, length 300Después del intercambio, a3 tiene todo lo que necesita:
$ docker exec clab-w04-nat-a3 ip -br addr show dev eth1
eth1@if3501      UP             10.200.50.100/24 fe80::a8c1:abff:fe37:a15c/64
$ docker exec clab-w04-nat-a3 ip route
default via 10.200.50.1 dev eth1 metric 3702
10.200.50.0/24 dev eth1 proto kernel scope link src 10.200.50.100
172.90.4.128/25 dev eth0 proto kernel scope link src 172.90.4.131
Error común. Creer que el RFC obliga al servidor a responder por broadcast. Nuestro servidor lo hace siempre porque es lo más simple. El RFC 2131 dice que, si el cliente no encendió el bit de broadcast (aquí
Flags [none]), el servidor le responde por unicast, a la MAC del cliente. Lo que sí va siempre por broadcast es lo que envía el cliente antes de tener dirección.
NAT
Las direcciones de 32 bits alcanzan para poco más de 4 mil millones de interfaces, y eso no da para todas las laptops, celulares y sensores del planeta. NAT nació como un parche para ganar tiempo y terminó siendo parte de casi toda red de hogar y de muchas de oficina.
La idea: la red de adentro usa direcciones privadas, las de RFC 1918, que cualquiera puede reutilizar y que no tienen ruta en Internet. Un router de borde tiene al menos una dirección pública, y reescribe los datagramas que cruzan: cambia la dirección y el puerto de origen al salir, y deshace el cambio al volver.
Sin NAT, no funciona
En nuestra topología, isp no conoce la red 10.200.50.0/24, igual que un
proveedor real no lleva rutas a direcciones privadas. Si a1 hace ping a ext, el
pedido llega. La respuesta no tiene cómo volver.
[gw.eth2]
06:48:23.333424 IP 10.200.50.10 > 100.64.9.10: ICMP echo request, id 74, seq 0, length 64
$ docker exec clab-w04-nat-isp ip route get 10.200.50.10
RTNETLINK answers: Network unreachableLa traducción
En gw, con nftables, la regla es una sola. Este es nat/masquerade.nft:
# NAT de salida: lo que viene de la LAN y sale por eth2 toma la dirección de eth2.
flush ruleset
table ip nat {
    chain postrouting {
        type nat hook postrouting priority srcnat; policy accept;
        ip saddr 10.200.50.0/24 oifname "eth2" masquerade
    }
}
Una cadena de tipo nat se engancha a un punto del camino del paquete.
postrouting es justo antes de salir, cuando ya se decidió por dónde sale. La
regla dice: si viene de la LAN y sale por eth2, cambia el origen por la
dirección de esa interfaz. Eso es masquerade. Carguémosla y hagamos el mismo
ping:
[gw.eth1]
06:48:32.642207 IP 10.200.50.10 > 100.64.9.10: ICMP echo request, id 80, seq 0, length 64
06:48:32.642259 IP 100.64.9.10 > 10.200.50.10: ICMP echo reply, id 80, seq 0, length 64
[gw.eth2]
06:48:32.642220 IP 100.64.0.2 > 100.64.9.10: ICMP echo request, id 80, seq 0, length 64
06:48:32.642255 IP 100.64.9.10 > 100.64.0.2: ICMP echo reply, id 80, seq 0, length 64
[ext.eth1]
06:48:32.642228 IP 100.64.0.2 > 100.64.9.10: ICMP echo request, id 80, seq 0, length 64
06:48:32.642251 IP 100.64.9.10 > 100.64.0.2: ICMP echo reply, id 80, seq 0, length 64
El mismo paquete, a cada lado del router. Adentro, el origen es 10.200.50.10;
afuera, es 100.64.0.2. ext nunca se entera de que existe a1. Y la
respuesta, que llega a gw dirigida a 100.64.0.2, sale hacia a1 con el
destino reescrito.
La tabla de traducción
¿Cómo sabe gw a quién devolver una respuesta? Guarda una tabla de
traducción con una fila por conexión. En Linux la mantiene conntrack, el
seguimiento de conexiones del kernel:
$ docker exec clab-w04-nat-gw conntrack -L -p icmp
conntrack v1.4.8 (conntrack-tools): 2 flow entries have been shown.
icmp     1 14 src=10.200.50.10 dst=100.64.9.10 type=8 code=0 id=74 [UNREPLIED] src=100.64.9.10 dst=10.200.50.10 type=0 code=0 id=74 mark=0 use=1
icmp     1 23 src=10.200.50.10 dst=100.64.9.10 type=8 code=0 id=80 src=100.64.9.10 dst=100.64.0.2 type=0 code=0 id=80 mark=0 use=1
La segunda fila es este ping. Cada fila tiene dos mitades: lo que se vio al ir
(src=10.200.50.10) y lo que se espera al volver (dst=100.64.0.2). La diferencia
entre las dos es la traducción. El número 23 son los segundos que le quedan a la
fila si no hay más tráfico. ICMP no tiene puertos, y para eso usa el campo id.
La primera fila es el ping anterior, el de antes de cargar la regla: conntrack
sigue todos los paquetes, con NAT o sin él. Lleva [UNREPLIED] porque nunca volvió
nada, y sus dos mitades son iguales porque no hubo traducción.
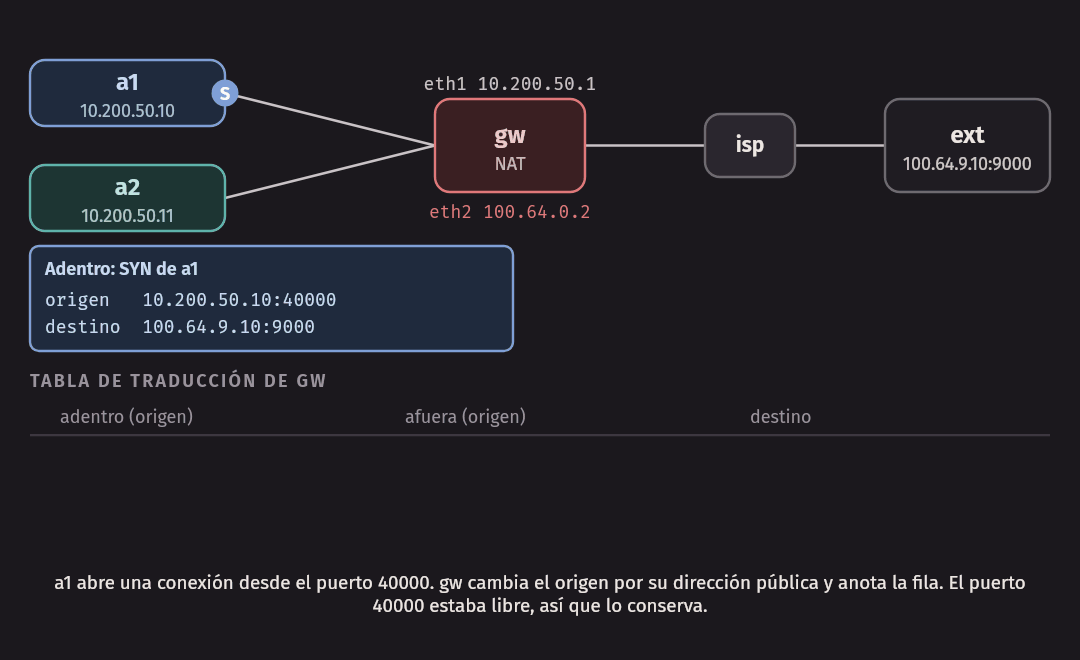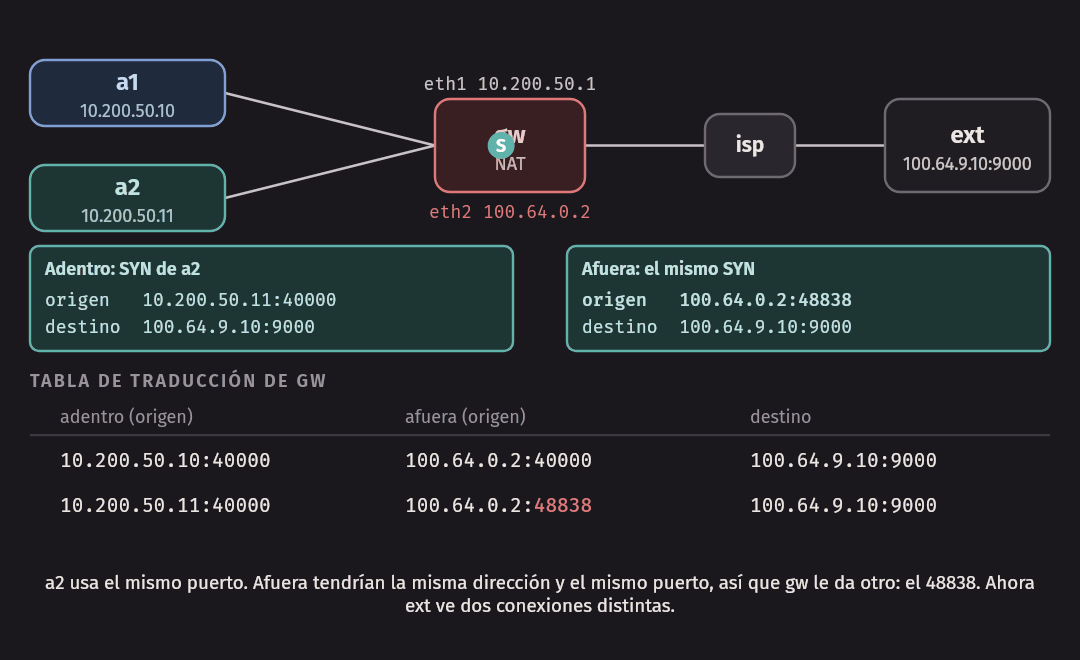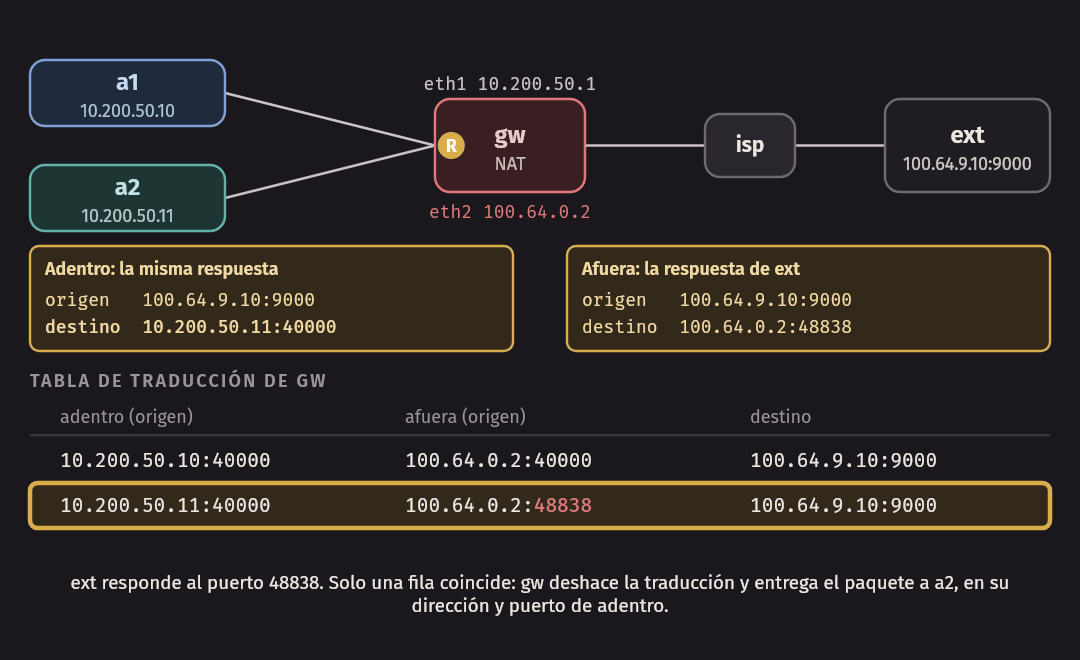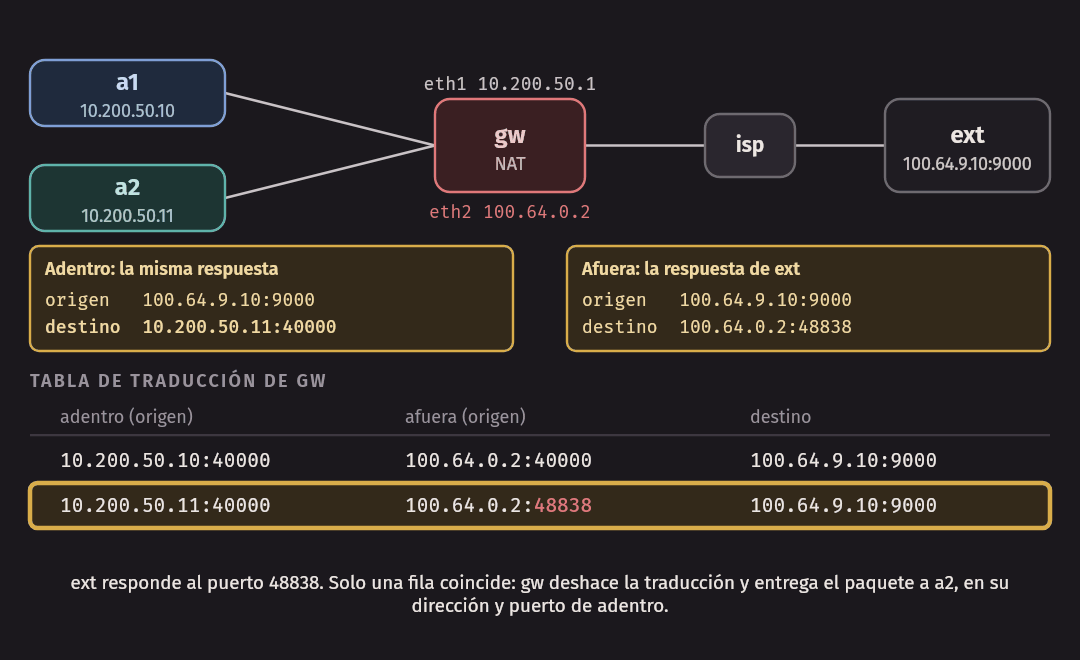
Dos hosts, un solo puerto. Pongamos el caso difícil: a1 y a2 se conectan
al mismo servidor, desde el mismo puerto local 40000. Afuera, los dos tienen la
misma dirección. Si gw no hiciera algo más, ext vería dos conexiones
idénticas.
$ docker exec clab-w04-nat-gw conntrack -L -p tcp
tcp      6 431997 ESTABLISHED src=10.200.50.11 dst=100.64.9.10 sport=40000 dport=9000 src=100.64.9.10 dst=100.64.0.2 sport=9000 dport=48838 [ASSURED] mark=0 use=1
tcp      6 431997 ESTABLISHED src=10.200.50.10 dst=100.64.9.10 sport=40000 dport=9000 src=100.64.9.10 dst=100.64.0.2 sport=9000 dport=40000 [ASSURED] mark=0 use=1
conntrack v1.4.8 (conntrack-tools): 2 flow entries have been shown.
Lo que llega a ext son dos conexiones distintas, con distinto puerto:
06:48:39.770616 IP 100.64.0.2.40000 > 100.64.9.10.9000: Flags [S], seq 3040336838, win 64240, options [mss 1460,sackOK,TS val 2426135484 ecr 0,nop,wscale 7], length 0
06:48:39.822139 IP 100.64.0.2.48838 > 100.64.9.10.9000: Flags [S], seq 1785326165, win 64240, options [mss 1460,sackOK,TS val 2476650052 ecr 0,nop,wscale 7], length 0
La primera conexión conservó su puerto, porque estaba libre. La segunda recibió otro, elegido por el NAT. Así, la tabla queda como esta:
| Adentro (origen) | Afuera (origen) | Destino |
|---|---|---|
10.200.50.10:40000 |
100.64.0.2:40000 |
100.64.9.10:9000 |
10.200.50.11:40000 |
100.64.0.2:48838 |
100.64.9.10:9000 |
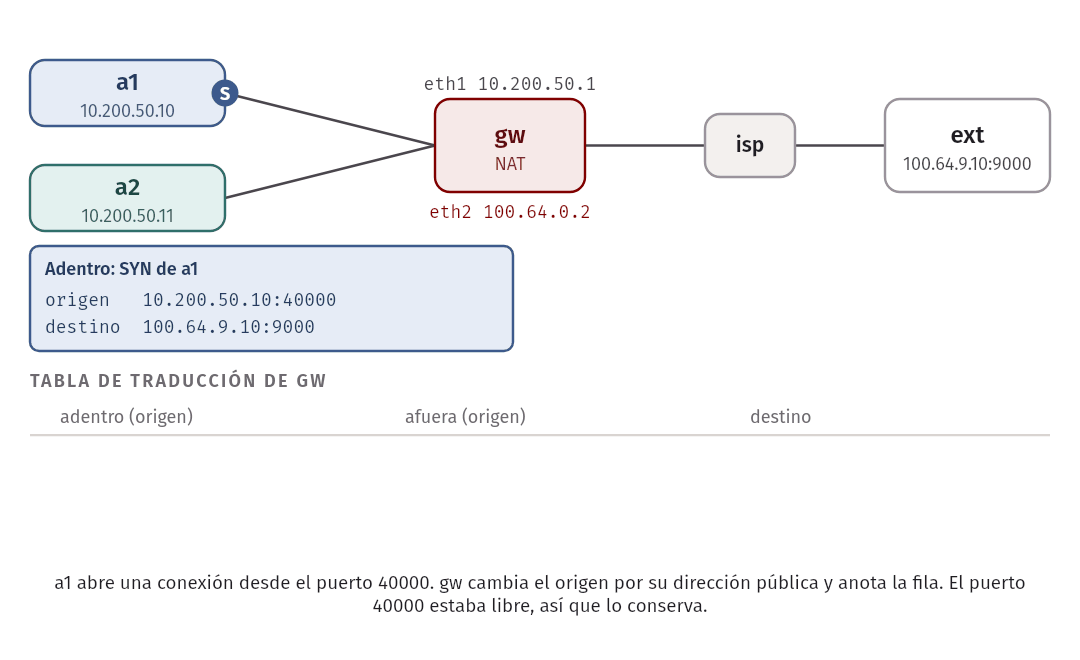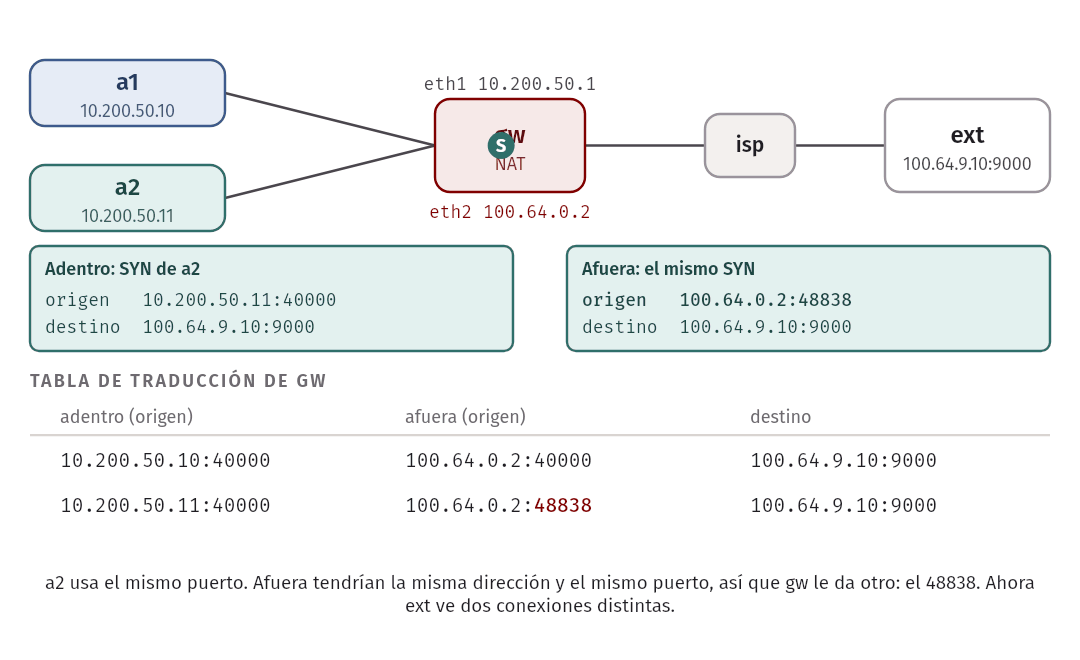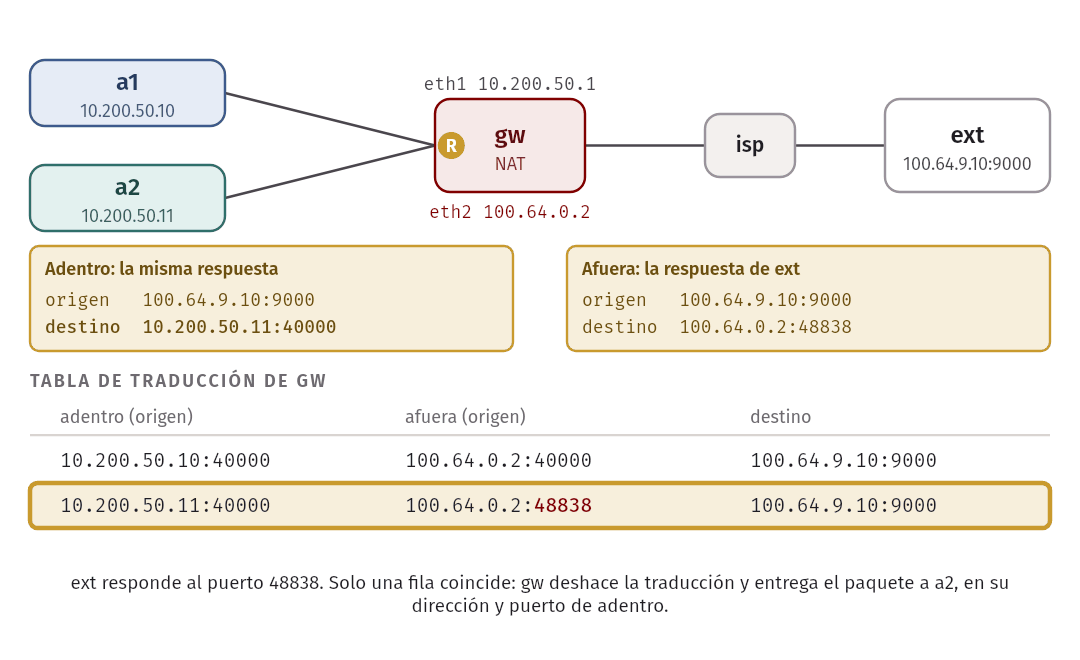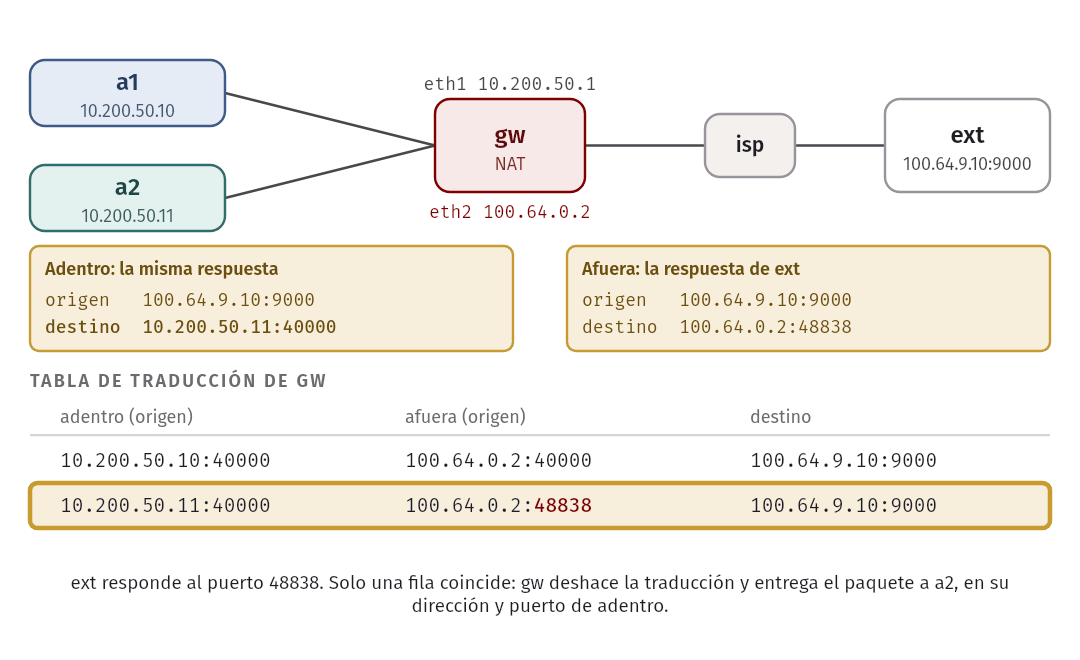
Cuando llega una respuesta a 100.64.0.2:48838, solo una fila coincide, y el
NAT sabe que es para a2. Por eso se suele decir NAPT (network address and port
translation). Con 16 bits de puerto, una sola dirección pública alcanza para
decenas de miles de conexiones simultáneas hacia un mismo destino.
El NAT cambia más de lo que se ve a primera vista. El checksum del encabezado IP cambia, porque cambió la dirección. El de TCP también, porque se calcula sobre un pseudo-encabezado con las direcciones. En el recorrido del final veremos esos dos valores.
Idea clave. Un NAT tiene estado. Un router normal no recuerda nada de un paquete al siguiente; un NAT sí, y si se reinicia sin esa tabla, todas las conexiones de la red se cortan. Eso rompe la idea de que los routers de la red no guardan estado por conexión, que discutimos en la semana 2.
Conexiones entrantes
La tabla se llena con lo que sale. ¿Y lo que quiere entrar? Desde ext,
intentemos llegar a a1:
$ docker exec clab-w04-nat-ext curl -sS --connect-timeout 2 http://10.200.50.10:8080/
curl: (7) Failed to connect to 10.200.50.10 port 8080 after 0 ms: Could not connect to server
06:48:55.015855 IP 100.64.9.10.41568 > 10.200.50.10.8080: Flags [S], seq 2854544516, win 64240, options [mss 1460,sackOK,TS val 2636656427 ecr 0,nop,wscale 7], length 0
06:48:55.015913 IP 100.64.9.1 > 100.64.9.10: ICMP net 10.200.50.10 unreachable, length 68La dirección privada no sirve de nada afuera: el primer router la rechaza. ¿Y si
se dirige a la pública? gw la recibe, no tiene ninguna fila en la tabla, y
como él mismo no escucha en ese puerto responde con un RST, aunque a1 sí tenga
un servidor en el puerto 8080:
$ docker exec clab-w04-nat-ext curl -sS --connect-timeout 2 http://100.64.0.2:8080/
curl: (7) Failed to connect to 100.64.0.2 port 8080 after 0 ms: Could not connect to server
06:49:03.165747 IP 100.64.9.10.57644 > 100.64.0.2.8080: Flags [S], seq 1619685849, win 64240, options [mss 1460,sackOK,TS val 421118166 ecr 0,nop,wscale 7], length 0
06:49:03.165768 IP 100.64.0.2.8080 > 100.64.9.10.57644: Flags [R.], seq 0, ack 1619685850, win 0, length 0Para resolverlo hay que crear la fila a mano: una redirección de puerto
(port forwarding). Esta vez se cambia el destino, y antes de decidir la ruta.
Este es nat/dnat_demo.nft:
# Redirección de puerto: lo que llega por eth2 al puerto 8080 de gw va a a1.
# Se agrega encima de masquerade.nft.
table ip nat {
    chain prerouting {
        type nat hook prerouting priority dstnat; policy accept;
        iifname "eth2" tcp dport 8080 dnat to 10.200.50.10:8080
    }
}
Tiene que ser en prerouting: si el destino sigue siendo 100.64.0.2 cuando el
router decide, el paquete se entrega a gw mismo. Ahora sí:
$ docker exec clab-w04-nat-ext sh -c 'echo x | nc -w2 100.64.0.2 8080'
hola-desde-a1
$ docker exec clab-w04-nat-gw conntrack -L -p tcp --dport 8080
tcp      6 9 CLOSE src=100.64.9.10 dst=100.64.0.2 sport=38369 dport=8080 src=10.200.50.10 dst=100.64.9.10 sport=8080 dport=38369 [ASSURED] mark=0 use=1
El SYN, a cada lado de gw:
[gw.eth2]
06:49:10.367172 IP 100.64.9.10.38369 > 100.64.0.2.8080: Flags [S], seq 1657360769, win 64240, options [mss 1460,sackOK,TS val 421125367 ecr 0,nop,wscale 7], length 0
[gw.eth1]
06:49:10.367193 IP 100.64.9.10.38369 > 10.200.50.10.8080: Flags [S], seq 1657360769, win 64240, options [mss 1460,sackOK,TS val 421125367 ecr 0,nop,wscale 7], length 0
El origen no cambió: a1 ve la dirección real de ext, y su respuesta vuelve
por gw, que es su router por defecto. Y si ese no fuera su router por defecto,
la respuesta no pasaría por el NAT y la conexión fallaría. Un NAT tiene que ver
las dos direcciones de un flujo.
Error común. Tomar el NAT por un firewall. Un NAT impide las conexiones entrantes como efecto lateral, porque no sabe a quién entregarlas, pero no fue diseñado para filtrar. Si se quiere una política de seguridad, se escribe una política de seguridad. Eso lo hacemos en la semana 15, con
nftables.
En la práctica. Muchas aplicaciones entre pares, como una videollamada, tienen a los dos extremos detrás de un NAT. Ninguno puede recibir conexiones. Para eso existen técnicas como STUN y hole punching: los dos envían hacia afuera a la vez, y cada NAT abre su fila. Si nada de eso funciona, un servidor público retransmite el tráfico. Además, muchos proveedores tienen su propio NAT frente a todos sus clientes (carrier-grade NAT), y por eso existe el bloque
100.64.0.0/10. Si su celular tiene una dirección de allí, esa es la razón.
Las críticas
NAT funciona y está en todas partes, pero tiene un costo conceptual. Un puerto debería identificar procesos, no hosts. Los routers no deberían meterse en la capa de transporte ni guardar estado por conexión, y los protocolos que llevan direcciones dentro de sus datos, como FTP, se rompen. Pero la objeción mayor es que quita la posibilidad de que cualquier host le hable a cualquier otro. Internet deja de ser una red entre pares, y hay aplicaciones que nunca se llegaron a inventar.
IPv6
Con NAT se ganó tiempo, pero no direcciones. IANA, el organismo que reparte los bloques a los registros regionales, entregó sus últimos bloques IPv4 en febrero de 2011. Los registros regionales, entre ellos LACNIC, se fueron quedando sin reservas en los años siguientes. La respuesta, diseñada desde los años 90, es IPv6: direcciones de 128 bits.
No es solo ampliar el campo. También se aprovechó para simplificar, a partir de la experiencia con IPv4.
El encabezado
 0       4               12      16              24            31
+-------+---------------+-------------------------------------+
|Versión|Traffic class  |              Flow label             |
+-------+---------------+---------------+---------------------+
|        Largo de datos                 | Next hdr | Hop limit|
+---------------------------------------+----------+----------+
|                                                             |
|              Dirección de origen (128 bits)                 |
|                                                             |
+-------------------------------------------------------------+
|                                                             |
|              Dirección de destino (128 bits)                |
|                                                             |
+-------------------------------------------------------------+
Son 40 bytes fijos. Un router sabe dónde está cada campo sin calcular nada. Comparado con IPv4:
| IPv4 | IPv6 | Por qué |
|---|---|---|
| Direcciones de 32 bits | 128 bits | Es el motivo de todo |
| TTL | Hop limit | Lo mismo, con un nombre honesto |
| Protocolo | Next header | Puede ser un transporte o una extensión |
| ToS | Traffic class | Lo mismo |
| Largo total | Largo de datos | No cuenta el encabezado, que es fijo |
| IHL | Se fue | El encabezado no cambia de tamaño |
| Identificación, flags, offset | Se fueron | Los routers ya no fragmentan |
| Checksum | Se fue | El enlace y el transporte ya verifican, y así no hay que rehacerlo en cada salto |
| Opciones | Encabezados de extensión | Se encadenan con next header |
| (no existía) | Flow label | Marca paquetes del mismo flujo sin mirar los puertos |
Las direcciones se escriben en 8 grupos de 16 bits en hexadecimal, separados por
:. Se pueden omitir los ceros a la izquierda de cada grupo, y una sola
secuencia de grupos en cero se puede reemplazar por ::. Así,
2001:0db8:0001:0000:0000:0000:0000:0010 se escribe 2001:db8:1::10.
| Bloque | Tipo | Ejemplo |
|---|---|---|
2000::/3 |
Global: tiene ruta en Internet | |
2001:db8::/32 |
Para documentación y ejemplos; es el que usamos | 2001:db8:1::10 |
fe80::/10 |
Link-local: no sale de su enlace, y toda interfaz tiene una | fe80::a8c1:abff:feab:1972 |
ff00::/8 |
Multicast; en IPv6 no hay broadcast | ff02::1:ff00:1 |
::1/128 |
Loopback |
La convención es que una LAN siempre es un /64: 64 bits de red y 64 bits para
la interfaz. No hace falta el cálculo de tamaños que hicimos en IPv4. Eso
permite la autoconfiguración (SLAAC): un host escucha el prefijo que anuncia el
router y arma por sí mismo su dirección, sin un servidor DHCP.
Lo mismo, en vivo
Los nodos de nuestros laboratorios ya tienen IPv6: cada interfaz nace con su dirección link-local, sin que nadie se la asigne.
$ docker exec clab-w04-fwd-h1 ip -6 addr show dev eth1
3339: eth1@if3340: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UP group default  link-netnsid 1
    altname clab-o-fe1c283b8dc1833b
    inet6 fe80::a8c1:abff:feab:1972/64 scope link proto kernel_ll
       valid_lft forever preferred_lft forever
El script fwd/ipv6.sh da direcciones de ejemplo en el camino h1 – r1 – r3, y
escribe las rutas. Un ping de h1 a r3, capturado en h1, muestra algo que
no se parece a IPv4:
06:47:32.888670 IP6 (hlim 255, next-header ICMPv6 (58) payload length: 32) 2001:db8:1::10 > ff02::1:ff00:1: [icmp6 sum ok] ICMP6, neighbor solicitation, length 32, who has 2001:db8:1::1
	  source link-address option (1), length 8 (1): aa:c1:ab:ab:19:72
06:47:32.888699 IP6 (hlim 255, next-header ICMPv6 (58) payload length: 32) 2001:db8:1::1 > 2001:db8:1::10: [icmp6 sum ok] ICMP6, neighbor advertisement, length 32, tgt is 2001:db8:1::1, Flags [router, solicited, override]
	  destination link-address option (2), length 8 (1): aa:c1:ab:93:e2:1d
06:47:32.888702 IP6 (flowlabel 0x507a4, hlim 64, next-header ICMPv6 (58) payload length: 64) 2001:db8:1::10 > 2001:db8:13::2: [icmp6 sum ok] ICMP6, echo request, id 376, seq 0
06:47:32.888772 IP6 (flowlabel 0xda6f7, hlim 63, next-header ICMPv6 (58) payload length: 64) 2001:db8:13::2 > 2001:db8:1::10: [icmp6 sum ok] ICMP6, echo reply, id 376, seq 0
No hay ARP. En IPv6, el mismo trabajo lo hace ICMPv6, con neighbor
discovery. Para hallar la MAC de 2001:db8:1::1, h1 no le pregunta a todo el
enlace. Envía un neighbor solicitation a un grupo multicast derivado de la
dirección buscada, el ff02::1:ff00:1: el prefijo fijo ff02::1:ff seguido de
los últimos 24 bits de 2001:db8:1::1. Casi nadie más está en ese grupo. Esa es
una mejora real sobre el broadcast de ARP, que interrumpe a todos los del
enlace.
ICMPv6 ya no es opcional. Sin él no hay neighbor discovery, y sin eso no se entrega nada. Si bloquean todo ICMP en IPv6, se quedan sin red.
Hop limit, salto a salto. Comparemos un mismo pedido a los dos lados de
r1:
[r1.eth1]
06:47:40.189748 aa:c1:ab:ab:19:72 > aa:c1:ab:93:e2:1d, ethertype IPv6 (0x86dd), length 118: (flowlabel 0x507a4, hlim 64, next-header ICMPv6 (58) payload length: 64) 2001:db8:1::10 > 2001:db8:13::2: [icmp6 sum ok] ICMP6, echo request, id 400, seq 0
[r1.eth3]
06:47:40.189755 aa:c1:ab:28:28:61 > aa:c1:ab:ed:eb:db, ethertype IPv6 (0x86dd), length 118: (flowlabel 0x507a4, hlim 63, next-header ICMPv6 (58) payload length: 64) 2001:db8:1::10 > 2001:db8:13::2: [icmp6 sum ok] ICMP6, echo request, id 400, seq 0
Es la misma historia de IPv4: las MAC cambian, las IP no, y el hop limit baja de
64 a 63. Falta una cosa: ningún checksum de IP cambia, porque no existe. El
frame también mide 118 bytes (14 de Ethernet, 40 de IPv6 y 64 de ICMPv6). El
mismo ping en IPv4 mide 98, con un encabezado de 20.
Límite de esta topología. Para que un nodo Linux haga forwarding en IPv6 hay que encender
net.ipv6.conf.all.forwarding, que viene apagado aunqueip_forwardde IPv4 esté en 1. Los.clab.ymlde la semana lo hacen en los routers defwd. Otro detalle: una dirección nueva pasa un par de segundos en duplicate address detection, y mientras tanto no se usa como origen. Por esofwd/ipv6.shtermina con una espera.
Sin fragmentación en los routers
En IPv6, un router nunca fragmenta. Si un paquete no cabe, lo descarta y le
envía al origen un ICMPv6 Packet Too Big. Es lo que IPv4 hace con DF, ahora
obligatorio para todo. Por eso IPv6 exige que todo enlace acepte al menos 1280
bytes. Bajemos el enlace r1–r3 a ese mínimo y enviemos 1400 bytes:
06:47:47.372568 IP6 (flowlabel 0x507a4, hlim 64, next-header ICMPv6 (58) payload length: 1408) 2001:db8:1::10 > 2001:db8:13::2: [icmp6 sum ok] ICMP6, echo request, id 414, seq 0
06:47:47.372586 IP6 (flowlabel 0x9371f, hlim 64, next-header ICMPv6 (58) payload length: 1240) 2001:db8:1::1 > 2001:db8:1::10: [icmp6 sum ok] ICMP6, packet too big, mtu 1280
$ docker exec clab-w04-fwd-h1 ip -6 route get 2001:db8:13::2
2001:db8:13::2 from :: via 2001:db8:1::1 dev eth1 src 2001:db8:1::10 metric 1024 expires 592sec mtu 1280 pref mediumEl origen sí puede fragmentar, con un encabezado de extensión. Al repetir el
ping:
06:47:55.527053 IP6 (flowlabel 0x507a4, hlim 64, next-header Fragment (44) payload length: 1240) 2001:db8:1::10 > 2001:db8:13::2: frag (0x02aa4b39:0|1232) ICMP6, echo request, id 434, seq 0
06:47:55.527075 IP6 (flowlabel 0x507a4, hlim 64, next-header Fragment (44) payload length: 184) 2001:db8:1::10 > 2001:db8:13::2: frag (0x02aa4b39:1232|176)
next-header Fragment (44) es el encabezado de extensión. Las cuentas salen: 40
de IPv6 + 8 del encabezado de fragmento + 1232 de datos = 1280, exacto. Los 1408
bytes de ICMPv6 se reparten en 1232 + 176.
Convivencia de IPv4 e IPv6
IPv6 no es compatible con IPv4: un host que solo habla IPv4 no puede leer un paquete IPv6. Y no hubo, ni habrá, un día en que todos cambien a la vez. Las dos versiones conviven, y hay dos técnicas principales.
Doble pila (dual stack). Cada host y router tiene direcciones de los dos tipos. Al consultar un nombre, se obtiene una dirección de cada tipo si las tiene, y se elige. Es lo más limpio, pero exige que todo el camino hable IPv6.
Túneles (tunneling). Si en el medio hay una isla que solo habla IPv4, el paquete IPv6 entero viaja como datos de un datagrama IPv4, con protocolo 41. Para IPv4, ese paquete es carga como cualquier otra:
 IPv6 ---- R1 ========= túnel IPv4 ========= R2 ---- IPv6
   [IPv6|datos]       [IPv4|IPv6|datos]       [IPv6|datos]
Nuevamente el modelo de capas: un túnel trata a una red completa como si fuera un enlace. Volveremos a esta idea con los overlays de la semana 14 y las VPN de la semana 15.
En la práctica. Una parte grande del tráfico que llega a los servicios grandes de Internet ya es IPv6, y la mayoría de los celulares de muchas redes móviles usa IPv6. La adopción varía mucho entre países y entre redes. Para verlo en su propia casa, revisen si su laptop tiene una dirección que empiece con
2o3enip -6 addr, o enifconfig.
Recorrido completo de un paquete
Juntemos todo. a3 acaba de arrancar y quiere abrir una conexión TCP a ext,
en el puerto 9000. Sigamos el primer segmento, el SYN, en la topología nat con
el masquerade activo.
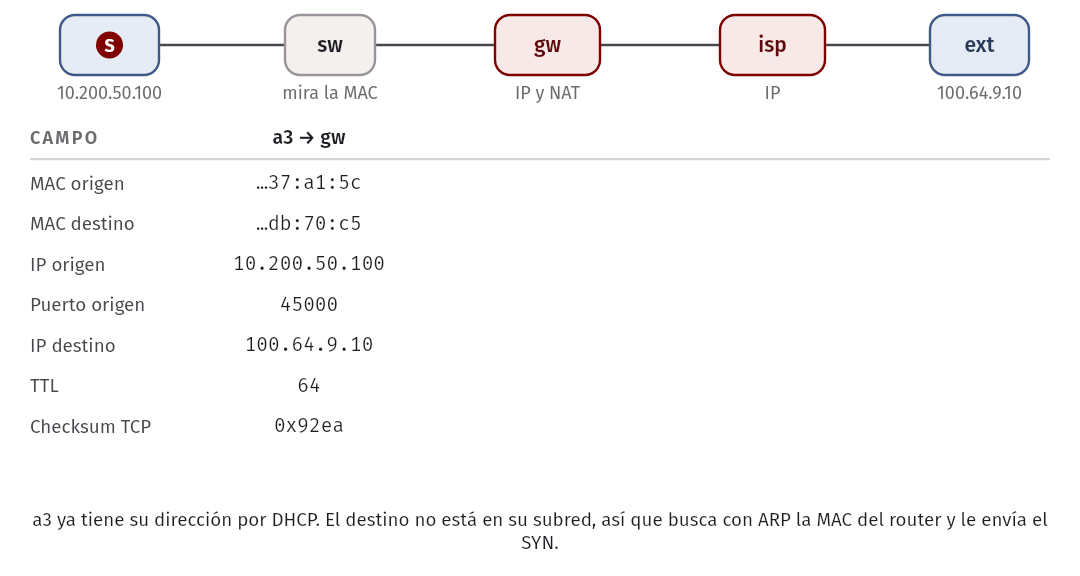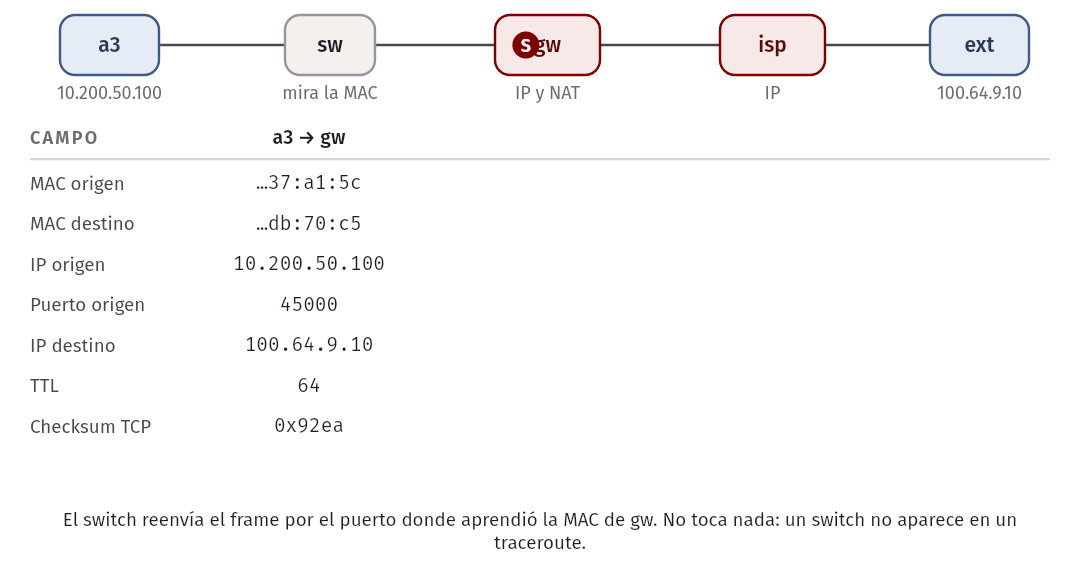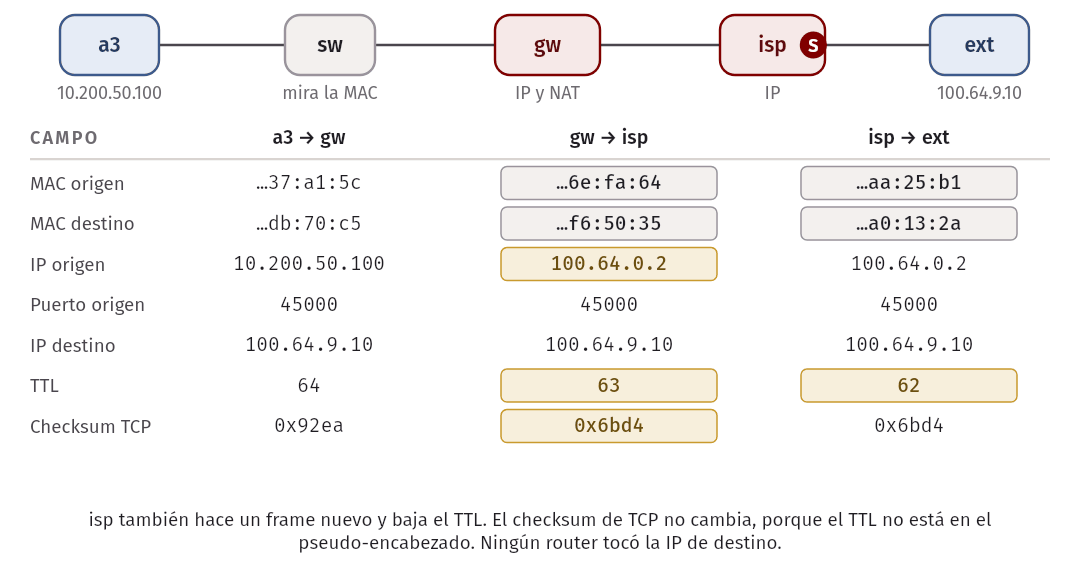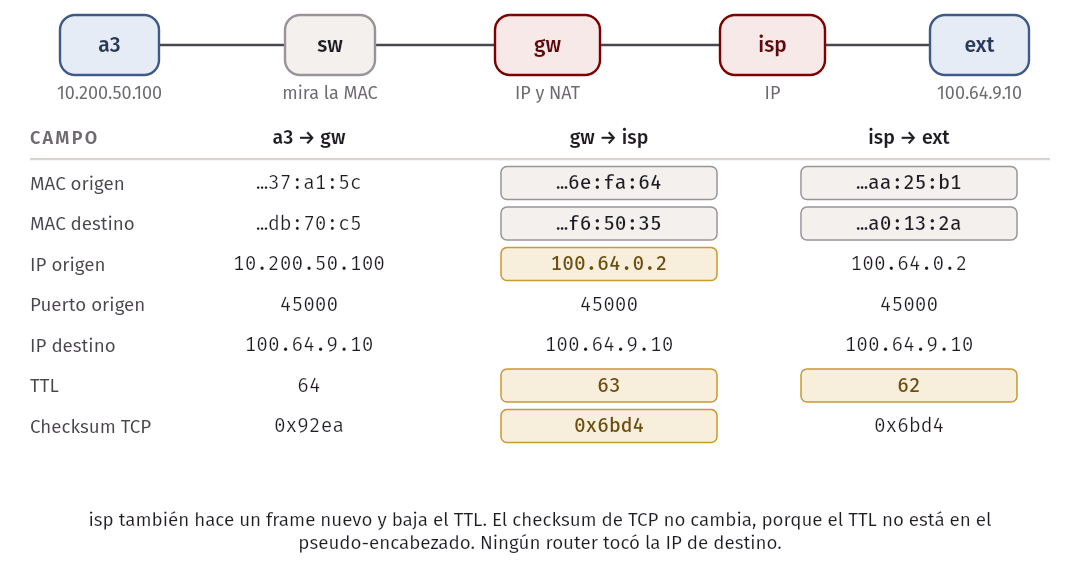
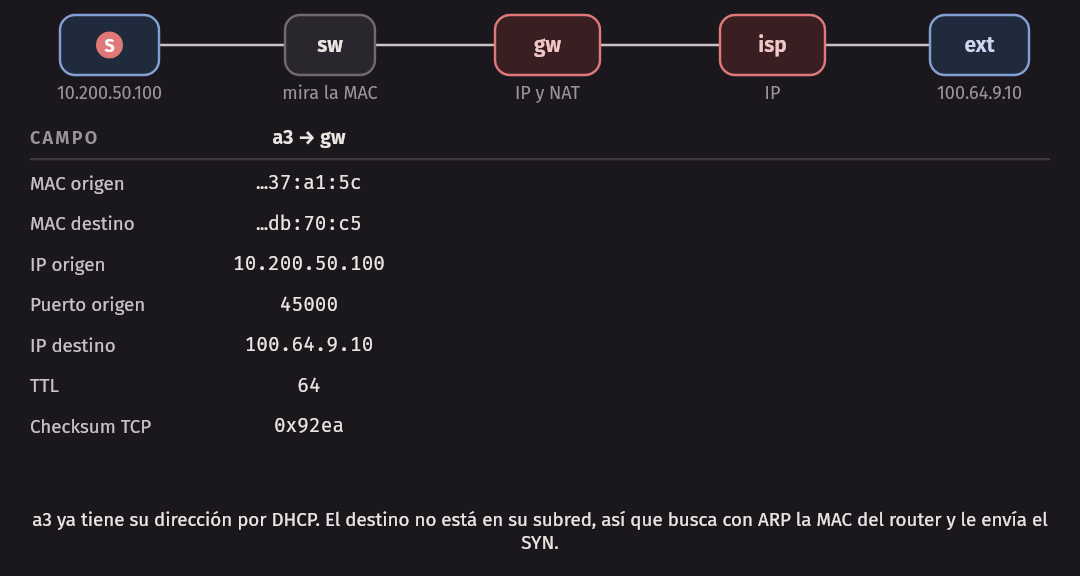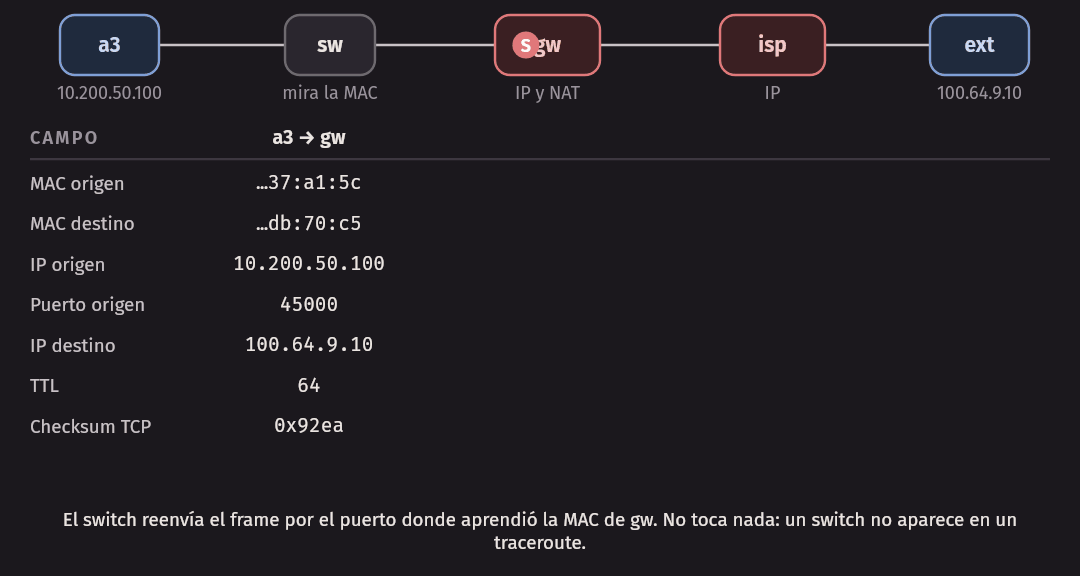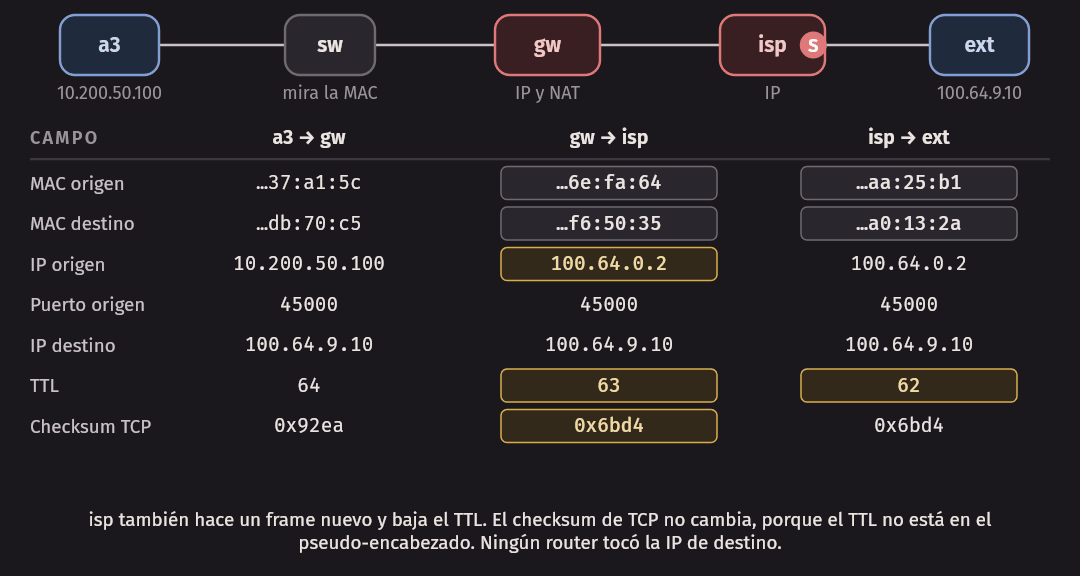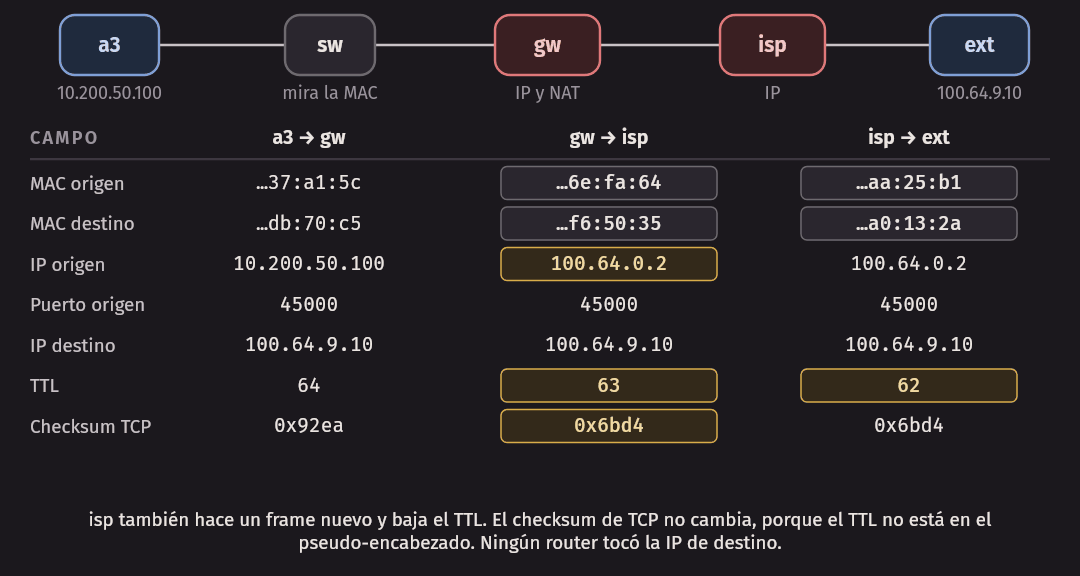
Paso 1: DHCP. a3 obtiene 10.200.50.100/24, y su router por defecto es
10.200.50.1. Lo vimos con detalle.
Paso 2: decidir el siguiente salto. Aplicando la máscara, 100.64.9.10 no
está en su subred. La tabla de a3 dice default via 10.200.50.1.
Paso 3: ARP. Antes de enviar, necesita la MAC del router, no la de ext.
Vaciamos las tablas de vecinos para ver esto:
06:49:16.742301 aa:c1:ab:37:a1:5c > ff:ff:ff:ff:ff:ff, ethertype ARP (0x0806), length 42: Ethernet (len 6), IPv4 (len 4), Request who-has 10.200.50.1 tell 10.200.50.100, length 28
06:49:16.742360 aa:c1:ab:db:70:c5 > aa:c1:ab:37:a1:5c, ethertype ARP (0x0806), length 42: Ethernet (len 6), IPv4 (len 4), Reply 10.200.50.1 is-at aa:c1:ab:db:70:c5, length 28
Paso 4: el SYN sale. sw lo reenvía por el puerto donde aprendió la MAC de
gw, sin tocar nada; un switch no aparece en un traceroute.
Paso 5: gw. Recibe el frame, le quita el encabezado de Ethernet, baja el
TTL y consulta su tabla: default por eth2. conntrack crea una fila para esta conexión al recibir el paquete, y en
postrouting la regla cambia el origen y deja la traducción escrita en esa fila. Hace su propio ARP, ahora por el otro
enlace, y envía un frame nuevo.
Pasos 6 y 7: isp y ext. isp tiene a 100.64.9.0/24 conectada; baja el
TTL, hace ARP por ext y lo entrega.
Aquí están las capturas reales del SYN en tres enlaces. Se dejaron afuera las líneas de ARP:
[a3 eth1]
06:49:16.742362 aa:c1:ab:37:a1:5c > aa:c1:ab:db:70:c5, ethertype IPv4 (0x0800), length 74: (tos 0x0, ttl 64, id 38920, offset 0, flags [DF], proto TCP (6), length 60)
    10.200.50.100.45000 > 100.64.9.10.9000: Flags [S], cksum 0x92ea (correct), seq 3555848426, win 64240, options [mss 1460,sackOK,TS val 4252334699 ecr 0,nop,wscale 7], length 0
[gw eth2]
06:49:16.742396 aa:c1:ab:6e:fa:64 > aa:c1:ab:f6:50:35, ethertype IPv4 (0x0800), length 74: (tos 0x0, ttl 63, id 38920, offset 0, flags [DF], proto TCP (6), length 60)
    100.64.0.2.45000 > 100.64.9.10.9000: Flags [S], cksum 0x6bd4 (correct), seq 3555848426, win 64240, options [mss 1460,sackOK,TS val 4252334699 ecr 0,nop,wscale 7], length 0
[isp eth2]
06:49:16.742410 aa:c1:ab:aa:25:b1 > aa:c1:ab:a0:13:2a, ethertype IPv4 (0x0800), length 74: (tos 0x0, ttl 62, id 38920, offset 0, flags [DF], proto TCP (6), length 60)
    100.64.0.2.45000 > 100.64.9.10.9000: Flags [S], cksum 0x6bd4 (correct), seq 3555848426, win 64240, options [mss 1460,sackOK,TS val 4252334699 ecr 0,nop,wscale 7], length 0
Y la fila que quedó en gw. Al momento de mirarla, la conexión ya se había
cerrado:
tcp 6 113 TIME_WAIT src=10.200.50.100 dst=100.64.9.10 sport=45000 dport=9000 src=100.64.9.10 dst=100.64.0.2 sport=9000 dport=45000 [ASSURED] mark=0 use=1Todo en una tabla, con las MAC de esa ejecución:
| Tramo | MAC origen | MAC destino | IP origen | Puerto origen | IP destino | TTL | Checksum de TCP |
|---|---|---|---|---|---|---|---|
a3 → gw |
a3 |
gw eth1 |
10.200.50.100 |
45000 | 100.64.9.10 |
64 | 0x92ea |
gw → isp |
gw eth2 |
isp eth1 |
100.64.0.2 |
45000 | 100.64.9.10 |
63 | 0x6bd4 |
isp → ext |
isp eth2 |
ext |
100.64.0.2 |
45000 | 100.64.9.10 |
62 | 0x6bd4 |
Lean la tabla por columnas, porque cada una dice algo:
- Las MAC cambian en cada enlace, siempre.
- La IP de origen cambia una sola vez, en el NAT. Un router común no la toca.
- El puerto de origen se mantuvo porque 45000 estaba libre. Si no, también habría cambiado.
- La IP de destino no cambia nunca. Es lo que guía cada decisión de forwarding.
- El TTL baja en 1 en cada router, y
swno lo toca. - El checksum de TCP cambia en el NAT, porque cubre las direcciones. Es la
prueba de que un NAT se mete en el transporte.
ispno lo cambia, y tampoco el TTL lo afecta, porque el TTL no forma parte del pseudo-encabezado. - Los números de TCP (
seq,win, opciones) no se tocan. Eso es asunto de los extremos.
Idea clave. Si entienden esta tabla, entienden las semanas 3 y 4. Cada dispositivo trabaja en una capa: el switch mira la MAC y no toca nada, el router mira la IP de destino y reescribe el encabezado de enlace y el TTL, y el NAT además mira y reescribe la IP y el puerto de origen.
El laboratorio de la semana y make test
Todo se hace en code/week-04/, dentro del contenedor del curso. Antes de
empezar, make compila cidr, lpm e ipv4_header.
code/week-04/
  fwd/fwd.clab.yml    tres routers con rutas incompletas
  fwd/ipv6.sh         direcciones IPv6 de h1 a r3
  nat/nat.clab.yml    LAN, NAT, proveedor y servidor externo
  nat/masquerade.nft  NAT de salida
  nat/dnat_demo.nft   redirección de puerto de ejemplo
  nat/dhcp_server.py  servidor DHCP mínimo
  lab/                sus respuestas: routes.sh, portforward.nft, ipv6_h3.sh
Paso 1, rutas. Con make up-fwd, comprueben que h1 y h3 se alcanzan
pero h2 no. Dibujen la topología y escriban qué le falta a cada router. Pongan
los comandos en lab/routes.sh, siguiendo el ejemplo que está en el archivo. La
clave es recordar que cada dirección necesita su camino de ida y su camino de
vuelta. Cuando esté, h1, h2 y h3 deben alcanzarse entre todos.
Paso 2, ruta específica. Antes de ejecutarla, predigan por dónde va
10.200.3.10 y por dónde va 10.200.3.11 al agregar la ruta /32 de la
sección de longest prefix match. Comprueben con ip route get y traceroute.
¿Por qué traceroute muestra 10.200.13.2 en el salto 3? ¿Por dónde vuelve la
respuesta?
Paso 3, salto a salto. Corran tcpdump -n -e -v en cada enlace del camino y
armen su propia tabla de MAC, IP y TTL, como la de la Sesión A. Sus MAC serán
otras.
Paso 4, NAT. Con make up-nat, comprueben que a1 no alcanza a ext.
Carguen la regla y capturen a los dos lados:
docker exec -i clab-w04-nat-gw nft -f - < nat/masquerade.nft
docker exec clab-w04-nat-gw nft list ruleset
docker exec clab-w04-nat-gw conntrack -L
Luego abran dos conexiones desde a1 y a2 con el mismo puerto de origen, y
lean la tabla.
Paso 5, conexión entrante. Primero intenten abrir una conexión desde ext
hacia a2. Después escriban en lab/portforward.nft una redirección para que
quien se conecte desde afuera al puerto 2222 de gw llegue al puerto 8000 de
a2. El ejemplo de la sección de NAT usa otros números. Para probarla:
docker exec -d clab-w04-nat-a2 sh -c 'nc -lk -p 8000 -e /bin/echo hola-desde-a2'
docker exec -i clab-w04-nat-gw nft -f - < lab/portforward.nft
docker exec clab-w04-nat-ext sh -c 'echo x | nc -w2 100.64.0.2 2222'
Paso 6, IPv6. En fwd, corran fwd/ipv6.sh y hagan ping de h1 a r3.
Luego completen lab/ipv6_h3.sh para que h1 también alcance a h3 en
2001:db8:3::10, con la red 2001:db8:3::/64. Observen el neighbor discovery
con tcpdump.
Paso 7, P1. Avancen con su proyecto. Tienen lo que necesitan de direccionamiento y de NAT, pero su red es otra: tiene un núcleo con caminos alternativos y VLANs, y OSPF llega la próxima semana.
Cuando terminen un archivo de lab/, borren su línea TODO. Las pruebas que
dependen de un archivo con TODO se saltan, con un mensaje que dice cuál falta.
make test compila sin advertencias, corre las pruebas de test_tools.py sobre
los tres programas, y levanta las dos topologías, una tras otra, para comprobar
lo que dice este capítulo:
make test # dentro del contenedor; tarda poco más de un minutotest_queue_delay_and_strict_priority (test_fwd.E_Queues.test_queue_delay_and_strict_priority) ... ok
test_hop_limit_drops_at_router (test_fwd.F_Ipv6.test_hop_limit_drops_at_router) ... ok
test_ping_and_neighbor_discovery (test_fwd.F_Ipv6.test_ping_and_neighbor_discovery) ... ok
test_router_sends_packet_too_big_and_source_fragments (test_fwd.F_Ipv6.test_router_sends_packet_too_big_and_source_fragments) ... ok
setUpClass (test_fwd.G_LabRoutes) ... skipped 'falta completar lab/routes.sh'
test_lease_with_four_messages_by_broadcast (test_nat.A_Dhcp.test_lease_with_four_messages_by_broadcast) ... ok
test_lab_step_5_port_forward (test_nat.B_Nat.test_lab_step_5_port_forward) ... skipped 'falta completar lab/portforward.nft'
...
----------------------------------------------------------------------
Ran 36 tests in 63.811s
OK (skipped=2)Eso es lo que verán mientras los archivos de lab/ sigan con su TODO: las
pruebas de esos pasos se saltan, y el resto ya pasa. Las pruebas no exigen cifras
exactas, solo tendencias con margen: por ejemplo,
que el RTT con la cola llena sea varias veces mayor. Al terminar, pase lo que
pase, make test destruye sus topologías. Si levantan algo a mano, make down
lo limpia.
Resumen
- Forwarding es local y por paquete; routing es global y llena las tablas. Son el plano de datos y el plano de control, y se comunican por la forwarding table.
- IPv4 tiene un encabezado de 20 bytes o más. En cada router cambian el TTL y el checksum, y nada más.
- El checksum protege solo el encabezado. Se puede ajustar sin volver a sumar todo.
- Un datagrama que no cabe se fragmenta, o se descarta si trae DF. Hoy lo normal es que el origen use DF y descubra el MTU del camino con ICMP. El offset cuenta unidades de 8 bytes.
- Una dirección identifica una interfaz. Un prefijo
/ndeja 32 − n bits de host y 2^(32−n) − 2 direcciones para hosts, salvo/31y/32. - CIDR permite prefijos de cualquier largo y agregar rutas. Siempre gana el prefijo más largo, sin importar el orden de la tabla.
- Un router tiene puertos de entrada, un fabric, puertos de salida y un procesador de routing. Las colas se forman sobre todo a la salida, y el retardo de cola se puede medir. El scheduling decide quién espera.
- A cada salto, las MAC cambian y las IP no cambian. La excepción a la segunda es el NAT.
- ICMP viaja sobre IP y lleva errores.
tracerouteusa Time exceeded y Port unreachable. La dirección que muestra no es necesariamente la de entrada, y la vuelta puede ser distinta de la ida. - DHCP entrega dirección, máscara y router con discover, offer, request y ack. El cliente usa broadcast porque todavía no tiene dirección ni conoce al servidor.
- NAT reescribe dirección y puerto, y guarda una tabla por conexión. Distingue a dos hosts con el mismo puerto cambiando el puerto externo. Lo que entra necesita una fila previa o una redirección.
- IPv6 tiene direcciones de 128 bits, encabezado fijo de 40 bytes, sin checksum y sin fragmentación en routers. Neighbor discovery reemplaza a ARP. Convive con IPv4 con doble pila y túneles.
Ejercicios
- Sin computadora, den la máscara, la dirección de red, el broadcast y el rango
de hosts de
10.200.77.130/26. Verifiquen con./cidr. - Dividan
10.200.96.0/20en 8 subredes iguales. ¿Qué prefijo tienen? ¿Cuántos hosts caben en cada una? Escriban la primera y la última. - Reciben el bloque
10.200.80.0/23para una red con LAN de 200, 100 y 30 hosts, y cuatro enlaces entre routers. Armen el plan como en el ejemplo. ¿Cuánto sobra? - Un router tiene las rutas
10.200.0.0/16 → A,10.200.32.0/19 → B,10.200.40.0/21 → C,10.200.40.128/25 → Dy0.0.0.0/0 → E. ¿Por dónde salen10.200.40.200,10.200.40.100,10.200.33.1y10.201.0.1? Hagan los cuatro a mano en binario y comprueben conlpm. - Con el encabezado
4500 0028 1c46 4000 4006 ???? 0ac8 3201 6440 090a, calculen el checksum a mano, y después el nuevo valor cuando el TTL baje a3f. No vuelvan a sumar todo para el segundo. - Un datagrama de 4000 bytes en total (20 de encabezado) sin DF debe cruzar un enlace con MTU 1500. Hagan la tabla de fragmentos con el largo, el valor del campo offset y MF. Después, si cada fragmento debe cruzar un enlace de MTU 800, ¿cuántos quedan al final? ¿Quién los vuelve a armar?
lpm.crecorre toda la tabla. Cambienlookuppor un trie binario: un árbol donde cada nivel consume un bit de la dirección y un nodo puede guardar una ruta. La búsqueda baja mientras pueda y recuerda la última ruta que vio. Comprueben quetest_tools.pysiga pasando. ¿Cuántos nodos visita, como máximo, una búsqueda? ¿Depende del número de rutas?- En la tabla del recorrido completo, agreguen las filas de la respuesta
(el SYN-ACK que vuelve de
extaa3). Sin capturar nada, predigan MAC, IP, puertos y TTL en cada tramo. Después capturen y comparen. - En la topología
fwd, una compañera reemplaza enr2la ruta a10.200.3.0/24: ahora va por10.200.12.1en vez de porr3, con la/32der1activa. ¿Qué le pasa a un ping deh1ah3? ¿Qué mostrarátraceroute? ¿Qué mensaje ICMP llega al final, y desde quién? Predíganlo, háganlo y expliquen el papel del TTL. nat/dhcp_server.pytiene varias simplificaciones. Lean el código y digan: ¿qué pasa si dos clientes piden direcciones cuando solo queda una libre? ¿Y si un cliente desaparece sin avisar? ¿Y si hay dos servidores en la misma LAN? Busquen en el RFC 2131 qué debería pasar en cada caso.- Un NAT tiene una sola dirección pública y atiende a 500 hosts. Cada uno abre 200 conexiones hacia el mismo servidor, al mismo puerto. ¿Le alcanzan los puertos? ¿Y si cada uno habla con servidores distintos? Justifiquen con qué campos distingue el NAT una fila de otra. ¿Por qué un carrier-grade NAT se preocupa por esto y un router de hogar no?
- Expliquen por qué IPv6 pudo quitar el checksum y por qué exige un MTU mínimo
de 1280. Si una red bloquea todo ICMPv6, ¿qué falla primero: el
ping, el descubrimiento de vecinos o el MTU del camino? Prueben a bloquearlo enr1connftables, y vean qué pasa con unpingde 56 bytes y con uno de 1400.