
Apuntes · Capítulo 5Routing
Routing dentro de una red
Routing dentro de una red
La semana pasada escribimos las rutas a mano. Con tres routers se puede, y aun
así el paso 1 del laboratorio pedía cuidado: cada dirección necesitaba su camino
de ida y su camino de vuelta. Al final de la clase quedó una pregunta abierta: si
se cae el enlace entre r1 y r3, ¿quién avisa, y cómo se entera r2? Con rutas
a mano la respuesta es nadie. Los paquetes se pierden hasta que una persona entre
a cada router a corregir su tabla.
Esta semana reemplazamos a esa persona por un protocolo. Los routers conversan entre ellos, descubren la topología y llenan sus forwarding tables solos. Cuando algo se cae, las vuelven a calcular. El plano de datos no cambia nada: sigue siendo el longest prefix match de la semana 4. Lo que cambia es quién escribe la tabla.
El problema tiene una formulación limpia: una red es un grafo, y queremos el camino de menor costo entre cada par de nodos. Hay dos familias de algoritmos para resolverlo sin un jefe central. En estado de enlace (link-state), cada router consigue el mapa completo y calcula por su cuenta. En vector de distancias (distance-vector), cada router solo conversa con sus vecinos y nunca ve el mapa. Las dos llegan a la misma respuesta cuando la red está quieta. La diferencia aparece cuando algo falla.
En la Sesión A resolvemos los dos algoritmos a mano, con programas en C que imprimen cada iteración, y provocamos el conteo al infinito. En la Sesión B vemos OSPF, el protocolo de estado de enlace que corre en muchas redes reales, lo configuramos con FRRouting, comprobamos que da lo mismo que nuestro cálculo a mano y medimos cuánto tarda en reaccionar ante una falla. Ahí aparece la idea más práctica de la semana: lo que más demora casi nunca es calcular, sino darse cuenta.
Todo lo que se muestra salió de tres topologías de Containerlab que ustedes pueden levantar. Los tiempos, los números de secuencia y los checksums cambian en cada ejecución. Los costos y las rutas, no.
Ruta de lectura.
Antes de clase (obligatorio, unos 15 a 20 minutos). Sesión A: El routing como un problema de grafos, de Estado de enlace, Inundar: que todos tengan el mismo mapa y Calcular: Dijkstra, y la introducción de Vector de distancias. Sesión B: Por qué un solo algoritmo no alcanza, la introducción de OSPF y la de Áreas y backbone.
En clase. Sesión A: Ejemplo resuelto, desde
a, De las distancias a la forwarding table, Ejemplo resuelto, iteración por iteración, Buenas noticias y malas noticias y Comparación de los dos algoritmos. Sesión B: Configurarlo en FRRouting, Hello y adyacencias, La base de datos, Inundar un cambio y Convergencia: cuánto tarda en reaccionar.Después de clase. Repasen con Dos tablas que no son la misma, Cuando dos routers no forman adyacencia, el Resumen y los Ejercicios, y preparen El laboratorio de la semana y
make test. Opcional: Qué se gana, y hasta dónde, Lo que arriesgan los temporizadores cortos y Mientras tanto: ciclos pasajeros. Para profundizar, las lecturas del libro y las gratuitas de la semana:Este capítulo acompaña a Kurose y Ross, Computer Networking: A Top-Down Approach (9.ª ed.). Para la Sesión A, las secciones 5.1 Introduction y 5.2 Routing Algorithms. Para la Sesión B, la sección 5.3 Intra-AS Routing in the Internet: OSPF. Lecturas libres de CS168: Model for Intra-Domain Routing, Distance Vector, Link State y Model for Inter-Domain Routing. FRRouting: OSPFv2. Complementaria: RFC 2328, OSPF versión 2. El código de la semana está en
code/week-05/.
El routing como un problema de grafos
Olvidemos por un momento los paquetes y las interfaces. Una red se modela como un grafo G = (N, E), donde N es el conjunto de nodos (los routers) y E el de aristas (los enlaces). Cada arista (x, y) tiene un costo c(x, y), un número positivo. Si no hay enlace, el costo es infinito.
El costo de un camino es la suma de los costos de sus aristas. Un camino de menor costo entre x e y es uno cuyo costo no se puede mejorar. Puede haber más de uno, y eso importa, como veremos.
¿Qué significa el costo? Lo que el administrador de la red decida. El grafo no lo sabe. Puede representar el retardo del enlace, el inverso de su capacidad, el dinero que cuesta usarlo, o simplemente 1 para contar saltos. El algoritmo minimiza la suma de lo que le den.
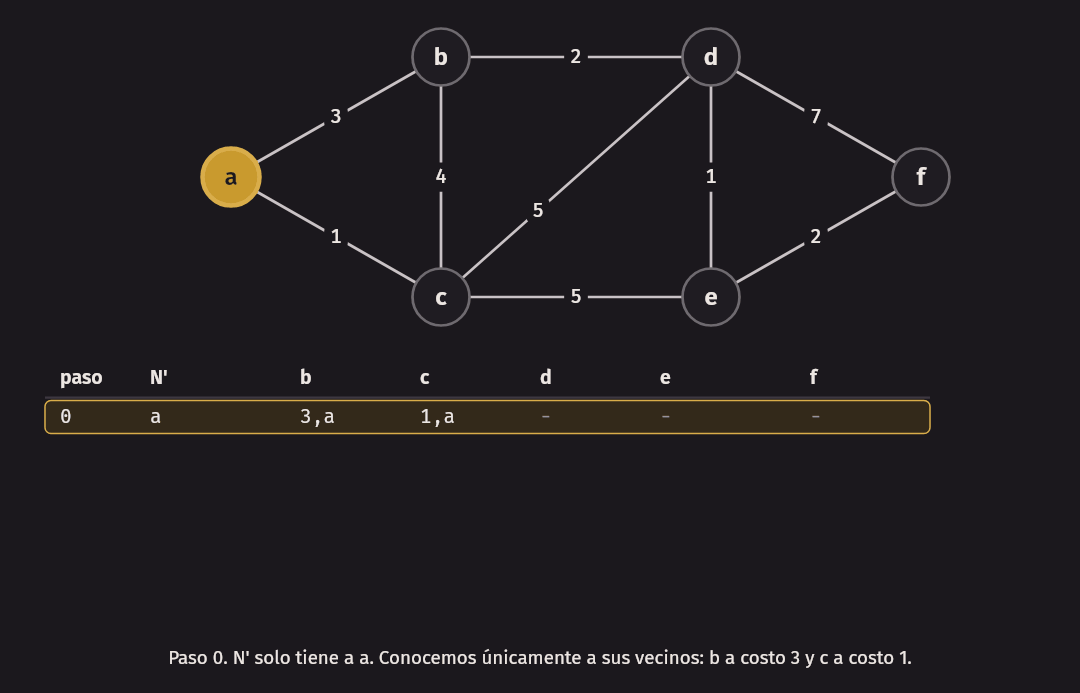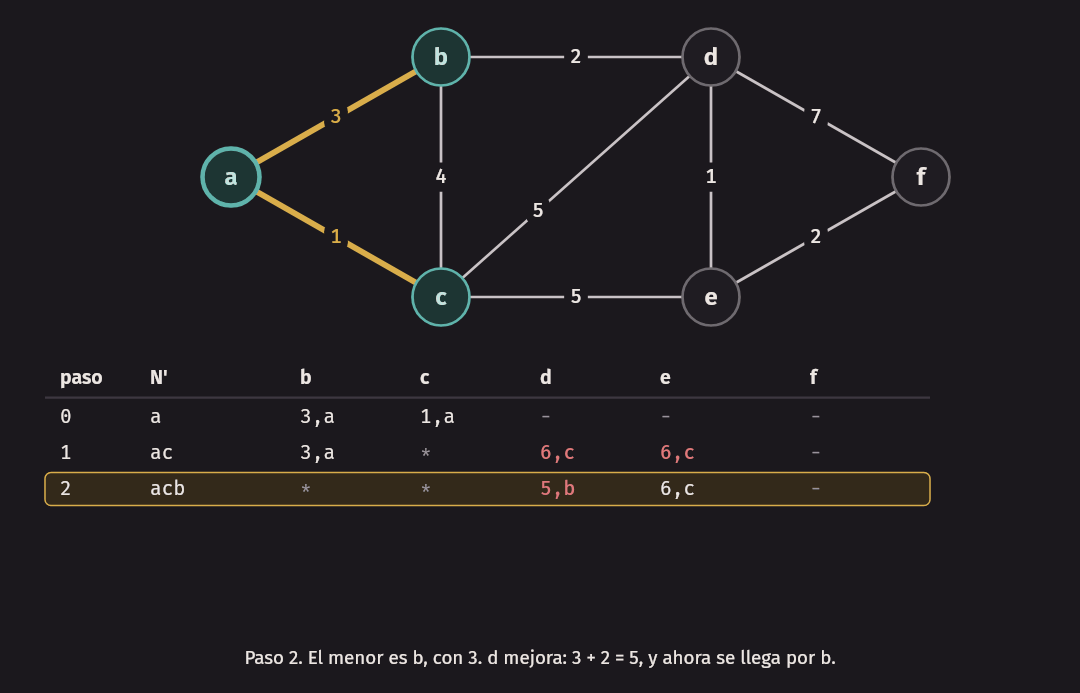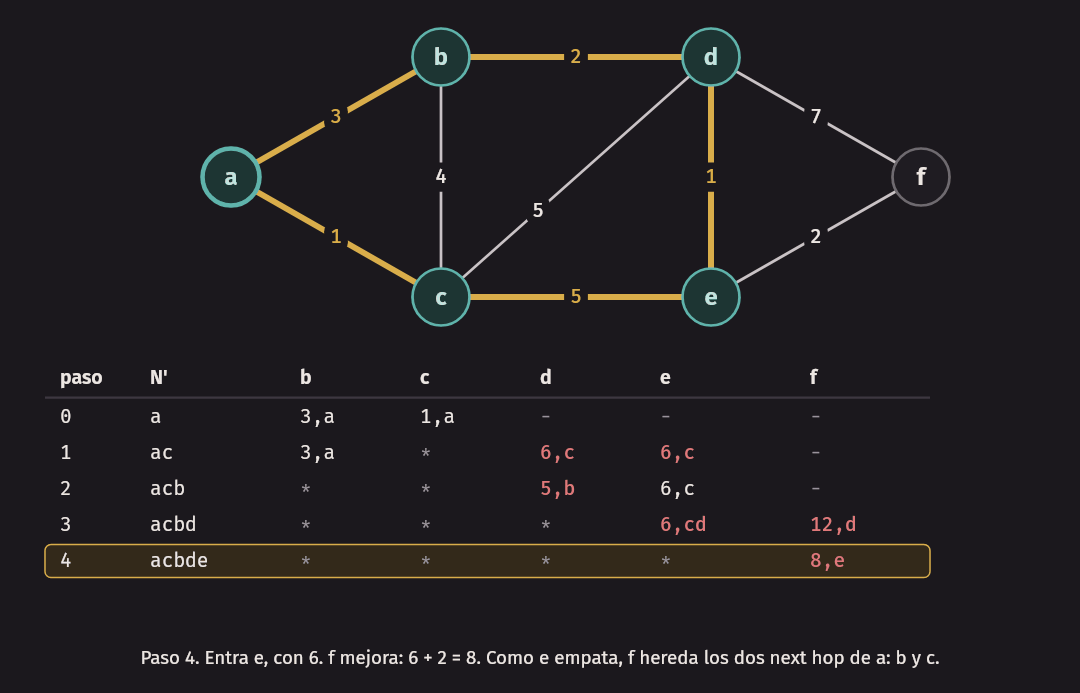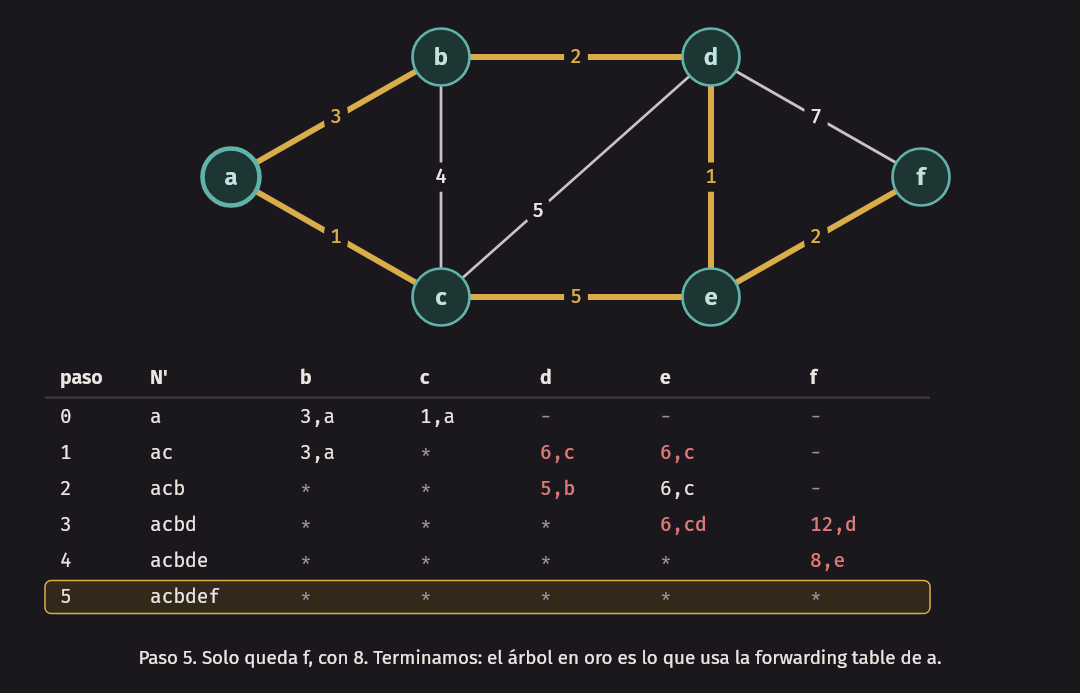
Este es el grafo de los ejemplos de la semana:
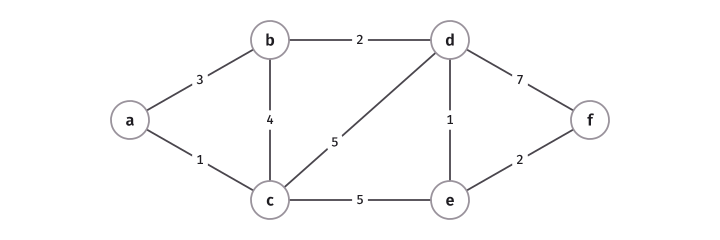
Son seis nodos y nueve enlaces: a-b 3, a-c 1, b-c 4, b-d 2, c-d 5, c-e 5, d-e 1, d-f 7 y e-f 2.
Qué es una ruta válida
Antes de buscar la mejor ruta, ¿qué le exigimos a un conjunto de forwarding tables para que siquiera funcione? Elijamos un destino y sigamos, desde cada router, el next hop que indica su tabla. Pueden pasar tres cosas:
- Llegamos al destino. Bien.
- Llegamos a un router sin entrada para ese destino. Es un callejón sin salida (dead end), y el paquete se descarta.
- Volvemos a un router por el que ya pasamos. Es un ciclo (loop), y el paquete da vueltas hasta que se le acabe el TTL.
Un estado de routing es válido para un destino si, desde cada router, seguir los next hop siempre llega al destino: sin callejones y sin ciclos. Esta definición es la que vale la pena memorizar, porque es global. Ningún router puede verificarla mirando solo su propia tabla. Y es la que dejan de cumplir las redes justo cuando algo falla.
Noten una consecuencia. Las rutas válidas hacia un destino forman un árbol, con el
destino en la raíz. De cada router sale exactamente un next hop, hacia el árbol. Y
los caminos de menor costo se pueden organizar así gracias a una propiedad
sencilla: todo tramo de un camino de menor costo es también de menor costo. Si
el mejor camino de a a f pasa por e, el tramo que va de e a f tiene que
ser el mejor de e a f; si existiera uno mejor, lo usaríamos y mejoraríamos
también el de a. Por eso a un router le basta con guardar el próximo salto. No
necesita el camino entero: confía en que el siguiente router hará lo correcto.
Idea clave. Una forwarding table es una decisión local que solo tiene sentido si todas las demás son coherentes con ella. Mientras todas se calculen sobre la misma información, el conjunto es válido. Los problemas aparecen mientras las tablas se están actualizando, cuando unos routers saben algo que otros todavía no saben.
Plano de control centralizado o distribuido
¿Dónde se hace el cálculo? La semana 4 separó el plano de datos del plano de control. Hay dos formas de organizar el segundo.
En un plano de control distribuido, cada router corre un proceso de routing y conversa con los demás. Nadie tiene autoridad sobre nadie. Es la forma clásica de Internet, y la que estudiamos esta semana y la próxima.
En un plano de control centralizado, un controlador lógicamente central conoce la red, calcula las tablas y las instala en los routers. Los routers solo hacen forwarding. Es la idea de SDN, y lo que hacen muchas redes de data center.
Una segunda clasificación, independiente de la primera, es qué sabe cada nodo. Un algoritmo global calcula con el grafo completo. Un algoritmo descentralizado calcula con la información de sus vecinos y va mejorando poco a poco. Estado de enlace es global aunque se ejecute de forma distribuida: cada router tiene el mapa completo. Vector de distancias es descentralizado.
| Estado de enlace | Vector de distancias | |
|---|---|---|
| Qué conoce cada router | Todo el grafo | Sus enlaces y lo que dicen sus vecinos |
| Qué comunica | Sus enlaces, a todos | Sus distancias, a sus vecinos |
| Qué calcula | Dijkstra, sobre el mapa | Bellman-Ford, poco a poco |
| Protocolo típico | OSPF, IS-IS | RIP |
Estado de enlace
La idea tiene dos pasos, y los dos son simples:
- Inundar. Cada router le cuenta a toda la red qué enlaces tiene y cuánto cuesta cada uno.
- Calcular. Cada router, con el mapa completo en la mano, corre Dijkstra desde sí mismo y llena su tabla.
Inundar: que todos tengan el mismo mapa
Un router solo sabe de sus propios enlaces. Empaqueta esa información en un anuncio de estado de enlace (link-state advertisement, LSA) y se lo manda a sus vecinos. Cada vecino que recibe un LSA nuevo lo guarda y lo reenvía por todos sus enlaces menos por el que llegó. Así llega a todos.
Inundar parece fácil y tiene dos trampas. Primera: en una red con ciclos, un anuncio reenviado sin control daría vueltas para siempre. Por eso cada LSA lleva un número de secuencia: un router reenvía un LSA solo si es más nuevo que el que ya tiene. Segunda: un enlace puede perder el anuncio justo cuando más se necesita. Por eso la inundación es confiable: cada salto confirma, y se retransmite hasta que llega la confirmación.
El resultado es una base de datos de estado de enlace (link-state database, LSDB), que es igual en todos los routers. Más abajo lo comprobamos con checksums.
¿Cuántos mensajes cuesta? Un LSA cruza cada enlace, en el peor caso, una vez en cada dirección. Con n routers y e enlaces, inundar los anuncios de todos cuesta del orden de n·e transmisiones. En nuestro grafo, como máximo 6 × 2 × 9 = 108 copias de LSA al arrancar. Después solo se inunda lo que cambia.
Calcular: Dijkstra
Dijkstra responde: dado un nodo de origen u, ¿cuál es el camino de menor costo hacia cada otro nodo? Mantiene un conjunto N’ de nodos ya resueltos, y para cada nodo v una distancia tentativa D(v) y su predecesor p(v) en el camino.
Inicio:
    N' = {u}
    para cada nodo v:
        si v es vecino de u:  D(v) = c(u, v), p(v) = u
        si no:                D(v) = infinito

Repetir hasta que N' tenga todos los nodos:
    w = el nodo que no está en N' con el menor D(w)
    agregar w a N'
    para cada vecino v de w que no esté en N':
        D(v) = min( D(v), D(w) + c(w, v) )
        si el valor bajó, p(v) = w
La intuición. En cada paso, el nodo más cercano de los que faltan ya no puede mejorar. Cualquier otro camino hacia él tendría que salir de N’ por un nodo cuya distancia tentativa es igual o mayor, y después sumar más costos positivos. Por eso podemos marcarlo como resuelto para siempre y seguir. Este argumento es el corazón de la demostración, y también es la razón por la que Dijkstra exige costos positivos.
El costo. Con n nodos hay n−1 iteraciones, y en cada una se busca el mínimo entre los que faltan: del orden de n² comparaciones en la versión simple, y mejor con un heap.
Ejemplo resuelto, desde a
Hagámoslo a mano en el grafo de seis nodos. Cada celda es D(v),p(v). Una raya es
infinito, y un asterisco indica que el nodo ya está en N’.
Paso 0. N’ = {a}. Solo conocemos los vecinos de a: D(b) = 3 y D(c) = 1.
Paso 1. El menor es c, con 1. Lo agregamos y miramos sus vecinos:
b: ¿mejora pasar porc? 1 + 4 = 5, y ya teníamos 3. Se queda.d: 1 + 5 = 6. Era infinito, así que ahora es 6, porc.e: 1 + 5 = 6. Ahora es 6, porc.
Paso 2. El menor es b, con 3. Sus vecinos que faltan:
d: 3 + 2 = 5. Mejora a 6, así que ahora es 5, porb.
Paso 3. El menor es d, con 5. Sus vecinos que faltan:
e: 5 + 1 = 6. ¡Empata con el 6 que ya tenía porc! Nos quedamos con los dos.f: 5 + 7 = 12. Ahora es 12, pord.
Paso 4. El menor es e, con 6:
f: 6 + 2 = 8. Mejora a 12, así que ahora es 8, pore.
Paso 5. Solo queda f, con 8. Terminamos.
El programa dijkstra.c hace exactamente eso e imprime cada paso:
$ ./dijkstra graphs/six.txt a
6 nodos, 9 enlaces, origen a

paso N'      b        c        d        e        f
0    a       3,a      1,a      -        -        -
1    ac      3,a      *        6,c      6,c      -
2    acb     *        *        5,b      6,c      -
3    acbd    *        *        *        6,cd     12,d
4    acbde   *        *        *        *        8,e
5    acbdef  *        *        *        *        *

forwarding table de a
destino  costo  next hop
b        3      b
c        1      c
d        5      b
e        6      b c
f        8      b c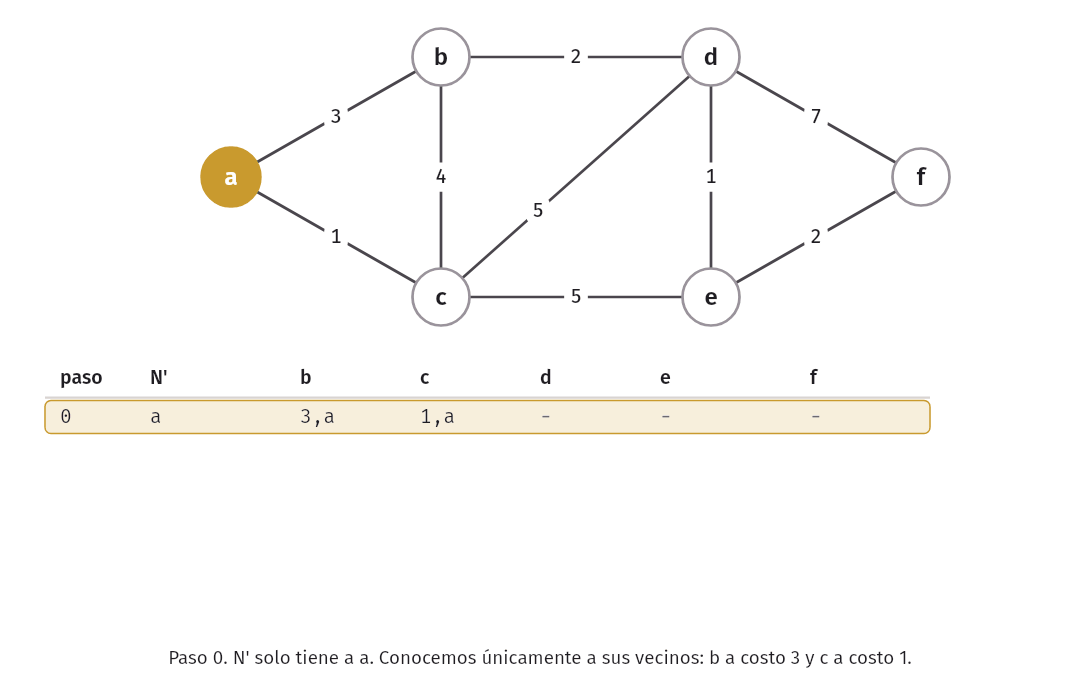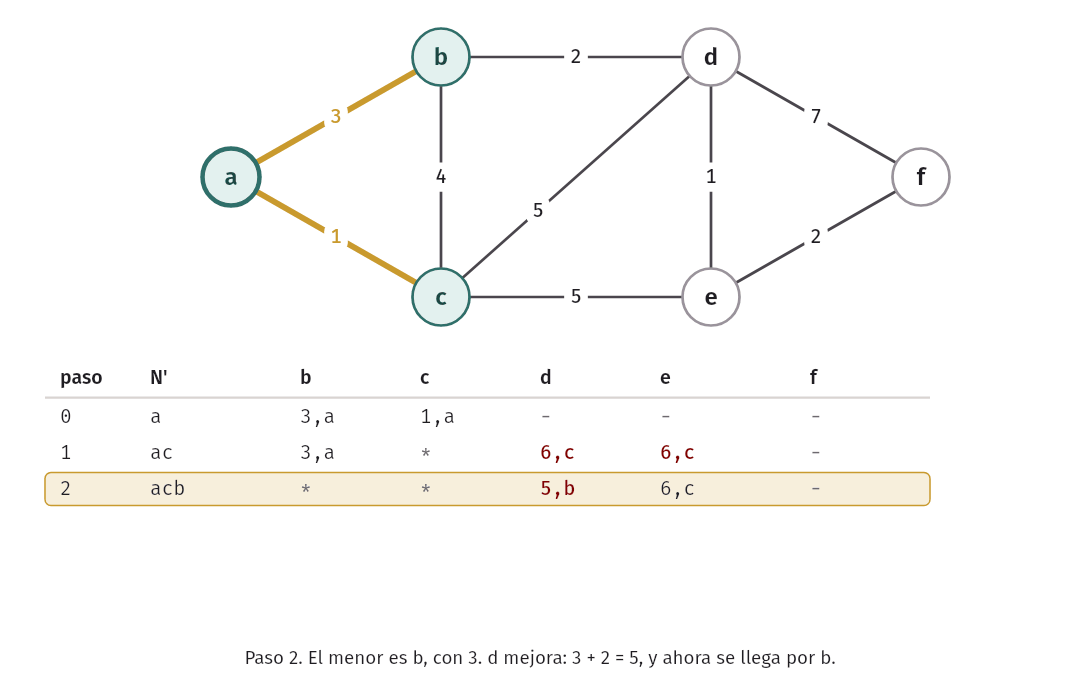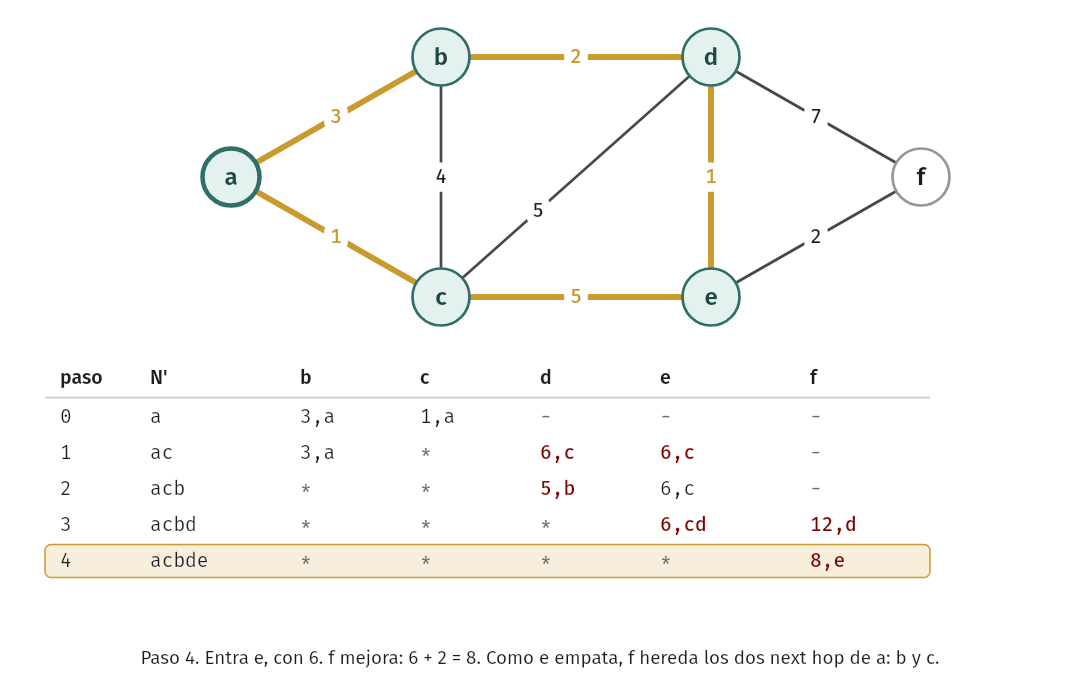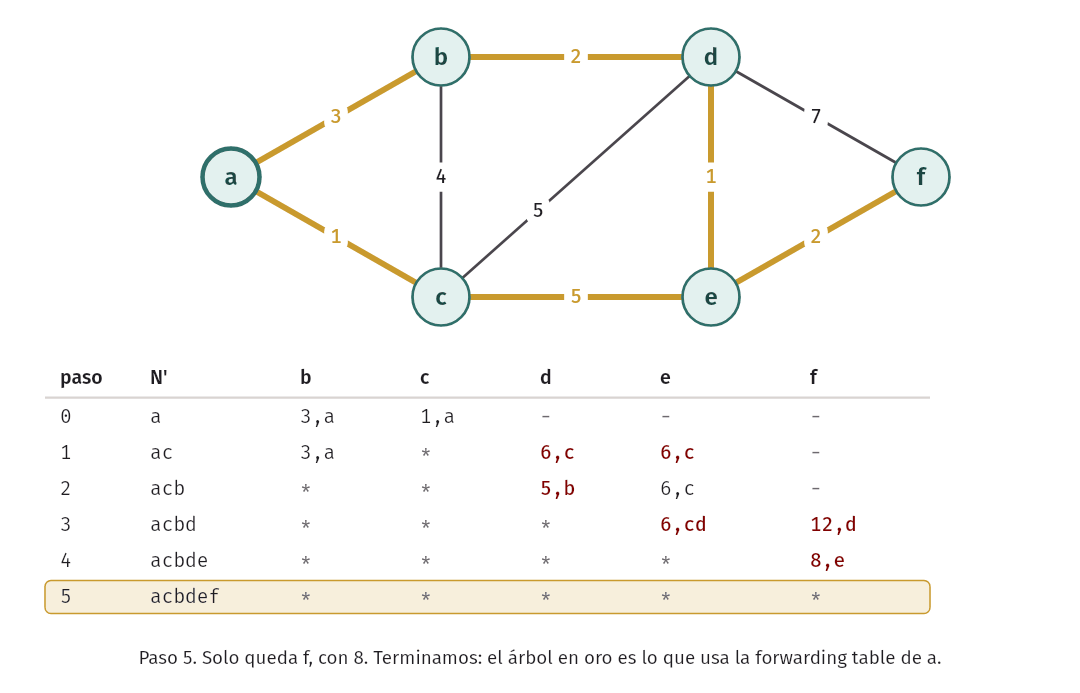
De las distancias a la forwarding table
Dijkstra da costos y predecesores, y un router necesita otra cosa: por cuál vecino
sacar el paquete. Se obtiene caminando hacia atrás desde el destino. ¿Cómo se llega a
d? Por b. ¿Y a b? Directo desde a. Entonces hacia d el next hop es b. El
programa lo hace mientras avanza: el next hop de un nodo es el de su predecesor.
Miren la fila de e. Hay dos caminos de costo 6: a-c-e (1 + 5) y a-b-d-e (3 + 2 +
1). Como e empata, f, que está detrás de e, hereda los dos. Cuando dos caminos
empatan, un router puede usarlos a la vez y repartir el tráfico entre ellos. Eso se
llama ECMP (equal-cost multipath), y dijkstra.c guarda los dos porque OSPF hace lo
mismo, como veremos.
Error común. Dijkstra no da “la ruta de la red”, sino la del nodo de origen. Cada router corre su propio Dijkstra, con él mismo como origen. Ejecutarlo desde
ano le dice nada afsobre cómo llegar ab, aunque los dos tengan el mismo mapa.
¿Se pueden formar ciclos? Mientras todos tengan el mismo mapa, no: todos calculan caminos de menor costo sobre el mismo grafo, y por la propiedad de los tramos esos caminos encajan entre sí. Los ciclos aparecen solo cuando las bases de datos difieren, por ejemplo mientras una noticia se está inundando.
En la práctica. Conviene no atar el costo a la carga actual del enlace. Si el costo sube cuando hay tráfico, el tráfico se muda al otro camino, ese se llena, el primero se vacía, y las rutas oscilan. Por eso los protocolos reales usan costos que no cambian solos.
Vector de distancias
Ahora quitemos el mapa. Cada router conoce solo el costo de sus propios enlaces y lo que le cuentan sus vecinos. Parece poco, y alcanza gracias a la ecuación de Bellman-Ford. Si d(x, y) es el costo del mejor camino de x a y:
d(x, y) = el mínimo, sobre todos los vecinos v de x, de c(x, v) + d(v, y)Se lee así: para ir de x a y hay que salir por algún vecino. Si salgo por v, pago el enlace hasta v y después lo que le cueste a v llegar. Elijo al vecino que dé la menor suma, y ese vecino es mi next hop. Es la misma propiedad de los tramos de antes, escrita como ecuación.
Lo interesante es que se puede resolver de forma distribuida. Cada router mantiene un vector de distancias: su mejor estimación hacia cada destino. Periódicamente se lo manda a sus vecinos. Al recibir un vector, recalcula. No hace falta coordinación ni orden: si los costos no cambian, las estimaciones llegan a los valores correctos.
El programa dv_sim.c simula esto. Cada router guarda, por destino, un costo y un next
hop, y aplica dos reglas:
- Lo que diga mi next hop actual se acepta siempre, aunque sea peor. Es quien me lleva, así que si su costo subió, el mío también.
- Lo que diga otro vecino se acepta solo si mejora lo que tengo.
La primera regla parece un detalle, pero sin ella un router nunca se enteraría de las malas noticias. Por omisión, todos los routers anuncian a la vez, en rondas, cada uno con la tabla que tenía al empezar la ronda. Es una simplificación: en una red real cada uno anuncia cuando puede y los mensajes se cruzan.
Ejemplo resuelto, iteración por iteración
Usemos un grafo más chico, para poder hacerlo a mano:
          2
     w ------- x
      \       / \
     9 \    3/   \ 8
        \   /     \
          y ------ z
              1
Al empezar, cada router conoce solo a sus vecinos. Cada celda es costo/next hop. La
fila es el router y la columna, el destino:
$ ./dv_sim graphs/four.txt
ronda 0
     w      x      y      z
w    0      2/x    9/y    inf
x    2/w    0      3/y    8/z
y    9/w    3/x    0      1/z
z    inf    8/x    1/y    0
Hagamos a mano la primera ronda para w. Recibe los vectores de x y de y, los de
la ronda 0:
- Destino
y: porxcuesta 2 + 3 = 5, y porydirecto cuesta 9 + 0 = 9. Ganax, con 5. - Destino
z: porxcuesta 2 + 8 = 10, y porycuesta 9 + 1 = 10. Empatan. Se queda con el primero que encontró,x.
Y para z, destino w: por x cuesta 8 + 2 = 10, y por y cuesta 1 + 9 = 10. Otro
empate. Ya nadie tiene inf, y la tabla queda así:
ronda 1
     w      x      y      z
w    0      2/x    5/x    10/x
x    2/w    0      3/y    4/y
y    5/x    3/x    0      1/z
z    10/x   4/y    1/y    0
Fíjense en lo que aún está mal. x ya descubrió que llega a z con 4, pasando por
y, pero w todavía usa el 8 viejo de x porque recibió el vector antes de esa
mejora. La noticia avanza un salto por ronda. En la ronda 2, w recibe el 4 de x y
calcula 2 + 4 = 6. Y z recibe el 5 de y y calcula 1 + 5 = 6:
ronda 2
     w      x      y      z
w    0      2/x    5/x    6/x
x    2/w    0      3/y    4/y
y    5/x    3/x    0      1/z
z    6/y    4/y    1/y    0

convergió: 2 rondas, 30 anuncios
Una ronda más no cambia nada: la red convergió. El mejor camino más largo de este grafo es de 3 saltos (w-x-y-z), y por eso bastaron pocas rondas. Los 30 anuncios son 3 rondas por 10 mensajes: cada uno de los 5 enlaces lleva un vector en cada dirección.
Sobre el grafo de seis nodos, sin mapa y sin Dijkstra, los costos que obtiene a son
los mismos que calculamos antes:
$ ./dv_sim graphs/six.txt | tail -9
     a      b      c      d      e      f
a    0      3/b    1/c    5/b    6/c    8/c
b    3/a    0      4/c    2/d    3/d    5/d
c    1/a    4/b    0      5/d    5/e    7/e
d    5/b    2/b    5/c    0      1/e    3/e
e    6/c    3/d    5/c    1/d    0      2/f
f    8/e    5/e    7/e    3/e    2/e    0

convergió: 2 rondas, 54 anuncios
Hay una sola diferencia con dijkstra: en los empates, dv_sim se queda con un solo
next hop, y por eso muestra 6/c y no los dos. Es decisión de este programa, para
mantenerlo simple. Un protocolo real puede guardar los dos.
Buenas noticias y malas noticias
Mientras los costos no cambian, vector de distancias se porta bien. El problema está en
lo que pasa cuando cambian, porque la información viaja de boca en boca. Tomemos este
triángulo y miremos solo el destino p:
          2
     p ------- q
      \       /
    30 \     / 1
        \   /
          r
q llega a p directo, con 2, y r llega pasando por q, con 3.
Buenas noticias. El enlace p-q baja de 2 a 1:
$ ./dv_sim graphs/triangle.txt --dest p --inf 100 --set p q 1
convergió: 1 ronda, 12 anuncios
antes          q=2/p    r=3/q
--- el enlace p-q pasa a costar 1
evento         q=1/p    r=3/q
ronda 1        q=1/p    r=2/q
volvió a converger: 1 ronda, 12 anuncios
Una ronda y listo. Una mejora se propaga de inmediato, porque cada router la acepta apenas la oye.
Malas noticias. Ahora el mismo enlace sube de 2 a 20. El mejor camino de r
debería pasar a ser 21, por q, pero miren:
$ ./dv_sim graphs/triangle.txt --dest p --inf 100 --set p q 20
convergió: 1 ronda, 12 anuncios
antes          q=2/p    r=3/q
--- el enlace p-q pasa a costar 20
evento         q=20/p   r=3/q
ronda 1        q=4/r    r=21/q    ciclo: q > r > q
ronda 2        q=20/p   r=5/q
ronda 3        q=6/r    r=21/q    ciclo: q > r > q
ronda 4        q=20/p   r=7/q
ronda 5        q=8/r    r=21/q    ciclo: q > r > q
ronda 6        q=20/p   r=9/q
ronda 7        q=10/r   r=21/q    ciclo: q > r > q
ronda 8        q=20/p   r=11/q
ronda 9        q=12/r   r=21/q    ciclo: q > r > q
ronda 10       q=20/p   r=13/q
ronda 11       q=14/r   r=21/q    ciclo: q > r > q
ronda 12       q=20/p   r=15/q
ronda 13       q=16/r   r=21/q    ciclo: q > r > q
ronda 14       q=20/p   r=17/q
ronda 15       q=18/r   r=21/q    ciclo: q > r > q
ronda 16       q=20/p   r=19/q
ronda 17       q=20/p   r=21/q
volvió a converger: 17 rondas, 108 anuncios
¿Qué pasó en la ronda 1? q ve que su enlace directo ahora cuesta 20, y oye a r decir
“yo llego a p con 3”. Le cree, y calcula 1 + 3 = 4, mucho mejor que 20. Lo que q no
puede saber es que el camino de r pasaba por el mismo q. Un vector de distancias
trae costos, no caminos. Y al mismo tiempo r, que confía en su next hop, sube a 21.
Durante 16 rondas la estimación falsa sube de a dos, y en las rondas impares hay un
ciclo real: un paquete hacia p va de q a r y de r a q hasta agotar su TTL.
Termina recién cuando la mentira deja de ser mejor que el enlace de costo 20. Si ese
enlace hubiera costado 2000, serían cientos de rondas.
Idea clave. Las buenas noticias viajan rápido y las malas, lento. Una mejora se acepta al primer anuncio. Un empeoramiento hay que descubrirlo, y mientras tanto los routers se creen unos a otros información que ya no es cierta.
El conteo al infinito
El caso extremo es cuando no hay camino alternativo. Tres nodos en línea:
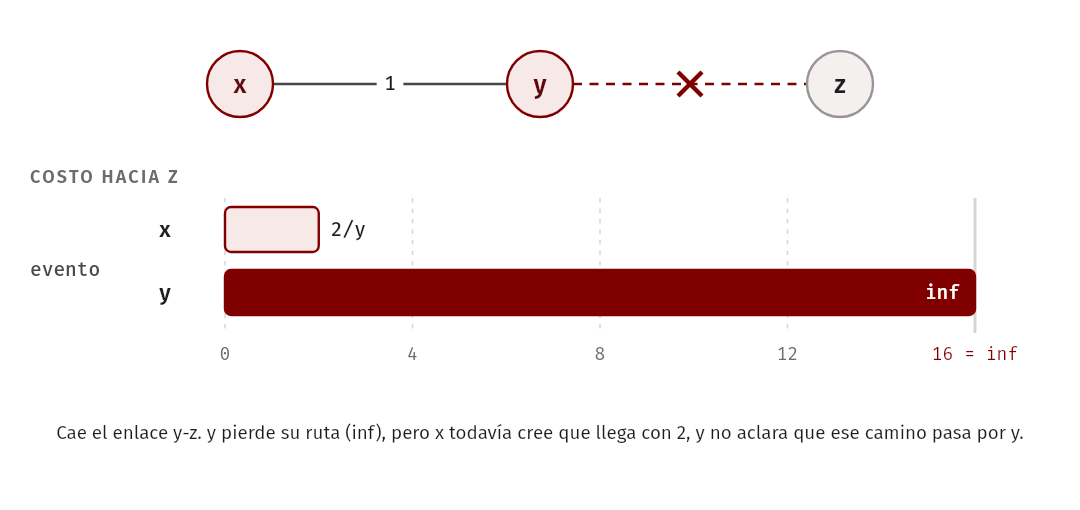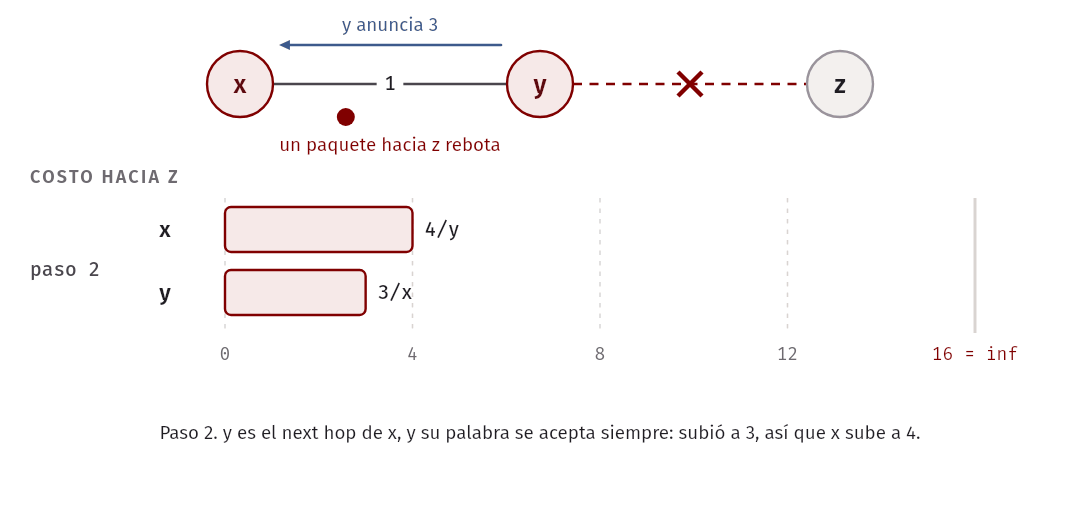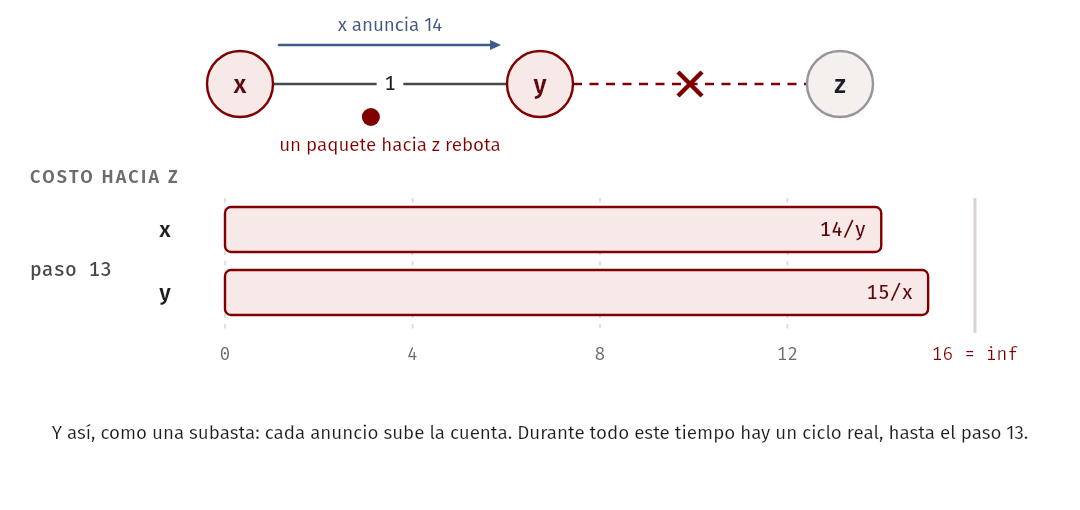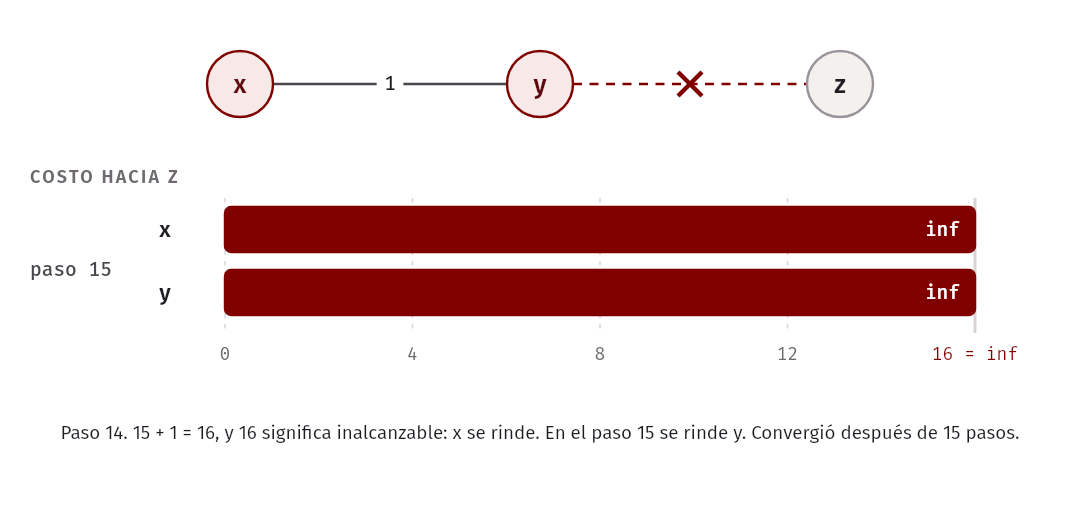
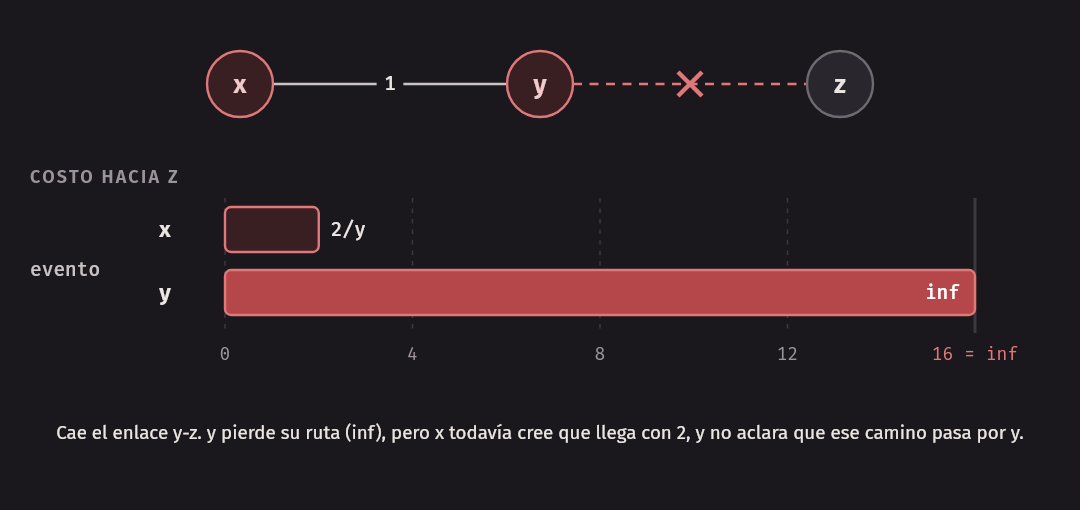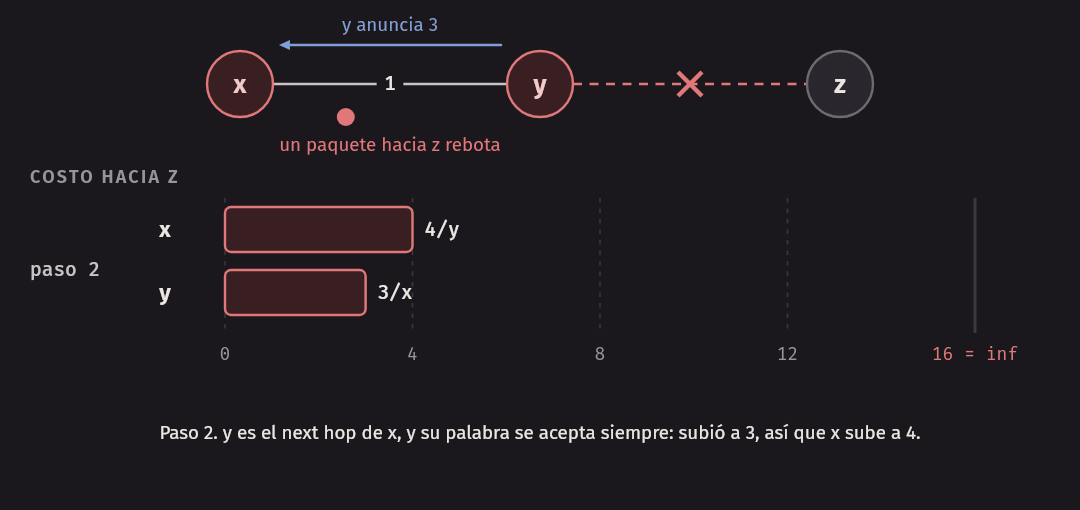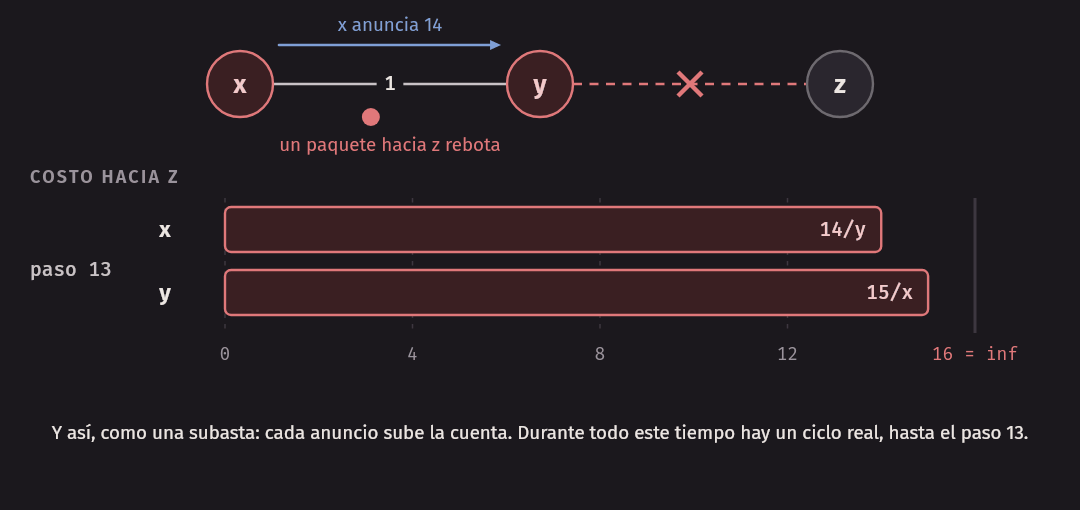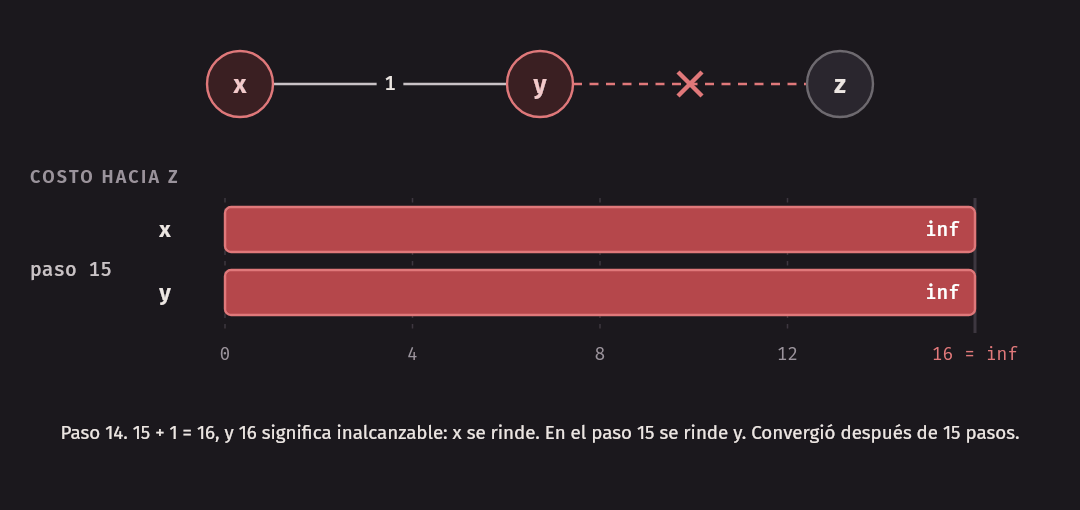
Cae el enlace y-z. Ahora z es inalcanzable, y nadie va a dar una mejor noticia nunca.
Fijemos un orden para que se vea claro: primero x le anuncia a y, después y a x,
y así sucesivamente.
$ ./dv_sim graphs/line.txt --dest z --fail y z --order x:y,y:x
convergió: 1 ronda, 8 anuncios
antes          x=2/y    y=1/z
--- cae el enlace y-z
evento         x=2/y    y=inf
paso 1 x>y     x=2/y    y=3/x     ciclo: x > y > x
paso 2 y>x     x=4/y    y=3/x     ciclo: x > y > x
paso 3 x>y     x=4/y    y=5/x     ciclo: x > y > x
paso 4 y>x     x=6/y    y=5/x     ciclo: x > y > x
paso 5 x>y     x=6/y    y=7/x     ciclo: x > y > x
paso 6 y>x     x=8/y    y=7/x     ciclo: x > y > x
paso 7 x>y     x=8/y    y=9/x     ciclo: x > y > x
paso 8 y>x     x=10/y   y=9/x     ciclo: x > y > x
paso 9 x>y     x=10/y   y=11/x    ciclo: x > y > x
paso 10 y>x    x=12/y   y=11/x    ciclo: x > y > x
paso 11 x>y    x=12/y   y=13/x    ciclo: x > y > x
paso 12 y>x    x=14/y   y=13/x    ciclo: x > y > x
paso 13 x>y    x=14/y   y=15/x    ciclo: x > y > x
paso 14 y>x    x=inf    y=15/x
paso 15 x>y    x=inf    y=inf
paso 16 y>x    x=inf    y=inf
paso 17 x>y    x=inf    y=inf
volvió a converger: 15 pasos, 17 anuncios
Lean el paso 1. y acaba de perder su ruta. x le dice “yo llego con 2”, sin aclarar
que ese camino pasaba por y. Entonces y calcula 3 y apunta hacia x. Desde ese
instante, un paquete hacia z rebota entre x e y. En el paso 2, x oye a su next
hop subir a 3, y por la regla 1 sube a 4. Y así, en una subasta sin fin.
Sin un tope, este proceso no termina nunca. Por eso vector de distancias define un valor
como infinito. En dv_sim, igual que en RIP, ese valor es 16: un costo de 16 o más
significa inalcanzable. El número no es arbitrario: tiene que ser más grande que cualquier
camino real, y mientras más grande, más se tarda en contar. A cambio, RIP solo sirve para
redes de hasta 15 saltos.
Split horizon y poison reverse
La causa del ciclo anterior es que x le anuncia a y una ruta que pasa por y. Hay un
arreglo evidente:
- Split horizon: no le anuncio una ruta al vecino por el que la aprendí.
- Poison reverse: se la anuncio, pero con costo infinito. Es más explícito: “por mí no vayas”.
Las dos resuelven la línea:
$ ./dv_sim graphs/line.txt --dest z --mode split --fail y z --order x:y,y:x
convergió: 1 ronda, 8 anuncios
antes          x=2/y    y=1/z
--- cae el enlace y-z
evento         x=2/y    y=inf
paso 1 x>y     x=2/y    y=inf
paso 2 y>x     x=inf    y=inf
paso 3 x>y     x=inf    y=inf
paso 4 y>x     x=inf    y=inf
volvió a converger: 2 pasos, 4 anuncios
Con --mode poison sale lo mismo. Y también arregla el triángulo de las malas noticias:
$ ./dv_sim graphs/triangle.txt --dest p --inf 100 --mode poison --set p q 20
convergió: 1 ronda, 12 anuncios
antes          q=2/p    r=3/q
--- el enlace p-q pasa a costar 20
evento         q=20/p   r=3/q
ronda 1        q=20/p   r=21/q
volvió a converger: 1 ronda, 12 anuncios
Una ronda, en vez de 17. ¿Qué diferencia hay entre las dos técnicas? Con split horizon,
un router que no oye nada de un vecino no sabe si la ruta sigue siendo buena, y solo la
olvida cuando vence. Por eso dv_sim hace vencer una ruta si su next hop calla por 6
rondas, igual que RIP la hace vencer tras 180 s con anuncios cada 30 s. Poison reverse
no tiene que esperar eso, a cambio de mensajes más grandes.
Los límites
Split horizon y poison reverse miran una sola relación: yo y el vecino que me dio la ruta. Por eso evitan los ciclos de dos nodos, y nada garantiza los de tres. Agreguemos un triángulo con una cola:
     a ---1--- b
      \       /
      1\     /1
        \   /
          c ---1--- d
Cae c-d. Antes de la falla, a y b llegan a d por c. Ninguno de los dos pasa por
el otro, así que se anuncian mutuamente su costo de verdad, sin veneno: “yo llego con 2”.
$ ./dv_sim graphs/tail.txt --dest d --mode poison --fail c d
convergió: 1 ronda, 16 anuncios
antes          a=2/c    b=2/c    c=1/d
--- cae el enlace c-d
evento         a=2/c    b=2/c    c=inf
ronda 1        a=3/b    b=3/a    c=inf     ciclo: a > b > a
ronda 2        a=inf    b=inf    c=4/a
ronda 3        a=inf    b=5/c    c=inf
ronda 4        a=6/b    b=inf    c=inf
ronda 5        a=inf    b=inf    c=7/a
ronda 6        a=inf    b=8/c    c=inf
ronda 7        a=9/b    b=inf    c=inf
ronda 8        a=inf    b=inf    c=10/a
ronda 9        a=inf    b=11/c   c=inf
ronda 10       a=12/b   b=inf    c=inf
ronda 11       a=inf    b=inf    c=13/a
ronda 12       a=inf    b=14/c   c=inf
ronda 13       a=15/b   b=inf    c=inf
ronda 14       a=inf    b=inf    c=inf
volvió a converger: 14 rondas, 90 anuncios
En la ronda 1, a se entera de que c perdió la ruta, pero en la misma ronda oye a b
decir “yo llego con 2”. Ese anuncio ya era falso, y b todavía no lo sabe. Con poison
reverse y todo, la ruta falsa circula por el triángulo, sube de a uno por ronda y solo
muere al llegar a 16. Con --mode split se obtiene lo mismo, y tarda algo más.
El ciclo también puede ser de tres nodos, si los mensajes llegan en un orden desfavorable:
$ ./dv_sim graphs/tail.txt --dest d --mode poison --fail c d --order c:a,b:a,a:c,c:b --max 12
convergió: 1 ronda, 16 anuncios
antes          a=2/c    b=2/c    c=1/d
--- cae el enlace c-d
evento         a=2/c    b=2/c    c=inf
paso 1 c>a     a=inf    b=2/c    c=inf
paso 2 b>a     a=3/b    b=2/c    c=inf
paso 3 a>c     a=3/b    b=2/c    c=4/a     ciclo: a > b > c > a
paso 4 c>b     a=3/b    b=5/c    c=4/a     ciclo: a > b > c > a
paso 5 c>a     a=3/b    b=5/c    c=4/a     ciclo: a > b > c > a
paso 6 b>a     a=6/b    b=5/c    c=4/a     ciclo: a > b > c > a
paso 7 a>c     a=6/b    b=5/c    c=7/a     ciclo: a > b > c > a
paso 8 c>b     a=6/b    b=8/c    c=7/a     ciclo: a > b > c > a
paso 9 c>a     a=6/b    b=8/c    c=7/a     ciclo: a > b > c > a
paso 10 b>a    a=9/b    b=8/c    c=7/a     ciclo: a > b > c > a
paso 11 a>c    a=9/b    b=8/c    c=10/a    ciclo: a > b > c > a
paso 12 c>b    a=9/b    b=11/c   c=10/a    ciclo: a > b > c > a
detenido por --max: 12 pasos, 12 anuncios
Sin ese límite, el conteo sigue hasta 16.
Ningún mensaje viola la regla. a envenena hacia b, su next hop, y b envenena hacia
c, el suyo. Pero cada uno le cuenta su ruta a quien no es su next hop, y al recorrer
el círculo la información vuelve al origen. Para detectar un ciclo de cualquier largo,
un router necesitaría saber por dónde pasa la ruta, no solo cuánto cuesta. Esa es
justamente la idea del vector de caminos de BGP, la próxima semana.
Error común. “Poison reverse resuelve el conteo al infinito.” Lo resuelve solo para ciclos de dos nodos. Con tres o más routers que se conocen entre sí, el conteo sigue pasando. Los protocolos reales combinan estas técnicas con temporizadores, y aun así convergen más lento que estado de enlace.
Comparación de los dos algoritmos
| Estado de enlace | Vector de distancias | |
|---|---|---|
| Información que guarda | El grafo entero | Una distancia y un next hop por destino |
| Mensajes | Del orden de n·e al arrancar. Después, solo lo que cambia, a toda la red | Vectores a los vecinos. Un cambio local puede o no propagarse |
| Cálculo local | Dijkstra: del orden de n² en la versión simple | Una comparación por vecino y destino |
| Convergencia | Inundar y recalcular. Hay ciclos pasajeros, solo mientras las bases difieren | Lenta con malas noticias. Puede contar al infinito |
| Si un router se equivoca | Daña sobre todo lo suyo | Puede arrastrar a toda la red |
La última fila merece un ejemplo. En dv_sim, --lie hace que un router anuncie un
costo falso. Supongamos que e, por un error de configuración, dice que llega a a con
costo 0:
$ ./dv_sim graphs/six.txt --dest a --lie e a 0
convergió: 2 rondas, 54 anuncios
antes          b=3/a    c=1/a    d=5/b    e=6/c    f=8/e
--- e anuncia a con costo 0
evento         b=3/a    c=1/a    d=5/b    e=0      f=8/e
ronda 1        b=3/a    c=1/a    d=1/e    e=0      f=2/e
volvió a converger: 1 ronda, 36 anuncios
d cambia de next hop y f cree que ahora está a 2. Los dos mandan el tráfico hacia e,
que no lleva a ningún lado. b y c se salvan porque están muy cerca de a y ninguna
oferta mejora lo que tienen. Lo grave es que d y f no reciben un dato falso aislado:
lo incorporan a su propio costo y lo vuelven a anunciar. El número falso queda mezclado
en los vectores de los demás, sin rastro de quién lo inventó.
En estado de enlace, un router anuncia lo suyo y cada uno calcula con todo lo de los demás. Un costo falso afecta solo a los caminos que usan los enlaces de ese router, y el anuncio lleva la firma de quien lo originó, de modo que se puede rastrear. No es inmune: un router también puede anunciar como propio un prefijo ajeno y atraer ese tráfico. Pero el error no se transforma al avanzar, y cada router sigue calculando con datos correctos sobre los demás.
¿Quién gana? No hay ganador absoluto. Vector de distancias es simple y barato en memoria, pero converge peor. Estado de enlace necesita más memoria y cálculo, y por eso domina dentro de una organización, donde la computadora del router no es el problema y converger rápido sí importa. Entre organizaciones nadie quiere publicar su mapa, y gana una variante del vector de distancias. Esa es la historia de la próxima semana.
Dos tablas que no son la misma
Antes de pasar a OSPF, aclaremos una confusión que aparecerá apenas abramos un router. En el lenguaje diario se dice “la tabla de routing” para todo. Pero en un router hay más de una tabla, y sirven para cosas distintas:
- La tabla de routing (RIB, routing information base) está en el plano de control. Guarda todas las rutas candidatas que conoce el router, de cualquier origen, incluso las que no usa.
- La forwarding table (FIB, forwarding information base) está en el plano de datos. Guarda solo las elegidas, en la forma que hace falta para decidir rápido.
En nuestros laboratorios el reparto es este. FRRouting es un conjunto de procesos: ospfd
habla OSPF y calcula, staticd guarda las rutas a mano, y zebra recibe las rutas de
todos, elige una por prefijo y la instala en el kernel. La forwarding table es la del
kernel de Linux, la que muestra ip route.
  ospfd        staticd              proponen rutas
    \            /
     v          v
   +----------------+
   |     zebra      |               tabla de routing: show ip route
   +----------------+               elige la de menor distancia administrativa
           |
           v
   +----------------+
   |  kernel Linux  |               forwarding table: ip route
   +----------------+
Levantemos el grafo de seis nodos hecho red, con make up-six. Cada nodo es un router y
cada arista, un enlace con el mismo costo. Todavía no explicamos cómo se configura OSPF;
por ahora basta con saber que usa estado de enlace y Dijkstra. Esta es parte de lo que dice
vtysh en a. Quitamos la leyenda del principio:
$ docker exec clab-w05-six-a vtysh -c 'show ip route ospf'
O   10.205.0.1/32 [110/0] is directly connected, lo, weight 1, 00:00:22
O>* 10.205.0.2/32 [110/3] via 10.205.12.2, eth1, weight 1, 00:00:02
O>* 10.205.0.3/32 [110/1] via 10.205.13.2, eth2, weight 1, 00:00:07
O>* 10.205.0.4/32 [110/5] via 10.205.12.2, eth1, weight 1, 00:00:02
O>* 10.205.0.5/32 [110/6] via 10.205.12.2, eth1, weight 1, 00:00:02
  *                       via 10.205.13.2, eth2, weight 1, 00:00:02
O>* 10.205.0.6/32 [110/8] via 10.205.12.2, eth1, weight 1, 00:00:02
  *                       via 10.205.13.2, eth2, weight 1, 00:00:02
O   10.205.12.0/30 [110/3] is directly connected, eth1, weight 1, 00:00:22
O   10.205.13.0/30 [110/1] is directly connected, eth2, weight 1, 00:00:21
Cada router tiene una dirección de loopback 10.205.0.N, una dirección que no depende de
ninguna interfaz física. La columna entre corchetes se lee [distancia/costo]. Miren los
costos: 3, 1, 5, 6 y 8. Son exactamente los de nuestra tabla a mano, y 10.205.0.5 y
10.205.0.6 (los nodos e y f) aparecen con dos next hop, el empate que encontramos en
el paso 3. La prueba test_six.py hace esta comparación desde los seis routers contra la
salida de dijkstra.
Los símbolos dicen qué pasó con cada ruta: > es la seleccionada y * la que está en la
FIB. La línea de 10.205.12.0/30 no tiene ninguno de los dos. OSPF conoce ese prefijo, pero
a está conectado a él directamente, y una ruta conectada tiene prioridad. Es una ruta en la
RIB que nunca llegó a la FIB.
En el kernel, lo que quedó es esto:
$ docker exec clab-w05-six-a ip route
10.205.0.2 nhid 22 via 10.205.12.2 dev eth1 proto ospf metric 20
10.205.0.3 nhid 17 via 10.205.13.2 dev eth2 proto ospf metric 20
10.205.0.4 nhid 22 via 10.205.12.2 dev eth1 proto ospf metric 20
10.205.0.5 nhid 23 proto ospf metric 20
	nexthop via 10.205.13.2 dev eth2 weight 1
	nexthop via 10.205.12.2 dev eth1 weight 1
10.205.0.6 nhid 23 proto ospf metric 20
	nexthop via 10.205.13.2 dev eth2 weight 1
	nexthop via 10.205.12.2 dev eth1 weight 1
10.205.12.0/30 dev eth1 proto kernel scope link src 10.205.12.1
10.205.13.0/30 dev eth2 proto kernel scope link src 10.205.13.1
Dos detalles que despistan. El metric 20 no es el costo de OSPF: es un valor fijo con el
que zebra marca sus rutas en el kernel, y por eso sale 20 aunque el costo sea 1 o 8. El
costo se lee en vtysh. Y las dos líneas nexthop son ECMP en la forwarding table: el kernel
reparte por flujo, de modo que dos paquetes de una misma conexión siguen el mismo camino.
Con otras direcciones de origen, el reparto puede salir por el otro. Lo vemos con ip route get, que usa como origen la dirección de la interfaz, y con un traceroute desde el loopback
de a:
$ docker exec clab-w05-six-a ip route get 10.205.0.6
10.205.0.6 via 10.205.13.2 dev eth2 src 10.205.13.1 uid 0
    cache
$ docker exec clab-w05-six-a traceroute -n -q1 -s 10.205.0.1 10.205.0.6
traceroute to 10.205.0.6 (10.205.0.6) from 10.205.0.1, 30 hops max, 46 byte packets
 1  10.205.12.2  0.005 ms
 2  10.205.24.2  0.001 ms
 3  10.205.45.2  0.002 ms
 4  10.205.0.6  0.002 ms
Para ver las tablas separadas, agreguemos una ruta a mano hacia d, por un camino que OSPF no
elegiría:
$ docker exec clab-w05-six-a vtysh -c 'conf t' -c 'ip route 10.205.0.4/32 10.205.13.2'
$ docker exec clab-w05-six-a vtysh -c 'show ip route 10.205.0.4/32'
Routing entry for 10.205.0.4/32
  Known via "static", distance 1, metric 0, best
  Last update 00:00:02 ago
  * 10.205.13.2, via eth2, weight 1

Routing entry for 10.205.0.4/32
  Known via "ospf", distance 110, metric 5
  Last update 00:00:04 ago
    10.205.12.2, via eth1, weight 1

$ docker exec clab-w05-six-a ip route show 10.205.0.4
10.205.0.4 nhid 17 via 10.205.13.2 dev eth2 proto 196 metric 20
$ docker exec clab-w05-six-a vtysh -c 'show ip ospf route' | grep -A1 '10.205.0.4/32'
N    10.205.0.4/32         [5] area: 0.0.0.0
                           via 10.205.12.2, eth1
Son tres respuestas distintas para la misma pregunta. ospfd sigue creyendo que el mejor
camino es por b, con costo 5. La RIB tiene las dos rutas y eligió la estática, porque su
distancia administrativa es 1, contra 110 de OSPF: esa distancia compara orígenes, no
costos. Y el kernel solo tiene la elegida (196 es el número con que FRRouting marca lo
estático; ip en esta imagen no tiene nombre para él). Al borrar la ruta estática, vuelve
la de OSPF, porque nunca se había ido de la RIB.
Error común. Confundir la tabla de routing con la de forwarding. FRRouting calcula la primera, e instala lo elegido en la segunda, la del kernel. Si
show ip routemuestra una ruta y el paquete no la sigue, miren si tiene>*, y comparen conip route. Una ruta sin*no mueve ningún paquete.
Por qué un solo algoritmo no alcanza
Hasta aquí imaginamos una sola red, con todos los routers iguales y un solo costo por enlace. Internet está hecha de decenas de miles de redes así, y ese modelo falla por dos razones.
Escala. Con estado de enlace, cada router guardaría el mapa de todo el planeta, con cientos de miles de prefijos, y cualquier enlace que se cae en cualquier lugar obligaría a todos a inundar y recalcular. Con vector de distancias, los anuncios serían enormes y no convergerían nunca.
Autonomía. Una empresa, una universidad o un proveedor quieren decidir cómo funciona su propia red, con los criterios que les convienen, y no quieren publicar su topología. Además, sus decisiones entre redes no son técnicas: un proveedor no lleva gratis el tráfico de otro.
La solución es dividir. Un sistema autónomo (AS, autonomous system) es un conjunto de routers bajo una misma administración, que aplica una política de routing común y se identifica con un número. Hay entonces dos problemas separados:
- Routing dentro de un AS (intra-AS, o IGP): cada red elige su protocolo, y el objetivo es el mejor camino con sus propios costos. OSPF e IS-IS son los usuales. Es el tema de hoy.
- Routing entre AS (inter-AS): todos usan el mismo protocolo, BGP, y lo que manda es la política, no el costo. Es el tema de la próxima semana.
Idea clave. Dentro de un AS manda el desempeño; entre AS manda la política. Por eso son protocolos distintos, con objetivos distintos. Un AS elige su IGP sin preguntarle a nadie, y nadie de afuera se entera.
OSPF
OSPF (Open Shortest Path First) es un protocolo de estado de enlace. “Open” significa que su especificación es pública, el RFC 2328 para IPv4. Lo que vimos en la Sesión A se traduce casi directamente:
| Concepto | En OSPF |
|---|---|
| Descubrir vecinos | Paquetes Hello |
| Sincronizar el mapa con un vecino nuevo | Adyacencia: Database Description, LS Request |
| Inundar un cambio | LS Update, confirmado con LS Ack |
| El anuncio | LSA |
| El mapa | LSDB, base de datos de estado de enlace |
| Calcular | SPF, que es Dijkstra |
| Costo | Lo configura el administrador, por interfaz |
Dos rasgos llaman la atención. OSPF corre directo sobre IP, con número de protocolo 89, sin
TCP ni UDP. Por eso implementa su propia entrega confiable: confirmaciones y retransmisión. Y
se habla con sus vecinos por multicast, a 224.0.0.5, con TTL 1: un paquete OSPF nunca sale del
enlace en que se envió. Las direcciones multicast llegan a quien escucha en esa red, sin que
nadie conozca de antemano a sus vecinos.
Configurarlo en FRRouting
Este es el frr.conf del router c:
frr defaults traditional
hostname c
log file /tmp/ospfd.log
!
interface lo
 ip address 10.205.0.3/32
!
! hacia a
interface eth1
 ip address 10.205.13.2/30
 ip ospf network point-to-point
 ip ospf cost 1
!
! hacia b
interface eth2
 ip address 10.205.23.2/30
 ip ospf network point-to-point
 ip ospf cost 4
!
! hacia d
interface eth3
 ip address 10.205.34.1/30
 ip ospf network point-to-point
 ip ospf cost 5
!
! hacia e
interface eth4
 ip address 10.205.35.1/30
 ip ospf network point-to-point
 ip ospf cost 5
!
router ospf
 ospf router-id 10.205.0.3
 log-adjacency-changes detail
 network 10.205.0.0/16 area 0
Línea por línea:
ip ospf costfija el costo de salir por esa interfaz. Un mismo enlace puede tener un costo distinto en cada dirección. Aquí los dos extremos tienen el mismo, porque el grafo no tiene direcciones.ip ospf network point-to-pointle dice a OSPF que en ese enlace solo hay un vecino posible. Lo explicamos en un momento.router ospfabre la configuración del proceso.ospf router-ides el nombre del router dentro de OSPF. Es un número de 32 bits que se escribe como una dirección IP. Usar el loopback es una costumbre, no una regla.network 10.205.0.0/16 area 0dice: toda interfaz cuya dirección esté dentro de ese prefijo participa en OSPF, en el área 0. No anuncia ese prefijo, sino que selecciona interfaces. Lo que se anuncia son las subredes de esas interfaces. Vean la tabla de arriba: en ningún lado aparece un10.205.0.0/16.log-adjacency-changes detailregistra cada cambio de estado de un vecino. Sin esa línea y ellog file, los routers de la imagen no guardan ningún registro.
Las mismas líneas se pueden escribir en vivo dentro de vtysh, y vtysh -c corre un comando sin
entrar a la consola. Los comandos para mirar son estos:
| Comando | Qué responde |
|---|---|
show ip ospf neighbor |
¿Quiénes son mis vecinos, y en qué estado? |
show ip ospf interface eth1 |
Área, costo, temporizadores y tipo de red de una interfaz |
show ip ospf database |
El mapa: la lista de LSA |
show ip ospf route |
Lo que calculó ospfd |
show ip route ospf |
Lo que ospfd propuso y quedó en la RIB |
En la práctica. La configuración hecha con
vtyshvive en la memoria. Si el contenedor se reinicia, se pierde a menos que la lleven afrr.conf. En las topologías del curso ese archivo se monta como solo lectura, así quewrite memoryfalla a propósito: edítenlo en su computadora. En sus proyectos, elfrr.confes el documento: nada se configura a mano sin dejarlo escrito.
Costos: mejor explícitos
¿Qué pasa si no ponemos ip ospf cost? OSPF deriva el costo dividiendo un ancho de banda de
referencia por el de la interfaz. Quitémoslo de eth1 en a para ver:
  ifindex 8779, MTU 1500 bytes, BW 10000 Mbit <UP,LOWER_UP,BROADCAST,RUNNING,MULTICAST>
  Router ID 10.205.0.1, Network Type POINTOPOINT, Cost: 10
Una interfaz veth se declara de 10 000 Mbit/s, y sale costo 10. Con bandwidth 1000, en otra
interfaz, medimos así (las dos últimas líneas agregan auto-cost reference-bandwidth 1000):
  ifindex 8192, MTU 1500 bytes, BW 1000 Mbit <UP,LOWER_UP,BROADCAST,RUNNING,MULTICAST>
  Router ID 10.205.0.3, Network Type POINTOPOINT, Cost: 100
  ifindex 8192, MTU 1500 bytes, BW 1000 Mbit <UP,LOWER_UP,BROADCAST,RUNNING,MULTICAST>
  Router ID 10.205.0.3, Network Type POINTOPOINT, Cost: 1
De lo medido se deduce que aquí la fórmula da 100 000 dividido entre los Mbit/s de la interfaz,
y que auto-cost reference-bandwidth en Mbit/s reemplaza esa referencia. El manual de FRRouting
describe una referencia de 100 Mbit/s, así que el valor por defecto depende de la versión y sus
opciones: no lo den por hecho. En los laboratorios ponemos ip ospf cost en cada enlace. Así
el costo es una decisión escrita, y no un efecto secundario de lo que reporta una interfaz virtual.
Por cierto, esa cuenta explica una costumbre vieja: con la referencia clásica de 100 Mbit/s, un enlace de 100 Mbit/s y uno de 10 Gbit/s cuestan lo mismo, 1. Si todos los routers no usan la misma referencia, sus costos no se pueden comparar.
Hello y adyacencias
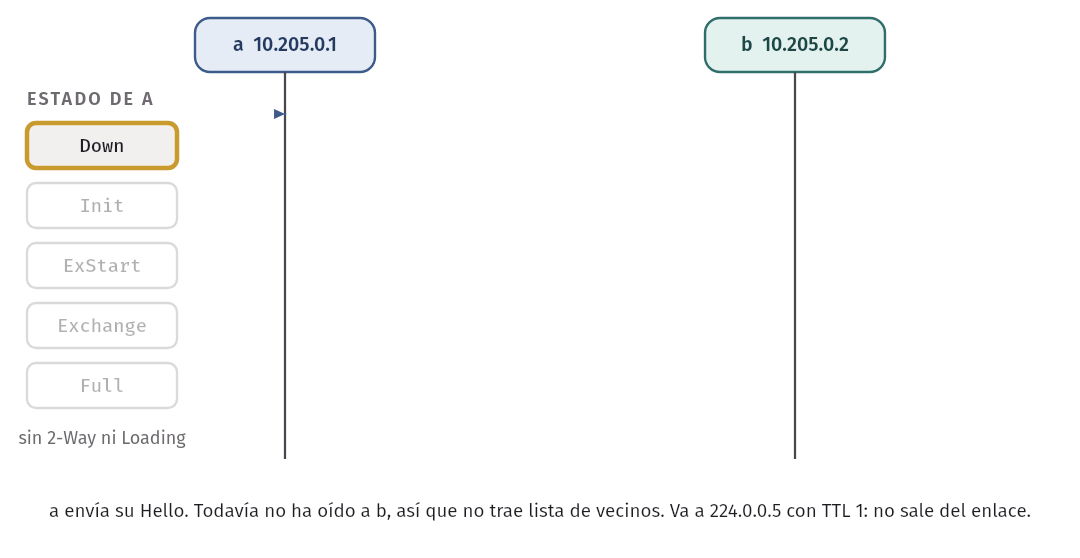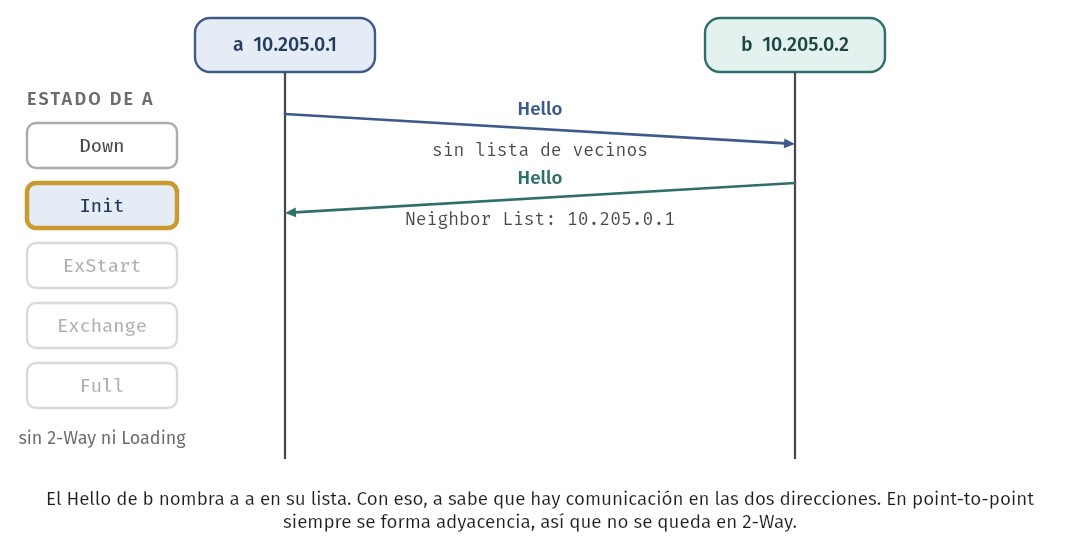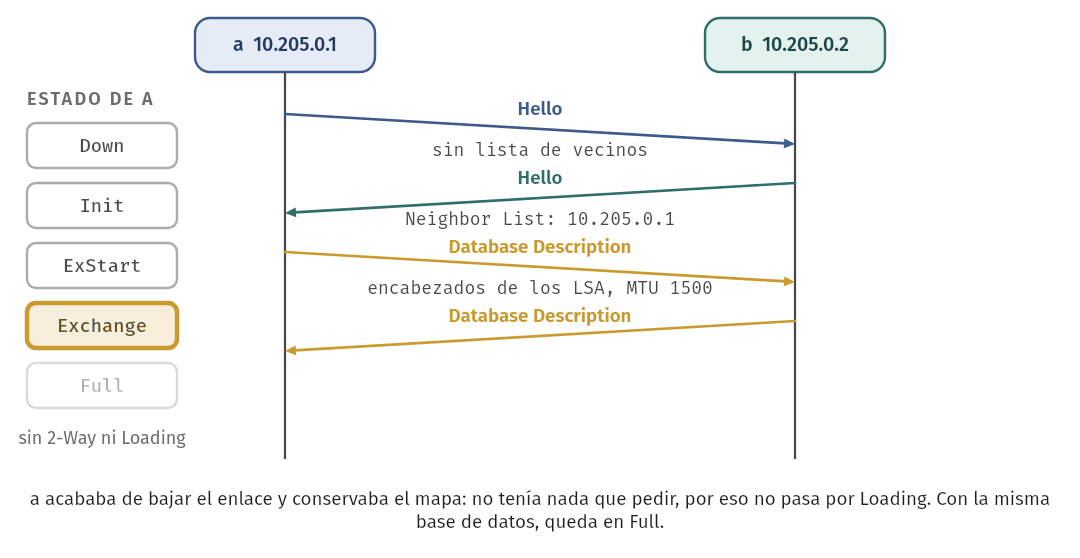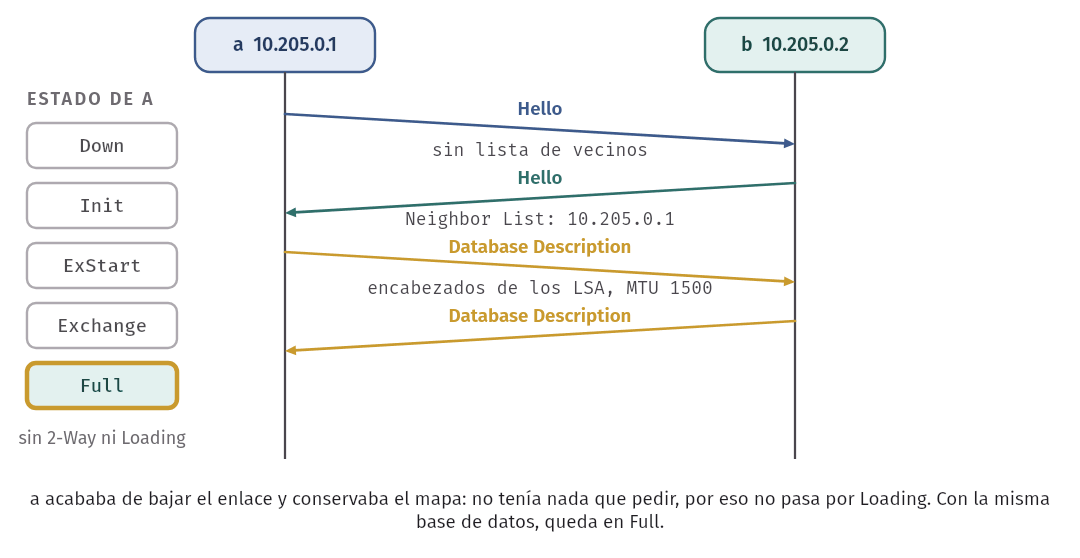
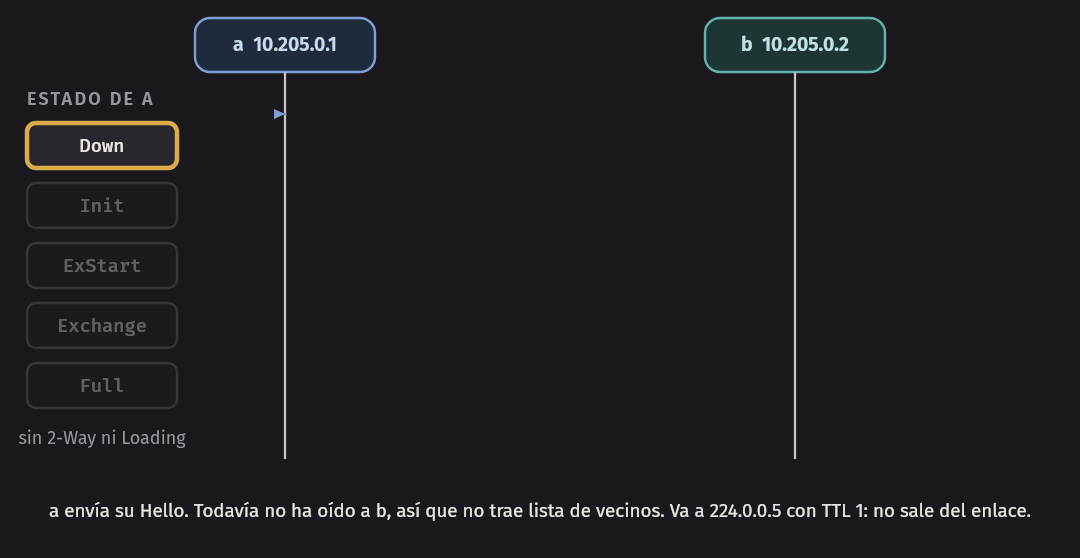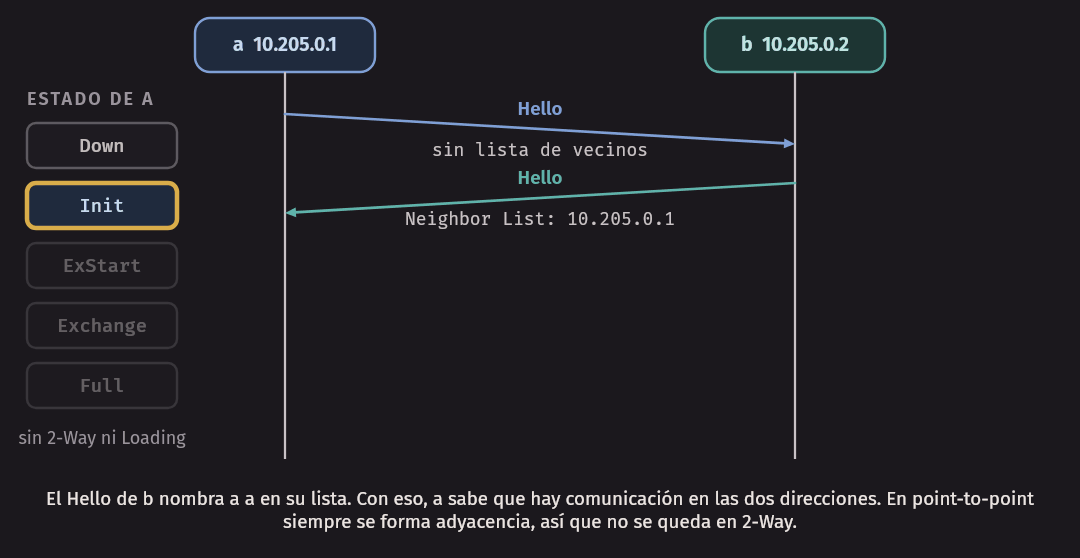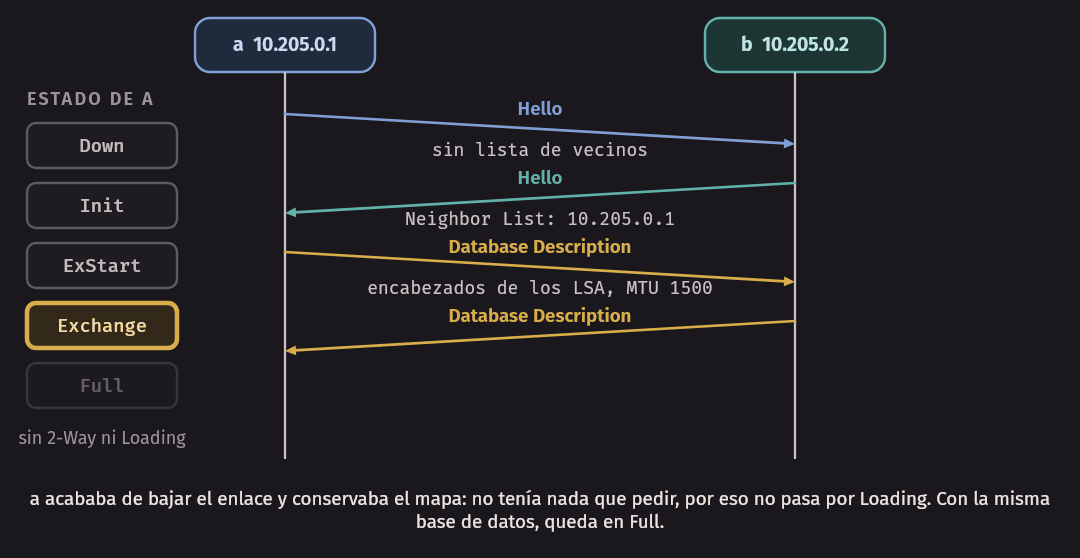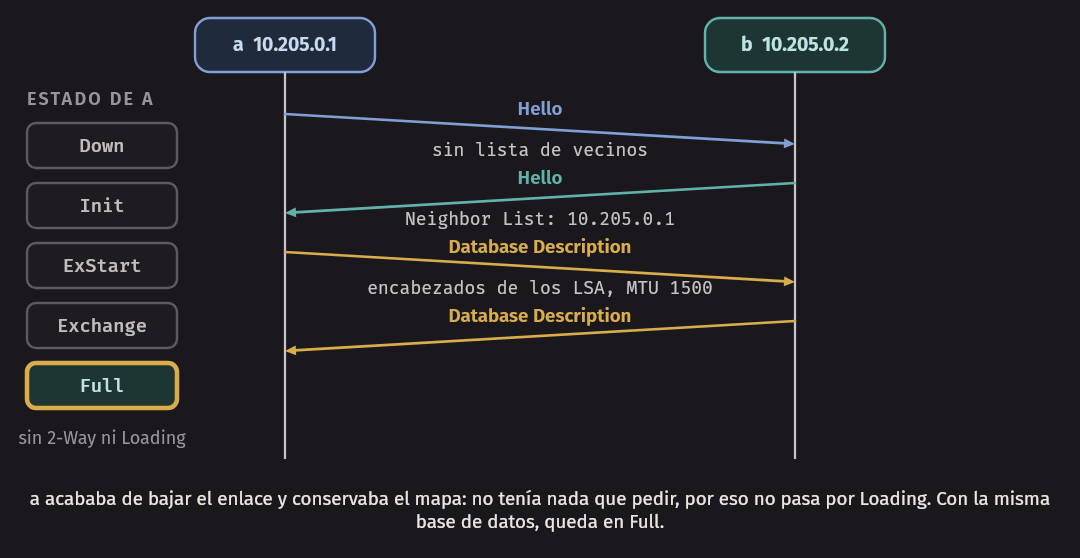
Dos routers conectados pasan por varias etapas hasta tener el mismo mapa. Cada estado responde a una pregunta:
| Estado | ¿Qué sé? |
|---|---|
Down |
Nada de este vecino |
Init |
Oí su Hello, pero él no me menciona: todavía no sé si me oye |
2-Way |
Me menciona en su Hello. La comunicación funciona en las dos direcciones |
ExStart |
Estamos acordando quién dirige el intercambio |
Exchange |
Nos mandamos los índices de nuestras bases de datos |
Loading |
Pido los LSA que me faltan |
Full |
Tenemos la misma base de datos. Ahora sí podemos usar el enlace |
El Hello cumple dos trabajos. Descubre vecinos, y su campo lista de vecinos es lo que prueba que la comunicación va en las dos direcciones: yo solo considero a alguien como vecino si veo mi nombre en lo que dice. Un enlace que solo funciona en un sentido no llega a formar adyacencia.
Veámoslo en vivo. Bajamos y subimos eth1 en a mientras capturamos con tcpdump -n -v -i eth1 ip proto 89. Con log-adjacency-changes detail, cada cambio queda escrito en /tmp/ospfd.log:
$ docker exec clab-w05-six-a grep AdjChg /tmp/ospfd.log
08:03:38 OSPF: AdjChg: Nbr 10.205.0.2 ... on eth1:10.205.12.1: Full -> Deleted (KillNbr)
08:03:39 OSPF: AdjChg: Nbr 10.205.0.2 ... on eth1:10.205.12.1: Down -> Init (HelloReceived)
08:03:39 OSPF: AdjChg: Nbr 10.205.0.2 ... on eth1:10.205.12.1: Init -> ExStart (2-WayReceived)
08:03:39 OSPF: AdjChg: Nbr 10.205.0.2 ... on eth1:10.205.12.1: ExStart -> Exchange (NegotiationDone)
08:03:39 OSPF: AdjChg: Nbr 10.205.0.2 ... on eth1:10.205.12.1: Exchange -> Full (ExchangeDone)
(Acortamos el principio de cada línea, sin cambiar lo demás). No se ve 2-Way como estado propio.
Al recibir el Hello con su nombre, un router decide si debe formar adyacencia con ese vecino. En
un enlace point-to-point siempre debe, así que pasa de frente a ExStart. Tampoco se ve Loading,
porque esta vez a no tenía nada que pedir: acababa de bajar el enlace y conservaba el mapa. Cuando
la red arranca desde cero, sí aparece: Exchange -> Loading (ExchangeDone) y Loading -> Full (LoadingDone).
Los paquetes de ese mismo momento:
08:03:39.474012 IP (tos 0xc0, ttl 1, id 17380, offset 0, flags [none], proto OSPF (89), length 64)
    10.205.12.1 > 224.0.0.5: OSPFv2, Hello, length 44
	Router-ID 10.205.0.1, Backbone Area, Authentication Type: none (0)
	Options [External]
	  Hello Timer 10s, Dead Timer 40s, Mask 255.255.255.252, Priority 1
08:03:39.474079 IP (tos 0xc0, ttl 1, id 17403, offset 0, flags [none], proto OSPF (89), length 68)
    10.205.12.2 > 224.0.0.5: OSPFv2, Hello, length 48
	Router-ID 10.205.0.2, Backbone Area, Authentication Type: none (0)
	Options [External]
	  Hello Timer 10s, Dead Timer 40s, Mask 255.255.255.252, Priority 1
	  Neighbor List:
	    10.205.0.1
Comprueben lo que decíamos del TTL 1, el protocolo 89 y la dirección multicast. En el Hello van el
área, los temporizadores y la máscara: justo lo que se debe coincidir, como veremos. Y en la segunda
línea, b ya menciona a a en su lista. Ese es el instante en que a sabe que hay comunicación
en las dos direcciones. Después viene el índice de la base de datos, en el Database Description:
08:03:39.474554 IP (tos 0xc0, ttl 1, id 17382, offset 0, flags [none], proto OSPF (89), length 172)
    10.205.12.1 > 224.0.0.5: OSPFv2, Database Description, length 152
	Router-ID 10.205.0.1, Backbone Area, Authentication Type: none (0)
	Options [External], DD Flags [none], MTU: 1500, Sequence: 0x3dd493f0
	  Advertising Router 10.205.0.1, seq 0x80000008, age 0s, length 52
	    Router LSA (1), LSA-ID: 10.205.0.1
	    Options: [External]
	  Advertising Router 10.205.0.2, seq 0x8000000a, age 2s, length 76
	    Router LSA (1), LSA-ID: 10.205.0.2
	    Options: [External]
	  Advertising Router 10.205.0.3, seq 0x80000009, age 20s, length 112
	    Router LSA (1), LSA-ID: 10.205.0.3
	    Options: [External]
De los seis encabezados que caben en length 152 (24 de OSPF, 8 del Database Description y 20 por cada uno), aquí dejamos tres.
Trae solo los encabezados de los LSA: quién lo originó, su número de secuencia y su edad. Es un
índice, no los datos. Cada router compara con lo suyo y pide lo que le falta. Y fíjense en el campo
MTU: 1500: también viaja aquí, y más abajo veremos para qué sirve.
Los temporizadores
El Hello no se manda solo una vez. Se repite cada HelloInterval, para decir “sigo vivo”, y si pasa un RouterDeadInterval sin oír a un vecino, se lo da por muerto. Los valores usuales en una red local son 10 s y 40 s, cuatro veces más para tolerar pérdidas:
$ docker exec clab-w05-six-a vtysh -c 'show ip ospf interface eth1'
eth1 is up
  ifindex 8779, MTU 1500 bytes, BW 10000 Mbit <UP,LOWER_UP,BROADCAST,RUNNING,MULTICAST>
  Internet Address 10.205.12.1/30, Broadcast 10.205.12.3, Area 0.0.0.0
  MTU mismatch detection: enabled
  Router ID 10.205.0.1, Network Type POINTOPOINT, Cost: 3
  Transmit Delay is 1 sec, State Point-To-Point, Priority 1
  No backup designated router on this network
  Multicast group memberships: OSPFAllRouters
  Timer intervals configured, Hello 10s, Dead 40s, Wait 40s, Retransmit 5
    Hello due in 9.173s
  Neighbor Count is 1, Adjacent neighbor count is 1
  Graceful Restart hello delay: 10s
  LSA retransmissions: 0
Redes point-to-point y redes broadcast
Un enlace Ethernet puede conectar a muchos routers con un switch. Con n routers en la misma red, formar una adyacencia entre cada par daría del orden de n² adyacencias, y cada cambio se inundaría por todas. Por eso, en una red broadcast, OSPF elige un router designado (DR, designated router) y uno de respaldo (BDR). Todos forman adyacencia completa solo con esos dos. El DR origina un Network LSA, un nodo más del grafo, que representa a la red entera y lista a quienes están en ella.
Si no se le dice otra cosa, OSPF trata a un enlace Ethernet como broadcast, aunque solo haya dos
routers. El precio se ve al arrancar. Sin ip ospf network point-to-point, la elección espera un
Wait de 40 s, por si ya existe un DR, y aparece un Network LSA para cada enlace:
Neighbor ID     Pri State           Up Time         Dead Time Address         Interface                        RXmtL RqstL DBsmL
10.205.0.2        1 Full/DR         0.430s            39.575s 10.205.12.2     eth1:10.205.12.1                     1     0     0
Full/DR significa que el vecino es el DR de ese enlace. En cambio, con point-to-point, sale Full/-:
$ docker exec clab-w05-six-a vtysh -c 'show ip ospf neighbor'

Neighbor ID     Pri State           Up Time         Dead Time Address         Interface                        RXmtL RqstL DBsmL
10.205.0.2        1 Full/-          5.909s            39.469s 10.205.12.2     eth1:10.205.12.1                     1     0     0
10.205.0.3        1 Full/-          10.882s           39.116s 10.205.13.2     eth2:10.205.13.1                     0     0     0
No hay elección ni Network LSA, y en esta topología la red convergió 16 s después de levantarla. Cada
LSA de router lista directamente a sus vecinos. Por eso usamos point-to-point en los /30 entre routers
de nuestros laboratorios, y dejamos broadcast para donde de verdad haya varios routers en la misma red.
La base de datos
Esta es la base de datos de a, y debajo la de d, con las columnas Age que cambian de un
momento a otro:
$ docker exec clab-w05-six-a vtysh -c 'show ip ospf database'

       OSPF Router with ID (10.205.0.1)

                Router Link States (Area 0.0.0.0)

Link ID         ADV Router      Age  Seq#       CkSum  Link count
10.205.0.1     10.205.0.1         6 0x80000005 0x64d9 5
10.205.0.2     10.205.0.2         7 0x80000007 0x0d36 7
10.205.0.3     10.205.0.3        13 0x80000009 0x9b91 9
10.205.0.4     10.205.0.4         7 0x80000009 0xbc11 9
10.205.0.5     10.205.0.5         8 0x80000007 0xeeac 7
10.205.0.6     10.205.0.6         8 0x80000005 0x5034 5

$ docker exec clab-w05-six-d vtysh -c 'show ip ospf database'

       OSPF Router with ID (10.205.0.4)

                Router Link States (Area 0.0.0.0)

Link ID         ADV Router      Age  Seq#       CkSum  Link count
10.205.0.1     10.205.0.1         8 0x80000005 0x64d9 5
10.205.0.2     10.205.0.2         6 0x80000007 0x0d36 7
10.205.0.3     10.205.0.3        11 0x80000009 0x9b91 9
10.205.0.4     10.205.0.4         6 0x80000009 0xbc11 9
10.205.0.5     10.205.0.5         6 0x80000007 0xeeac 7
10.205.0.6     10.205.0.6         6 0x80000005 0x5034 5
Los números de secuencia y los checksums coinciden línea por línea. Es el mismo mapa en dos
routers, que es lo que promete la inundación confiable. Hay un LSA por router, originado por él mismo.
El número de secuencia es el que permite decidir cuál es más nuevo. Este es el de b, reducido a lo
que importa:
$ docker exec clab-w05-six-a vtysh -c 'show ip ospf database router 10.205.0.2'
  LS Type: router-LSA
  Link State ID: 10.205.0.2
  Advertising Router: 10.205.0.2
  LS Seq Number: 80000007
  Checksum: 0x0d36
  Length: 108

   Number of Links: 7

    Link connected to: Stub Network
     (Link ID) Net: 10.205.0.2
     (Link Data) Network Mask: 255.255.255.255
      Number of TOS metrics: 0
       TOS 0 Metric: 0

    Link connected to: another Router (point-to-point)
     (Link ID) Neighboring Router ID: 10.205.0.1
     (Link Data) Router Interface address: 10.205.12.2
      Number of TOS metrics: 0
       TOS 0 Metric: 3

    Link connected to: Stub Network
     (Link ID) Net: 10.205.12.0
     (Link Data) Network Mask: 255.255.255.252
      Number of TOS metrics: 0
       TOS 0 Metric: 3
Esto es el grafo. b anuncia que tiene un vecino 10.205.0.1 a costo 3, y lo mismo para los otros
dos, a costo 4 y a costo 2. Las 7 líneas son 1 de su loopback, con costo 0, y 2 por cada uno de sus 3
enlaces: una que dice quién es el vecino y otra que dice qué subred hay. Si juntan los seis LSA,
reconstruyen el dibujo de la Sesión A. Dos consecuencias del formato:
- Una red stub es una subred sin más routers detrás: una hoja del grafo. Sirve para llegar a sus direcciones, y por ahí no se pasa. Como el loopback es stub con costo 0, el costo hasta él es el de los enlaces, y por eso nuestras cuentas salieron exactas.
- Un enlace entre routers se usa solo si ambos lo anuncian. Es la verificación en las dos direcciones, ahora dentro de SPF. Es otra línea de defensa contra datos falsos.
Cada LSA tiene además una edad, que crece desde que se originó. Un router vuelve a anunciar los suyos cada 30 minutos aunque no cambie nada, y un LSA que llega a la hora sin renovarse se elimina de la red. Esto limpia los datos de un router que desapareció sin avisar.
En la práctica.
show ip ospf databasees la herramienta de diagnóstico más honesta. Si dos routers de la misma área tienen bases distintas después de un rato, algo está mal, y no vale la pena mirar sus tablas todavía. Si las bases coinciden pero el tráfico va mal, el problema está en los costos o más abajo.
Inundar un cambio
¿Qué se ve en la red cuando se cae un enlace? Apagamos b-d y capturamos en f, un router lejano que no
toca ese enlace (quitamos los Hello con el filtro):
$ docker exec clab-w05-six-b ip link set eth3 down
08:08:33.128338 IP 10.205.56.1 > 224.0.0.5: OSPFv2, LS-Update, length 112
08:08:33.128533 IP 10.205.56.2 > 224.0.0.5: OSPFv2, LS-Update, length 136
08:08:33.128559 IP 10.205.56.1 > 224.0.0.5: OSPFv2, LS-Update, length 136
08:08:34.129375 IP 10.205.56.2 > 224.0.0.5: OSPFv2, LS-Ack, length 44
08:08:38.128286 IP 10.205.56.1 > 224.0.0.5: OSPFv2, LS-Update, length 112
08:08:38.128356 IP 10.205.56.2 > 224.0.0.5: OSPFv2, LS-Update, length 112
08:08:38.128363 IP 10.205.56.2 > 224.0.0.5: OSPFv2, LS-Update, length 136
08:08:38.128390 IP 10.205.56.1 > 224.0.0.5: OSPFv2, LS-Update, length 136
Son dos tandas, separadas por 5 s. Volvemos a la segunda más abajo. El contenido de la primera dice qué
cambió. Esto es uno de sus paquetes, visto en a:
08:08:33.128015 IP (tos 0xc0, ttl 1, id 17528, offset 0, flags [none], proto OSPF (89), length 132)
    10.205.13.1 > 224.0.0.5: OSPFv2, LS-Update, length 112
	Router-ID 10.205.0.1, Backbone Area, Authentication Type: none (0), 1 LSA
	  LSA #1
	  Advertising Router 10.205.0.2, seq 0x80000020, age 2s, length 64
	    Router LSA (1), LSA-ID: 10.205.0.2
	    Options: [External]
	    Router LSA Options: [none]
	      Stub Network: 10.205.0.2, Mask: 255.255.255.255
		topology default (0), metric 0
	      Neighbor Router-ID: 10.205.0.3, Interface Address: 10.205.23.1
		topology default (0), metric 4
	      Stub Network: 10.205.23.0, Mask: 255.255.255.252
		topology default (0), metric 4
	      Neighbor Router-ID: 10.205.0.1, Interface Address: 10.205.12.2
		topology default (0), metric 3
	      Stub Network: 10.205.12.0, Mask: 255.255.255.252
		topology default (0), metric 3
Lo reenvía a (Router-ID 10.205.0.1), y lo originó b (Advertising Router 10.205.0.2). Los que
hablan son los que originan; los demás retransmiten sin cambiar nada. El LSA nuevo de b tiene un
número de secuencia mayor y ya no menciona a d. Eso es todo lo que necesita saber la red. Del otro
extremo sale otro igual, de d, sin mencionar a b. Como cada router tiene ahora el mapa corregido,
corre SPF y actualiza su tabla. Ningún router les dijo a los demás qué ruta usar.
¿Y la segunda tanda? ¿Es una retransmisión? Lo decide el número de secuencia. Repetimos la captura en
f con -v y filtramos los LSA de b (en otra ejecución, por eso los números son otros):
09:11:31  Advertising Router 10.205.0.2, seq 0x80000008, age 3s, length 64
09:11:36  Advertising Router 10.205.0.2, seq 0x80000009, age 8s, length 64
La secuencia subió, así que no es una retransmisión del mismo LSA, sino una instancia nueva, originada
de nuevo por b. Esos 5 s coinciden con el LSA minimum interval que veremos enseguida.
Áreas y backbone
Un solo LSA puede cruzar toda la red, y cada cambio hace correr SPF a todos. Para muchos cientos de routers eso se vuelve pesado. OSPF ofrece una solución dentro del AS: dividirlo en áreas.
- Cada interfaz de un router pertenece a un área.
- El área 0, o backbone, es especial: toda otra área se conecta con ella.
- Un area border router (ABR) tiene interfaces en el área 0 y en otra, y mantiene una base de datos por área.
- Router LSA y Network LSA no salen de su área. El mapa detallado es local.
Lo que cruza es un Summary LSA, que el ABR genera. No describe enlaces, sino que dice “por mí se llega a este prefijo con este costo”. Del otro lado, los routers no saben cómo es esa área: solo cuánto cuesta llegar al ABR y lo que él dijo. Es decir: entre áreas, OSPF funciona como vector de distancias, con el backbone en el centro para evitar ciclos.
Armamos una red de cinco routers con tres áreas, make up-areas:
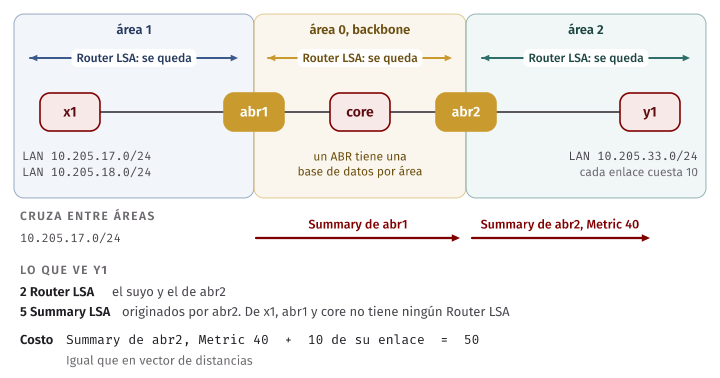
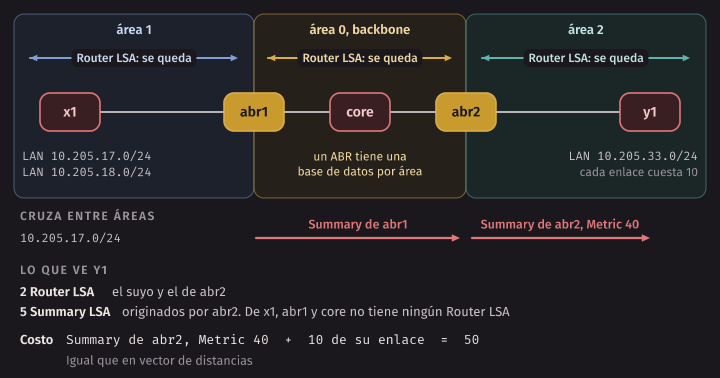
Esto es lo que ve y1, en el área 2:
$ docker exec clab-w05-areas-y1 vtysh -c 'show ip ospf database'

       OSPF Router with ID (10.205.0.15)

                Router Link States (Area 0.0.0.2)

Link ID         ADV Router      Age  Seq#       CkSum  Link count
10.205.0.14    10.205.0.14       12 0x80000003 0x612c 2
10.205.0.15    10.205.0.15       12 0x80000003 0xc1b7 3

                Summary Link States (Area 0.0.0.2)

Link ID         ADV Router      Age  Seq#       CkSum  Route
10.205.1.0     10.205.0.14        7 0x80000001 0xd1bb 10.205.1.0/30
10.205.2.0     10.205.0.14       22 0x80000001 0x6234 10.205.2.0/30
10.205.16.0    10.205.0.14        7 0x80000001 0x90e3 10.205.16.0/30
10.205.17.0    10.205.0.14        7 0x80000001 0xfb6a 10.205.17.0/24
10.205.18.0    10.205.0.14        7 0x80000001 0xf074 10.205.18.0/24
y1 conoce a dos routers: él mismo y abr2. De x1, de abr1 y de core no tiene ni un Router LSA,
aunque llegue a sus prefijos:
$ docker exec clab-w05-areas-y1 vtysh -c 'show ip route ospf'
O>* 10.205.1.0/30 [110/30] via 10.205.32.1, eth1, weight 1, 00:00:07
O>* 10.205.2.0/30 [110/20] via 10.205.32.1, eth1, weight 1, 00:00:07
O>* 10.205.16.0/30 [110/40] via 10.205.32.1, eth1, weight 1, 00:00:07
O>* 10.205.17.0/24 [110/50] via 10.205.32.1, eth1, weight 1, 00:00:07
O>* 10.205.18.0/24 [110/50] via 10.205.32.1, eth1, weight 1, 00:00:07
O   10.205.32.0/30 [110/10] is directly connected, eth1, weight 1, 00:00:22
O 10.205.33.0/24 [110/10] is directly connected, lan1, weight 1, 00:00:22abr1, en cambio, tiene las dos bases separadas (área 0 y área 1) y lo confirma: This router is an ABR.
Cada costo se lee como en vector de distancias: el Summary de 10.205.17.0/24 que llega a y1 dice
Metric: 40, lo que le cuesta a abr2, y y1 suma 10 de su enlace para obtener los 50.
Qué se gana, y hasta dónde
Si se apaga una LAN de x1, en el área 1 se inunda un Router LSA nuevo. Su número de secuencia pasa de
80000004 a 80000005, y a y1 no le llega: sigue sin tener un Router LSA de x1. Lo único que se entera
y1 es que un Summary dejó de valer. Ese Summary aparece con edad máxima (3600), la forma de retirar un LSA:
10.205.17.0 10.205.0.14 3600 0x80000001 0xfb6a 10.205.17.0/24¿Eso le evita trabajo a y1? Aquí conviene mirar en vez de suponer. show ip ospf cuenta las corridas de
SPF por área, y el contador de y1 subió de 5 a 7: en FRRouting, un cambio de Summary también dispara el
cálculo, aunque no toque el mapa del área. Lo que evitamos es la inundación del detalle, no todo cálculo.
Para ganar de verdad, el ABR puede resumir: anunciar un solo prefijo por toda el área. Es la agregación
de la semana 4, usada en el plano de control. Y por eso conviene que las direcciones de un área sean
agregables: aquí, todo el área 1 está dentro de 10.205.16.0/20. Con make up-range, abr1 arranca con
una línea más:
router ospf
 ospf router-id 10.205.0.12
 network 10.205.1.0/30 area 0
 network 10.205.16.0/20 area 1
 area 1 range 10.205.16.0/20
Ahora y1 ve un solo prefijo:
Link ID         ADV Router      Age  Seq#       CkSum  Route
10.205.1.0     10.205.0.14        7 0x80000001 0xd1bb 10.205.1.0/30
10.205.2.0     10.205.0.14       21 0x80000001 0x6234 10.205.2.0/30
10.205.16.0    10.205.0.14        7 0x80000001 0xbbba 10.205.16.0/20
Apagamos la misma LAN. El contador de SPF de y1 se queda en 5, y su base no cambia en nada. La falla
quedó contenida en el área 1. Pero hay un precio, y se paga en el plano de datos:
$ docker exec clab-w05-areas-y1 ping -c 1 -W 1 10.205.17.1
1 packets transmitted, 0 packets received, 100% packet loss
$ docker exec clab-w05-areas-y1 ping -c 1 -W 1 10.205.18.1
1 packets transmitted, 1 packets received, 0% packet loss
round-trip min/avg/max = 0.125/0.125/0.125 ms
y1 sigue enviando hacia 10.205.17.1, porque cae dentro del /20, y el paquete se pierde cerca del destino.
Resumir significa que afuera no se entera de lo que pasa adentro, tanto de lo malo como de lo que le serviría
saber.
Idea clave. Las áreas cambian información por escala. Dentro del área, todo el mapa. Afuera, solo prefijos y costos, y si se resume, ni eso. Por eso cruza lo mínimo: un Summary con prefijo y costo. Nunca cruza un Router LSA ni un Network LSA.
En la práctica. Una red chica no necesita áreas, y P1 usa solo el área 0. Y un detalle de esta versión: en nuestras pruebas con FRRouting 10.3.1, escribir
area 1 rangeconvtyshsobre una red ya convergida tumbó aospfd(Received signal 11, yshowrespondeospfd is not running). Enfrr.conf, antes de arrancar, funciona. Por eso la topología lo carga desde un archivo.
Convergencia: cuánto tarda en reaccionar
Hasta aquí hemos visto que la red se recupera. ¿Cuánto tarda? Converger es llegar de nuevo a un estado válido y estable después de un cambio. Ese tiempo tiene cinco partes:
- Detectar la falla.
- Originar un LSA nuevo.
- Inundarlo por toda el área.
- Calcular SPF en cada router.
- Instalar las rutas nuevas en la forwarding table.
Veamos los órdenes de magnitud en nuestra red. El último SPF de a tardó 67 microsegundos, y los mismos
paquetes de arriba muestran que el LSA cruza varios saltos en menos de un milisegundo:
 Initial SPF scheduling delay 0 millisec(s)
 Minimum hold time between consecutive SPFs 50 millisec(s)
 Maximum hold time between consecutive SPFs 5000 millisec(s)
 Hold time multiplier is currently 2
 SPF algorithm last executed 1.441s ago
 Last SPF duration 67 usecs
 SPF timer is inactive
 LSA minimum interval 5000 msecs
 LSA minimum arrival 1000 msecs
El SPF inicial no espera (0 millisec). Las líneas hold time lo frenan si los cambios llegan seguidos. LSA minimum interval limita a 5 s la frecuencia con que un router vuelve a originar el mismo LSA, y coincide con la
segunda tanda de la captura de f. Son frenos contra la inestabilidad.
¿Y detectar? Eso depende de cómo muere el enlace, y ahí está lo más importante de la semana. Un enlace puede caer de dos formas.
Cuando el enlace avisa
Si se corta un cable, la interfaz pierde carrier: el hardware detecta que no hay señal, y avisa al sistema.
ospfd se entera al instante y da al vecino por perdido, sin esperar ningún temporizador. Lo mismo pasa con
nuestras interfaces veth: ip link set eth3 down en b hace que d vea NO-CARRIER en el otro extremo.
Medimos con un ping de a a d, a 5 paquetes por segundo, que al principio va por b. A los 2 s apagamos b-d:
$ docker exec clab-w05-six-a ping -c 40 -i 0.2 -W 1 -q -I 10.205.0.1 10.205.0.4
$ docker exec clab-w05-six-b ip link set eth3 down
$ docker exec clab-w05-six-d ip link show eth1
8765: eth1@if8764: <NO-CARRIER,BROADCAST,MULTICAST,UP> mtu 1500 qdisc noqueue state DOWN mode DEFAULT group default
40 packets transmitted, 40 packets received, 0% packet loss
$ docker exec clab-w05-six-a traceroute -n -q1 -s 10.205.0.1 10.205.0.4
 1  10.205.13.2  0.005 ms
 2  10.205.0.4  0.001 ms
Ningún paquete perdido, en las tres veces que lo medimos, y el tráfico cambió de camino, a c. ¿Cómo? b se
enteró de inmediato, inundó, a corrigió su tabla y, en esos milisegundos, ningún ping de los que van cada 200 ms
cayó en la ventana. Los temporizadores no tuvieron nada que ver. Por eso medir la convergencia apagando una interfaz
da una idea equivocada: es el caso más favorable que existe.
Cuando el enlace no avisa
La otra forma es la peligrosa. Entre dos routers hay un switch, un convertidor de medios o un proveedor, y lo que falla está en medio. Cada router sigue viendo su interfaz arriba, con carrier. Los paquetes simplemente desaparecen. Lo único que puede delatar la falla es que dejaron de llegar los Hello.
Para reproducirlo sin un switch de por medio, usamos tc para descartar todo lo que sale por los dos extremos. A
OSPF eso le parece un enlace mudo:
docker exec clab-w05-six-b tc qdisc add dev eth3 root netem loss 100%
docker exec clab-w05-six-d tc qdisc add dev eth1 root netem loss 100%
Lo que pasa justo después es instructivo. La interfaz sigue arriba, la ruta sigue ahí, el vecino sigue en Full, y
los paquetes se pierden:
$ docker exec clab-w05-six-b ip link show eth3
8764: eth3@if8765: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc netem state UP mode DEFAULT group default qlen 1000
$ docker exec clab-w05-six-a vtysh -c 'show ip route 10.205.0.4/32' | tail -2
  * 10.205.12.2, via eth1, weight 1

$ docker exec clab-w05-six-a ping -c 3 -W 1 -I 10.205.0.1 10.205.0.4
3 packets transmitted, 0 packets received, 100% packet loss
$ docker exec clab-w05-six-b vtysh -c 'show ip ospf neighbor' | grep 10.205.0.4
10.205.0.4        1 Full/-          5.931s            34.068s 10.205.24.2     eth3:10.205.24.1                     0     0     0
Es el peor estado que existe: el plano de control dice que todo va bien, y el de datos pierde todo. Dura hasta que se agota el Dead:
08:08:20 OSPF: AdjChg: Nbr 10.205.0.4 ... on eth3:10.205.24.1: Full -> Deleted (InactivityTimer)Medimos tres veces con el mismo ping, a 5 por segundo, y anotamos el tiempo hasta que a cambia de ruta: 275 paquetes con
los temporizadores por defecto. Después, con Hello de 2 s y Dead de 8 s en los dos extremos del enlace, bastan 75:
| Falla | Temporizadores | Cambio de ruta en a |
Paquetes perdidos | Pérdida en segundos |
|---|---|---|---|---|
| Interfaz abajo | 10 / 40 | Inmediato | 0, 0, 0 de 40 | 0 |
| Silenciosa | 10 / 40 | 38,2 s; 35,7 s; 35,0 s | 190, 177, 174 de 275 | 35 a 38 |
| Silenciosa | 2 / 8 | 6,8 s; 7,7 s; 7,3 s | 34, 38, 36 de 75 | 7 a 8 |
La pérdida en segundos es la cantidad de paquetes perdidos por 0,2 s. Las cifras dependen de la máquina y de la carga, pero el orden no: el tiempo sin servicio es prácticamente el Dead. Cuando se corta el enlace, el último Hello recibido tiene una edad entre 0 y un HelloInterval. Por eso el tiempo de detección cae entre Dead − Hello y Dead: de 30 a 40 s con los valores por defecto, y de 6 a 8 s con los cortos. Lo que siguió después (LSA, inundación, SPF, FIB) no se nota al lado de esto.
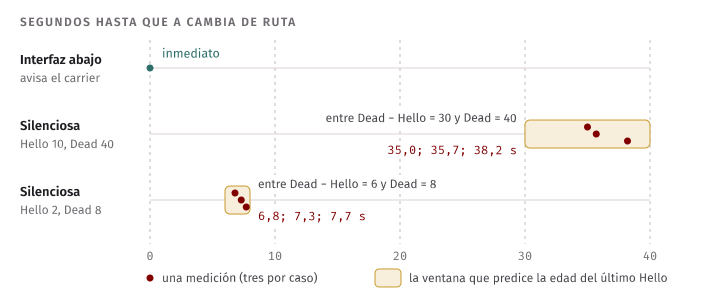
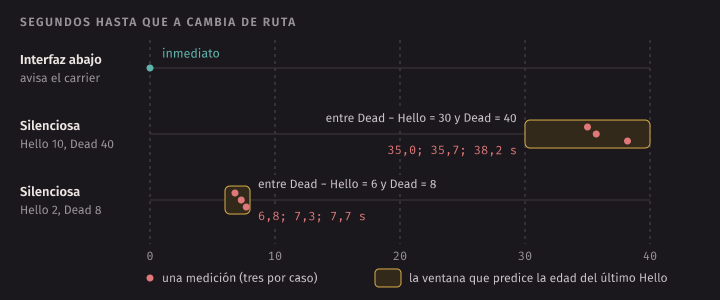
Idea clave. Detectar la falla suele ser lo más lento, por mucho. Calcular Dijkstra en esta red toma microsegundos e inundar, milisegundos. Esperar el Dead toma decenas de segundos. Para converger más rápido, no hace falta un mejor algoritmo, sino enterarse antes.
Lo que arriesgan los temporizadores cortos
¿Por qué no usar entonces Hello de 1 s y Dead de 3 s, siempre? Porque el Dead es la cantidad de silencio que toleramos antes de creer que el vecino murió, y a veces un vecino se queda callado sin haber muerto: un enlace con un corte breve, un router ocupado, un burst de pérdidas.
Cortamos el mismo enlace por solo 12 s y lo reparamos. Con 10 / 40, la adyacencia ni se entera, y grep -c AdjChg da
0 cambios. Con 2 / 8 se cae:
08:09:42 OSPF: AdjChg: Nbr 10.205.0.4 ... on eth3:10.205.24.1: Full -> Deleted (InactivityTimer)
08:09:50 OSPF: AdjChg: Nbr 10.205.0.4 ... on eth3:10.205.24.1: Down -> Init (HelloReceived)
08:09:50 OSPF: AdjChg: Nbr 10.205.0.4 ... on eth3:10.205.24.1: Init -> ExStart (2-WayReceived)
08:09:50 OSPF: AdjChg: Nbr 10.205.0.4 ... on eth3:10.205.24.1: ExStart -> Exchange (NegotiationDone)
08:09:50 OSPF: AdjChg: Nbr 10.205.0.4 ... on eth3:10.205.24.1: Exchange -> Full (ExchangeDone)
¿Eso es bueno o malo? Es las dos cosas. Si el enlace realmente iba a seguir caído, ganamos 30 s. Si fue un parpadeo de
un instante, se inundó toda el área dos veces, todos corrieron SPF dos veces y el tráfico se movió sin necesidad. Un
enlace que parpadea cada pocos segundos (un flap) puede tener a toda el área recalculando sin parar. Por eso el Dead
se fija en varias veces el Hello, y hay frenos como los hold time y el LSA minimum interval.
| Temporizadores largos | Temporizadores cortos | |
|---|---|---|
| Falla silenciosa | Mucho tiempo sin servicio | Poco tiempo sin servicio |
| Parpadeo | Pasa inadvertido | Mueve toda la red |
| Tráfico de control | Casi nada | Más Hello, pero rara vez es el problema |
| Un router ocupado | Aguanta | Puede perder vecinos |
En la práctica. En redes de producción, los Hello no suelen bajar de un segundo. Para detectar de verdad en milisegundos, existe BFD (Bidirectional Forwarding Detection), un protocolo muy liviano, dedicado solo a eso, del que OSPF puede depender. En nuestra imagen su proceso viene apagado; aquí jugamos solo con Hello y Dead.
Mientras tanto: ciclos pasajeros
Las tablas no cambian en todos los routers a la vez. Supongamos que cae un enlace y tres routers ya actualizaron su tabla, pero dos todavía no. Cada uno calcula bien con lo que sabe, y sin embargo el conjunto de tablas puede no ser válido:
- Ciclo pasajero (microloop). Si un router actualizado reenvía hacia uno atrasado, y este todavía apunta al primero, el paquete rebota entre ellos hasta que el segundo se actualice o se acabe el TTL. Esos paquetes pueden congestionar el enlace mientras dura.
- Callejón pasajero. Un router atrasado envía por el enlace muerto, y el paquete se pierde allí.
Es la definición de ruta válida de la Sesión A: es una propiedad del conjunto de tablas, no de cada una. La diferencia con el conteo al infinito es que esto termina por sí solo, en cuanto la inundación llega a todos y las bases de datos vuelven a coincidir. Con estado de enlace, estos ciclos duran lo que dura la inundación. Con vector de distancias, pueden durar lo que tarde el conteo.
Cuando dos routers no forman adyacencia
Es la falla de configuración más común, y tiene un diagnóstico ordenado. El Hello trae el área, los temporizadores y la máscara, y OSPF los compara con los de la interfaz que lo recibe. Si no coinciden, descarta el Hello en silencio, y del otro router no se sabe nada. El vecino simplemente no aparece. Hay dos herramientas:
show ip ospf interface, en los dos routers, para comparar los valores.- El log, si está activado:
log file /tmp/ospfd.log. FRRouting escribe ahí la causa del descarte. En lo que sigue, a los mensajes del log les quitamos la fecha y el código del principio.
Hagamos cada caso en el enlace a-b, modificando solo a.
Área distinta. Ponemos eth1 de a en el área 1:
$ docker exec clab-w05-six-a vtysh -c 'show ip ospf neighbor'

Neighbor ID     Pri State           Up Time         Dead Time Address         Interface                        RXmtL RqstL DBsmL
10.205.0.3        1 Full/-          10.289s           39.709s 10.205.13.2     eth2:10.205.13.1                     0     0     0

$ docker exec clab-w05-six-a vtysh -c 'show ip ospf interface eth1' | grep -E 'Internet|Neighbor Count'
  Internet Address 10.205.12.1/30, Broadcast 10.205.12.3, Area 0.0.0.1
  Neighbor Count is 0, Adjacent neighbor count is 0
$ docker exec clab-w05-six-b vtysh -c 'show ip ospf interface eth1' | grep -E 'Internet|Neighbor Count'
  Internet Address 10.205.12.2/30, Broadcast 10.205.12.3, Area 0.0.0.0
  Neighbor Count is 1, Adjacent neighbor count is 1
$ docker exec clab-w05-six-a grep 'Area ID' /tmp/ospfd.log | tail -1
08:10:41 OSPF: [Y9FH4-5CVMQ][EC 134217741] interface eth1: ospf_read invalid Area ID 0.0.0.0
El vecino desapareció de a, y Area 0.0.0.1 contra Area 0.0.0.0 lo dice todo. En b, el vecino sigue ahí hasta que
se le venza el Dead: los dos lados no se enteran al mismo tiempo.
Temporizadores distintos. Ponemos Dead de 20 s en a:
$ docker exec clab-w05-six-a vtysh -c 'conf t' -c 'interface eth1' -c 'ip ospf dead-interval 20'
$ docker exec clab-w05-six-a vtysh -c 'show ip ospf neighbor' | grep 10.205.0.2
10.205.0.2        1 Full/-          2.791s            37.207s 10.205.12.2     eth1:10.205.12.1                     3     0     0
¡Sigue en Full! Una adyacencia ya formada no se corta porque cambió la configuración. Se corta cuando pasan 20 s sin un
Hello aceptable, y solo entonces desaparece:
  Timer intervals configured, Hello 10s, Dead 20s, Wait 20s, Retransmit 5
  Neighbor Count is 0, Adjacent neighbor count is 0
Del lado de b dice Hello 10s, Dead 40s. Y el log explica:
Packet 10.205.0.2 [Hello:RECV]: RouterDeadInterval mismatch on eth1:10.205.12.1 (expected 20, but received 40).Error común. Cambiar algo, mirar
show ip ospf neighborde inmediato, verFully concluir que no pasa nada. El efecto llega con el Dead. Si cambian temporizadores en una red en vivo, háganlo en los dos extremos casi a la vez.
Máscara distinta. Este caso tiene letra chica. Probamos /29 en a y /30 en b, con nuestro enlace point-to-point:
Neighbor ID     Pri State           Up Time         Dead Time Address         Interface                        RXmtL RqstL DBsmL
10.205.0.2        1 Full/-          4.881s            35.118s 10.205.12.2     eth1:10.205.12.1                     0     0     0
  Internet Address 10.205.12.1/29, Broadcast 10.205.12.7, Area 0.0.0.0
  Router ID 10.205.0.1, Network Type POINTOPOINT, Cost: 3
¡Forma adyacencia igual! No es un error de FRRouting: el RFC 2328, en su sección 10.5, dice que en redes point-to-point y en
enlaces virtuales la máscara del Hello se ignora. Solo importa en redes broadcast y similares. Si le quitamos
point-to-point a los dos extremos y repetimos:
  Internet Address 10.205.12.1/29, Broadcast 10.205.12.7, Area 0.0.0.0
  Router ID 10.205.0.1, Network Type BROADCAST, Cost: 3
  Neighbor Count is 0, Adjacent neighbor count is 0
Ahora el vecino no aparece, y el log dice:
Packet 10.205.0.2 [Hello:RECV]: NetworkMask mismatch on eth1:10.205.12.1 (configured prefix length is 29, but hello packet indicates 30).MTU distinto. Este no se detecta en el Hello, sino después. Con MTU 1400 en un extremo y 1500 en el otro, los dos intercambian Hello sin problema, hasta llegar al Database Description, donde viaja el MTU:
Neighbor ID     Pri State           Up Time         Dead Time Address         Interface                        RXmtL RqstL DBsmL
10.205.0.2        1 ExStart/-       25.069s           34.934s 10.205.12.2     eth1:10.205.12.1                     0     0     0
Packet[DD]: Neighbor 10.205.0.2 MTU 1500 is larger than [eth1:10.205.12.1]'s MTU 1400Queda atrapado en ExStart para siempre, y eso es una pista en sí misma. Un vecino detenido en ExStart casi siempre es
MTU. Tiene sentido: si un LSA grande no cabe, mejor no fingir una adyacencia que luego va a fallar. Tengan esto presente al
armar topologías: Containerlab usa MTU 9500 por defecto, y por eso las nuestras fijan mtu: 1500 en cada enlace.
| Síntoma | Causa probable | Dónde se ve |
|---|---|---|
| El vecino no aparece | Área distinta | Area en show ip ospf interface; log invalid Area ID |
| El vecino no aparece | Hello o Dead distintos | Timer intervals; log RouterDeadInterval mismatch |
| El vecino no aparece, en broadcast | Máscara distinta | Internet Address; log NetworkMask mismatch |
| El vecino no aparece | Interfaz passive-interface, o sin network que la incluya |
No Hellos (Passive interface), o la interfaz no está en OSPF |
Detenido en ExStart |
MTU distinto | Log MTU ... is larger |
Full, pero faltan rutas |
La otra punta tiene otra área o no anuncia ese prefijo | show ip ospf database |
En la práctica. Sigan siempre el mismo orden. Primero, ¿hay conectividad en el enlace? Un
pinga la dirección del otro extremo. Luego, ¿la interfaz está en OSPF?show ip ospf interface. Después, ¿coinciden los valores? Y al final, si hace falta,tcpdump -n -v -i eth1 ip proto 89, porque el paquete muestra lo que el otro router realmente dice.
El laboratorio de la semana y make test
Todo se hace en code/week-05/, dentro del contenedor del curso. Antes de empezar, make compila dijkstra y dv_sim.
code/week-05/
  dijkstra.c, dv_sim.c    los dos algoritmos, paso a paso
  graphs/                 los grafos de la Sesión A
  six/six.clab.yml        el grafo de seis nodos, con OSPF
  areas/areas.clab.yml    tres áreas, con y sin resumen
  ospf/ospf.clab.yml      la red del laboratorio, sin OSPF
  lab/                    sus respuestas: ospf.sh, r1_table.txt, cost.sh, timers.sh
La red del laboratorio tiene cinco routers, con caminos alternativos y un host en cada extremo. Trae las direcciones configuradas, pero no OSPF.
              h1
              |
              r1
             /  \
           r2 -- r3
           |      |
           r4 -- r5
           |
h4| Enlace | Subred | Extremo .1 |
Extremo .2 |
Costo |
|---|---|---|---|---|
| r1-r2 | 10.205.12.0/30 |
r1 eth1 |
r2 eth1 |
2 |
| r1-r3 | 10.205.13.0/30 |
r1 eth2 |
r3 eth1 |
3 |
| r2-r3 | 10.205.23.0/30 |
r2 eth2 |
r3 eth2 |
4 |
| r2-r4 | 10.205.24.0/30 |
r2 eth3 |
r4 eth1 |
6 |
| r3-r5 | 10.205.35.0/30 |
r3 eth3 |
r5 eth1 |
5 |
| r4-r5 | 10.205.45.0/30 |
r4 eth2 |
r5 eth2 |
3 |
Las LAN son 10.205.101.0/24 (r1 eth3, h1 en .10) y 10.205.104.0/24 (r4 eth3, h4 en .10), con el router en
.1, y sus interfaces ya tienen ip ospf cost 10. Cada router tiene el loopback 10.205.0.N/32. Los enlaces ya tienen ip ospf network point-to-point, y sus costos, que ustedes configuran, valen en los dos sentidos.
Paso 1, adyacencia. Con make up-ospf, comprueben que h1 no alcanza a h4. Entren a r1 con vtysh y configuren OSPF solo
para su enlace con r2: un router-id, log-adjacency-changes detail y un network 10.205.12.0/30 area 0. Hagan lo mismo en r2.
En otra terminal, repitan show ip ospf neighbor en un ciclo. ¿Cuánto tiempo pasa en Init? ¿Por qué? Lean el camino completo en
el log: grep AdjChg /tmp/ospfd.log. Finalmente, capturen los paquetes con tcpdump y encuentren el Hello que trae la lista de
vecinos.
Paso 2, el resto. Antes de seguir, corran Dijkstra a mano desde r1, en papel. Anoten el resultado en lab/r1_table.txt, con
los cuatro loopback y la LAN de h4. Recuerden que la LAN es una red stub con su costo propio, 10, que se suma al llegar a ella. Luego completen lab/ospf.sh, que ya trae r1 como ejemplo, para configurar los cinco routers
con sus costos. Fíjense en passive-interface: en una LAN con hosts no hay vecinos que descubrir, y nadie debería poder hacerse
pasar por uno. Se anuncia la subred, pero no se envían Hello. Ejecútenlo y comparen:
sh lab/ospf.sh
docker exec clab-w05-ospf-r1 vtysh -c 'show ip route ospf'
Si la tabla no coincide con su Dijkstra, uno de los dos está mal. Averigüen cuál. ./dijkstra les puede ayudar, si le escriben
el grafo en un archivo.
Paso 3, mover el tráfico. Con traceroute, vean por dónde va el tráfico de h1 a h4, y de vuelta. En lab/cost.sh, cambien
costos para que pase por r3 y r5 en las dos direcciones, sin apagar nada. Pista: ¿el costo de un enlace es uno solo? Prueben
primero cambiando un solo extremo, y miren los dos traceroute. ¿Cuál es el costo mínimo que logra el cambio? Calcúlenlo antes de
probar.
Paso 4, una falla en vivo. Dejen corriendo un ping a 5 paquetes por segundo de h1 a h4, y primero apaguen un enlace del
camino:
docker exec clab-w05-ospf-h1 ping -i 0.2 10.205.104.10
docker exec clab-w05-ospf-r3 ip link set eth3 down
Cuenten cuántos paquetes se pierden: la línea final de ping, al detenerlo con Ctrl+C. Vuelvan a subir el enlace. Ahora una falla sin
aviso, como vimos en la sección de convergencia:
docker exec clab-w05-ospf-r3 tc qdisc add dev eth3 root netem loss 100%
docker exec clab-w05-ospf-r5 tc qdisc add dev eth1 root netem loss 100%
Cuenten de nuevo, y expliquen la diferencia. Para repararlo, tc qdisc del dev eth3 root y tc qdisc del dev eth1 root.
Paso 5, temporizadores. Completen lab/timers.sh con Hello de 2 s y Dead de 8 s en todos los enlaces entre routers. Repitan la
falla sin aviso tres veces y comparen con el paso 4. Luego prueben un corte de 12 s: con los temporizadores cortos y con los largos.
¿Qué se gana y qué se arriesga?
Paso 6, una adyacencia que no sube. Provoquen una adyacencia que no sube, con al menos dos de las causas de la tabla, en un
enlace que no sea el del ejemplo. Diagnostiquen primero con show ip ospf interface en los dos routers, y confirmen después en el
log. ¿Cuánto tarda en notarse cada una? Piensen en por qué.
Paso 7, P1. Avancen con su proyecto. Lo que hicimos aquí se aplica a su núcleo, pero es otra red: su plan de direcciones, sus costos y sus temporizadores los fijan el enunciado y ustedes.
Cuando terminen un archivo de lab/, borren su línea TODO. Las pruebas que dependen de un archivo con TODO se saltan, con un
mensaje que dice cuál falta.
make test compila sin advertencias, corre test_tools.py sobre los dos programas y levanta las tres topologías, una tras otra, para
comprobar lo que dice este capítulo:
make test # dentro del contenedor; tarda unos minutos, porque espera temporizadores de verdadtest_one_prefix_replaces_the_detail (test_areas.B_WithSummary.test_one_prefix_replaces_the_detail) ... ok
test_1_no_ospf_at_start (test_ospf.A_Starting.test_1_no_ospf_at_start) ... ok
test_2_links_use_ethernet_mtu (test_ospf.A_Starting.test_2_links_use_ethernet_mtu) ... ok
test_3_two_routers_reach_full_through_every_state (test_ospf.A_Starting.test_3_two_routers_reach_full_through_every_state) ... ok
setUpClass (test_ospf.B_Lab) ... skipped 'falta completar lab/ospf.sh'
test_routes_match_dijkstra_from_every_node (test_six.A_MatchesTheGraph.test_routes_match_dijkstra_from_every_node) ... ok
test_2_silent_failure_waits_for_dead_interval (test_six.C_Failures.test_2_silent_failure_waits_for_dead_interval) ... ok
...
----------------------------------------------------------------------
Ran 40 tests in 290.156s
OK (skipped=1)Eso es lo que verán mientras los archivos de lab/ sigan con su TODO: las pruebas de esos pasos se saltan, y el resto ya pasa. Las
pruebas no exigen cifras exactas, solo tendencias con margen: por ejemplo, que una falla silenciosa con temporizadores por defecto tarde
más de 20 s en notarse, y con los cortos menos de 15 s. Al terminar, pase lo que pase, make test destruye sus topologías. Si levantan
algo a mano, make down lo limpia.
Resumen
- El routing es un problema de grafos: encontrar caminos de menor costo. Un estado de routing es válido para un destino si, desde cada router, seguir los next hop llega al destino, sin callejones y sin ciclos.
- Estado de enlace: cada router inunda sus enlaces, todos tienen el mismo mapa y cada uno corre Dijkstra desde sí mismo.
- Vector de distancias: cada router conversa solo con sus vecinos y aplica Bellman-Ford. Con los costos quietos, llega a la misma respuesta.
- Un empate da dos next hop, y un router los puede usar a la vez: ECMP.
- En vector de distancias, las buenas noticias viajan rápido y las malas, lento, porque un vector trae costos, no caminos. El conteo al infinito solo termina con un tope, y por eso existe el valor infinito.
- Split horizon y poison reverse evitan los ciclos de dos nodos, no los de tres o más.
- La tabla de routing guarda candidatas y la forwarding table, las elegidas. FRRouting calcula la primera e instala la segunda en el
kernel. El
metric 20del kernel no es el costo de OSPF. - Dentro de un AS manda el desempeño, y entre AS, la política. Por eso son protocolos distintos.
- OSPF corre directo sobre IP (protocolo 89). Hello descubre vecinos y prueba comunicación en las dos direcciones. Los estados
van de
DownaFull. Los costos se configuran por interfaz y por dirección. - La LSDB es igual en todos los routers de un área: se comprueba con los números de secuencia y los checksums.
- Las áreas reducen la inundación. Router LSA y Network LSA se quedan en su área, y un ABR anuncia solo prefijos y costos con Summary LSA, o incluso un resumen.
- Converger tiene cinco partes, y detectar la falla suele ser lo más lento. Si la interfaz avisa, es inmediato. Si no, se espera el Dead, entre Dead − Hello y Dead. Con temporizadores cortos se detecta antes, y también se cae más fácil ante un parpadeo.
- Mientras las tablas se actualizan, puede haber ciclos y callejones pasajeros.
- Si dos routers no forman adyacencia, comparen área, temporizadores y, en broadcast, máscara. Un vecino en
ExStartsuele ser MTU.
Ejercicios
- Corran Dijkstra a mano desde
den el grafo de seis nodos, con la tabla de cada paso, y escriban la forwarding table ded. Comprueben con./dijkstra graphs/six.txt d, y luego conshow ip route ospfen el routerd. - En el grafo de seis nodos, ¿qué costo tendría que tener el enlace a-c para que
eyfdejaran de empatar y fueran solo porb? ¿Y solo porc? Verifíquenlo cambiando el archivo. - Dibujen el árbol de caminos de menor costo con destino
f, sin ECMP. ¿Por qué todos los caminos hacia un destino forman un árbol, y no cualquier grafo? - Sigan a mano la primera y la segunda ronda de vector de distancias en un grafo en línea de cinco nodos, con todos los costos iguales a 1. ¿Cuántas
rondas tarda un nodo en un extremo en conocer al otro? Generalicen a n nodos, y comprueben con
dv_sim. - Muestren con tres nodos en línea cómo aparece el conteo al infinito, y cuántos anuncios pasan hasta llegar a infinito si este vale 16. ¿Y si vale 100?
¿Qué se gana y qué se pierde con un infinito grande? Usen
--inf. - En
graphs/tail.txt, expliquen por qué poison reverse no evita el ciclo a-b-c. ¿Qué información adicional le permitiría aarechazar la ruta deb? Comparen su respuesta con la idea de vector de caminos. - Comparen estado de enlace y vector de distancias en lo que pasa si un router anuncia un costo falso. Prueben
--liecon varios mentirosos y varios destinos engraphs/six.txt. ¿Quiénes se dejan engañar? ¿Pueden predecirlo antes de correr? - Un enlace falla, y tres routers ya actualizaron su tabla y dos todavía no. Con un dibujo de cinco routers, den un ejemplo concreto de un ciclo pasajero y otro de callejón. ¿Qué pasa con los paquetes en cada caso? ¿Quién termina con el problema?
- En una red de 200 routers sin áreas, cada enlace parpadea, en promedio, una vez al día, y hay 300 enlaces. ¿Cuántos eventos por minuto ve cada router? ¿Cuántas corridas de SPF hace? ¿Qué cambia con 4 áreas iguales, cuando el parpadeo está en otra área y el ABR resume?
- Con
make up-six, cambienip ospf costdeeth1solo ena(no enb), de modo que el camino a-b sea muy caro en una sola dirección. Con dostraceroute, muestren que la ida y la vuelta son distintas. ¿Eso rompe algo? ¿Qué pasa con el RTT y con quien analiza el tráfico? - Quiten
ip ospf network point-to-pointde los dos extremos de un enlace, y midan cuánto tarda en volver aFull, comparado con antes. Expliquen el Wait. Hagan que un router nunca sea DR conip ospf priority 0, y leanshow ip ospf interface. - Reto.
dijkstra.cbusca el mínimo recorriendo todos los nodos. Cámbienlo por un heap binario y verifiquen quetest_tools.pysiga pasando. ¿Con cuántos nodos deja de valer la pena la versión simple? Midan con un grafo aleatorio ygcc -O2.