
Apuntes · Capítulo 6Routing
BGP y políticas entre redes
BGP y políticas entre redes
La semana pasada una red entera aprendió sus caminos sola. Con OSPF, cada router de un mismo dominio describe sus enlaces, todos arman el mismo mapa y cada uno calcula el camino de menor costo. Funciona porque hay una sola organización al mando: ella define los costos, ella decide cuándo un camino es mejor que otro.
Internet no es así. Es una colección de decenas de miles de redes, cada una con sus dueños, sus contratos y sus secretos comerciales. Ninguna de esas redes le va a mostrar su mapa a la competencia, y ninguna va a llevar tráfico ajeno gratis solo porque un algoritmo dijo que era el camino más corto. Entre estas redes la pregunta deja de ser “¿cuál es el camino más barato?” y pasa a ser “¿qué caminos me conviene usar, y cuáles estoy dispuesto a ofrecerle a los demás?”. El protocolo que responde esa pregunta es BGP, y esta semana lo vamos a mirar por dentro.
En la Sesión A vemos qué es un sistema autónomo, cómo funciona un vector de caminos, qué mensajes viajan por una sesión BGP y cómo elige un router la mejor ruta entre varias. También vemos cómo convive BGP con OSPF dentro de una misma red. En la Sesión B entra el dinero: clientes, proveedores y peers, las reglas de importación y exportación que se siguen de quién le paga a quién, y por qué esas reglas mantienen estable a Internet. Terminamos con las herramientas de FRRouting para escribir políticas, con anycast y con los pasos para que una organización aparezca en Internet.
Todo lo que se muestra aquí salió de tres topologías de Containerlab que ustedes pueden levantar. Los tiempos, las versiones de tabla y los contadores de mensajes cambian en cada ejecución. Los caminos no deben cambiar.
Ruta de lectura.
Antes de clase (obligatorio, unos 15 a 20 minutos). Sesión A: la introducción de Sistemas autónomos: por qué hace falta otro protocolo, Vector de caminos, la introducción de Sesiones sobre TCP y Atributos: lo que acompaña a un prefijo. Sesión B: Quién le paga a quién, Las reglas de importación y exportación y El problema: tránsito gratis.
En clase. Sesión A: Los seis AS de esta semana, Una sesión, en la captura, Leer una tabla BGP, eBGP e iBGP: BGP dentro de un AS y Elegir la mejor ruta. Sesión B: Caminos valle-libre, Políticas en FRRouting, Lo que debe pasar con las políticas puestas y Anycast.
Después de clase. Repasen con el Resumen y los Ejercicios, y preparen El laboratorio de la semana y
make test. Opcional: MED y cold potato, Por qué estas reglas dan estabilidad y Cómo llega una organización a Internet. Para profundizar, las lecturas del libro y las gratuitas de la semana:Este capítulo acompaña a Kurose y Ross, Computer Networking: A Top-Down Approach (9.ª ed.). Para la Sesión A, las secciones 5.4.1 The Role of BGP, 5.4.2 Advertising BGP Route Information y 5.4.3 Determining the Best Routes. Para la Sesión B, las secciones 5.4.4 IP-Anycast, 5.4.5 Routing Policy y 5.4.6 Putting the Pieces Together. Lecturas libres de CS168: BGP y BGP Implementation and Issues. Referencia de las políticas: FRRouting, BGP. Complementaria: RFC 4271, BGP-4. El código de la semana está en
code/week-06/.
Sistemas autónomos: por qué hace falta otro protocolo
Un sistema autónomo (AS) es un conjunto de routers bajo una misma administración, que frente al resto del mundo se presenta con una sola política de routing. Lo identifica un número de AS. Son ejemplos de AS un ISP, una universidad grande, una empresa de contenido o un proveedor de cloud. Una organización puede tener varios, y muchas organizaciones chicas no tienen ninguno, porque viven dentro del AS de su proveedor.
Los números de AS tienen 32 bits. Hay rangos reservados para uso privado, igual que
las direcciones de la RFC 1918: 64512–65534 entre los antiguos de 16 bits. Todo el
curso usa ese rango.
Con esto el routing se parte en dos problemas distintos:
| Dentro de un AS (intradominio) | Entre AS (interdominio) | |
|---|---|---|
| Protocolo típico | OSPF, IS-IS | BGP |
| Quién manda | Una sola administración | Cada AS manda solo en el suyo |
| Qué se busca | El camino de menor costo | El camino que convenga según la política |
| Qué se comparte | El mapa entero | Solo qué prefijos se alcanzan, y por dónde |
| Tamaño | Cientos o miles de routers | Toda Internet |
¿Por qué no se usa OSPF para todo? Por tres razones, y las tres importan.
Escala. OSPF inunda cada cambio de cada enlace a todos los routers, y todos recalculan. Con toda Internet, ese mapa tendría cientos de miles de redes cambiando a cada momento.
Autonomía. Un costo de OSPF solo tiene sentido dentro de la red que lo definió. Si un AS pone costo 10 a un enlace de 100 Gb/s y otro AS pone costo 10 a uno de 10 Mb/s, sumarlos no significa nada. Además, ningún operador quiere publicar su topología interna, y cada uno debe poder usar el protocolo interno que prefiera.
Política. Esta es la razón de fondo. Un AS puede tener un camino corto y aun así no querer usarlo, porque pasa por un competidor, o porque es caro, o porque un contrato lo prohíbe. Y puede tener un camino y no querer ofrecérselo a un vecino. Un algoritmo que minimiza una suma no sabe expresar nada de eso.
Idea clave. Dentro de un AS manda la eficiencia. Entre sistemas autónomos manda la política. BGP no resuelve un problema de optimización: permite que cada AS aplique sus propias reglas, y aun así la red como un todo funcione.
BGP (Border Gateway Protocol, RFC 4271) le da a cada AS tres cosas. Primero, una forma de anunciar al resto del mundo “este prefijo existe, y está aquí”. Segundo, una forma de enterarse de qué prefijos se alcanzan a través de sus vecinos. Tercero, una forma de decidir entre varios caminos con sus propios criterios. Lo que un router aprende por BGP termina en la misma forwarding table de siempre: BGP es routing, y el forwarding sigue siendo longest prefix match.
Los seis AS de esta semana
Vamos a usar esta red. Cada router rN es un AS entero, el 6460N:
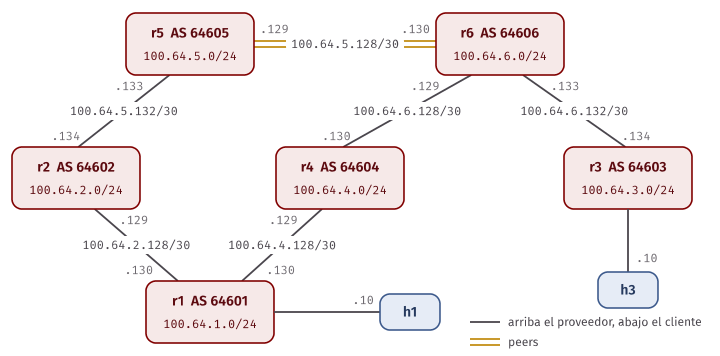
Por ahora no hemos hablado de dinero, así que tomen ese dibujo solo como un grafo. En la Sesión B vamos a leer qué significa cada línea. Lo que importa de la topología:
- Cada AS es owner de
100.64.N.0/24y lo anuncia entero. - Dentro de ese bloque, la parte baja (
100.64.N.0/25) es para hosts y la alta (100.64.N.128/25) para enlaces.100.64.N.1siempre es una dirección derN. - Un enlace entre dos AS se numera con direcciones del bloque del proveedor. Por
ejemplo, el enlace
r1–r2es100.64.2.128/30. Así es en la realidad, y tiene una consecuencia práctica: esas direcciones son alcanzables desde afuera ytraceroutepuede mostrarlas. Si un enlace usara direcciones que nadie anuncia, la respuesta de ese salto nunca volvería.
Por cada router hay un frr.conf. Este es el de r2, completo:
frr defaults traditional
hostname r2
! AS 64602: proveedor de r1 y cliente de r5.
interface lo
 ip address 100.64.2.1/32
interface eth1
 description hacia r1 (cliente)
 ip address 100.64.2.129/30
interface eth2
 description hacia r5 (proveedor)
 ip address 100.64.5.134/30
ip route 100.64.2.0/24 Null0
router bgp 64602
 bgp router-id 100.64.2.1
 no bgp ebgp-requires-policy
 neighbor 100.64.2.130 remote-as 64601
 neighbor 100.64.5.133 remote-as 64605
 address-family ipv4 unicast
  network 100.64.2.0/24
 exit-address-family
Lo leemos línea por línea:
router bgp 64602dice cuál es el número de AS de este router.neighbor 100.64.2.130 remote-as 64601declara un vecino, su dirección y su AS. BGP no descubre vecinos, a diferencia de OSPF: cada sesión se configura a mano, en los dos lados. Es a propósito, porque cada sesión representa un contrato.network 100.64.2.0/24pide anunciar ese prefijo. Atención:networken BGP no significa lo mismo que en OSPF. Aquí solo anuncia un prefijo que ya esté en la tabla de routing con esa misma máscara.- Por eso está
ip route 100.64.2.0/24 Null0. Es una ruta que bota lo que llega, y parece absurda. Pero cualquier ruta más específica, como las de los enlaces o las LANs, le gana por longest prefix match, así que solo cae enNull0lo que no corresponde a nada que exista. Es la forma estándar de sostener el anuncio de un agregado. no bgp ebgp-requires-policyapaga un seguro. La RFC 8212 pide que un router no acepte ni anuncie nada por eBGP si no tiene políticas configuradas, y FRRouting lo cumple por defecto. Lo apagamos porque primero queremos ver a BGP sin políticas.
¿Qué pasa si se olvidan de esa línea? La sesión sube, pero no se intercambia nada. Lo probamos en un router de otra topología, activando el seguro:
Neighbor        V         AS   MsgRcvd   MsgSent   TblVer  InQ OutQ  Up/Down State/PfxRcd   PfxSnt Desc
100.64.130.133  4      65300        13        12        7    0    0 00:00:07     (Policy) (Policy) N/A
Cuando vean (Policy) en las dos últimas columnas, ya saben qué falta. Con el seguro
puesto, cada vecino eBGP necesita una política de entrada y otra de salida. En
producción es lo recomendable.
Vector de caminos
Recuerden el vector de distancias de la semana pasada: cada router le dice a sus vecinos “llego a este destino con costo 7”. Tiene dos problemas para Internet. Un costo no se puede comparar entre redes de distintos dueños, y puede caer en count to infinity, porque nadie sabe si el camino de su vecino pasa por él mismo.
Path vector es la misma idea con un cambio. En vez de anunciar un número, cada AS
anuncia la lista de sistemas autónomos que hay que cruzar para llegar al prefijo.
Esa lista es el atributo AS_PATH. La regla de construcción es:
- El AS que es owner del prefijo lo anuncia a sus vecinos, con
AS_PATHigual a su número. - Un AS que recibe una ruta y decide reenviarla agrega su propio número al principio.
- Un AS que recibe una ruta cuyo
AS_PATHya contiene su número la descarta.
La regla 3 elimina los ciclos sin necesidad de ningún mapa global. Veamos cómo se
propaga 100.64.3.0/24, de r3 hacia r1:
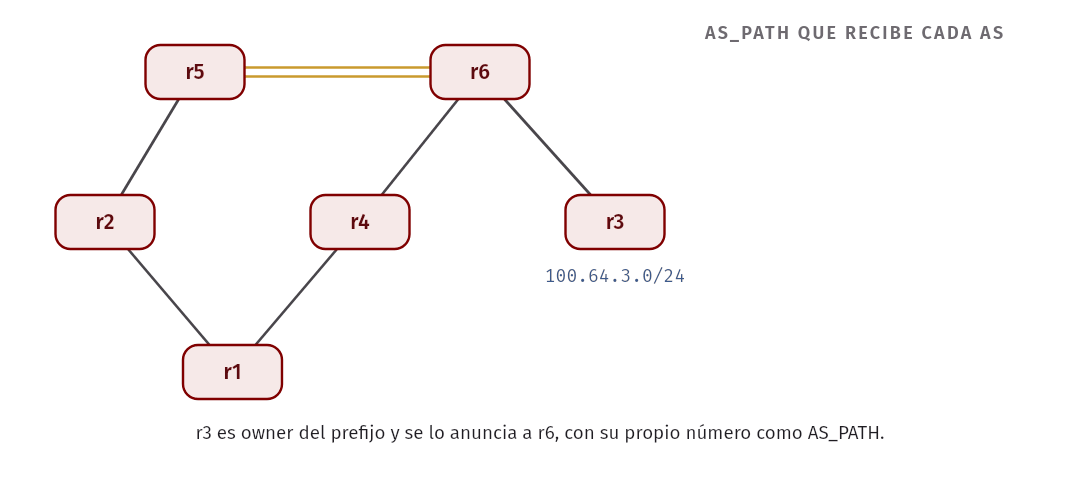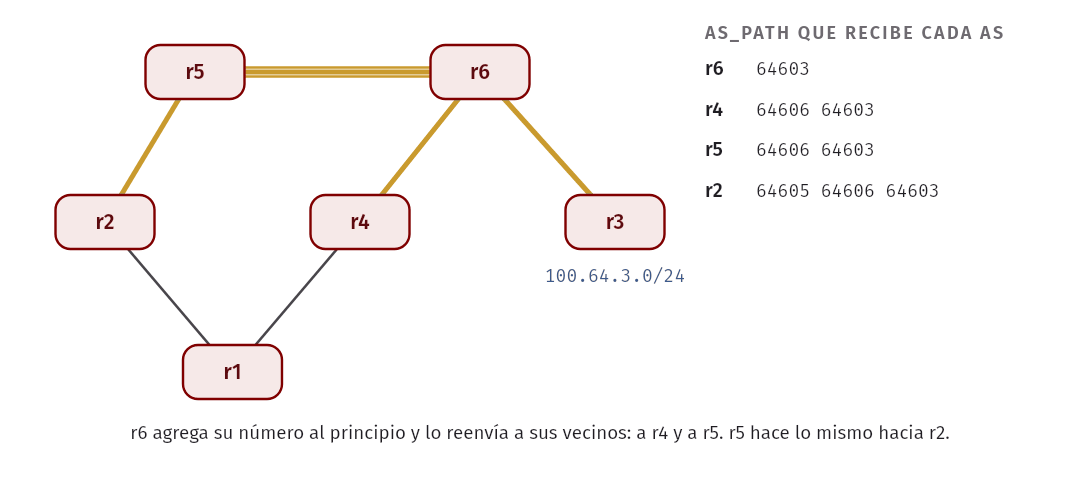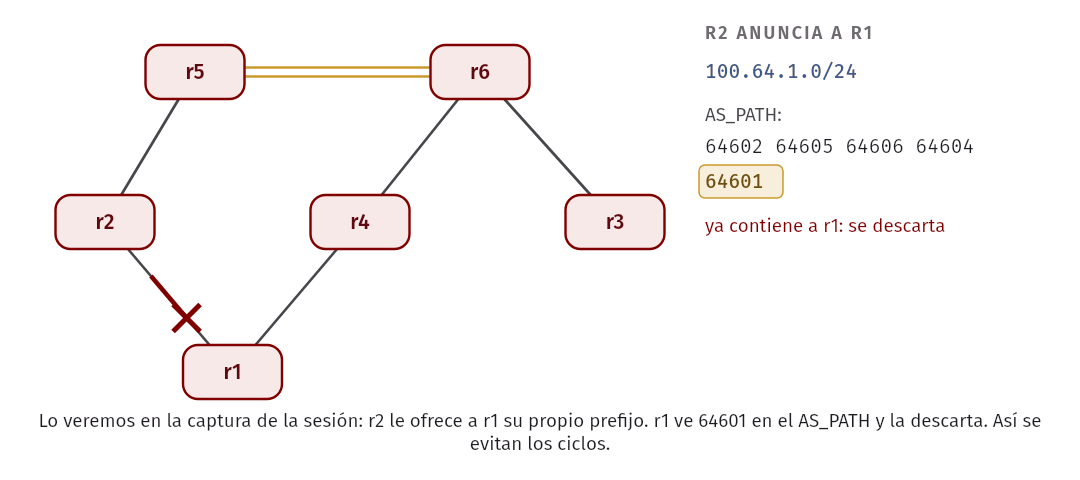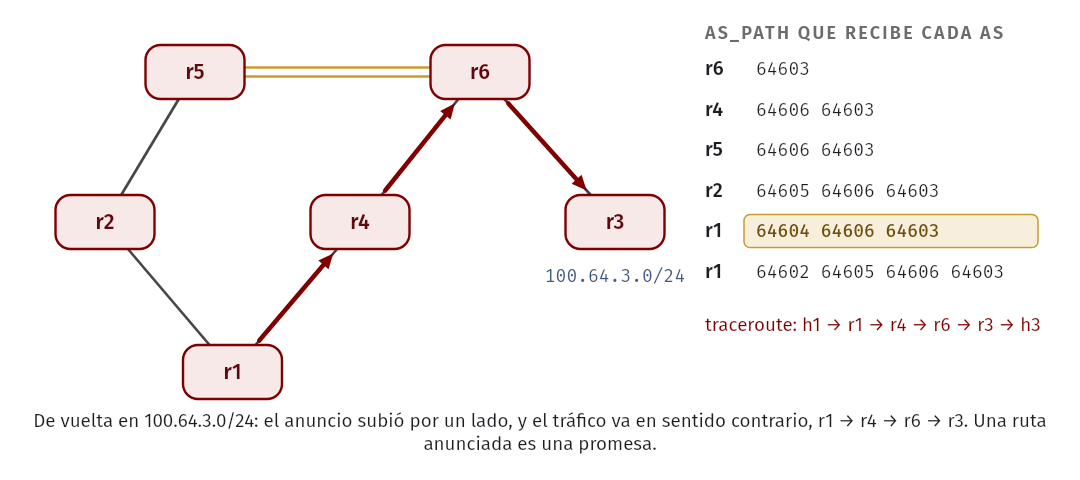
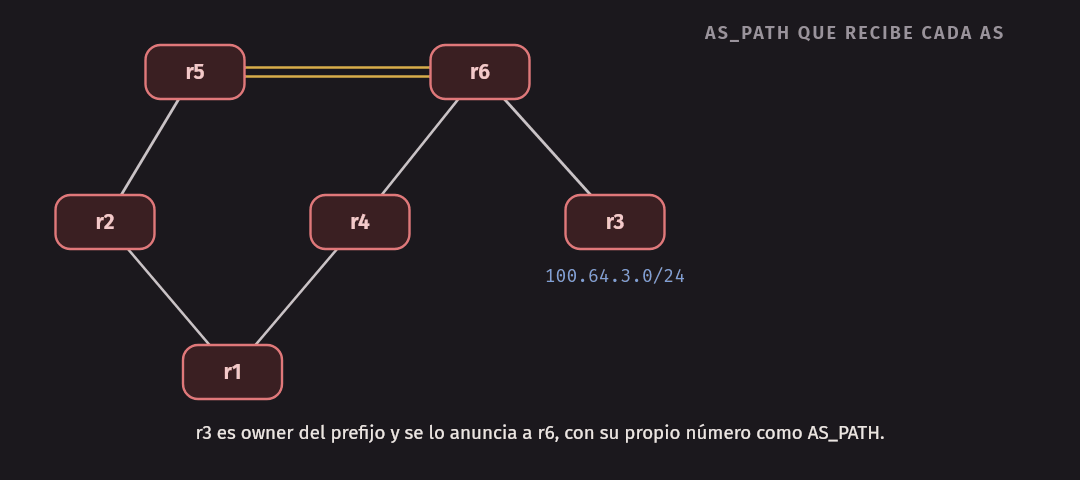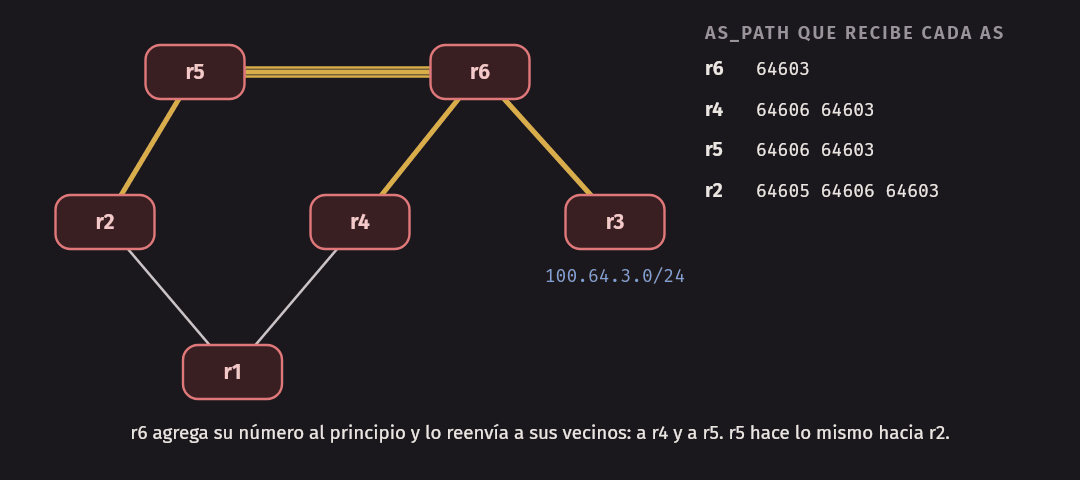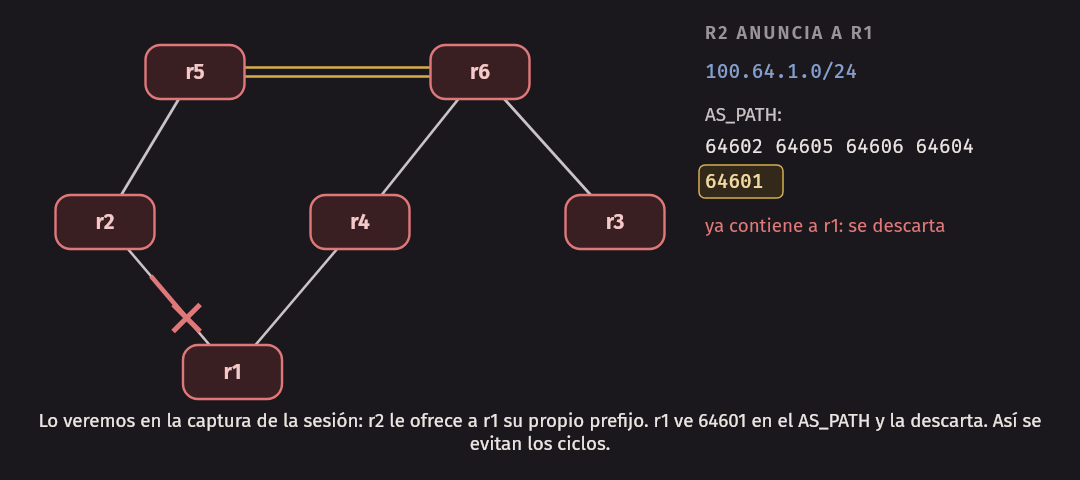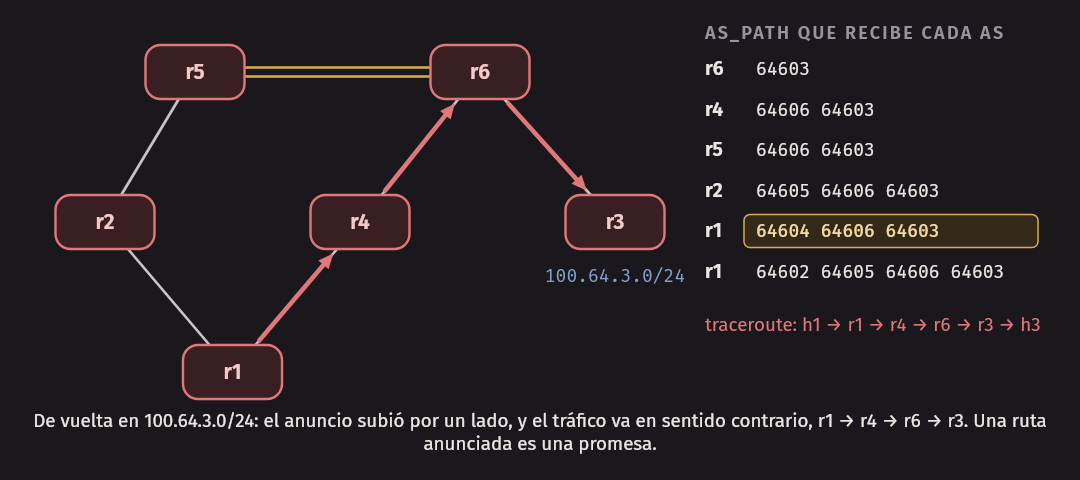
El anuncio viaja en un sentido, y el tráfico irá en el contrario: r1 manda a r4,
r4 a r6, r6 a r3. Una ruta anunciada es una promesa: “si me mandas paquetes
para este prefijo, yo los llevo”.
Y AS_PATH hace más que evitar ciclos: le muestra a cada AS por dónde pasaría su
tráfico. Eso es lo que permite aplicar políticas como “nunca por este competidor”,
que en un vector de distancias serían imposibles. Lo que no dice es nada sobre
retardo, ancho de banda o cuántos routers hay dentro de cada AS.
Una consecuencia importante: BGP anuncia solo el camino que el AS eligió, no todos los que conoce. Un AS no puede usar un camino que su vecino no decidió anunciarle. Una red sabe de Internet lo que sus vecinos quieren contarle.
Error común. Decir que BGP “calcula” el camino como OSPF. No hay ningún algoritmo global. Cada AS elige por su cuenta entre lo que le anunciaron, y le cuenta su elección a quien quiera. El camino final es el resultado de todas esas decisiones locales, y nadie lo ve completo.
Sesiones sobre TCP
Dos routers que hablan BGP son peers BGP, y lo que hay entre ellos es una sesión BGP. (Más adelante veremos que “peer” también es un tipo de relación comercial; son dos usos distintos de la misma palabra. Cuando haya dudas, diremos “vecino BGP” para la sesión y “peer” para el negocio.)
La sesión corre sobre una conexión TCP al puerto 179. Eso simplifica mucho el protocolo: BGP no tiene que preocuparse por retransmisiones, orden ni fragmentos. Y a diferencia de OSPF, BGP no refresca sus rutas: una vez anunciadas valen hasta que se retiran o hasta que la sesión cae. Por eso el costo de un BGP tranquilo es casi nulo, aunque la tabla tenga un millón de rutas.
Hay cuatro mensajes básicos. Todos empiezan con el mismo header de 19 bytes: un
marcador de 16 bytes en ff, el largo y el tipo.
| Tipo | Mensaje | Para qué |
|---|---|---|
| 1 | OPEN | Abre la sesión: versión, número de AS, hold time, identificador y capacidades. |
| 2 | UPDATE | Anuncia rutas nuevas con sus atributos y retira las que ya no valen. |
| 3 | NOTIFICATION | Informa un error o un cierre, y la sesión termina. |
| 4 | KEEPALIVE | Solo dice “sigo aquí”. Es únicamente el header. |
Si un router no recibe nada de su vecino durante el hold time, da la sesión por muerta y retira todas las rutas que aprendió de él. El KEEPALIVE se manda por lo general cada tercio de ese tiempo, para que una sesión tranquila no caiga. Con los valores por defecto que vemos abajo, una falla silenciosa del otro lado puede tardar hasta tres minutos en notarse. En un enlace directo que se cae, el router se entera al instante por la interfaz.
Una sesión, en la captura
Pasemos a verlo. Levanten la red:
make up-ases
docker exec clab-w06-ases-r2 vtysh -c 'show bgp summary'
IPv4 Unicast Summary:
BGP router identifier 100.64.2.1, local AS number 64602 VRF default vrf-id 0
BGP table version 6
RIB entries 11, using 1408 bytes of memory
Peers 2, using 33 KiB of memory
Neighbor V AS MsgRcvd MsgSent TblVer InQ OutQ Up/Down State/PfxRcd PfxSnt Desc
100.64.2.130 4 64601 9 9 6 0 0 00:00:10 4 6 N/A
100.64.5.133 4 64605 9 10 6 0 0 00:00:10 4 6 N/A
Total number of neighbors 2Hay una trampa de lectura. La columna State/PfxRcd muestra el estado de la sesión
mientras no esté establecida. Si muestra un número, la sesión está en Established
y ese número es cuántos prefijos se recibieron. PfxSnt es cuántos se anunciaron.
Los estados por los que pasa una sesión son Idle, Connect, Active, OpenSent,
OpenConfirm y Established. Los nombres confunden: Active significa que el router
está intentando abrir la conexión TCP sin lograrlo, es decir, que algo anda mal.
Para capturar el inicio de una sesión, la apagamos desde r1. Empezamos a capturar y
la volvemos a prender:
docker exec clab-w06-ases-r1 vtysh -c 'configure terminal' -c 'router bgp 64601' \
    -c 'neighbor 100.64.2.129 shutdown'
docker exec clab-w06-ases-r1 vtysh -c 'show bgp summary'
Neighbor V AS MsgRcvd MsgSent TblVer InQ OutQ Up/Down State/PfxRcd PfxSnt Desc
100.64.2.129 4 64602 9 11 0 0 0 00:00:02 Idle (Admin) 0 N/A
100.64.4.129 4 64604 11 13 9 0 0 00:00:12 5 6 N/Adocker exec -d clab-w06-ases-r1 sh -c 'tcpdump -U -i eth2 -w /tmp/s.pcap tcp port 179'
docker exec clab-w06-ases-r1 vtysh -c 'configure terminal' -c 'router bgp 64601' \
-c 'no neighbor 100.64.2.129 shutdown'Después de unos segundos, detenemos tcpdump, copiamos el archivo a la carpeta y lo
leemos con tshark:
    1   0.000000 100.64.2.130 → 100.64.2.129 TCP 74 35516 → 179 [SYN] Seq=0 Win=64240 Len=0 MSS=1460
    2   0.000033 100.64.2.129 → 100.64.2.130 TCP 74 179 → 35516 [SYN, ACK] Seq=0 Ack=1 Win=65160 Len=0
    3   0.000044 100.64.2.130 → 100.64.2.129 TCP 66 35516 → 179 [ACK] Seq=1 Ack=1 Win=64256 Len=0
    4   0.000582 100.64.2.129 → 100.64.2.130 BGP 165 OPEN Message
    5   0.000595 100.64.2.130 → 100.64.2.129 TCP 66 35516 → 179 [ACK] Seq=1 Ack=100 Win=64256 Len=0
    6   0.001513 100.64.2.130 → 100.64.2.129 BGP 165 OPEN Message
    7   0.001533 100.64.2.129 → 100.64.2.130 TCP 66 179 → 35516 [ACK] Seq=100 Ack=100 Win=65280 Len=0
    8   0.001724 100.64.2.129 → 100.64.2.130 BGP 85 KEEPALIVE Message
    9   0.001738 100.64.2.130 → 100.64.2.129 BGP 85 KEEPALIVE Message
   12   1.152823 100.64.2.129 → 100.64.2.130 BGP 436 UPDATE Message, UPDATE Message, UPDATE Message, ...
   14   1.153378 100.64.2.130 → 100.64.2.129 BGP 436 UPDATE Message, UPDATE Message, UPDATE Message, ...
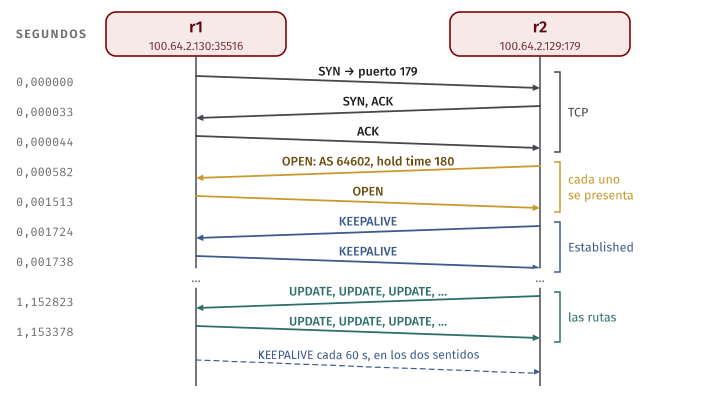
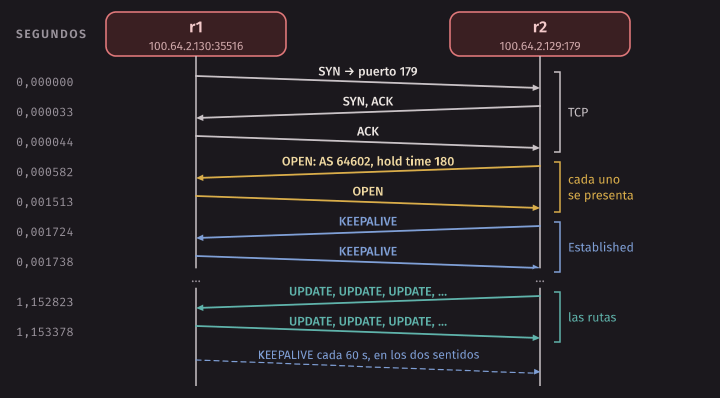
(Recortamos el final de cada línea, quitamos algunos ACK y dejamos afuera los UPDATE
que siguen.) Se ve la historia completa. El handshake de TCP hacia el puerto 179. Un
OPEN en cada sentido. Un KEEPALIVE en cada sentido, que confirma el OPEN del otro y
deja la sesión en Established. Y recién entonces, las rutas. Ojo con el último
detalle: un solo segmento TCP puede llevar varios mensajes BGP, porque para TCP son
solo bytes de un stream.
Abramos un OPEN con tshark -O bgp:
Border Gateway Protocol - OPEN Message
    Marker: ffffffffffffffffffffffffffffffff
    Length: 99
    Type: OPEN Message (1)
    Version: 4
    My AS: 64602
    Hold Time: 180
    BGP Identifier: 100.64.2.1
    Optional Parameters Length: 70
    Optional Parameters
        Optional Parameter: Capability
            Parameter Type: Capability (2)
            Parameter Length: 6
            Capability: Multiprotocol extensions capability
                Type: Multiprotocol extensions capability (1)
                Length: 4
                AFI: IPv4 (1)
                Reserved: 00
                SAFI: Unicast (1)
Están los campos que importan: versión 4, el AS del que habla, un hold time de 180 segundos y un identificador con forma de dirección IPv4. Las capacidades sirven para que los dos lados acuerden extensiones: aquí IPv4 unicast, y más abajo en la misma captura, números de AS de 4 bytes.
Si el AS del OPEN no coincide con el remote-as que el otro configuró, la sesión no
sube. Esa es la primera defensa contra un error de escritura.
Ahora un UPDATE que r1 le manda a r2. Quitamos los bits de cada campo de flags:
Border Gateway Protocol - UPDATE Message
    Marker: ffffffffffffffffffffffffffffffff
    Length: 55
    Type: UPDATE Message (2)
    Withdrawn Routes Length: 0
    Total Path Attribute Length: 28
    Path attributes
        Path Attribute - ORIGIN: IGP
            Flags: 0x40, Transitive, Well-known, Complete
            Type Code: ORIGIN (1)
            Length: 1
            Origin: IGP (0)
        Path Attribute - AS_PATH: 64601
            Flags: 0x50, Transitive, Extended-Length, Well-known, Complete
            Type Code: AS_PATH (2)
            Length: 6
            AS Path segment: 64601
                Segment type: AS_SEQUENCE (2)
                Segment length (number of ASN): 1
                AS4: 64601
        Path Attribute - NEXT_HOP: 100.64.2.130
            Flags: 0x40, Transitive, Well-known, Complete
            Type Code: NEXT_HOP (3)
            Length: 4
            Next hop: 100.64.2.130
        Path Attribute - MULTI_EXIT_DISC: 0
            Flags: 0x80, Optional, Non-transitive, Complete
            Type Code: MULTI_EXIT_DISC (4)
            Length: 4
            Multiple exit discriminator: 0
    Network Layer Reachability Information (NLRI)
        100.64.1.0/24
            NLRI prefix length: 24
            NLRI prefix: 100.64.1.0
La estructura de un UPDATE es: rutas retiradas, atributos, y los prefijos a los que se aplican esos atributos (NLRI, Network Layer Reachability Information). Un UPDATE que solo retira rutas no lleva atributos. Y un UPDATE sin rutas ni retiros es el marcador de End-of-RIB, con el que el vecino dice “ya te conté todo lo que tenía”.
El mismo tráfico se puede leer con tcpdump -vv, que muestra otra cosa interesante.
Esto es lo que r2 le mandó a r1 en esa misma captura:
	Update Message (2), length: 64
	  Origin (1), length: 1, Flags [T]: IGP
	  AS Path (2), length: 22, Flags [TE]: 64602 64605 64606 64604 64601
	  Next Hop (3), length: 4, Flags [T]: 100.64.2.129
	  Updated routes:
100.64.1.0/24¡r2 le está ofreciendo a r1 una ruta hacia el propio prefijo de r1! Mientras la
sesión estaba apagada, r2 aprendió 100.64.1.0/24 por el camino largo, a través de
r4, y como acaba de volver el vecino, se lo cuenta. r1 ve su número en el
AS_PATH y la descarta. Eso explica lo que muestra show bgp summary en r1, ya con
la sesión arriba:
Neighbor        V         AS   MsgRcvd   MsgSent   TblVer  InQ OutQ  Up/Down State/PfxRcd   PfxSnt Desc
100.64.2.129    4      64602        20        22       11    0    0 00:00:02            4        6 N/A
r2 conoce seis prefijos y le manda los seis, pero r1 registra solo cuatro como
recibidos. Los otros dos traen 64601 en el AS_PATH: su propio prefijo y
100.64.4.0/24, al que r2 llega a través de r1. Es la regla 3 del vector de
caminos, funcionando en una captura real.
Si apagamos la sesión de nuevo, vemos el último mensaje:
Border Gateway Protocol - NOTIFICATION Message
    Marker: ffffffffffffffffffffffffffffffff
    Length: 23
    Type: NOTIFICATION Message (3)
    Major error Code: Cease (6)
    Minor error Code (Cease): Hard Reset (9)
    Data: 0602
Cease es el código de “cierro a propósito”. Otros errores tienen otros códigos: un
AS inesperado en el OPEN, por ejemplo, o un atributo mal formado. Después de una
NOTIFICATION se cierra la conexión TCP y se retiran las rutas.
Un detalle más de la captura: los mensajes BGP de esta sesión viajan con TTL 1, en
los dos sentidos. Lo verifica test_ases.py. Una sesión eBGP entre vecinos directos no
debería cruzar ningún router, y con TTL 1 un paquete muere en el primer salto: así, una
sesión mal configurada hacia un router lejano no llega a formarse. Ojo, esto no es una
defensa contra un atacante, que desde lejos puede mandar paquetes con un TTL alto. La
defensa es la inversa (GTSM, RFC 5082): mandar con TTL 255 y aceptar solo 254 o más,
un valor que nadie puede lograr desde más lejos. FRRouting muestra el límite en
show bgp neighbors:
BGP neighbor is 100.64.2.129, remote AS 64602, local AS 64601, external link
  BGP state = Established, up for 00:00:05
  Hold time is 180 seconds, keepalive interval is 60 seconds
  Minimum time between advertisement runs is 0 seconds
  External BGP neighbor may be up to 1 hops away.
En la práctica. Una tabla BGP completa de Internet tiene alrededor de un millón de prefijos IPv4. Un router que la recibe por primera vez recibe cientos de miles de UPDATE. Después, solo los cambios. Esa es la ventaja de que BGP sea incremental. Pero también significa que, si una sesión con un vecino grande se reinicia, hay que volver a mandarlo todo.
Leer una tabla BGP
Cada router guarda todo lo que le anunciaron, elige un mejor camino por prefijo e
instala ese en la forwarding table. Esta es la tabla de r1:
docker exec clab-w06-ases-r1 vtysh -c 'show bgp ipv4'BGP table version is 16, local router ID is 100.64.1.1, vrf id 0
Default local pref 100, local AS 64601
Status codes: s suppressed, d damped, h history, u unsorted, * valid, > best, = multipath,
i internal, r RIB-failure, S Stale, R Removed
Nexthop codes: @NNN nexthop's vrf id, < announce-nh-self
Origin codes: i - IGP, e - EGP, ? - incomplete
RPKI validation codes: V valid, I invalid, N Not found
Network Next Hop Metric LocPrf Weight Path
*> 100.64.1.0/24 0.0.0.0 0 32768 i
*> 100.64.2.0/24 100.64.2.129 0 0 64602 i
*> 100.64.3.0/24 100.64.4.129 0 64604 64606 64603 i
* 100.64.2.129 0 64602 64605 64606 64603 i
*> 100.64.4.0/24 100.64.4.129 0 0 64604 i
*> 100.64.5.0/24 100.64.2.129 0 64602 64605 i
* 100.64.4.129 0 64604 64606 64605 i
*> 100.64.6.0/24 100.64.4.129 0 64604 64606 i
* 100.64.2.129 0 64602 64605 64606 i
Displayed 6 routes and 9 total pathsLa columna de la izquierda dice * si el camino es válido y > si es el elegido. Una
línea sin prefijo es otro camino hacia el prefijo de la línea anterior. Path se lee
de izquierda a derecha: el primero es el vecino, el último el origen, y la letra final
es el atributo ORIGIN. Observen cuatro cosas:
r1no aparece en ningúnAS_PATHde su propia tabla. Un AS agrega su número al anunciar, no al recibir.Next Hopes la dirección a la que hay que mandar el paquete.0.0.0.0significa que la ruta es propia.- Hacia
100.64.4.0/24solo se ve un camino, aunque también existe porr2, porquer2eligió llegar a ese prefijo a través der1(lo veremos en la Sesión B) y el camino de regreso contiene64601. - La columna
Metrictrae el MED. Solo la tienen los prefijos que originó el vecino directo, y es porque ese atributo no cruza más de un AS.
Weight es un valor local de este router: no es un atributo de BGP y no viaja.
32768 es el que FRRouting le da a lo que origina él mismo.
Para ver por qué ganó un camino, se pide el detalle:
docker exec clab-w06-ases-r1 vtysh -c 'show bgp ipv4 100.64.3.0/24'BGP routing table entry for 100.64.3.0/24, version 5
Paths: (2 available, best #1, table default)
Advertised to non peer-group peers:
100.64.2.129 100.64.4.129
64604 64606 64603
100.64.4.129 from 100.64.4.129 (100.64.4.1)
Origin IGP, valid, external, best (AS Path)
Last update: Mon Nov 2 07:47:09 2026
64602 64605 64606 64603
100.64.2.129 from 100.64.2.129 (100.64.2.1)
Origin IGP, valid, external
Last update: Mon Nov 2 07:47:33 2026best (AS Path) es la razón por la que ganó, y es muy útil para aprender: cada vez
que tengan dudas sobre por qué un router eligió algo, lean esa palabra. external
significa que lo aprendió por eBGP.
Y lo elegido termina en la tabla del kernel, con proto bgp:
docker exec clab-w06-ases-r1 ip route100.64.1.0/25 dev eth1 proto kernel scope link src 100.64.1.1
blackhole 100.64.1.0/24 proto 196 metric 20
100.64.2.0/24 nhid 27 via 100.64.2.129 dev eth2 proto bgp metric 20
100.64.2.128/30 dev eth2 proto kernel scope link src 100.64.2.130
100.64.3.0/24 nhid 30 via 100.64.4.129 dev eth3 proto bgp metric 20
100.64.4.0/24 nhid 30 via 100.64.4.129 dev eth3 proto bgp metric 20
100.64.4.128/30 dev eth3 proto kernel scope link src 100.64.4.130
100.64.5.0/24 nhid 27 via 100.64.2.129 dev eth2 proto bgp metric 20
100.64.6.0/24 nhid 30 via 100.64.4.129 dev eth3 proto bgp metric 20
172.90.6.0/26 dev eth0 proto kernel scope link src 172.90.6.2 Aquí se ve también lo que hace la ruta a Null0: un blackhole para el /24 propio,
con 100.64.1.0/25 más específico encima de él. (La última línea es la red de gestión
de Docker.)
Y por último, el camino real de un paquete, de h1 a h3:
traceroute to 100.64.3.10 (100.64.3.10), 30 hops max, 46 byte packets
 1  100.64.1.1  0.006 ms
 2  100.64.4.129  0.003 ms
 3  100.64.6.129  0.003 ms
 4  100.64.6.134  0.003 ms
 5  100.64.3.10  0.002 ms
Corresponde al AS_PATH elegido: r1, r4, r6, r3 y el host. (Corrimos
traceroute con -n -w 1 -q 1, una sola prueba por salto. No lean los tiempos: en
esta red los enlaces son virtuales.)
Atributos: lo que acompaña a un prefijo
Una ruta BGP es un prefijo más sus atributos. Estos son los que necesitamos:
| Atributo | Qué dice | Quién lo pone y hasta dónde llega |
|---|---|---|
ORIGIN |
De dónde salió la ruta: i (IGP, con network), e (EGP, histórico) o ? (por ejemplo, redistribuida) |
El origen. Viaja por todas partes. |
AS_PATH |
Los AS que cruzó | Cada AS al anunciar a otro AS. Viaja por todas partes. |
NEXT_HOP |
A qué dirección mandar los paquetes | Se cambia al pasar por eBGP. Dentro de un AS, no cambia sin que se pida. |
LOCAL_PREF |
Cuánto le gusta esta ruta a este AS | Se pone al entrar. Viaja solo por iBGP: nunca sale del AS. |
MED |
Por cuál de mis enlaces prefiero que me entren | Lo pone el AS vecino. Se compara y no pasa al siguiente AS. |
| Comunidad | Una etiqueta de 32 bits que no tiene significado propio | La pone cualquiera. Viaja mientras nadie la quite. |
Vean cómo la tabla de arriba confirma las dos últimas filas sobre el MED. El vecino
directo lo manda (la captura trae MULTI_EXIT_DISC: 0), y por eso se ve la columna
Metric en 64602 i. El camino 64604 64606 64603 i tiene esa columna vacía: el MED
no pasó de un AS al siguiente.
Los atributos se clasifican según lo que el protocolo obliga a hacer con ellos, y esas
categorías aparecen en la captura como Well-known, Optional, Transitive. Por
ejemplo, ORIGIN, AS_PATH y NEXT_HOP son well-known y obligatorios: todo router
debe entenderlos y deben venir en cada anuncio. El MED es optional y non-transitive.
Las comunidades son optional y transitive, así que un router que no las entienda las
debe dejar pasar.
eBGP e iBGP: BGP dentro de un AS
Hasta ahora cada AS era un solo router. Un AS real tiene muchos routers, y varios de
ellos pueden ser de borde. Si b1 aprende una ruta de un vecino externo, ¿cómo se
enteran los demás routers del AS?
Aquí hay dos variantes de la misma sesión BGP:
- eBGP (external): entre routers de distintos AS, normalmente conectados directo.
- iBGP (internal): entre routers del mismo AS, que pueden estar a varios saltos.
El mensaje y el puerto son los mismos. Las diferencias son de reglas: qué se hace con
AS_PATH, con NEXT_HOP y con LOCAL_PREF al pasar la ruta. FRRouting decide cuál
es según si el remote-as coincide con el propio.
Tampoco se debe confundir iBGP con OSPF, porque hacen trabajos distintos:
- OSPF enseña a cada router del AS cómo llegar a los demás routers del AS.
- iBGP les enseña a todos qué prefijos externos se alcanzan, y por cuál router de borde.
Para llegar a un destino externo, un router hace dos búsquedas: BGP le dice “ese prefijo está detrás del next hop X”, y OSPF le dice “para llegar a X, sal por esta interfaz”. Por eso las rutas externas no se meten en OSPF. Serían un millón de rutas inundadas a cada router, justo lo que queríamos evitar.
Vamos a la segunda topología, con un AS de tránsito de cuatro routers y un vecino externo que se conecta a los dos extremos:
       +----- x (65200) ------+
       |                      |
      b1 ---- b2 ---- b3 ---- b4        AS 65100: OSPF e iBGP entre los cuatro
Los routers b1 a b4 tienen OSPF en sus enlaces internos y en una loopback
(100.64.100.N/32), y los enlaces hacia x (10.207.1.0/30 y 10.207.4.0/30) no
están en OSPF. Entre ellos hay una sesión iBGP por cada par. Este es el trozo de b1
que nos importa:
router ospf
 ospf router-id 100.64.100.1
router bgp 65100
 bgp router-id 100.64.100.1
 no bgp ebgp-requires-policy
 ! Malla completa de iBGP: una sesión con cada otro router, entre loopbacks.
 ! Las sesiones esperan a OSPF: se reintenta cada 5 s, en vez de los 120 s por defecto.
 neighbor 100.64.100.2 remote-as 65100
 neighbor 100.64.100.2 update-source lo
 neighbor 100.64.100.2 timers connect 5
Las sesiones se abren entre loopbacks y no entre interfaces. Así una sesión no depende
de un enlace: mientras OSPF encuentre algún camino, sigue arriba. Por eso
update-source lo.
make up-ibgp
docker exec clab-w06-ibgp-b2 vtysh -c 'show bgp summary'
Neighbor V AS MsgRcvd MsgSent TblVer InQ OutQ Up/Down State/PfxRcd PfxSnt Desc
100.64.100.1 4 65100 5 3 2 0 0 00:00:09 2 0 FRRouting/10.3.1_git
100.64.100.3 4 65100 3 3 2 0 0 00:00:10 0 0 FRRouting/10.3.1_git
100.64.100.4 4 65100 5 3 2 0 0 00:00:09 2 0 FRRouting/10.3.1_gitEl problema del NEXT_HOP
x anuncia 100.64.120.0/24, y b1 lo pasa a sus compañeros por iBGP. Veamos qué le
llega a b2:
docker exec clab-w06-ibgp-b2 vtysh -c 'show bgp ipv4 100.64.120.0/24'BGP routing table entry for 100.64.120.0/24, version 0
Paths: (2 available, no best path)
Not advertised to any peer
65200
10.207.4.2 (inaccessible, import-check enabled) from 100.64.100.4 (100.64.100.4)
Origin IGP, metric 0, localpref 100, invalid, internal
Last update: Mon Nov 2 07:48:35 2026
65200
10.207.1.2 (inaccessible, import-check enabled) from 100.64.100.1 (100.64.100.1)
Origin IGP, metric 0, localpref 100, invalid, internal
Last update: Mon Nov 2 07:48:35 2026b2 conoce la ruta y no la puede usar: no best path. La razón está a la vista. Por
iBGP el NEXT_HOP no cambia, así que sigue siendo 10.207.1.2, la dirección de x.
Y a ese enlace b2 no sabe llegar, porque no está en OSPF. Como la tabla del kernel
de b2 lo confirma, no hay ninguna entrada para ese prefijo:
10.207.12.0/30 dev eth1 proto kernel scope link src 10.207.12.2
10.207.23.0/30 dev eth2 proto kernel scope link src 10.207.23.1
10.207.34.0/30 nhid 22 via 10.207.23.2 dev eth2 proto ospf metric 20
100.64.100.0/24 nhid 24 via 10.207.12.1 dev eth1 proto bgp metric 20
100.64.100.1 nhid 24 via 10.207.12.1 dev eth1 proto ospf metric 20
100.64.100.3 nhid 22 via 10.207.23.2 dev eth2 proto ospf metric 20
100.64.100.4 nhid 22 via 10.207.23.2 dev eth2 proto ospf metric 20
172.90.6.64/26 dev eth0 proto kernel scope link src 172.90.6.69
Hay dos arreglos. Uno es meter los enlaces de borde en OSPF. El otro, el más común, es que el router de borde se ponga a sí mismo como next hop al pasar la ruta por iBGP:
! En b1: las rutas que pasa por iBGP llevan como NEXT_HOP su propia loopback,
! que los demás conocen por OSPF.
router bgp 65100
 address-family ipv4 unicast
  neighbor 100.64.100.2 next-hop-self
  neighbor 100.64.100.3 next-hop-self
  neighbor 100.64.100.4 next-hop-self
 exit-address-family
Cargamos ese archivo, y uno igual en b4:
docker cp ibgp/nhs_b1.conf clab-w06-ibgp-b1:/tmp/n.conf
docker exec clab-w06-ibgp-b1 vtysh -f /tmp/n.conf
docker cp ibgp/nhs_b4.conf clab-w06-ibgp-b4:/tmp/n.conf
docker exec clab-w06-ibgp-b4 vtysh -f /tmp/n.conf
docker exec clab-w06-ibgp-b2 vtysh -c 'show bgp ipv4 100.64.120.0/24'
BGP routing table entry for 100.64.120.0/24, version 3
Paths: (2 available, best #1, table default)
Not advertised to any peer
65200
100.64.100.1 (metric 10) from 100.64.100.1 (100.64.100.1)
Origin IGP, metric 0, localpref 100, valid, internal, best (IGP Metric)
Last update: Mon Nov 2 07:48:44 2026
65200
100.64.100.4 (metric 20) from 100.64.100.4 (100.64.100.4)
Origin IGP, metric 0, localpref 100, valid, internal
Last update: Mon Nov 2 07:48:44 2026Ahora el next hop es una loopback, y (metric 10) es la distancia OSPF hasta ella. Ya
tenemos la interacción entre los dos protocolos en una sola línea.
Compárenlo con la vista de OSPF en el mismo router: solo trae loopbacks y enlaces
internos, y de 100.64.120.0/24 no sabe nada.
============ OSPF network routing table ============
N    10.207.12.0/30        [10] area: 0.0.0.0
                           directly attached to eth1
N    10.207.23.0/30        [10] area: 0.0.0.0
                           directly attached to eth2
N    10.207.34.0/30        [20] area: 0.0.0.0
                           via 10.207.23.2, eth2
N    100.64.100.1/32       [10] area: 0.0.0.0
                           via 10.207.12.1, eth1
N    100.64.100.2/32       [0] area: 0.0.0.0
                           directly attached to lo
N    100.64.100.3/32       [10] area: 0.0.0.0
                           via 10.207.23.2, eth2
N    100.64.100.4/32       [20] area: 0.0.0.0
                           via 10.207.23.2, eth2
iBGP no reenvía a iBGP
En eBGP, los ciclos se evitan con AS_PATH. Dentro de un AS eso no sirve: el número
de AS se agrega al salir, así que una ruta que da vueltas entre routers del mismo AS
no cambia su AS_PATH, y nadie la reconocería. La solución de BGP es tajante:
Una ruta aprendida por iBGP no se reenvía a otro vecino iBGP.
Un router de borde le cuenta directamente lo que aprendió afuera a cada router del AS,
y por eso hace falta una malla completa: una sesión iBGP por cada par. Con n
routers son n(n-1)/2 sesiones. Con cuatro son seis. Con 500, son 124 750.
Se puede comprobar. Apagamos en b3 las sesiones con b1 y con b4, y le dejamos
solo la que tiene con b2, que sí conoce la ruta:
docker exec clab-w06-ibgp-b3 vtysh -c 'configure terminal' -c 'router bgp 65100' \
    -c 'neighbor 100.64.100.1 shutdown' -c 'neighbor 100.64.100.4 shutdown'
docker exec clab-w06-ibgp-b3 vtysh -c 'show bgp summary'
Neighbor V AS MsgRcvd MsgSent TblVer InQ OutQ Up/Down State/PfxRcd PfxSnt Desc
100.64.100.1 4 65100 7 4 0 0 0 00:00:03 Idle (Admin) 0 FRRouting/10.3.1_git
100.64.100.2 4 65100 3 3 3 0 0 00:00:19 0 0 FRRouting/10.3.1_git
100.64.100.4 4 65100 7 4 0 0 0 00:00:03 Idle (Admin) 0 FRRouting/10.3.1_gitLa sesión con b2 está arriba y trae cero prefijos. Y en b3:
% Network not in table
PING 100.64.120.1 (100.64.120.1) from 100.64.100.3: 56 data bytes
ping: sendto: Network unreachable
Mientras tanto, b2 tiene los dos caminos elegidos sin problema:
 *>i 100.64.120.0/24  100.64.100.1             0    100      0 65200 i
 * i                  100.64.100.4             0    100      0 65200 i
La i después de *> significa que la aprendió por iBGP. El paquete de b3 podría
cruzar por b2 sin problema, pero nadie le contó a b3 que el destino existe.
En la práctica. Una malla completa no escala. Las redes grandes usan route reflectors (RFC 4456), routers a los que se les permite reenviar lo aprendido por iBGP, bajo ciertas reglas y con atributos propios para evitar ciclos. Cada router solo habla con los reflectores. El resultado es el mismo que da la malla: todos se enteran de todo.
Error común. Olvidar que iBGP necesita un camino interno. iBGP no reemplaza a OSPF: corre encima de él. Sin OSPF, las loopbacks no se alcanzan y las sesiones se quedan en
Active.
Elegir la mejor ruta
Cuando un router tiene varios caminos válidos hacia un mismo prefijo, los compara con una lista de criterios en orden. Se detiene en el primero que desempata. En FRRouting, los que nos importan son estos:
| Orden | Criterio | Gana | Razón que muestra FRRouting |
|---|---|---|---|
| 1 | Weight | El mayor (local al router, no es un atributo de BGP) | Weight |
| 2 | LOCAL_PREF |
El mayor | Local Pref |
| 3 | Ruta originada localmente | La propia | Local Route |
| 4 | Largo de AS_PATH |
El menor | AS Path |
| 5 | ORIGIN |
i antes que e, y e antes que ? |
Origin |
| 6 | MED |
El menor, solo entre rutas que vienen del mismo AS vecino | MED |
| 7 | eBGP contra iBGP | eBGP | Peer Type |
| 8 | Costo IGP hasta el NEXT_HOP |
El menor | IGP Metric |
| 9 | Desempates finales | El camino más antiguo entre rutas eBGP, luego el menor router ID, luego otros | Older Path, Router ID |
Las filas 2 y 4 en ese orden son la frase más importante de esta semana: la política
va primero. Un AS usa LOCAL_PREF para decidir antes de que el largo del camino
siquiera se mire. La fila 1 es propia de la implementación, y en este curso no vamos a
usar weight: lo que hagamos debe valer para todo el AS, y por eso se hace con
LOCAL_PREF.
Kurose y Ross resumen la lista en cuatro pasos: LOCAL_PREF, AS_PATH más corto,
next hop más cercano y criterios adicionales. Es la misma idea, sin el detalle.
Cada criterio, en nuestras tablas
Ya vimos best (AS Path) en r1. Los demás aparecen en la topología con iBGP. En
b2 y b3 el LOCAL_PREF, el AS_PATH, el ORIGIN y el MED son iguales, y además
son dos rutas iBGP, así que decide la fila 8. Cada uno se va por su salida más
cercana:
$ docker exec clab-w06-ibgp-b2 vtysh -c 'show bgp ipv4 100.64.120.0/24'
  65200
    100.64.100.1 (metric 10) from 100.64.100.1 (100.64.100.1)
      Origin IGP, metric 0, localpref 100, valid, internal, best (IGP Metric)
  65200
    100.64.100.4 (metric 20) from 100.64.100.4 (100.64.100.4)
      Origin IGP, metric 0, localpref 100, valid, internal

$ docker exec clab-w06-ibgp-b3 vtysh -c 'show bgp ipv4 100.64.120.0/24'
  65200
    100.64.100.4 (metric 10) from 100.64.100.4 (100.64.100.4)
      Origin IGP, metric 0, localpref 100, valid, internal, best (IGP Metric)
  65200
    100.64.100.1 (metric 20) from 100.64.100.1 (100.64.100.1)
      Origin IGP, metric 0, localpref 100, valid, internal
Quitamos de la salida las líneas de fecha. Los paquetes lo confirman:
traceroute to 100.64.120.1 (100.64.120.1) from 100.64.100.2, 30 hops max, 46 byte packets
 1  10.207.12.1  0.009 ms
 2  100.64.120.1  0.002 ms

traceroute to 100.64.120.1 (100.64.120.1) from 100.64.100.3, 30 hops max, 46 byte packets
 1  10.207.34.2  0.004 ms
 2  100.64.120.1  0.001 ms
Dos routers del mismo AS, hacia el mismo destino, sacan el tráfico por puntas opuestas. Esto se llama hot potato: como una papa caliente, el AS se deshace del paquete lo antes posible. Le conviene porque cada kilómetro dentro de su red le cuesta, y el resto del camino es problema de otro.
En b1, en cambio, la fila 7 decide antes de llegar a la 8:
BGP routing table entry for 100.64.120.0/24, version 2
Paths: (2 available, best #1, table default)
  Advertised to non peer-group peers:
  10.207.1.2 100.64.100.2 100.64.100.3 100.64.100.4
  65200
    10.207.1.2 from 10.207.1.2 (100.64.120.1)
      Origin IGP, metric 0, valid, external, best (Peer Type)
      Last update: Mon Nov  2 07:48:21 2026
  65200
    100.64.100.4 (metric 30) from 100.64.100.4 (100.64.100.4)
      Origin IGP, metric 0, localpref 100, valid, internal
      Last update: Mon Nov  2 07:48:45 2026
MED y cold potato
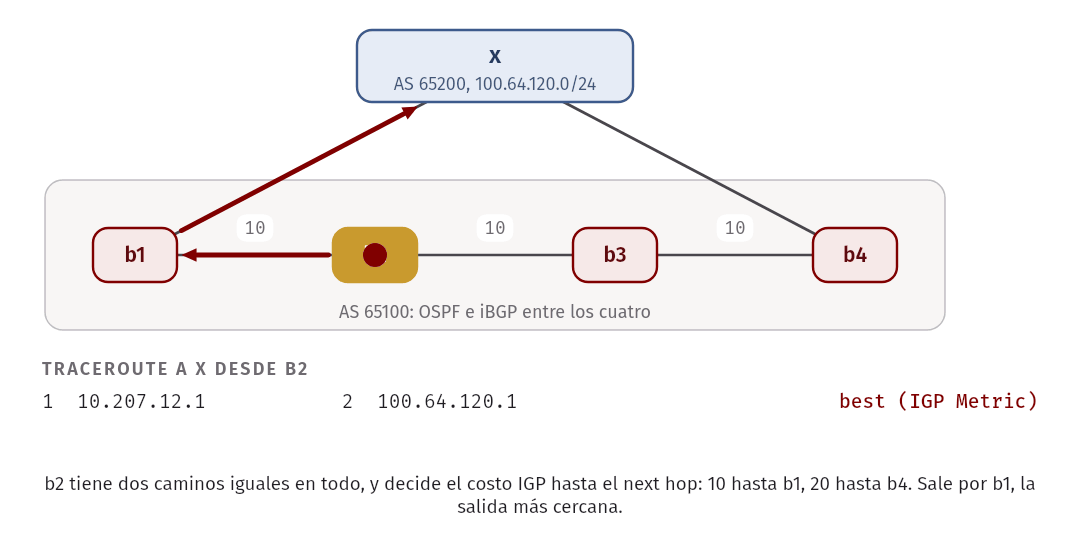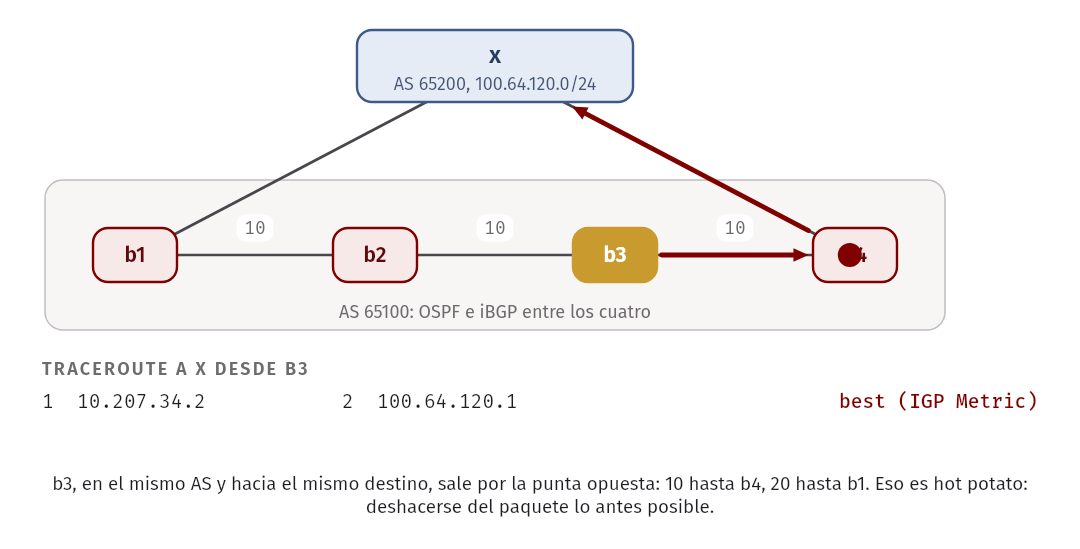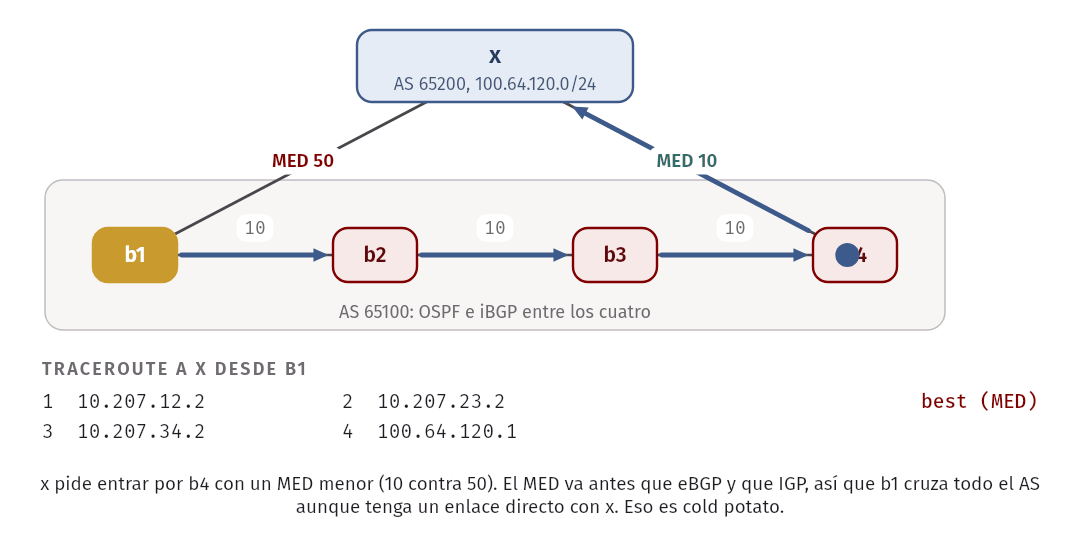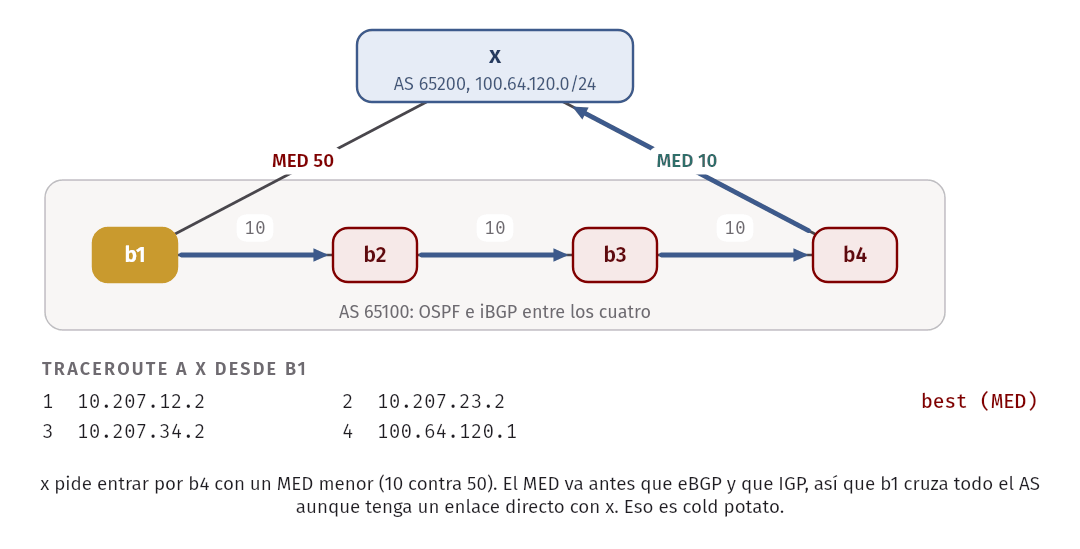
Ahora veamos a x. A él no le da igual dónde le entre el tráfico: supongamos que su
servidor está cerca de su enlace con b4. Puede pedirle a su vecino que use esa
entrada, con un MED menor:
! En x: pide que el tráfico hacia su prefijo entre por b4 (MED menor gana).
route-map MED_LOW permit 10
 set metric 10
route-map MED_HIGH permit 10
 set metric 50
router bgp 65200
 address-family ipv4 unicast
  neighbor 10.207.4.1 route-map MED_LOW out
  neighbor 10.207.1.1 route-map MED_HIGH out
 exit-address-family
(Un adelanto de los route-map, que veremos en detalle en la Sesión B. Aquí solo
cambian un número en lo que se anuncia.)
docker cp ibgp/med_x.conf clab-w06-ibgp-x:/tmp/n.conf
docker exec clab-w06-ibgp-x vtysh -f /tmp/n.conf
docker exec clab-w06-ibgp-b1 vtysh -c 'show bgp ipv4 100.64.120.0/24'
BGP routing table entry for 100.64.120.0/24, version 5
Paths: (2 available, best #1, table default)
Advertised to non peer-group peers:
10.207.1.2
65200
100.64.100.4 (metric 30) from 100.64.100.4 (100.64.100.4)
Origin IGP, metric 10, localpref 100, valid, internal, best (MED)
Last update: Mon Nov 2 07:49:05 2026
65200
10.207.1.2 from 10.207.1.2 (100.64.120.1)
Origin IGP, metric 50, valid, external
Last update: Mon Nov 2 07:49:10 2026Lean esta salida con calma, porque es sorprendente. b1 tiene un enlace directo
con x, y aun así elige un camino a través de todo el AS, porque la fila 6 (MED) va
antes que la 7 (eBGP) y que la 8 (IGP). El tráfico lo muestra:
traceroute to 100.64.120.1 (100.64.120.1) from 100.64.100.1, 30 hops max, 46 byte packets
 1  10.207.12.2  0.004 ms
 2  10.207.23.2  0.002 ms
 3  10.207.34.2  0.001 ms
 4  100.64.120.1  0.002 ms
Y hay un segundo efecto. Un router solo anuncia su mejor camino, y si ese camino lo
aprendió por iBGP no se lo reenvía a otro vecino iBGP. Como el mejor camino de b1
ahora viene de b4, b1 deja de ofrecer su ruta externa, y b2 se queda con una
sola opción:
BGP routing table entry for 100.64.120.0/24, version 5
Paths: (1 available, best #1, table default)
  Not advertised to any peer
  65200
    100.64.100.4 (metric 20) from 100.64.100.4 (100.64.100.4)
      Origin IGP, metric 10, localpref 100, valid, internal, best (First path received)
      Last update: Mon Nov  2 07:49:05 2026
First path received aparece cuando hay un solo camino y no hubo nada que comparar.
Esto se llama cold potato: el AS 65100 carga el paquete por su red hasta el
punto que x pidió. Si 65100 obedece, está pagando la distancia que antes se
ahorraba. Por eso un AS acepta el MED de un vecino cuando le conviene o cuando un
contrato lo exige (típicamente, cuando el vecino es su cliente). Si no quiere, le
basta con quitarlo en su política de entrada.
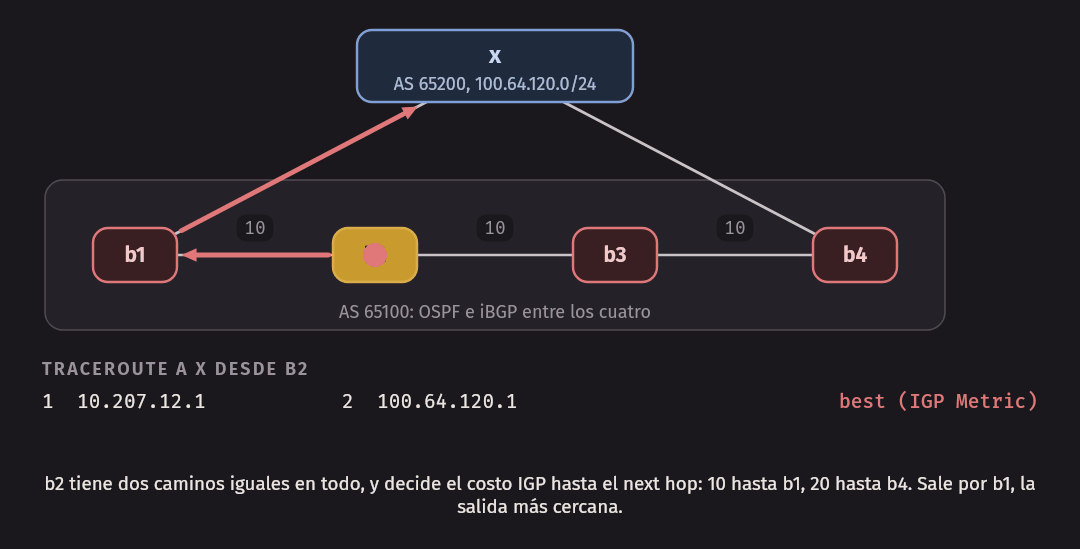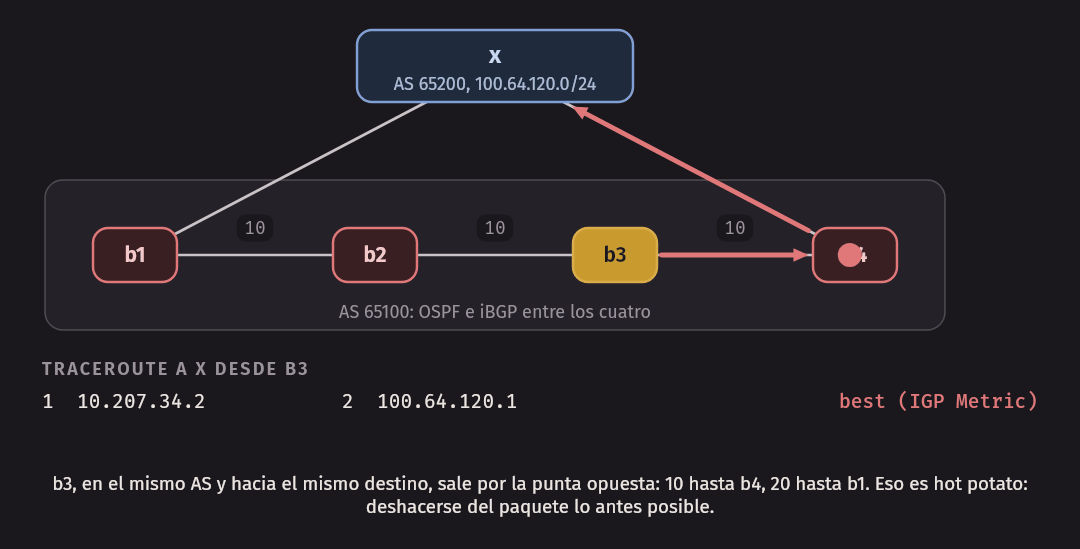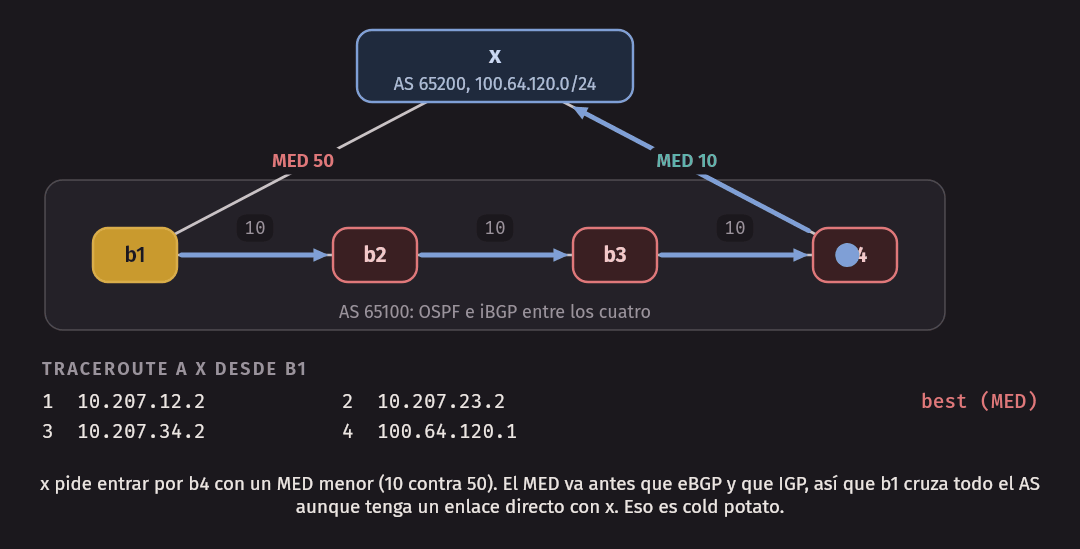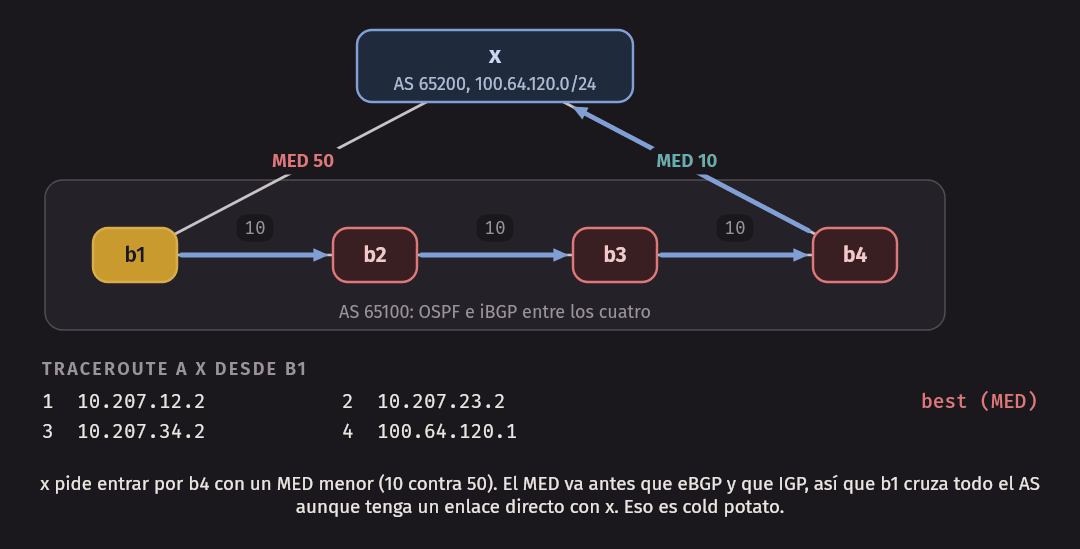
| Hot potato | Cold potato | |
|---|---|---|
| Regla | Salgo por la salida más cercana a mí | Llevo el paquete hasta la entrada que prefiere el otro |
| Quién carga la distancia | El siguiente AS | Yo |
| A quién favorece | Al AS que manda el tráfico | Al AS que lo recibe, y a menudo al usuario |
| Efecto típico | Caminos asimétricos | Caminos más controlados |
Un apunte sobre la asimetría: si dos AS usan hot potato entre sí, el tráfico de ida
sale por un punto y el de vuelta por otro, y es perfectamente normal. Un traceroute
solo les muestra la ida.
Error común. Creer que BGP busca el camino de menor retardo. No conoce el retardo: ningún atributo lo mide. El
AS_PATHmás corto tampoco es el primer criterio, y solo cuenta sistemas autónomos: un AS puede ser un edificio o un continente. Dos saltos de AS pueden ser mucho peores que cinco. En la Sesión B veremos ar1usar a propósito un camino más largo en AS.
Idea clave. La lista de criterios tiene un orden con sentido. Primero lo que el AS quiere (
LOCAL_PREF). Después lo que le sugieren los demás (AS_PATH,MED). Y solo al final, lo que sale más barato dentro del AS (hot potato).
Quién le paga a quién
Empezamos la Sesión B. Sabemos cómo funciona BGP: ahora la pregunta es qué hacer con él. La respuesta no sale de ningún algoritmo. Sale de los contratos.
Entre dos AS vecinos hay, casi siempre, una de dos relaciones:
- Cliente y proveedor (customer-provider). El cliente le paga al proveedor para que este lo conecte con todo Internet. El pago suele depender del tráfico que cruza ese enlace, en cualquiera de los dos sentidos. Un ISP de hogares es cliente de un ISP regional, y ese es cliente de uno mundial. A este servicio se le llama transit.
- Peers (peering). Dos AS acuerdan intercambiar tráfico entre sus propias redes y sus clientes, por lo general sin pagarse nada. No es un servicio de acceso a Internet: un peer no te da salida hacia el resto. Se hace porque, si dos redes intercambian mucho tráfico, conectarse directo les ahorra lo que pagarían a sus proveedores.
Con esa información, cada enlace se traduce en dinero:
| Tráfico en un enlace con mi… | Efecto |
|---|---|
| cliente | Gano dinero, en cualquier sentido |
| peer | No gano ni pierdo, salvo el costo del enlace |
| proveedor | Pago dinero, en cualquier sentido |
Volvamos ahora al dibujo de los seis AS, que antes leímos como un grafo:
| AS | Router | Proveedores | Peers | Clientes |
|---|---|---|---|---|
| 64601 | r1 |
r2, r4 |
||
| 64602 | r2 |
r5 |
r1 |
|
| 64603 | r3 |
r6 |
||
| 64604 | r4 |
r6 |
r1 |
|
| 64605 | r5 |
r6 |
r2 |
|
| 64606 | r6 |
r5 |
r3, r4 |
r5 y r6 no tienen proveedor: son la parte de arriba de esta pequeña Internet, y
para alcanzarse dependen de su enlace de peers. r1 es lo que se llama
multihomed: una organización con dos proveedores, para no quedarse sin red si uno
falla.
Idea clave. Una ruta anunciada es una oferta de llevar tráfico. Anunciar una ruta a un vecino es ofrecerle transportar sus paquetes por ese camino. Por eso la exportación es una decisión de negocio, y no un detalle técnico.
Las reglas de importación y exportación
De esa tabla salen dos reglas.
Importación: a qué ruta le doy preferencia. Si un AS conoce un mismo prefijo por
varios vecinos, prefiere la ruta de un cliente, luego la de un peer y por
último la de un proveedor, sin importar el largo del AS_PATH. Mandar el tráfico
por un cliente le da ingresos; por un peer, le sale gratis; por un proveedor, le
cuesta. Se implementa con LOCAL_PREF, que como vimos gana antes de mirar el largo
del camino.
Exportación: qué le cuento a quién. Antes de anunciar una ruta, un AS se pregunta: “si este vecino me manda tráfico por aquí, ¿quién paga?”.
| La ruta viene de mi… | ¿A un cliente? | ¿A un peer? | ¿A un proveedor? |
|---|---|---|---|
| propia red | Sí | Sí | Sí |
| cliente | Sí | Sí | Sí |
| peer | Sí | No | No |
| proveedor | Sí | No | No |
Leamos dos casos. Una ruta de un cliente se anuncia a todos, porque todo el tráfico que llegue por ella termina cruzando el enlace con ese cliente, y eso le genera ingresos. En cambio, si anuncio a un peer una ruta que aprendí de mi proveedor, ese peer me podría mandar tráfico que yo le llevaría a mi proveedor, pagando, sin que me den nada a cambio. Le estaría regalando transit.
A los clientes se les anuncia todo: es justamente el servicio por el que pagan.
Error común. Pensar que un peer da acceso a todo Internet. Un peer te da acceso a él y a sus clientes. Por eso, si
r5yr6dejan de tener peering, los clientes de uno no alcanzan a los del otro, aunque ambos sigan conectados. Este tipo de corte se ha visto en la realidad, cuando dos redes grandes se pelean por quién debe pagar.
El problema: tránsito gratis
Ya podemos leer lo que ocurre en la red sin políticas. Aquí hay un AS que está
regalando su enlace. Es el paso 3 del laboratorio, y les recomendamos buscarlo antes
de seguir leyendo: miren las tablas de r2 y r4, y busquen un AS_PATH que no
tenga sentido comercial.
docker exec clab-w06-ases-r2 vtysh -c 'show bgp ipv4 100.64.4.0/24'BGP routing table entry for 100.64.4.0/24, version 16
Paths: (2 available, best #1, table default)
Advertised to non peer-group peers:
100.64.2.130 100.64.5.133
64601 64604
100.64.2.130 from 100.64.2.130 (100.64.1.1)
Origin IGP, valid, external, best (AS Path)
Last update: Mon Nov 2 07:47:33 2026
64605 64606 64604
100.64.5.133 from 100.64.5.133 (100.64.5.1)
Origin IGP, valid, external
Last update: Mon Nov 2 07:47:09 2026r2 llega a r4 a través de r1, que es su cliente. Y r4 llega a r2 de la
misma forma. El tráfico real lo confirma:
traceroute to 100.64.4.1 (100.64.4.1) from 100.64.2.1, 30 hops max, 46 byte packets
 1  100.64.2.130  0.012 ms
 2  100.64.4.1  0.003 ms
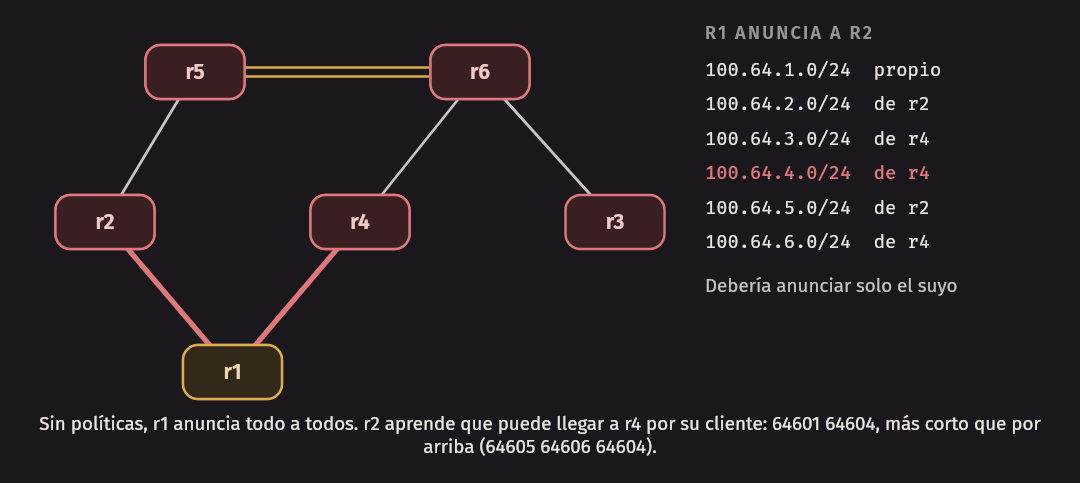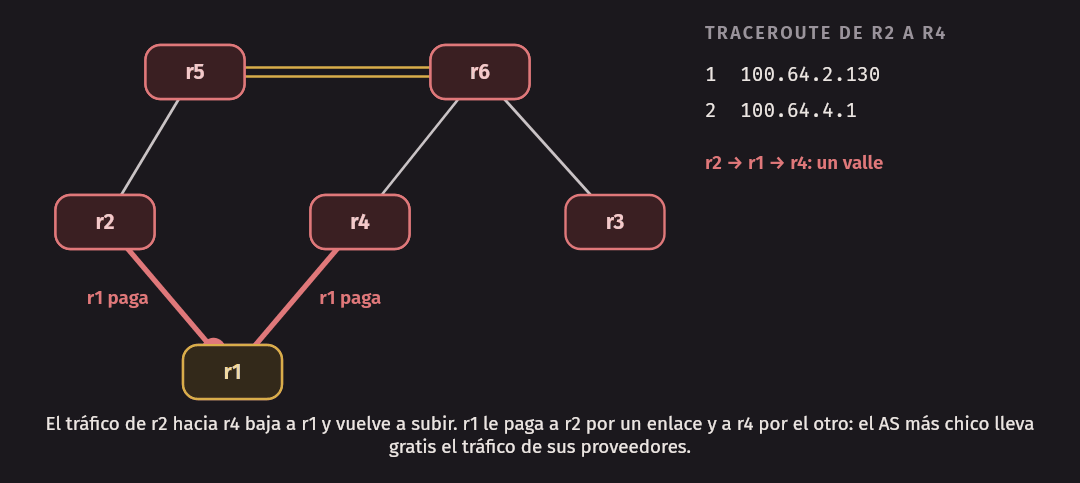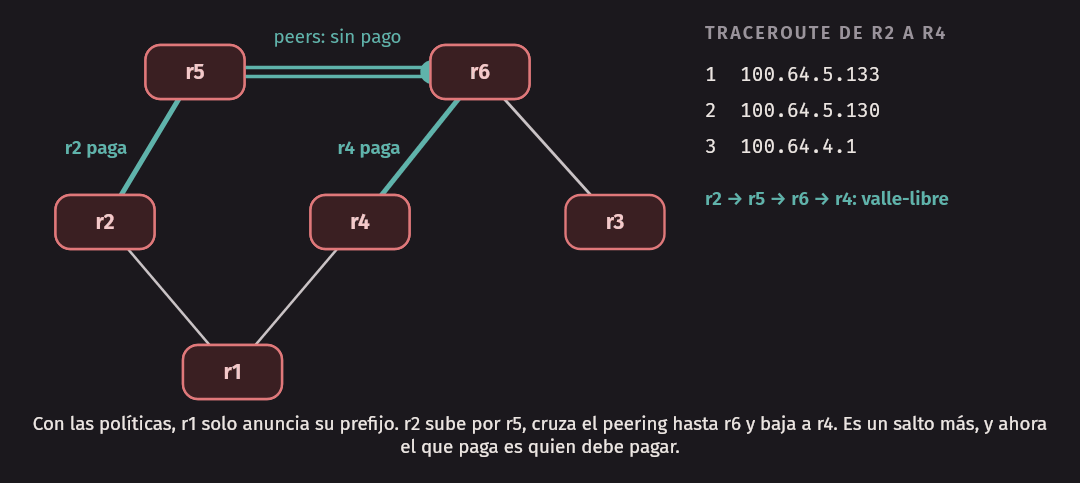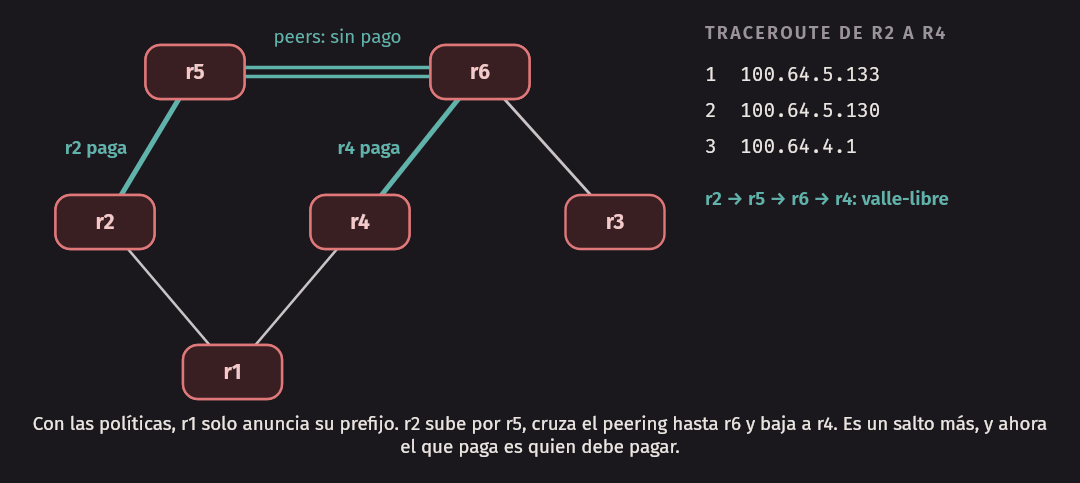
¿Por qué ocurre? Porque r1 les anuncia todo a todos:
docker exec clab-w06-ases-r1 vtysh -c 'show bgp ipv4 neighbors 100.64.2.129 advertised-routes' Network Next Hop Metric LocPrf Weight Path
*> 100.64.1.0/24 0.0.0.0 0 32768 i
*> 100.64.2.0/24 100.64.2.129 0 0 64602 i
*> 100.64.3.0/24 100.64.4.129 0 64604 64606 64603 i
* 100.64.3.0/24 100.64.2.129 0 64602 64605 64606 64603 i
*> 100.64.4.0/24 100.64.4.129 0 0 64604 i
*> 100.64.5.0/24 100.64.2.129 0 64602 64605 i
* 100.64.5.0/24 100.64.4.129 0 64604 64606 64605 i
*> 100.64.6.0/24 100.64.4.129 0 64604 64606 i
* 100.64.6.0/24 100.64.2.129 0 64602 64605 64606 i
Total number of prefixes 6Esta salida también muestra las filas *, que no son el mejor camino. Solo se le manda
al vecino la que tiene *>, una por prefijo: por eso el total dice 6, y no 9.
Hagamos las cuentas. Lo que r2 manda hacia r4 entra por el enlace r2–r1, y
r1 le paga a r2 por ese tráfico. Luego sale por el enlace r1–r4, y r1
también le paga a r4 por él. El AS más chico de la red está pagando dos veces para
llevar el tráfico entre sus dos proveedores, que no le dan nada a cambio. Y ese
enlace, con toda seguridad, no se dimensionó para eso, así que sus propios usuarios
también se quedan sin capacidad.
Nótese que BGP funcionó exactamente como se le pidió. No hubo ninguna falla ni ningún ataque: es una falta de política. El protocolo no sabe qué es un proveedor. Esta misma situación, cuando ocurre en la Internet real, se llama route leak. Volveremos a verla la próxima semana.
Caminos valle-libre
Dibujemos cada camino con el proveedor arriba y el cliente abajo. El de r2 a r4 es
el de arriba a la derecha:
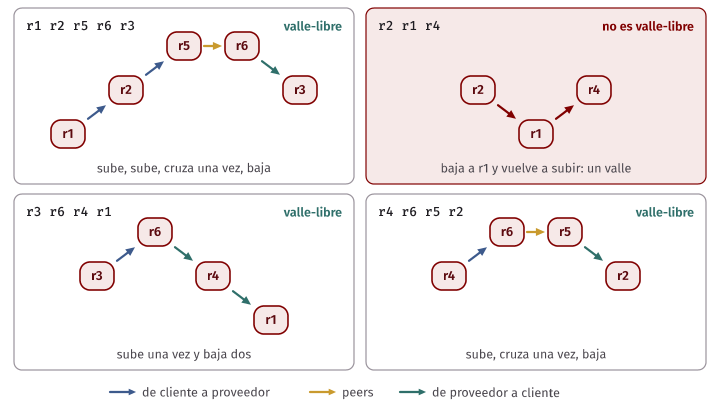
El tráfico baja a un cliente para volver a subir. A eso se le llama un valle, y las reglas de exportación existen para impedirlo. Formalmente, un camino de sistemas autónomos es valle-libre (valley-free) si se puede dividir en tres partes, en este orden:
- Cero o más enlaces de cliente a proveedor (subida).
- A lo sumo un enlace de peers.
- Cero o más enlaces de proveedor a cliente (bajada).
Todo camino permitido es una montaña: sube, quizás cruza una vez en la cima y baja. Los caminos prohibidos son los que tienen un valle (bajan y vuelven a subir), los que cruzan dos enlaces de peers, y los que suben después de un enlace de peers.
Las reglas de exportación garantizan esa forma. Si un AS recibe una ruta de un peer o proveedor (la ruta ya “bajó” o “cruzó”, vista desde el que anuncia), solo la manda a clientes, y por lo tanto el anuncio sigue bajando.
El archivo spvp.py tiene una función corta, is_valley_free, que aplica esta
definición a un AS_PATH sabiendo las relaciones de los seis AS. Las pruebas la
aplican a las tablas reales:
| Camino | ¿Valle-libre? | Por qué |
|---|---|---|
r1 r2 r5 r6 r3 |
Sí | Sube, sube, cruza una vez, baja |
r2 r1 r4 |
No | Baja de r2 a r1, y vuelve a subir a r4 |
r3 r6 r4 r1 |
Sí | Sube una vez y baja dos veces |
r4 r6 r5 r2 |
Sí | Sube, cruza una vez, baja |
Por qué estas reglas dan estabilidad
BGP no tiene un punto único que decida. Cada AS reacciona a lo que hacen los otros. ¿Quién garantiza que todas esas decisiones lleguen a un estado estable, en vez de cambiar para siempre?
Hay un resultado famoso de Gao y Rexford (2001). Si se cumplen tres condiciones, la red siempre converge a un estado estable, sin importar el orden en que los AS tomen sus decisiones:
- No hay ciclos de proveedores. Si a es proveedor de b y b de c, entonces c no es proveedor de a. El grafo de cliente a proveedor es acíclico.
- Importación. Cada AS prefiere rutas de clientes antes que de peers y proveedores.
- Exportación. Se cumple la tabla de la sección anterior.
Vale la pena sorprenderse: ninguna de las tres pide coordinación global. Cada operador las cumple porque le conviene económicamente, y la estabilidad de toda Internet sale como consecuencia.
Para ver que no es algo automático, spvp.py simula un vector de caminos en
miniatura. En cada turno, cada AS mira lo que ofrecen sus vecinos, descarta los
caminos que ya lo contienen y se queda con el que más le gusta. Se detiene si en una
vuelta completa nadie cambia, o si el estado se repite. El primer ejemplo tiene tres
AS y un destino 0, que es cliente de los tres. Hay un ciclo de proveedores: 1 es
proveedor de 2, 2 de 3, y 3 de 1. Cumple las reglas 2 y 3: las rutas que cada AS
prefiere vienen de clientes, y la regla 2 deja libre el orden entre clientes. Cada uno
prefiere pasar por su cliente del anillo antes que llegar directo.
python3 spvp.pyAnillo con un ciclo de proveedores:
vuelta 1: 1 0 2 0 3 1 0
vuelta 2: 1 2 0 2 3 1 0 3 1 2 0
vuelta 3: 1 0 2 0 3 1 0
repite un estado ya visto: en este orden no termina nunca
Anillo sin ciclo de proveedores:
vuelta 1: 1 0 2 0 3 0
vuelta 2: 1 2 0 2 3 0 3 0
vuelta 3: 1 3 0 2 3 0 3 0
vuelta 4: 1 3 0 2 3 0 3 0
estable
Seis AS con las reglas de Gao y Rexford (camino de cada uno hacia 64603):
64601: 64604 64606 64603
64602: 64605 64606 64603
64603: (origen)
64604: 64606 64603
64605: 64606 64603
64606: 64603
con 50 órdenes de activación al azar: 1 resultado distintoCada columna es el camino que usa un AS: 1, 2 y 3. Sigan el primer ejemplo. En la vuelta 1, 3 pasa por 1. En la vuelta 2, 1 quiere pasar por 2, y 2 por 3, y 3 por 1: cada uno está persiguiendo al siguiente. Pero cuando el camino de un vecino ya contiene al que pregunta, no lo puede usar y debe volver atrás. Los tres dan vueltas y nunca descansan. Una configuración de esta forma se conoce como bad gadget, por el trabajo de Griffin, Shepherd y Wilfong.
Al invertir un solo enlace del ciclo (1 pasa a ser proveedor de 3), las mismas
preferencias se estabilizan en pocas vueltas. Y los seis AS de nuestro laboratorio,
con las reglas completas, llegan al mismo resultado hacia 64603 con cada uno de los
50 órdenes al azar. Lo último es solo una comprobación en este ejemplo, no una
demostración. La demostración está en el artículo de Gao y Rexford.
Dos advertencias para quedarse con la idea correcta:
- Es una garantía condicional. Basta que un AS no cumpla para que se pierda. BGP no verifica nada: la próxima semana veremos qué ocurre.
- Estable no significa bueno. El resultado puede ser un camino largo, lento o caro para alguien. Las reglas aseguran que el sistema se detenga, no que se detenga en el mejor lugar.
Idea clave. Las reglas de importación y exportación no son solo una forma de ahorrar. Es lo que evita que BGP oscile, y que las rutas de Internet cambien sin parar.
Políticas en FRRouting
Pasemos a la herramienta. En FRRouting, una política de BGP se escribe con tres piezas.
Un route-map es un programa corto que se aplica a cada ruta, en una dirección de
una sesión. Se compone de entradas numeradas, y cada una tiene una acción, permit o
deny, sus condiciones match y sus cambios set:
route-map NOMBRE permit 10
 match <condición>
 set <cambio>
route-map NOMBRE permit 20
 match <otra condición>
Se evalúa de esta forma:
- Se recorren las entradas por número, de menor a mayor.
- Una entrada sin
matchaplica a todas las rutas. Si hay variosmatchdeben cumplirse todos. - En la primera entrada que aplica: si es
permit, se hacen lossety la ruta pasa; si esdeny, se bota. - Si ninguna aplica, la ruta se bota. Un
route-maptermina con undenyimplícito.
Una prefix-list es una lista de prefijos con la que un match puede preguntar
“¿es este prefijo?”. Una comunidad es una etiqueta de 32 bits, que se escribe
AS:valor, y sirve para recordar algo acerca de la ruta. Con bgp community-list se
le pone un nombre a un conjunto de comunidades para poder hacer match con ellas.
El route-map se aplica a un vecino, con una dirección:
router bgp 65300
 address-family ipv4 unicast
  neighbor 100.64.130.130 route-map FROM_Q in
in es lo que entra desde ese vecino, antes de la elección del mejor camino: es la
política de importación. out es lo que se le va a anunciar: es la exportación. Un
vecino tiene a lo sumo un route-map por dirección.
Un ejemplo, pieza por pieza
Para aprender cada pieza por separado, usamos la tercera topología, en poli/. Tiene
un AS mediano, m, con tres vecinos. Va a ser un ejemplo: no vamos a escribir
aquí todas las reglas. Eso es el laboratorio.
      p (65310) ---- q (65320)        q también es cliente de p
        |  proveedor  /  peer
        |            /
        +--- m (65300)
              |  cliente
             c (65330)
Prefijos: m, 100.64.130.0/24; p, 100.64.131.0/24; q, 100.64.132.0/24; c,
100.64.133.0/24. Al inicio no hay políticas:
make up-poli
docker exec clab-w06-poli-m vtysh -c 'show bgp ipv4'
Network Next Hop Metric LocPrf Weight Path
*> 100.64.130.0/24 0.0.0.0 0 32768 i
*> 100.64.131.0/24 100.64.131.129 0 0 65310 i
* 100.64.130.130 0 65320 65310 i
*> 100.64.132.0/24 100.64.130.130 0 0 65320 i
* 100.64.131.129 0 65310 65320 i
*> 100.64.133.0/24 100.64.130.134 0 0 65330 i
Displayed 4 routes and 6 total pathsHacia 100.64.131.0/24, m va directo a su proveedor p, porque el camino es más
corto. Pero el camino por su peer q le saldría gratis.
Paso 1, local-preference. Este es el archivo poli/step1_localpref.conf:
! Paso 1, en m: lo que llega de q vale más que el valor por defecto (100).
route-map FROM_Q permit 10
 set local-preference 150
router bgp 65300
 address-family ipv4 unicast
  neighbor 100.64.130.130 route-map FROM_Q in
 exit-address-family
La configuración se puede cargar en un router que ya está corriendo. vtysh -f lee un
archivo que esté dentro del nodo, así que primero se copia:
docker cp poli/step1_localpref.conf clab-w06-poli-m:/tmp/s.conf
docker exec clab-w06-poli-m vtysh -f /tmp/s.conf
docker exec clab-w06-poli-m vtysh -c 'show bgp ipv4 100.64.131.0/24'
BGP routing table entry for 100.64.131.0/24, version 7
Paths: (2 available, best #1, table default)
Advertised to non peer-group peers:
100.64.130.130 100.64.130.134 100.64.131.129
65320 65310
100.64.130.130 from 100.64.130.130 (100.64.132.1)
Origin IGP, localpref 150, valid, external, best (Local Pref)
Last update: Mon Nov 2 07:49:42 2026
65310
100.64.131.129 from 100.64.131.129 (100.64.131.1)
Origin IGP, metric 0, valid, external
Last update: Mon Nov 2 07:49:14 2026Un camino de dos AS le gana a uno de un AS, y el router lo explica: best (Local Pref). LOCAL_PREF no sale del AS. Desde c, que es otro AS, este es el camino que
m anuncia, sin rastro de la preferencia:
BGP routing table entry for 100.64.131.0/24, version 11
Paths: (1 available, best #1, table default)
  Advertised to non peer-group peers:
  100.64.130.133
  65300 65320 65310
    100.64.130.133 from 100.64.130.133 (100.64.130.1)
      Origin IGP, valid, external, best (First path received)
      Last update: Mon Nov  2 07:49:37 2026
En la práctica. Mientras un
route-maprecién cargado se aplica a lo que ya está en la tabla, pueden ver por unos segundos la letraS(stale) en vez de*enshow bgp ipv4: FRRouting le pidió al vecino que le vuelva a mandar sus rutas. Espérense un momento. Si un cambio no parece tener efecto,clear bgp ipv4 * softpide reprocesar todo sin tumbar las sesiones.
Paso 2, comunidades. Queremos recordar de dónde vino una ruta. Una vez en la
tabla, el AS_PATH no dice qué tipo de vecino era: 65330 es solo un número. La
forma habitual es poner una etiqueta al entrar, y leerla al salir:
! Paso 2, en m: lo que llega de c se marca con una comunidad.
route-map FROM_C permit 10
 set community 65300:30
router bgp 65300
 address-family ipv4 unicast
  neighbor 100.64.130.134 route-map FROM_C in
 exit-address-family
BGP routing table entry for 100.64.133.0/24, version 9
Paths: (1 available, best #1, table default)
Advertised to non peer-group peers:
100.64.130.130 100.64.130.134 100.64.131.129
65330
100.64.130.134 from 100.64.130.134 (100.64.133.1)
Origin IGP, metric 0, valid, external, best (First path received)
Community: 65300:30
Last update: Mon Nov 2 07:49:55 2026El valor 30 no significa nada para BGP: el significado lo pone el operador. Y a
diferencia de LOCAL_PREF, una comunidad sí viaja a otros AS. Este es p, que
recibió la ruta con la etiqueta:
  65300 65330
    100.64.131.130 from 100.64.131.130 (100.64.130.1)
      Origin IGP, valid, external, best (AS Path)
      Community: 65300:30
      Last update: Mon Nov  2 07:49:50 2026
Por eso conviene que set community, sin más opciones, reemplace las que traía la
ruta: un vecino no debería poder meterse en la lógica interna de otro AS mandando una
comunidad con su número. Para agregar sin borrar existe la palabra additive.
Paso 3, exportación. Ahora usamos la etiqueta. Hacia su proveedor, m solo debe
mandar su prefijo y lo de su cliente:
! Paso 3, en m: hacia p salen el prefijo propio y lo marcado en el paso 2.
ip prefix-list MINE seq 5 permit 100.64.130.0/24
bgp community-list standard TAGGED_C permit 65300:30
route-map TO_P permit 10
 match ip address prefix-list MINE
route-map TO_P permit 20
 match community TAGGED_C
router bgp 65300
 address-family ipv4 unicast
  neighbor 100.64.131.129 route-map TO_P out
 exit-address-family
Dos entradas, cada una con un permit, y todo lo demás cae en el deny implícito.
Antes de esto, m le anunciaba a p hasta la ruta de su peer q. Después:
docker exec clab-w06-poli-m vtysh -c 'show bgp ipv4 neighbors 100.64.131.129 advertised-routes' Network Next Hop Metric LocPrf Weight Path
*> 100.64.130.0/24 0.0.0.0 0 32768 i
*> 100.64.133.0/24 100.64.130.134 0 0 65330 i
Total number of prefixes 2Y desde p, ya no existe el camino a q que pasaba por m:
     Network          Next Hop            Metric LocPrf Weight Path
 *>  100.64.130.0/24  100.64.131.130           0             0 65300 i
 *                    100.64.131.134                         0 65320 65300 i
 *>  100.64.131.0/24  0.0.0.0                  0         32768 i
 *>  100.64.132.0/24  100.64.131.134           0             0 65320 i
 *>  100.64.133.0/24  100.64.131.130                         0 65300 65330 i
 *                    100.64.131.134                         0 65320 65300 65330 i

Displayed 4 routes and 6 total paths
Para ver cuántas veces se usó cada entrada, sirve show route-map TO_P. Y show bgp ipv4 community 65300:30 lista las rutas que tienen esa etiqueta.
¿Por qué una comunidad, y no una prefix-list con los prefijos de c? Porque una
lista hay que mantenerla a mano en cada router, y cuando el cliente tiene su propio
cliente se queda corta. La comunidad se pone una vez, en el borde donde se conoce la
relación, y sirve en todas las sesiones de salida.
Error común. Olvidar el
denyimplícito. Unroute-mapque no deja pasar nada deja la sesión arriba y no anuncia nada, sin ningún error. También se bota todo si el nombre está mal escrito. Lo probamos enm, con un nombre que no existe:The route-map 'TYPO_NAME' does not exist. Neighbor V AS MsgRcvd MsgSent TblVer InQ OutQ Up/Down State/PfxRcd PfxSnt Desc 100.64.130.130 4 65320 26 32 9 0 0 00:01:09 2 0 N/A 100.64.130.134 4 65330 35 37 9 0 0 00:00:49 1 4 N/A 100.64.131.129 4 65310 12 18 9 0 0 00:01:09 2 2 N/A
PfxSnten 0 para100.64.130.130. Si una sesión está enEstablishedy el vecino no recibe nada, miren primero susroute-mapy susshow bgp ipv4 neighbors ... advertised-routes.
Lo que debe pasar con las políticas puestas
Ahora les toca a ustedes. El paso 4 del laboratorio es escribir el conjunto
completo de políticas para los seis AS, en lab/r1.conf a lab/r6.conf, con lo que
acabamos de ver. Cada AS marca cada ruta según su origen, le da su preferencia y
filtra lo que exporta. Aquí no está la configuración, pero sí está lo que deben
observar cuando funcione, para que puedan comprobarlo. Como todos los AS comparten el
mismo esquema, el trabajo está en entenderlo para uno y aplicarlo a los otros.
El AS chico ya no le anuncia nada ajeno a sus proveedores:
docker exec clab-w06-ases-r1 vtysh -c 'show bgp ipv4 neighbors 100.64.2.129 advertised-routes' Network Next Hop Metric LocPrf Weight Path
*> 100.64.1.0/24 0.0.0.0 0 32768 i
Total number of prefixes 1Y el caso del tránsito gratis se resolvió. El camino de r2 a r4 ahora pasa por
arriba, y es valle-libre:
traceroute to 100.64.4.1 (100.64.4.1) from 100.64.2.1, 30 hops max, 46 byte packets
 1  100.64.5.133  0.007 ms
 2  100.64.5.130  0.002 ms
 3  100.64.4.1  0.002 ms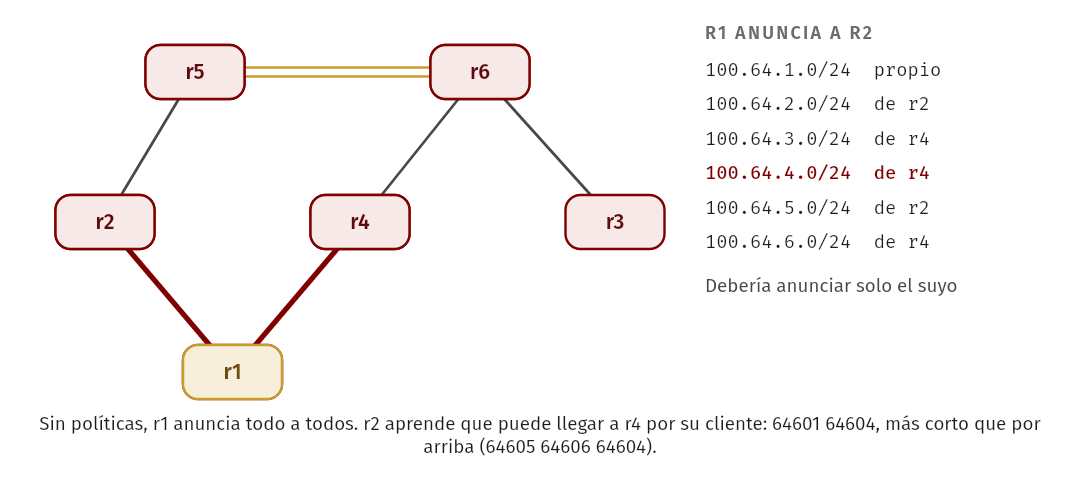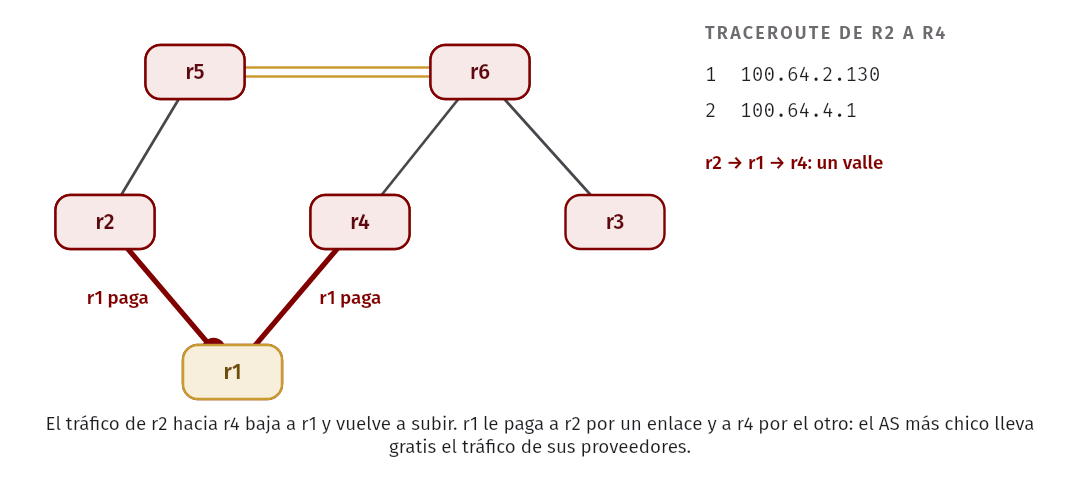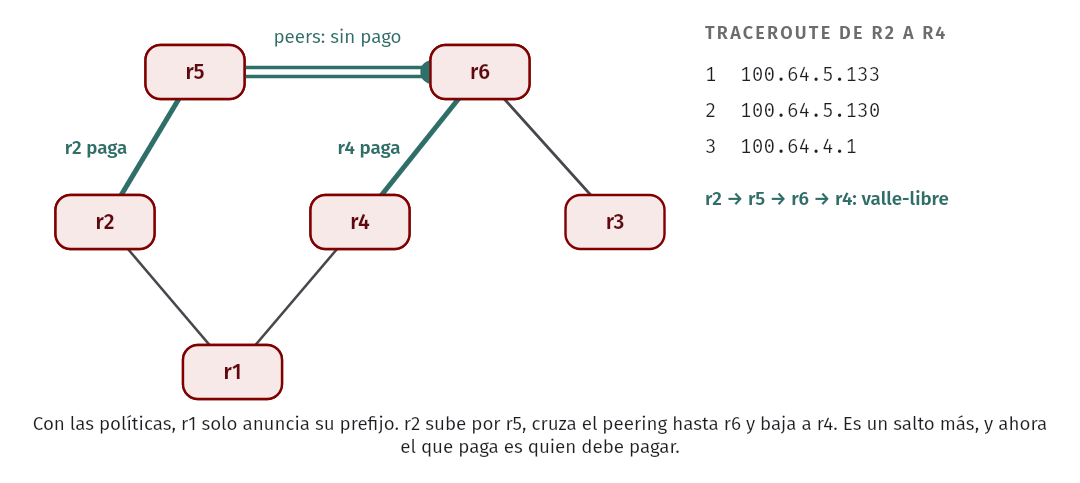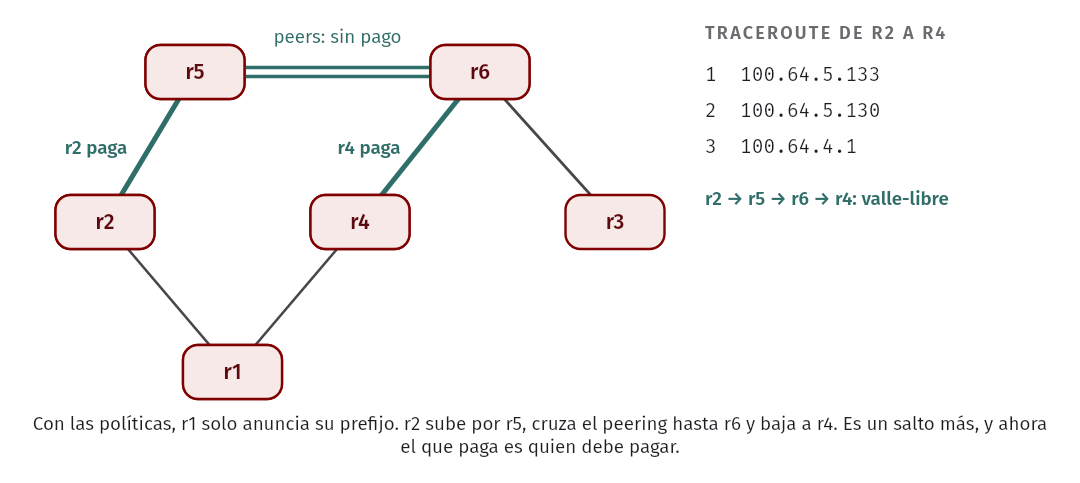
Es más largo. A la red en su conjunto le toma un salto más, y es lo correcto: ahora el
que paga es quien debe pagar. Veamos el criterio de importación en r6, que conoce
100.64.1.0/24 de dos formas. Esta tabla viene de una solución con valores 300, 200 y
100. Los valores de ustedes pueden ser otros:
BGP routing table entry for 100.64.1.0/24, version 15
Paths: (2 available, best #1, table default)
  Advertised to non peer-group peers:
  100.64.5.129 100.64.6.130 100.64.6.134
  64604 64601
    100.64.6.130 from 100.64.6.130 (100.64.4.1)
      Origin IGP, localpref 300, valid, external, best (Local Pref)
      Community: 64606:100
      Last update: Mon Nov  2 07:47:54 2026
  64605 64602 64601
    100.64.5.129 from 100.64.5.129 (100.64.5.1)
      Origin IGP, localpref 200, valid, external
      Community: 64606:200
      Last update: Mon Nov  2 07:47:53 2026
Ganó por Local Pref y no por el largo: el camino de cliente habría ganado aunque
fuera más largo. test_lab.py hace una comprobación más: los mejores caminos de los
seis routers hacia los seis prefijos deben coincidir con lo que predice spvp.py con
las reglas de Gao y Rexford, y todos deben ser valle-libres.
Preferir un proveedor
El paso 5 es para r1, el AS con dos proveedores. Con las políticas puestas, los
dos proveedores valen lo mismo, y r1 llega a h3 por el más corto:
traceroute to 100.64.3.10 (100.64.3.10), 30 hops max, 46 byte packets
 1  100.64.1.1  0.004 ms
 2  100.64.4.129  0.002 ms
 3  100.64.6.129  0.002 ms
 4  100.64.6.134  0.001 ms
 5  100.64.3.10  0.002 ms
Supongamos que el contrato con r2 es más barato. r1 debería preferirlo siempre que
pueda, aunque el camino sea más largo. Con un LOCAL_PREF mayor en lo que entra desde
r2:
BGP routing table entry for 100.64.3.0/24, version 27
Paths: (2 available, best #1, table default)
  Not advertised to any peer
  64602 64605 64606 64603
    100.64.2.129 from 100.64.2.129 (100.64.2.1)
      Origin IGP, localpref 120, valid, external, best (Local Pref)
      Community: 64601:300
      Last update: Mon Nov  2 07:48:01 2026
  64604 64606 64603
    100.64.4.129 from 100.64.4.129 (100.64.4.1)
      Origin IGP, localpref 100, valid, external
      Community: 64601:300
      Last update: Mon Nov  2 07:47:52 2026
traceroute to 100.64.3.10 (100.64.3.10), 30 hops max, 46 byte packets
1 100.64.1.1 0.005 ms
2 100.64.2.129 0.003 ms
3 100.64.5.133 0.002 ms
4 100.64.6.129 0.002 ms
5 100.64.6.134 0.001 ms
6 100.64.3.10 0.005 msUn salto más, y por el proveedor que r1 quería. Ahora miren el traceroute de
vuelta, desde h3:
traceroute to 100.64.1.10 (100.64.1.10), 30 hops max, 46 byte packets
 1  100.64.3.1  0.006 ms
 2  100.64.6.133  0.002 ms
 3  100.64.6.130  0.002 ms
 4  100.64.2.130  0.001 ms
 5  100.64.1.10  0.003 ms
Atención: el salto 4 es 100.64.2.130, una dirección del enlace r1–r2. Aun así,
ese paquete no llegó por r2. Vino de r4 (100.64.6.130 es la dirección de r4) y
entró a r1 por la otra interfaz. Es que r1 responde al ICMP con una dirección
suya, y no necesariamente con la de la interfaz por la que entró el paquete: la elige
según por dónde va a salir la respuesta, que ahora es hacia r2. Y r2 no estuvo en
el camino de ida de ese traceroute. Lo que dice el AS_PATH en r6 y lo que
muestra el salto 3 coinciden: entró por r4.
Idea clave.
LOCAL_PREFcontrola por dónde sale el tráfico de mi AS, y nada más. Por dónde entra lo decide el que manda, con sus propias preferencias. Un AS tiene un control total de su salida, y solo puede hacer sugerencias para su entrada: un MED hacia un vecino, anuncios de prefijos más específicos, o repetir su número en elAS_PATHpara alargar el camino que no quiere (AS path prepending, ejercicio 8).
Si se cae el enlace con r2, se retiran las rutas y el tráfico pasa solo al otro
proveedor, sin que nadie toque nada:
docker exec clab-w06-ases-r1 ip link set eth2 down
docker exec clab-w06-ases-h1 traceroute -n -w 1 -q 1 100.64.3.10
traceroute to 100.64.3.10 (100.64.3.10), 30 hops max, 46 byte packets
1 100.64.1.1 0.004 ms
2 100.64.4.129 0.001 ms
3 100.64.6.129 0.004 ms
4 100.64.6.134 0.002 ms
5 100.64.3.10 0.002 msY al volver el enlace, el tráfico vuelve a r2.
Anycast
Hasta ahora, un prefijo tiene un solo owner. Nada en BGP impide que dos AS anuncien el mismo prefijo. De hecho, si uno lo hace sin permiso es un hijack, y lo veremos la próxima semana. Si lo hacen de común acuerdo, es una técnica muy útil.
Anycast es asignar la misma dirección IP a varios servidores en lugares distintos, y dejar que el routing lleve cada paquete a uno de ellos, normalmente el más cercano según BGP. El cliente no se entera: ve una sola dirección. Se usa mucho en:
- DNS. Los servidores raíz usan anycast: cada letra (
aam) es una dirección, y detrás hay muchas instancias en todo el mundo. - CDN. Un usuario llega a la instancia cercana, sin pasar por una redirección de DNS.
- Defensa contra DoS. Un ataque distribuido se reparte entre las instancias, en lugar de caer todo en un solo lugar.
El script ases/anycast.sh prende una instancia en un router: le agrega la dirección
100.64.200.1 a su loopback, levanta un pequeño servicio que responde con el nombre
del router y anuncia 100.64.200.0/24. Lo prendemos en r2 y en r6, sin políticas:
ases/anycast.sh r2 64602 on
ases/anycast.sh r6 64606 on
docker exec clab-w06-ases-h1 sh -c 'nc -w 2 100.64.200.1 5300 </dev/null'
docker exec clab-w06-ases-h3 sh -c 'nc -w 2 100.64.200.1 5300 </dev/null'
r2
r6Misma dirección, dos respuestas. h1 está junto a r2, y h3 está junto a r6. ¿Y
r5, que queda a la misma distancia de los dos?
BGP routing table entry for 100.64.200.0/24, version 11
Paths: (2 available, best #1, table default)
  Advertised to non peer-group peers:
  100.64.5.130 100.64.5.134
  64602
    100.64.5.134 from 100.64.5.134 (100.64.2.1)
      Origin IGP, metric 0, valid, external, best (Older Path)
      Last update: Mon Nov  2 07:47:38 2026
  64606
    100.64.5.130 from 100.64.5.130 (100.64.6.1)
      Origin IGP, metric 0, valid, external
      Last update: Mon Nov  2 07:47:38 2026
Decide un desempate, el más antiguo: los dos caminos son iguales en todo lo que importa. “Cercano” significa cercano para BGP, con todos los criterios y políticas de antes. Puede no ser cercano en kilómetros ni en milisegundos.
Si se apaga una instancia, su ruta se retira y sus clientes pasan solos a la otra:
ases/anycast.sh r2 64602 off
docker exec clab-w06-ases-h1 sh -c 'nc -w 2 100.64.200.1 5300 </dev/null'r6Error común. Creer que anycast sirve igual para todo. Si durante una conexión TCP cambia la ruta, los paquetes siguientes llegan a otra instancia, que no conoce esa conexión y la corta. Por eso se popularizó primero en DNS sobre UDP, donde una consulta es un solo paquete. En CDN funciona bien porque en la práctica las rutas cambian poco durante una conexión corta, pero no es una garantía.
Cómo llega una organización a Internet
Armemos todas las piezas con un caso. Una empresa nueva en Lima quiere publicar un servicio web y no depender de un solo proveedor. ¿Qué necesita?
- Direcciones. Un bloque de direcciones públicas. Hay dos caminos: pedirlas a su proveedor (son del proveedor, y hay que devolverlas si se cambia de proveedor), o solicitar un bloque propio al registro regional, que para América Latina es LACNIC. En IPv4, los bloques nuevos son muy difíciles de conseguir y a menudo se compran a otros.
- Un número de AS. Sirve si la empresa tendrá políticas propias, como dos proveedores. También lo asigna el registro. Si tiene un solo proveedor, por lo general no hace falta: el proveedor anuncia sus direcciones dentro de su propio agregado.
- Conexión con proveedores. Contrata uno o más, y abre una sesión eBGP con cada
uno. Aquí aplica lo que hicimos con
r1: anunciar solo lo propio, y nunca dar transit entre proveedores. Los proveedores, a su vez, filtran lo que aceptan de ese cliente. - Red interna. OSPF dentro, iBGP entre los routers de borde si hay más de uno, y NAT o direcciones públicas según lo que se vaya a publicar. Es el P1 de ustedes.
- DNS. Tener direcciones no es tener un nombre. La empresa registra su dominio, y el registrador deja en los servidores del dominio superior un registro NS que apunta a sus servidores de nombres, junto con sus direcciones. En esos servidores de nombres, un registro A apunta al servidor web. Veremos DNS en detalle más adelante en el curso.
En Kurose y Ross esto es la sección 5.4.6: ninguna pieza es nueva. Pero notar cómo se enlazan es útil. Sin DNS no te encuentran. Sin BGP, aunque te encuentren no te alcanzan. Sin OSPF, el paquete no atraviesa tu propia red. Y sin direcciones no hay nada que anunciar.
El laboratorio de la semana y make test
Todo se hace en code/week-06/, dentro del contenedor del curso.
code/week-06/
  ases/ases.clab.yml     los seis AS, sin políticas; base del laboratorio
  ases/anycast.sh        prende o apaga una instancia anycast
  ibgp/ibgp.clab.yml     un AS con cuatro routers, OSPF e iBGP
  ibgp/nhs_b1.conf ...   next-hop-self en los bordes; med_x.conf para MED
  poli/poli.clab.yml     el ejemplo de route-map, local-preference y comunidades
  poli/step1...conf      los tres pasos del ejemplo
  spvp.py                simulador de vector de caminos y comprobación de valle-libre
  lab/                   sus respuestas: r1.conf ... r6.conf y prefer.conf
Paso 1, una sesión. make up-ases. Con show bgp summary, sigan una sesión hasta
Established. Apáguenla con neighbor ... shutdown, empiecen a capturar y vuelvan a
prenderla. Encuentren en la captura el OPEN y un UPDATE, como en la Sesión A. Copien
el archivo con docker cp y ábranlo en Wireshark, con el filtro bgp. No suban los
.pcap al repositorio: se generan.
Paso 2, leer un AS_PATH. Desde r5, lean la ruta a 100.64.3.0/24 con show bgp ipv4. ¿Cuántos AS cruza? ¿Quién la originó? ¿Por dónde saldría el paquete?
Paso 3, tránsito gratis. Sin tocar nada, encuentren el AS que da transit gratis a
sus dos proveedores. Muestren el AS_PATH y el traceroute que lo prueban, y
expliquen quién paga cada enlace.
Paso 4, políticas. Completen lab/r1.conf a lab/r6.conf. Cada archivo trae el
AS, sus vecinos y su relación con cada uno. Con route-map, marquen cada ruta con una
comunidad según su origen, ordenen las preferencias con local-preference y filtren
lo que sale. Carguen todo y comprueben lo que describe la sección anterior:
make policies
docker exec clab-w06-ases-r2 vtysh -c 'show bgp ipv4'
Paso 5, preferir un proveedor. Completen lab/prefer.conf para que r1 prefiera
a r2. Un vecino admite un solo route-map de entrada, así que deben seguir marcando
la ruta. Cárguenlo con make prefer, y compruébenlo con traceroute desde h1.
Paso 6, los proyectos. Entreguen P1 y lean el enunciado de P2.
En la práctica. P2 les pide algo parecido en otra escala: su AS tiene varios routers, otros vecinos y reglas adicionales. Lo que hagan en
lab/no se puede copiar tal cual, pero sí les va a servir la forma de razonar.
Cuando terminen un archivo de lab/, borren su línea TODO. Las pruebas que dependen
de esos archivos se saltan, con un mensaje, hasta que estén todos.
make test levanta las tres topologías, una tras otra, y comprueba lo que dice este
capítulo:
make test # dentro del contenedor; tarda poco más de un minutotest_every_session_is_established (test_ases.A_Sessions.test_every_session_is_established) ... ok
test_each_router_goes_to_its_closest_exit (test_ibgp.B_HotPotato.test_each_router_goes_to_its_closest_exit) ... ok
setUpModule (test_lab) ... skipped 'falta completar lab/r1.conf'
test_local_pref_beats_a_shorter_as_path (test_poli.B_LocalPref.test_local_pref_beats_a_shorter_as_path) ... ok
test_provider_cycle_with_free_ranking_never_settles (test_spvp.Convergence.test_provider_cycle_with_free_ranking_never_settles) ... ok
...
----------------------------------------------------------------------
Ran 49 tests in 65.683s
OK (skipped=1)Eso es lo que verán mientras lab/ siga con su TODO. Cuando lo completen, se
agregan las pruebas de test_lab.py. Esas pruebas miran comportamientos, no sus
valores: local-preference y comunidades pueden tener otros números. Al terminar,
pase lo que pase, make test destruye sus topologías. Si levantan algo a mano, make down lo limpia. Para reiniciar desde cero, destruyan y vuelvan a levantar: las
políticas cargadas no se guardan en los frr.conf.
Resumen
- Un sistema autónomo es una red bajo una misma administración y una misma política de routing. Dentro de un AS manda la eficiencia. Entre AS, manda la política.
- BGP es un protocolo de vector de caminos: cada AS anuncia prefijos con un
AS_PATH, le agrega su número al reenviar y descarta lo que ya lo contiene. No hay mapa global. - Una sesión es una conexión TCP al puerto 179, con cuatro mensajes: OPEN, UPDATE, KEEPALIVE y NOTIFICATION. Los anuncios valen hasta que se retiran o cae la sesión.
- eBGP es entre AS distintos, e iBGP dentro del mismo. iBGP no reenvía a iBGP
(por eso se usa malla completa o route reflectors) y no cambia el
NEXT_HOPsi no se pide connext-hop-self. OSPF sigue siendo el que lleva hasta los routers de borde. - Para elegir:
LOCAL_PREF, largo deAS_PATH,ORIGIN,MED, eBGP antes que iBGP, costo IGP y desempates. BGP no mide retardo. Hot potato es salir por la salida más cercana. - Cliente, proveedor y peer responden a quién le paga a quién. Importación: preferir cliente, luego peer, luego proveedor. Exportación: rutas de clientes y propias a todos; las de peers y proveedores, solo a clientes.
- Si se cumplen esas reglas, y no hay ciclos de proveedores, los caminos son valle-libres y BGP converge a un estado estable. Es una garantía condicional, no una propiedad del protocolo.
- En FRRouting, una política es un
route-mapaplicado coninuout, conmatch,sety undenyimplícito al final.local-preferenceordena la salida; las comunidades recuerdan de dónde vino una ruta;prefix-listnombra prefijos. - Anycast es anunciar el mismo prefijo desde varios lugares. “Cercano” significa cercano para BGP.
- Para aparecer en Internet hacen falta direcciones, a menudo un número de AS, proveedores, una red interna y DNS.
Ejercicios
- Sin correr nada, predigan el
AS_PATHque tiener5hacia100.64.4.0/24, en la red sin políticas y con políticas. Si cambia, expliquen por qué. Comprueben. - Respondan según las reglas: un AS recibe dos rutas al mismo prefijo, una de un
proveedor con
AS_PATHde largo 2 y otra de un cliente conAS_PATHde largo 5. ¿Cuál debería preferir, y qué configuración lo hace posible? ¿Y a quién puede anunciar cada una? - En una captura de una sesión, un router tiene un hold time de 180 s y el otro
propone 90 s. Busquen en la RFC 4271 qué valor usan. ¿Cada cuánto debería mandarse
un KEEPALIVE? Prueben a cambiarlo con
neighbor ... timers 30 90y confírmenlo enshow bgp neighbors. - En
ibgp/, sin cargarnext-hop-self, agreguen los enlaces de borde a OSPF. ¿Qué cambia enshow bgp ipv4deb2? ¿Qué desventaja tendría esta solución en un AS con cientos de vecinos? - Dibujen un camino que no sea valle-libre y que tenga un enlace de peers. Expliquen,
enlace por enlace, qué AS está perdiendo dinero. Comprueben su respuesta con
spvp.is_valley_free. - Expliquen la diferencia entre hot potato y cold potato. En la topología
ibgp, sixy65100tienen dos conexiones y ambos usan hot potato, ¿es simétrico el tráfico entre un host detrás deb2y uno detrás dex? Dibujen las dos direcciones. - Escriban en
spvp.pyuna red de cuatro AS que tenga un ciclo de proveedores y que aun así converja. ¿Contradice lo que dice este capítulo? Expliquen la diferencia entre “garantiza que converge” y “si no se cumple, no converge”. - Con las políticas puestas, hagan que
r1prefiera que el tráfico le entre porr4, repitiendo su número en elAS_PATHhaciar2conset as-path prepend 64601 64601. Comprueben desdeh3y desder5qué cambia y qué no. ¿Por quér2puede seguir usando el enlace directo conr1? - Con las políticas puestas, quiten en
r1solo elroute-mapde salida haciar4(no neighbor 100.64.4.129 route-map ... out). Antes de mirar, predigan qué camino elegiránr4yr6hacia100.64.5.0/24, recordando quélocal-preferencele dan a un cliente. Comprueben conshow bgp ipv4y contraceroutedesder6. ¿Qué AS paga de más? Comparen con la definición de route leak, y expliquen por qué la regla de importación empeora la situación en este caso. - Una organización tiene
100.64.200.0/24en anycast en tres ciudades y usa TCP. Expliquen qué le pasa a una descarga larga si una falla cambia el mejor camino de un usuario a otra ciudad. Propongan una forma de reducir ese riesgo y digan qué pierde con ella. - Un compañero aplica en su AS este
route-mapde exportación hacia un proveedor:route-map OUT deny 10, conmatch community FROM_PEER, y nada más. Dice que así bloquea las rutas de peers y deja pasar el resto. ¿Qué anuncia en realidad? Corríjanlo. Comprueben conadvertised-routes. - Más difícil. Lean el
route-mapde sur2del laboratorio. Supongan quer1empieza a anunciarle100.64.5.0/24, el prefijo de su proveedorr5, por error o a propósito. ¿Cuál ruta eliger2? ¿Por dónde va el tráfico der2haciar5? ¿Qué regla habría que agregar para impedirlo? (Es el tema de la próxima semana.)