
Apuntes · Capítulo 7Routing
Los problemas de BGP y la estructura de Internet
Los problemas de BGP y la estructura de Internet
La semana pasada configuramos BGP como si todos dijeran la verdad. Un AS anuncia un prefijo, sus vecinos lo aprenden, cada uno aplica sus políticas y se forman los caminos. Esta semana vemos qué pasa cuando alguien anuncia algo que no le corresponde, ya sea por mala intención o por un error de configuración. La sorpresa es incómoda: BGP no tiene una forma propia de comprobar lo que se le dice. Un router cree el anuncio, lo elige si le conviene y se lo cuenta a los demás.
En la Sesión A provocamos tres problemas en una red de laboratorio. Primero, un hijack del mismo prefijo, que engaña solo a una parte de la red. Después, un hijack con un prefijo más específico, que engaña a casi todos. Por último, un route leak, en el que un cliente chico termina llevando tráfico entre sus dos proveedores. Cada uno se compara con un incidente real: Pakistan Telecom y YouTube en 2008, y la fuga de junio de 2019. Luego vemos las defensas: filtros, límites de prefijos y RPKI, y lo que RPKI no protege. Cerramos con Facebook en octubre de 2021, una caída que no fue un ataque y en la que BGP hizo lo que le pidieron.
En la Sesión B miramos la Internet real: tránsito, peering, IXPs y cables submarinos, con un ojo puesto en el Perú. Medimos cuánto se acorta un camino con un IXP y terminamos con un repaso guiado para el examen parcial de la próxima semana.
Todo lo que se muestra en los laboratorios salió de dos topologías de Containerlab que ustedes pueden levantar. Los tiempos y las horas cambian en cada ejecución; los caminos y las decisiones, no. Los datos de los incidentes reales vienen de los informes enlazados en el texto, y cada uno se cita donde se usa.
Ruta de lectura.
Antes de clase (obligatorio, unos 15 a 20 minutos). Sesión A: BGP cree lo que le dicen, La red de esta sesión, Caso real: Pakistan Telecom y YouTube, 2008, la introducción de Route leak y, de RPKI: validar quién puede originar un prefijo, Las piezas. Sesión B: De la jerarquía a una red más plana y Qué es un IXP.
En clase. Sesión A: Con el mismo prefijo: un concurso de popularidad, Con un prefijo más específico: gana en todas partes, Cómo responde la víctima, Provocar la fuga, Defensas sin criptografía, Los tres resultados, RPKI en el laboratorio y Lo que RPKI no protege. Sesión B: Tránsito y peering: cuánto cuesta cada uno, Lo medimos, El caso del Perú y Repaso guiado para el parcial.
Después de clase. Repasen con el Resumen y los Ejercicios, y preparen El laboratorio de la semana y
make test. Opcional: Caso real: la fuga de junio de 2019, ¿Qué habría hecho RPKI en los casos reales?, Más allá del origen y Fallas que no son ataques: Facebook, octubre de 2021. Para profundizar, las lecturas del libro y las gratuitas de la semana:Este capítulo acompaña a Kurose y Ross, Computer Networking: A Top-Down Approach (9.ª ed.). Para la Sesión A, la sección 5.4.5 Routing Policy, el capítulo BGP Implementation and Issues de CS168 y la sección Prefix Filtering del RFC 7454. Complementarias: RFC 6480, infraestructura RPKI, y RFC 6811, validación de origen. Para la Sesión B, la sección 1.3.3 A Network of Networks y el capítulo Model for Inter-Domain Routing de CS168. El código de la semana está en
code/week-07/.
BGP cree lo que le dicen
Recordemos qué lleva un anuncio de BGP. Un UPDATE dice, en esencia: “a este
prefijo se llega por mí, y el camino es este AS_PATH”. El router que lo recibe
hace tres cosas:
- Descarta el anuncio si ve su propio número de AS en el
AS_PATH, porque habría un ciclo. - Le aplica su política de importación.
- Lo compara con las otras rutas al mismo prefijo y, si es la mejor, lo instala y lo reanuncia según su política de exportación.
Fíjense en lo que no aparece en esa lista. Nada en el protocolo comprueba estas dos cosas:
- Que el AS de origen tenga derecho a ese prefijo. El número al final del
AS_PATHes solo un número que alguien escribió. - Que el camino exista. El
AS_PATHlo arma cada AS al reenviar; quien lo recibe no tiene cómo verificarlo.
La sesión BGP corre sobre TCP entre dos routers que se configuran a mano, y se puede proteger para que nadie se meta en esa conversación. Pero eso protege al mensajero, no al mensaje. Un vecino legítimo, con una sesión impecable, puede anunciar cualquier cosa.
CS168 lo resume en su sección Issues with BGP: el protocolo no da garantías de seguridad propias, y un AS puede anunciar rutas que no puede cumplir para atraer tráfico. El resultado se llama prefix hijack. Además, hay otra clase de problema que no requiere mala intención: el route leak.
Idea clave. BGP es un sistema de confianza entre vecinos. Sus únicas defensas son las que cada AS decida configurar en sus propios routers. Por eso se dice que la seguridad de BGP es un problema de adopción: importa lo que hacen los demás, no solo lo que hace uno.
La red de esta sesión
Para ver todo esto en vivo usamos ocho sistemas autónomos, cada uno con un solo
router, en code/week-07/bgp/. Son una topología propia de esta semana: no
dependen de la de la semana 6, y se levantan por su cuenta.
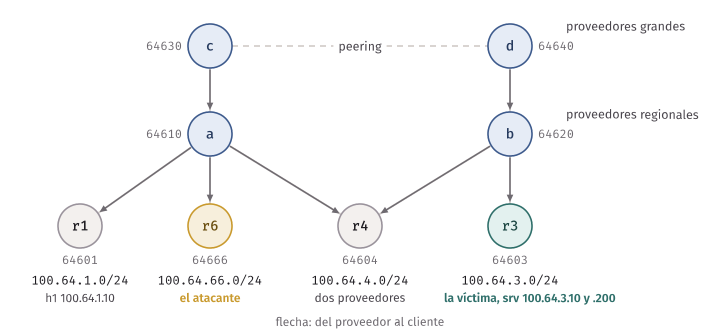
| Nodo | AS | Rol | Prefijo |
|---|---|---|---|
c, d |
64630, 64640 | Proveedores grandes, peers entre sí | ninguno |
a |
64610 | Proveedor de r1, r4 y r6; cliente de c |
ninguno |
b |
64620 | Proveedor de r3 y r4; cliente de d |
ninguno |
r1 |
64601 | Red con el host h1 (100.64.1.10) |
100.64.1.0/24 |
r3 |
64603 | La víctima, con el servidor srv (100.64.3.10 y 100.64.3.200) |
100.64.3.0/24 |
r4 |
64604 | Cliente con dos proveedores, a y b |
100.64.4.0/24 |
r6 |
64666 | El atacante, cliente de a |
100.64.66.0/24 |
Hay tres decisiones de diseño que conviene explicar:
- Nadie configura
local-preference. Todos los empates de la semana los resuelve el largo delAS_PATH, para que cada resultado se pueda predecir contando saltos. Sabemos por la semana 6 que en una red real manda primero la política: al final de cada caso discutimos qué cambia con ella. no bgp ebgp-requires-policysigue puesto, igual que al comienzo de la semana 6. Aquí queremos que todo se propague, para romperlo a propósito.r4tiene una regla de exportación: solo anuncia las rutas conAS_PATHvacío, es decir, las que origina él. Es la regla que va a perder más adelante.
Levanten la red, desde el contenedor del curso, y comprueben el punto de
partida. curl le pide una página al servidor que está en cada dirección; cada
uno de nuestros servidores contesta con una frase que dice quién es.
cd code/week-07
make up
$ docker exec clab-w07-bgp-h1 curl -s http://100.64.3.10:8080/
servidor legitimo de AS 64603
$ docker exec clab-w07-bgp-h1 traceroute -n -w 1 100.64.3.10
traceroute to 100.64.3.10 (100.64.3.10), 30 hops max, 46 byte packets
1 100.64.1.1 0.003 ms 0.002 ms 0.002 ms
2 10.207.4.2 0.001 ms 0.001 ms 0.003 ms
3 10.207.2.2 0.002 ms 0.003 ms 0.001 ms
4 10.207.1.2 0.001 ms 0.002 ms 0.003 ms
5 10.207.3.1 0.001 ms 0.002 ms 0.002 ms
6 10.207.8.1 0.001 ms 0.002 ms 0.002 ms
7 100.64.3.10 0.001 ms 0.002 ms 0.002 msEl camino sube por a y c, cruza el peering a d y baja por b hasta r3.
Los tiempos son casi cero porque todo corre en una sola computadora. Lo que nos
importa aquí es la lista de saltos. En la tabla de a (de aquí en adelante omitimos la
leyenda y las líneas de encabezado de estas salidas) se ve lo mismo en términos de sistemas autónomos:
$ docker exec clab-w07-bgp-a vtysh -c "show bgp ipv4 unicast"
     Network          Next Hop            Metric LocPrf Weight Path
 *>  100.64.1.0/24    10.207.4.1               0             0 64601 i
 *>  100.64.3.0/24    10.207.2.2                             0 64630 64640 64620 64603 i
 *>  100.64.4.0/24    10.207.6.1               0             0 64604 i
 *>  100.64.66.0/24   10.207.5.1               0             0 64666 i
Los escenarios de esta semana están en scenarios.py, y cada uno es una lista
corta de comandos que vale la pena leer. Se aplican con python3 scenarios.py <nombre>, y reset vuelve al estado inicial:
$ python3 scenarios.py
same             r6 origina el mismo /24 de la víctima y contesta en la dirección del servidor.
specific         r6 origina solo la mitad del /24 donde está el servidor: un /25.
forged           El /24 otra vez, pero con el AS de la víctima al final del AS_PATH.
forged_specific  El /25 con el origen forjado: aquí debería importar el largo máximo del ROA.
counter          r3 responde anunciando dos /25: más específicos que el /24 del atacante.
leak             r4 pierde su regla de exportación: cada proveedor recibe las rutas del otro.
slow_r4          r4 es una red chica: 5 ms y 20 Mbit/s por enlace. Sirve para ver el costo de la fuga.
max_prefix       Los proveedores de r4 toleran hasta dos prefijos en esa sesión; luego la cierran.
rov_a            Solo a, el proveedor del atacante, aplica validación de origen.
rov_a_lax        Como rov_a, pero con un ROA descuidado: el largo máximo de la víctima es 25.
rov_d            Solo d, en la cima y lejos del atacante, aplica validación de origen.
reset            vuelve al estado inicial
filters          carga sus filtros de lab/ en a y en b
Prefix hijack
Definición. Un prefix hijack ocurre cuando un AS origina una ruta hacia un prefijo que no le fue asignado, y otras redes la aceptan. El tráfico de esas redes hacia el prefijo termina en el AS equivocado.
El atacante tiene dos formas de competir, y se comportan de manera muy distinta.
Con el mismo prefijo: un concurso de popularidad
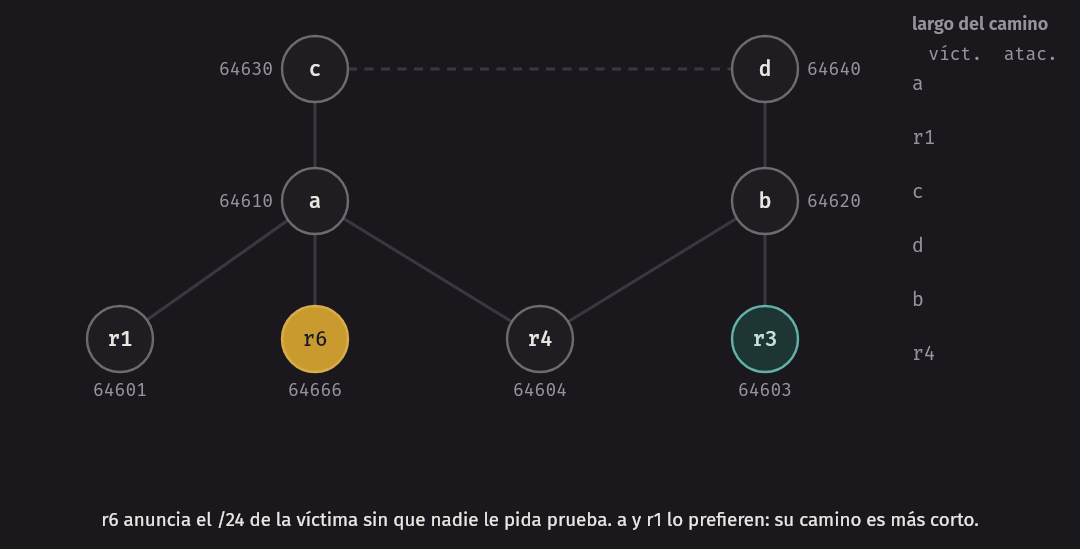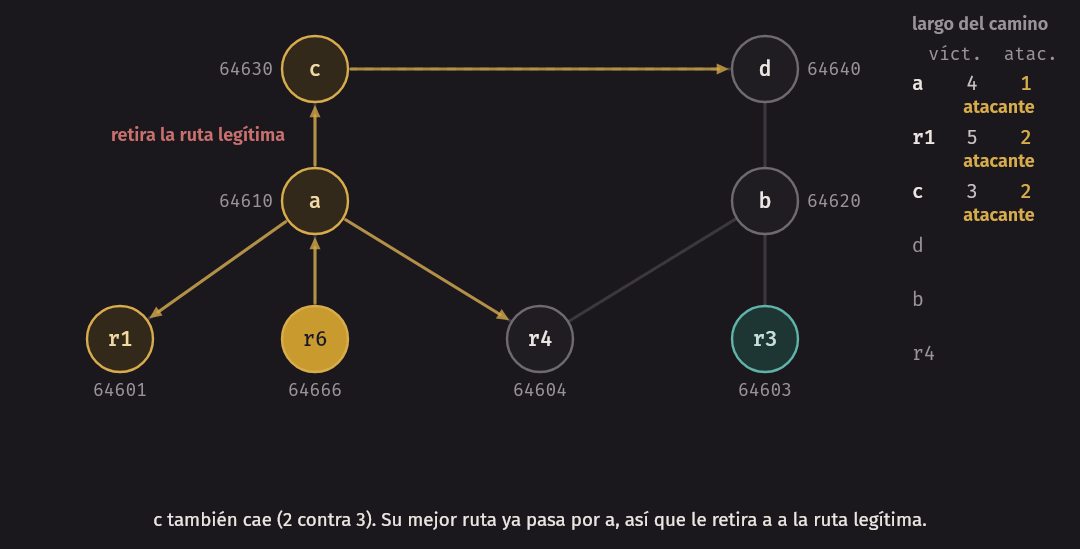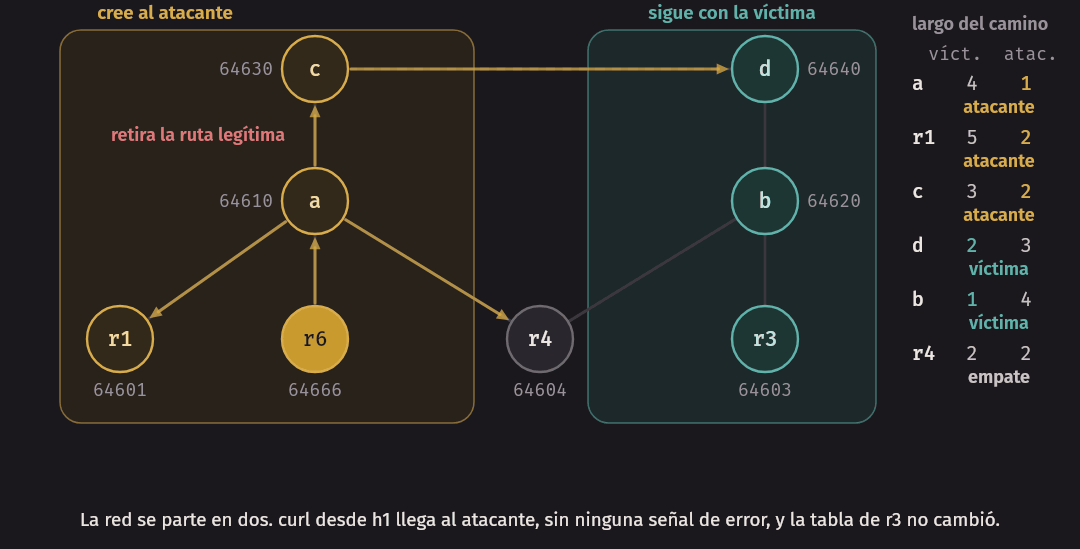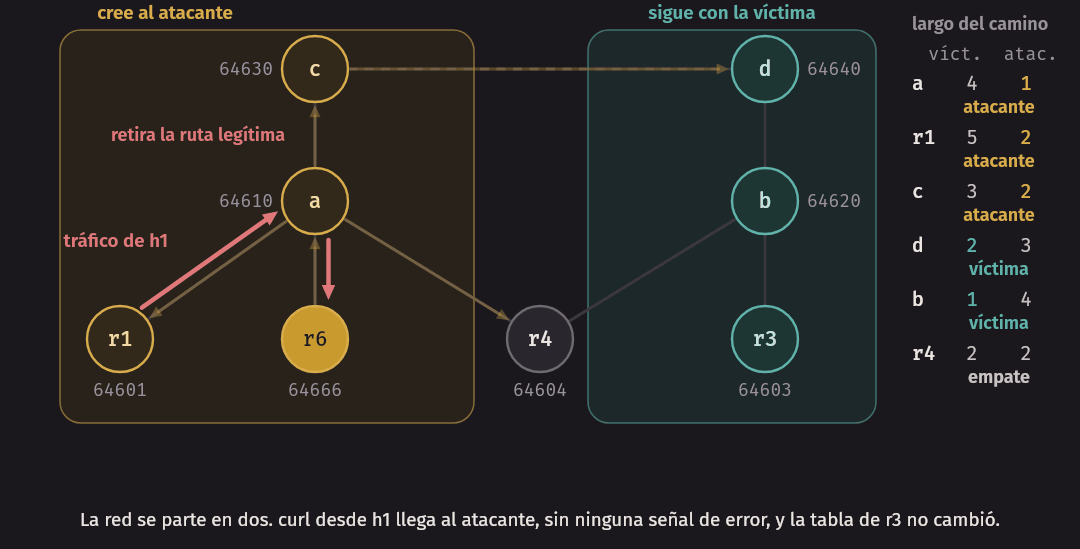
Si el atacante anuncia exactamente el mismo prefijo que la víctima, cada router tiene dos rutas al mismo destino y aplica su proceso de decisión normal. Cada AS se queda con la ruta que su política y el largo del camino le indiquen. No gana nadie en todas partes: la Internet se parte en dos, según quién quede más cerca de quién.
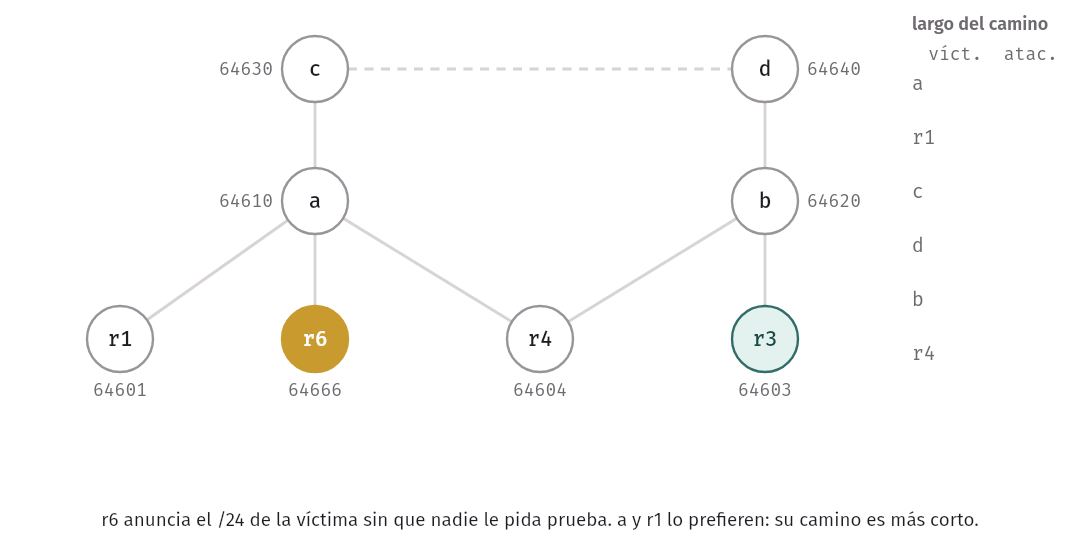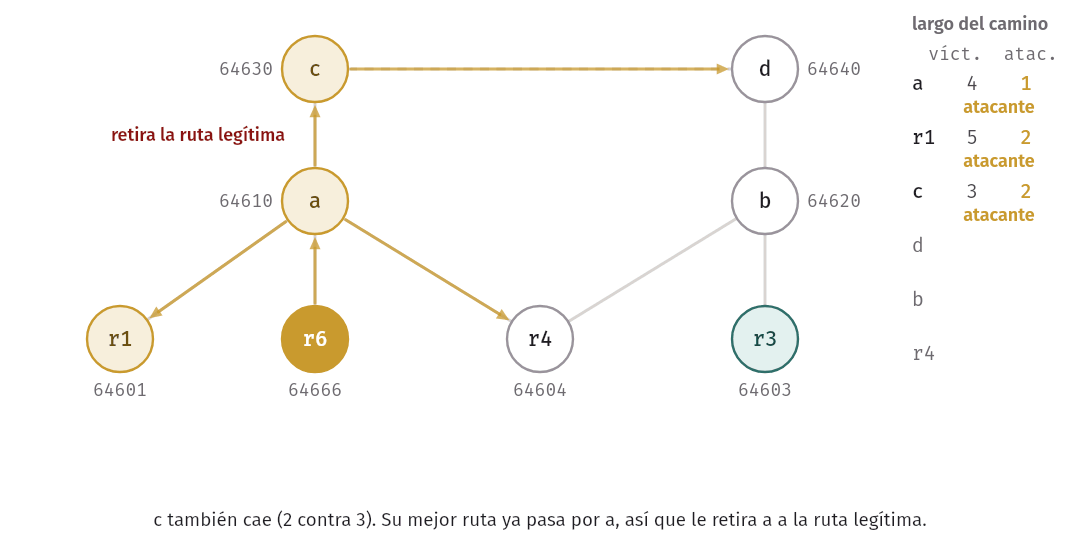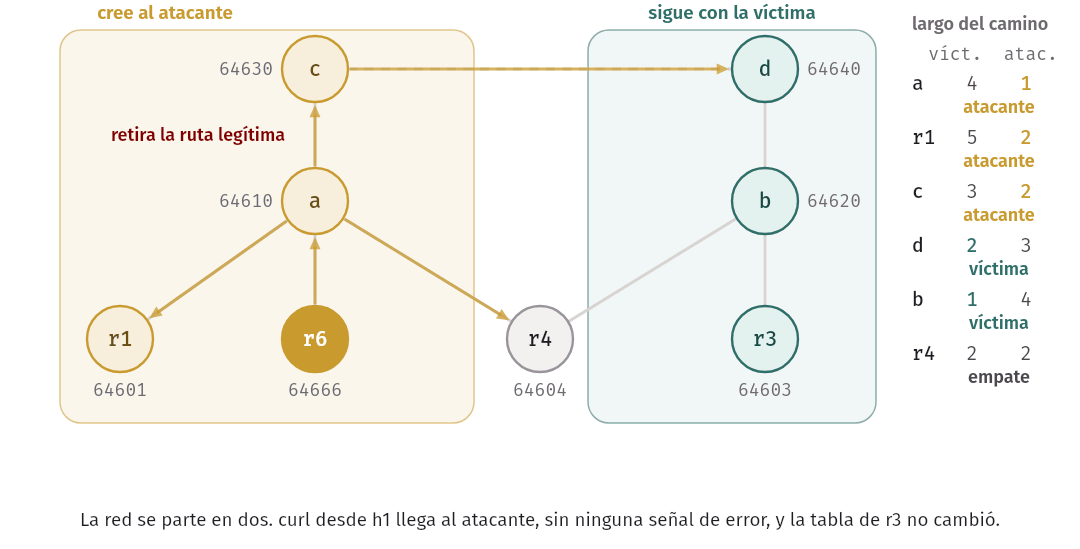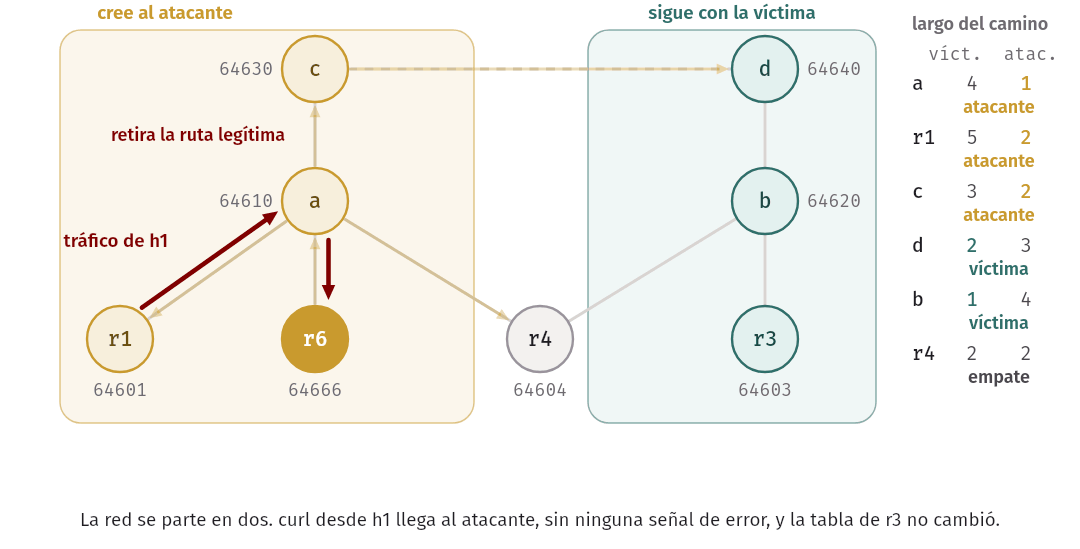
Antes de correrlo, hagan la predicción con la topología. r6 anuncia
100.64.3.0/24. Para cada AS, comparen el AS_PATH hacia la víctima y hacia el
atacante:
| AS | Camino hacia r3 |
Largo | Camino hacia r6 |
Largo | Gana |
|---|---|---|---|---|---|
r1 |
64610 64630 64640 64620 64603 |
5 | 64610 64666 |
2 | atacante |
a |
64630 64640 64620 64603 |
4 | 64666 |
1 | atacante |
c |
64640 64620 64603 |
3 | 64610 64666 |
2 | atacante |
d |
64620 64603 |
2 | 64630 64610 64666 |
3 | víctima |
b |
64603 |
1 | 64640 64630 64610 64666 |
4 | víctima |
r4 |
64620 64603 |
2 | 64610 64666 |
2 | empate |
La tabla compara los caminos que hay en la topología, aunque no todos lleguen a anunciarse. Por ejemplo, d prefiere a la víctima
y solo reanuncia su mejor ruta, así que b nunca recibe el camino hacia r6. El resultado es el mismo.
Ahora lo hacemos:
python3 scenarios.py sameLo que hace ese escenario, en el atacante, son tres cosas: agregar la dirección
del servidor a una de sus interfaces, para poder contestar; crear una ruta a
Null0 para que BGP pueda anunciar el prefijo; y escribir network 100.64.3.0/24. Eso es todo. Nadie le pide una prueba.
$ docker exec clab-w07-bgp-h1 curl -s http://100.64.3.10:8080/
ATACANTE: AS 64666 recibio esta conexion
$ docker exec clab-w07-bgp-h1 traceroute -n -w 1 100.64.3.10
traceroute to 100.64.3.10 (100.64.3.10), 30 hops max, 46 byte packets
 1  100.64.1.1  0.003 ms  0.001 ms  0.003 ms
 2  10.207.4.2  0.001 ms  0.004 ms  0.002 ms
 3  100.64.3.10  0.002 ms  0.002 ms  0.002 ms
Tres saltos en vez de siete, y la misma dirección de destino al final. Desde
h1 no hay ninguna señal de error: la dirección responde, y la conexión se
establece. Si el cliente no comprueba con quién habla, no se entera. Esa
comprobación es justamente lo que hace TLS con certificados, y por eso
volveremos a este ejemplo cuando lleguemos a seguridad.
Miremos la decisión en c, que ve las dos rutas y elige:
$ docker exec clab-w07-bgp-c vtysh -c "show bgp ipv4 unicast 100.64.3.0/24"
BGP routing table entry for 100.64.3.0/24, version 5
Paths: (2 available, best #1, table default)
  Advertised to non peer-group peers:
  10.207.1.2 10.207.2.1
  64610 64666
    10.207.2.1 from 10.207.2.1 (10.207.0.3)
      Origin IGP, valid, external, best (AS Path)
      Last update: Mon Nov  2 07:50:20 2026
  64640 64620 64603
    10.207.1.2 from 10.207.1.2 (10.207.0.2)
      Origin IGP, valid, external
      Last update: Mon Nov  2 07:50:01 2026
best (AS Path) dice exactamente qué criterio decidió. Del otro lado de la
cima, d tiene las mismas dos rutas y elige la contraria:
$ docker exec clab-w07-bgp-d vtysh -c "show bgp ipv4 unicast 100.64.3.0/24"
BGP routing table entry for 100.64.3.0/24, version 1
Paths: (2 available, best #1, table default)
  Advertised to non peer-group peers:
  10.207.1.1 10.207.3.1
  64620 64603
    10.207.3.1 from 10.207.3.1 (10.207.0.4)
      Origin IGP, valid, external, best (AS Path)
      Last update: Mon Nov  2 07:50:01 2026
  64630 64610 64666
    10.207.1.1 from 10.207.1.1 (10.207.0.1)
      Origin IGP, valid, external
      Last update: Mon Nov  2 07:50:20 2026
Y a, en cambio, ya no ve dos rutas sino una:
$ docker exec clab-w07-bgp-a vtysh -c "show bgp ipv4 unicast 100.64.3.0/24"
BGP routing table entry for 100.64.3.0/24, version 5
Paths: (1 available, best #1, table default)
  Advertised to non peer-group peers:
  10.207.2.2 10.207.4.1 10.207.5.1 10.207.6.1
  64666
    10.207.5.1 from 10.207.5.1 (10.207.0.3)
      Origin IGP, metric 0, valid, external, best (First path received)
      Last update: Mon Nov  2 07:50:19 2026
¿Dónde quedó la ruta legítima? Se la daba c. Pero ahora la mejor ruta de c
pasa por a, y c no le ofrece a a una ruta que contiene el AS de a: por
eso se la retira. Un AS solo reanuncia su mejor ruta, así que cuando el
hijack avanza, la ruta buena va desapareciendo de las tablas de quienes ya
cayeron. Mientras dure el ataque, a ni siquiera sabe que existe un camino a la
víctima.
Queda el empate de r4. Tiene dos rutas de largo 2, y los criterios siguientes
tampoco las separan, así que se queda con la que ya tenía:
$ docker exec clab-w07-bgp-r4 vtysh -c "show bgp ipv4 unicast 100.64.3.0/24"
BGP routing table entry for 100.64.3.0/24, version 3
Paths: (2 available, best #1, table default)
  Not advertised to any peer
  64620 64603
    10.207.7.2 from 10.207.7.2 (10.207.0.4)
      Origin IGP, valid, external, best (Older Path)
      Last update: Mon Nov  2 07:50:04 2026
  64610 64666
    10.207.6.2 from 10.207.6.2 (10.207.0.3)
      Origin IGP, valid, external
      Last update: Mon Nov  2 07:50:20 2026
El resultado de un empate depende del orden de los eventos, así que no se puede
predecir mirando solo la topología. Por eso las pruebas de la semana no exigen
nada sobre r4 en este caso.
Desde el lado de la víctima el servicio sigue funcionando, lo que hace más difícil notar el problema:
$ docker exec clab-w07-bgp-srv curl -s http://100.64.3.10:8080/
servidor legitimo de AS 64603
Y ninguna alarma suena sola en la víctima: su propia tabla no cambió. La
ruta que r3 ve es la local. Para detectar un hijack hay que mirar la tabla de
BGP desde afuera, y desde muchos puntos. Eso es lo que permite un servicio como
el RIS del RIPE NCC, que veremos enseguida.
En la práctica. Con política real, el largo del camino no es lo primero. Un AS prefiere las rutas de sus clientes aunque sean largas. Si en esta red
aycaplicaran esa regla,aseguiría prefiriendo al atacante, que es su cliente. Peroc, que ve aacomo cliente y adcomo peer, también. Un atacante conectado como cliente de un proveedor grande aprovecha esa preferencia: su anuncio se trata como dinero que entra.
Con un prefijo más específico: gana en todas partes
El segundo ataque no compite por el mismo prefijo: anuncia uno más largo. Recordemos de la semana 4 cómo decide el plano de datos. Para cada paquete, el router busca en la forwarding table y aplica longest prefix match: entre todas las rutas que contienen la dirección, gana la de prefijo más largo.
La consecuencia es brutal. Un /25 y un /24 no son “dos rutas al mismo
destino” para BGP: son dos prefijos distintos. El proceso de decisión de BGP
no los compara nunca. Los dos se instalan, y es el forwarding el que después
elige el más largo, sin mirar el AS_PATH, el LOCAL_PREF ni nada. Largos o
cortos, los caminos no importan: todo router que reciba el /25 lo usará.
python3 scenarios.py reset
python3 scenarios.py specific
$ docker exec clab-w07-bgp-r1 vtysh -c "show bgp ipv4 unicast"
Network Next Hop Metric LocPrf Weight Path
*> 100.64.1.0/24 0.0.0.0 0 32768 i
*> 100.64.3.0/24 10.207.4.2 0 64610 64630 64640 64620 64603 i
*> 100.64.3.0/25 10.207.4.2 0 64610 64666 i
*> 100.64.4.0/24 10.207.4.2 0 64610 64604 i
*> 100.64.66.0/24 10.207.4.2 0 64610 64666 iLas dos rutas conviven en la tabla. Ahora b y d, que en el ataque anterior
no se dejaron engañar, y hasta r3, la propia víctima:
$ docker exec clab-w07-bgp-b vtysh -c "show ip route 100.64.3.10"
Routing entry for 100.64.3.0/25
  Known via "bgp", distance 20, metric 0, best
  Last update 00:00:03 ago
  * 10.207.3.2, via eth1, weight 1

$ docker exec clab-w07-bgp-d vtysh -c "show ip route 100.64.3.10"
Routing entry for 100.64.3.0/25
  Known via "bgp", distance 20, metric 0, best
  Last update 00:00:03 ago
  * 10.207.1.1, via eth1, weight 1

$ docker exec clab-w07-bgp-r3 vtysh -c "show ip route 100.64.3.10"
Routing entry for 100.64.3.0/25
  Known via "bgp", distance 20, metric 0, best
  Last update 00:00:03 ago
  * 10.207.8.2, via eth2, weight 1
Lean la última con calma. El servidor está conectado directamente a una interfaz
de r3, y aun así r3 manda hacia afuera lo que va a 100.64.3.10. La ruta
conectada es un /24, y el /25 es más largo. La distancia administrativa (0
contra 20) no ayuda: esa comparación solo se hace entre rutas al mismo
prefijo. Para ver cómo se pierde r3:
$ docker exec clab-w07-bgp-r3 traceroute -n -w 1 100.64.3.10
traceroute to 100.64.3.10 (100.64.3.10), 30 hops max, 46 byte packets
 1  10.207.8.2  0.007 ms  0.003 ms  0.003 ms
 2  *  *  *
 3  *  *  *
(Así hasta el salto 30.) Los paquetes salen de r3, y no vuelve respuesta,
porque la dirección de enlace de r3 no se anuncia y los routers del otro lado
no saben llegar a ella.
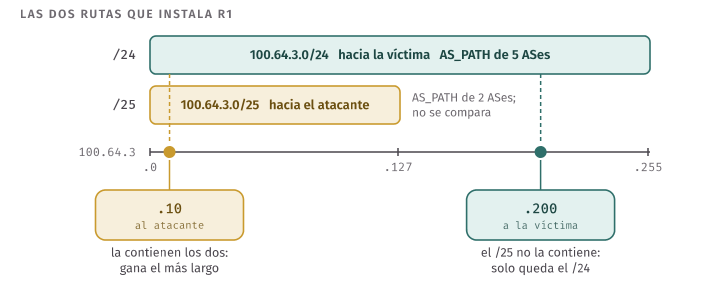
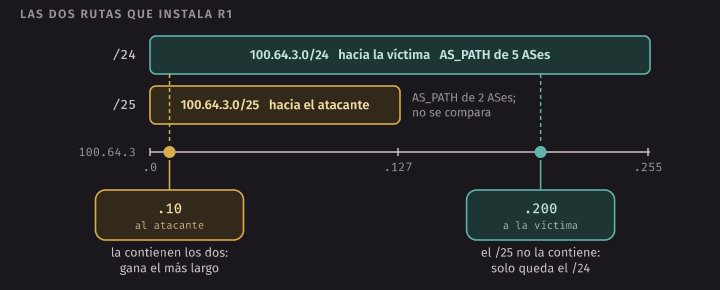
¿Y la otra mitad del /24? Un /25 cubre 128 direcciones: 100.64.3.0/25 va
de .0 a .127. Nuestro servidor también responde en .200:
$ docker exec clab-w07-bgp-h1 curl -s http://100.64.3.10:8080/
ATACANTE: AS 64666 recibio esta conexion
$ docker exec clab-w07-bgp-h1 curl -s http://100.64.3.200:8080/
servidor legitimo de AS 64603
El hijack llega solo hasta donde llega el prefijo anunciado. Con esto se
responde una pregunta típica: si el atacante anuncia 203.0.113.0/25 y la
víctima 203.0.113.0/24, el tráfico hacia 203.0.113.5 va al atacante, porque
esa dirección cae en el /25; y el tráfico hacia 203.0.113.200 va a la
víctima, porque el /25 no la contiene y solo queda el /24.
| Mismo prefijo | Prefijo más específico | |
|---|---|---|
| ¿Quién decide? | El proceso de decisión de BGP en cada AS | Longest prefix match en cada router |
| ¿Cuánto se propaga? | Solo donde la ruta falsa queda mejor | En todo lugar que acepte el anuncio |
| ¿Importa la distancia al atacante? | Sí | No |
| ¿Cae la víctima misma? | No, tiene su ruta local | Sí, si acepta el prefijo |
| Límite | Depende de la topología | Muchas redes no aceptan prefijos demasiado largos |
Error común. Decir que “gana la ruta con el
AS_PATHmás corto” en un hijack con un prefijo más específico. ElAS_PATHnunca llega a compararse. Hay dos entradas distintas, y en el plano de datos la elección la hace longest prefix match. Para entender un hijack hay que tener claros los dos planos de la semana 4.
Caso real: Pakistan Telecom y YouTube, 2008
Este es el ejemplo clásico, y uno de los mejor documentados: el RIPE NCC publicó
un estudio de
caso
con datos de su sistema de monitoreo RIS. Según ese estudio, Pakistán buscaba
bloquear el sitio de YouTube. Las direcciones de youtube.com en el DNS
(208.65.153.238, .251 y .253) estaban dentro de 208.65.152.0/22, el
prefijo que anunciaba YouTube.
Esta es la cronología del domingo 24 de febrero de 2008, en UTC:
| Hora | Qué pasó |
|---|---|
| Antes | AS36561 (YouTube) anuncia 208.65.152.0/22. |
| 18:47 | AS17557 (Pakistan Telecom) empieza a anunciar 208.65.153.0/24. AS3491 (PCCW Global), uno de sus proveedores, propaga el anuncio. El tráfico de YouTube se redirige a Pakistán. |
| 20:07 | YouTube empieza a anunciar 208.65.153.0/24. Ahora hay dos prefijos idénticos y la política decide. Pakistan Telecom sigue atrayendo parte del tráfico. |
| 20:18 | YouTube anuncia 208.65.153.0/25 y 208.65.153.128/25. Por longest prefix match, quienes los reciben mandan el tráfico a YouTube. |
| 20:51 | Todos los anuncios de prefijos, incluido el /24 de AS17557 vía AS3491, se ven con otro 17557 antepuesto. El camino más largo hace que más routers prefieran el anuncio de YouTube. |
| 21:01 | PCCW retira todos los prefijos originados por AS17557, y termina el hijack. |
Comparen con lo que acabamos de hacer. Un /24 dentro de un /22 es
exactamente el caso del prefijo más específico: no importó qué tan lejos
estuviera Pakistán. Dos horas después de que empezó, el hijack terminó cuando el proveedor retiró
las rutas. Es el punto donde más sirve un filtro, y volveremos a
él.
El estudio aclara un límite honesto: RIS muestra lo que ven sus puntos de observación, y por eso no puede decir cuántos sitios tuvieron su tráfico a YouTube desviado.
Cómo responde la víctima
Una víctima no controla los filtros de los demás. Lo que sí controla son sus propios anuncios, y tiene pocas opciones:
- Anunciar más específicos que el atacante. Es lo que hizo YouTube a las
20:18. Si el atacante anuncia un
/24, la víctima anuncia dos/25. - Llamar a los proveedores del atacante, para que retiren la ruta. Es lento y depende de que alguien conteste. El hijack de 2008 terminó cuando PCCW retiró las rutas; el estudio no dice qué motivó esa retirada.
Probemos la primera en el laboratorio. El ataque es el /24, y la víctima
responde con sus dos mitades:
$ python3 scenarios.py same
$ docker exec clab-w07-bgp-h1 curl -s http://100.64.3.10:8080/
ATACANTE: AS 64666 recibio esta conexion
$ python3 scenarios.py counter
$ docker exec clab-w07-bgp-r1 vtysh -c "show ip route 100.64.3.10"
Routing entry for 100.64.3.0/25
  Known via "bgp", distance 20, metric 0, best
  Last update 00:00:03 ago
  * 10.207.4.2, via eth2, weight 1

$ docker exec clab-w07-bgp-h1 curl -s http://100.64.3.10:8080/
servidor legitimo de AS 64603
$ docker exec clab-w07-bgp-h1 traceroute -n -w 1 100.64.3.10
traceroute to 100.64.3.10 (100.64.3.10), 30 hops max, 46 byte packets
 1  100.64.1.1  0.005 ms  0.004 ms  0.003 ms
 2  10.207.4.2  0.001 ms  0.002 ms  0.003 ms
 3  10.207.2.2  0.002 ms  0.003 ms  0.002 ms
 4  10.207.1.2  0.002 ms  0.002 ms  0.002 ms
 5  10.207.3.1  0.001 ms  0.002 ms  0.003 ms
 6  10.207.8.1  0.001 ms  0.002 ms  0.002 ms
 7  100.64.3.10  0.001 ms  0.003 ms  0.002 ms
Recuperó el tráfico, y sin que el atacante retirara nada. Pero esta defensa
tiene un techo. El RFC 7454 (sección
6.1.3) recoge que los prefijos IPv4 más largos que /24 y los IPv6 más largos
que /48 “generalmente ni se anuncian ni se aceptan” en Internet, y aclara que
esos límites no los fija él y pueden cambiar. Así que un /25 de respuesta no
llega a todas partes. En el caso de YouTube se vio en los datos: en una consulta
a RIS que cita el estudio del RIPE NCC, el /22 se veía desde 112 peers, el
/24 desde 105 y el /25 solo desde 21.
Y si el atacante anuncia desde el principio un /24, y la víctima ya anuncia
ese mismo /24, responder con /25 es tan limitado como acabamos de ver. Por
eso no basta con reaccionar: hace falta que el anuncio falso no entre.
Idea clave. En un hijack con más específicos, el que anuncia el prefijo más largo que todavía se propague se lleva el tráfico. Si los dos llegan a ese límite, vuelven a competir por política y por largo del camino.
Route leak
Definición. El RFC 7908, que propone una definición de trabajo y una clasificación, dice: un route leak es la propagación de anuncios de routing más allá de su alcance previsto. La diferencia con el hijack: aquí el origen puede ser totalmente correcto. Lo que está mal es por dónde pasa el anuncio.
Recuerden las reglas de exportación de la semana 6: las rutas de peers y proveedores solo se anuncian a clientes. Un AS que aprende una ruta de un proveedor y se la pasa a otro proveedor está violando esa regla, y además está ofreciendo gratis un servicio que le cuesta dinero. El camino resultante tiene un valle:
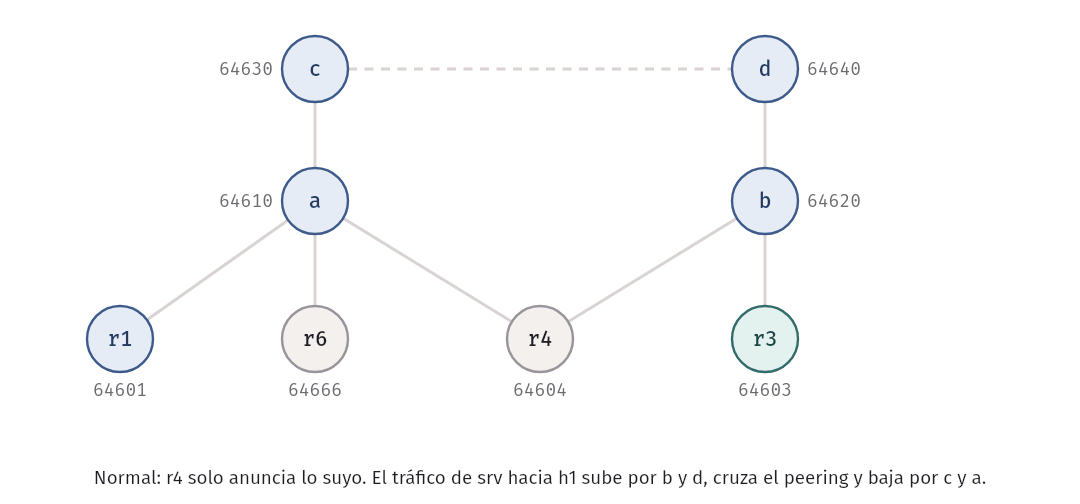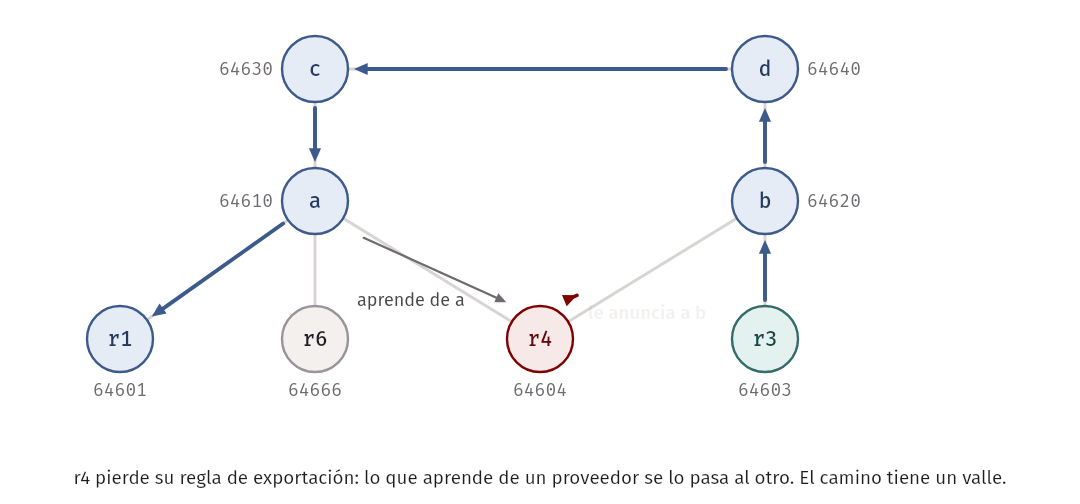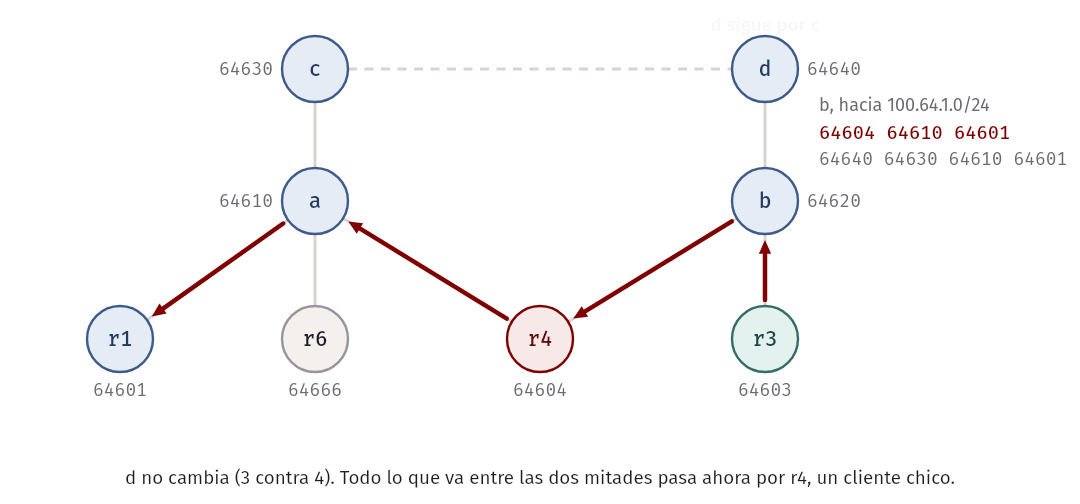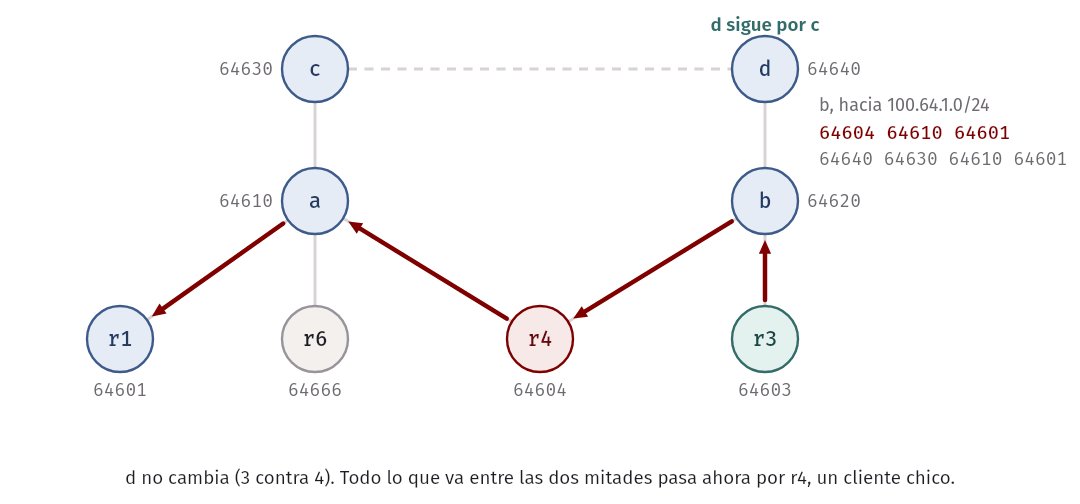
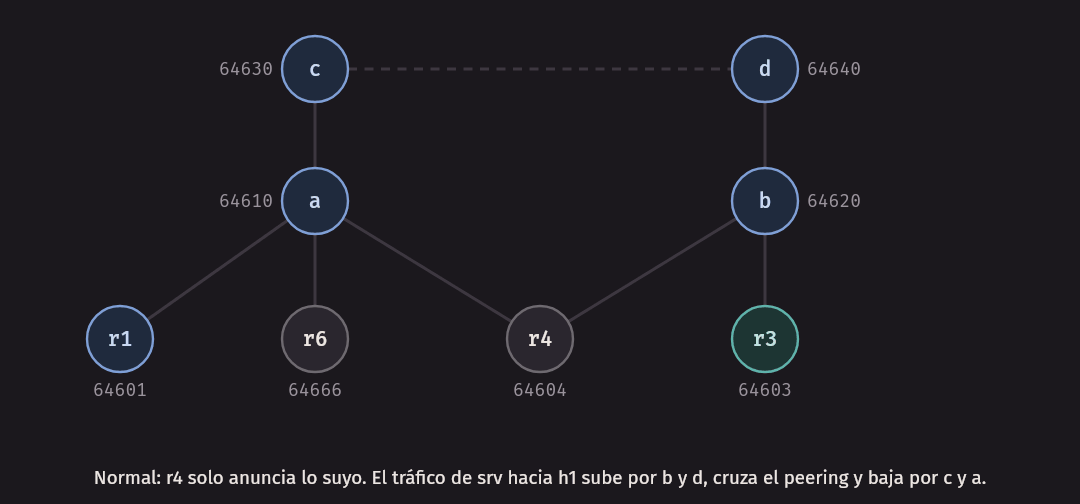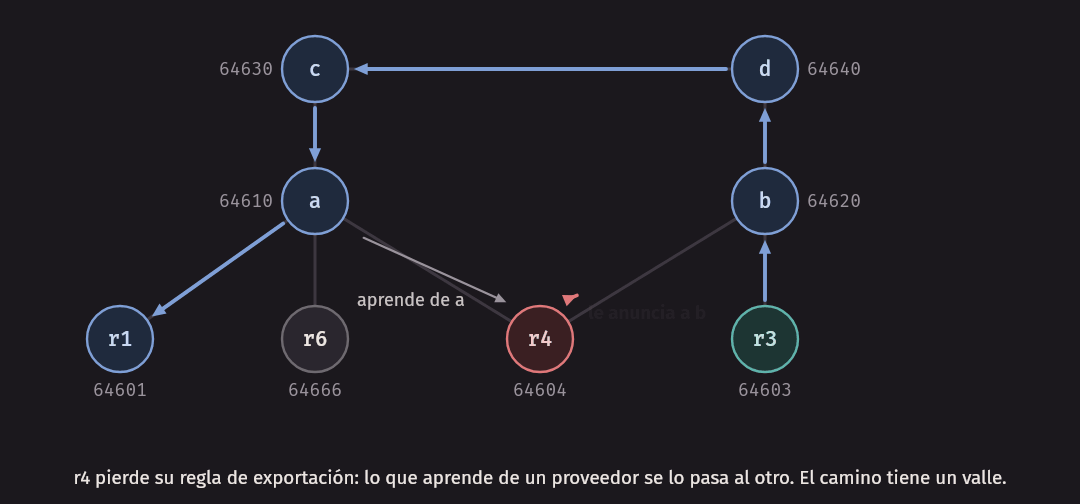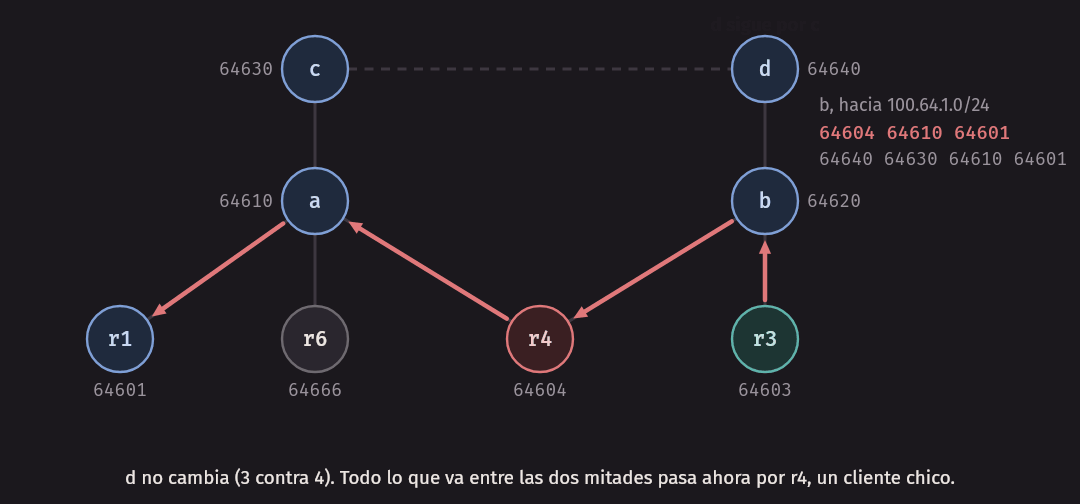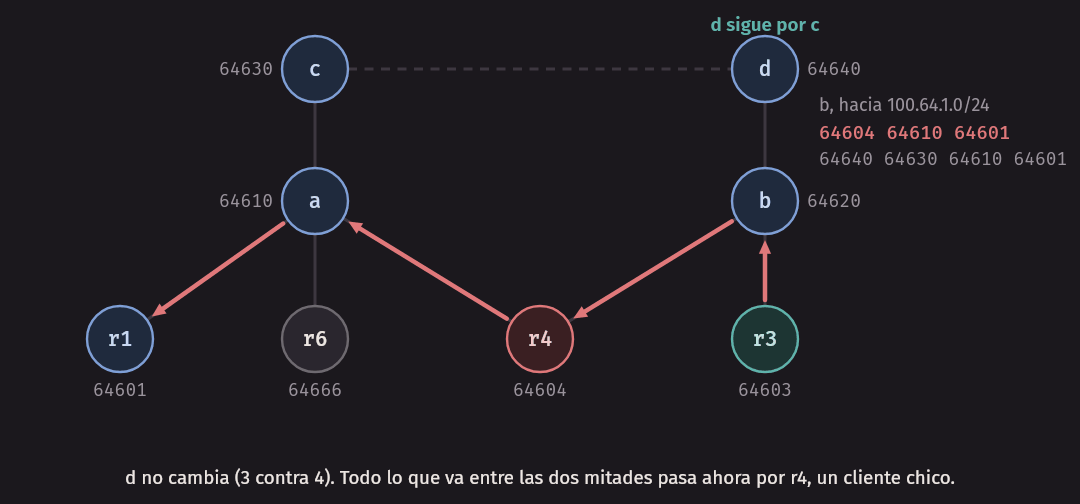
El RFC 7908 llama a esto Tipo 1: Hairpin Turn: “un AS con varios proveedores
aprende una ruta de un proveedor y simplemente la propaga a otro”. Es nuestro
r4.
Provocar la fuga
Partimos del estado normal, midiendo primero. Ponemos en r4 un límite de 20
Mbit/s y 5 ms por enlace, porque es una red chica. Eso no cambia nada todavía,
porque por r4 no pasa el tráfico de nadie:
$ docker exec clab-w07-bgp-srv traceroute -n -w 1 100.64.1.10
traceroute to 100.64.1.10 (100.64.1.10), 30 hops max, 46 byte packets
 1  100.64.3.1  0.003 ms  0.002 ms  0.003 ms
 2  10.207.8.2  0.002 ms  0.003 ms  0.002 ms
 3  10.207.3.2  0.001 ms  0.002 ms  0.005 ms
 4  10.207.1.1  0.002 ms  0.001 ms  0.002 ms
 5  10.207.2.1  0.002 ms  0.002 ms  0.001 ms
 6  10.207.4.1  0.001 ms  0.002 ms  0.002 ms
 7  100.64.1.10  0.002 ms  0.001 ms  0.002 ms
$ python3 scenarios.py slow_r4
$ docker exec clab-w07-bgp-srv ping -c 5 -q 100.64.1.10
PING 100.64.1.10 (100.64.1.10): 56 data bytes

--- 100.64.1.10 ping statistics ---
5 packets transmitted, 5 packets received, 0% packet loss
round-trip min/avg/max = 0.066/0.090/0.128 ms
r4 le anuncia a b solo lo suyo:
$ docker exec clab-w07-bgp-r4 vtysh -c "show bgp ipv4 unicast neighbors 10.207.7.2 advertised-routes"
     Network          Next Hop            Metric LocPrf Weight Path
 *>  100.64.4.0/24    0.0.0.0                  0         32768 i

Total number of prefixes 1
Ahora le quitamos a r4 su regla de exportación. Es un cambio de dos líneas, el
tipo de cosa que se borra por error en una ventana de mantenimiento:
python3 scenarios.py leak$ docker exec clab-w07-bgp-r4 vtysh -c "show bgp ipv4 unicast neighbors 10.207.7.2 advertised-routes"
Network Next Hop Metric LocPrf Weight Path
*> 100.64.1.0/24 10.207.6.2 0 64610 64601 i
*> 100.64.3.0/24 10.207.7.2 0 64620 64603 i
*> 100.64.4.0/24 0.0.0.0 0 32768 i
*> 100.64.66.0/24 10.207.6.2 0 64610 64666 i
Total number of prefixes 4Y b hace lo que dice el protocolo: ve una ruta más corta hacia r1 y la
elige.
$ docker exec clab-w07-bgp-b vtysh -c "show bgp ipv4 unicast 100.64.1.0/24"
BGP routing table entry for 100.64.1.0/24, version 15
Paths: (2 available, best #1, table default)
  Advertised to non peer-group peers:
  10.207.3.2 10.207.7.1 10.207.8.1
  64604 64610 64601
    10.207.7.1 from 10.207.7.1 (10.207.0.7)
      Origin IGP, valid, external, best (AS Path)
      Last update: Mon Nov  2 07:52:21 2026
  64640 64630 64610 64601
    10.207.3.2 from 10.207.3.2 (10.207.0.2)
      Origin IGP, valid, external
      Last update: Mon Nov  2 07:52:07 2026
Tres ASes contra cuatro: la ruta filtrada gana porque atraviesa la cima por
abajo. Es un atajo real. El tráfico efectivamente pasa por él, y a hace lo
mismo en el otro sentido.
$ docker exec clab-w07-bgp-srv traceroute -n -w 1 100.64.1.10
traceroute to 100.64.1.10 (100.64.1.10), 30 hops max, 46 byte packets
 1  100.64.3.1  0.003 ms  0.004 ms  0.002 ms
 2  10.207.8.2  0.002 ms  0.002 ms  0.002 ms
 3  10.207.7.1  5.798 ms  6.708 ms  5.994 ms
 4  10.207.6.2  12.010 ms  12.706 ms  11.089 ms
 5  10.207.4.1  11.884 ms  12.185 ms  14.302 ms
 6  100.64.1.10  12.932 ms  14.381 ms  12.146 ms
$ docker exec clab-w07-bgp-srv ping -c 5 -q 100.64.1.10
PING 100.64.1.10 (100.64.1.10): 56 data bytes

--- 100.64.1.10 ping statistics ---
5 packets transmitted, 5 packets received, 0% packet loss
round-trip min/avg/max = 11.832/11.999/12.224 ms
El salto 3 es r4. El RTT pasó de décimas de milisegundo a 12 ms. Es lo que se
espera: tc netem actúa en la salida de cada interfaz, así que r4 agrega 5 ms
a la ida (al salir por eth1) y 5 ms a la vuelta (al salir por eth2), y los cerca de 2 ms restantes dependen de la
computadora. Y el efecto en el throughput, con
iperf3:
$ docker exec clab-w07-bgp-srv iperf3 -c 100.64.1.10 -t 3
[  5]   0.00-3.00   sec  7.38 MBytes  20.6 Mbits/sec   12             sender
[  5]   0.00-3.10   sec  7.00 MBytes  18.9 Mbits/sec                  receiver
Sin la fuga, y sobre todo sin pasar por r4, la misma medición en la misma
laptop da:
$ docker exec clab-w07-bgp-srv iperf3 -c 100.64.1.10 -t 3
[  5]   0.00-3.00   sec  1.60 GBytes  4.57 Gbits/sec   41             sender
[  5]   0.00-3.00   sec  1.60 GBytes  4.57 Gbits/sec                  receiver
La cifra de 4,57 Gbit/s depende de la computadora y de lo que esté corriendo: es lo que da un enlace virtual sin límite. Lo que importa es la tendencia: todo el tráfico entre las dos mitades de la red tiene que pasar por un cuello de botella de 20 Mbit/s, porque un cliente chico se volvió tránsito entre sus dos proveedores.
No todo cambió. d mantiene su ruta por c, porque desde su lugar el camino
normal sigue siendo más corto que el filtrado (tres ASes contra cuatro):
$ docker exec clab-w07-bgp-d vtysh -c "show bgp ipv4 unicast 100.64.1.0/24"
BGP routing table entry for 100.64.1.0/24, version 2
Paths: (2 available, best #1, table default)
  Advertised to non peer-group peers:
  10.207.1.1 10.207.3.1
  64630 64610 64601
    10.207.1.1 from 10.207.1.1 (10.207.0.1)
      Origin IGP, valid, external, best (AS Path)
      Last update: Mon Nov  2 07:52:07 2026
  64620 64604 64610 64601
    10.207.3.1 from 10.207.3.1 (10.207.0.4)
      Origin IGP, valid, external
      Last update: Mon Nov  2 07:52:21 2026
En la práctica. En nuestro laboratorio la fuga gana porque el camino es más corto. Con políticas reales es peor:
bve ar4como cliente y prefiere las rutas de clientes antes que las de su proveedor, aunque sean más largas. La regla “prefiere a quien te paga” empuja el tráfico hacia la fuga, sin importar el largo.
Caso real: la fuga de junio de 2019
Cloudflare publicó el mismo día un análisis del incidente del 24 de junio de 2019, que empezó a las 10:30 UTC. Según ese análisis:
- AS33154 (DQE Communications), un ISP de Pensilvania, usaba en su red un
“optimizador de BGP” de la empresa Noction. Ese producto divide los prefijos
recibidos en partes más pequeñas. El ejemplo que da Cloudflare es su propio
104.20.0.0/20, convertido en104.20.0.0/21y104.20.8.0/21. - DQE se las anunció a su cliente, AS396531 (Allegheny Technologies).
- Allegheny las pasó a su otro proveedor de tránsito, AS701 (Verizon).
- Verizon se las anunció al resto de Internet.
El resultado afectó servicios de Cloudflare, Amazon y Linode, entre otros. Cloudflare reporta que, en el peor momento, perdió alrededor del 15 % de su tráfico global. El tráfico de grandes redes pasó a un camino que incluía a redes pequeñas. Se resolvió cuando Cloudflare logró comunicarse con DQE y este dejó de anunciar esas rutas a Allegheny.
Este incidente tiene dos de los ingredientes que vimos, juntos:
- El viraje de Allegheny es nuestro
r4: aprende de un proveedor y le anuncia a otro. - Los más específicos explican por qué fue tan grave: como en el hijack con
/25, no compiten por política. Allí donde llegaron, ganaron.
Nuestra fuga de laboratorio tiene el primer ingrediente y no el segundo. Por eso
solo cambió los caminos de a y b. Con más específicos, también habría caído
d. En los ejercicios lo van a comprobar.
Observen también dónde estaba el punto de control. Cloudflare critica sobre todo a Verizon: su sesión con un cliente chico dejó pasar de golpe rutas que ese cliente no tenía por qué anunciar. Eso lleva a la siguiente sección.
Error común. Llamar hijack a todo. En un hijack se origina un prefijo ajeno; en una fuga, la ruta puede tener el origen correcto y el problema es que se pasó a quien no debía. La diferencia importa porque las defensas son distintas, como vamos a ver con RPKI.
Defensas sin criptografía
Ninguna de estas defensas cambia el protocolo. Son configuraciones que cada AS aplica en sus sesiones, y están recogidas como buenas prácticas en el RFC 7454.
Filtros de prefijos
El RFC 7454 organiza el filtrado según con quién sea la sesión. La sección 6 dice, en resumen:
| Sesión | Filtro de entrada que recomienda |
|---|---|
| Cliente (6.2.2.1) | Aceptar solo los prefijos verificados del cliente, y descartar el resto. |
| Peer (6.2.1.1) | Modo estricto, contra registros de routing; o modo laxo: descartar lo no enrutable globalmente, lo demasiado específico, los prefijos propios, los de la LAN del IXP y la ruta por defecto. |
| Proveedor (6.2.3.1) | Si se pide la tabla completa, lo mismo que con un peer, menos el filtro de la ruta por defecto. |
El filtro más poderoso es el primero, y hay una razón. Un proveedor sabe qué bloques tiene su cliente: es parte del contrato. Una tabla completa de Internet tiene demasiadas rutas para validarlas todas, pero la lista de un cliente chico cabe en pocas líneas.
Los dos casos reales se habrían detenido en ese punto:
- Con un filtro de ese tipo en la sesión de PCCW con Pakistan Telecom,
208.65.153.0/24no habría pasado. - Cloudflare escribe que, si se hubieran usado filtros construidos con los registros de routing (IRR), ninguna de las redes involucradas habría aceptado los más específicos.
Lo que se configura es lo mismo que vieron en la semana 6, una ip prefix-list
asociada a una sesión. Lo que hay que tener claro es cómo se interpreta. Una
línea de lista tiene un prefijo y, opcionalmente, un rango de largos con ge y
le; sin rango, coincide solo con ese largo exacto:
| Línea | 198.51.100.0/24 |
198.51.100.0/25 |
198.51.0.0/16 |
|---|---|---|---|
permit 198.51.100.0/24 |
sí | no | no |
permit 198.51.100.0/24 le 25 |
sí | sí | no |
permit 198.51.100.0/24 ge 25 |
no | sí | no |
permit 198.51.0.0/16 le 32 |
sí | sí | sí |
Y una lista termina en un deny implícito. Si un anuncio no coincide con ninguna línea, se descarta.
Error común. Escribir un filtro con
le 32“para no molestar al cliente si algún día anuncia partes de su bloque”. Con eso, el cliente puede anunciar más específicos de lo acordado, y los más específicos son justamente lo que hizo tanto daño en 2019. Y ojo con lo contrario: por el deny implícito, si olvidan una línea, el cliente pierde su propia ruta.
El ejercicio central del laboratorio es escribir ese filtro para esta topología:
ustedes completan lab/filters-a.conf y lab/filters-b.conf. Aquí no lo
mostramos, porque es parte de lo que tienen que resolver. Lo que sí podemos
mostrar es el resultado. Con los filtros cargados, los dos ataques y la fuga,
juntos:
$ python3 scenarios.py same
$ python3 scenarios.py leak
$ docker exec clab-w07-bgp-a vtysh -c "show bgp ipv4 unicast neighbors 10.207.5.1 routes"
     Network          Next Hop            Metric LocPrf Weight Path
 *>  100.64.66.0/24   10.207.5.1               0             0 64666 i

Displayed 1 routes and 4 total paths
$ docker exec clab-w07-bgp-a vtysh -c "show bgp ipv4 unicast"
     Network          Next Hop            Metric LocPrf Weight Path
 *>  100.64.1.0/24    10.207.4.1               0             0 64601 i
 *>  100.64.3.0/24    10.207.2.2                             0 64630 64640 64620 64603 i
 *>  100.64.4.0/24    10.207.6.1               0             0 64604 i
 *>  100.64.66.0/24   10.207.5.1               0             0 64666 i
$ docker exec clab-w07-bgp-h1 curl -s http://100.64.3.10:8080/
servidor legitimo de AS 64603
El atacante sigue anunciando lo que quiere; a solo se queda con su bloque
legítimo. La ruta a 100.64.3.0/24 volvió a ser la de la jerarquía, y srv
llega a h1 por b, d, c y a, como al principio.
Límite de prefijos
El filtro necesita mantenerse al día. Una protección más gruesa, y que no depende de saber qué prefijos son, es limitar cuántos recibe una sesión. El RFC 7454 (sección 8) recomienda un límite por sesión. Si se excede, la sesión se corta.
router bgp 64620
 address-family ipv4 unicast
  neighbor 10.207.7.1 maximum-prefix 2
Eso le dice a b que tolere hasta dos prefijos de r4, que normalmente anuncia
uno. Ahora repetimos la fuga:
$ python3 scenarios.py max_prefix
$ python3 scenarios.py leak
$ docker exec clab-w07-bgp-b vtysh -c "show bgp summary"
Neighbor        V         AS   MsgRcvd   MsgSent   TblVer  InQ OutQ  Up/Down State/PfxRcd   PfxSnt Desc
10.207.3.2      4      64640        89        97       22    0    0 00:02:51            3        4 d (proveedor)
10.207.7.1      4      64604        83       110        0    0    0 00:00:05 Idle (PfxCt)        0 r4 (cliente)
10.207.8.1      4      64603        97        95       22    0    0 00:02:51            1        4 r3 (cliente)
$ docker exec clab-w07-bgp-a vtysh -c "show bgp summary"
Neighbor        V         AS   MsgRcvd   MsgSent   TblVer  InQ OutQ  Up/Down State/PfxRcd   PfxSnt Desc
10.207.2.2      4      64630        96       113       29    0    0 00:02:51            1        4 c (proveedor)
10.207.4.1      4      64601       122       104       29    0    0 00:02:51            1        4 r1 (cliente)
10.207.5.1      4      64666       122       104       29    0    0 00:02:51            1        4 r6 (cliente)
10.207.6.1      4      64604        93       121       29    0    0 00:00:14            1        4 r4 (cliente)
$ docker exec clab-w07-bgp-srv traceroute -n -w 1 100.64.1.10
traceroute to 100.64.1.10 (100.64.1.10), 30 hops max, 46 byte packets
 1  100.64.3.1  0.003 ms  0.001 ms  0.003 ms
 2  10.207.8.2  0.002 ms  0.002 ms  0.002 ms
 3  10.207.3.2  0.003 ms  0.002 ms  0.002 ms
 4  10.207.1.1  0.002 ms  0.002 ms  0.002 ms
 5  10.207.2.1  0.001 ms  0.002 ms  0.003 ms
 6  10.207.4.1  0.002 ms  0.002 ms  0.002 ms
 7  100.64.1.10  0.002 ms  0.002 ms  0.002 ms
Idle (PfxCt) significa que la sesión se cerró por excederse el conteo. El
tráfico volvió a su camino normal. Tres detalles que esta salida enseña:
ano cortó la sesión. Tenía el mismo límite de 2, pero der4le llegaron como mucho dos prefijos antes de quebcortara: el propio der4y el der3, que es lo único quer4había aprendido deb. El límite no detecta fugas: detecta fugas grandes. Una fuga pequeña pasa por debajo.r4quedó con un solo proveedor, y esta sesión no vuelve sola: hay que reabrirla (en FRRouting,clear bgp). Mientras tanto,r4llega y es alcanzable solo pora. La defensa también tiene un costo, y es lo que queríamos: una sesión caída es más visible que una fuga silenciosa.- El valor del límite es una decisión. Si es muy ajustado, una red que crece normalmente pierde la sesión. El RFC recomienda revisarlo con el tiempo, y fijarlo según lo que se espera de cada vecino.
Cloudflare menciona este mismo mecanismo entre los que pudieron contener el incidente de 2019.
Idea clave. Los filtros y los límites protegen a los demás, no a quien los configura. PCCW o Verizon, filtrando a sus clientes, protegen al resto de Internet. Por eso hace falta que sea una norma de la comunidad, y por eso los incentivos son el problema difícil.
RPKI: validar quién puede originar un prefijo
Filtrar a un cliente funciona porque el proveedor conoce a su cliente. Pero d
no conoce al cliente de a, y tampoco tiene por qué. Lo que le falta a d es
una forma de preguntarse, sin depender de nadie cercano: ¿64666 tiene derecho
a originar 100.64.3.0/24?
El dato existe. Alguien le asignó esa dirección a la víctima: los bloques de direcciones se reparten de forma jerárquica. RPKI (Resource Public Key Infrastructure, RFC 6480) aprovecha esa jerarquía para certificar quién tiene qué.
Las piezas
El RFC 6480 describe tres componentes:
- Una PKI de recursos. Certificados X.509 que acreditan quién tiene qué direcciones y qué números de AS. Los emite quien asigna el recurso, y la jerarquía sigue a la de las asignaciones: IANA, los cinco registros regionales (RIRs, como LACNIC en esta parte del mundo), registros nacionales y locales o ISPs, y los suscriptores.
- Objetos de routing firmados. El principal es el ROA (Route Origin Authorization).
- Un sistema de repositorios distribuidos de donde se descargan los objetos.
Un ROA es una autorización firmada por quien tiene el prefijo, y contiene:
- Un solo número de AS, el autorizado a originar.
- Una lista de prefijos.
- Para cada prefijo, opcionalmente, un largo máximo (maxLength): hasta qué largo puede anunciar ese AS partes más específicas. Si no se da, es el largo del propio prefijo.
Dicho en una frase: el owner de 100.64.3.0/24 autoriza al AS 64603 a
originarlo, y hasta /24.
Para que esto llegue al router hay dos pasos:
  repositorios RPKI                cache (relying party)             router
  (ROAs firmados)     ----->       descarga y valida firmas  ----->  FRRouting
                      descarga     queda: lista de VRPs       RTR    compara cada anuncio
El cache, también llamado relying party o validador, descarga los objetos y comprueba las firmas en una máquina aparte. Lo que queda es una lista de VRPs (Validated ROA Payloads): tripletas de prefijo, largo máximo y AS. Los routers no hacen criptografía: reciben esa lista con el protocolo RTR (RFC 8210), y la comparan con cada ruta.
Los tres resultados
El RFC 6811 define la comparación, y
conviene leer sus definiciones con cuidado. Para una ruta, se toma el prefijo
anunciado y el origen, que es el último AS del AS_PATH.
- Un VRP cubre la ruta si el prefijo del VRP es igual o más corto que el de la ruta, y sus bits coinciden.
- Un VRP hace match con la ruta si la cubre, si el largo de la ruta no pasa del largo máximo del VRP, y si el origen es igual al AS del VRP.
Y con eso, el resultado:
| Resultado | Condición |
|---|---|
| valid | Al menos un VRP hace match con la ruta. |
| invalid | Al menos un VRP cubre la ruta, y ninguno hace match. |
| not found | Ningún VRP cubre la ruta. |
Fíjense en lo que el resultado no dice. Invalid no significa “ataque”: puede ser un ROA mal hecho. Not found no significa “sospechoso”: significa que el owner del prefijo no publicó ningún ROA. Y valid no significa “este camino es bueno”. Es la clase de cosas que van a preguntar en el examen.
rov.c implementa estas definiciones en menos de cien líneas de lógica, para
que las puedan seguir. Recibe un archivo de VRPs, un prefijo y un AS de origen.
El archivo vrps-example.txt tiene varios VRPs, entre ellos 198.51.100.0/24 24 64600: un ROA autoriza al AS 64600 a originar 198.51.100.0/24, con largo
máximo 24.
$ ./rov vrps-example.txt 198.51.100.0/24 64600
  cubierto por 198.51.100.0/24 max 24 AS 64600: largo ok, origen ok
valid
$ ./rov vrps-example.txt 198.51.100.0/24 64666
  cubierto por 198.51.100.0/24 max 24 AS 64600: largo ok, origen no coincide
invalid
$ ./rov vrps-example.txt 198.51.100.0/25 64600
  cubierto por 198.51.100.0/24 max 24 AS 64600: largo demasiado largo, origen ok
invalid
$ ./rov vrps-example.txt 198.51.100.0/25 64666
  cubierto por 198.51.100.0/24 max 24 AS 64600: largo demasiado largo, origen no coincide
invalid
$ ./rov vrps-example.txt 198.51.0.0/16 64600
not found
$ ./rov vrps-example.txt 198.51.101.0/24 64600
not found
Lean el caso de la tercera línea: el AS correcto anunciando una parte de su
propio bloque, y aun así invalid. El largo máximo es 24, así que esa
autorización no alcanza. Ese es el mecanismo que frena los más específicos. Y
lean el penúltimo: 198.51.0.0/16 contiene al prefijo del ROA, pero un VRP solo
cubre rutas iguales o más largas que él. El /16 es más corto, así que
nadie lo cubre.
Largo máximo mayor que el prefijo. El VRP 203.0.113.0/24 25 64601 autoriza
también los /25 de ese AS:
$ ./rov vrps-example.txt 203.0.113.128/25 64601
  cubierto por 203.0.113.0/24 max 25 AS 64601: largo ok, origen ok
valid
$ ./rov vrps-example.txt 203.0.113.128/26 64601
  cubierto por 203.0.113.0/24 max 25 AS 64601: largo demasiado largo, origen ok
invalid
Basta con un match. Si varios VRPs cubren una ruta, se revisan todos, y
basta uno que haga match. Con dos VRPs de 10.0.0.0/8, uno con AS 64700 y largo
máximo 16, y el otro con AS 64701 y largo máximo 8:
$ ./rov vrps-example.txt 10.1.0.0/16 64700
  cubierto por 10.0.0.0/8 max 16 AS 64700: largo ok, origen ok
  cubierto por 10.0.0.0/8 max 8 AS 64701: largo demasiado largo, origen no coincide
valid
$ ./rov vrps-example.txt 10.1.0.0/16 64701
  cubierto por 10.0.0.0/8 max 16 AS 64700: largo ok, origen no coincide
  cubierto por 10.0.0.0/8 max 8 AS 64701: largo demasiado largo, origen ok
invalid
AS 0. El RFC 6811 exige que el AS del VRP sea distinto de cero para hacer match. Un ROA con AS 0 no autoriza a nadie, así que todo lo que cubre queda invalid: es la forma de decir “este prefijo no debería anunciarse”.
$ ./rov vrps-example.txt 192.0.2.0/24 64600
  cubierto por 192.0.2.0/24 max 24 AS 0: largo ok, origen no coincide
invalid
RPKI en el laboratorio
Vamos a verlo en un router real. FRRouting trae el módulo bgpd_rpki, que se
activa con la opción -M rpki de bgpd; por eso a y d llevan su propio
archivo daemons. Lo único que falta es un cache.
Qué es real y qué no en esta parte. Los routers, el protocolo RTR, la clasificación y el descarte son los de verdad. El cache no:
bgp/cache/rtr_cache.pyes un programa nuestro, de unas cien líneas, que lee una lista fija de VRPs de un archivo de texto y la entrega por RTR. No descarga ROAs ni comprueba firmas, porque esos datos solo existen en la jerarquía real, con prefijos reales. Para esta semana, las VRPs del archivo se toman como si ya hubieran sido validadas.
$ cat bgp/cache/vrps.txt
# prefijo          largo-máximo  AS autorizado
100.64.1.0/24      24            64601
100.64.3.0/24      24            64603
La víctima y r1 publicaron su ROA; r4 y el atacante no. Le decimos a a
dónde está el cache, y nada más:
rpki
 rpki polling_period 5
 rpki cache tcp 10.207.9.2 8282 preference 1
$ docker exec clab-w07-bgp-a vtysh -c "show rpki cache-connection"
Connected to group 1
rpki tcp cache 10.207.9.2 8282 pref 1 (connected)
$ docker exec clab-w07-bgp-a vtysh -c "show rpki prefix-table"
RPKI/RTR prefix table
Prefix Prefix Length Origin-AS
100.64.3.0 24 - 24 64603
100.64.1.0 24 - 24 64601
Number of IPv4 Prefixes: 2
Number of IPv6 Prefixes: 0
$ docker exec clab-w07-bgp-cache cat /tmp/rtr.log
10.207.9.1: PDU tipo 2, versión 1
$ docker exec clab-w07-bgp-a vtysh -c "show bgp ipv4 unicast"
Network Next Hop Metric LocPrf Weight Path
V*> 100.64.1.0/24 10.207.4.1 0 0 64601 i
V*> 100.64.3.0/24 10.207.2.2 0 64630 64640 64620 64603 i
N*> 100.64.4.0/24 10.207.6.1 0 0 64604 i
N*> 100.64.66.0/24 10.207.5.1 0 0 64666 iEl tipo 2 de la bitácora del cache es un Reset Query: el router pide la tabla
completa. La primera columna de show bgp ya tiene los estados: V, N y más
adelante I. Validar no es descartar. Veámoslo con el hijack:
$ python3 scenarios.py same
$ docker exec clab-w07-bgp-a vtysh -c "show bgp ipv4 unicast"
     Network          Next Hop            Metric LocPrf Weight Path
V*>  100.64.1.0/24    10.207.4.1               0             0 64601 i
I*>  100.64.3.0/24    10.207.5.1               0             0 64666 i
N*>  100.64.4.0/24    10.207.6.1               0             0 64604 i
N*>  100.64.66.0/24   10.207.5.1               0             0 64666 i
$ docker exec clab-w07-bgp-h1 curl -s http://100.64.3.10:8080/
ATACANTE: AS 64666 recibio esta conexion
Ahí está el I, en la línea de la mejor ruta, y el tráfico sigue yendo al
atacante. Es lo que exige el RFC 6811: una implementación no debe excluir una
ruta por su estado de validación a menos que se configure explícitamente.
Considerar o no las inválidas es una decisión de política local. Hay que
escribirla:
route-map ROV deny 10
 match rpki invalid
route-map ROV permit 20

router bgp 64610
 address-family ipv4 unicast
neighbor 10.207.5.1 route-map ROV in(scenarios.py la aplica a todas las sesiones de a, no solo a esta.) A esto
se le llama Route Origin Validation, o ROV. Ojo con el permit 20: sin él, el
final implícito del route-map descartaría también lo válido y lo que no tiene
ROA.
$ python3 scenarios.py rov_a
$ docker exec clab-w07-bgp-a vtysh -c "show bgp ipv4 unicast"
     Network          Next Hop            Metric LocPrf Weight Path
V*>  100.64.1.0/24    10.207.4.1               0             0 64601 i
V*>  100.64.3.0/24    10.207.2.2                             0 64630 64640 64620 64603 i
N*>  100.64.4.0/24    10.207.6.1               0             0 64604 i
N*>  100.64.66.0/24   10.207.5.1               0             0 64666 i
$ docker exec clab-w07-bgp-h1 curl -s http://100.64.3.10:8080/
servidor legitimo de AS 64603
El /24 falso desapareció. Noten dos cosas más. Sigue pasando 100.64.66.0/24,
el prefijo del atacante, marcado N: no hay ROA que lo cubra, y descartar lo
not found dejaría sin servicio a todas las redes que no hayan publicado ROAs.
Y el /25 también queda fuera, gracias al largo máximo. Partiendo de reset:
$ python3 scenarios.py rov_a
$ python3 scenarios.py specific
$ docker exec clab-w07-bgp-r6 vtysh -c "show bgp ipv4 unicast 100.64.3.0/25"
BGP routing table entry for 100.64.3.0/25, version 38
Paths: (1 available, best #1, table default)
  Advertised to non peer-group peers:
  10.207.5.2
  Local
    0.0.0.0 from 0.0.0.0 (10.207.0.8)
      Origin IGP, metric 0, weight 32768, valid, sourced, local, best (First path received)
      Last update: Mon Nov  2 07:53:31 2026
$ docker exec clab-w07-bgp-a vtysh -c "show bgp ipv4 unicast 100.64.3.0/25"
% Network not in table
$ docker exec clab-w07-bgp-h1 curl -s http://100.64.3.10:8080/
servidor legitimo de AS 64603
Lo que RPKI no protege
Ahora la parte que más se malentiende. En cada caso de aquí en adelante partimos
de reset. Empezamos por el origen forjado. El RFC 6811 lo dice en su
sección 6: ROV no protege contra ataques AS-in-the-middle ni valida el camino,
y al atacante solo le hace falta poner el AS de origen “válido” antes de la
ruta que falsifica. El AS del AS_PATH no está firmado. Probemos:
$ python3 scenarios.py rov_a
$ python3 scenarios.py forged
$ docker exec clab-w07-bgp-a vtysh -c "show bgp ipv4 unicast 100.64.3.0/24"
BGP routing table entry for 100.64.3.0/24, version 43
Paths: (2 available, best #1, table default)
  Advertised to non peer-group peers:
  10.207.2.2 10.207.4.1 10.207.5.1 10.207.6.1
  64666 64603
    10.207.5.1 from 10.207.5.1 (10.207.0.8)
      Origin IGP, metric 0, valid, external, best (AS Path), rpki validation-state: valid
      Last update: Mon Nov  2 07:53:50 2026
  64630 64640 64620 64603
    10.207.2.2 from 10.207.2.2 (10.207.0.1)
      Origin IGP, valid, external, rpki validation-state: valid
      Last update: Mon Nov  2 07:53:48 2026
$ docker exec clab-w07-bgp-h1 curl -s http://100.64.3.10:8080/
ATACANTE: AS 64666 recibio esta conexion
Con una regla de exportación de tres líneas en r6, el AS_PATH queda 64666 64603. El último AS es la víctima, y RPKI queda satisfecho: rpki validation-state: valid, y la ruta gana por ser corta. La misma salida muestra
las dos rutas, ambas valid, y solo una es real. El RFC concluye que este
sistema debe verse más como una protección contra errores de configuración que
como una “seguridad” en sentido fuerte.
¿Y si el atacante hace lo mismo con el /25? Aquí es donde se gana o se pierde
con el largo máximo:
$ python3 scenarios.py rov_a
$ python3 scenarios.py forged_specific
$ docker exec clab-w07-bgp-a vtysh -c "show bgp ipv4 unicast 100.64.3.0/25"
% Network not in table
$ docker exec clab-w07-bgp-h1 curl -s http://100.64.3.10:8080/
servidor legitimo de AS 64603
El origen es correcto, pero el largo pasa del máximo, y queda invalid. Un
atacante con origen forjado solo tiene el /24, y debe competir por política.
Pero si la víctima hubiera publicado su ROA con un largo máximo de 25, “por si
acaso”, el mismo ataque pasa:
$ python3 scenarios.py rov_a_lax
$ docker exec clab-w07-bgp-a vtysh -c "show rpki prefix-table"
RPKI/RTR prefix table
Prefix                                   Prefix Length  Origin-AS
100.64.3.0                                  24 -  25   64603
100.64.1.0                                  24 -  24   64601
Number of IPv4 Prefixes: 2
Number of IPv6 Prefixes: 0
$ python3 scenarios.py forged_specific
$ docker exec clab-w07-bgp-a vtysh -c "show bgp ipv4 unicast 100.64.3.0/25"
BGP routing table entry for 100.64.3.0/25, version 53
Paths: (1 available, best #1, table default)
  Advertised to non peer-group peers:
  10.207.2.2 10.207.4.1 10.207.5.1 10.207.6.1
  64666 64603
    10.207.5.1 from 10.207.5.1 (10.207.0.8)
      Origin IGP, metric 0, valid, external, best (First path received), rpki validation-state: valid
      Last update: Mon Nov  2 07:54:27 2026
$ docker exec clab-w07-bgp-h1 curl -s http://100.64.3.10:8080/
ATACANTE: AS 64666 recibio esta conexion
Por este motivo el RFC 9319 recomienda
evitar el largo máximo en los ROAs salvo en casos específicos: un largo máximo
holgado autoriza /25 que nadie anuncia, y le regala al atacante espacio para
un más específico válido.
La adopción parcial. Solo protege donde se aplica. Si a no valida y d
sí, el /25 del atacante pasa a y c, y se detiene en d:
$ python3 scenarios.py rov_d
$ python3 scenarios.py specific
$ docker exec clab-w07-bgp-r1 vtysh -c "show ip route 100.64.3.10"
Routing entry for 100.64.3.0/25
  Known via "bgp", distance 20, metric 0, best
  Last update 00:00:04 ago
  * 10.207.4.2, via eth2, weight 1

$ docker exec clab-w07-bgp-d vtysh -c "show ip route 100.64.3.10"
Routing entry for 100.64.3.0/24
  Known via "bgp", distance 20, metric 0, best
  Last update 00:04:50 ago
  * 10.207.3.1, via eth2, weight 1

$ docker exec clab-w07-bgp-b vtysh -c "show ip route 100.64.3.10"
Routing entry for 100.64.3.0/24
  Known via "bgp", distance 20, metric 0, best
  Last update 00:04:50 ago
  * 10.207.8.1, via eth3, weight 1

$ docker exec clab-w07-bgp-r3 vtysh -c "show ip route 100.64.3.10"
Routing entry for 100.64.3.0/24
  Known via "connected", distance 0, metric 0, best
  Last update 00:04:52 ago
  * directly connected, eth1, weight 1

$ docker exec clab-w07-bgp-h1 curl -s http://100.64.3.10:8080/
ATACANTE: AS 64666 recibio esta conexiond, b y r3 se salvaron; c, a y r1, no. Tampoco basta con que la
víctima haga bien su parte. La víctima publicó su ROA, pero h1 igual llega al
atacante porque quienes validan no están en el camino.
El route leak. Una fuga conserva el origen original, así que RPKI no la ve:
$ python3 scenarios.py rov_a
$ python3 scenarios.py rov_d
$ python3 scenarios.py leak
$ docker exec clab-w07-bgp-a vtysh -c "show bgp ipv4 unicast"
     Network          Next Hop            Metric LocPrf Weight Path
V*>  100.64.1.0/24    10.207.4.1               0             0 64601 i
V*>  100.64.3.0/24    10.207.6.1                             0 64604 64620 64603 i
V*                    10.207.2.2                             0 64630 64640 64620 64603 i
N*>  100.64.4.0/24    10.207.6.1               0             0 64604 i
N*>  100.64.66.0/24   10.207.5.1               0             0 64666 i
La mejor ruta hacia 100.64.3.0/24 es la de la fuga, marcada V. Tiene un
valle y es valid.
El resumen, para aplicar en cualquier caso:
| Situación | ¿La detiene ROV? |
|---|---|
| Origen ajeno, mismo prefijo, con ROA del owner | Sí, si quien la recibe la descarta. |
| Más específico con origen ajeno, con ROA del owner | Sí. |
| Prefijo sin ROA | No: queda not found. |
| Origen forjado, dentro del largo máximo | No. |
| Origen forjado, más largo que el máximo | Sí. |
| Fuga con el mismo largo | No: el origen no cambió. |
| Fuga con más específicos, más largos que el máximo | Sí, por el largo. |
| Falla que no tiene que ver con anuncios falsos | No aplica. |
¿Qué habría hecho RPKI en los casos reales?
La arquitectura de RPKI se publicó en febrero de 2012, en el RFC 6480, así que en 2008 no era una opción. Pero es un buen ejercicio razonarlo.
- Pakistan Telecom y YouTube. Si YouTube hubiera tenido un ROA para
208.65.152.0/22con su AS, el anuncio de208.65.153.0/24con origen AS17557 habría quedado invalid, por el origen y también por el largo. Quienes aplicaran ROV lo habrían descartado. Quienes no, seguirían igual. - La fuga de 2019. Cloudflare escribe que firmaba sus prefijos con largo máximo 20, y que por eso RPKI indica que no se acepte ningún más específico, sin importar el camino: si Verizon hubiera usado RPKI, habría visto que las rutas anunciadas no eran válidas. Observen lo que hace el trabajo: el largo, no el camino. Si los más específicos no hubieran existido, es decir, si la fuga hubiera sido de los prefijos con el mismo largo, RPKI las habría marcado como válidas, igual que en nuestro laboratorio.
Más allá del origen
Si el problema del origen forjado es que nadie firma el camino, la respuesta natural es firmarlo. Eso es BGPsec (RFC 8205): cada AS que reenvía un UPDATE agrega una firma digital, y así todo el camino queda autorizado. Exige más cómputo en cada router y que los ASes del camino la tengan.
Para las fugas hay otra idea, más simple, en el RFC 9234: que cada lado declare su relación con el vecino en el OPEN (cliente, proveedor, peer), y que las rutas lleven una marca en el UPDATE, para prevenir y detectar los anuncios que violan esa relación.
Error común. Creer que RPKI cifra BGP o evita todo hijack. RPKI no cifra nada: los anuncios siguen viajando igual, y un ROA es un objeto firmado y público. Tampoco valida el camino. Solo ayuda a responder una pregunta, quién puede originar este prefijo, y solo donde alguien la haga y actúe según la respuesta.
Fallas que no son ataques: Facebook, octubre de 2021
No todo lo que sale mal en BGP es un anuncio falso. El 4 de octubre de 2021,
Facebook, Instagram y WhatsApp dejaron
de estar disponibles. Con las horas que da Cloudflare, del pico de cambios de
routing (hacia las 15:40 UTC) a la vuelta de facebook.com a su resolver (21:20
UTC), fueron cerca de seis horas. Tenemos dos fuentes muy buenas, una desde adentro y una desde afuera: el
informe de ingeniería de
Facebook
y el análisis de
Cloudflare.
El orden de los hechos importa, porque suele contarse mal:
- Un comando de mantenimiento. Según Facebook, durante un trabajo de rutina se emitió un comando para evaluar la capacidad disponible de su backbone global. Sin querer, dio de baja todas las conexiones de ese backbone, desconectando sus data centers entre sí y de Internet.
- La herramienta de auditoría falló. Sus sistemas auditan comandos como ese para evitar errores, pero un bug en la herramienta dejó que pasara.
- Los servidores DNS se retiraron solos. Y aquí entra BGP. Los servidores DNS de Facebook están diseñados para dejar de anunciar sus prefijos por BGP si ellos mismos no logran hablar con los data centers: lo interpretan como una señal de que su conexión de red no está sana. Al caer el backbone, todas esas ubicaciones se declararon enfermas y retiraron sus anuncios. Los servidores DNS siguieron funcionando, pero nadie podía alcanzarlos.
- Desde afuera. Cloudflare vio un pico de cambios de routing de AS32934
cerca de las 15:40 UTC, y a las 15:58 UTC notó que los prefijos de los
servidores DNS, como
185.89.218.0/23y129.134.30.0/23, ya no se anunciaban. Los resolvers públicos, sin poder contactar a esos servidores, empezaron a darSERVFAIL. - La recuperación fue lenta. Sin red, no había acceso remoto. Sin DNS,
tampoco herramientas internas. Hubo que enviar personal a los data centers,
cuyas medidas de seguridad física, diseñadas para que sea difícil modificar
los equipos, hicieron que tomara tiempo. Cloudflare vio volver la actividad
de BGP alrededor de las 21:00 UTC, y
facebook.comrespondió de nuevo en su resolver a las 21:20 UTC. - Tampoco se podía encender todo de una vez. Facebook restauró los servicios de forma gradual, porque el regreso repentino de toda la carga podía causar nuevas fallas. Atribuye parte de esa preparación a sus simulacros de falla (“storm”).
Lo que debe quedar claro: BGP no se equivocó. No hubo anuncio falso, ni fuga, ni hijack, y ningún filtro ni RPKI habrían ayudado. Los prefijos desaparecieron porque se retiraron de manera legítima, siguiendo una regla razonable, en el peor momento posible.
Las lecciones son de otro tipo, y aplican a cualquier sistema:
- Las dependencias circulares. Las herramientas para arreglar la red dependen de la red.
- Un mecanismo de seguridad puede ampliar la falla. Retirar un servidor DNS enfermo es lo correcto cuando se cae uno. Cuando todos deciden lo mismo al mismo tiempo, desaparece todo el servicio.
- Un error de configuración puede tener alcance global, y por eso los comandos se auditan.
Idea clave. Hijacks y fugas son anuncios que no debían existir. El caso de Facebook es el opuesto: anuncios que debían existir y se retiraron. En ambos, una decisión local se propaga a toda Internet en cuestión de minutos.
La estructura real de Internet
Empezamos ahora la Sesión B. En la semana 1 dibujamos la red de redes, y desde entonces hablamos de proveedores, peers y clientes. Toca ver cómo se ve de verdad, y por qué.
De la jerarquía a una red más plana
El modelo clásico es una jerarquía. CS168 lo describe así: cada AS que no es Tier 1 tiene al menos un proveedor, y siguiendo los proveedores hacia arriba siempre se llega a un Tier 1. Un Tier 1 no tiene proveedores y hace peering con todos los otros Tier 1. El mismo texto calcula que hay alrededor de 20 redes así o casi así. Los ASes más comunes, en cambio, son stubs: solo atienden a sus propios hosts y no llevan tráfico de nadie más.
Si ese modelo fuera toda la historia, el tráfico de Lima a Lima subiría muchas veces hasta un Tier 1, y bajaría de nuevo. No es así, y por dos fuerzas, que también aparecen en la sección 1.3.3 de Kurose y Ross:
- El peering entre redes del mismo nivel. Dos ISPs intercambian tráfico directamente, sin pagarle a nadie. Se ahorran un tránsito, y se acorta el camino.
- Las redes de contenido. Las grandes empresas de contenido construyeron sus
propias redes, que llegan directamente a muchos ISPs. Esas empresas compran
menos tránsito hacia arriba, porque conectan sus data centers directamente con
la red donde están los usuarios, y controlan mejor cómo llega su servicio. Lo
vimos en la semana 1: la traza a
www.ox.ac.ukllegó acdn.cloudflare.neten 55 ms, cuando Oxford exigiría más de 100 ms solo por la física. El contenido estaba más cerca que la universidad.
CS168 lo dice de otra manera: esas grandes empresas borran la frontera entre un stub y un AS de tránsito. Para nosotros, el resultado es que los caminos reales suelen ser más cortos de lo que indica la jerarquía, y una buena parte del tráfico nunca llega a la cima.
                 Tier 1 <--- peering ---> Tier 1
                    ^                       ^
             tránsito                   tránsito
                    |                       |
      ISP regional  <---- peering ---->  ISP regional
           |   \                           /    |
           |    \                         /     |
           |     +----- [ IXP ] ---------+      |
           |              |                     |
           |          red de contenido          |
           |                                    |
        ISP de acceso                     ISP de acceso
Tránsito y peering: cuánto cuesta cada uno
Las dos relaciones que hemos usado son un negocio:
| Tránsito | Peering | |
|---|---|---|
| ¿Qué se compra? | Acceso a toda Internet | Acceso a la red del otro y sus clientes |
| ¿Quién paga? | El cliente, a su proveedor | Normalmente nadie le paga al otro |
| ¿Cómo se paga? | Normalmente por volumen de tráfico | Lo que se paga es el equipo, el puerto y la conexión al lugar |
| ¿Qué tráfico pasa? | Todo lo que el cliente quiera | Solo el que va hacia el otro y sus clientes |
Por eso, dos ISPs deciden hacer peering cuando el ahorro en tránsito supera el costo de conectarse. CS168 observa que los peers suelen intercambiar cantidades parecidas de tráfico y que normalmente no se pagan entre sí. Es razonable pensar que, si el tráfico fuera muy desigual, uno de los dos podría argumentar que le están haciendo un servicio.
Ejemplo con números inventados. Los precios reales cambian mucho según el país, el volumen y el año; estos solo sirven para mostrar la cuenta.
Un ISP paga 1 dólar por Mbps al mes de tránsito. De su tráfico, 3000 Mbps van hacia otro ISP de la misma ciudad. Conectarse a un punto común (puerto, enlace y equipo) le cuesta 1200 dólares al mes.
- Sin peering: 3000 Mbps × 1 dólar = 3000 dólares al mes por ese tráfico.
- Con peering: 1200 dólares al mes, y el tráfico deja de pasar por el enlace pagado.
- Ahorro: 3000 − 1200 = 1800 dólares al mes.
Si solo fueran 500 Mbps, pagaría 500 dólares de tránsito contra 1200 de conectarse: no le conviene, salvo que el mismo punto común le dé acceso a muchas otras redes. Ese es el motivo por el que existen los IXPs: un solo puerto para hablar con muchos.
Además, el peering no reemplaza al tránsito: solo llega a la red del otro y a sus clientes. Y si un ISP le anuncia a un peer también sus rutas de proveedores, le estaría regalando tránsito. Ya vimos el nombre de ese error.
Qué es un IXP
Un IXP (Internet Exchange Point) es, físicamente, algo muy simple: un switch grande, o varios, en un edificio al que varias redes llevan un enlace. Cada red conecta un router al switch, y así queda en una misma LAN con todas las demás. Sobre esa LAN, cada par de redes que quiera abre una sesión eBGP.
Fíjense en lo que el IXP no hace: no es un router, no decide los caminos y no tiene su propia política. El camino sigue siendo decisión de cada AS.
Abrir sesiones con todos no escala: con N redes hacen falta N(N−1)/2 sesiones. Con 100 redes son 4950. Por eso, muchos IXPs ofrecen un route server: un equipo que recibe los anuncios de cada red y los reenvía a los demás, y con eso cada una abre una sola sesión. Ojo: el route server no está en el camino de los paquetes. Los paquetes van directo de un router a otro por el switch.
Lo medimos
La segunda topología, code/week-07/ixp/, tiene tres ISPs en una ciudad, un
proveedor de tránsito lejos y un IXP local al que los tres ya llegan, pero donde
nadie tiene todavía una sesión.
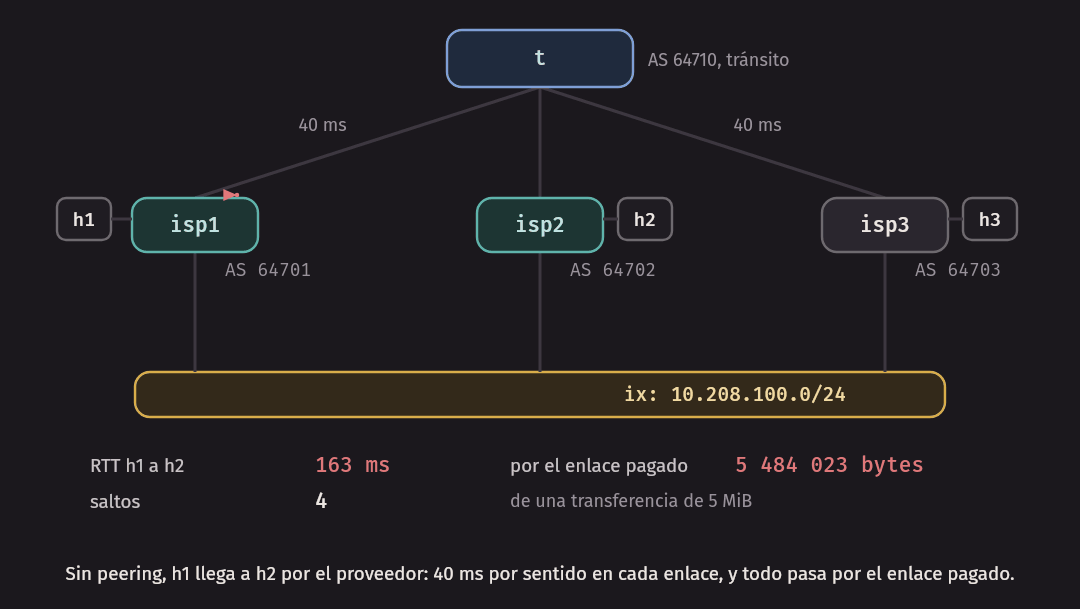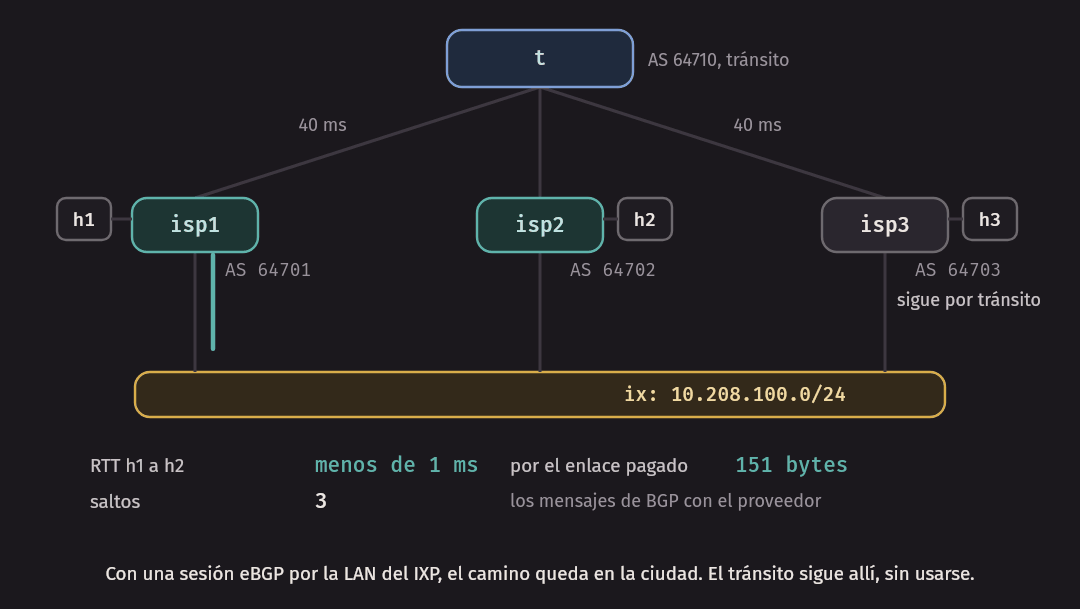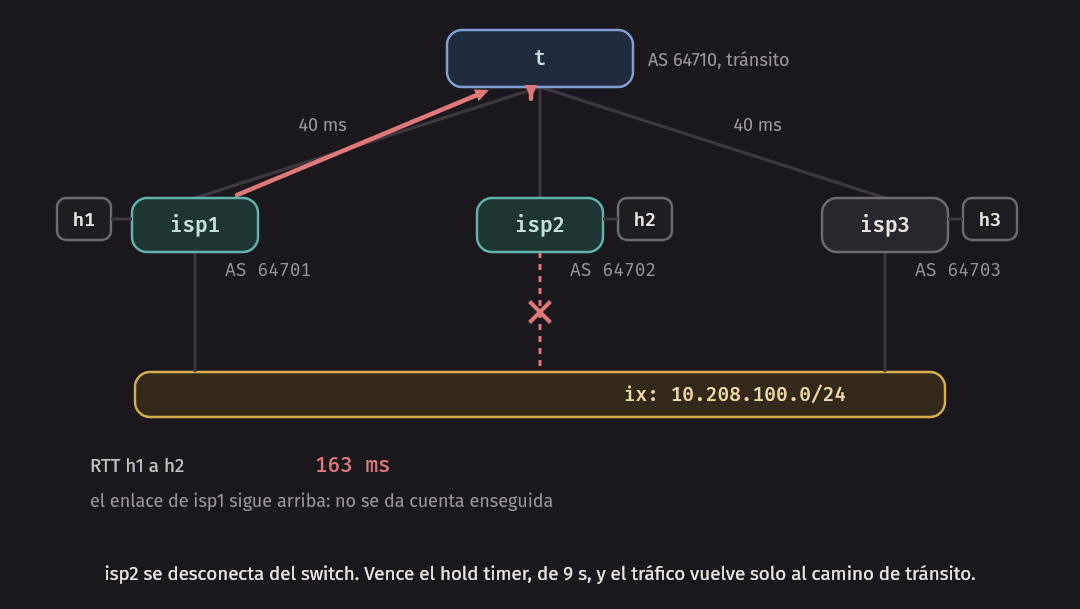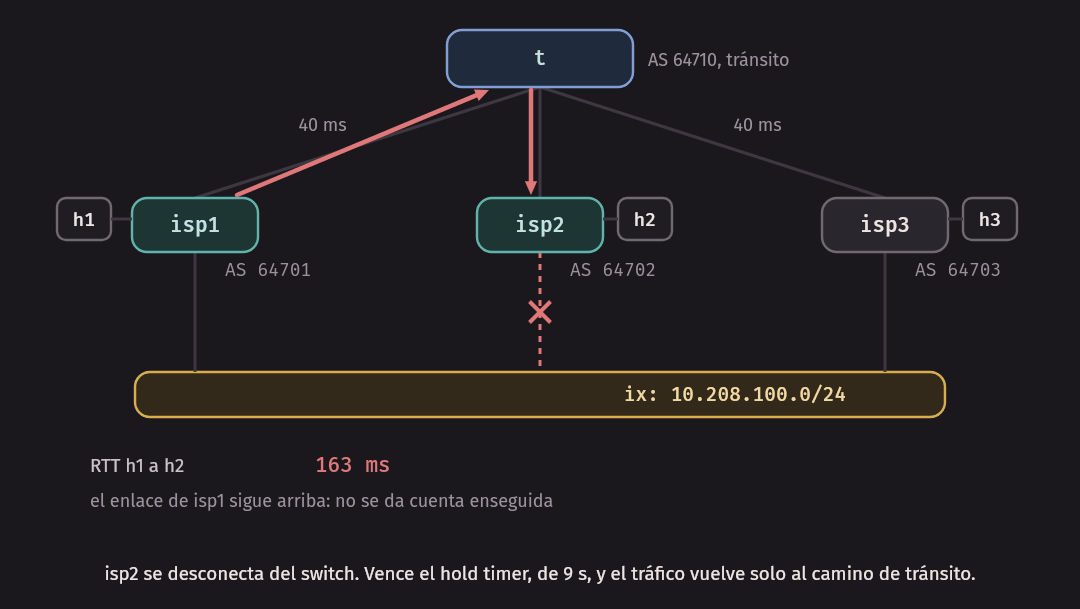
Cada enlace hacia t tiene 40 ms en cada sentido: como el cable hasta Miami que
medimos en la semana 1, con unos 80 ms de RTT. Es un retardo que elegimos
nosotros, con tc netem. Levantamos la topología con make up-ixp.
Primero el estado inicial: el tráfico entre dos ISPs vecinos va hasta el proveedor y vuelve.
$ docker exec clab-w07-ixp-h1 ping -c 5 -q 100.64.72.10
PING 100.64.72.10 (100.64.72.10): 56 data bytes

--- 100.64.72.10 ping statistics ---
5 packets transmitted, 5 packets received, 0% packet loss
round-trip min/avg/max = 163.003/163.327/163.975 ms
$ docker exec clab-w07-ixp-h1 traceroute -n -w 1 100.64.72.10
traceroute to 100.64.72.10 (100.64.72.10), 30 hops max, 46 byte packets
 1  100.64.71.1  0.003 ms  0.004 ms  0.002 ms
 2  10.208.1.2  81.855 ms  81.972 ms  82.051 ms
 3  10.208.2.1  162.883 ms  163.983 ms  162.111 ms
 4  100.64.72.10  163.813 ms  162.196 ms  162.939 ms
$ docker exec clab-w07-ixp-isp1 vtysh -c "show bgp ipv4 unicast"
     Network          Next Hop            Metric LocPrf Weight Path
 *>  100.64.71.0/24   0.0.0.0                  0         32768 i
 *>  100.64.72.0/24   10.208.1.2                             0 64710 64702 i
 *>  100.64.73.0/24   10.208.1.2                             0 64710 64703 i
Son 163 ms entre dos computadoras de la misma ciudad. El salto 2 es el
proveedor: 82 ms hasta allá. Y isp1 paga por todo ese tráfico. Para medirlo,
leemos el contador del enlace pagado mientras transferimos 5 MiB:
$ docker exec clab-w07-ixp-t cat /sys/class/net/eth1/statistics/rx_bytes
1920
$ docker exec clab-w07-ixp-h1 iperf3 -c 100.64.72.10 -n 5M
$ docker exec clab-w07-ixp-t cat /sys/class/net/eth1/statistics/rx_bytes
5485943
(Omitimos la salida de iperf3, que aquí solo interesa como carga.) Casi 5.5
millones de bytes entraron a t por ese enlace. Son los 5 MiB (5 242 880 bytes)
más los encabezados. Ahora abrimos el peering entre isp1 e isp2, por la LAN
del IXP.
sh ixp/peering.shSon dos sesiones eBGP normales (mírenlas en el script). Cada lado usa una regla
de exportación: solo le ofrece al peer las rutas que él origina. Sin ella,
isp1 le estaría ofreciendo al otro la ruta a isp3, y eso sería darle
tránsito gratis.
$ docker exec clab-w07-ixp-isp1 vtysh -c "show bgp summary"
Neighbor        V         AS   MsgRcvd   MsgSent   TblVer  InQ OutQ  Up/Down State/PfxRcd   PfxSnt Desc
10.208.1.2      4      64710       123       124        4    0    0 00:05:51            2        3 t (proveedor)
10.208.100.2    4      64702         6         6        4    0    0 00:00:07            1        1 isp2 (peer por el
$ docker exec clab-w07-ixp-isp1 vtysh -c "show bgp ipv4 unicast"
     Network          Next Hop            Metric LocPrf Weight Path
 *>  100.64.71.0/24   0.0.0.0                  0         32768 i
 *>  100.64.72.0/24   10.208.100.2             0             0 64702 i
 *                    10.208.1.2                             0 64710 64702 i
 *>  100.64.73.0/24   10.208.1.2                             0 64710 64703 i
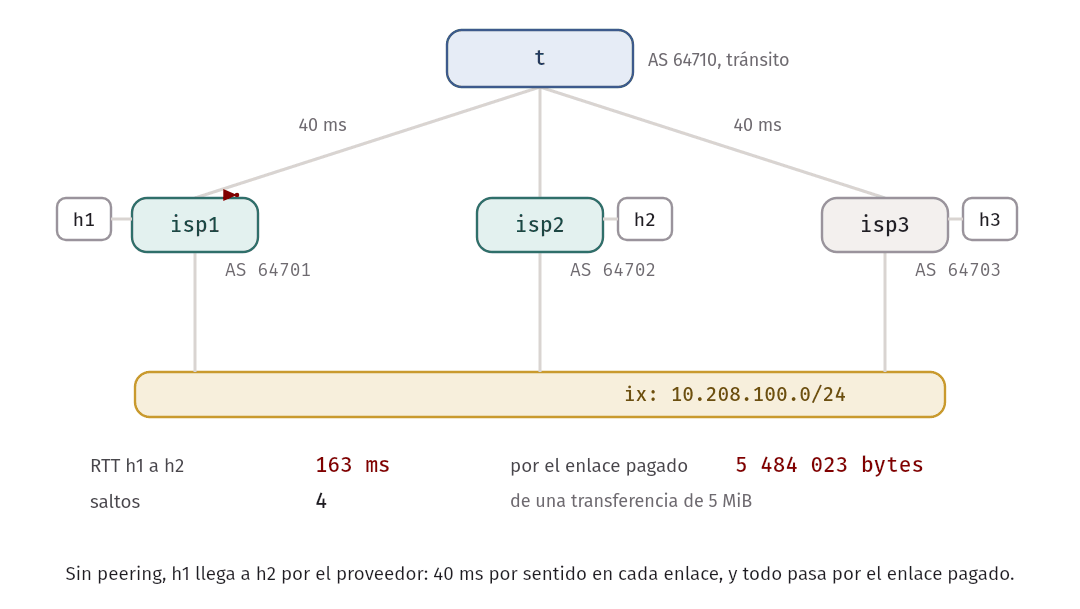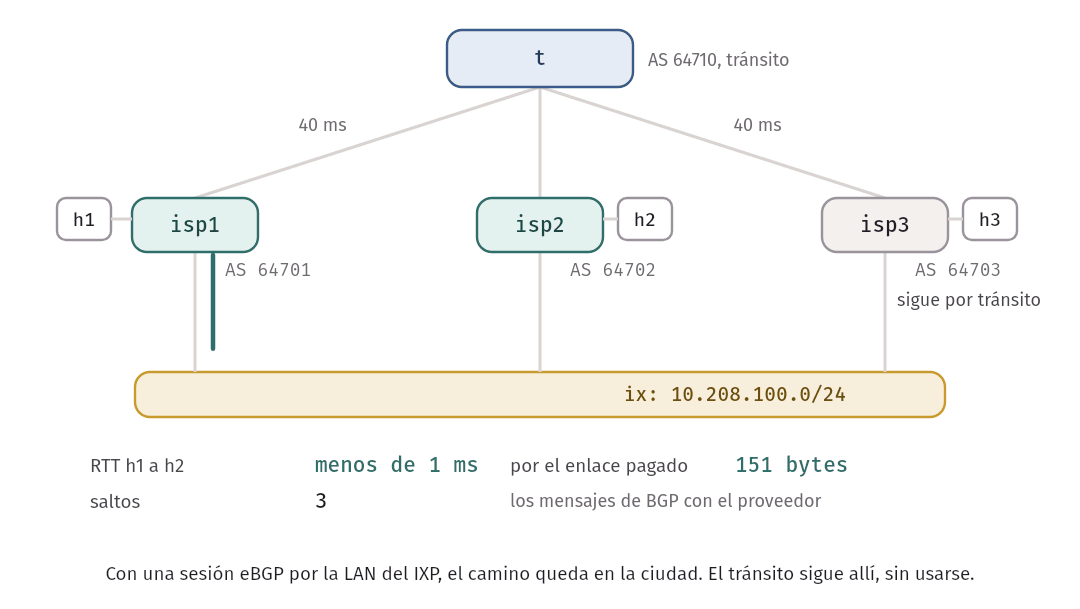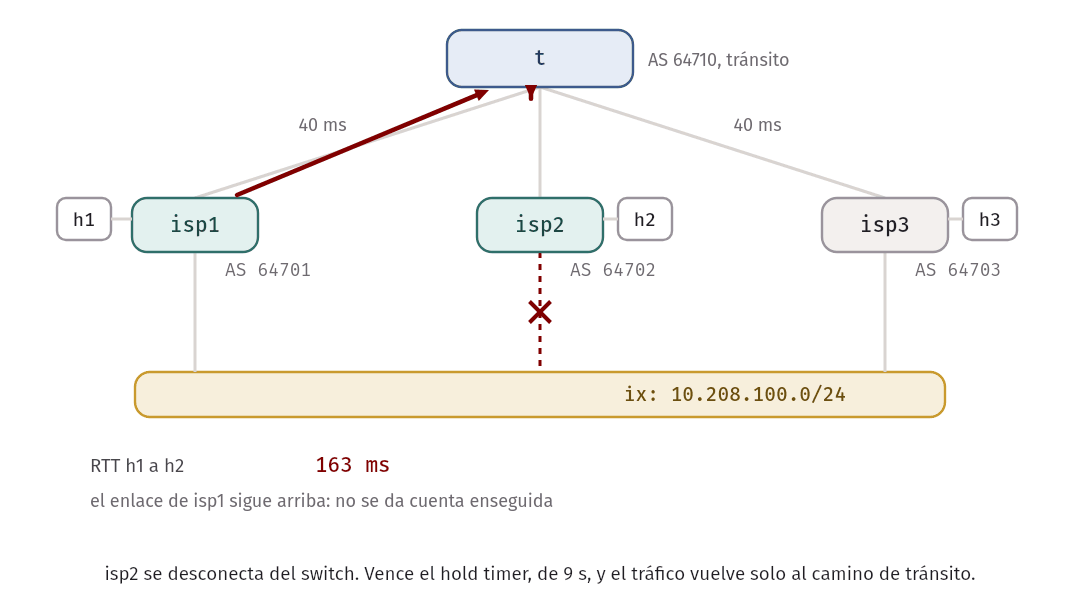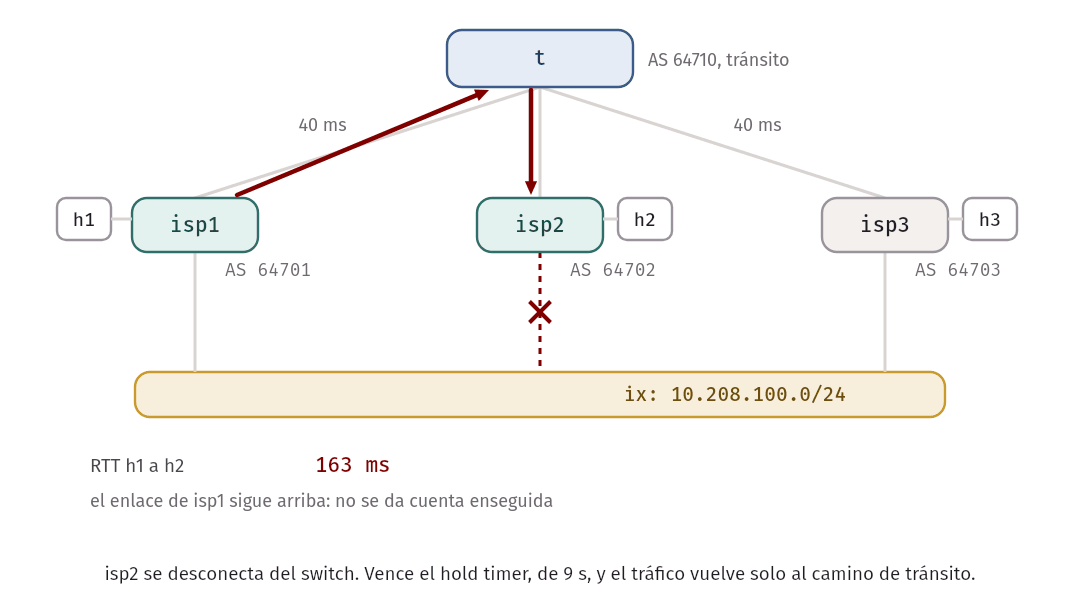
Ahora hay dos caminos a isp2, y el más corto es el del peer. El de tránsito
sigue allí, sin usarse. Y isp3, que no hizo peering con nadie, sigue por
tránsito. Comparemos:
$ docker exec clab-w07-ixp-h1 ping -c 5 -q 100.64.72.10
PING 100.64.72.10 (100.64.72.10): 56 data bytes

--- 100.64.72.10 ping statistics ---
5 packets transmitted, 5 packets received, 0% packet loss
round-trip min/avg/max = 0.092/0.219/0.605 ms
$ docker exec clab-w07-ixp-h1 traceroute -n -w 1 100.64.72.10
traceroute to 100.64.72.10 (100.64.72.10), 30 hops max, 46 byte packets
 1  100.64.71.1  0.005 ms  0.003 ms  0.005 ms
 2  10.208.100.2  0.002 ms  0.004 ms  0.004 ms
 3  100.64.72.10  0.002 ms  0.005 ms  0.004 ms
$ docker exec clab-w07-ixp-h1 ping -c 5 -q 100.64.73.10
PING 100.64.73.10 (100.64.73.10): 56 data bytes

--- 100.64.73.10 ping statistics ---
5 packets transmitted, 5 packets received, 0% packet loss
round-trip min/avg/max = 163.220/164.341/165.471 ms
El contador del enlace pagado, con otra transferencia de 5 MiB:
$ docker exec clab-w07-ixp-t cat /sys/class/net/eth1/statistics/rx_bytes
5486514
$ docker exec clab-w07-ixp-h1 iperf3 -c 100.64.72.10 -n 5M
$ docker exec clab-w07-ixp-t cat /sys/class/net/eth1/statistics/rx_bytes
5486665| Sin peering | Con peering | |
|---|---|---|
RTT h1 a h2 |
163 ms | menos de 1 ms |
| Saltos | 4 | 3 |
| Bytes de esa transferencia por el enlace pagado | 5 484 023 | 151 |
Los 151 bytes son los mensajes de BGP con el proveedor, que siguen corriendo. Los 163 ms salen del retardo que elegimos para el laboratorio. Lo que no depende de esa elección es la idea: sin peering, el retardo depende de la distancia al proveedor; con peering, de la distancia dentro de la ciudad.
¿Y qué pasa si el IXP falla? Desconectamos a isp2 del switch. El enlace de
isp1 sigue arriba, así que isp1 no se da cuenta enseguida. La sesión se cae
cuando vence el hold timer, que aquí es de 9 segundos (lo configuramos corto con
timers bgp 3 9), y el tráfico vuelve al camino de tránsito:
$ docker exec clab-w07-ixp-ix ip link set eth2 down
$ docker exec clab-w07-ixp-isp1 vtysh -c "show bgp summary"
Neighbor        V         AS   MsgRcvd   MsgSent   TblVer  InQ OutQ  Up/Down State/PfxRcd   PfxSnt Desc
10.208.1.2      4      64710       131       133        5    0    0 00:06:15            2        3 t (proveedor)
10.208.100.2    4      64702        10        13        0    0    0 00:00:04      Connect        0 isp2 (peer por el
$ docker exec clab-w07-ixp-h1 ping -c 3 -q 100.64.72.10
PING 100.64.72.10 (100.64.72.10): 56 data bytes

--- 100.64.72.10 ping statistics ---
3 packets transmitted, 3 packets received, 0% packet loss
round-trip min/avg/max = 162.113/163.193/164.182 ms
$ docker exec clab-w07-ixp-ix ip link set eth2 up
$ docker exec clab-w07-ixp-h1 ping -c 3 -q 100.64.72.10
PING 100.64.72.10 (100.64.72.10): 56 data bytes

--- 100.64.72.10 ping statistics ---
3 packets transmitted, 3 packets received, 0% packet loss
round-trip min/avg/max = 0.065/0.098/0.130 ms
Volvió a 163 ms mientras duró la falla y se recuperó sola. Por eso se conserva el tránsito aun teniendo peering: el peering no alcanza a toda Internet, y sirve de respaldo.
Idea clave. Un IXP local baja el retardo entre dos ISPs de la misma ciudad porque cambia el camino: el tráfico deja de ir hasta el proveedor común y volver. No hace el enlace más rápido: quita distancia. Y baja los costos porque ese tráfico deja de pasar por un enlace pagado.
El caso del Perú
En la semana 1 mencionamos el NAP Perú, que se presenta en su sitio como una institución privada que agrupa a los principales operadores de telecomunicaciones y proveedores de acceso a Internet del país.
Comparen dos de las trazas que se hicieron en la semana 1 desde una conexión doméstica en el Perú:
$ traceroute -n -q 3 -w 2 -m 22 www.uni.edu.pe
 ...
 5  181.177.224.6  5.601 ms  5.040 ms  6.637 ms
 6  45.5.68.100  11.603 ms  5.765 ms  6.462 ms
 7  45.183.47.179  5.896 ms  4.633 ms  6.118 ms
 ...
 9  10.2.18.14  6.389 ms  6.353 ms  6.635 ms
$ traceroute -q 3 -w 2 -m 14 www.uct.ac.za
...
6 8.243.120.5 (8.243.120.5) 10.167 ms 6.497 ms 6.092 ms
7 * * *
8 4.68.38.70 (4.68.38.70) 82.491 ms 83.350 ms 82.815 ms
9 ce-2-0-2.a02.miamfl02.us.ce.gin.ntt.net (129.250.200.114) 82.401 ms 82.054 ms 82.488 ms
10 et-0-0-1-66.rt04.bb.ampath.net (170.39.8.30) 82.700 ms 82.417 ms 82.540 ms
11 187-185-103-190.ampath.net (190.103.185.187) 241.758 ms 241.256 ms 241.834 msLa primera se queda cerca, en 6 ms. Omitimos el salto 8, el router lento en contestar que explicamos en la semana 1: el salto 9, más lejos, vuelve a 6 ms. La segunda da el gran salto de 6 a 82 ms entre los saltos 6 y 8. En la semana 1 calculamos que el mínimo teórico hasta Miami, a 4200 km en línea recta, es de 42 ms de RTT; medimos 76 de aumento. Eso es un cable submarino, y también es el precio de que un contenido no esté en el país.
Y los cables no son infinitos. Según Submarine Networks, Lurín es la puerta de entrada internacional de telecomunicaciones del Perú, y allí llegan los cables que lista esa página: Pan-America, South American Crossing, SAm-1 y Pacific Cable; SAm-1 también tiene una estación en Máncora. El cable Mistral, de unos 7300 km según Telxius, que une Guatemala con Chile, también tiene un punto de aterrizaje en Lurín.
¿Por qué importa todo esto en un país como el Perú? Por lo que vimos:
- Por el retardo. Un contenido fuera del país suma decenas de milisegundos por trayecto, sin que se pueda evitar: es física. La única forma de bajar eso es traer el contenido cerca, con caché local o data centers en el país, y evitar que el tráfico entre peruanos salga del Perú, con peering local.
- Por el costo. El tránsito internacional cuesta, y cada mega que se queda en el país deja de pagarlo.
- Por la resiliencia. Pocos puntos físicos de salida quieren decir pocos puntos de falla. Las mismas reglas de BGP que vimos con el IXP hacen que el tráfico busque otro camino, si existe, y con el retardo que tenga.
En la práctica. Repitan la comparación en su casa, fuera del contenedor: un sitio peruano, un sitio de otro continente y uno de una CDN. Busquen el salto en el que el RTT sube y se queda alto. Eso es lo que pide el ejercicio de esta semana. Los resultados dependen de su proveedor: si su ISP y el del sitio no tienen peering, hasta un sitio peruano puede dar la vuelta por afuera.
Repaso guiado para el parcial
El examen de la semana 8 cubre las semanas 1 a 7. Estos problemas son del tipo que se espera. Resuélvanlos primero sin mirar, porque así es el examen. Las respuestas están enseguida de cada uno.
Semana 1: retardos
Problema. Un paquete de 1500 bytes cruza un enlace de 100 Mbps y 4200 km, con propagación a 2×10⁸ m/s. ¿Cuánto tarda en total? ¿Qué pasa si el enlace sube a 1 Gbps?
Respuesta. Transmisión: 12 000 bits / 100 Mbps = 0,12 ms. Propagación: 4 200 000 m / 2×10⁸ m/s = 21 ms. Total: 21,12 ms. Con 1 Gbps, la transmisión baja a 0,012 ms y el total a 21,012 ms. Un enlace más rápido casi no ayuda a un paquete en un camino largo; lo que manda es la propagación.
Semana 2: TCP, UDP y sockets
Problema. Un servidor en C hace socket, bind, listen y accept. ¿Cuál
de esas llamadas hace falta para un servidor UDP? ¿Qué devuelve accept? ¿Qué
le garantiza TCP a una aplicación que UDP no?
Respuesta. UDP solo necesita socket y bind, y luego recvfrom, porque
no hay conexión. accept devuelve un socket nuevo, para esa conexión; el
original sigue escuchando. TCP garantiza entrega confiable y en orden de un
stream de bytes, además de control de flujo y de congestión. UDP solo entrega
datagramas sueltos, y ni eso con seguridad. Ninguno de los dos garantiza retardo
ni throughput.
Semana 3: CRC
Problema. Calculen los bits de CRC para los datos 1101011 con el generador
1011.
Respuesta. El generador tiene 4 bits, así que se agregan 3 ceros:
1101011000. Con división módulo 2 sobre esa secuencia, el resto es 110. Se
envía 1101011110. Para comprobar, dividan esta secuencia por 1011: el resto
debe dar 000.
Semana 4: CIDR y longest prefix match
Problema. Dividan 10.207.16.0/23 para LANs de 200, 100 y 30 hosts,
asignando las más grandes primero. Luego, con las rutas 10.207.0.0/16 → A,
10.207.16.0/24 → B, 10.207.16.128/25 → C y 0.0.0.0/0 → D, ¿por dónde sale
10.207.16.200? ¿Y 10.207.17.1? ¿Y 10.208.0.1?
Respuesta. 200 hosts piden /24 (254): 10.207.16.0/24. 100 hosts piden
/25 (126): 10.207.17.0/25. 30 hosts piden /27 (30, justo, sin contar la interfaz del router; contándola serían 31 y haría falta un /26): 10.207.17.128/27.
10.207.16.200 coincide con A, B y C, y gana C, el más largo. 10.207.17.1
solo coincide con A y D, y gana A. 10.208.0.1 solo coincide con D.
Semana 4: seguir un paquete
Problema. Un host con 10.0.0.5 detrás de un NAT, cuya dirección pública es
100.64.0.2, abre una conexión TCP a 100.64.9.10:80. Entre el host y el
servidor hay dos routers. ¿Qué campos cambian en cada salto? ¿Qué ve el
servidor?
Respuesta. En cada salto cambian las MAC de origen y destino, baja el
TTL y, por eso, se recalcula el checksum de IP. Las IP no cambian, salvo en el NAT. Allí el origen pasa de 10.0.0.5:p a
100.64.0.2:p', y se recalcula también el checksum de TCP. El servidor ve 100.64.0.2:p' y
responde a esa dirección. El NAT usa su tabla para deshacer el cambio en la
respuesta.
Semana 5: Dijkstra
Problema. Un grafo tiene los costos u-v 3, u-w 7, u-x 5, v-w 2,
v-y 6, w-x 1, w-y 3, w-z 8, x-z 6 y y-z 2. Corran Dijkstra desde
u.
Respuesta. Con D(v) como el costo tentativo hasta cada nodo:
| Paso | Agrega | D(v) | D(w) | D(x) | D(y) | D(z) |
|---|---|---|---|---|---|---|
| 0 | u |
3, u | 7, u | 5, u | ∞ | ∞ |
| 1 | v |
5, v | 5, u | 9, v | ∞ | |
| 2 | w |
5, u | 8, w | 13, w | ||
| 3 | x |
8, w | 11, x | |||
| 4 | y |
10, y | ||||
| 5 | z |
Hay un empate entre w y x en el paso 2: cualquier orden da el mismo
resultado final. Costos finales: v 3, w 5, x 5, y 8 y z 10. El camino
a z es u-v-w-y-z.
Semana 5: vector de distancias
Problema. Tres routers forman un triángulo, con costos a-b 2, b-c 3 y
a-c 9. El costo de b-c sube a 40. Muestren cómo cambian los costos hacia
c, primero sin poison reverse y después con él.
Respuesta. Antes: D_a(c) = 5 (por b), D_b(c) = 3 (directo).
Sin poison reverse, b recalcula con lo último que oyó de a: min(40, 2 + 5) =
7, por a. Pero el 5 de a pasaba por b, y es falso.
| Iteración | D_b(c) | D_a(c) |
|---|---|---|
b recalcula |
7, por a |
5 |
a recibe 7 |
7 | min(9, 2 + 7) = 9, directo |
b recibe 9 |
min(40, 2 + 9) = 11, por a |
9 |
a recibe 11 |
11 | min(9, 2 + 11) = 9 |
Termina con D_a(c) = 9 y D_b(c) = 11. Con poison reverse, a le anuncia a b
un costo ∞ hacia c, porque su camino pasa por b. Entonces b calcula
min(40, ∞) = 40, directo. a recibe 40 y calcula min(9, 42) = 9, directo. b
recibe 9 y calcula min(40, 11) = 11. Llega a lo mismo, sin pasar por el valor
falso de 7. Aun así, poison reverse no resuelve los ciclos de tres o más nodos.
Semanas 6 y 7: políticas de BGP
Problema. Los AS son: P proveedor de X e Y; X e Y peers entre sí;
X proveedor de C1; Y proveedor de C2. Si todos cumplen las reglas de
exportación, ¿qué camino elige C1 para llegar a C2? ¿X le anuncia a P la
ruta a C2? ¿Y si X aprende de Y una ruta hacia un cliente de Y, y se la
pasa a P?
Respuesta. X aprende la ruta a C2 de dos lugares: de Y, por peering,
con AS_PATH Y C2; y de P, con P Y C2. Elige la del peer: es más corta y,
por política, los peers van antes que los proveedores. C1 recibe de X el
camino X Y C2. X no le anuncia a P esa ruta, porque la aprendió de un
peer: las rutas de peers solo van a clientes. Si lo hiciera, sería un route
leak: un camino con valle, en el que X lleva gratis tráfico de P hacia su
peer.
Semana 7: leer una tabla
Problema. Vean esta salida del laboratorio, de a durante una fuga con ROV
activado:
V*>  100.64.3.0/24    10.207.6.1                             0 64604 64620 64603 i
V*                    10.207.2.2                             0 64630 64640 64620 64603 i
¿Cuál se está usando? ¿Por qué? ¿Quién la origina? ¿Por qué RPKI no ayuda aquí?
¿Quién es 64604 para a?
Respuesta. Se usa la primera, por el >: es más corta, 3 contra 4. Ambas
las origina 64603, el último del AS_PATH, y por eso ambas son valid. RPKI
solo mira el origen y el largo del prefijo: no ve que la primera tiene un valle.
Para a, 64604 es un cliente que le está ofreciendo llegar a un AS que no es
cliente suyo: 64620 es su proveedor. Eso es la fuga.
El laboratorio de la semana y make test
La carpeta code/week-07/ tiene dos topologías, las pruebas y una herramienta
en C:
| Archivo | Qué es |
|---|---|
bgp/bgp.clab.yml |
Los AS de la Sesión A, con el atacante y el cache |
bgp/cache/rtr_cache.py |
Cache RTR mínimo, con una lista fija de VRPs |
bgp/cache/vrps.txt, vrps-lax.txt |
Las dos listas de VRPs |
ixp/ixp.clab.yml, ixp/peering.sh |
Tres ISPs, tránsito e IXP; abrir y cerrar el peering |
scenarios.py |
Los escenarios: ataques, fuga y defensas |
rov.c, vrps-example.txt |
Clasificador del RFC 6811 |
lab/filters-a.conf, lab/filters-b.conf |
Lo que ustedes completan |
test_rov.py, test_bgp.py, test_ixp.py |
Las pruebas |
Pasos del laboratorio. Para cada uno, antes de ejecutar, predigan el resultado con la topología y el proceso de decisión de BGP.
- Línea base.
make up. Comprueben queh1, en el AS 64601, alcanza asrv, en el AS 64603, concurlytraceroute. - Mismo prefijo.
python3 scenarios.py same. Llenen una tabla: para cada AS, qué ruta eligió y por qué criterio. ¿Quiénes cambiaron de ruta y quiénes no? - Más específico.
reset, y luegospecific. Comprueben que ahora el tráfico se desvía desde todos lados, incluida la víctima, y expliquen por qué, con los dos planos. Prueben las dos direcciones desrv. - Route leak.
reset,slow_r4, y luegoleak. Lean las rutas deby dea, y sigan el tráfico contraceroute. Midan conpingeiperf3antes y después. - El filtro. Completen
lab/filters-a.confylab/filters-b.conf: queaybacepten de cada cliente solo el bloque que le corresponde. Se cargan conpython3 scenarios.py filters. Repitan los dos ataques y la fuga, y luego el ataque con origen forjado,forged. Las direcciones y los nombres de cada sesión están en los comentarios de esos archivos. - RPKI. Repitan los ataques con
rov_a,rov_d,forgedyrov_a_lax, y llenen la tabla: ¿qué detuvo cada defensa? Discutan en grupo: ¿qué tendría que cambiar para que RPKI hubiera detenido cada ataque? ¿Cuáles nunca podría detener? - IXP.
make up-ixp. Midan RTT y bytes por el enlace de tránsito antes y después desh ixp/peering.sh, y bajen el enlace con el IXP. - Avancen con P2. Lo que vieron aquí les sirve para entender qué se les pide, pero la red de P2 es otra: tiene varios routers, iBGP y una relación distinta con cada vecino. El archivo de filtros de este laboratorio no se puede copiar: tienen que escribir el de ustedes.
make test levanta cada topología, corre todos los escenarios y comprueba lo
que dicen estos apuntes. Destruye todo al terminar, incluso si algo falla. Tarda
unos minutos. Las pruebas de F_Filters se saltan hasta que quiten la línea
TODO de sus archivos de filtros.
Error común. Olvidar
python3 scenarios.py resetentre pasos. Un escenario no deshace el anterior, y los resultados se mezclan. Con los filtros, recuerden usar los nombresCLIENTE-R1,CLIENTE-R3,CLIENTE-R4yCLIENTE-R6que indican los comentarios:resetlos busca por nombre para quitarlos.
Resumen
- BGP no verifica lo que se le anuncia: ni que el origen tenga derecho, ni que el camino exista. La sesión se puede proteger, pero el contenido del mensaje no.
- Un prefix hijack es originar un prefijo ajeno. Con el mismo prefijo,
gana solo donde la política y el largo del camino lo favorecen, y la red se
parte en dos. Con un más específico, gana en todo lugar que lo acepte,
porque lo decide longest prefix match, sin comparar el
AS_PATH. Hasta la víctima cae. - YouTube, 2008: AS17557 anunció un
/24dentro del/22de YouTube. Se propagó por AS3491. YouTube anunció el mismo/24y luego dos/25. Terminó a las 21:01 UTC cuando AS3491 retiró las rutas. - Una víctima solo puede anunciar más específicos, que tienen un límite práctico, o llamar a los proveedores del atacante.
- Un route leak es propagar un anuncio más allá de su alcance previsto. El origen puede ser correcto. Lo típico es un AS que pasa rutas de un proveedor a otro. El cliente chico se vuelve tránsito, y el tráfico sufre su capacidad.
- La fuga de 2019: los más específicos del optimizador de AS33154 pasaron por AS396531 a AS701, que los propagó. Cloudflare perdió cerca del 15 % de su tráfico global en el peor momento.
- Defensas sin criptografía: filtros de prefijos en cada sesión, en especial
en las de clientes, con los largos exactos; y
maximum-prefix, que detecta las fugas grandes, y no las pequeñas. Protegen a los demás, no a quien los configura. - RPKI: un ROA firmado autoriza un AS a originar un prefijo, hasta un largo máximo. Un cache valida los ROAs y entrega VRPs por RTR. La comparación da valid, invalid o not found. Marcar no es descartar: el descarte es política local.
- Lo que RPKI no hace: no cifra nada, no valida el camino, no detiene el origen forjado dentro del largo máximo, ni las fugas del mismo largo, y no protege donde no se aplica. BGPsec firma el camino; el RFC 9234 ataca las fugas.
- Facebook, 2021: un comando de mantenimiento bajó el backbone, un bug dejó pasar el comando, y los servidores DNS retiraron sus propias rutas por su diseño de salud. BGP hizo lo que le pidieron.
- La Internet no es solo una jerarquía: peering y redes de contenido la aplanan. El tránsito se paga a un proveedor y da toda Internet; el peering da solo la red del otro y sus clientes.
- Un IXP es un switch compartido. Baja el retardo porque acorta el camino, y baja el costo porque el tráfico deja el enlace pagado. El tránsito queda como respaldo.
- En el Perú, los cables internacionales llegan a pocos lugares, entre ellos Lurín. Por eso importa mantener local el tráfico local y traer el contenido cerca.
Ejercicios
- Clasifiquen a mano como valid, invalid o not found, contra un solo ROA de
203.0.113.0/24con largo máximo 25 y AS 64600 (escriban un archivo de VRPs con esa línea):203.0.113.0/24desde 64600,203.0.113.0/25desde 64600,203.0.113.0/26desde 64600,203.0.113.0/24desde 64601,203.0.0.0/16desde 64600 y198.51.100.0/24desde 64600. Comprueben con./rov <su-archivo> <prefijo> <as>. - Un atacante anuncia
198.51.100.0/23, y la víctima,198.51.100.0/24. ¿A dónde va el tráfico hacia198.51.100.5? ¿Y hacia198.51.101.5? ¿Funciona este ataque? ¿Qué le conviene al atacante? ¿Qué diría RPKI, con un ROA198.51.100.0/24de la víctima con largo máximo 24? - Para la topología de la Sesión A, predigan qué AS cambian de ruta si el
atacante está conectado a
ben lugar de aa. Hagan una tabla como la de la sección de hijack, sin correr nada. Luego indiquen quién queda en empate. - Con la misma topología original, el atacante usa el escenario
same, yaempieza a preferir sus rutas de clientes conlocal-preference. ¿Cambia algo paraa? ¿Y parac, si hace lo mismo? ¿Y parad? Hagan la predicción y compruébenla en el laboratorio, poniendo elset local-preferencedonde corresponda. - Un AS recibe de un cliente una ruta a un prefijo de otra red, con un
AS_PATHque termina en el AS real de esa red. ¿Qué filtro lo habría evitado? ¿RPKI la habría marcado como inválida? ¿Es un hijack o una fuga? Justifiquen. - Simulen el optimizador de 2019 en
r4, para los dos/25de100.64.1.0/24: dos rutas estáticas haciaa(10.207.6.2),networkpara cada una, y unroute-mapde salida solo haciabque les antepone64610 64601, para que parezcan rutas aprendidas. ¿Por qué hace falta queano las reciba, y por qué sirve anteponer esos números? ¿Qué pasa ahora end, comparado con la fuga que vimos? ¿Qué diría RPKI, con el ROA devrps.txt? - En
max_prefix, cambien el límite para queatambién corte la sesión. ¿Con qué valor lo logran? ¿Qué le pasa ahora a la red der4? ¿Por qué alguien no querría poner ese límite tan bajo en una red real? Busquen qué haceneighbor X maximum-prefix N warning-onlyen la documentación de FRRouting, y discutan cuándo lo usarían. - Con
rtr_cache.pyy RFC 8210 a la vista, lean los bytes de un Reset Query, y los del Cache Response, un IPv4 Prefix y el End of Data. Capturen contcpdump -Xena, en la interfazeth5, y marquen en la captura cada campo. ¿Por qué el router no hace la validación criptográfica de los ROAs? - Un ISP le ofrece a su peer en el IXP sus rutas de tránsito, por error. En la
topología
ixp, quiten la reglaSOLO-PROPIASdeisp1, y predigan qué le pasa al tráfico deisp2haciaisp3. ¿Qué veisp2en su tabla, y cambia su tráfico? Compruébenlo. ¿Cuál es el nombre de este error? ¿Qué cambiaría siisp2prefiriera las rutas de peers conlocal-preference? - Facebook 2021: ¿habría ayudado RPKI? ¿Y filtros en sus proveedores? ¿Y un servidor DNS de respaldo en otra red? Argumenten cada uno usando los hechos del informe. ¿Qué cambiarían ustedes en la regla de salud de los servidores DNS?
- Desde su computadora (fuera del contenedor), hagan
traceroutea un sitio del Perú, a uno de otro continente y a uno servido por una CDN. Marquen el salto en el que el RTT sube y se queda alto, y calculen con la velocidad de la luz en fibra el máximo de distancia que permite. ¿Sale del Perú? ¿Por qué podría salir aunque el sitio esté aquí? - Hagan la cuenta del peering con datos que ustedes inventen, para un ISP con tres posibles peers y un costo de puerto fijo. ¿Con qué volumen de tráfico le conviene entrar al IXP? ¿Qué pasa si tiene más tráfico hacia uno de los peers que el que recibe de él? ¿Qué le pediría el otro?