
Apuntes · Capítulo 9Transporte y aplicaciones
Entrega confiable: de UDP a la ventana deslizante
Entrega confiable: de UDP a la ventana deslizante
Hasta el parcial nos ocupamos de una sola pregunta: cómo llega un paquete de un host a otro. Ya sabemos armar redes, llenar tablas con OSPF y conectar sistemas autónomos con BGP. Pero lo que esa maquinaria ofrece es modesto. IP hace su mejor esfuerzo: un paquete puede perderse, llegar dañado, duplicado o después de otro que salió más tarde, y nadie le avisa a quien lo mandó.
Con esta semana empieza la parte de transporte y aplicaciones. La pregunta cambia: ¿cómo se construye, encima de ese servicio malo, algo que un programa pueda usar? La respuesta tiene dos mitades. La primera es casi trivial: llevar los datos hasta el proceso correcto, no solo hasta el host. Con eso y un checksum tenemos UDP. La segunda es una de las construcciones más bonitas del curso: entrega confiable sobre un canal que no lo es.
En la Sesión A vemos la multiplexación con programas que muestran qué socket recibe cada dato, leemos un datagrama UDP byte por byte y calculamos su checksum. Luego construimos un protocolo confiable agregando un mecanismo a la vez, y cada uno responde a una falla que el anterior no aguanta. Terminamos con la mala noticia: stop-and-wait funciona, y en un enlace largo desperdicia casi todo.
En la Sesión B arreglamos eso con la ventana deslizante. Comparamos Go-Back-N y Selective Repeat con trazas y con mediciones del simulador, y vemos por qué la ventana no puede crecer sin límite si los números de secuencia son finitos.
El laboratorio es otra cosa: el hackathon, donde el Internet de la clase se conecta de verdad. Al final del capítulo hay un ensayo con cuatro equipos ficticios y cuatro fallas puestas a propósito.
Hay tres clases de resultados en este capítulo, y conviene no mezclarlas. Las trazas de los simuladores son exactas y se repiten igual en cada corrida. Las capturas y los mensajes de la red de laboratorio muestran lo que pasó en una ejecución real; los puertos y los tiempos cambian. Las mediciones de velocidad dependen de la computadora y de lo que esté corriendo: comparen tendencias, no cifras.
Ruta de lectura.
Antes de clase (obligatorio, unos 15 a 20 minutos). Sesión A: Qué agrega el transporte sobre IP, La red de la Sesión A, UDP: dos campos, TCP: cuatro campos, la introducción de UDP y, de Construir un protocolo paso a paso, de la introducción a Versión 2.2: sin NAK. Sesión B: la introducción de Stop-and-wait en un enlace largo y la de Ventana deslizante: mandar sin esperar.
En clase. Sesión A: El checksum, ¿Qué hace el receptor con un datagrama dañado?, Versión 3: pérdidas, con un temporizador, Lo que construimos y Dos generales. Sesión B: El precio, Go-Back-N, Selective Repeat, Comparación y Cuántos números de secuencia hacen falta. El laboratorio es Laboratorio: el hackathon.
Después de clase. Repasen con el Resumen y los Ejercicios, y revisen Archivos y
make test. Opcional: El matiz: UDP conconnect, Un stop-and-wait de verdad: TFTP y Y esto en P3. Para profundizar, las lecturas del libro y las gratuitas de la semana:Este capítulo acompaña a Kurose y Ross, Computer Networking: A Top-Down Approach (9.ª ed.). Para la Sesión A, las secciones 3.1 Introduction and Transport-Layer Services, 3.2 Multiplexing and Demultiplexing, 3.3 Connectionless Transport: UDP y 3.4.1 Building a Reliable Data Transfer Protocol, y el capítulo Transport Layer Principles de CS168. Complementaria: RFC 768, UDP. Para la Sesión B, las secciones 3.4.2 Pipelined Reliable Data Transfer Protocols, 3.4.3 Go-Back-N y 3.4.4 Selective Repeat, y otra vez el capítulo de CS168, que da el marco general (metas de la confiabilidad, puertos y UDP); el detalle de la ventana está en el libro. El código de la semana está en
code/week-09/.
Qué agrega el transporte sobre IP
IP entrega entre hosts. Un paquete lleva la dirección de una máquina y ahí termina su promesa. Pero en esa máquina corren un navegador, un cliente de correo, un servidor de base de datos. Lo que se comunica de verdad son procesos.
Definición. La capa de transporte da comunicación lógica entre procesos: cada aplicación trabaja como si estuviera conectada directamente con la otra, sin saber cuántos routers hay en medio.
Dos consecuencias conviene tener claras desde ya:
- El transporte corre en los extremos. Un router mira hasta el encabezado de IP para hacer forwarding. No abre el segmento, no sabe de puertos (salvo los que hacen NAT) y no retransmite nada. Es el argumento de extremo a extremo de la semana 2, aplicado: lo que solo los extremos pueden garantizar, lo hacen los extremos.
- El transporte no puede arreglarlo todo. Puede convertir pérdidas en retransmisiones, y un caos de paquetes en un stream ordenado. No puede inventar ancho de banda que el camino no tiene, ni bajar el retardo mínimo del camino.
Internet ofrece dos servicios de transporte. Esta tabla ya la vimos en la semana 2, y ahora vamos a entender qué hay detrás de cada celda:
| Servicio | UDP | TCP |
|---|---|---|
| Entrega al proceso correcto | sí | sí |
| Detección de errores | sí, con checksum | sí, con checksum |
| Entrega confiable y en orden | no | sí |
| Conexión | no | sí |
| Control de flujo y de congestión | no | sí |
| Límites de mensaje | se conservan | no: es un stream de bytes |
| Garantías de retardo o de ancho de banda | no | no |
La última fila sorprende a veces. TCP no promete rapidez: promete que lo que llegue esté completo y en orden.
Idea clave. IP mueve paquetes entre hosts y no promete nada. El transporte agrega dos cosas de naturaleza muy distinta: una dirección más fina (el puerto), que es barata, y, si se la pide, confiabilidad, que tiene un costo real en tiempo, en memoria y en complejidad.
La red de la Sesión A
Usamos cuatro nodos, en code/week-09/par/: dos clientes y un servidor, separados por
un router.
   h1  10.209.21.10 ---\
                        r --- srv  10.209.23.10
   h2  10.209.22.10 ---/
Levántenla desde el contenedor del curso, en code/week-09:
make upmake compila los programas de C con -static, para que corran dentro de los nodos,
y la topología monta la carpeta de la semana en /w09. El enlace entre r y srv se
puede configurar con par/enlace.sh, que usaremos más adelante.
Multiplexación y demultiplexación
Imaginen un edificio con un solo buzón en la entrada. El cartero (IP) deja las cartas en el edificio, y alguien tiene que repartirlas por departamento. Ese reparto es la demultiplexación, y el número de departamento es el puerto.
Definición. Multiplexar es juntar en el host de origen los datos de varios sockets y agregarles un encabezado que permita separarlos. Demultiplexar es, en el host de destino, usar ese encabezado para entregar cada segmento al socket correcto.
Un puerto es un número de 16 bits. Los del 0 al 1023 son los bien conocidos (53 para DNS, 443 para HTTPS). Cuando un cliente no elige el suyo, el sistema operativo le da uno efímero, y por eso en las capturas de un cliente se ven números altos.
La regla que hay que aprender está en cómo se identifica el socket de destino, y ahí UDP y TCP difieren.
UDP: dos campos
Un socket UDP sin connect se identifica por dirección y puerto de destino. No
importa de quién venga el datagrama. Lo comprobamos con udp_demux, un servidor que
imprime qué socket recibió cada cosa, y con demux_client, que permite elegir el
puerto de origen. Los dos clientes h1 y h2 usan incluso el mismo puerto:
$ docker exec -d clab-w09-par-srv sh -c '/w09/bin/udp_demux 9009 > /tmp/udp.log 2>&1'
$ docker exec clab-w09-par-h1 /w09/bin/demux_client udp 10.209.23.10 9009 5000 "de h1, puerto 5000"
recibido en el socket 3
$ docker exec clab-w09-par-h2 /w09/bin/demux_client udp 10.209.23.10 9009 5000 "de h2, puerto 5000"
recibido en el socket 3
$ docker exec clab-w09-par-h1 /w09/bin/demux_client udp 10.209.23.10 9009 5001 "de h1, puerto 5001"
recibido en el socket 3
$ docker exec clab-w09-par-srv cat /tmp/udp.log
socket 3  de 10.209.21.10:5000  "de h1, puerto 5000"
socket 3  de 10.209.22.10:5000  "de h2, puerto 5000"
socket 3  de 10.209.21.10:5001  "de h1, puerto 5001"
Los tres clientes caen en el mismo socket. ¿Cómo sabe entonces el servidor a quién
contestar? recvfrom le entrega también la dirección y el puerto de origen. Separar a
los clientes, si hace falta, es trabajo de la aplicación. El sistema operativo muestra
un solo socket:
$ docker exec clab-w09-par-srv sh -c "ss -uan | grep -E 'State|9009'"
State  Recv-Q Send-Q Local Address:Port  Peer Address:Port
UNCONN 0      0            0.0.0.0:9009       0.0.0.0:*
TCP: cuatro campos
Un socket de una conexión TCP se identifica por dirección de origen, puerto de
origen, dirección de destino y puerto de destino. Hacemos lo mismo con tcp_demux:
$ docker exec clab-w09-par-srv cat /tmp/tcp.log
socket 3  escuchando en el puerto 9009
socket 4  conexión nueva de 10.209.21.10:5000
socket 4  de 10.209.21.10:5000  "de h1, puerto 5000"
socket 5  conexión nueva de 10.209.22.10:5000
socket 5  de 10.209.22.10:5000  "de h2, puerto 5000"
socket 6  conexión nueva de 10.209.21.10:5001
socket 6  de 10.209.21.10:5001  "de h1, puerto 5001"
$ docker exec clab-w09-par-srv sh -c "ss -tan | grep -E 'State|9009'"
State  Recv-Q Send-Q Local Address:Port  Peer Address:Port
LISTEN 0      8            0.0.0.0:9009       0.0.0.0:*
ESTAB  0      0       10.209.23.10:9009  10.209.21.10:5000
ESTAB  0      0       10.209.23.10:9009  10.209.21.10:5001
ESTAB  0      0       10.209.23.10:9009  10.209.22.10:5000
Hay cuatro sockets en el mismo puerto: uno que escucha y uno por conexión. Fíjense en las dos conexiones que vienen del puerto 5000: solo se distinguen por la dirección de origen, y con eso basta. Fíjense también en que el socket que escucha nunca recibe datos. Su trabajo termina al entregar conexiones nuevas: un SYN no pertenece todavía a ninguna conexión, y por eso llega al socket que solo mira el destino. Lo que viene después ya tiene sus cuatro campos.
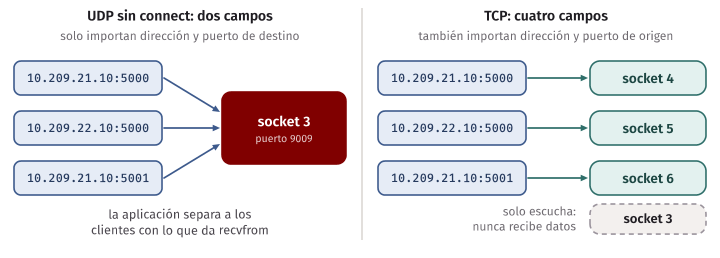
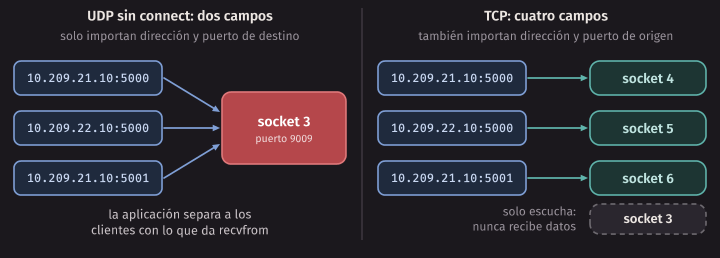
Esta es la respuesta a la primera pregunta de repaso de la guía:
UDP sin connect |
TCP, conexión establecida | |
|---|---|---|
| Identifica al socket | IP y puerto de destino | IP y puerto de origen, IP y puerto de destino |
| Dos clientes al mismo puerto | un solo socket | un socket por cliente |
| Cómo los separa el servidor | la aplicación, con lo que da recvfrom |
el sistema operativo |
Error común. Decir que “un puerto es una conexión”, o que un servidor web se queda sin puertos porque tiene muchos clientes. Un servidor en el puerto 443 puede tener miles de conexiones, todas con ese mismo puerto local: lo que las separa es el otro extremo. Lo que se agota de verdad son otros recursos, como la memoria y los descriptores de archivo.
El matiz: UDP con connect
“Dos campos” es la regla de un socket UDP sin connect. En UDP, connect no manda
ningún paquete: solo le dice al kernel que ese socket es para un solo otro extremo. Y
cuando hay un socket así, Linux lo prefiere para los datagramas que coinciden con él,
porque es más específico. udp_demux acepta un cliente con el que conectar un segundo
socket en el mismo puerto:
$ docker exec -d clab-w09-par-srv sh -c '/w09/bin/udp_demux 9009 10.209.21.10 5000 > /tmp/udp2.log 2>&1'
$ docker exec clab-w09-par-srv cat /tmp/udp2.log
socket 4  de 10.209.21.10:5000  "de h1, puerto 5000"
socket 3  de 10.209.22.10:5000  "de h2, puerto 5000"
socket 3  de 10.209.21.10:5001  "de h1, puerto 5001"
$ docker exec clab-w09-par-srv sh -c "ss -uan | grep -E 'State|9009'"
State  Recv-Q Send-Q Local Address:Port  Peer Address:Port
ESTAB  0      0       10.209.23.10:9009  10.209.21.10:5000
UNCONN 0      0            0.0.0.0:9009       0.0.0.0:*
El datagrama de h1:5000 fue al socket 4, y los otros dos al socket 3. ss hasta le
pone ESTAB, aunque nunca hubo handshake: es solo una marca local, y el otro extremo no
se entera de nada.
Cuando nadie escucha
¿Qué pasa si el puerto está cerrado? Probamos con los tres tipos de cliente, sin ningún servidor corriendo:
$ docker exec clab-w09-par-h1 /w09/bin/demux_client tcp 10.209.23.10 9009 5002 x
connect: Connection refused
$ docker exec clab-w09-par-h1 /w09/bin/demux_client udp-connect 10.209.23.10 9009 5003 x
recv: Connection refused
$ docker exec clab-w09-par-h1 /w09/bin/demux_client udp 10.209.23.10 9009 5004 x
recv: Resource temporarily unavailable
Con TCP, el kernel de srv contesta con un RST y connect falla. En UDP, el kernel de
srv contesta con un ICMP de puerto inalcanzable, que capturamos más abajo. Pero ese
aviso solo le llega a un socket conectado. El socket sin connect no se entera: su
recv simplemente vence a los 2 s que le dimos de espera.
UDP
UDP es casi lo mínimo que un transporte puede ser. Su encabezado tiene 8 bytes, con cuatro campos de 16 bits:
 0               16              31
+----------------+----------------+
| puerto origen  | puerto destino |
+----------------+----------------+
|     largo      |    checksum    |
+----------------+----------------+
|              datos              |
+---------------------------------+
El largo cuenta el encabezado y los datos. Como IP también limita el tamaño, en IPv4 caben hasta 65 507 bytes de datos: 65 535 menos 20 de IP y 8 de UDP. En la práctica se manda bastante menos, para no fragmentar.
Capturamos en srv un datagrama con hola, y la respuesta del kernel cuando el puerto
está cerrado:
$ docker exec clab-w09-par-srv tcpdump -r /tmp/u.pcap -n -v -x
13:56:38.933668 IP (tos 0x0, ttl 63, id 29469, offset 0, flags [DF], proto UDP (17), length 32)
    10.209.21.10.5000 > 10.209.23.10.9009: UDP, length 4
	0x0000:  4500 0020 731d 4000 3f11 86fa 0ad1 150a
	0x0010:  0ad1 170a 1388 2331 000c b296 686f 6c61
Los primeros 20 bytes son IP. Lo que sigue es UDP:
| Bytes | Campo | Valor |
|---|---|---|
1388 |
Puerto de origen | 5000 |
2331 |
Puerto de destino | 9009 |
000c |
Largo | 12: 8 de encabezado y 4 de datos |
b296 |
Checksum | lo calculamos a continuación |
686f 6c61 |
Datos | hola en ASCII |
Y esto es lo que recibe h1 cuando no hay nadie en el puerto:
13:56:39.448637 IP (tos 0xc0, ttl 64, id 27701, offset 0, flags [none], proto ICMP (1), length 60)
    10.209.23.10 > 10.209.21.10: ICMP 10.209.23.10 udp port 9009 unreachable, length 40
El checksum
Definición. El checksum de UDP es el complemento a uno de la suma en complemento a uno de tres cosas, tomadas en palabras de 16 bits: un pseudo-encabezado, el encabezado UDP con el checksum en cero, y los datos (con un byte en cero al final si el largo es impar).
La aritmética es la misma del checksum de IP de la semana 4. La novedad es el pseudo-encabezado: las dos direcciones IP, un byte en cero, el número de protocolo (17) y el largo de UDP. No viaja en el paquete: cada extremo lo arma con lo que sabe. El RFC 768 explica para qué está: protege contra datagramas mal entregados. Si un error cambiara la dirección de destino, el checksum de UDP no calzaría en quien lo reciba por equivocación.
udp_checksum.py hace la cuenta con los datos de la captura:
$ python3 udp_checksum.py 10.209.21.10 10.209.23.10 5000 9009 hola
pseudo-encabezado  0ad1 150a 0ad1 170a 0011 000c
encabezado UDP     1388 2331 000c 0000
datos              686f 6c61
suma               14d68
con acarreos       4d69
complemento        b296
checksum           b296
La suma se pasa de 16 bits, y el acarreo se suma de vuelta: 4d68 + 1 = 4d69. Su
complemento es b296, justo lo que dice la captura. Quien recibe suma todo, checksum
incluido, y debe obtener ffff. Aquí, 4d69 + b296 = ffff.
Dos detalles del RFC 768, que se prestan para preguntas de examen:
- Un checksum transmitido en cero significa que el emisor no lo calculó. Por eso, si
la cuenta da cero de verdad, se manda
ffff. En complemento a uno, las dos son formas de escribir el cero. - Eso vale para IPv4. En IPv6, como el encabezado de IP ya no tiene checksum, el RFC 8200 obliga a calcular el de UDP, y un receptor debe descartar los datagramas que lleguen con cero (con una excepción para ciertos túneles).
El checksum es débil, y ya lo medimos en la semana 3 con detect.py. Por ejemplo, no ve
un cambio en el orden de las palabras. La prueba test_swapping_two_words_goes_undetected
lo confirma con los datos abcd y cdab, que dan el mismo checksum.
En la práctica. En un host común, lo más probable es que
tcpdumples muestre checksums “incorrectos” en lo que el propio host envía. La tarjeta de red calcula el checksum al transmitir, y la captura ve el paquete antes de eso: se llama offload. En nuestras topologías sí vimos el valor real, ytsharklo marca como correcto, porque Containerlab apaga esa función en sus enlaces. Si venbad udp cksumen su laptop, miren primero si la captura se hizo en el host que envía.
¿Qué hace el receptor con un datagrama dañado?
Lo descarta en silencio, y lleva la cuenta. La aplicación no se entera. Lo vemos dañando
el 5 % de los paquetes con netem, durante una transferencia que explicaremos más
adelante, y mirando los contadores de UDP en h1:
$ sh par/enlace.sh 100mbit 30 0 0 5
$ docker exec clab-w09-par-h1 grep Udp: /proc/net/snmp
Udp: InDatagrams NoPorts InErrors OutDatagrams RcvbufErrors SndbufErrors InCsumErrors IgnoredMulti MemErrors
Udp: 919 0 0 931 0 0 0 0 0
$ docker exec clab-w09-par-h1 python3 /w09/tftp_mini.py get 10.209.23.10 50k /tmp/o
bytes=51200 tiempo=4.44s tasa=92.2 kbit/s duplicados=0 sha256=df1ba5f500ea33cb
$ docker exec clab-w09-par-h1 grep Udp: /proc/net/snmp
Udp: InDatagrams NoPorts InErrors OutDatagrams RcvbufErrors SndbufErrors InCsumErrors IgnoredMulti MemErrors
Udp: 1020 0 4 1033 0 0 4 0 0
InCsumErrors pasó de 0 a 4. Esos cuatro datagramas nunca llegaron al programa. Y el
hash del archivo es el correcto, porque el servidor los repitió.
Idea clave. Para la aplicación, el checksum de UDP convierte un dato dañado en un dato perdido. Por eso, sobre UDP, un protocolo confiable solo necesita lidiar con pérdidas, duplicados y desorden en lo que le llega. Eso vale siempre que el daño lo detecte el checksum, que es de 16 bits. Si necesitan más seguridad, comprueben de extremo a extremo, como en la semana 2.
¿Para qué sirve algo tan simple?
UDP no da casi nada, y a veces eso es exactamente lo que se quiere:
- DNS. Una pregunta y una respuesta chicas, sin gastar un handshake. Si se pierde, se pregunta de nuevo. Lo vemos en la semana 12.
- Medios en vivo. En una llamada, un paquete que llega 2 segundos tarde no sirve. Retransmitirlo gastaría red en algo que ya nadie va a usar.
- Base para otro transporte. QUIC corre sobre UDP y pone encima su propia confiabilidad, en el espacio de la aplicación. Una razón es práctica: en Internet hay muchas middleboxes que solo dejan pasar TCP y UDP, y un protocolo nuevo sobre IP no pasaría. Lo vemos en la semana 13. Y P3 hace lo mismo que QUIC en esto: construye sobre UDP lo que IP no da.
Error común. Decir que “UDP es más rápido que TCP”. UDP no tiene una velocidad. No espera un handshake y no frena ante la congestión, pero sus bits viajan igual de rápido por el mismo enlace. Y si un flujo UDP manda más de lo que el camino aguanta, se pierde lo que sobra. Cuando usan UDP, el control de congestión pasa a ser responsabilidad de ustedes.
Construir un protocolo paso a paso
Ahora la parte central de la sesión. Queremos ofrecerle a una aplicación este servicio: lo que entrega el emisor llega al receptor completo, sin daños, sin duplicados y en el mismo orden. Y solo contamos con un canal que puede fallar.
Vamos a construirlo agregando un mecanismo a la vez, y solo cuando una falla concreta
lo exija. Trabajamos en una dirección (los datos van de un lado, y solo vuelven
confirmaciones), con un solo paquete en camino a la vez. rdt_sim.py simula cada versión:
no hay red ni sockets, y el canal sigue un guion que dice qué le pasa a cada transmisión.
Así, cada falla ocurre siempre en el mismo lugar. Cada sentido demora 10 ms. El libro llama
a estas versiones rdt1.0, rdt2.0, rdt2.1, rdt2.2 y rdt3.0, y las describe con máquinas de
estados; aquí las seguimos con trazas.
$ python3 rdt_sim.py
v1-perfecto  v1 sobre un canal perfecto: funciona
v1-errores   v1 con un error de bits: entrega basura sin enterarse
v2-datos     v2 con un dato dañado: el NAK lo arregla
v2-ack       v2 con un ACK dañado: el emisor repite y se duplica
v21-ack      v2.1 con un ACK dañado: el bit de secuencia lo arregla
v22-datos    v2.2 con un dato dañado: un ACK repetido hace de NAK
v22-perdida  v2.2 con una pérdida: se queda esperando para siempre
v3-dato      v3 con un dato perdido: el temporizador lo repite
v3-ack       v3 con un ACK perdido: repite, y el receptor reconoce el duplicado
v3-tarde     v3 con un ACK tarde: retransmisión innecesaria, pero correcta
v3-sin-seq   temporizador sin números de secuencia: se duplica
Versión 1: un canal perfecto
Si el canal no falla, no hay nada que hacer. El emisor manda, el receptor entrega. El protocolo es la nada misma, y funciona. Pero basta un error de bits:
$ python3 rdt_sim.py v1-errores
--- v1-errores: v1 con un error de bits: entrega basura sin enterarse
    0 ms  emisor   envía DATA "a"
   10 ms  receptor recibe y entrega "a"
   11 ms  emisor   envía DATA "b"  [el canal daña bits]
   21 ms  receptor recibe y entrega "?!?"
   22 ms  emisor   envía DATA "c"
   32 ms  receptor recibe y entrega "c"
   33 ms  emisor   terminó
entregado: a ?!? c   (INCORRECTO, 3 transmisiones)
Versión 2: errores de bits, con ACK y NAK
Supongamos que el canal puede dañar bits, pero no perder paquetes. Pensemos en cómo se resuelve en un dictado por teléfono: quien escucha dice “ok” o “repite”. Hacen falta tres cosas:
- Detectar el error: un checksum.
- Avisar: un ACK si llegó bien, un NAK si llegó dañado.
- Reparar: el emisor repite cuando recibe un NAK. Por eso, mientras tanto, se queda esperando, sin mandar nada más. Esto se llama stop-and-wait.
$ python3 rdt_sim.py v2-datos
--- v2-datos: v2 con un dato dañado: el NAK lo arregla
    0 ms  emisor   envía DATA "a"
   10 ms  receptor recibe y entrega "a"
   10 ms  receptor envía ACK
   20 ms  emisor   recibe ACK
   20 ms  emisor   envía DATA "b"  [el canal daña bits]
   30 ms  receptor recibe datos dañados
   30 ms  receptor envía NAK
   40 ms  emisor   recibe NAK: repite
   40 ms  emisor   envía DATA "b" (otra vez)
   50 ms  receptor recibe y entrega "b"
   50 ms  receptor envía ACK
   60 ms  emisor   recibe ACK
   60 ms  emisor   envía DATA "c"
   70 ms  receptor recibe y entrega "c"
   70 ms  receptor envía ACK
   80 ms  emisor   recibe ACK
   80 ms  emisor   terminó: todo confirmado
entregado: a b c   (correcto, 8 transmisiones)
Parece listo. Pero hay un agujero: las respuestas viajan por el mismo canal. ¿Qué hace el emisor si la respuesta le llega dañada? No sabe si era un ACK o un NAK. Lo razonable es repetir, porque así no se pierde nada. Veamos el resultado:
$ python3 rdt_sim.py v2-ack
--- v2-ack: v2 con un ACK dañado: el emisor repite y se duplica
    0 ms  emisor   envía DATA "a"
   10 ms  receptor recibe y entrega "a"
   10 ms  receptor envía ACK  [el canal daña bits]
   20 ms  emisor   recibe una respuesta dañada: no sabe qué era, repite
   20 ms  emisor   envía DATA "a" (otra vez)
   30 ms  receptor recibe y entrega "a"
   30 ms  receptor envía ACK
   40 ms  emisor   recibe ACK
   40 ms  emisor   envía DATA "b"
   50 ms  receptor recibe y entrega "b"
   50 ms  receptor envía ACK
   60 ms  emisor   recibe ACK
   60 ms  emisor   envía DATA "c"
   70 ms  receptor recibe y entrega "c"
   70 ms  receptor envía ACK
   80 ms  emisor   recibe ACK
   80 ms  emisor   terminó: todo confirmado
entregado: a a b c   (INCORRECTO, 8 transmisiones)
El receptor entregó a dos veces. Para él, la a repetida es indistinguible de un dato
nuevo que por casualidad dice lo mismo.
Versión 2.1: números de secuencia
Definición. Un número de secuencia es un campo que el emisor pone en cada paquete para que el receptor pueda distinguir un paquete nuevo de la repetición de uno anterior.
Como aquí hay un solo paquete en camino, basta un bit: el paquete nuevo lleva el número contrario al anterior. Si llega el número que ya vio, es un duplicado: no lo entrega, pero sí lo confirma, porque el emisor evidentemente no se enteró.
$ python3 rdt_sim.py v21-ack
--- v21-ack: v2.1 con un ACK dañado: el bit de secuencia lo arregla
    0 ms  emisor   envía DATA 0 "a"
   10 ms  receptor recibe 0 y entrega "a"
   10 ms  receptor envía ACK  [el canal daña bits]
   20 ms  emisor   recibe una respuesta dañada: no sabe qué era, repite
   20 ms  emisor   envía DATA 0 "a" (otra vez)
   30 ms  receptor recibe 0: duplicado, no lo entrega
   30 ms  receptor envía ACK
   40 ms  emisor   recibe ACK
   40 ms  emisor   envía DATA 1 "b"
   50 ms  receptor recibe 1 y entrega "b"
   50 ms  receptor envía ACK
   60 ms  emisor   recibe ACK
   60 ms  emisor   envía DATA 0 "c"
   70 ms  receptor recibe 0 y entrega "c"
   70 ms  receptor envía ACK
   80 ms  emisor   recibe ACK
   80 ms  emisor   terminó: todo confirmado
entregado: a b c   (correcto, 8 transmisiones)
Versión 2.2: sin NAK
¿Hace falta el NAK? Si el ACK dice qué número confirma, el receptor puede avisar de un paquete dañado repitiendo la confirmación del último que recibió bien. Un ACK repetido significa lo mismo que un NAK. Hay un tipo de mensaje menos, y esta idea reaparece en la próxima semana, con el fast retransmit de TCP.
$ python3 rdt_sim.py v22-datos
--- v22-datos: v2.2 con un dato dañado: un ACK repetido hace de NAK
    0 ms  emisor   envía DATA 0 "a"
   10 ms  receptor recibe 0 y entrega "a"
   10 ms  receptor envía ACK 0
   20 ms  emisor   recibe ACK 0
   20 ms  emisor   envía DATA 1 "b"  [el canal daña bits]
   30 ms  receptor recibe datos dañados: confirma el último bueno
   30 ms  receptor envía ACK 0
   40 ms  emisor   recibe ACK 0: esperaba ACK 1, repite
   40 ms  emisor   envía DATA 1 "b" (otra vez)
   50 ms  receptor recibe 1 y entrega "b"
   50 ms  receptor envía ACK 1
   60 ms  emisor   recibe ACK 1
   60 ms  emisor   envía DATA 0 "c"
   70 ms  receptor recibe 0 y entrega "c"
   70 ms  receptor envía ACK 0
   80 ms  emisor   recibe ACK 0
   80 ms  emisor   terminó: todo confirmado
entregado: a b c   (correcto, 8 transmisiones)
Versión 3: pérdidas, con un temporizador
Ahora el canal también puede perder paquetes. Todo lo anterior depende de que llegue alguna respuesta, y si el paquete se pierde, no llega ninguna:
$ python3 rdt_sim.py v22-perdida
--- v22-perdida: v2.2 con una pérdida: se queda esperando para siempre
    0 ms  emisor   envía DATA 0 "a"
   10 ms  receptor recibe 0 y entrega "a"
   10 ms  receptor envía ACK 0
   20 ms  emisor   recibe ACK 0
   20 ms  emisor   envía DATA 1 "b"  [el canal lo pierde]
   20 ms  emisor   se quedó esperando para siempre: nada en camino, ningún temporizador
entregado: a   (INCORRECTO, 3 transmisiones)
Los dos extremos quedan esperándose: es un deadlock. El emisor necesita una forma de decidir que ya esperó demasiado: un temporizador. Lo arranca al enviar, lo apaga al recibir la confirmación y, si vence, repite. En esta versión, el emisor ignora las respuestas dañadas o de otro número: que se encargue el temporizador.
$ python3 rdt_sim.py v3-dato
--- v3-dato: v3 con un dato perdido: el temporizador lo repite
    0 ms  emisor   envía DATA 0 "a"
   10 ms  receptor recibe 0 y entrega "a"
   10 ms  receptor envía ACK 0
   20 ms  emisor   recibe ACK 0
   20 ms  emisor   envía DATA 1 "b"  [el canal lo pierde]
   50 ms  emisor   vence el temporizador
   50 ms  emisor   envía DATA 1 "b" (otra vez)
   60 ms  receptor recibe 1 y entrega "b"
   60 ms  receptor envía ACK 1
   70 ms  emisor   recibe ACK 1
   70 ms  emisor   envía DATA 0 "c"
   80 ms  receptor recibe 0 y entrega "c"
   80 ms  receptor envía ACK 0
   90 ms  emisor   recibe ACK 0
   90 ms  emisor   terminó: todo confirmado
entregado: a b c   (correcto, 7 transmisiones)
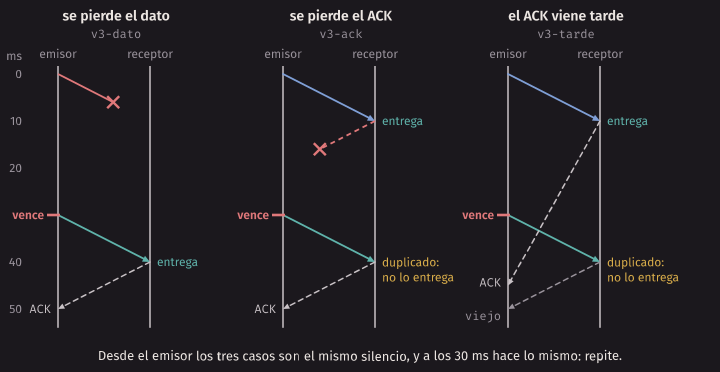
Lo importante es que el emisor no puede saber qué pasó. Si vence el temporizador, pudo perderse el dato, pudo perderse el ACK, o pudo ser que el ACK simplemente venga tarde. Las tres situaciones se ven igual desde su lado, y él hace lo mismo en las tres. Lo que hace que eso sea correcto está en el receptor. Primero, el ACK perdido:
$ python3 rdt_sim.py v3-ack
--- v3-ack: v3 con un ACK perdido: repite, y el receptor reconoce el duplicado
    0 ms  emisor   envía DATA 0 "a"
   10 ms  receptor recibe 0 y entrega "a"
   10 ms  receptor envía ACK 0  [el canal lo pierde]
   30 ms  emisor   vence el temporizador
   30 ms  emisor   envía DATA 0 "a" (otra vez)
   40 ms  receptor recibe 0: duplicado, no lo entrega
   40 ms  receptor envía ACK 0
   50 ms  emisor   recibe ACK 0
   50 ms  emisor   envía DATA 1 "b"
   60 ms  receptor recibe 1 y entrega "b"
   60 ms  receptor envía ACK 1
   70 ms  emisor   recibe ACK 1
   70 ms  emisor   envía DATA 0 "c"
   80 ms  receptor recibe 0 y entrega "c"
   80 ms  receptor envía ACK 0
   90 ms  emisor   recibe ACK 0
   90 ms  emisor   terminó: todo confirmado
entregado: a b c   (correcto, 8 transmisiones)
Y si el ACK solo viene atrasado, se retransmite sin necesidad. Eso gasta red, pero el resultado sigue siendo correcto:
$ python3 rdt_sim.py v3-tarde
--- v3-tarde: v3 con un ACK tarde: retransmisión innecesaria, pero correcta
    0 ms  emisor   envía DATA 0 "a"
   10 ms  receptor recibe 0 y entrega "a"
   10 ms  receptor envía ACK 0  [llega tarde]
   30 ms  emisor   vence el temporizador
   30 ms  emisor   envía DATA 0 "a" (otra vez)
   40 ms  receptor recibe 0: duplicado, no lo entrega
   40 ms  receptor envía ACK 0
   45 ms  emisor   recibe ACK 0
   45 ms  emisor   envía DATA 1 "b"
   50 ms  emisor   recibe ACK 0: es de un paquete viejo, la ignora
   55 ms  receptor recibe 1 y entrega "b"
   55 ms  receptor envía ACK 1
   65 ms  emisor   recibe ACK 1
   65 ms  emisor   envía DATA 0 "c"
   75 ms  receptor recibe 0 y entrega "c"
   75 ms  receptor envía ACK 0
   85 ms  emisor   recibe ACK 0
   85 ms  emisor   terminó: todo confirmado
entregado: a b c   (correcto, 8 transmisiones)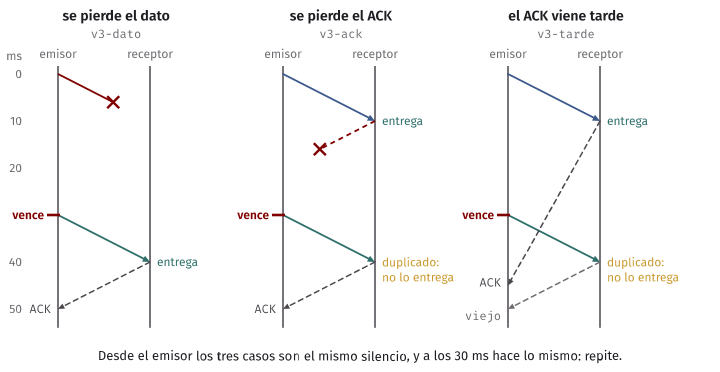
¿Para qué se necesitan números de secuencia si ya existe el temporizador? Es la tercera pregunta de repaso. Quitémoslos y dejemos solo el temporizador:
$ python3 rdt_sim.py v3-sin-seq
--- v3-sin-seq: temporizador sin números de secuencia: se duplica
    0 ms  emisor   envía DATA "a"
   10 ms  receptor recibe y entrega "a"
   10 ms  receptor envía ACK  [el canal lo pierde]
   30 ms  emisor   vence el temporizador
   30 ms  emisor   envía DATA "a" (otra vez)
   40 ms  receptor recibe y entrega "a"
   40 ms  receptor envía ACK
   50 ms  emisor   recibe ACK
   50 ms  emisor   envía DATA "b"
   60 ms  receptor recibe y entrega "b"
   60 ms  receptor envía ACK
   70 ms  emisor   recibe ACK
   70 ms  emisor   envía DATA "c"
   80 ms  receptor recibe y entrega "c"
   80 ms  receptor envía ACK
   90 ms  emisor   recibe ACK
   90 ms  emisor   terminó: todo confirmado
entregado: a a b c   (INCORRECTO, 8 transmisiones)
El temporizador hace que el emisor repita. El número de secuencia hace que esa repetición sea inofensiva. Se necesitan los dos.
Lo que construimos
| La falla | El mecanismo | Lo que introduce |
|---|---|---|
| Bits dañados | Checksum | Detecta, no repara |
| El emisor no sabe si llegó | ACK (y NAK) | Las respuestas también se dañan |
| Hay que reparar | Retransmisión | Duplicados |
| Duplicados | Número de secuencia | Con uno solo en camino, basta un bit |
| Se pierde un paquete o una respuesta | Temporizador | Retransmisiones innecesarias |
Idea clave. Una red no se puede preguntar qué pasó. El emisor solo ve el silencio, y tiene que actuar igual sea cual sea la causa. La confiabilidad sale de combinar dos reglas: el emisor repite hasta que le confirmen, y el receptor reconoce lo que ya recibió. Es la misma idea de CS168: entrega de al menos una vez más la eliminación de duplicados da entrega de exactamente una vez a la aplicación.
Error común. Pensar que un temporizador más corto siempre es mejor. Si es más corto que el RTT, cada paquete se repite aunque nada se pierda. Y si es muy largo, cada pérdida detiene todo por un buen rato. Cómo elegirlo sobre un RTT que cambia es un tema de la próxima semana. En los simuladores de este capítulo es un número fijo.
Stop-and-wait en un enlace largo
El protocolo de la versión 3 es correcto. Ahora veamos su costo.
Sea L el tamaño del paquete y R la velocidad del enlace. El tiempo de transmisión es d = L / R. El emisor pone el primer bit en el instante 0 y el último en d. Recibe el ACK en d + RTT, si ignoramos el tiempo de transmisión del ACK, y solo entonces puede seguir. En cada ciclo de d + RTT, el enlace trabajó d.
Definición. La utilización del emisor es la fracción del tiempo que pasa transmitiendo. Para stop-and-wait:
U = d / (RTT + d)El ejemplo de la guía es un enlace de 1 Gbps con 30 ms de RTT y paquetes de 1500 bytes:
d = 1500 × 8 bits / 1 000 000 000 bits/s = 12 µs
U = 0,012 ms / (30 ms + 0,012 ms) = 0,0004
Es decir, el 0,04 %. Un enlace de un gigabit se comporta como uno de 0,4 Mbps (1500 ×
8 bits cada 30,012 ms). El simulador llega a lo mismo. window_sim.py con ventana 1 es un
stop-and-wait:
$ python3 window_sim.py util
d = 1500 bytes a 1000 Mbps = 0.0120 ms    RTT = 30 ms
fórmula, stop-and-wait: U = d / (RTT + d) = 0.00040
simulador, ventana 1:   U = 0.00040
ventana para llenar el enlace: (RTT + d) / d = 2501 paquetes
throughput de stop-and-wait: 0.400 Mbps

 ventana   fórmula  simulador
       1    0.0004     0.0004
      10    0.0040     0.0040
     100    0.0400     0.0399
    1250    0.4998     0.4936
    2501    1.0000     0.9756
    5002    1.0000     0.9877
La otra mitad de esa tabla la usaremos en la Sesión B. Con esta herramienta también se responde la segunda pregunta de repaso, con 100 Mbps, 40 ms de RTT y 1500 bytes:
$ python3 window_sim.py util --mbps 100 --rtt 40
d = 1500 bytes a 100 Mbps = 0.1200 ms    RTT = 40 ms
fórmula, stop-and-wait: U = d / (RTT + d) = 0.00299
simulador, ventana 1:   U = 0.00299
ventana para llenar el enlace: (RTT + d) / d = 335 paquetes
throughput de stop-and-wait: 0.299 Mbps

 ventana   fórmula  simulador
       1    0.0030     0.0030
      10    0.0299     0.0299
     100    0.2991     0.2969
     167    0.4995     0.4934
     335    1.0000     0.9757
     670    1.0000     0.9877
Fíjense en qué es lo que limita. El throughput de stop-and-wait es un paquete por RTT, y la velocidad del enlace casi no aparece. Comprar un enlace diez veces más rápido prácticamente no cambia nada.
Un stop-and-wait de verdad: TFTP
¿Eso pasa en una red real, o solo en la fórmula? Existe un protocolo real que es
exactamente esto: TFTP, del RFC 1350, un
protocolo simple para transferir archivos sobre UDP. Se usa, por ejemplo, para cargar el
sistema de arranque de un equipo por red. El servidor manda bloques de 512 bytes
numerados, y por cada uno espera su ACK. Un bloque de menos de 512 bytes marca el final.
tftp_mini.py es una versión mínima, solo de lectura, que corre en los nodos:
docker exec clab-w09-par-srv sh -c 'mkdir -p /srv/t; head -c 51200 /dev/urandom > /srv/t/50k'
docker exec -d clab-w09-par-srv sh -c 'python3 /w09/tftp_mini.py serve /srv/t --timeout-ms 200 > /tmp/tftp.log 2>&1'
La captura en srv la lee tshark, que conoce el formato real de TFTP, y no sabe nada de
nuestro programa:
$ tshark -r t.pcap -d udp.port==69,tftp -c 7
    1   0.000000 10.209.21.10 → 10.209.23.10 TFTP 54 Read Request, File: 50k, Transfer type: octet
    2   0.016999 10.209.23.10 → 10.209.21.10 TFTP 558 Data Packet, Block: 1
    3   0.035202 10.209.21.10 → 10.209.23.10 TFTP 46 Acknowledgement, Block: 1
    4   0.051001 10.209.23.10 → 10.209.21.10 TFTP 558 Data Packet, Block: 2
    5   0.067075 10.209.21.10 → 10.209.23.10 TFTP 46 Acknowledgement, Block: 2
    6   0.094005 10.209.23.10 → 10.209.21.10 TFTP 558 Data Packet, Block: 3
    7   0.110004 10.209.21.10 → 10.209.23.10 TFTP 46 Acknowledgement, Block: 3
Ahí está el paso a paso: bloque, ACK, bloque, ACK. Los tiempos están afectados por el
netem del enlace, porque tcpdump ve lo que sale después de la cola. Y hay ruido: entre
los bloques 2 y 3 pasaron 43 ms, y entre los bloques 1 y 2, 34 ms. En su computadora serán otros números.
También se ve la demultiplexación en acción. Pedimos los puertos de esos tres primeros paquetes:
$ tshark -r t.pcap -d udp.port==69,tftp -T fields -e udp.srcport -e udp.dstport -c 3
37954	69
57872	37954
37954	57872
El cliente le escribe al puerto 69, y el servidor responde desde un puerto nuevo, el 57872, con un socket propio para esa transferencia. Así, el socket del puerto 69 queda libre para otros pedidos. Es la forma de tener “una conexión por cliente” encima de UDP.
Ahora medimos. Cambiamos la velocidad y el RTT con par/enlace.sh <velocidad> <rtt_ms>:
$ sh par/enlace.sh 100mbit 30
bytes=51200 tiempo=3.32s tasa=123.6 kbit/s duplicados=0 sha256=df1ba5f500ea33cb
$ sh par/enlace.sh 1gbit 30
bytes=51200 tiempo=3.33s tasa=123.2 kbit/s duplicados=0 sha256=df1ba5f500ea33cb
$ sh par/enlace.sh 100mbit 40
bytes=51200 tiempo=4.55s tasa=90.1 kbit/s duplicados=0 sha256=df1ba5f500ea33cb
$ sh par/enlace.sh 100mbit 10
bytes=51200 tiempo=1.41s tasa=290.0 kbit/s duplicados=0 sha256=df1ba5f500ea33cb
(Entre cada enlace.sh y su resultado corrimos tftp_mini.py get; dejamos solo su línea
de salida.)
| Velocidad | RTT | Predicción, 512 × 8 bits / RTT | Medido |
|---|---|---|---|
| 100 Mbps | 30 ms | 136,5 kbit/s | 123,6 kbit/s |
| 1 Gbps | 30 ms | 136,5 kbit/s | 123,2 kbit/s |
| 100 Mbps | 40 ms | 102,4 kbit/s | 90,1 kbit/s |
| 100 Mbps | 10 ms | 409,6 kbit/s | 290,0 kbit/s |
Con el enlace diez veces más rápido, la tasa no cambió. Con el RTT tres veces menor, sí.
Lo medido queda bajo la predicción, porque cada ciclo cuesta unos milisegundos más que el
RTT configurado: con 30 ms, 3,32 s entre 101 bloques son 32,9 ms por bloque. Esa diferencia
viene de Python y de los temporizadores de netem, y depende de la máquina. Pesa más cuanto
más corto es el RTT, y por eso la fila de 10 ms es la que más se aleja.
Con pérdidas, el archivo sigue llegando bien, y lo único que sube es el tiempo. El cuarto
argumento de enlace.sh es la pérdida en los ACK, y el tercero, en los datos:
$ sh par/enlace.sh 100mbit 30 5 0
bytes=51200 tiempo=4.47s tasa=91.6 kbit/s duplicados=0 sha256=df1ba5f500ea33cb
enviado 50k: 101 bloques, 4 retransmisiones
$ sh par/enlace.sh 100mbit 30 0 5
bytes=51200 tiempo=3.77s tasa=108.7 kbit/s duplicados=2 sha256=df1ba5f500ea33cb
enviado 50k: 101 bloques, 2 retransmisiones
En el primer caso se perdieron datos, y el cliente no vio duplicados. En el segundo se
perdieron ACK: los dos bloques que el servidor repitió ya estaban en el cliente, y su número
de bloque los delató. ¿Y si el cliente no mirara ese número? Lo hace con
--ignore-block-number, que escribe todo lo que llega:
$ sh par/enlace.sh 100mbit 30 0 5
$ docker exec clab-w09-par-h1 python3 /w09/tftp_mini.py get 10.209.23.10 50k /tmp/o --ignore-block-number
bytes=52736 tiempo=3.94s tasa=107.0 kbit/s duplicados=3 sha256=14938be1c049607e
52 736 bytes en lugar de 51 200, y otro hash: los 1536 bytes de más son tres bloques
duplicados dentro del archivo. Lo que el simulador mostró con a a b c pasa también en una
red real.
En la práctica. TFTP tiene un error de diseño famoso, el Sorcerer’s Apprentice Syndrome, descrito en la sección 4.2.3.1 del RFC 1123. Si un emisor manda el bloque siguiente cada vez que recibe un ACK, un solo ACK duplicado hace que se manden dos copias del siguiente bloque, que generan dos ACK, y así para siempre. El archivo llega bien, pero la red carga con todo el doble. La regla para evitarlo: no se retransmite por recibir un ACK repetido. Por eso
tftp_mini.pylos ignora, y solo su temporizador lo hace repetir.
Dos generales
Antes de pasar a la ventana, un resultado teórico que aclara qué significa “confiable”.
Dos ejércitos están en dos colinas, con el enemigo en el valle. Si atacan juntos, ganan; si ataca uno solo, pierde. Se comunican con mensajeros que cruzan el valle, y a un mensajero lo pueden capturar. El general A manda: “atacamos al amanecer”. ¿Puede atacar tranquilo?
No, porque no sabe si el mensaje llegó. Entonces B confirma. Pero ahora B no sabe si su confirmación llegó, y si no llegó, A no atacará; así que B tampoco puede atacar tranquilo. A confirma la confirmación, y el problema se repite.
El argumento. Supongamos que existe un protocolo que garantiza el acuerdo y que termina en una cantidad finita de mensajes. Tomemos el más corto. Su último mensaje podría perderse, y quien lo envió no se enteraría: tiene que decidir lo mismo tanto si llegó como si no. Pero entonces quien lo recibe también debe poder decidir sin él, y ese último mensaje sobraba. Eso da un protocolo más corto, lo que contradice que tomamos el más corto. Así que no existe.
Error común. Sacar de ahí que la entrega confiable es imposible, o bien creer que dos máquinas pueden coordinarse con certeza si envían suficientes confirmaciones. Las dos ideas están mal. Lo imposible es que los dos extremos sepan con certeza, en un tiempo finito, que ambos saben lo mismo. Lo que sí se logra es esto: si el canal entrega algo de vez en cuando, los datos terminan llegando, repitiendo tantas veces como haga falta. La confiabilidad tiene un costo en tiempo y nunca es instantánea. Y si la red está cortada, ningún protocolo la arregla: lo honesto es avisarle a la aplicación que falló.
Esto se nota en detalles concretos. El cierre de TCP tiene un estado de espera, TIME_WAIT,
porque el último ACK puede perderse y nadie lo puede confirmar. Lo vemos la próxima semana.
Ventana deslizante: mandar sin esperar
Empieza la Sesión B. La cuenta de stop-and-wait dice que el problema es esperar. La solución es obvia: no esperar.
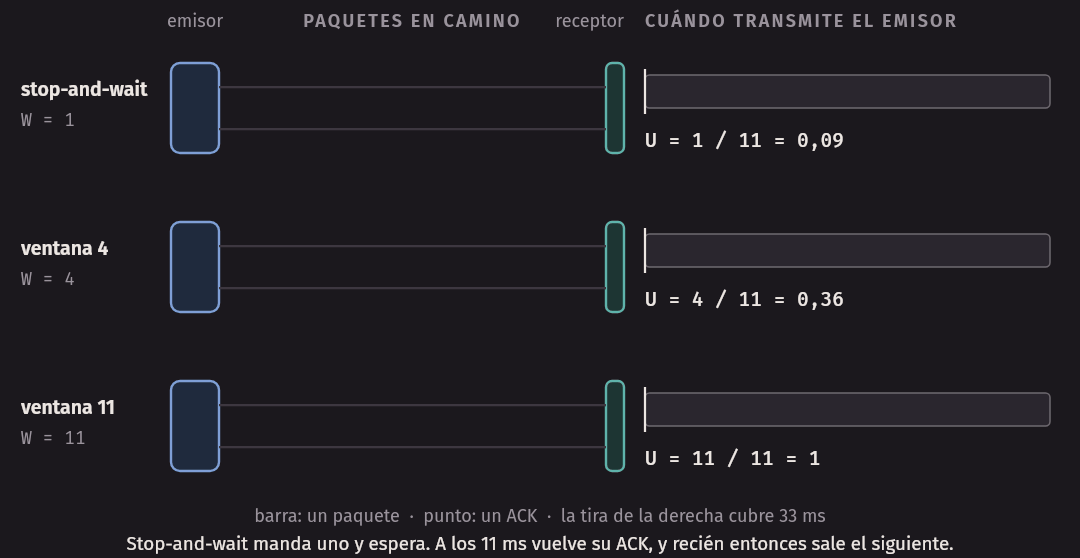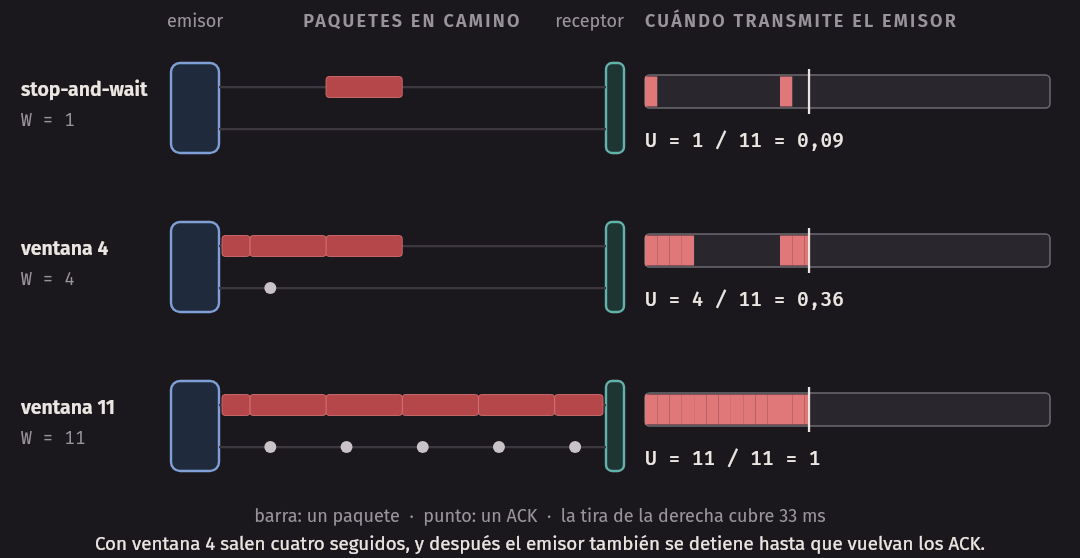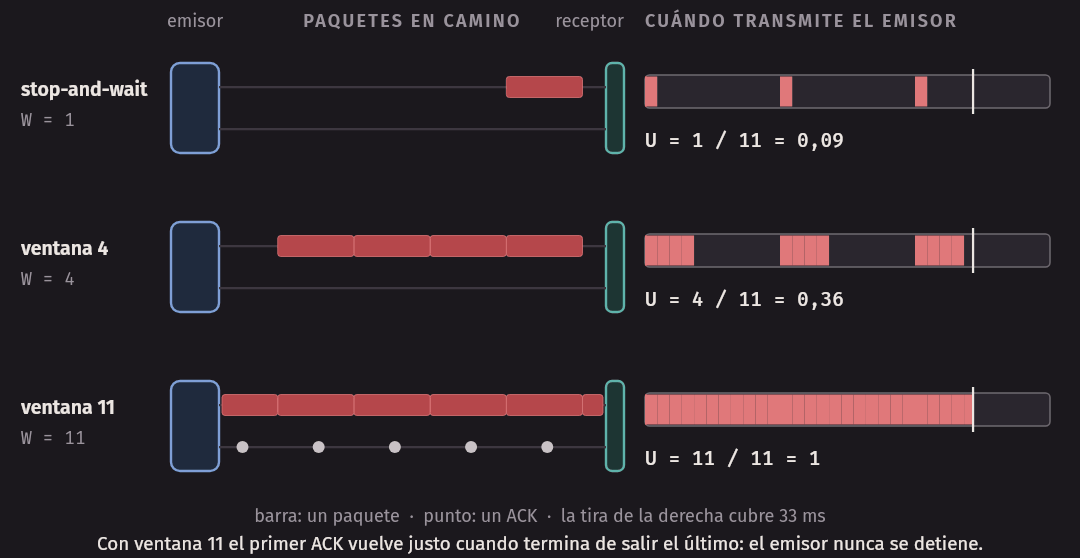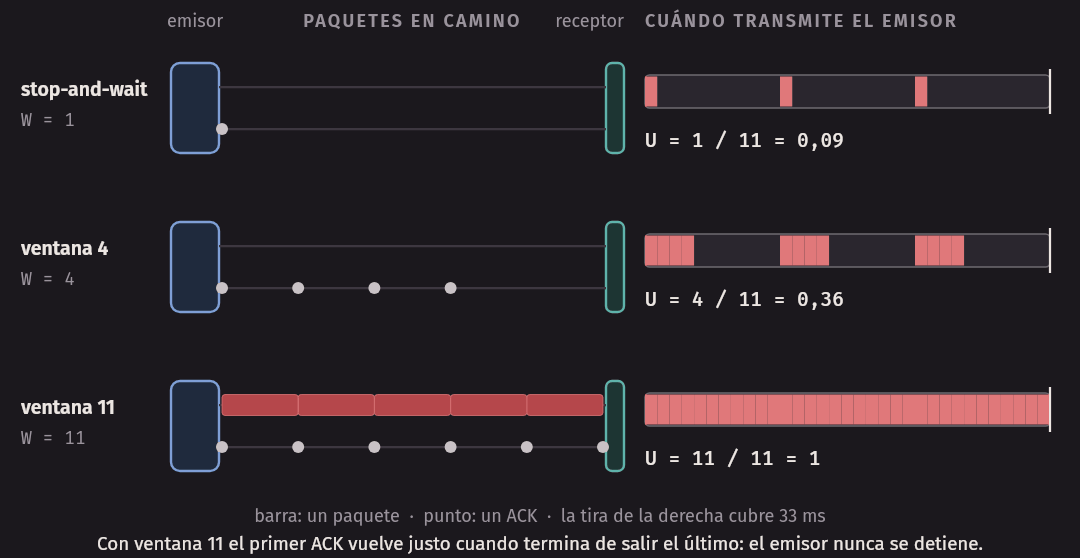
Definición. Pipelining es mandar varios paquetes sin esperar la confirmación del primero. La ventana W es el máximo de paquetes enviados y todavía sin confirmar.
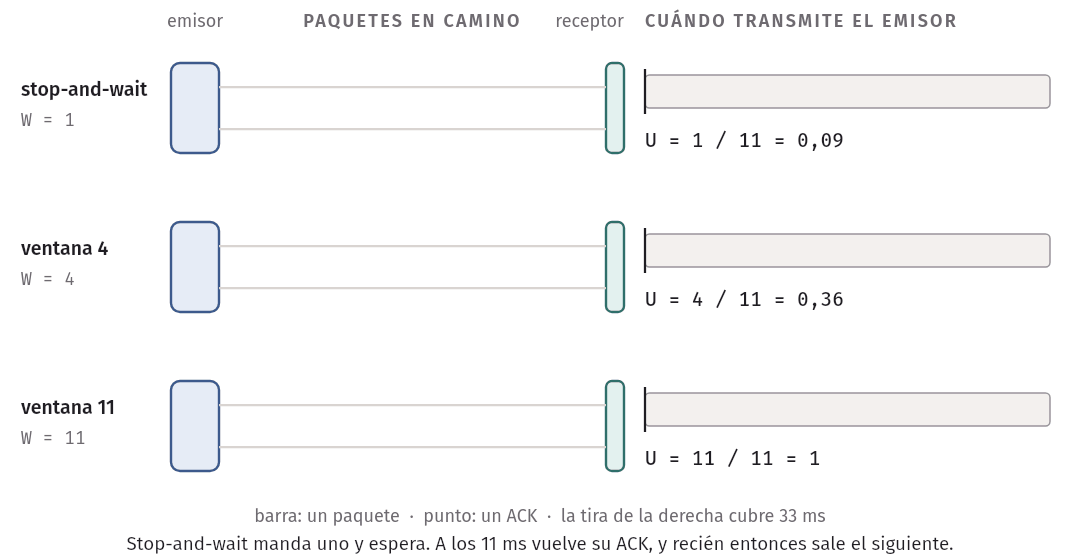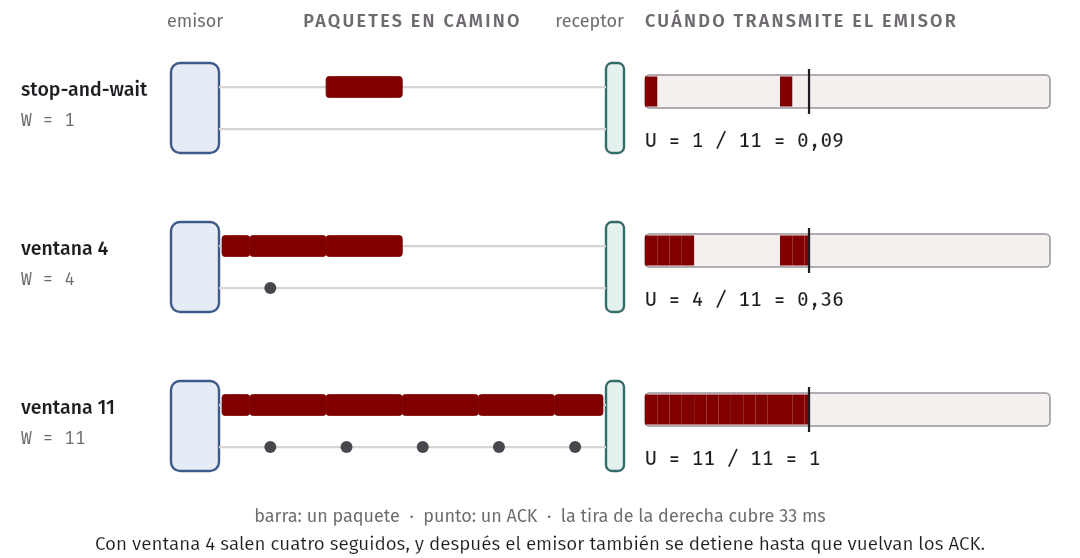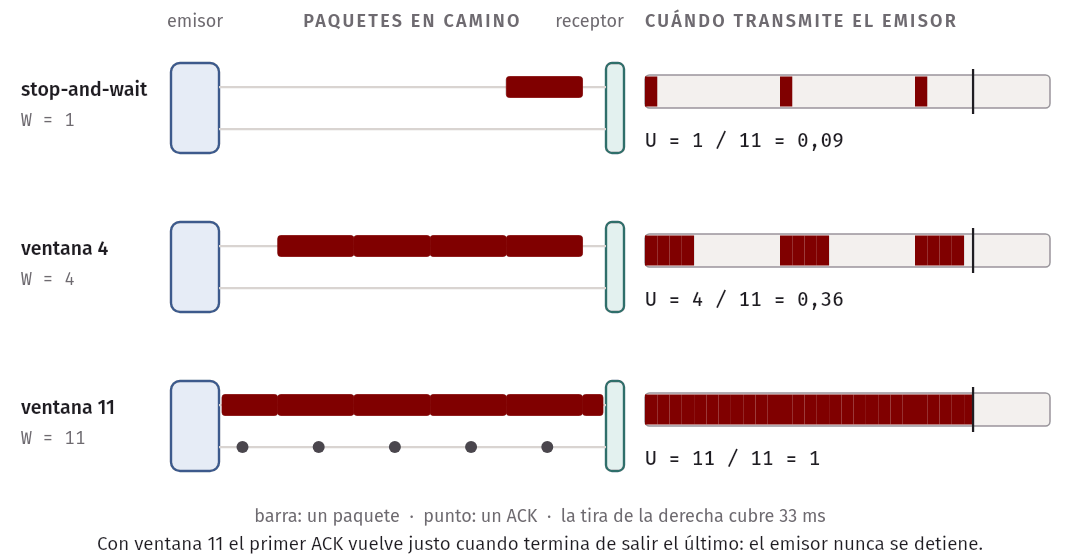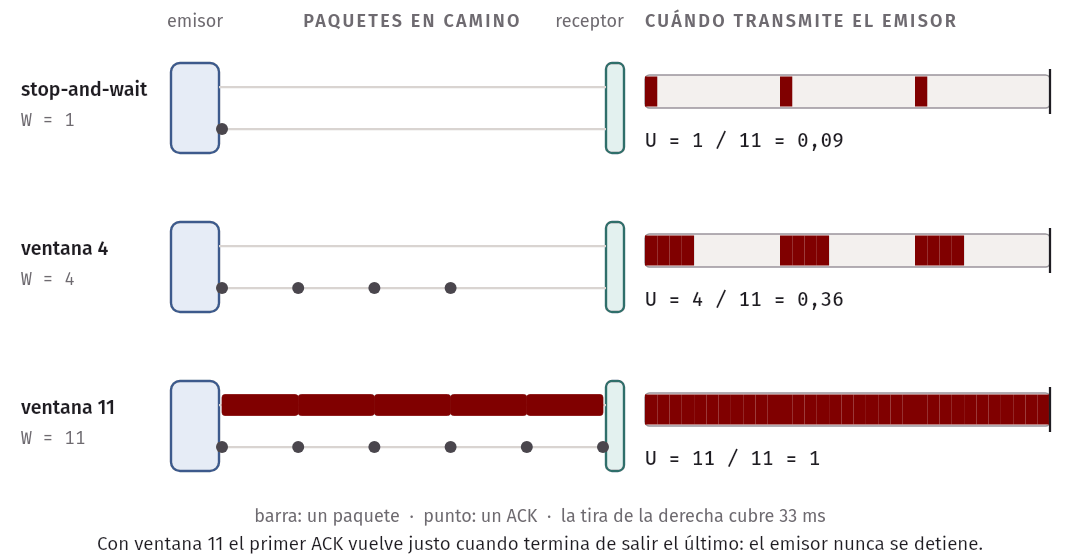
Con ventana W, el emisor manda W paquetes en cada ciclo de d + RTT:
U = min(1, W × d / (RTT + d))¿Cuánta ventana hace falta para llenar el enlace? La necesaria para que el emisor no se detenga nunca: la cantidad de paquetes que caben en d + RTT.
Definición. El producto ancho de banda × retardo (BDP) es la cantidad de datos que caben “en el tubo”: R × RTT.
Para 1 Gbps y 30 ms, el BDP es 30 000 000 bits: 3,75 MB, o 2500 paquetes de 1500 bytes. Más
el que se está transmitiendo, son 2501, como dijo window_sim.py. Para 100 Mbps y 40 ms son
500 KB: unos 333 paquetes, y 335 redondeando la fórmula hacia arriba.
Volvamos a las tablas de window_sim.py util. La fórmula y el simulador coinciden mientras la
ventana es chica, y cuando la ventana iguala al BDP la utilización se acerca a 1. El simulador
se queda en 0,976 y no en 1, porque la fórmula describe el régimen, y el simulador incluye el
final de la transferencia, cuando ya no quedan paquetes por mandar. Es el motivo por el que
simula muchas ventanas: 40 en ese caso. Duplicar la ventana después de eso no aporta más.
¿Y en una red de verdad? Aún no tenemos nuestro protocolo de ventana, pero TCP es uno. Con
iperf3 -w limitamos el buffer de su socket, y con eso su ventana, sobre el mismo enlace de
100 Mbps y 30 ms de RTT. Dos corridas seguidas, con iperf3 -t 4 (y -t 6 sin límite):
-w |
Primera corrida | Segunda corrida | Con un RTT de 32 ms, W × 8 / RTT |
|---|---|---|---|
| 16 KB | 3,64 Mbps | 3,11 Mbps | 4,1 Mbps |
| 32 KB | 8,82 Mbps | 7,79 Mbps | 8,2 Mbps |
| 64 KB | 18,2 Mbps | 17,7 Mbps | 16,4 Mbps |
| 128 KB | 33,7 Mbps | 34,6 Mbps | 32,8 Mbps |
| sin límite | 92,9 Mbps | 93,0 Mbps |
$ docker exec clab-w09-par-srv iperf3 -c 10.209.21.10 -p 5209 -t 4 -w 64K -f m
[  5]   0.00-4.03   sec  8.75 MBytes  18.2 Mbits/sec                  receiver
$ docker exec clab-w09-par-srv iperf3 -c 10.209.21.10 -p 5209 -t 6 -f m
[  5]   0.00-6.26   sec  69.4 MBytes  92.9 Mbits/sec                  receiver
El throughput crece casi en proporción a la ventana, hasta que el enlace se llena. Y todo está
muy por encima de los 0,4 Mbps que daría stop-and-wait con paquetes de 1500 bytes y 30 ms. La
última columna es solo una referencia: -w pide un tamaño de buffer, y el kernel saca de ahí
la ventana con sus propias cuentas, así que no esperen una coincidencia exacta. Además, TCP
tiene control de congestión, que veremos en la semana 11. Pero la forma de la curva es la que
dice la fórmula.
Idea clave. Para llenar un enlace hace falta una ventana de al menos un BDP. El throughput de un protocolo de ventana es, como mucho, W / RTT. Ese límite explica muchos casos reales de “tengo un enlace enorme y la transferencia va lenta”: si la ventana quedó chica, nada de lo que le hagan al enlace va a ayudar.
El precio
Mandar sin esperar obliga a resolver tres cosas que stop-and-wait no tenía:
- Más números de secuencia. Un bit ya no alcanza, con varios paquetes en camino.
- Memoria en el emisor. Tiene que guardar todo lo no confirmado, por si hay que repetirlo. Quizás también en el receptor.
- Una política ante las pérdidas. Si se pierde uno de los W que están en camino, ¿qué se hace con los otros? Hay dos respuestas clásicas, que son el resto de la sesión.
Lo que ve el emisor es esto. Los números de secuencia se dividen en cuatro zonas, y la ventana se desliza hacia la derecha a medida que llegan confirmaciones:
                base                      base + W
                  |                          |
   ... 0 1 2 3 4  5 6 7 8  9 10 11 12 ...
   \___________/  \_____/  \________/  \_____________
    confirmados   enviados  se pueden   todavía no se
                  sin       enviar      pueden enviar
                  confirmar
window_sim.py simula los dos protocolos, tal como aparecen en el libro. Trabaja con paquetes
numerados, sin conexión, sin bytes y con un temporizador fijo. Modelo: cada paquete tarda d = 1
ms en transmitirse (las líneas muestran cuándo el emisor lo entrega a su enlace), cada sentido
demora RTT / 2, el RTT es 10 ms y los ACK no ocupan tiempo de transmisión.
Go-Back-N
La idea: el receptor es lo más simple posible. Solo acepta los paquetes en orden. Si falta uno, descarta todos los que siguen, y el emisor tendrá que repetirlos.
Reglas del emisor:
- Manda mientras haya espacio en la ventana.
- Tiene un solo temporizador, para el paquete más antiguo sin confirmar. Lo reinicia cuando la ventana avanza, y lo apaga cuando no queda nada en camino.
- Si el temporizador vence, repite todo lo que esté sin confirmar, desde
base. De ahí viene el nombre.
Reglas del receptor:
- Solo guarda un número: el próximo que espera. No necesita buffer para el desorden.
- Si llega ese número, lo entrega y manda su ACK.
- Si llega cualquier otro, lo descarta y repite el ACK del último que recibió en orden.
El ACK es acumulativo: “ACK n” dice que todo hasta el n, inclusive, llegó bien. Esto tiene una ventaja: si se pierde un ACK, el siguiente lo reemplaza.
Es la cuarta pregunta de repaso: ventana 4, se pierde el paquete 2 de la secuencia 0 a 5.
$ python3 window_sim.py traza gbn --window 4 --packets 6 --drop-data 2
    0.0  emisor   envía 0
    0.0  emisor   envía 1
    0.0  emisor   envía 2  [se pierde]
    0.0  emisor   envía 3
    6.0  receptor recibe 0, entrega el contenido 0
    6.0  receptor   ACK 0
    7.0  receptor recibe 1, entrega el contenido 1
    7.0  receptor   ACK 1
    9.0  receptor recibe 3: esperaba 2, lo descarta
    9.0  receptor   ACK 1
   11.0  emisor   recibe ACK 0: confirma hasta 0
   11.0  emisor   envía 4
   12.0  emisor   recibe ACK 1: confirma hasta 1
   12.0  emisor   envía 5
   14.0  emisor   recibe ACK 1: ya confirmado, lo ignora
   17.0  receptor recibe 4: esperaba 2, lo descarta
   17.0  receptor   ACK 1
   18.0  receptor recibe 5: esperaba 2, lo descarta
   18.0  receptor   ACK 1
   22.0  emisor   recibe ACK 1: ya confirmado, lo ignora
   23.0  emisor   recibe ACK 1: ya confirmado, lo ignora
   40.0  emisor   vence el temporizador: repite desde 2
   40.0  emisor   repite 2
   40.0  emisor   repite 3
   40.0  emisor   repite 4
   40.0  emisor   repite 5
   46.0  receptor recibe 2, entrega el contenido 2
   46.0  receptor   ACK 2
   47.0  receptor recibe 3, entrega el contenido 3
   47.0  receptor   ACK 3
   48.0  receptor recibe 4, entrega el contenido 4
   48.0  receptor   ACK 4
   49.0  receptor recibe 5, entrega el contenido 5
   49.0  receptor   ACK 5
   51.0  emisor   recibe ACK 2: confirma hasta 2
   52.0  emisor   recibe ACK 3: confirma hasta 3
   53.0  emisor   recibe ACK 4: confirma hasta 4
   54.0  emisor   recibe ACK 5: confirma hasta 5
entregado: [0, 1, 2, 3, 4, 5]   transmisiones: 10 (repetidas: 4)   tiempo: 54.0 ms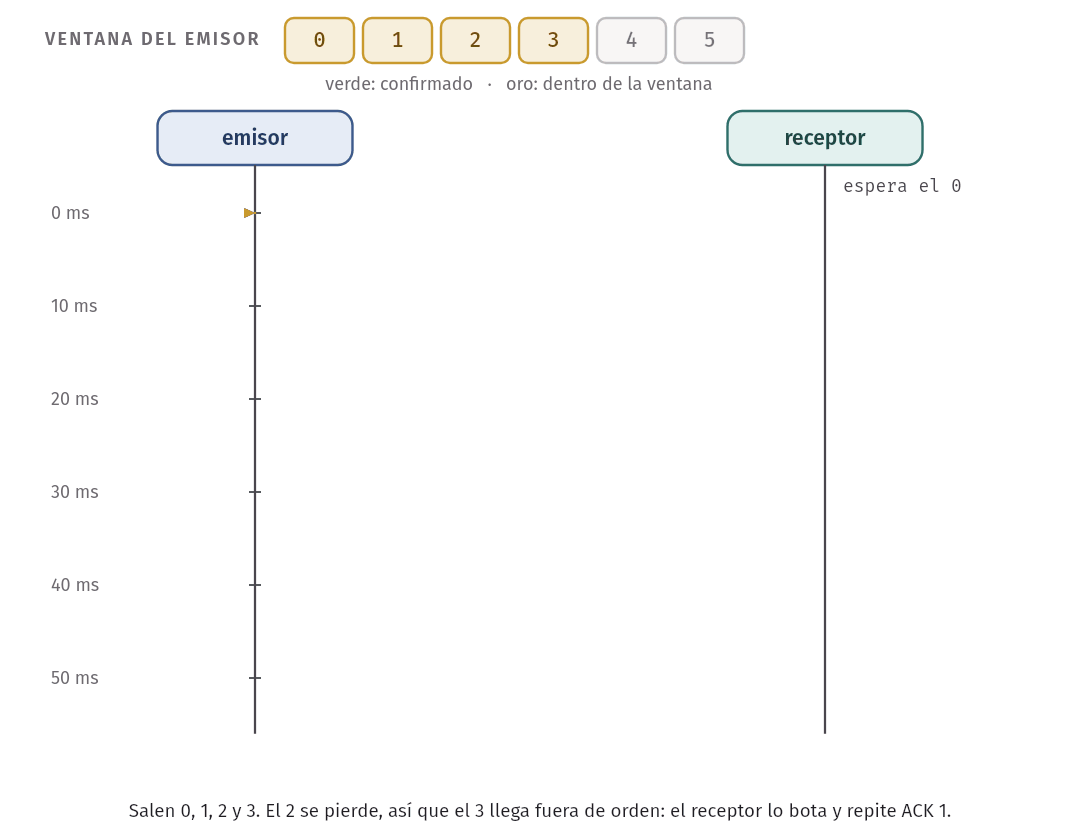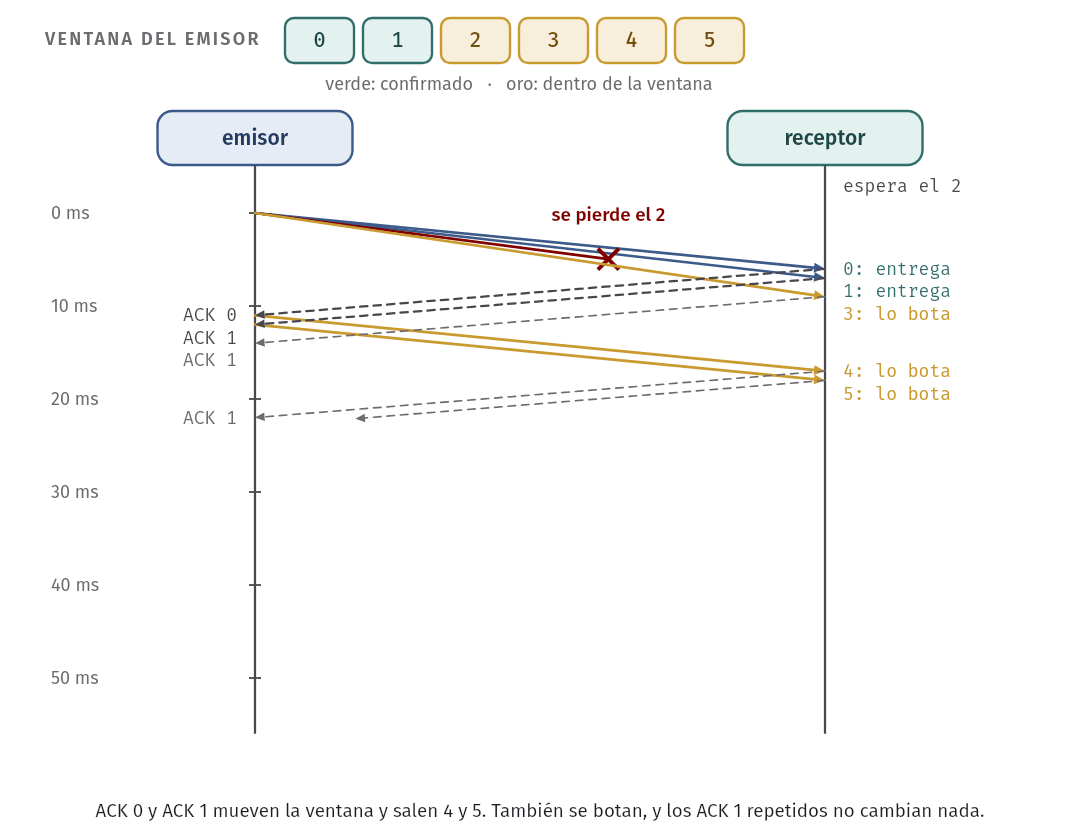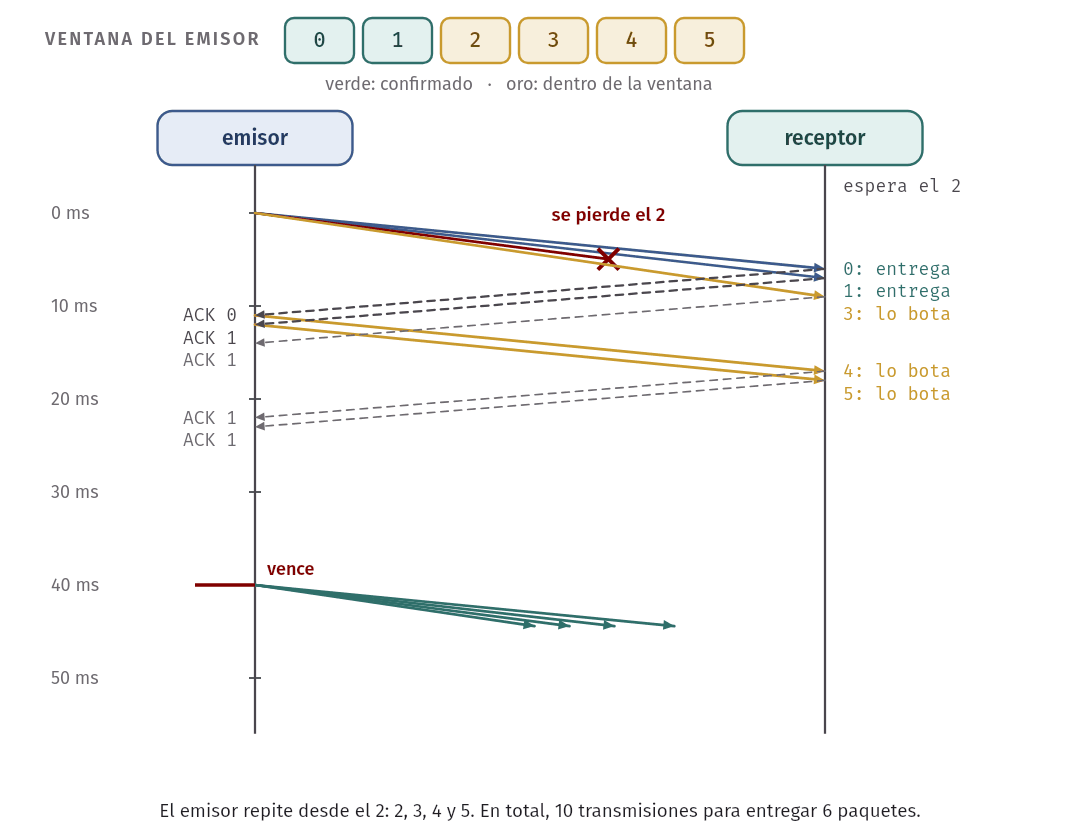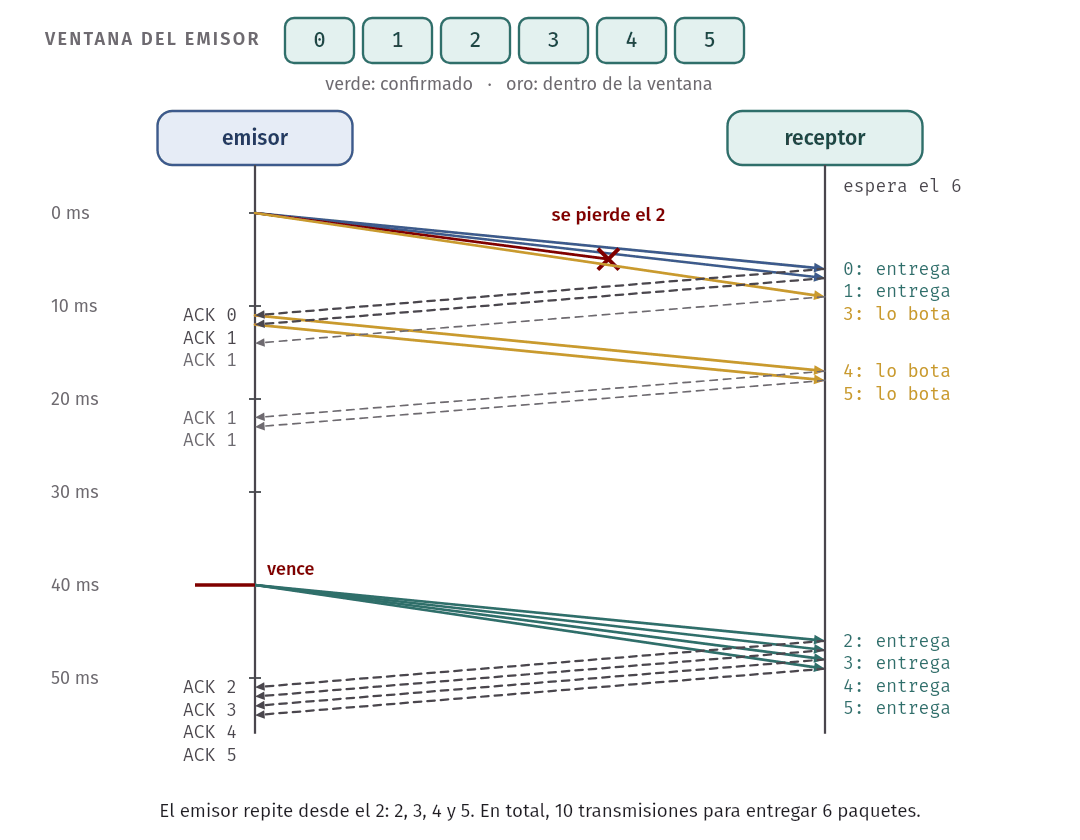
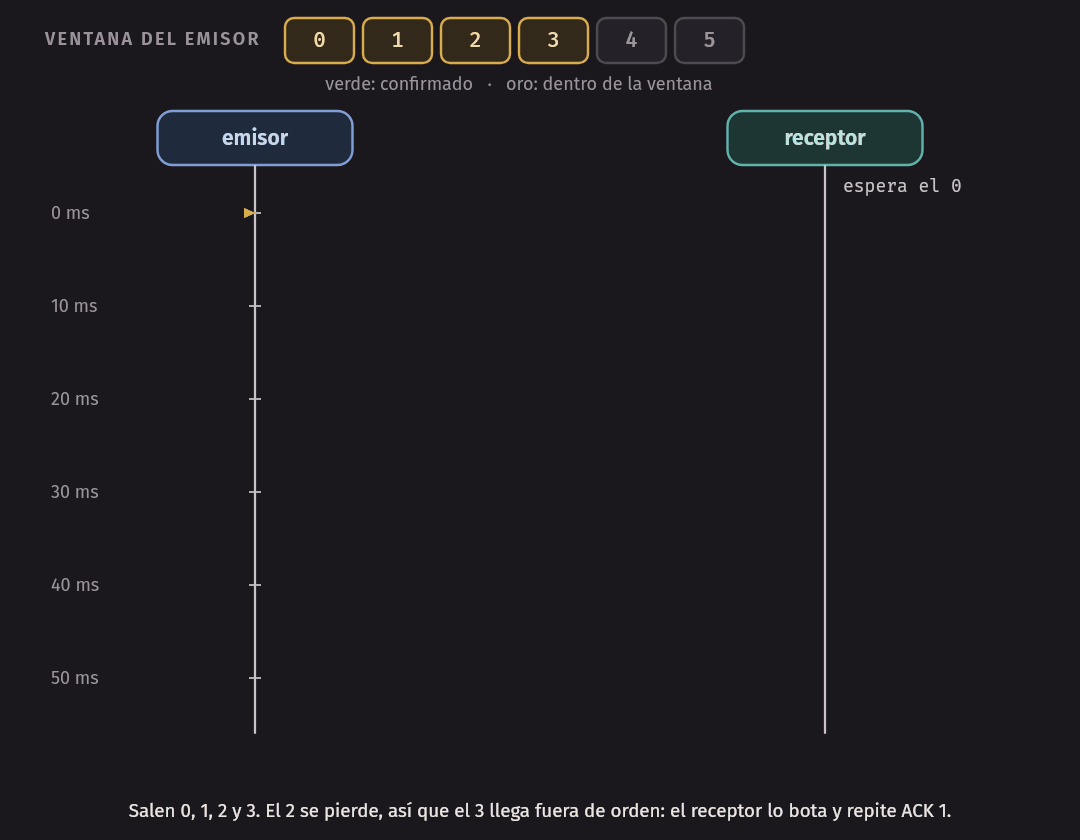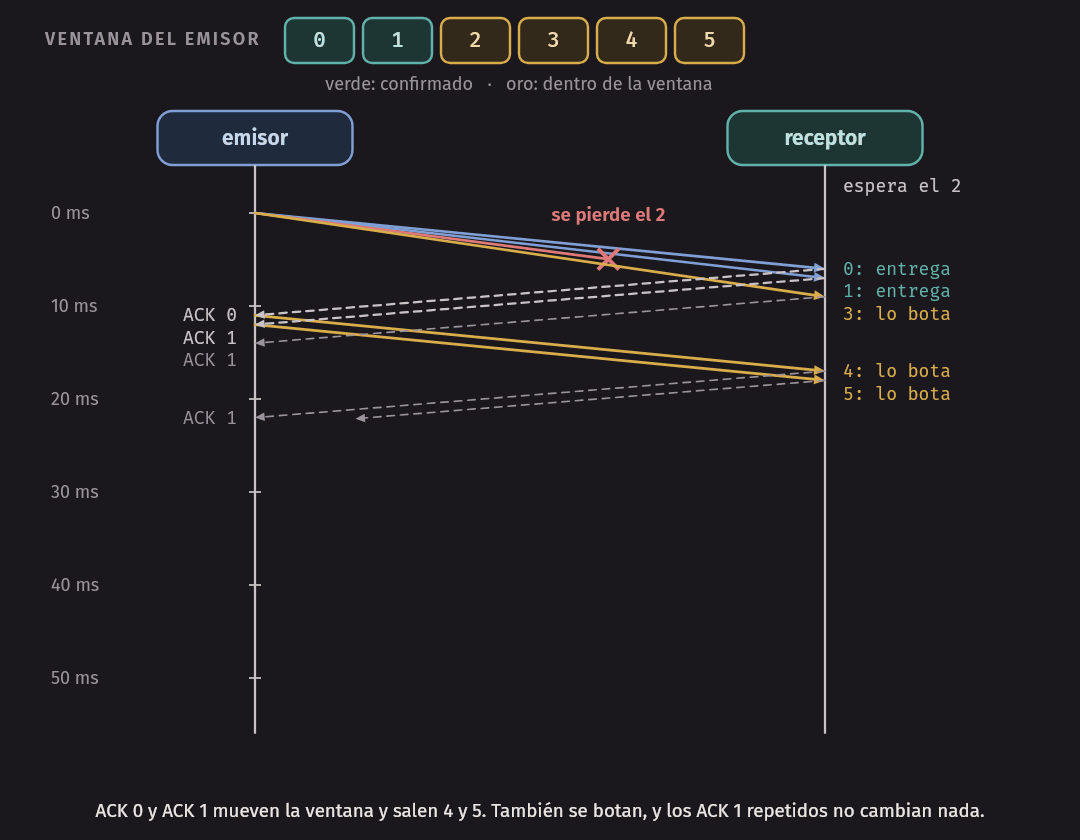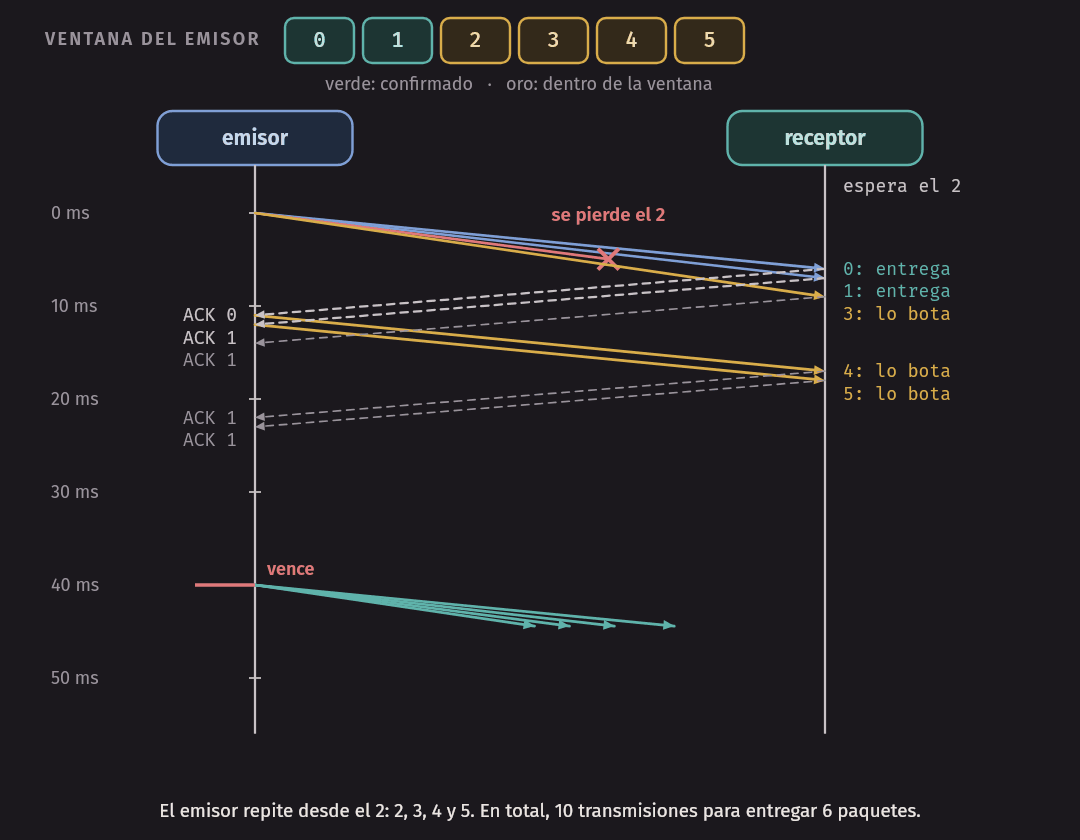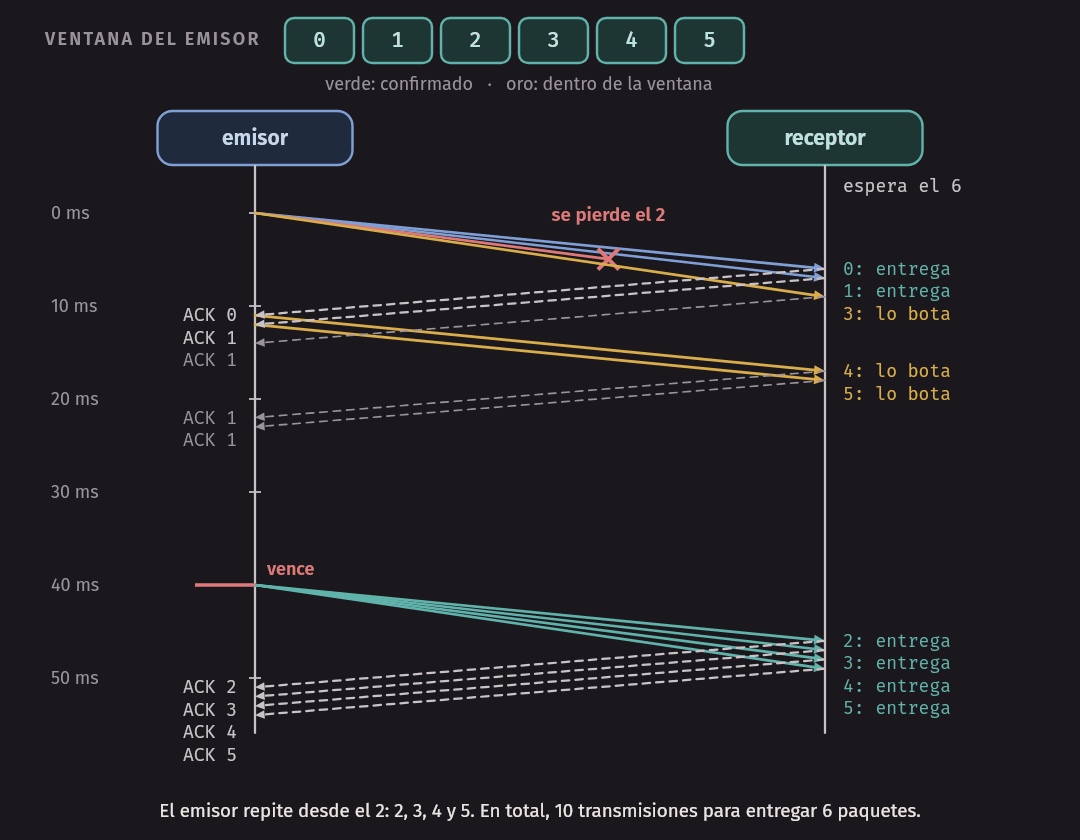
Lean la traza con calma. El receptor recibió bien 3, 4 y 5, y los botó. Los ACK repetidos del 1 llegaron al emisor, que no hizo nada con ellos: nuestro Go-Back-N de libro solo reacciona al temporizador. Se transmitieron 10 paquetes para entregar 6.
Error común. Los números de ACK tienen dos convenciones, y conviene no confundirlas. Aquí y en el libro, para Go-Back-N y Selective Repeat, “ACK n” confirma el paquete n. En TCP y en el campo
ackde P3, en cambio, el ACK dice cuál es el siguiente byte que se espera. Tras recibir hasta el paquete 1, el primero diría “ACK 1”, y el segundo diría el número del primer byte del paquete 2. Lean siempre la definición del protocolo que tienen delante.
Selective Repeat
La idea: no botar lo que llegó bien. El receptor guarda lo que llega fuera de orden, confirma cada paquete por separado, y el emisor solo repite lo que de verdad faltó.
Reglas del emisor:
- Manda mientras haya espacio en la ventana.
- Tiene un temporizador por paquete. Si uno vence, repite solo ese.
- Marca cada paquete confirmado. La ventana avanza cuando se confirma el más antiguo, hasta el primero que siga sin confirmar.
Reglas del receptor, con rcv_base como el próximo paquete por entregar:
- Si llega algo en
[rcv_base, rcv_base + W - 1]: lo confirma y lo guarda. Si esrcv_base, entrega ese y todos los consecutivos que tenga, y su ventana avanza. - Si llega algo en
[rcv_base - W, rcv_base - 1]: ya lo entregó, pero igual lo confirma. - Cualquier otra cosa se ignora.
La segunda regla es la que siempre se olvida, y es indispensable. Si un ACK se perdió, el emisor sigue repitiendo ese paquete. El receptor ya lo tiene, pero si no vuelve a confirmarlo, la ventana del emisor se queda detenida para siempre.
La misma pérdida de antes:
$ python3 window_sim.py traza sr --window 4 --packets 6 --drop-data 2
    0.0  emisor   envía 0
    0.0  emisor   envía 1
    0.0  emisor   envía 2  [se pierde]
    0.0  emisor   envía 3
    6.0  receptor recibe 0, entrega el contenido [0]
    6.0  receptor   ACK 0
    7.0  receptor recibe 1, entrega el contenido [1]
    7.0  receptor   ACK 1
    9.0  receptor recibe 3, lo guarda
    9.0  receptor   ACK 3
   11.0  emisor   recibe ACK 0
   11.0  emisor   envía 4
   12.0  emisor   recibe ACK 1
   12.0  emisor   envía 5
   14.0  emisor   recibe ACK 3
   17.0  receptor recibe 4, lo guarda
   17.0  receptor   ACK 4
   18.0  receptor recibe 5, lo guarda
   18.0  receptor   ACK 5
   22.0  emisor   recibe ACK 4
   23.0  emisor   recibe ACK 5
   31.0  emisor   vence el temporizador de 2
   31.0  emisor   repite 2
   37.0  receptor recibe 2, entrega el contenido [2, 3, 4, 5]
   37.0  receptor   ACK 2
   42.0  emisor   recibe ACK 2
entregado: [0, 1, 2, 3, 4, 5]   transmisiones: 7 (repetidas: 1)   tiempo: 42.0 ms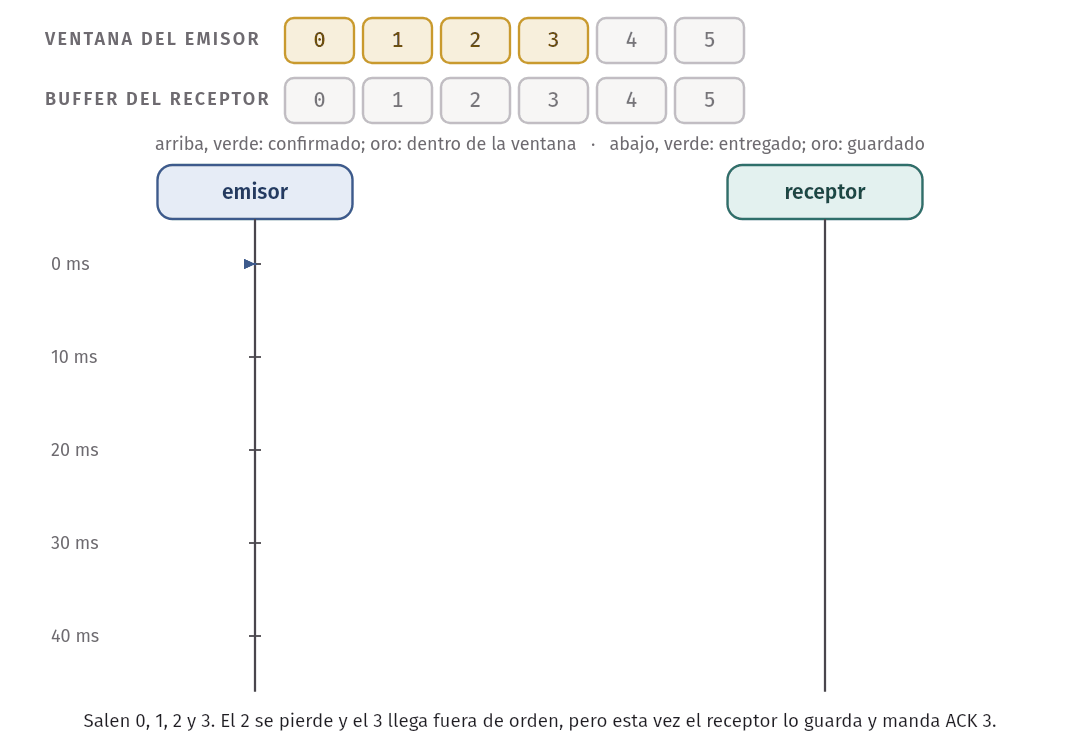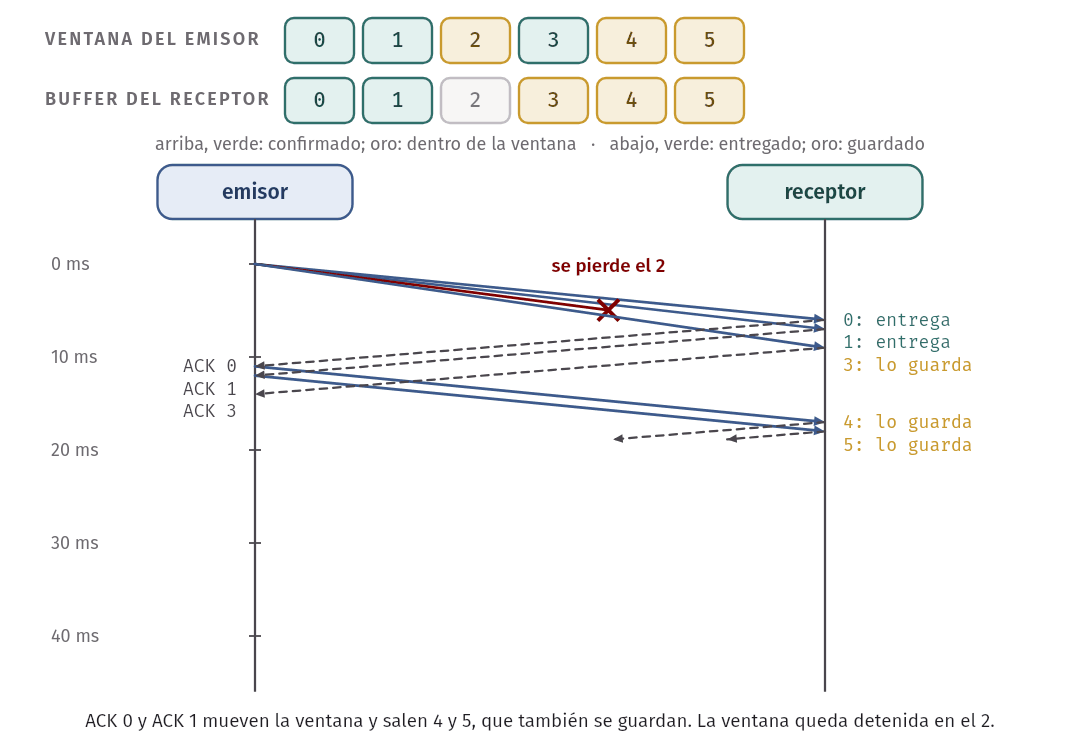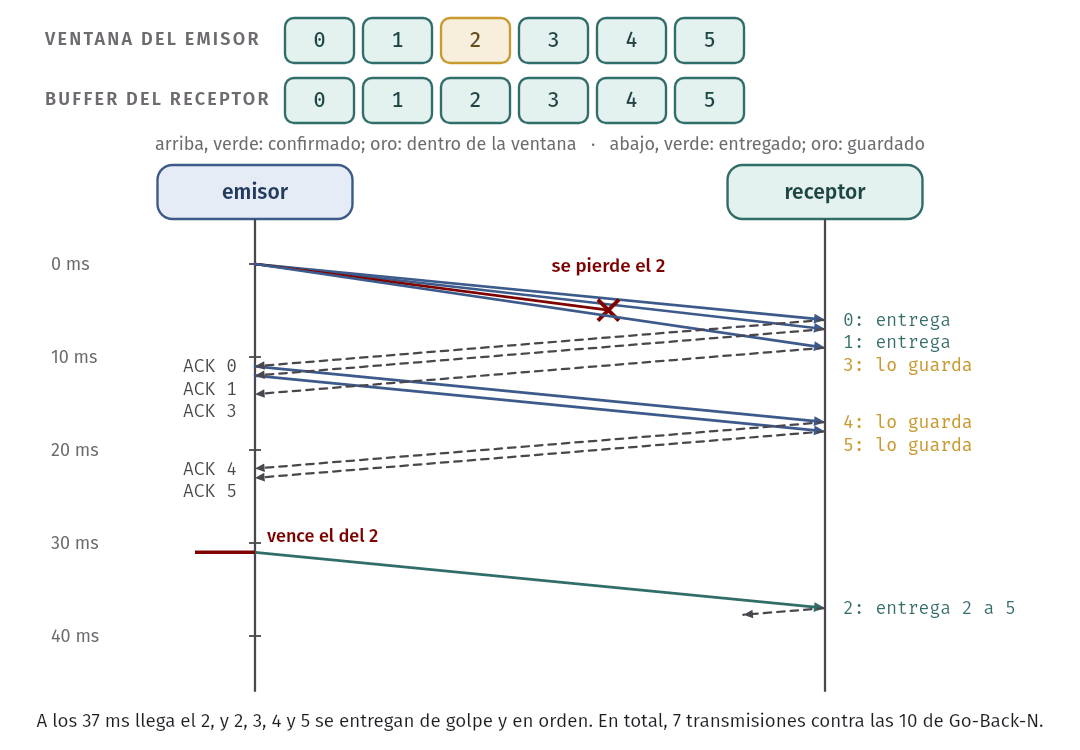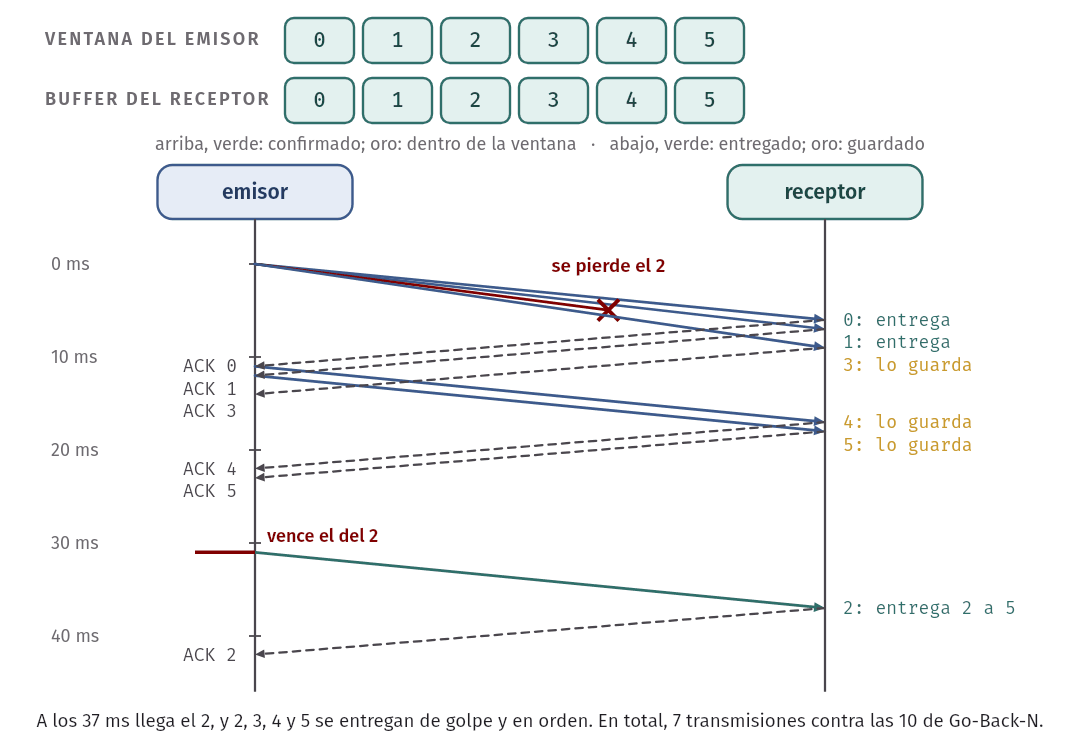
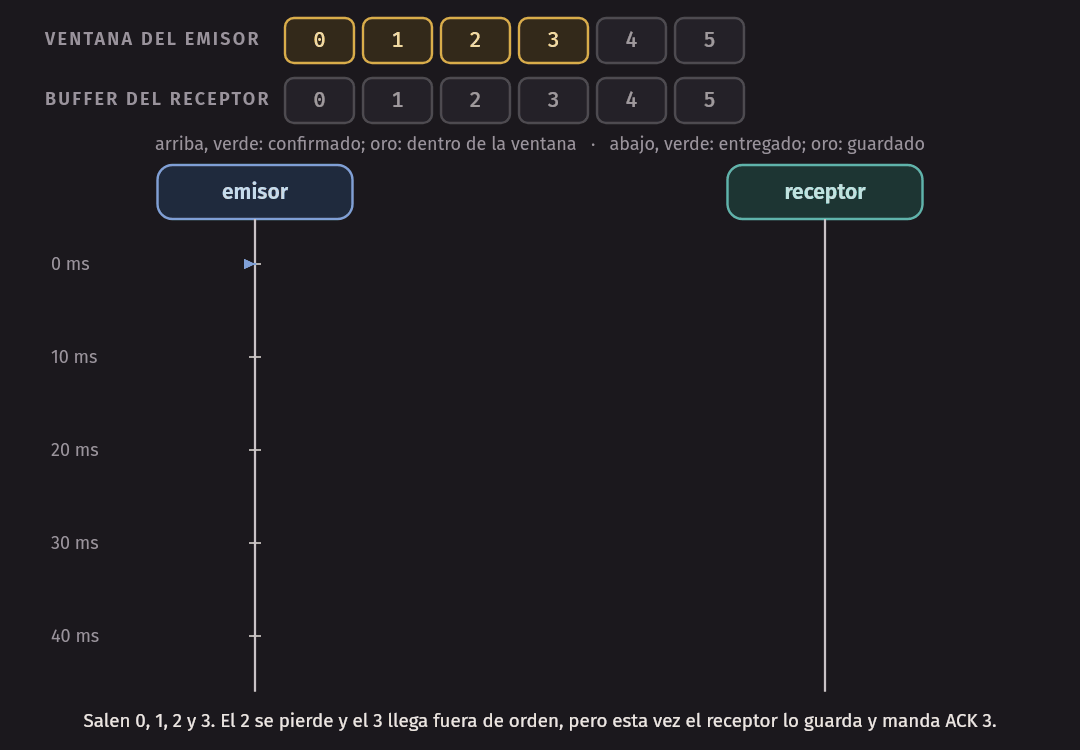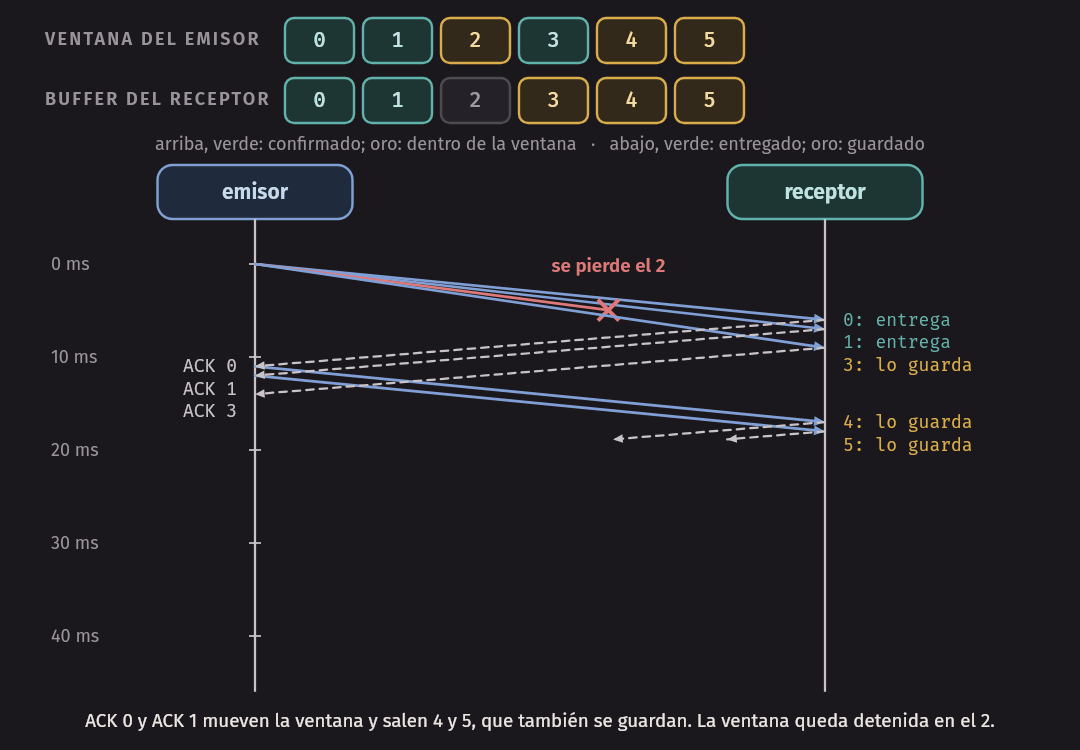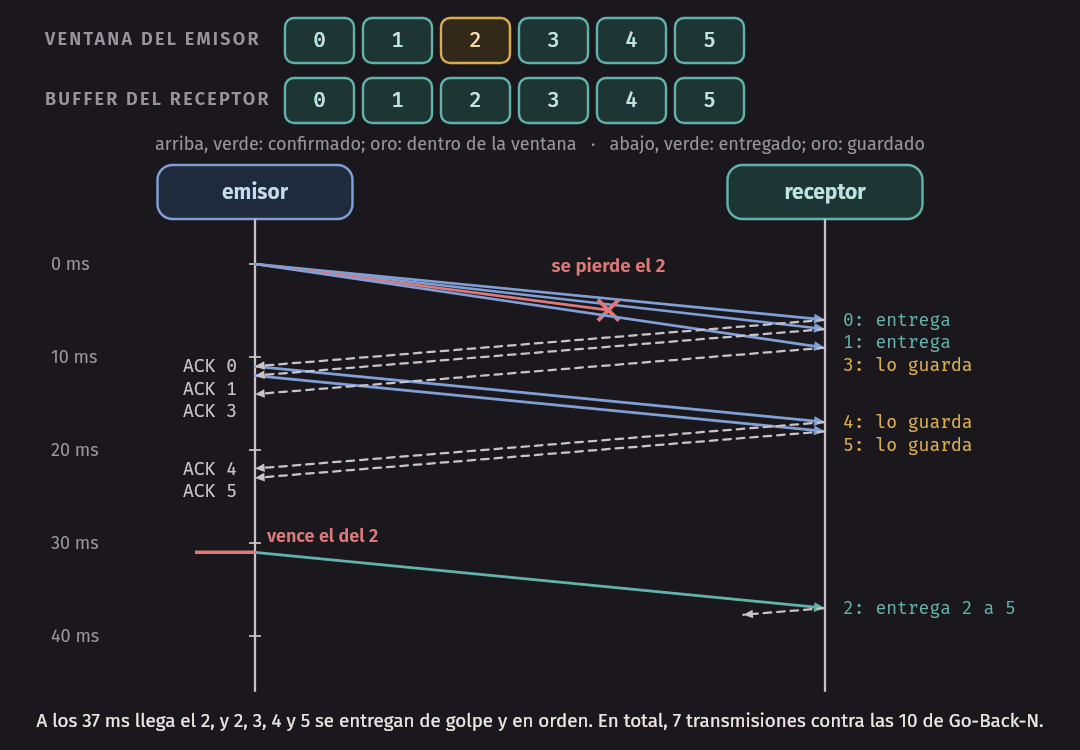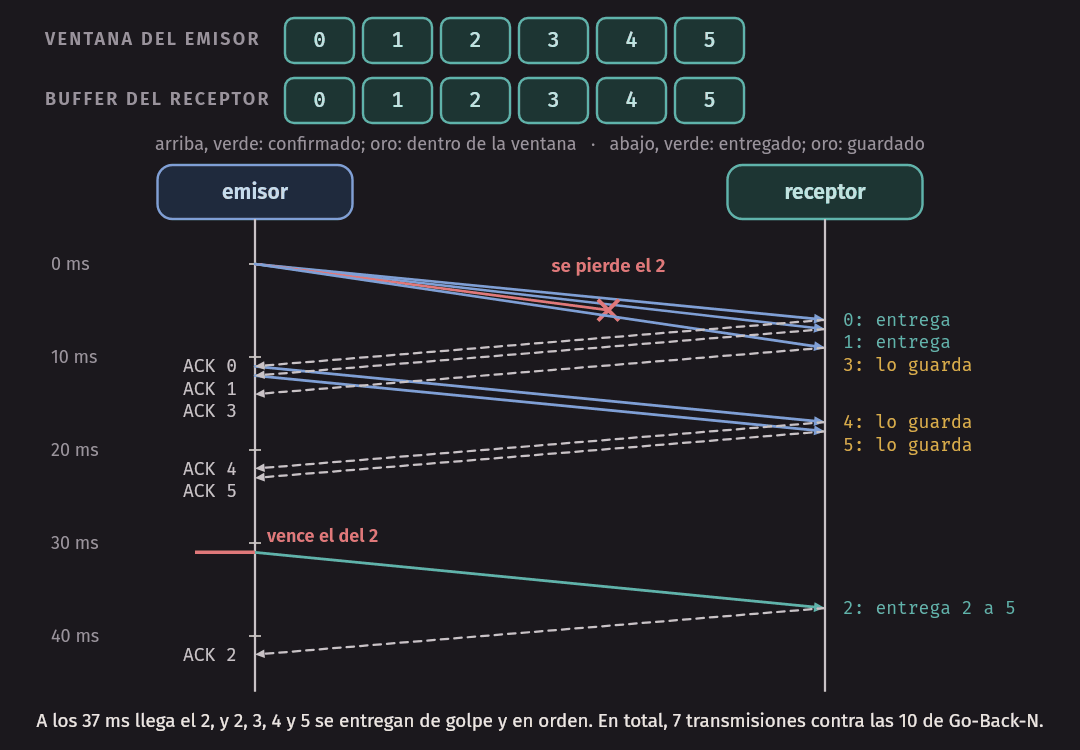
Siete transmisiones contra diez. Fíjense en el instante 37: el receptor tenía guardados 3, 4 y 5, y los entrega de golpe, en orden, en cuanto llega el 2. La aplicación nunca ve el desorden. Eso significa que durante unos 20 ms esos datos ya estaban en la máquina sin poder usarse.
Comparación
| Go-Back-N | Selective Repeat | |
|---|---|---|
| ACK | Acumulativo | Individual |
| Temporizadores | Uno | Uno por paquete |
| Receptor | Un número; descarta el desorden | Buffer de W paquetes |
| Ante una pérdida | Repite todo desde el perdido | Repite solo el perdido |
| Si se pierde un ACK | El siguiente lo cubre | Se repite ese paquete |
| Límite de ventana, con 2^k números | 2^k - 1 | 2^(k-1) |
Medimos con el simulador. Una ventana de 50, un RTT de 40 ms y 1 ms por paquete, de modo que la ventana cubre el BDP de 41 paquetes. La pérdida es aleatoria e independiente, el temporizador es fijo, y cada fila promedia cinco semillas. La columna envíos/paq cuenta las transmisiones por paquete entregado, y U es la utilización. Son resultados exactos del modelo, no de una red:
$ python3 window_sim.py barrido
ventana 50, 2000 paquetes, d = 1 ms, RTT = 40 ms, temporizador = 180 ms, promedio de 5 semillas
pérdida en los dos sentidos:
 pérdida | GBN envíos/paq   GBN U |  SR envíos/paq    SR U
    0.0% |           1.00    0.98 |           1.00    0.98
    0.1% |           1.09    0.71 |           1.00    0.73
    1.0% |           1.50    0.31 |           1.02    0.35
    5.0% |           3.74    0.07 |           1.11    0.20
   10.0% |           6.71    0.04 |           1.23    0.14
   20.0% |          13.27    0.02 |           1.55    0.08
pérdida solo en los ACK:
 pérdida | GBN envíos/paq   GBN U |  SR envíos/paq    SR U
    0.0% |           1.00    0.98 |           1.00    0.98
    0.1% |           1.00    0.98 |           1.00    0.82
    1.0% |           1.00    0.98 |           1.01    0.47
    5.0% |           1.00    0.98 |           1.05    0.26
   10.0% |           1.00    0.98 |           1.11    0.20
   20.0% |           1.00    0.98 |           1.24    0.13
Cuatro cosas salen de esas tablas:
Sin pérdidas son iguales. La complejidad de Selective Repeat no compra nada cuando no se pierde nada.
Con muchas pérdidas, Go-Back-N se derrumba. Al 20 %, manda más de 13 veces cada paquete, porque cada pérdida arrastra a toda la ventana, y esas repeticiones también se pierden. Selective Repeat se puede predecir con una cuenta: un paquete queda confirmado si llegan él y su ACK, con probabilidad 0,8 × 0,8 = 0,64. El promedio de envíos es 1 / 0,64 = 1,56, y el simulador da 1,55.
La pérdida de ACK favorece al ACK acumulativo. Con pérdida solo en los ACK, Go-Back-N ni se inmuta: el siguiente ACK cubre al perdido. A Selective Repeat, en cambio, le cuesta caro. Cada ACK perdido obliga a una repetición (1 / 0,8 = 1,25, y el simulador da 1,24) y, peor aún, deja a la ventana detenida hasta que vence el temporizador. Ninguno de los dos es mejor en todo.
El temporizador pesa mucho. La utilización de Selective Repeat al 10 % es solo 0,14, aunque casi no repite nada: lo que le cuesta es esperar. Con el temporizador en 60 ms en lugar de 180, se ve la diferencia. Los envíos no cambian y la utilización sube mucho (mostramos solo la primera tabla):
$ python3 window_sim.py barrido --timeout 60
ventana 50, 2000 paquetes, d = 1 ms, RTT = 40 ms, temporizador = 60 ms, promedio de 5 semillas
pérdida en los dos sentidos:
 pérdida | GBN envíos/paq   GBN U |  SR envíos/paq    SR U
    0.0% |           1.00    0.98 |           1.00    0.98
    0.1% |           1.09    0.83 |           1.00    0.88
    1.0% |           1.50    0.48 |           1.02    0.62
    5.0% |           3.74    0.14 |           1.11    0.43
   10.0% |           6.71    0.07 |           1.23    0.33
   20.0% |          13.27    0.04 |           1.55    0.22
Este modelo deja cosas fuera. No hay colas ni otros flujos, de modo que repetir no empeora nada; en una red real, una ventana grande que repite mucho puede ser justamente lo que está congestionando el enlace. Y nadie reacciona a una pérdida antes del temporizador. Los protocolos reales no se quedan en ninguno de estos dos extremos. TCP, que veremos la próxima semana, usa ACK acumulativos, y además guarda lo que llega fuera de orden. Cuando uno lee “TCP es Go-Back-N” o “TCP es Selective Repeat”, las dos frases están mal.
Idea clave. Go-Back-N y Selective Repeat son dos puntos en un diseño: cuánta complejidad se pone en el receptor y cuánta información lleva cada ACK. Si hay pocas pérdidas casi no se diferencian. Si hay muchas, conviene no repetir lo que ya llegó.
Y esto en P3
Hoy se publica P3: rimay, un protocolo confiable real, en C, sobre UDP. Lean su enunciado con
esta semana en mente, y noten que no les pide ninguno de los dos protocolos de libro tal cual. Su
ACK es acumulativo y cuenta bytes, y además exige recordar los paquetes que llegan fuera de orden.
También les pide cosas que no vimos hoy, como el cálculo del RTO y el control de flujo, que son de la
semana 10. Los simuladores de esta semana sirven para razonar: paquetes numerados, un temporizador
fijo, sin red y sin ninguna de esas decisiones. Antes de escribir código en C, contesten por escrito:
¿cuándo avanza su ventana? ¿qué guarda cada lado y hasta cuándo? ¿qué hace cada lado ante un
duplicado?
Cuántos números de secuencia hacen falta
Hasta ahora, los números de secuencia no tenían límite. Pero en un paquete real son un campo de k bits: hay 2^k valores, y dan la vuelta. Con cuatro números: 0, 1, 2, 3, 0, 1, 2, 3…
¿Qué tan grande puede ser la ventana? Veamos la quinta pregunta de repaso: Selective Repeat con cuatro números y ventana 3. El emisor manda 0, 1 y 2, todos llegan bien, y se pierden los tres ACK. El receptor entregó todo y avanzó su ventana, y ahora acepta 3, 0 y 1. El emisor no sabe nada, vence su temporizador y repite el 0, el paquete viejo. El receptor ve un 0, que está en su ventana, y lo acepta como nuevo.
window_sim.py lo muestra. Cada paquete lleva un contenido, para poder ver qué se entregó de verdad.
Mostramos el comienzo de la traza:
$ python3 window_sim.py ambiguedad
--- sr: 4 números, ventana 3; se pierden los ACK de la primera ronda
    0.0  emisor   envía 0
    0.0  emisor   envía 1
    0.0  emisor   envía 2
    6.0  receptor recibe 0, entrega el contenido [0]
    6.0  receptor   ACK 0  [se pierde]
    7.0  receptor recibe 1, entrega el contenido [1]
    7.0  receptor   ACK 1  [se pierde]
    8.0  receptor recibe 2, entrega el contenido [2]
    8.0  receptor   ACK 2  [se pierde]
   27.0  emisor   vence el temporizador de 0
   27.0  emisor   repite 0
   28.0  emisor   vence el temporizador de 1
   28.0  emisor   repite 1
   29.0  emisor   vence el temporizador de 2
   29.0  emisor   repite 2
   33.0  receptor recibe 0, lo guarda
   33.0  receptor   ACK 0
   34.0  receptor recibe 1, lo guarda
   34.0  receptor   ACK 1
   35.0  receptor recibe 2: ya entregado, solo confirma
   35.0  receptor   ACK 2
   38.0  emisor   recibe ACK 0
   38.0  emisor   envía 3
   39.0  emisor   recibe ACK 1
   39.0  emisor   envía 0
   40.0  emisor   recibe ACK 2
   40.0  emisor   envía 1
   44.0  receptor recibe 3, entrega el contenido [3, 0, 1]
   44.0  receptor   ACK 3
   45.0  receptor recibe 0, lo guarda
        ... (14 líneas más)
contenidos entregados: [0, 1, 2, 3, 0, 1, 6, 7, 4]   (INCORRECTO)
Miren el instante 33: el receptor guarda como nuevos unos 0 y 1 que son repeticiones. En el 44 los
entrega: la aplicación recibe [3, 0, 1], es decir, datos viejos en el lugar de datos nuevos, sin
ningún error a la vista. Todos los checksums están bien. El resultado final es 0 1 2 3 0 1 6 7 4: el 0 y
el 1 se repiten, el 4 aparece fuera de lugar y el 5 no se entrega nunca. Y el emisor cree que todo salió bien.
El receptor no tenía cómo evitarlo. Vean las dos historias posibles, desde su punto de vista:
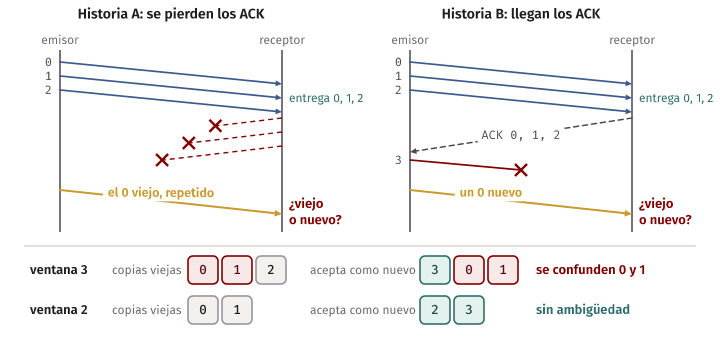
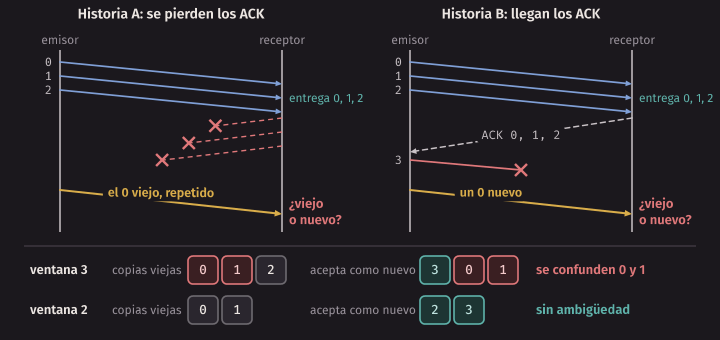
Lo que ve es idéntico en los dos casos, y lo correcto es distinto. Con ventana 2 el problema desaparece:
--- sr: 4 números, ventana 2; se pierden los ACK de la primera ronda
    0.0  emisor   envía 0
    0.0  emisor   envía 1
    6.0  receptor recibe 0, entrega el contenido [0]
    6.0  receptor   ACK 0  [se pierde]
    7.0  receptor recibe 1, entrega el contenido [1]
    7.0  receptor   ACK 1  [se pierde]
   25.0  emisor   vence el temporizador de 0
   25.0  emisor   repite 0
   26.0  emisor   vence el temporizador de 1
   26.0  emisor   repite 1
   31.0  receptor recibe 0: ya entregado, solo confirma
   31.0  receptor   ACK 0
   32.0  receptor recibe 1: ya entregado, solo confirma
   32.0  receptor   ACK 1
(Y sigue hasta terminar, con contenidos entregados: [0, 1, 2, 3, 4, 5, 6, 7] (correcto).)
La regla
La condición sale de comparar dos conjuntos. El receptor espera r. El emisor puede estar atrasado hasta
una ventana entera, porque quizás no le llegó ningún ACK: las copias viejas que pueden llegar son r - W
a r - 1. Lo que el receptor aceptaría como nuevo es r a r + W - 1 en Selective Repeat, y solo r en
Go-Back-N. Hay ambigüedad si un número de un conjunto coincide con uno del otro, una vez reducidos a los
números disponibles.
- Selective Repeat: son 2W números seguidos, y deben ser todos distintos. Hace falta W ≤ N / 2.
- Go-Back-N: son W + 1 números seguidos. Hace falta W ≤ N - 1.
seq_space.py revisa los dos conjuntos caso por caso:
$ python3 seq_space.py
 números  bits  GBN: W máx  SR: W máx
       2     1           1          1
       4     2           3          2
       8     3           7          4
      16     4          15          8

sr, 4 números, ventana 2: sin ambigüedad
sr, 4 números, ventana 3: se confunden [0, 1]
gbn, 4 números, ventana 3: sin ambigüedad
gbn, 4 números, ventana 4: se confunden [0]
La primera fila es el stop-and-wait de la Sesión A: un bit, ventana 1. Y en test_sim.py, esta regla se comprueba
también con el simulador completo: Go-Back-N con cuatro números funciona con ventana 3 y falla con ventana 4.
Error común. Creer que con esto basta para cualquier red. La cuenta supone que un paquete no se queda perdido en la red más tiempo que el que tarda en pasar una ventana. Si una copia muy vieja reaparece después de que los números dieron la vuelta, ningún tamaño de ventana lo arregla. Por eso los protocolos reales usan espacios enormes (32 bits en TCP y en P3), y IP limita la vida de un paquete con el TTL.
Laboratorio: el hackathon
El laboratorio de esta semana no usa nada de lo anterior. Es el cierre de la parte de routing: los sistemas autónomos de todos los equipos, conectados en una sola red, en la computadora del docente. Es una de las clases que más enseñan del curso, porque aparece lo que no sale en ningún enunciado: las fallas de coordinación.
Cómo funciona
- Cada equipo entrega su carpeta
as/de P2 antes de empezar. Como dice el enunciado, no puede depender de nada que esté fuera deas/, y los vecinos reales se asignan ese día enas/vecinos.env. - El docente levanta la topología completa. Las sesiones BGP se abren solas a partir de
as/vecinos.env, y los equipos entran a sus routers a revisar y depurar las que no suban. - El objetivo es que todos los sistemas autónomos se alcancen, con caminos que respeten las políticas. Un tablero muestra quién alcanza a quién.
- Lo que falla se diagnostica con
show bgp summary,show bgp ipv4ytraceroute. - El docente corta un enlace de tránsito, y cada equipo comprueba si sigue conectado.
- La discusión final: qué falló, y cuánto de eso era técnico y cuánto era coordinación entre equipos.
- Se entrega P2 y se lee el enunciado de P3.
El ensayo
Para llegar con práctica, code/week-09/ensayo/ tiene un hackathon en miniatura: cuatro “equipos” de un solo router y dos
proveedores. Es una topología propia de esta semana, con direcciones que no chocan con las de ningún equipo, y no es una
solución de P2: los routers de esta red casi no tienen políticas. Por la misma razón de la semana 6, no bgp ebgp-requires-policy sigue puesto: aquí interesa la coordinación, no las políticas.
            t1 ------- peer ------- t2         AS 64901 y 64902
          /  |  \                 /  |  \
         /   |   \_____ e2 ______/   |   \
        /    |                       |    \
      e1     \________ e3 ___________/     e4
\_______ peer ______/| Equipo | AS | Prefijo | Proveedores | Peer |
|---|---|---|---|---|
e1 |
64911 | 100.64.11.0/24 |
t1 |
|
e2 |
64912 | 100.64.12.0/24 |
t1, t2 |
|
e3 |
64913 | 100.64.13.0/24 |
t1, t2 |
e4 |
e4 |
64914 | 100.64.14.0/24 |
t2 |
e3 |
Cada equipo anuncia solo lo que origina. t1 y t2 son peers entre sí y les pasan todo a sus clientes. En esta red, hay cuatro
fallas puestas a propósito, y es lo que ustedes van a resolver. Levantemos la red y corramos el tablero:
$ make up-ensayo
$ python3 tablero.py
      e1  e2  e3  e4
e1     -   X   X   X
e2     X   -   X   X
e3     X   X   -  ok
e4     X   X  ok   -
2 de 12 pares se alcanzan
sesiones BGP que no están arriba:
  e1: vecino 10.209.2.1, Idle
tablero.py hace ping desde el prefijo de cada equipo hacia el de cada uno de los demás. Un ok exige que el camino exista en los
dos sentidos. Por eso, si un equipo no anuncia bien su prefijo, le fallan también los pings que él inicia: las respuestas no saben
volver. Solo una sesión aparece caída, y sin embargo casi todo el tablero está en rojo. Una sesión arriba no quiere decir que las rutas
estén pasando.
Lean el archivo ensayo/equipos.txt: tablero.py no sabe nada de esta red, salvo lo que dice ese archivo, y sirve igual el día del
hackathon, con otro archivo. Para buscar las fallas, usen este orden, que también les sirve ese día:
| Pregunta | Comando |
|---|---|
| ¿Está arriba la sesión? ¿Por qué se cayó? | show bgp summary, show bgp neighbors <ip> y su línea Last reset |
| ¿Qué estoy anunciando, y a quién? | show bgp ipv4 unicast neighbors <ip> advertised-routes |
| ¿La ruta está en mi tabla, y es válida? | show bgp ipv4 unicast <prefijo> |
| ¿Qué dejo entrar? | show running-config, show ip prefix-list |
| ¿Por dónde va el tráfico? | traceroute -n -s <mi_ip> <destino> |
Pasos:
- Corran el tablero, y antes de abrir ningún router escriban una hipótesis por cada
X. ¿Qué filas y columnas fallan juntas? - Encuentren las tres fallas que se ven en el tablero: una está en
e1, otra ene2y otra ent2. Fíjense en que la det2perjudica a su cliente, sin que el cliente tenga nada mal. Escriban cada arreglo enlab/e1.conf,lab/e2.confylab/t2.conf, en sintaxis de vtysh, y cárguenlos conpython3 ensayo.py arreglos. - Encuentren la falla que no se ve, en
e3, con el tablero ya lleno. El aviso está en una tabla deshow bgp, no en un ping. Su arreglo va enlab/e3.conf. - Con todo arreglado, predigan qué pasa con cada corte y compruébenlo con
python3 ensayo.py corta <a> <b>, el tablero, ypython3 ensayo.py sube <a> <b>.python3 ensayo.py enlaceslos lista. Si necesitan volver al punto de partida, corran otra vezmake up-ensayo.
Con todo arreglado, el tablero se llena:
$ python3 tablero.py
      e1  e2  e3  e4
e1     -  ok  ok  ok
e2    ok   -  ok  ok
e3    ok  ok   -  ok
e4    ok  ok  ok   -
12 de 12 pares se alcanzan
todas las sesiones BGP están arriba
Error común. Cambiar un filtro de entrada y creer que ya se aplicó. En nuestras pruebas con FRR, después de corregir una
prefix-list, la ruta siguió sin aparecer en la tabla (esperamos más de 30 segundos), hasta correrclear bgp ipv4 unicast <vecino> soft in, que vuelve a procesar lo que ya se recibió.ensayo.py arregloslo hace por ustedes, pero el día del hackathon no.
Dos de los cortes dicen mucho sobre la estructura de Internet. Cortamos el enlace de e4 con su único proveedor:
$ python3 ensayo.py corta t2 e4
$ python3 tablero.py
      e1  e2  e3  e4
e1     -  ok  ok   X
e2    ok   -  ok   X
e3    ok  ok   -  ok
e4     X   X  ok   -
8 de 12 pares se alcanzan
sesiones BGP que no están arriba:
  e4: vecino 10.209.7.1, Active
e4 sigue teniendo un enlace con e3, que tiene dos proveedores. Pero e3 es su peer, y un peer no da tránsito: e4 solo alcanza a e3.
Tener conexión física no es tener ruta. Es lo que vimos en la semana 6, ahora en una red que falla.
Ahora cortamos el peering entre los dos proveedores:
$ python3 ensayo.py corta t1 t2
$ python3 tablero.py
      e1  e2  e3  e4
e1     -  ok  ok   X
e2    ok   -  ok  ok
e3    ok  ok   -  ok
e4     X  ok  ok   -
10 de 12 pares se alcanzan
todas las sesiones BGP están arriba
Todas las sesiones de los equipos están arriba y e1 y e4 no se pueden alcanzar. El tablero solo mira las sesiones de los cuatro equipos, y el
problema está en una sesión de la que ninguno de ellos es parte. e2 y e3 tienen caminos hacia los dos lados, pero, como corresponde, no dan tránsito
entre sus proveedores. Algo así pasa en Internet real cuando dos redes grandes dejan de hacer peering, y los clientes de cada una, sin tener nada mal,
dejan de verse.
En la práctica. En el hackathon de verdad, lo más difícil no será el comando. La dirección de cada enlace y los AS vecinos llegan en
as/vecinos.env, pero el error de un equipo se ve en la red del otro. Lleven escrito su plan: sus prefijos, su AS y quién es cada vecino. Cuando algo falle, hablen con el equipo vecino antes de cambiar su configuración, y cambien una cosa a la vez.
Archivos y make test
| Archivo | Qué es |
|---|---|
udp_demux.c, tcp_demux.c, demux_client.c |
Quién recibe cada dato: servidores y cliente de prueba |
udp_checksum.py |
El checksum de UDP, palabra por palabra |
rdt_sim.py |
Simulador: el protocolo construido paso a paso |
window_sim.py |
Simulador: Go-Back-N, Selective Repeat, utilización y ambigüedad |
seq_space.py |
Tamaño de ventana y números de secuencia, caso por caso |
tftp_mini.py |
TFTP mínimo, de solo lectura: un stop-and-wait real |
par/par.clab.yml, par/enlace.sh |
La red de la Sesión A y la configuración de su enlace |
ensayo/ensayo.clab.yml, ensayo/equipos.txt |
El ensayo del hackathon, con sus fallas |
tablero.py, ensayo.py |
El tablero; los arreglos y los cortes |
lab/*.conf |
Lo que ustedes completan |
test_sim.py, test_par.py, test_ensayo.py |
Las pruebas |
make test corre los simuladores, levanta las dos topologías, una tras otra, comprueba lo que dicen estos apuntes y destruye todo al terminar, incluso si
algo falla. Tarda unos minutos. Las pruebas de velocidad usan márgenes amplios, porque dependen de la máquina. Las pruebas B_TheFixes de test_ensayo.py se
saltan hasta que quiten la línea TODO de sus cuatro archivos en lab/.
Resumen
- IP entrega entre hosts, y el transporte entre procesos. El transporte corre en los extremos.
- Demultiplexar es entregar cada segmento al socket correcto. Un socket UDP sin
connectse identifica por IP y puerto de destino; una conexión TCP, por cuatro campos. Por eso, un servidor TCP tiene un socket por cliente en el mismo puerto. Un socket UDP conconnecttambién se vuelve más específico. - UDP agrega 8 bytes: puertos, largo y checksum. El checksum cubre un pseudo-encabezado, el encabezado y los datos. Un cero transmitido significa “sin checksum” en
IPv4; si la cuenta da cero, se manda
ffff. En IPv6 es obligatorio. Un datagrama dañado se descarta en silencio: el daño se convierte en pérdida. - Sirve para DNS, medios en vivo y como base de QUIC y de P3. No es “más rápido”: simplemente no espera ni frena.
- Un protocolo confiable se construye por partes: checksum para detectar, ACK para avisar, retransmisión para reparar, números de secuencia para reconocer los duplicados y temporizador para las pérdidas. El temporizador hace que se repita; el número de secuencia hace que repetir sea inofensivo.
- Stop-and-wait tiene U = d / (RTT + d). Con 1500 bytes, 1 Gbps y 30 ms: 0,04 %. Manda un paquete por RTT, y un enlace más rápido casi no ayuda. Lo medimos con TFTP.
- Dos generales: no existe un acuerdo con certeza en un tiempo finito sobre un canal con pérdidas. Lo que se logra es confiabilidad con un costo, si el canal entrega algo de vez en cuando.
- Pipelining: con ventana W, U = min(1, W × d / (RTT + d)). Para llenar el enlace se necesita un BDP, R × RTT. El throughput es como mucho W / RTT.
- Go-Back-N: ACK acumulativo, un temporizador; el receptor descarta el desorden y el emisor repite todo desde el perdido. Selective Repeat: ACK individual, un temporizador por paquete, buffer en el receptor, y se repite solo lo perdido. El receptor debe volver a confirmar lo ya entregado.
- La comparación: iguales sin pérdidas; con muchas pérdidas, Go-Back-N se derrumba; con pérdida solo en los ACK, el ACK acumulativo gana. El temporizador pesa mucho. TCP no es ninguno de los dos.
- Números de secuencia: con N valores, W ≤ N - 1 en Go-Back-N y W ≤ N / 2 en Selective Repeat. Con 4 números y ventana 3, Selective Repeat entrega datos viejos como nuevos sin que nada lo avise.
- El hackathon enseña coordinación. Una sesión arriba no significa que las rutas pasen, un tablero lleno no significa redundancia, y un peer no reemplaza a un proveedor.
Ejercicios
- Calculen a mano el checksum de un datagrama UDP de
10.0.0.1:53a10.0.0.2:40000con los datosok, y comprueben conudp_checksum.py. Luego repitan con los datosoka. ¿Cuántos bytes de relleno se suman? ¿Cuenta el relleno en el campo de largo? - Dos clientes usan el mismo puerto de origen, 5000, para hablarle a
srv, desde la misma máquina. ¿Se puede en TCP si el destino es el mismo? ¿Y si cambia el puerto de destino? Prueben condemux_client(usaSO_REUSEADDR) y expliquen lo que ven con los cuatro campos. - Un servidor UDP debe llevar el estado de cada cliente. Con lo que ofrece
recvfrom, ¿qué usaría como clave? Si el cliente está detrás de un NAT y este le cambia el puerto a mitad de camino, ¿qué le pasa a su servidor? ¿Cómo lo resuelve QUIC? (Busquen connection ID.) - En
rdt_sim.py, agreguen el escenario de un NAK dañado en v2.1. Antes de correrlo, predigan si el resultado es correcto y por qué. Agreguen también uno de v3 con dos pérdidas seguidas del mismo paquete. - ¿Qué pasaría en v3 si el receptor no confirmara los duplicados? Modifiquen el simulador para comprobarlo, con el escenario
v3-ack. - Un satélite geoestacionario tiene unos 500 ms de RTT. Con un enlace de 50 Mbps y paquetes de 1500 bytes, calculen U para stop-and-wait, el BDP y la ventana necesaria. Comprueben con
window_sim.py util. ¿Cuántos bits de número de secuencia necesitan, como mínimo, con Go-Back-N y con Selective Repeat? - Corran
python3 window_sim.py traza gbn --window 4 --packets 6 --drop-ack 1y lo mismo consr. ¿Cuántas retransmisiones hay en cada uno? Expliquen la diferencia. ¿Qué ACK tendrían que perderse para que Go-Back-N sí repitiera? - En Go-Back-N, el receptor descarta los paquetes fuera de orden. Propongan una variante en la que los guarde, pero siga con ACK acumulativos. ¿Qué mejora y qué no? ¿Cómo se entera el emisor de qué repetir? Esto se parece a TCP, y lo vemos la próxima semana.
- Con
window_sim.py barrido, prueben ventanas de 5, 50 y 200, con pérdida en los dos sentidos. ¿Con cuál se nota más la diferencia entre los dos protocolos? ¿Por qué? Prueben con temporizadores de 50, 200 y 1000 ms. ¿Qué pasa con un temporizador menor que el RTT? Interpreten con cuidado los envíos por paquete. - Con 3 bits de secuencia, ¿cuál es la ventana máxima de cada protocolo? Construyan a mano las dos historias del receptor para Selective Repeat con 8 números y ventana 5, como la tabla de
“historia A” e “historia B”. Comprueben modificando
ambiguity_run. - Midan su propio stop-and-wait: con
tftp_mini.pyyenlace.sh, grafiquen la tasa contra el RTT, de 10 a 100 ms. ¿Cuánto se separa de 512 × 8 / RTT, en milisegundos por bloque? ¿Con qué temporizador empieza a haber retransmisiones sin ninguna pérdida? Pruébenlo con--timeout-ms. - Sobre el ensayo: si
e4agrega un segundo proveedor,t1, ye2deja de tener at2, ¿qué pasa con cada corte de esta sección? Hagan la tabla sin correr nada. ¿Qué enlace, si se corta, le hace más daño a la red? ¿Cómo lo mediría un operador, sin cortarlo?