
Apuntes · Capítulo 10Transporte y aplicaciones
TCP: conexiones, retransmisión y control de flujo
TCP: conexiones, retransmisión y control de flujo
La semana pasada construimos la entrega confiable desde cero: números de secuencia, ACK, temporizadores y ventana deslizante. Todo eso se quedó en el pizarrón, con paquetes numerados de uno en uno. Esta semana lo vemos funcionando en el protocolo que transporta buena parte del tráfico de Internet. TCP usa esas mismas ideas, con tres diferencias que lo cambian casi todo: numera bytes y no paquetes, tiene que adivinar cuánto dura un RTT que además cambia, y le habla a un receptor que puede ser más lento que el emisor.
En la Sesión A leemos TCP en capturas: el segmento byte por byte, el handshake, el MSS,
los ACK acumulativos y retardados, y el cálculo del RTO. En la Sesión B lo hacemos
sufrir: descartamos un segmento preciso para ver el fast retransmit, cortamos el enlace
para ver el retroceso exponencial, y dejamos a un receptor sin leer para ver la ventana
cero. Cerramos con el handshake y el cierre vistos desde sus fallas: qué devuelve
connect en cada caso, para qué sirve TIME_WAIT y qué hace un SYN flood.
Vamos a encontrar una tensión que conviene decir desde ahora. Los libros y los RFC explican un TCP, y el kernel de Linux corre otro, compatible pero más afinado: su RTO no se calcula igual, su sonda de ventana cero no lleva datos, y a veces retransmite sin haber visto tres ACK duplicados. En cada caso les damos las dos versiones, la regla general y lo que se midió, para que sepan cuál es cuál.
Todo lo que se muestra salió de una topología de Containerlab que ustedes pueden levantar. Los puertos, los números de secuencia reales y los tiempos cambian en cada ejecución, y las cifras de velocidad dependen de la computadora. El comportamiento no.
Ruta de lectura.
Antes de clase (obligatorio, unos 15 a 20 minutos). Sesión A: La red de esta semana, Qué promete TCP, MSS y MTU, de El segmento TCP, byte por byte, la introducción y Secuencia y ACK cuentan bytes, y la introducción de Estimar el RTT y fijar el RTO. Sesión B: la introducción de Fast retransmit, la de Control de flujo, la de El handshake: abrir una conexión y A medio cerrar.
En clase. Sesión A: Los números relativos de Wireshark, La ventana y su escala, Una conexión completa, ACK acumulativos y ACK retardados, Ejemplo resuelto, Con muestras reales, Por qué no se mide un segmento retransmitido y El temporizador en acción. Sesión B: Por qué tres y no uno, SACK: decir exactamente qué llegó, Retransmisiones: lo que dice Wireshark y lo que pasó, Ventana cero, Quién limita: la ventana o el enlace, Por qué los números iniciales no empiezan en cero,
TIME_WAIT, RST: abortar y SYN flood y SYN cookies.Después de clase. Repasen con el Resumen y los Ejercicios, y preparen El laboratorio y
make test. Opcional: Qué hace Linux, Mirar una conexión viva conss, Qué devuelveconnecty El costo deTIME_WAIT. Para profundizar, las lecturas del libro y las gratuitas de la semana:Este capítulo acompaña a Kurose y Ross, Computer Networking: A Top-Down Approach (9.ª ed.). Para la Sesión A, las secciones 3.5.1 The TCP Connection, 3.5.2 TCP Segment Structure, 3.5.3 Round-Trip Time Estimation and Timeout y 3.5.4 Reliable Data Transfer, y los capítulos TCP Design y TCP Implementation de CS168. Complementarias: RFC 9293, TCP, y RFC 6298, cálculo del RTO. Para la Sesión B, las secciones 3.5.4 Reliable Data Transfer, 3.5.5 Flow Control y 3.5.6 TCP Connection Management, y otra vez TCP Implementation. El código de la semana está en
code/week-10/.
La red de esta semana
Dos hosts, a y b, unidos por un router m que es donde estropeamos el camino. Está
en code/week-10/tcp/tcp.clab.yml.
    a  10.210.1.10 ---- eth1  m  eth2 ---- 10.210.2.10  b
       10.210.1.20            |
                              +-- aquí se aplican tc netem y nft
El sentido de los datos es casi siempre de a hacia b. El enlace normal tiene 20 ms
de retardo en cada sentido, o sea 40 ms de RTT, y 20 Mbit/s de a hacia b con una cola de 200 paquetes. Los escenarios clean, drop y classic usan una cola de 2000, y explicamos por qué más adelante.
¿Por qué un router en el medio, si para el laboratorio bastarían dos hosts unidos por un
cable? Por dónde se pierde el paquete. Si tc netem se aplicara en el mismo host que
captura, tcpdump no vería el segmento perdido: en la salida, las capturas se toman
después de la cola de tc. Con el router en el medio, una captura en a muestra todo
lo que a envió, y una captura en b muestra lo que de verdad llegó. Comparar las dos
es la herramienta principal de esta semana.
Dentro del contenedor del curso, levanten la red y prueben un escenario:
cd code/week-10
make up
python3 scenarios.py clean
m# tc qdisc add dev eth2 root netem delay 20ms rate 20mbit limit 2000
m# tc qdisc add dev eth1 root netem delay 20ms
a# tcpdump -i eth1 -n -s 128 -B 16384 --immediate-mode -Z root -w /captures/clean-a.pcap tcp port 5001 &
b# tcpdump -i eth1 -n -s 128 -B 16384 --immediate-mode -Z root -w /captures/clean-b.pcap tcp port 5001 &
b# /w10/sink 5001 &
a# /w10/blast 10.210.2.10 5001 2000000
recibidos 2000000 bytes en 0.92 s (17.4 Mbit/s)Cada escenario imprime los comandos que corre (en las salidas que siguen, los omitimos casi siempre). Léanlos: son lo mismo que harían a mano,
y al final quedan en captures/ un archivo .pcap por cada lado. Los programas en C
son pocos y cortos:
| Programa | Qué hace |
|---|---|
blast.c |
Cliente: abre una conexión, envía N bytes y cierra |
sink.c |
Servidor: acepta, lee todo y cuenta; con opciones para no leer, para contestar y para cerrar primero |
connect_probe.c |
Intenta una conexión y dice qué devolvió connect y cuánto demoró |
half_open.c |
Deja conexiones a medio abrir, para la sección de SYN flood |
lab/slow_reader.c |
El receptor lento que ustedes van a completar |
También hay herramientas en Python: tcpsum.py resume una captura, timeseq.py dibuja
el gráfico tiempo-secuencia y rto_table.py hace la cuenta del RTO. La lista completa
de escenarios sale con python3 scenarios.py.
abort            El cliente cierra con RST en vez de FIN; el servidor se entera en su read.
bindfail         El servidor cierra primero y queda en TIME_WAIT: ¿puede volver a abrir ese puerto?
classic          El mismo descarte, con SACK y RACK apagados: TCP con los ACK duplicados de los libros.
clean            Transferencia de 2 MB sin pérdidas, con una cola que no se puede desbordar.
closed           Conectarse a un puerto cerrado: el RST del kernel de b, capturado.
delack           Datos chicos cada 100 ms a un receptor que no lee: ¿cuánto espera antes del ACK?
drop             El router descarta un solo segmento, el número 40. TCP moderno: con SACK y RACK.
halfclose        El cliente cierra su sentido y después todavía recibe la respuesta del servidor.
limit            La misma transferencia con buffers de recepción distintos: ¿quién limita?
loss             2 % de pérdida aleatoria en el sentido de los datos.
mss              Baja el MTU de a a 1400: el MSS que a anuncia cambia, y también el tamaño de los datos.
ports            Qué devuelve connect: puerto cerrado, filtrado en silencio, rechazado, y sin ruta.
reorder          Sin pérdida, sin tope de velocidad y con 3 ms de jitter: los segmentos se desordenan.
reorder_classic  El mismo enlace desordenado, con el TCP de los ACK duplicados.
rto              Un flujo lento y un corte total de 3 s: nadie manda ACK, y queda solo el temporizador.
rtomin           Fija rto_min en la ruta de a: se ve qué parte del RTO de Linux es ese piso.
slow             Su slow_reader del laboratorio: 2 KB cada 100 ms, o sea unos 160 kbit/s.
ss               Una conexión activa vista con ss cada segundo: rtt, rto, cwnd.
syn              Una cola de SYN llena, sin y con SYN cookies.
tail             Se pierden el último segmento y el FIN: no llega ningún ACK que avise. ¿Quién lo arregla?
timewait         Se pierde el último ACK del cierre: ese es el trabajo de quien espera en TIME_WAIT.
zero             El receptor acepta y se queda 3 s sin leer: su buffer se llena y anuncia ventana cero.
Qué promete TCP
Definición. TCP ofrece a dos procesos un stream de bytes confiable, ordenado, con conexión y full duplex. Cada palabra de esa frase dice algo preciso:
- Stream de bytes. Para la aplicación no hay mensajes. Es lo que vimos en la semana
2: un
writede 3000 bytes no corresponde a unreadde 3000 bytes. TCP decide cómo cortar el stream en segmentos. - Confiable y ordenado. Lo que
readentrega son los mismos bytes en el mismo orden, o un error. Nunca entrega un hueco. - Con conexión. Antes de enviar datos, los dos extremos crean un estado: números de secuencia, buffers, temporizadores. Ese estado vive solo en los hosts. Los routers no saben que existe la conexión.
- Full duplex. Son dos streams independientes, uno en cada sentido, y cada uno tiene sus propios números de secuencia. Cada segmento puede llevar datos de un sentido y el ACK del otro.
Ya vimos en la semana 9 que un socket TCP se identifica con cuatro campos (dirección y puerto de cada lado). Por eso un servidor en un solo puerto atiende a miles de clientes.
Respecto a los protocolos de la semana pasada, TCP es un híbrido. Se parece a Go-Back-N en que su ACK es acumulativo y lleva un solo temporizador. Se parece a Selective Repeat en que el receptor guarda lo que llega fuera de orden y el emisor retransmite poco, no toda la ventana.
Idea clave. TCP numera bytes, no paquetes, porque la aplicación le da un stream. Casi todo lo demás de esta semana es consecuencia de eso, o de que la red no le dice nada: TCP deduce lo que pasa solo por los ACK que vuelven y por el tiempo que tardan.
MSS y MTU
El MTU es el tamaño máximo de un paquete IP en un enlace. El MSS (maximum segment size) es la cantidad máxima de datos que TCP pone en un segmento, sin contar encabezados. El nombre confunde: el MSS no mide el segmento, sino lo que lleva adentro.
MSS = MTU - encabezado IP - encabezado TCP = 1500 - 20 - 20 = 1460Cada extremo anuncia su MSS en el SYN con una opción. No es una negociación: cada uno dice cuánto está dispuesto a recibir, y los dos valores pueden ser distintos. Miremos el resumen de la transferencia limpia:
$ python3 tcpsum.py captures/clean-a.pcap
conexión       10.210.1.10:33776 -> 10.210.2.10:5001
SYN            seq real 1661972085; MSS 1460, ventana 64240, escala 7, SACK sí, timestamps sí
SYN-ACK        seq real 3960613348; MSS 1460, ventana 65160, escala 7, SACK sí, timestamps sí
datos          1382 segmentos, 2000000 bytes enviados, 2000000 bytes distintos, el mayor de 1448
ACK de vuelta  896 sin datos, ventana máxima anunciada 1035136
ACK duplicados 0 (el mayor, #0); rachas que llegaron a #1: 0, a #2: 0, a #3: 0
retransmitidos 0 segmentos, 0 de ellos marcados como fast
ventana cero   0 avisos, 0 sondas
cierre         2 FIN, 0 RST
duración       1.003 s
Anunciaron 1460, pero el segmento más grande lleva 1448 bytes. ¿Y los otros 12? Son la opción de timestamps, que va en todos los segmentos: 10 bytes de la opción y 2 de relleno. La cuenta completa de un frame lleno es:
14 (Ethernet) + 20 (IP) + 20 (TCP) + 12 (timestamps) + 1448 (datos) = 1514 bytesSi el MTU cambia, cambia todo. El escenario mss baja a 1400 el MTU de la interfaz de
a:
$ python3 tcpsum.py captures/mss-a.pcap
conexión       10.210.1.10:35582 -> 10.210.2.10:5001
SYN            seq real 4265168592; MSS 1360, ventana 65280, escala 7, SACK sí, timestamps sí
SYN-ACK        seq real 2465781842; MSS 1460, ventana 65160, escala 7, SACK sí, timestamps sí
datos          75 segmentos, 100000 bytes enviados, 100000 bytes distintos, el mayor de 1348
a anuncia 1360 y b sigue anunciando 1460: cada uno habla de su propia interfaz. Pero
a envía datos de 1348 bytes como máximo (1360 − 12), porque tampoco puede enviar más
de lo que su propio enlace deja pasar. Lo que ocurre si el MTU chico está más adelante
en el camino lo vimos en la semana 4: el bit DF y el descubrimiento del MTU del camino.
Error común. Decir que “el MSS es 1500” o que “el segmento mide 1460”. 1500 es el MTU, que incluye IP y TCP. 1460 es lo que se anuncia. Y en una captura de Linux, lo que se ve en
Len=suele ser 1448.
El segmento TCP, byte por byte
El encabezado tiene 20 bytes fijos, más las opciones:
 0                   1                   2                   3
 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1
+-------------------------------+-------------------------------+
|         puerto origen         |        puerto destino         |
+-------------------------------+-------------------------------+
|                      número de secuencia                      |
+---------------------------------------------------------------+
|                        número de ACK                          |
+-------+-------+---------------+-------------------------------+
| largo | resv. |    banderas   |            ventana            |
+-------+-------+---------------+-------------------------------+
|           checksum            |        urgent pointer         |
+-------------------------------+-------------------------------+
|                     opciones (0 a 40 bytes)                   |
+---------------------------------------------------------------+
Vamos a leer un SYN real sin ayuda de Wireshark. Es el primer paquete de la captura
limpia. Los bytes salieron de tshark -r captures/clean-a.pcap -c 1 -x:
0000  aa c1 ab 4f 0b 7e aa c1 ab 45 b5 1d 08 00 45 00   ...O.~...E....E.
0010  00 3c 55 59 40 00 40 06 cc ab 0a d2 01 0a 0a d2   .<UY@.@.........
0020  02 0a 83 f0 13 89 63 0f ae 75 00 00 00 00 a0 02   ......c..u......
0030  fa f0 b1 64 00 00 02 04 05 b4 04 02 08 0a 82 de   ...d............
0040  57 16 00 00 00 00 01 03 03 07                     W.........
Ethernet ocupa 14 bytes y el encabezado IP, 20. El encabezado TCP empieza en el byte
0x22:
| Bytes | Campo | Valor |
|---|---|---|
83 f0 |
Puerto origen | 33776 |
13 89 |
Puerto destino | 5001 |
63 0f ae 75 |
Número de secuencia | 1661972085 |
00 00 00 00 |
Número de ACK | 0: todavía no confirma nada |
a0 |
Largo del encabezado (4 bits altos) | 10 palabras de 4 bytes: 40 bytes |
02 |
Banderas | Solo SYN |
fa f0 |
Ventana | 64240 |
b1 64 |
Checksum | Lo revisa el receptor |
00 00 |
Urgent pointer | Sin uso |
02 04 05 b4 |
Opción MSS | 1460 |
04 02 |
Opción SACK permitido | |
08 0a 82 de 57 16 00 00 00 00 |
Opción timestamps | Valor propio y eco en cero |
01 |
NOP | Relleno, para alinear |
03 03 07 |
Opción escala de ventana | Desplazamiento de 7 bits |
Las banderas que nos importan son SYN (abro una conexión y este es mi número inicial), ACK (el campo de ACK es válido), FIN (no voy a enviar más), RST (aborto) y PSH (entreguen esto a la aplicación sin esperar). Salvo el primer SYN, todos los segmentos de una conexión llevan ACK encendido.
Secuencia y ACK cuentan bytes
Definición. El número de secuencia de un segmento es el número del primer byte que lleva. El número de ACK es el número del siguiente byte que se espera recibir: “tengo todo hasta antes de este”.
Un ejemplo. Un segmento con seq=1000 y 500 bytes lleva los bytes 1000 a 1499. Si llegó
ese y todo lo anterior, el ACK es 1500. Si se perdió algo anterior, el ACK se queda
donde empieza el hueco, por más que este segmento haya llegado.
Hay un detalle que confunde al inicio: SYN y FIN gastan un número de secuencia, aunque no lleven datos. Si no fuera así, no habría forma de confirmarlos. Por eso, después de un SYN con número X, el primer byte de datos es X + 1. Veámoslo en la captura, con los números tal como aparecen en el paquete. Recortamos las columnas de la derecha:
$ tshark -r captures/clean-a.pcap -c 5 -o tcp.relative_sequence_numbers:FALSE
    1   0.000000  10.210.1.10 → 10.210.2.10  TCP 74 33776 → 5001 [SYN] Seq=1661972085 Win=64240 Len=0 MSS=1460
    2   0.041148  10.210.2.10 → 10.210.1.10  TCP 74 5001 → 33776 [SYN, ACK] Seq=3960613348 Ack=1661972086 Win=
    3   0.041166  10.210.1.10 → 10.210.2.10  TCP 66 33776 → 5001 [ACK] Seq=1661972086 Ack=3960613349 Win=64256
    4   0.041191  10.210.1.10 → 10.210.2.10  TCP 1514 33776 → 5001 [ACK] Seq=1661972086 Ack=3960613349 Win=642
    5   0.041195  10.210.1.10 → 10.210.2.10  TCP 1514 33776 → 5001 [PSH, ACK] Seq=1661973534 Ack=3960613349 Wi
Sigan los números. El SYN de a usa 1661972085, y b responde Ack=1661972086. El paquete 3 no lleva datos, así que no gasta nada: el paquete 4 sale con el mismo número. El paquete 5 tiene Seq=1661973534, que es 1661972086 + 1448. Cuenta bytes.
Los números relativos de Wireshark
La misma captura, sin esa opción de tshark:
$ tshark -r captures/clean-a.pcap -c 6
    1   0.000000  10.210.1.10 → 10.210.2.10  TCP 74 33776 → 5001 [SYN] Seq=0 Win=64240 Len=0 MSS=1460 SACK_PERM TSval=2195609366 TSecr=0 WS=
    2   0.041148  10.210.2.10 → 10.210.1.10  TCP 74 5001 → 33776 [SYN, ACK] Seq=0 Ack=1 Win=65160 Len=0 MSS=1460 SACK_PERM TSval=2105469646
    3   0.041166  10.210.1.10 → 10.210.2.10  TCP 66 33776 → 5001 [ACK] Seq=1 Ack=1 Win=64256 Len=0 TSval=2195609407 TSecr=2105469646
    4   0.041191  10.210.1.10 → 10.210.2.10  TCP 1514 33776 → 5001 [ACK] Seq=1 Ack=1 Win=64256 Len=1448 TSval=2195609407 TSecr=2105469646
    5   0.041195  10.210.1.10 → 10.210.2.10  TCP 1514 33776 → 5001 [PSH, ACK] Seq=1449 Ack=1 Win=64256 Len=1448 TSval=2195609407 TSecr=21054
    6   0.041200  10.210.1.10 → 10.210.2.10  TCP 1514 33776 → 5001 [ACK] Seq=2897 Ack=1 Win=64256 Len=1448 TSval=2195609407 TSecr=2105469646
Error común. Leer
Seq=0como si fuera el número real. Wireshark ytsharkmuestran por defecto números relativos al inicio de la conexión, restando el inicial de cada sentido. Es cómodo para leer, pero en el paquete viaja 1661972085. Para ver el real: en Wireshark, Edit → Preferences → Protocols → TCP y desmarquen Relative sequence numbers.tcpdumphace una mezcla que despista más: en el handshake muestra los reales, y después pasa a relativos.
Lo de tcpdump se ve en esta misma captura, con el ACK del tercer paquete:
$ tcpdump -nr captures/clean-a.pcap -c 3
14:52:18.479242 IP 10.210.1.10.33776 > 10.210.2.10.5001: Flags [S], seq 1661972085, win 64240, options [mss 1460,sackOK,TS val 2195609366 ec
14:52:18.520390 IP 10.210.2.10.5001 > 10.210.1.10.33776: Flags [S.], seq 3960613348, ack 1661972086, win 65160, options [mss 1460,sackOK,TS
14:52:18.520408 IP 10.210.1.10.33776 > 10.210.2.10.5001: Flags [.], ack 1, win 502, options [nop,nop,TS val 2195609407 ecr 2105469646], leng
La ventana y su escala
El campo de ventana tiene 16 bits, así que sin ayuda llega hasta 65535 bytes. En un enlace de 1 Gbit/s con 40 ms de RTT se necesitan 5 MB en vuelo: el campo no alcanza. La opción de escala de ventana dice: “multipliquen por 2^N lo que yo anuncie en esta conexión”.
Fíjense en dos detalles del tcpdump de arriba. El tercer paquete dice win 502,
mientras que Wireshark dice Win=64256. Son lo mismo: 502 × 128 = 64256, con la escala
7 que a anunció en su SYN. tcpdump muestra el campo crudo, y Wireshark hace la
multiplicación por ustedes si vio el handshake. El otro detalle: la ventana del SYN no
se escala nunca, porque la escala recién se está acordando.
Error común. Abrir en Wireshark una captura que empezó a la mitad de la conexión y creer que la ventana es diminuta. Sin el handshake, Wireshark no conoce la escala y muestra el campo crudo.
Una conexión completa
Volvamos a la captura limpia. Son 2282 segmentos, y la forma general es esta:
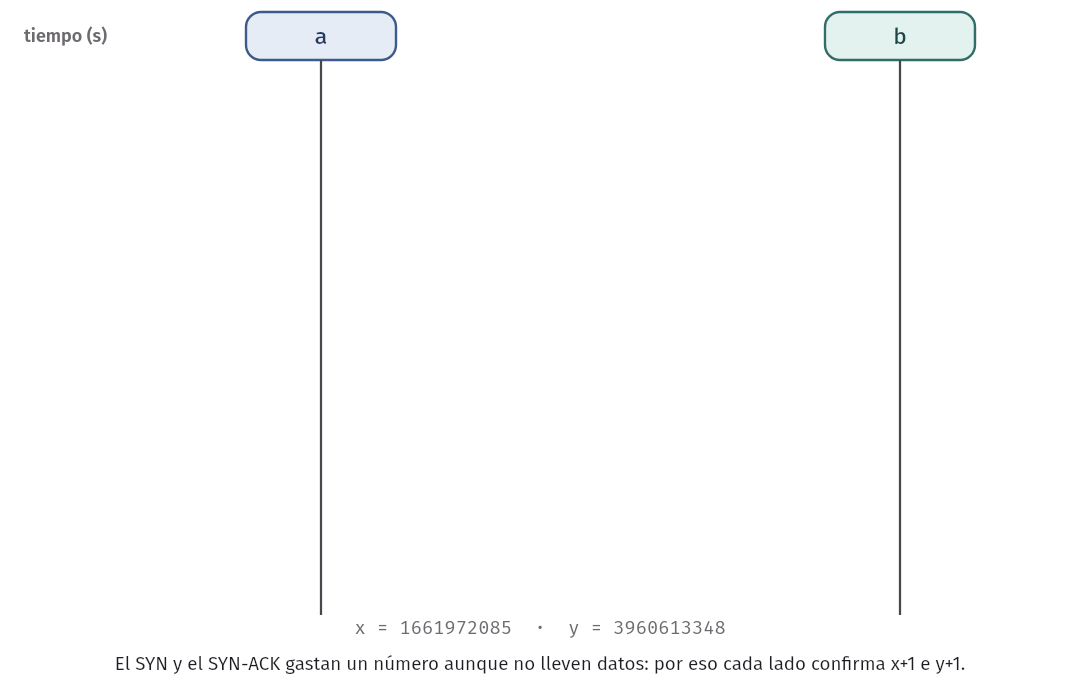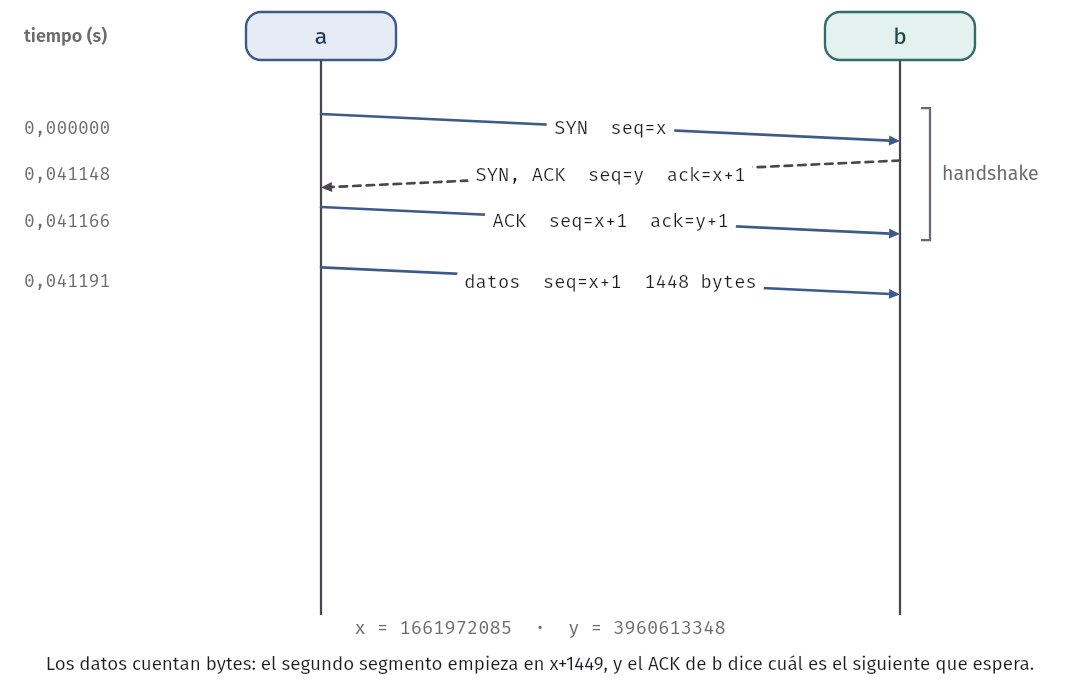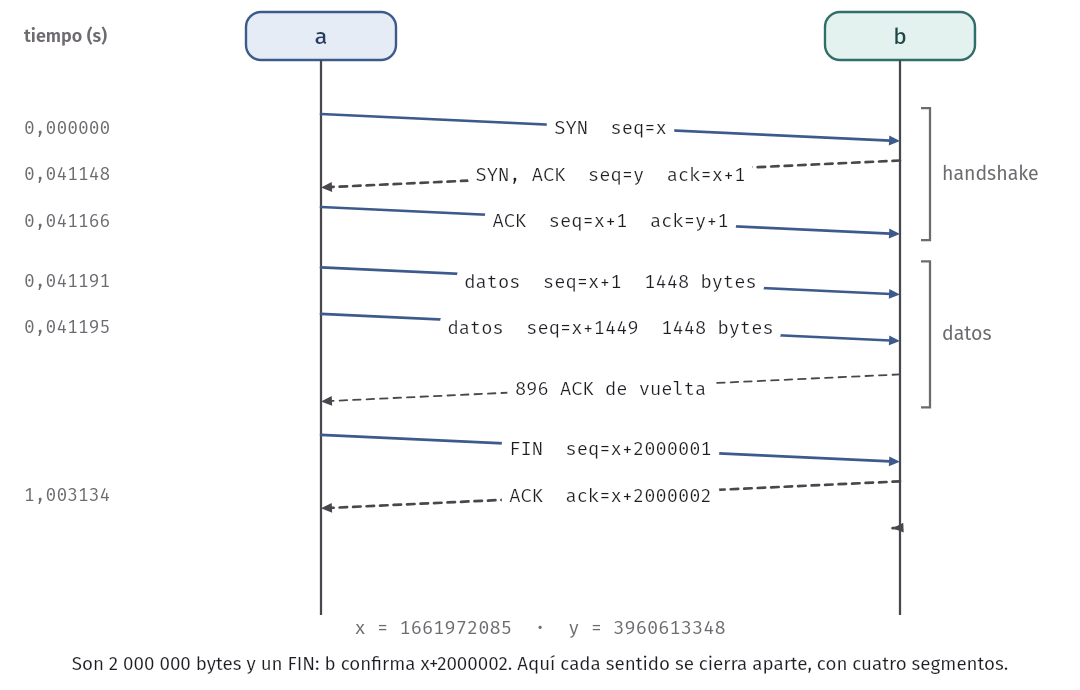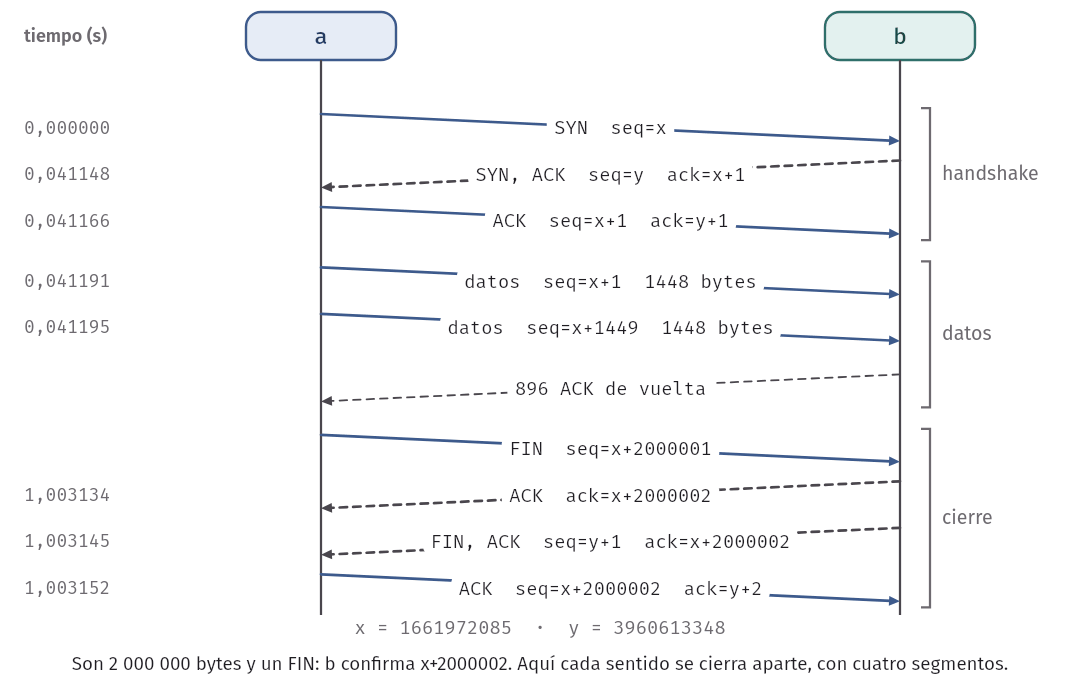
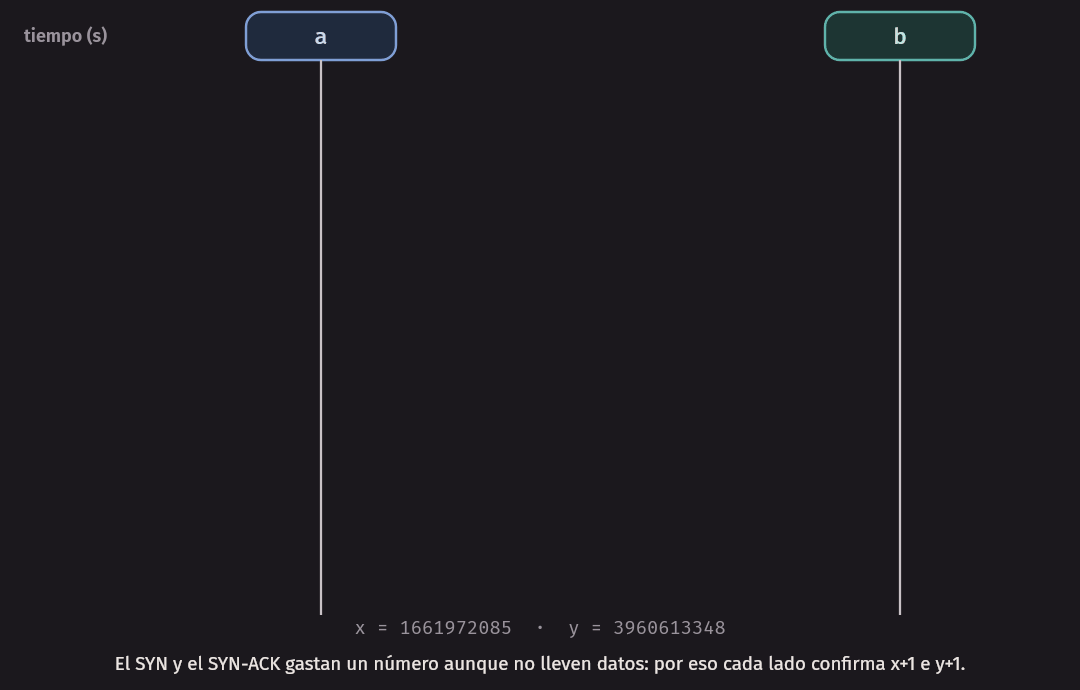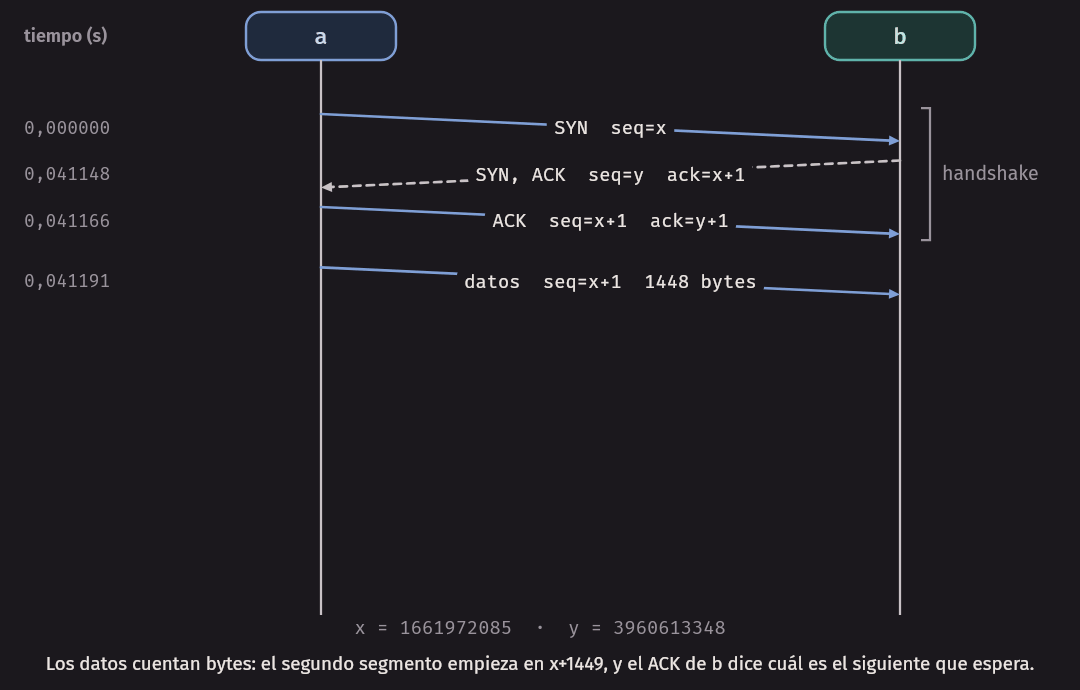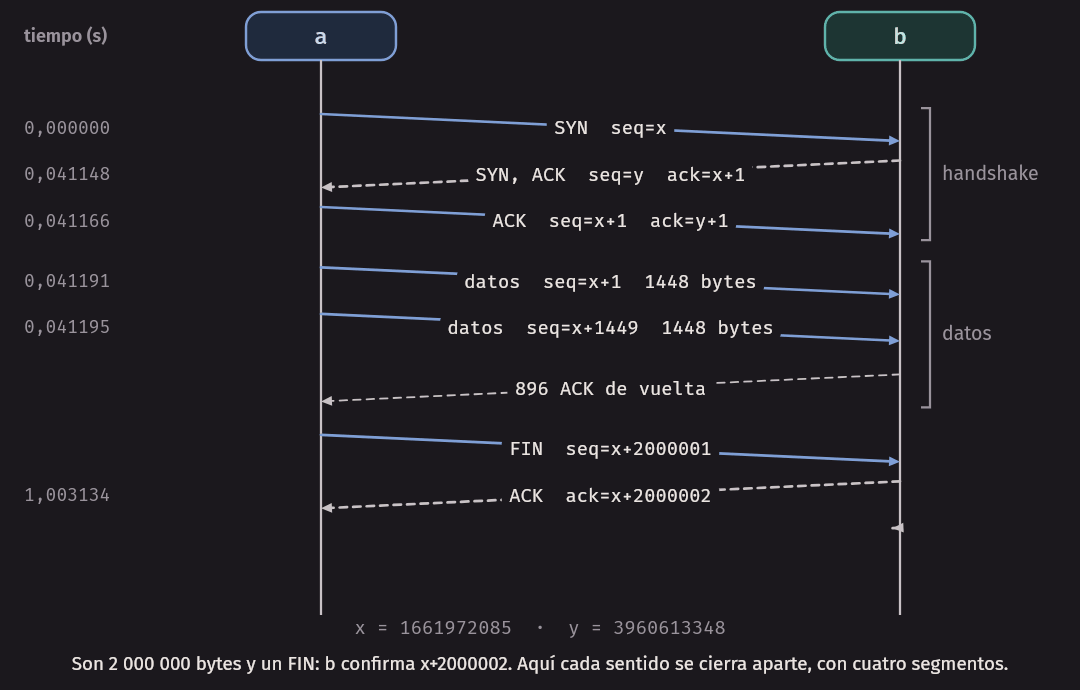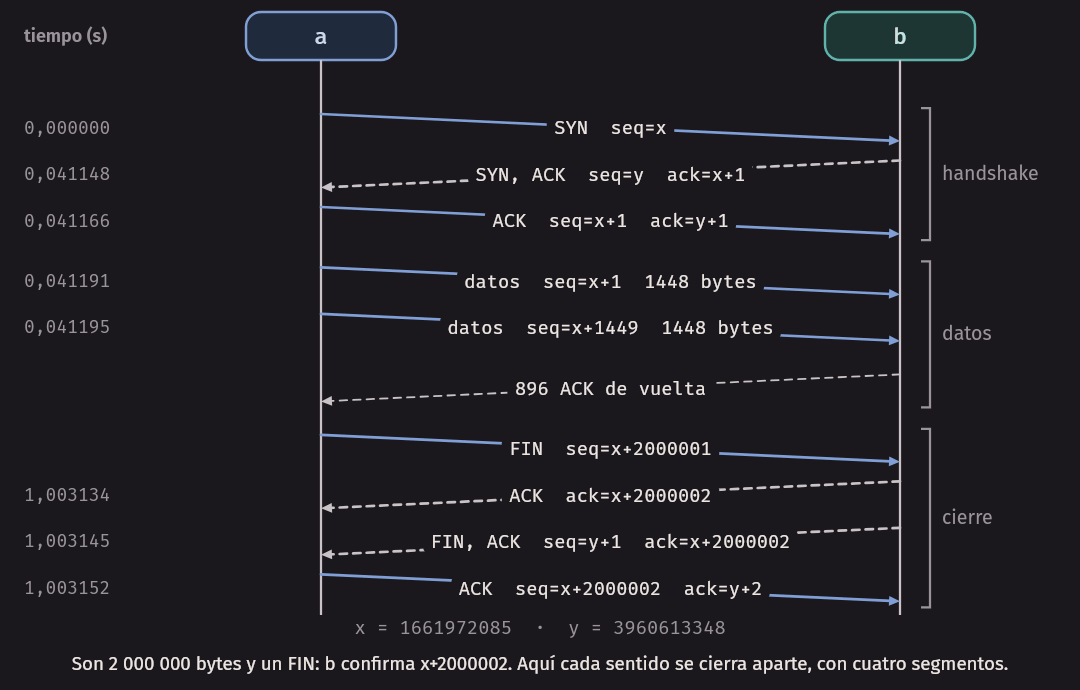
Y estos son sus últimos paquetes:
 2280   1.003134  10.210.2.10 → 10.210.1.10  TCP 66 5001 → 33776 [ACK] Seq=1 Ack=2000002 Win=1035136 Len=0 TSval=2105470608 TSecr=2195610236
 2281   1.003145  10.210.2.10 → 10.210.1.10  TCP 66 5001 → 33776 [FIN, ACK] Seq=1 Ack=2000002 Win=1035136 Len=0 TSval=2105470608 TSecr=21956
 2282   1.003152  10.210.1.10 → 10.210.2.10  TCP 66 33776 → 5001 [ACK] Seq=2000002 Ack=2 Win=64256 Len=0 TSval=2195610369 TSecr=2105470608
Cuenten: el Ack=2000002 son 2 000 000 bytes, más 1 porque el stream empieza en 1, más 1
del FIN de a. Y el cierre tiene que leerse con cuidado: aquí b confirmó el FIN en el paquete
2280 y envió el suyo en el 2281, un cierre de cuatro segmentos, como en la figura. Pero si el programa de b cierra
justo a tiempo, el kernel junta el ACK y el FIN en uno solo, y son tres. Las
dos formas aparecen en nuestras corridas, y la captura de la sección de TIME_WAIT tiene la de
tres. Las dos son correctas.
En la práctica. ¿Por qué estos escenarios usan una cola de 2000 y no de 200? Porque con 200 nos falló la palabra “limpia”. En dos de cinco corridas, una transferencia de 2 MB desbordó la cola al arrancar, y salieron más de cien retransmisiones (103 y 102) sin ningún
netem loss. Una cola más grande que todos los segmentos juntos no se puede desbordar. Esa pérdida no es un defecto del laboratorio: es congestión, y es el tema de la próxima semana.
El gráfico tiempo-secuencia
Una captura de 2000 líneas no se lee línea por línea. La herramienta para eso es el gráfico tiempo-secuencia: en el eje X va el tiempo, en el eje Y el número de secuencia, y cada segmento es un punto. En Wireshark está en Statistics → TCP Stream Graphs → Time Sequence. Nosotros también lo generamos en el contenedor:
$ python3 timeseq.py captures/clean-a.pcap captures/clean-a.png
gráfico en captures/clean-a.png
Ábranlo. Sin pérdidas, se ven tres cosas:
- Al comienzo, ráfagas separadas por un RTT. Hasta unos 0,25 s, los puntos forman escalones. Cada ráfaga es más grande que la anterior: es slow start, que estudiaremos la próxima semana. Los primeros escalones están a 40 ms entre sí, un RTT.
- Después, una recta. Su pendiente es la velocidad del enlace: 2 MB en cerca de 0,8 s son unos 20 Mbit/s. La pendiente del gráfico es el throughput.
- La línea de los ACK corre paralela, a la derecha. La distancia horizontal entre
un punto y su ACK es el RTT. Empieza en 40 ms y crece hasta más de 100 ms, porque
aenvía más rápido de lo que el enlace deja pasar, y se forma una cola enm. Es el mismo retardo de cola de la semana 1, visto desde TCP.
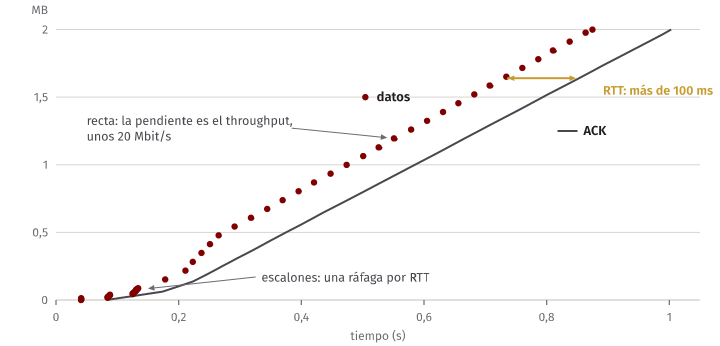
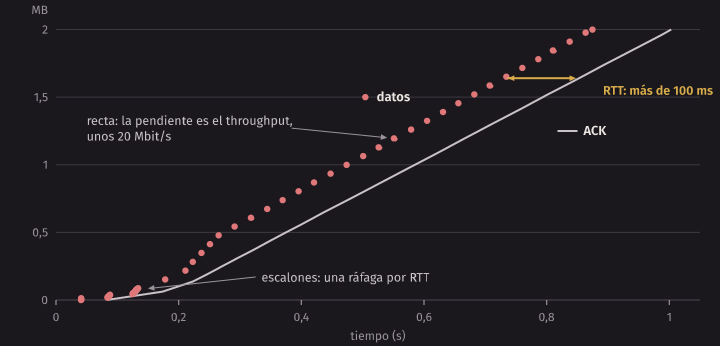
En la práctica. Cuando alguien dice que “la red está lenta”, el gráfico tiempo-secuencia separa los casos rápido. Si la curva es una recta sin escalones, TCP está usando lo que hay. Si tiene mesetas, algo lo detiene, y la pregunta es qué: una pérdida, o un receptor que no lee. Las dos cosas se ven en este capítulo.
ACK acumulativos y ACK retardados
TCP usa ACK acumulativo: el número dice hasta dónde está todo completo, y un ACK posterior vuelve innecesarios a los anteriores. Si se pierde un ACK no pasa nada, siempre que llegue otro con un número mayor.
El receptor además no tiene por qué confirmar cada segmento. El RFC
9293 le pide que, si implementa ACK
retardado (delayed ACK), genere un ACK al menos cada dos segmentos completos, y que
nunca espere más de 0,5 s. En la captura limpia hay 1382 segmentos de datos y 896 ACK de vuelta, y en la parte estable se ve el patrón de uno cada dos. Aquí, desde b, con las
columnas tiempo, origen, secuencia, ACK y largo:
0.417020000	10.210.1.10	693593	1	1448
0.417027000	10.210.1.10	695041	1	1448
0.417041000	10.210.2.10	1	696489	0
0.418035000	10.210.1.10	696489	1	1448
0.418042000	10.210.1.10	697937	1	1448
0.418045000	10.210.2.10	1	699385	0
0.419021000	10.210.1.10	699385	1	1448
0.420033000	10.210.1.10	700833	1	1448
0.420042000	10.210.2.10	1	702281	0
Los dos últimos segmentos de datos se confirman juntos: 702281 = 699385 + 2 × 1448. El
total no da exactamente uno cada dos porque al comienzo Linux confirma todo de
inmediato, para no frenar el arranque de la conexión.
Si llega un solo segmento y nada más, el ACK retardado se nota de verdad. El
escenario delack envía 100 bytes cada 100 ms a un receptor que no está leyendo:
1.438350000	10.210.1.10	1301	1	100
1.438362000	10.210.2.10	1	1401	0
1.538742000	10.210.1.10	1401	1	100
1.538761000	10.210.2.10	1	1501	0
1.638989000	10.210.1.10	1501	1	100
1.638997000	10.210.2.10	1	1601	0
1.745987000	10.210.1.10	1601	1	100
1.787576000	10.210.2.10	1	1701	0
1.846984000	10.210.1.10	1701	1	100
1.894997000	10.210.2.10	1	1801	0
1.955985000	10.210.1.10	1801	1	100
2.004004000	10.210.2.10	1	1901	0
Hasta el segmento de Seq=1501, el ACK sale en microsegundos. Desde el de Seq=1601,
sale unos 40 a 50 ms después. Esa espera es el ACK retardado. Dos precisiones que salen
de lo que medimos:
- Los 500 ms son un tope, no lo que se usa. Aquí se ven unos 40 ms.
- Depende de lo que haga la aplicación. Si
sinkestá leyendo, Linux responde en microsegundos a cada segmento chico: cuando probamos ese caso, ningún ACK se retrasó. Por eso el escenario usa un receptor que no lee.
¿Para qué esperar? Porque si la aplicación va a responder pronto, el ACK puede viajar en el mismo segmento que la respuesta (se llama piggybacking), y además se ahorra un paquete de cada dos en una transferencia larga. El costo es que un RTT medido incluye esa espera.
Error común. Creer que un ACK confirma un segmento. Confirma todos los bytes anteriores a ese número. Por eso no hay que contar “un ACK por paquete” al leer una captura, ni asustarse si faltan.
Estimar el RTT y fijar el RTO
Si un segmento se pierde, el emisor se entera porque no llega su ACK. ¿Cuánto debe esperar? Si espera muy poco, retransmite cosas que no se perdieron. Si espera mucho, una pérdida detiene la conexión sin motivo. La semana pasada eso era una constante. En Internet no se puede: el RTT cambia de una conexión a otra, y dentro de una misma conexión. En nuestra captura limpia, sin cambiar nada del enlace, pasa de 41 ms a más de 130 ms.
Definición. TCP mantiene dos promedios móviles exponenciales. Con cada nueva medición, SampleRTT:
DevRTT       = (1 - β) × DevRTT + β × |SampleRTT - EstimatedRTT|
EstimatedRTT = (1 - α) × EstimatedRTT + α × SampleRTT
RTO          = EstimatedRTT + 4 × DevRTT
con α = 1/8 y β = 1/4. El RFC 6298 los llama SRTT y RTTVAR, y agrega tres reglas:
- Antes de la primera medición, el RTO es de 1 s.
- La primera medición R inicializa todo: EstimatedRTT = R y DevRTT = R / 2.
- Si el RTO calculado es menor que 1 s, debería subirse a 1 s.
La intuición: EstimatedRTT sigue el valor típico, y es lento a propósito, para que una medición rara no lo mueva mucho. DevRTT mide cuánto se aparta el RTT de ese valor. El margen de seguridad es grande cuando la red es irregular y chico cuando es estable.
Ejemplo resuelto
Con EstimatedRTT = 100 ms y DevRTT = 5 ms, llega un SampleRTT de 120 ms:
DevRTT       = 0,75 × 5 + 0,25 × |100 - 120| = 3,75 + 5 = 8,75 ms
EstimatedRTT = 0,875 × 100 + 0,125 × 120     = 87,5 + 15 = 102,5 ms
RTO          = 102,5 + 4 × 8,75              = 137,5 ms
rto_table.py hace esta misma cuenta:
$ python3 rto_table.py --start 100 5 120
  muestra  EstimatedRTT   DevRTT      RTO
   120.00        102.50     8.75   137.50
Una muestra 20 % más lenta movió el promedio solo 2,5 ms, pero el RTO pasó de 120 ms a 137,5 ms. El margen reacciona más rápido que el promedio. Ahora, con una lista de muestras en que una es rara:
$ python3 rto_table.py 100 90 120 95 400 100
  muestra  EstimatedRTT   DevRTT      RTO
   100.00        100.00    50.00   300.00
    90.00         98.75    40.00   258.75
   120.00        101.41    35.31   242.66
    95.00        100.61    28.09   212.95
   400.00        138.03    95.91   521.68
   100.00        133.28    81.44   459.05
Error común. Usar el EstimatedRTT nuevo para calcular DevRTT. Da 8,125 y un RTO de 135 ms, y es fácil caer ahí porque muchos textos presentan primero la fórmula de EstimatedRTT. El RFC 6298 es explícito: DevRTT se calcula primero, con el valor anterior. En este curso usamos el orden del RFC.
Con muestras reales
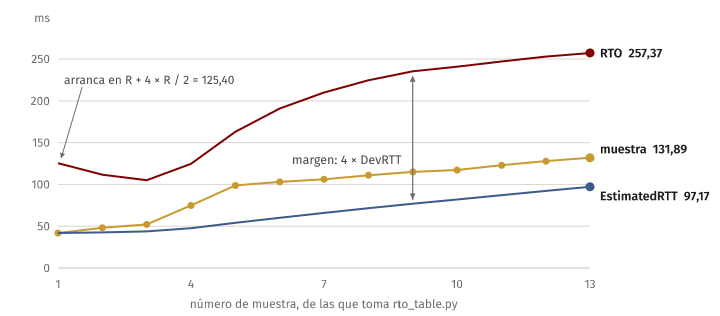
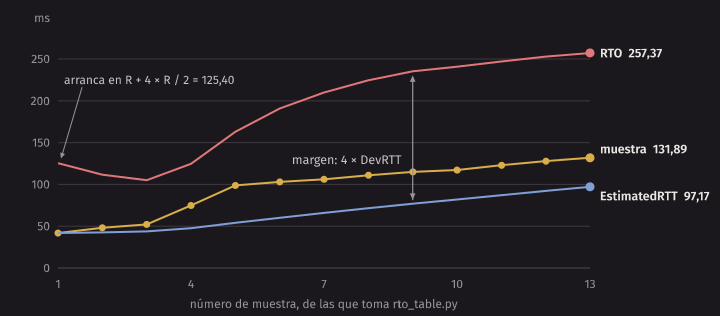
La misma cuenta, sobre mediciones tomadas de la captura limpia (Wireshark empareja cada dato con su ACK; la herramienta toma una de cada tantas):
$ python3 rto_table.py --pcap captures/clean-a.pcap
  muestra  EstimatedRTT   DevRTT      RTO
    41.80         41.80    20.90   125.40
    48.13         42.59    17.26   111.62
    52.13         43.78    15.33   105.09
    74.83         47.66    19.26   124.69
    98.77         54.05    27.22   162.93
   103.03         60.18    32.66   190.81
   106.18         65.93    36.00   209.91
   111.03         71.56    38.27   224.65
   115.01         76.99    39.57   235.26
   117.19         82.02    39.72   240.91
   122.86         87.12    40.00   247.14
   127.80         92.21    40.17   252.90
   131.89         97.17    40.05   257.37
Las muestras suben porque la cola en m se está llenando. Fíjense en que EstimatedRTT
va siempre detrás de las muestras, mientras que el RTO queda holgadamente por encima de
todas. Esa es la idea. (La herramienta solo hace la cuenta; un emisor real toma muchas
más muestras, así que sus valores no serán estos).
Por qué no se mide un segmento retransmitido
Supongan que un segmento se envía, vence el temporizador, se retransmite y llega un ACK. ¿De cuál de los dos envíos es ese ACK?
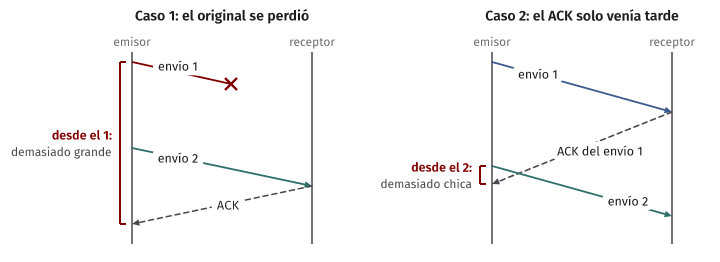
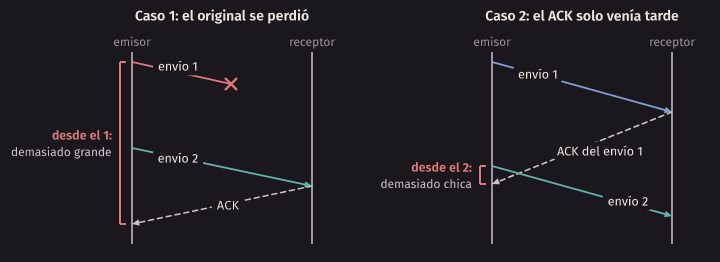
Si el emisor mide desde el envío 1 y fue el caso 1, la muestra sale demasiado grande. Si mide desde el envío 2 y fue el caso 2, sale demasiado chica. Peor aún: una muestra chica baja el RTO, lo que causa más retransmisiones innecesarias, y así más muestras malas. La regla, llamada algoritmo de Karn, es no tomar muestras de segmentos retransmitidos.
El RFC 6298 admite una excepción: con la opción de timestamps no hay ambigüedad, porque
el ACK devuelve en TSecr el valor del envío que lo provocó, y el RFC
7323 dice lo mismo. Sin timestamps, la regla de
Karn es obligatoria.
Qué hace Linux
Hagan la cuenta del RFC con lo que muestra ss -tin en una conexión de nuestra red, que
indica el RTT como rtt:promedio/desviación:
cubic wscale:7,7 rto:249 rtt:48.23/11.866 mss:1448 pmtu:1500 ... cwnd:10 ...Según la fórmula, el RTO sería 48,23 + 4 × 11,866 = 95,7 ms, y según la regla del piso, 1 s. Lo que aparece es 249 ms. No coincide ni con una cosa ni con la otra. Mirando varias conexiones se ve un patrón:
rto |
rtt |
rto − rtt |
|---|---|---|
| 249 | 48,23 | 200,8 |
| 244 | 43,46 | 200,5 |
| 324 | 123,18 | 200,8 |
| 306 | 105,57 | 200,4 |
Siempre unos 200 ms sobre el RTT. Linux toma como margen el mayor entre 4 × DevRTT y un
piso de 200 ms, en vez de subir todo el RTO a 1 s. Lo podemos comprobar: ese piso se
puede cambiar por ruta, con rto_min. Es lo que hace el escenario rtomin:
$ python3 scenarios.py rtomin
    default: rto:244 rtt:43.462/3.019
    500ms: rto:542 rtt:41.792/0.805
Con rto_min 500ms, la diferencia sigue al valor configurado. La regla del RFC es
conservadora; Linux prefiere recuperarse antes de una pérdida, a cambio de arriesgar
alguna retransmisión de más.
En la práctica. En un examen, y en P3, se aplica la fórmula del RFC 6298. Al leer
ssen un Linux real, recuerden que elrtoque aparece incluye ese piso. Ninguno de los dos está equivocado: el RFC usa “SHOULD” para el mínimo de 1 s, lo que deja lugar a esta decisión.
El temporizador en acción
Una vez que vence el RTO, TCP retransmite el segmento más antiguo sin confirmar y duplica el RTO antes de armar el temporizador de nuevo. Se llama retroceso exponencial (exponential backoff). Si vence, probablemente la red tiene un problema serio, y lo último que debe hacer TCP es insistir más rápido.
El escenario rto lo aísla. Un flujo lento envía 1000 bytes cada 100 ms y, a la mitad,
el router corta los dos sentidos durante unos 3 s, con netem loss 100%. Sin ACK de
ningún tipo, TCP solo tiene su reloj. Estas son las retransmisiones que vio la captura
en a: tiempo, secuencia y largo.
1.828041000	17001	1000
2.386997000	15001	1000
2.887999000	15001	1000
3.920219000	15001	1000
5.968019000	15001	1000
6.052147000	16001	1000
6.052152000	17001	1000
6.094050000	18001	1000
Lean la columna de la secuencia. La primera línea no es del temporizador: es una sonda
sobre lo último enviado, que explicamos en la Sesión B. Luego 15001, el byte más
antiguo sin confirmar, sale varias veces, a intervalos de 0,50 s, 1,03 s y 2,05 s:
cada uno es el doble del anterior. La última vez sí pasó, porque la red ya había
vuelto. Llegó el ACK, y TCP siguió de inmediato con lo demás. Esto mismo, desde ss,
antes y durante el corte:
cubic wscale:7,7 rto:249 rtt:48.23/11.866 mss:1448 pmtu:1500 rcvmss:536 advmss:1448 cwnd:10 bytes_sent:15000 bytes_acked:14001 ...
cubic wscale:7,7 rto:992 backoff:2 rtt:47.455/10.45 mss:1448 pmtu:1500 rcvmss:536 advmss:1448 cwnd:1 ssthresh:7 bytes_sent:26000 bytes_retrans:3000 bytes_acked:15001 ...
backoff:2 dice que se duplicó dos veces: 992 ≈ 248 × 4. Y cwnd:1 anticipa la próxima
semana: después de un timeout, TCP vuelve a empezar casi de cero. Este es el resumen de
los contadores del kernel para ese corte, que no adivinan nada:
TcpRetransSegs=12 TcpExtTCPTimeouts=4 TcpExtTCPLossProbes=1 TcpExtTCPSackRecovery=0 TcpExtTCPRenoRecovery=0Cuatro veces venció el temporizador, una vez salió una sonda. Y hay un costo oculto: como el temporizador ya está en retroceso, TCP puede quedarse callado un buen rato después de que la red volvió. Una caída de 3 s se puede sentir como bastante más.
Idea clave. Hay dos preguntas distintas. ¿Cuánto esperar la primera vez? Lo responde la estimación del RTT. ¿Y si tampoco esa vez llega nada? Lo responde el retroceso exponencial, que no mira el RTT: solo duplica.
Fast retransmit
Con esto empieza la Sesión B. Esperar el RTO es caro: aquí son más de 200 ms, unas seis veces el RTT. Pero en una transferencia larga, una pérdida da señales mucho antes. Si se pierde un segmento en medio de otros, los siguientes siguen llegando, y por cada uno el receptor manda un ACK con el mismo número. El emisor recibe ACK duplicados.
Para verlo sin azar, el escenario drop hace que m descarte exactamente un paquete:
el número 40 de los que van hacia el puerto 5001. Lo hace con esta regla, que vale la
pena leer:
m# nft 'add rule ip w10 forward tcp dport 5001 numgen inc mod 100000 == 40 counter drop'Empecemos por el TCP de los libros: el escenario classic apaga SACK y RACK, dos
mejoras que vemos enseguida, con sysctl en cada host.
$ tshark -r captures/classic-a.pcap -Y tcp.analysis.flags
  123   0.172808  10.210.2.10 → 10.210.1.10  TCP 66 [TCP Dup ACK 120#1] 5001 → 37986 [ACK] Seq=1 Ack=55025 Win=99840 Len=0 TS
  125   0.173835  10.210.2.10 → 10.210.1.10  TCP 66 [TCP Dup ACK 120#2] 5001 → 37986 [ACK] Seq=1 Ack=55025 Win=99840 Len=0 TS
  127   0.173840  10.210.2.10 → 10.210.1.10  TCP 66 [TCP Dup ACK 120#3] 5001 → 37986 [ACK] Seq=1 Ack=55025 Win=99840 Len=0 TS
  128   0.173843  10.210.1.10 → 10.210.2.10  TCP 1514 [TCP Fast Retransmission] 37986 → 5001 [ACK] Seq=55025 Ack=1 Win=64256
  129   0.173844  10.210.2.10 → 10.210.1.10  TCP 66 [TCP Dup ACK 120#4] 5001 → 37986 [ACK] Seq=1 Ack=55025 Win=99840 Len=0 TS
  130   0.173845  10.210.2.10 → 10.210.1.10  TCP 66 [TCP Dup ACK 120#5] 5001 → 37986 [ACK] Seq=1 Ack=55025 Win=99840 Len=0 TS
Definición. Con fast retransmit, al recibir el tercer ACK duplicado, el emisor retransmite el segmento que empieza en ese número, sin esperar el temporizador. Eso está en el RFC 5681.
Aquí pasa exactamente eso: a los 3 microsegundos del tercer duplicado sale la
retransmisión de Seq=55025. Con el mismo descarte, en la captura drop de la próxima
sección, eso ocurre unos 45 ms después del envío original, mucho menos que los 240 ms de
RTO. Los ACK duplicados 4 y 5 siguen llegando porque ya venían en camino.
Por qué tres y no uno
Un ACK duplicado no significa pérdida. Significa que llegó algo fuera de orden. Y eso también ocurre cuando un paquete solo se atrasó, por ejemplo si tomó otro camino. Con un umbral de uno, cualquier pequeño desorden causaría una retransmisión inútil. Con tres, hace falta que tres segmentos posteriores hayan adelantado al que falta, lo que ya es poco probable si solo fue desorden. El tres es un valor empírico, elegido para que el desorden leve no dispare nada, y no sale de ningún teorema.
Eso sí, el valor no alcanza para todo. El escenario reorder no pierde nada: solo
agrega 3 ms de jitter, sin tope de velocidad, y los segmentos se adelantan unos a otros.
Nada se pierde, así que toda retransmisión está de más:
$ python3 scenarios.py reorder_classic
recibidos 3000000 bytes en 0.52 s (46.3 Mbit/s)
TcpRetransSegs=34  TcpExtTCPTimeouts=0  TcpExtTCPLossProbes=0  TcpExtTCPSackRecovery=0  TcpExtTCPRenoRecovery=35

$ python3 scenarios.py reorder
recibidos 3000000 bytes en 0.34 s (71.0 Mbit/s)
TcpRetransSegs=4  TcpExtTCPTimeouts=0  TcpExtTCPLossProbes=0  TcpExtTCPSackRecovery=1  TcpExtTCPRenoRecovery=0
Y estos son los ACK duplicados de la segunda corrida, la moderna:
ACK duplicados 1595 (el mayor, #89); rachas que llegaron a #1: 162, a #2: 133, a #3: 115
retransmitidos 4 segmentos, 4 de ellos marcados como fast
Es decir, 115 veces hubo tres duplicados seguidos sin ninguna pérdida, y aun así este TCP retransmitió 4 segmentos. El clásico, en el mismo enlace, 34 y con menor velocidad. En otras corridas vimos entre 0 y 4 para el moderno y entre 34 y 40 para el clásico: comparen el orden de magnitud. ¿Qué hace distinto el moderno? Lo vemos a continuación.
Idea clave. Un ACK duplicado es una pista, no una prueba. El umbral de tres es un compromiso entre reaccionar rápido a una pérdida y no confundir desorden con pérdida.
SACK: decir exactamente qué llegó
El ACK acumulativo tiene un límite: solo dice dónde empieza el primer hueco. Si se
perdieron dos segmentos, el emisor no sabe nada del segundo hasta arreglar el primero.
SACK (selective acknowledgment) agrega una opción a los ACK con los bloques
recibidos más allá del hueco. Se acuerda en el handshake (es el SACK_PERM del SYN) y
es lo que usa Linux por defecto. Este es el mismo descarte, con el TCP normal. Las
columnas son número de duplicado, ACK, y el comienzo y el final del bloque:
$ tshark -r captures/drop-a.pcap -Y tcp.analysis.duplicate_ack -T fields -e tcp.analysis.duplicate_ack_num \
    -e tcp.ack -e tcp.options.sack_le -e tcp.options.sack_re
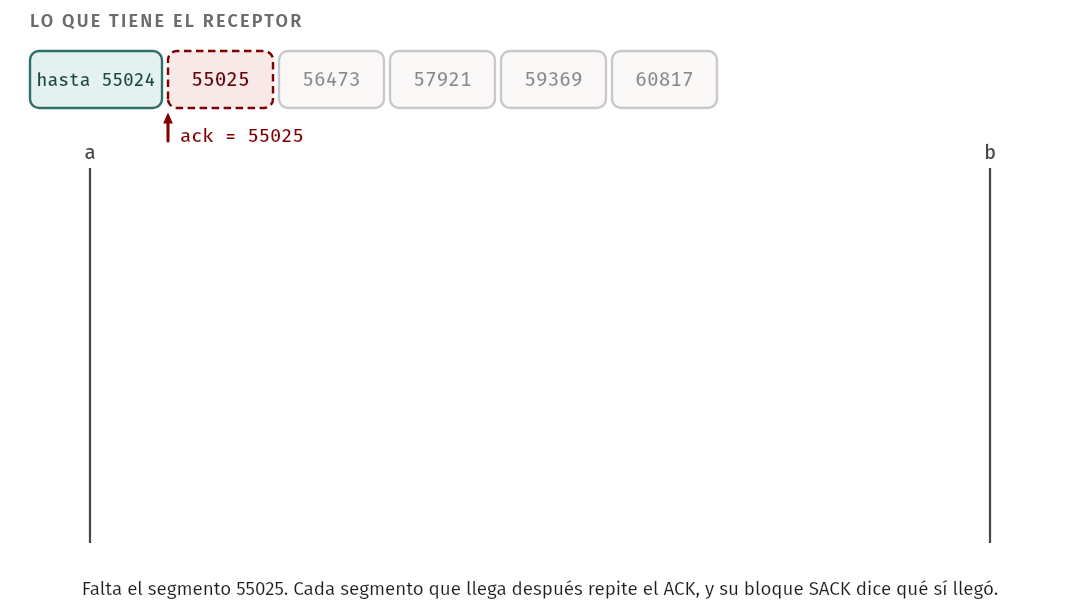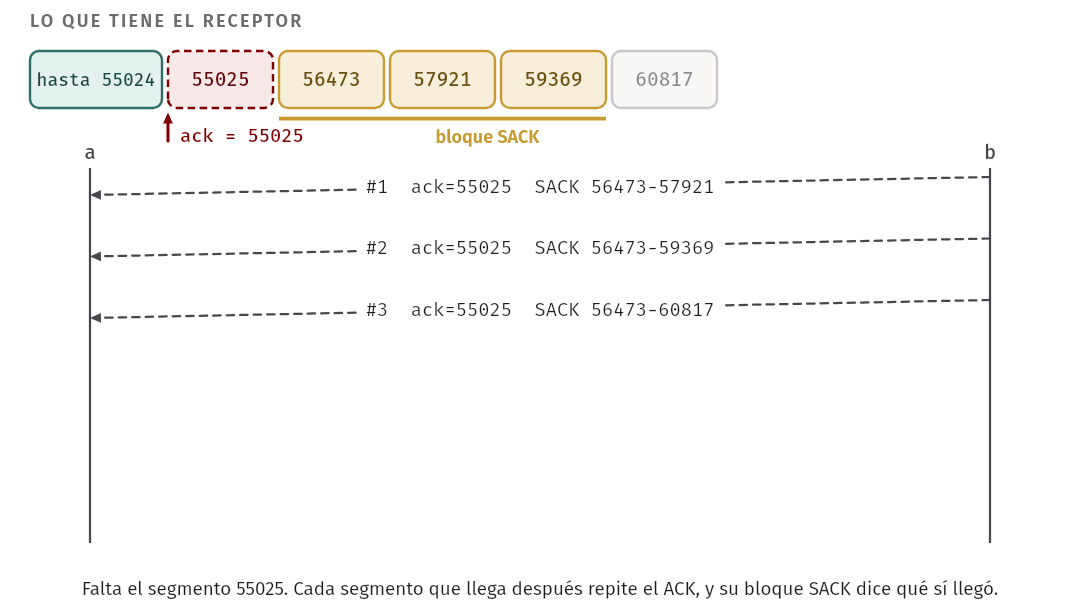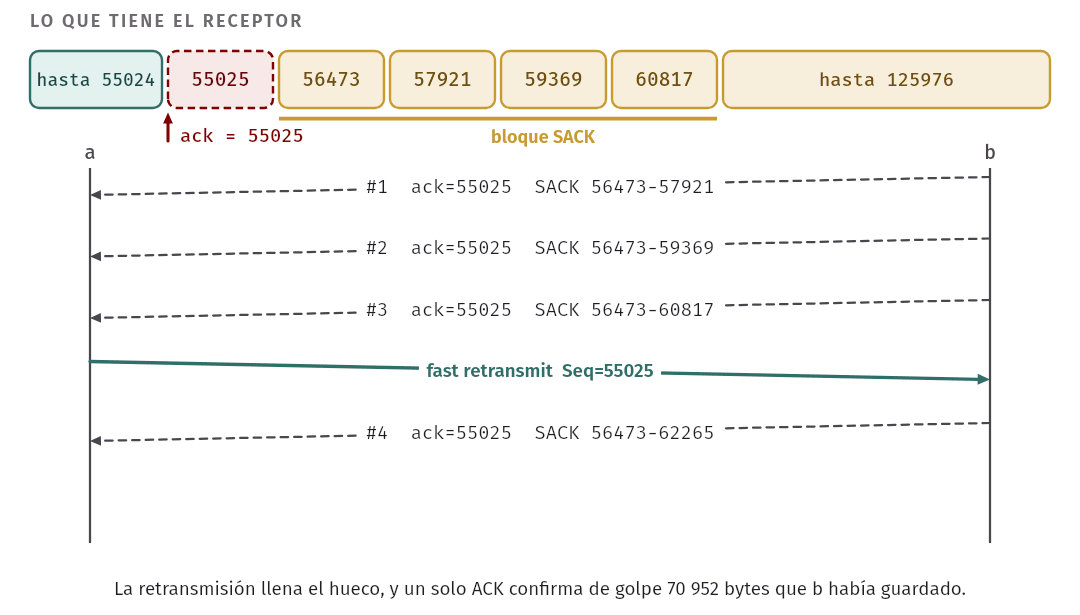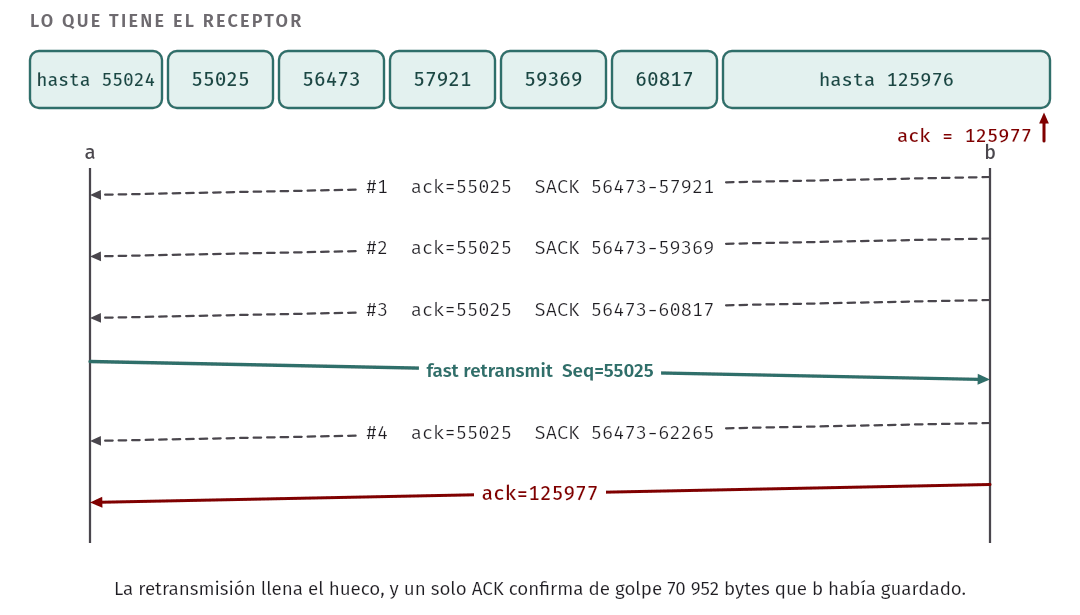
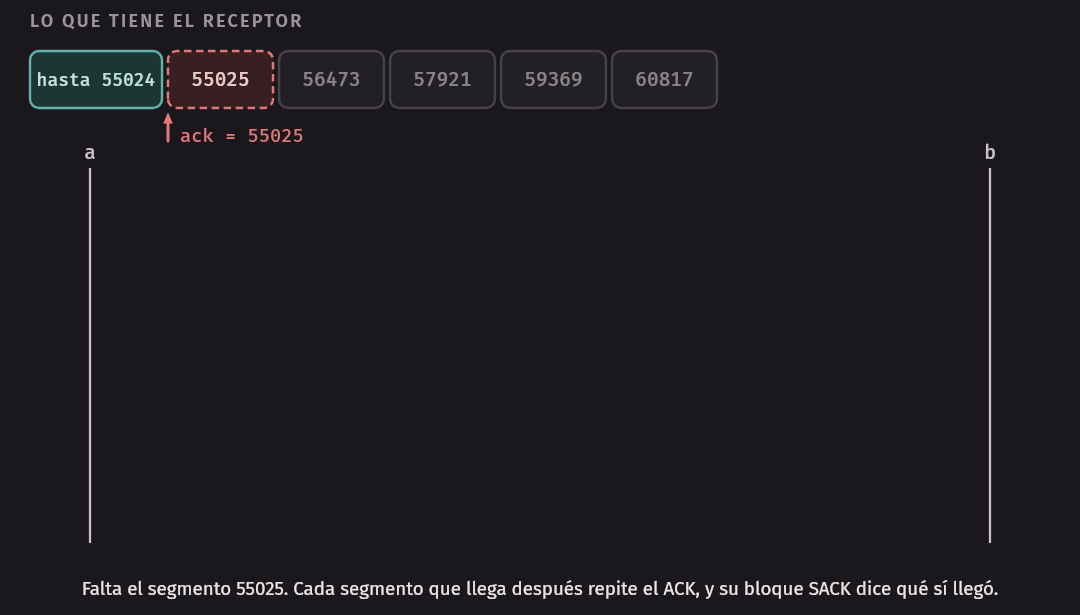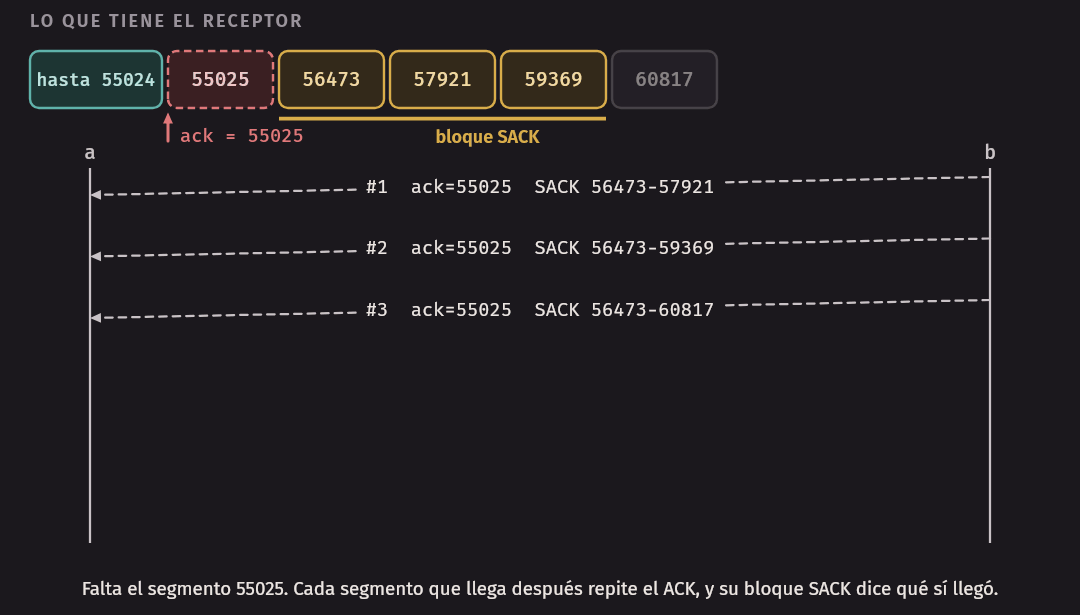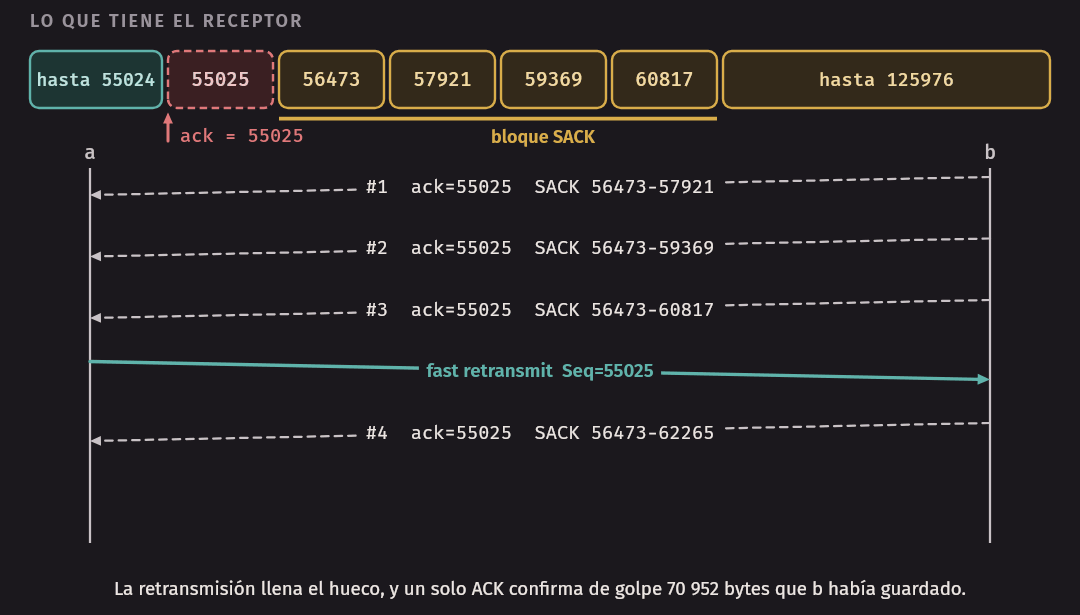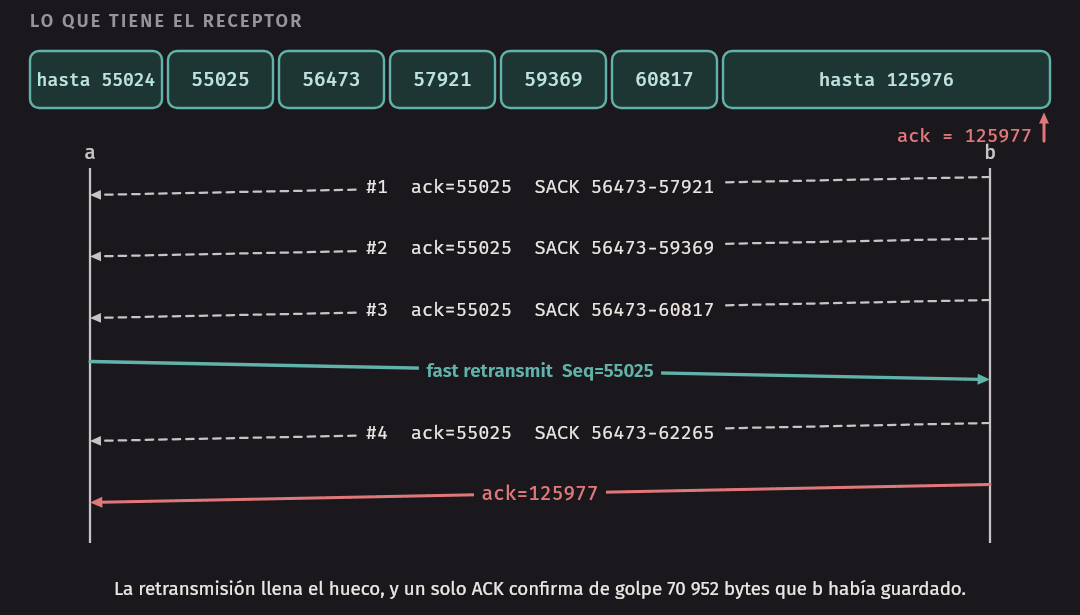
1	55025	56473	57921
2	55025	56473	59369
3	55025	56473	60817
4	55025	56473	62265
Léanlo así: “espero el byte 55025, pero ya tengo desde el 56473 hasta el 57921”. Falta
exactamente un segmento (1448 bytes), y el bloque crece con cada uno que llega. Ahora
comparemos las dos capturas, usando el truco de esta red. En a, el segmento sale dos
veces:
   57   0.128398  10.210.1.10 → 10.210.2.10  TCP 1514 37978 → 5001 [ACK] Seq=55025 Ack=1 Win=64256 Len=14
  126   0.172518  10.210.1.10 → 10.210.2.10  TCP 1514 [TCP Fast Retransmission] 37978 → 5001 [ACK] Seq=55
Y en b llega una sola vez: la retransmisión, en la posición de la captura en que ya
había bastantes otros detrás.
169 0.178087 10.210.1.10 → 10.210.2.10 TCP 1514 [TCP Fast Retransmission] 37978 → 5001 [ACK] Seq=55El primer ACK de b después de eso salta de golpe:
202 0.219291 10.210.2.10 → 10.210.1.10 TCP 66 5001 → 37978 [ACK] Seq=1 Ack=125977 Win=214656 Len=0 TSvalDe 55025 a 125977: 70 952 bytes confirmados con un solo ACK. Es el ACK acumulativo
haciendo su trabajo, sobre lo que b guardó mientras esperaba. Y los contadores del
kernel confirman la historia completa:
$ python3 scenarios.py drop
recibidos 2000000 bytes en 1.48 s (10.8 Mbit/s)
TcpRetransSegs=1  TcpExtTCPTimeouts=0  TcpExtTCPLossProbes=0  TcpExtTCPSackRecovery=1  TcpExtTCPRenoRecovery=0
Un solo segmento retransmitido, cero timeouts. Pero noten la velocidad: cerca de 11 Mbit/s, contra los 17 de la captura limpia, por un paquete perdido en 1383. Lo que costó no fue reenviar 1448 bytes, sino que TCP interpretó la pérdida como congestión y bajó su velocidad. Ese es el tema de la próxima semana.
Linux ya no cuenta hasta tres
Hoy, en Linux, el mecanismo por defecto no es contar duplicados. Es RACK (RFC
8985), que usa el tiempo: si ya se confirmó
(por SACK) un segmento que salió después de otro, y pasó un pequeño margen, el
anterior se da por perdido. Por eso tolera mejor el desorden que vimos arriba, y por eso
el sistema reacciona aunque no alcancen a llegar tres duplicados. En nuestra captura con
un solo descarte también salió justo tras el tercero, pero no es una garantía: la regla
de los tres duplicados sigue siendo lo que hay que entender, y lo que hace el modo
classic, pero un Linux real puede retransmitir antes o después.
Cuando no hay quién avise
Fast retransmit necesita que lleguen segmentos después del perdido. ¿Y si se pierde el
último? No habrá ACK duplicados, y solo quedaría esperar el RTO. Linux tiene una
respuesta: TLP (tail loss probe), la otra mitad del RFC
8985. Si pasan unos dos RTT sin ACK, reenvía lo último que mandó para provocar una
respuesta. El escenario tail envía 7000 bytes y descarta el último segmento de
datos y también el FIN:
    8   0.041812  10.210.1.10 → 10.210.2.10  TCP 1274 43294 → 5001 [PSH, ACK] Seq=5793 Ack=1 Win=642
    9   0.041816  10.210.1.10 → 10.210.2.10  TCP 66 43294 → 5001 [FIN, ACK] Seq=7001 Ack=1 Win=64256
   10   0.083735  10.210.2.10 → 10.210.1.10  TCP 66 5001 → 43294 [ACK] Seq=1 Ack=1449 Win=68096 Len=
   11   0.084735  10.210.2.10 → 10.210.1.10  TCP 66 5001 → 43294 [ACK] Seq=1 Ack=2897 Win=71040 Len=
   12   0.084738  10.210.2.10 → 10.210.1.10  TCP 66 5001 → 43294 [ACK] Seq=1 Ack=4345 Win=73856 Len=
   13   0.085730  10.210.2.10 → 10.210.1.10  TCP 66 5001 → 43294 [ACK] Seq=1 Ack=5793 Win=76800 Len=
   14   0.177741  10.210.1.10 → 10.210.2.10  TCP 66 [TCP Retransmission] 43294 → 5001 [FIN, ACK] Seq
   15   0.219737  10.210.2.10 → 10.210.1.10  TCP 78 [TCP Dup ACK 13#1] 5001 → 43294 [ACK] Seq=1 Ack=
   16   0.219753  10.210.1.10 → 10.210.2.10  TCP 1274 [TCP Retransmission] 43294 → 5001 [PSH, ACK] S
   17   0.261739  10.210.2.10 → 10.210.1.10  TCP 66 5001 → 43294 [ACK] Seq=1 Ack=7002 Win=79104 Len=
   18   0.261754  10.210.2.10 → 10.210.1.10  TCP 66 5001 → 43294 [FIN, ACK] Seq=1 Ack=7002 Win=79104
   19   0.261762  10.210.1.10 → 10.210.2.10  TCP 66 43294 → 5001 [ACK] Seq=7002 Ack=2 Win=64256 Len=
Entre el paquete 13 y el 14 no llegó nada. A los 92 ms, sin ninguna señal, a reenvía
lo último que había enviado: el FIN. Esa es la sonda. Esta vez sí llega, y su ACK (el
paquete 15) lleva un bloque SACK que revela el hueco. De inmediato sale el dato que
faltaba (16). El kernel lo confirma:
TcpRetransSegs=2 TcpExtTCPTimeouts=0 TcpExtTCPLossProbes=1 TcpExtTCPSackRecovery=1 TcpExtTCPRenoRecovery=0Es una mejora que no siempre alcanza: en otra corrida del mismo escenario el dato
faltante esperó al RTO (unos 0,23 s más), con TcpExtTCPTimeouts=1. Por eso la prueba de esta sección exige la sonda y no pide nada sobre el timeout.
Retransmisiones: lo que dice Wireshark y lo que pasó
Ahora el caso del laboratorio: 2 % de pérdida aleatoria, en el sentido de los datos.
$ python3 scenarios.py loss
recibidos 3000000 bytes en 11.53 s (2.1 Mbit/s)
TcpRetransSegs=43  TcpExtTCPTimeouts=0  TcpExtTCPLossProbes=0  TcpExtTCPSackRecovery=35  TcpExtTCPRenoRecovery=0
$ python3 tcpsum.py captures/loss-a.pcap
datos 2116 segmentos, 3062264 bytes enviados, 3000000 bytes distintos, el mayor de 1448
ACK de vuelta 1142 sin datos, ventana máxima anunciada 609408
ACK duplicados 304 (el mayor, #37); rachas que llegaron a #1: 41, a #2: 40, a #3: 38
retransmitidos 43 segmentos, 24 de ellos marcados como fastTres conclusiones:
- El archivo llegó entero. 3 000 000 bytes distintos, con 62 264 de sobra por retransmitir.
- La pérdida es de 2 %, pero la velocidad cayó casi 90 %. De unos 18 Mbit/s a unos 2 Mbit/s. La pérdida no cuesta los bytes reenviados, cuesta la reacción de TCP. Las cifras varían bastante de una corrida a otra (de 1,6 a 3,4 Mbit/s en las nuestras).
- Wireshark marcó 24 como fast y 19 como otra cosa. ¿Esas 19 son timeouts? No: el
kernel dice
TcpExtTCPTimeouts=0.
Error común. Leer
[TCP Retransmission]como “venció el temporizador”. Wireshark está mirando desde afuera y clasifica con reglas: si vio varios duplicados y fue reciente, dice fast; si no, dice retransmission. No sabe por qué el kernel tomó esa decisión. Un segmento que Wireshark marca así puede ser una sonda TLP, una decisión de RACK o un timeout real. En el corte de 3 s del escenariortotambién le puso fast a lo que siguió a la recuperación. La fuente confiable son los contadores:nstat -az TcpExtTCPTimeouts.
En las ocho corridas de este escenario en que miramos ese contador, ni una vez venció
el RTO. Con SACK, RACK y TLP, 2 % de pérdida aleatoria rara vez deja a TCP sin
señales. Para encontrar un timeout real, usen el escenario rto. Lo mismo vale en el
laboratorio.
El gráfico muestra una curva sin mesetas largas, con pendiente que cambia, y con cruces rojos donde hubo retransmisiones:
$ python3 timeseq.py captures/loss-a.pcap captures/loss-a.png
gráfico en captures/loss-a.png
Compárenlo con el de la captura limpia: aquella era una recta a 20 Mbit/s que tardaba un segundo, y esta tarda varios. Donde hay retransmisiones, la pendiente baja. Ahí TCP redujo su ventana.
Control de flujo
Hasta aquí, TCP protegía los datos de la red. Ahora lo protegemos de otra cosa: del
receptor. Los datos que llegan esperan en un buffer del kernel hasta que la aplicación
hace read. Si la aplicación es lenta, ese buffer se llena, y lo que llegue después se
descartaría.
Definición. Con control de flujo, cada segmento lleva en el campo de ventana
cuántos bytes más puede recibir ese extremo (la ventana de recepción, rwnd). El
emisor garantiza que:
último byte enviado - último byte confirmado <= ventana anunciadaEs la ventana deslizante de la semana 9 con una novedad: su tamaño cambia, y lo decide el receptor.
Ventana cero
El escenario zero usa un servidor con un buffer chico que acepta la conexión y se
queda 3 s sin leer. Lo ajustamos con SO_RCVBUF, y tiene que hacerse antes de listen,
porque la escala de la ventana se decide en el handshake:
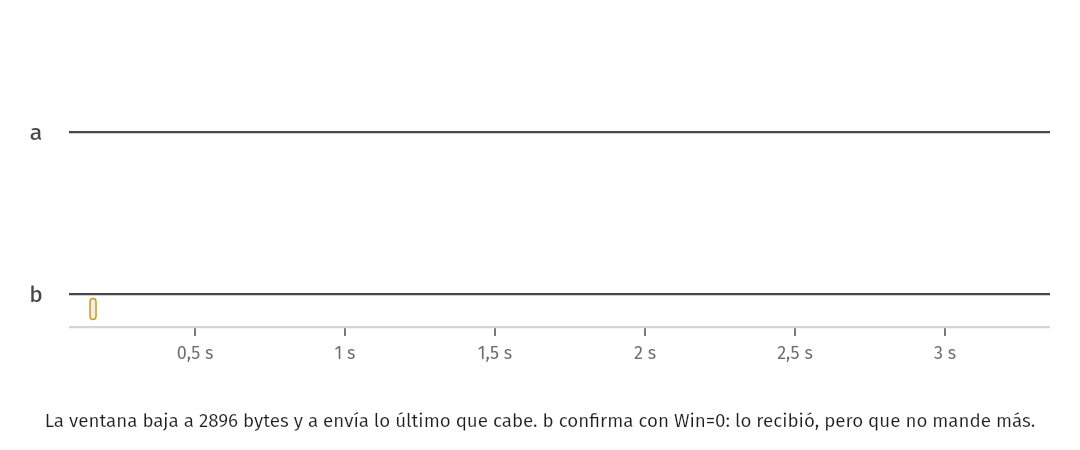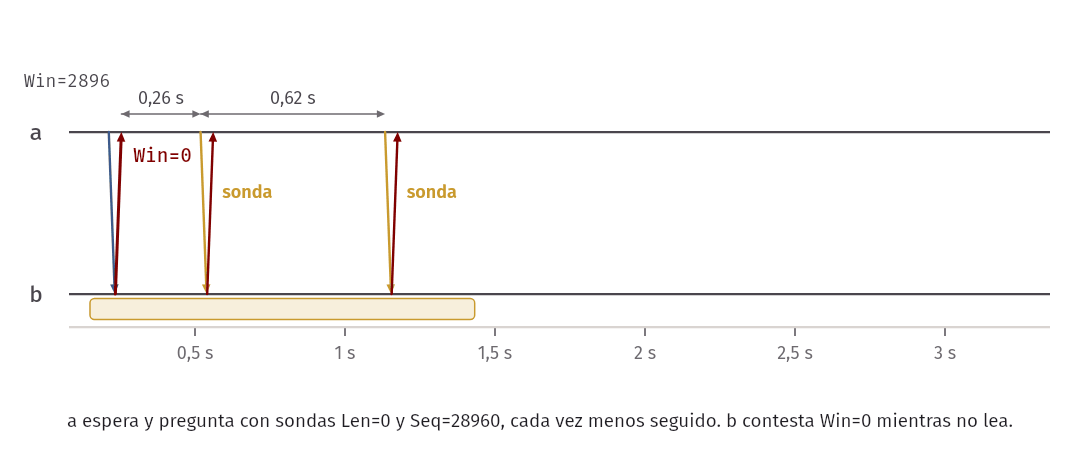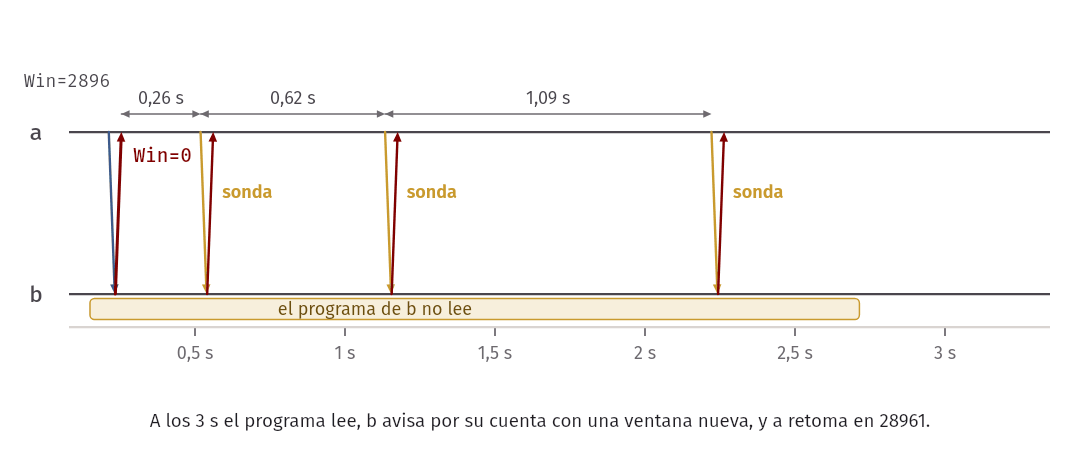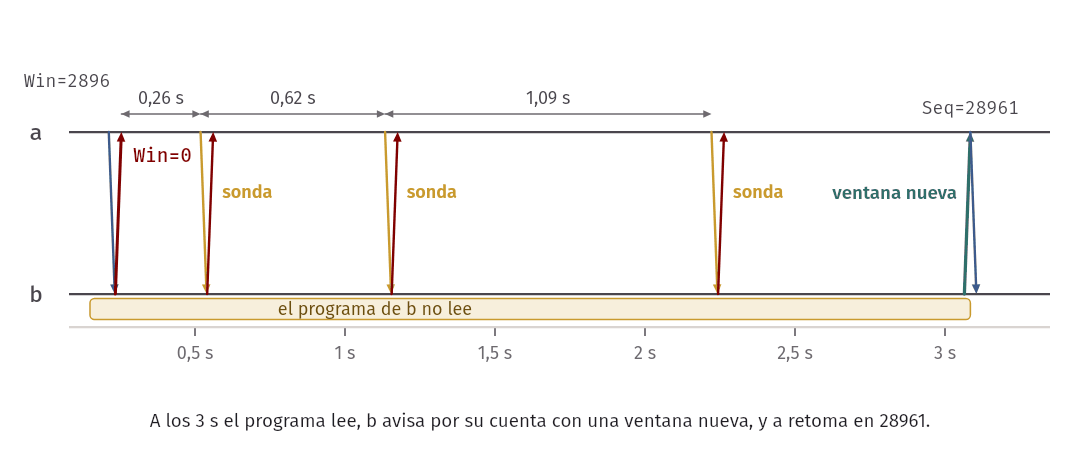
$ tshark -r captures/zero-a.pcap -Y "frame.number>=30 and frame.number<=41"
   30   0.212588  10.210.2.10 → 10.210.1.10  TCP 66 5001 → 56426 [ACK] Seq=1 Ack=26065 Win=2896 Len=0 TSval=21
   31   0.212613  10.210.1.10 → 10.210.2.10  TCP 1514 [TCP Window Full] 56426 → 5001 [ACK] Seq=27513 Ack=1 Win
   32   0.254582  10.210.2.10 → 10.210.1.10  TCP 66 [TCP ZeroWindow] 5001 → 56426 [ACK] Seq=1 Ack=28961 Win=0
   33   0.518604  10.210.1.10 → 10.210.2.10  TCP 66 [TCP Keep-Alive] 56426 → 5001 [ACK] Seq=28960 Ack=1 Win=64
   34   0.560608  10.210.2.10 → 10.210.1.10  TCP 66 [TCP ZeroWindow] 5001 → 56426 [ACK] Seq=1 Ack=28961 Win=0
   35   1.133607  10.210.1.10 → 10.210.2.10  TCP 66 [TCP Keep-Alive] 56426 → 5001 [ACK] Seq=28960 Ack=1 Win=64
   36   1.175605  10.210.2.10 → 10.210.1.10  TCP 66 [TCP ZeroWindow] 5001 → 56426 [ACK] Seq=1 Ack=28961 Win=0
   37   2.221656  10.210.1.10 → 10.210.2.10  TCP 66 [TCP Keep-Alive] 56426 → 5001 [ACK] Seq=28960 Ack=1 Win=64
   38   2.263588  10.210.2.10 → 10.210.1.10  TCP 66 [TCP ZeroWindow] 5001 → 56426 [ACK] Seq=1 Ack=28961 Win=0
   39   3.084589  10.210.2.10 → 10.210.1.10  TCP 66 [TCP Window Update] 5001 → 56426 [ACK] Seq=1 Ack=28961 Win
   40   3.084611  10.210.1.10 → 10.210.2.10  TCP 1514 56426 → 5001 [ACK] Seq=28961 Ack=1 Win=64256 Len=1448 TSval=
   41   3.084612  10.210.1.10 → 10.210.2.10  TCP 1514 56426 → 5001 [PSH, ACK] Seq=30409 Ack=1 Win=64256 Len=14
La historia, paso a paso:
- Paquete 30. La ventana ya está en 2896 bytes: dos segmentos.
- Paquete 31.
aenvía el último que cabe. Wireshark avisaWindow Full: con eso se acabó. - Paquete 32.
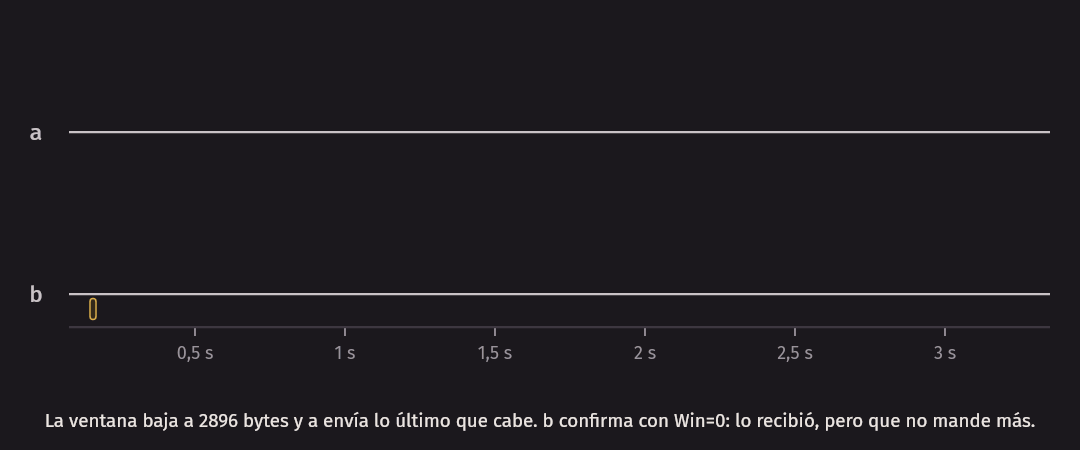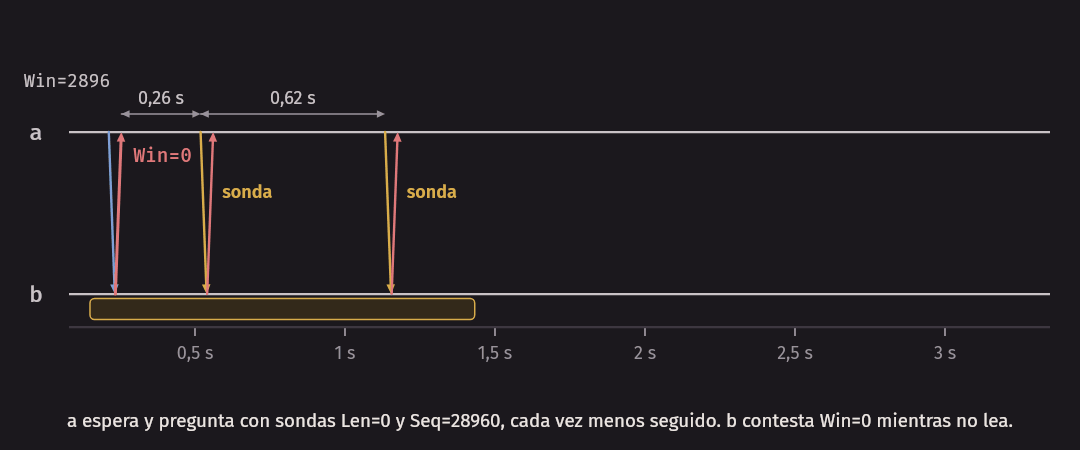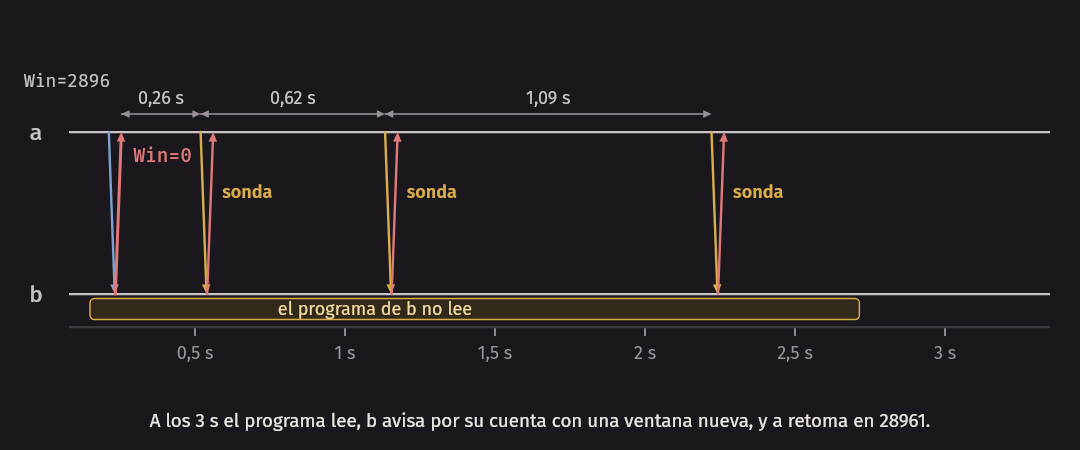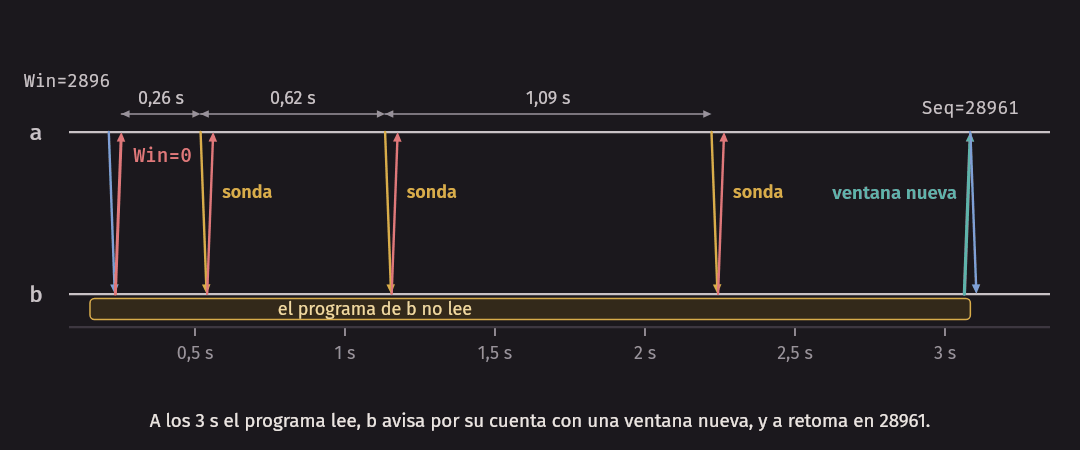
bconfirma todo, conWin=0. Es un mensaje importante: “lo recibí bien, pero no me mandes más”. - Paquetes 33 a 38.
aespera, y cada cierto tiempo pregunta. A estas preguntas las llamamos sondas de ventana (zero-window probes). Salen a 0,26 s, 0,62 s y 1,09 s entre sí: el intervalo crece. - Paquete 39. Al cumplirse los 3 s, el programa lee, y
bavisa por su cuenta con una ventana nueva. Un instante después,aretoma donde quedó.
¿Por qué hacen falta sondas, si b ya avisa cuando se abre la ventana? Porque ese aviso
del paquete 39 es un ACK sin datos, y los ACK sin datos no se retransmiten ni se
confirman. Si se pierde, a espera un aviso que no llegará, y b espera datos que no
vendrán. La conexión quedaría trabada para siempre. Las sondas evitan eso: el emisor
pregunta, y mientras reciba respuesta la conexión sigue viva, por todo el tiempo que
haga falta (el RFC 9293 lo exige).
Error común. Tomar al pie de la letra las descripciones de la sonda. El RFC 9293 habla de enviar al menos un byte de datos nuevos si hay, o de retransmitir, y muchos textos hablan de “una sonda de un byte”. Lo que capturamos aquí es otra cosa:
Len=0conSeq=28960, uno menos que el siguiente byte. Es un segmento con un número ya confirmado, que obliga al receptor a contestar con su estado actual. Por eso, además, Wireshark lo etiquetaTCP Keep-Alive: tiene el aspecto de un keep-alive. Búsquenlo con ese nombre.
Quién limita: la ventana o el enlace
Lo que transfiere TCP en un RTT no puede pasar de lo que permita la ventana. Por eso:
throughput <= ventana / RTTEl escenario limit lo mide, con un receptor que lee todo lo rápido que puede, pero con
buffers de distinto tamaño. El enlace es el de siempre: 20 Mbit/s, con 40 ms de RTT.
SO_RCVBUF |
Ventana máxima anunciada | Ventana / RTT | Medido |
|---|---|---|---|
| 8192 | 8 688 bytes | 1,7 Mbit/s | 1,2 Mbit/s |
| 32768 | 39 096 bytes | 7,8 Mbit/s | 6,8 Mbit/s |
| 262144 | 261 848 bytes | 52 Mbit/s | 17,9 Mbit/s |
Cifras de una corrida; cambian un poco en otras, y la tendencia no. En las dos primeras filas manda la ventana: lo medido anda algo por debajo de ventana / RTT, que es un techo. En la tercera, la ventana alcanzaría para 52 Mbit/s, y por eso quien limita es el enlace. Para llenar un enlace, la ventana debe ser al menos el producto ancho de banda × retardo: aquí, 20 Mbit/s × 40 ms = 100 kB. Es la misma cuenta de la semana 9.
Las capturas de las primeras filas no muestran una pérdida que explique la lentitud: en la corrida de la tabla, 0 segmentos retransmitidos. Ese es el diagnóstico: lento, sin pérdidas, con la ventana chica. No es la red.
Error común. Confundir control de flujo con control de congestión. Los dos limitan al emisor, pero el control de flujo protege al receptor, usa
rwnd, y el receptor la anuncia en cada segmento. El control de congestión protege a la red, usacwnd, y el emisor la deduce, porque la red no le dice nada. El emisor respeta el menor de los dos:min(rwnd, cwnd). Enss, sonsnd_wndycwnd. La próxima semana vemos la segunda.
En la práctica. Si una transferencia lenta sobre un enlace largo no sube de cierta velocidad sin importar el enlace, revisen la ventana. Linux agranda solo el buffer de recepción: la captura limpia llegó a anunciar 1 035 136 bytes, sin que nadie se lo pidiera. Fijar
SO_RCVBUFa mano apaga ese ajuste, y lo pagan quienes lo copian de un ejemplo viejo.
Mirar una conexión viva con ss
Todo lo anterior el kernel lo sabe de cada conexión, y ss -tin lo muestra. El
escenario ss envía 8 MB y consulta ss cada cierto tiempo. Recortamos los campos
menos relevantes:
a# ss -tin dst 10.210.2.10
ESTAB 0      738480   10.210.1.10:50756  10.210.2.10:5001
	 cubic wscale:7,7 rto:324 rtt:123.177/0.523 mss:1448 pmtu:1500 ... cwnd:215 ssthresh:168 bytes_sent:1911360 bytes_acked:1600041 ...
ESTAB 0      944096   10.210.1.10:50756  10.210.2.10:5001
	 cubic wscale:7,7 rto:306 rtt:105.569/0.502 mss:1448 pmtu:1500 ... cwnd:178 ssthresh:171 bytes_sent:3884984 bytes_retrans:17376 ... retrans:0/12 ...
ESTAB 0      871696   10.210.1.10:50756  10.210.2.10:5001
cubic wscale:7,7 rto:322 rtt:121.325/0.597 mss:1448 pmtu:1500 ... cwnd:204 ssthresh:171 bytes_sent:5949832 bytes_retrans:17376 ... retrans:0/12 ...| Campo | Qué es |
|---|---|
Tercera columna (Send-Q) |
Bytes aceptados por el kernel y aún no confirmados |
rtt |
EstimatedRTT y DevRTT, en ms |
rto |
El temporizador actual, en ms |
cwnd |
Ventana de congestión, en segmentos. El 215 son unos 311 kB |
ssthresh |
Umbral de slow start: próxima semana |
retrans:0/12 |
Retransmitidos: 0 ahora mismo, 12 en total |
snd_wnd |
La ventana que anunció el otro lado (la recortamos en esta salida) |
Hagamos dos cuentas. Con 215 segmentos en vuelo y 123 ms de RTT: 215 × 1448 × 8 / 0,123
= 20,2 Mbit/s, igual a lo que da el enlace. Y un RTT de 123 ms, en un camino de 40 ms:
los otros 80 ms son cola en m. Esa cola además se llena: los 12 retransmitidos no los
causó ningún netem loss, sino un buffer de 200 paquetes rebasado. Es pérdida por
congestión, la de la próxima semana.
Otra consecuencia de esto: write devuelve cuando el kernel acepta los bytes en su
buffer, no cuando llegan. Hay 738 480 bytes en Send-Q. Por eso sink mide la
velocidad en el receptor y no en blast.
El handshake: abrir una conexión
Ya vimos el handshake de tres pasos. Ahora la pregunta interesante: ¿por qué tres?
Cada lado debe saber dos cosas: el número inicial del otro, y que el otro recibió el
suyo. Con el número inicial de a y el de b, cada uno confirmado, salen cuatro
mensajes: SYN, ACK, SYN, ACK. El segundo y el tercero se pueden juntar en un solo
SYN-ACK. Quedan tres.
¿Y por qué no dos? Porque el servidor no puede distinguir un SYN nuevo de uno viejo. Es la razón principal que da el RFC 9293: evitar que SYN duplicados antiguos abran conexiones. Imaginen dos pasos:
  a                                    b
  | -- SYN x (viejo, de hace rato) ->   |  llega tarde
  |                                     |  con dos pasos, b ya abre la conexión
  | <---------- SYN-ACK y, ack x+1 ---  |  y puede esperar datos o enviarlos
  | a no reconoce esa conexión
Con tres pasos, b no considera abierta la conexión hasta que vea un ACK de su número
y, que no existía cuando se envió el SYN viejo. Y a, al ver un SYN-ACK que confirma
algo que no pidió, responde con RST. El tercer paso prueba que el otro lado está aquí y
ahora.
Idea clave. El handshake no es una cortesía. Es lo que convierte “alguien me envió un paquete” en “alguien está ahí, recibe lo que le envío y sabe en qué número voy”.
Por qué los números iniciales no empiezan en cero
Las capturas de arriba abren con 1661972085, 4265168592, 3960613348: cambian en cada conexión. Hay dos motivos:
- Confusión con conexiones anteriores. Un segmento retrasado de una conexión anterior, con los mismos cuatro campos, podría caer dentro de la ventana de la nueva. Si todas empezaran en cero, sería muy probable.
- Seguridad. Quien pueda adivinar los números de secuencia sin ver el tráfico puede inyectar segmentos falsos en una conexión ajena, o simular una conexión. El número inicial impredecible lo dificulta.
CS168 resume la historia así: originalmente el motivo era el primero, y hoy, en la práctica, es el segundo. El número inicial no es un mecanismo criptográfico: quien pueda capturar el tráfico lo lee. Protege contra quien no puede. Para protegerse de quien puede, está TLS, y lo veremos más adelante.
Qué devuelve connect
Lo que recibe la aplicación depende de lo que le pase al SYN. Las respuestas son fáciles
de confundir, y son las que van a ver en sus programas. Usamos connect_probe, con TCP_SYNCNT en 2 para no esperar dos minutos:
$ python3 scenarios.py ports
    closed: connect devolvió -1 en 0.042 s: ECONNREFUSED (Connection refused)
    filtered: connect devolvió -1 en 7.203 s: ETIMEDOUT (Connection timed out)
    filtered_exp: connect devolvió -1 en 7.098 s: ETIMEDOUT (Connection timed out)
    rejected: connect devolvió -1 en 0.021 s: EHOSTUNREACH (No route to host)
    no_route: connect devolvió -1 en 0.020 s: ENETUNREACH (Network is unreachable)
open: connect devolvió 0 en 0.041 s| Caso | Qué pasó | Qué ve connect |
Tiempo |
|---|---|---|---|
| Puerto abierto | SYN-ACK | 0 | Un RTT |
| Puerto cerrado | El kernel de b responde RST, ACK |
ECONNREFUSED |
Un RTT |
Puerto filtrado (drop) |
Nadie responde nada | ETIMEDOUT |
Segundos |
Filtrado con reject |
El router manda un ICMP | EHOSTUNREACH |
La mitad del RTT |
| Sin ruta | El router manda un ICMP | ENETUNREACH |
La mitad del RTT |
El puerto cerrado, en la captura:
    1   0.000000  10.210.1.10 → 10.210.2.10  TCP 74 55194 → 5999 [SYN] Seq=0 Win=64240 Len=0 MS
    2   0.041334  10.210.2.10 → 10.210.1.10  TCP 54 5999 → 55194 [RST, ACK] Seq=1 Ack=1 Win=0 L
Los dos últimos tardan 20 ms y no 40, porque responde m, a medio camino. Cerrado y
filtrado se distinguen fácil: “rechazado al instante” significa que el host existe y su
kernel respondió. “Se queda colgado” significa que algo se tragó el paquete, y puede ser
el firewall, o que el host está apagado.
Un resultado curioso salió aquí. Esperábamos reintentos a 1, 2 y 4 s, y el total de 7 s parecía confirmarlo. Pero veamos los tiempos de los SYN en la captura:
filtered (por defecto)        filtered_exp (tcp_syn_linear_timeouts=0)
0.000000000                   0.000000000
1.059143000                   1.018746000
2.083651000                   3.067214000
3.107122000
4.131391000
5.155128000
Con la configuración por defecto de este kernel, los primeros reintentos van cada 1 s, sin
duplicarse, por el valor net.ipv4.tcp_syn_linear_timeouts=4, y recién luego empieza el
retroceso. Si lo ponemos en 0, aparece la duplicación del libro: 1 s, 2 s. La primera espera, de
1 s, sí es la del RFC 6298 en los dos casos.
Lo otro que sorprende es que con TCP_SYNCNT en 2 salieron seis SYN, y no tres, y que el tiempo
total no cambió. Medimos más valores, con la configuración por defecto:
TCP_SYNCNT |
Tiempos de los SYN (s) | connect se rinde a los |
|---|---|---|
| 1 | 0, 1, 2 | 3,1 s |
| 2 | 0, 1, 2, 3, 4, 5 | 7,2 s |
| 3 | 0, 1, 2, 3, 4, 5, 7,2, 11,2 | 19,4 s |
Nuestra lectura de estos datos: en este kernel, el valor no funciona como un número de SYN sino como un plazo, el que tomarían n reintentos si cada uno duplicara la espera: 3 s, 7 s y 15 s. Y ese plazo se revisa solo cuando vence el temporizador: con 3, el temporizador venció a los 11,2 s, todavía dentro del plazo, y luego a los 19,4 s, ya fuera. Muchos textos hablan de “cantidad de reintentos”, y aquí no es eso. Otra razón para comprobar, y no suponer.
El cierre: FIN, conexiones a medio cerrar, TIME_WAIT y RST
Como TCP es full duplex, cerrar es cosa de dos: cada sentido se cierra por separado con su propio FIN. El FIN dice “no voy a enviar más”, no “no quiero recibir más”.
A medio cerrar
Eso permite una conexión a medio cerrar (half-close). Un cliente envía todo su
pedido y hace shutdown(fd, SHUT_WR). Ahora el servidor ve el fin del archivo en
read, y todavía puede contestar. Es útil cuando el servidor necesita saber que el
pedido terminó. El escenario halfclose lo hace:
    7   0.055415  10.210.1.10 → 10.210.2.10  TCP 66 48000 → 5001 [FIN, ACK] Seq=3001 Ack=1
    8   0.097507  10.210.2.10 → 10.210.1.10  TCP 66 5001 → 48000 [ACK] Seq=1 Ack=1449 Win=
    9   0.097514  10.210.2.10 → 10.210.1.10  TCP 66 5001 → 48000 [ACK] Seq=1 Ack=2897 Win=
   10   0.097516  10.210.2.10 → 10.210.1.10  TCP 66 5001 → 48000 [ACK] Seq=1 Ack=3001 Win=
   11   0.098352  10.210.2.10 → 10.210.1.10  TCP 77 5001 → 48000 [PSH, ACK] Seq=1 Ack=3002
   12   0.098372  10.210.1.10 → 10.210.2.10  TCP 66 48000 → 5001 [ACK] Seq=3002 Ack=12 Win
   13   0.098373  10.210.2.10 → 10.210.1.10  TCP 66 5001 → 48000 [FIN, ACK] Seq=12 Ack=300
   14   0.098375  10.210.1.10 → 10.210.2.10  TCP 66 48000 → 5001 [ACK] Seq=3002 Ack=13 Win
El cliente envió su FIN en el paquete 7. En el 11, después, el servidor le manda 11
bytes (3000 bytes\n), y el cliente los confirma en el 12. Luego vienen el FIN del
servidor y su ACK. Aquí el cierre tiene otra vez cuatro pasos: FIN (7), ACK (10),
FIN (13), ACK (14).
TIME_WAIT
El lado que cierra primero no libera la conexión al terminar. Se queda en el estado
TIME_WAIT. El RFC 9293 pide esperar 2 MSL, donde MSL (maximum segment lifetime) es
el tiempo máximo que un segmento puede andar por la red, fijado en 2 minutos: cuatro
minutos en total. Linux usa 60 s fijos. Se ve en ss:
$ ss -tano state time-wait sport = :5003
Recv-Q Send-Q Local Address:Port Peer Address:Port
0      0        10.210.2.10:5003  10.210.1.10:38724 timer:(timewait,59sec,0)
Existe por dos motivos:
- Para poder repetir el último ACK. Si se pierde, el otro lado va a retransmitir su
FIN, y alguien tiene que contestar. Sin
TIME_WAIT, la conexión ya no existiría, y el FIN recibiría un RST: el otro lado vería un error en una conexión que terminó bien. - Para que los segmentos viejos se mueran. Mientras dure, no se puede crear otra conexión con esos mismos cuatro campos, así que un segmento atrasado no cae dentro de la siguiente.
El primer motivo lo podemos provocar. El escenario timewait hace que m descarte el
último ACK:
    1   0.000000  10.210.1.10 → 10.210.2.10  TCP 74 54188 → 5001 [SYN] Seq=0 Win=64240 Len=0 MS
    2   0.046466  10.210.2.10 → 10.210.1.10  TCP 74 5001 → 54188 [SYN, ACK] Seq=0 Ack=1 Win=651
    3   0.046496  10.210.1.10 → 10.210.2.10  TCP 66 54188 → 5001 [ACK] Seq=1 Ack=1 Win=64256 Le
    4   0.046540  10.210.1.10 → 10.210.2.10  TCP 66 54188 → 5001 [FIN, ACK] Seq=1 Ack=1 Win=642
    5   0.090426  10.210.2.10 → 10.210.1.10  TCP 66 5001 → 54188 [FIN, ACK] Seq=1 Ack=2 Win=652
    6   0.090445  10.210.1.10 → 10.210.2.10  TCP 66 54188 → 5001 [ACK] Seq=2 Ack=2 Win=64256 Le
    7   0.367620  10.210.2.10 → 10.210.1.10  TCP 66 [TCP Retransmission] 5001 → 54188 [FIN, ACK
    8   0.367712  10.210.1.10 → 10.210.2.10  TCP 66 [TCP Dup ACK 6#1] 54188 → 5001 [ACK] Seq=2
El paquete 6 nunca llegó a b. Unos 277 ms después (un RTO de Linux, más o menos), b
repite su FIN (paquete 7). Del lado de a ya no hay ningún programa: blast terminó
hace rato. Quien contesta el paquete 8 es el estado que TIME_WAIT conservó en el
kernel. Sin eso, ahí habría un RST.
El costo de TIME_WAIT
Lo tiene quien cierra primero, y normalmente es el cliente, que no lo nota. Si es el
servidor, aparece un error famoso. El escenario bindfail lo reproduce:
$ python3 scenarios.py bindfail
  b# /w10/sink 5003 --close-first --no-reuseaddr &
  a# /w10/connect_probe 10.210.2.10 5003 2 300
  b# ss -tano state time-wait sport = :5003
Recv-Q Send-Q Local Address:Port Peer Address:Port
0      0        10.210.2.10:5003  10.210.1.10:38724 timer:(timewait,59sec,0)
  b# timeout 1 /w10/sink 5003 --no-reuseaddr
    sin SO_REUSEADDR: bind: Address already in use
  b# /w10/sink 5004 --close-first &
  a# /w10/connect_probe 10.210.2.10 5004 2 300
  b# ss -tano state time-wait sport = :5004
Recv-Q Send-Q Local Address:Port Peer Address:Port
0      0        10.210.2.10:5004  10.210.1.10:48858 timer:(timewait,59sec,0)
  b# timeout 1 /w10/sink 5004
    con SO_REUSEADDR: bind funciona
Esto explica por qué todo servidor del curso pone SO_REUSEADDR, y por qué sin él,
reiniciar un servidor falla durante un minuto. Hay un detalle poco conocido: la opción debe estar en los dos sockets, el que dejó el TIME_WAIT y el nuevo. Lo probamos a mano: si solo la pone el nuevo, también da Address already in use. Por eso el escenario usa dos puertos, uno por ronda.
Error común. Creer que
TIME_WAITes un error, o una conexión que quedó mal, porque aparecen muchas enss. Es una conexión que terminó bien, en su último estado normal. Y no ocupa al servidor: unTIME_WAITno impide atender a otros clientes en ese puerto.
RST: abortar
RST no es una forma de cerrar sino de abortar: dice “esta conexión no existe” o “no
sigo”. No se confirma, y el otro lado se entera con un error en su siguiente read. Ya
vimos uno, en respuesta a un puerto cerrado. El otro caso es un programa que aborta: con
SO_LINGER en cero, close manda RST y tira lo que no se haya enviado. El escenario
abort lo hace:
    4   0.041581  10.210.1.10 → 10.210.2.10  TCP 1514 56884 → 5001 [ACK] Seq=1 Ack=1 Win=6
    5   0.041581  10.210.1.10 → 10.210.2.10  TCP 1514 56884 → 5001 [PSH, ACK] Seq=1449 Ack
    6   0.041585  10.210.1.10 → 10.210.2.10  TCP 170 56884 → 5001 [PSH, ACK] Seq=2897 Ack=
    7   0.041594  10.210.1.10 → 10.210.2.10  TCP 66 56884 → 5001 [RST, ACK] Seq=3001 Ack=1
    8   0.083510  10.210.2.10 → 10.210.1.10  TCP 66 5001 → 56884 [ACK] Seq=1 Ack=1449 Win=
    9   0.083525  10.210.1.10 → 10.210.2.10  TCP 54 56884 → 5001 [RST] Seq=1449 Win=0 Len=
Del lado del servidor, read falló con Connection reset by peer. Los ACK de b
estaban en camino cuando llegó el RST, y a, que ya no conoce esa conexión, contesta
cada uno con otro RST: paquetes 8 y 9. Cualquier segmento que llegue a una conexión que
no existe recibe esta respuesta. También por eso un tercero que logre falsificar un RST
válido puede cortar una conexión ajena, como menciona CS168: es una forma real de
censura.
SYN flood y SYN cookies
Abrir una conexión le cuesta memoria al servidor antes de saber si el cliente es real.
Al recibir un SYN, guarda una entrada en la cola de SYN (estado SYN_RECV),
responde SYN-ACK y espera el ACK. Esa cola es finita.
Definición. En un SYN flood, el atacante envía muchos SYN y nunca completa el handshake, normalmente con direcciones de origen falsas, para que las respuestas se pierdan. La cola se llena, y los clientes legítimos no pueden entrar. Enviar un SYN cuesta muy poco, y por eso el ataque es barato. Es un ataque de denegación de servicio descrito en el RFC 4987, junto con las defensas.
En nuestra red lo vemos sin falsificar nada, y solo entre nuestros nodos. Un servidor
con backlog 16 recibe 100 SYN de half_open desde la segunda dirección de a, y m
descarta los SYN-ACK que vuelven a esa dirección. Luego un cliente legítimo, desde la
otra dirección, intenta entrar. Primero, con SYN cookies apagadas:
$ python3 scenarios.py syn
    cookies off: 17 en SYN-RECV, connect devolvió -1 en 7.154 s: ETIMEDOUT (Connection timed out), {'TcpExtTCPReqQFullDrop': 587, 'TcpExtSyncookiesSent': 0, 'TcpExtSyncookiesRecv': 0}
    cookies on: 17 en SYN-RECV, connect devolvió 0 en 0.041 s, {'TcpExtTCPReqQFullDrop': 0, 'TcpExtSyncookiesSent': 250, 'TcpExtSyncookiesRecv': 1}
La primera línea es el ataque funcionando. La cola quedó con 17 entradas, casi el valor
de backlog. Y se descartaron 587 SYN, contando los reintentos, entre ellos los del
cliente legítimo, que se quedó sin conexión. La segunda es la misma situación con la
defensa puesta: el cliente entra en un RTT.
Definición. Con SYN cookies, cuando la cola está llena, el servidor deja de guardar estado. Codifica lo necesario en el número de secuencia del SYN-ACK: un hash de los cuatro campos de la conexión y de un secreto, un contador de tiempo y el MSS. El cliente legítimo responde con ese número más uno, y solo entonces el servidor reconstruye el estado, tras comprobar el hash. El atacante, con direcciones falsas, nunca recibió el SYN-ACK y no puede responder con ese número.
Es un buen truco, porque no cambia nada en el cliente, y porque aprovecha justo lo que
hace al número inicial una buena idea: se ve como un número cualquiera. La línea lo
confirma: TcpExtSyncookiesSent=250 y TcpExtSyncookiesRecv=1, el cliente legítimo. El
costo es que no hay dónde guardar todo lo que trae el SYN: el RFC 4987 advierte que los
esquemas comunes son incompatibles con algunas opciones de TCP. Por eso se activa solo
cuando la cola se llena. En Linux es lo que hace el valor por defecto
tcp_syncookies=1.
En la práctica. Un SYN flood real llega con millones de paquetes por segundo. Las SYN cookies protegen la memoria del servidor, pero no el ancho de banda de su enlace, y para eso hay que filtrar antes de llegar. Esto lo veremos en la parte de seguridad.
El laboratorio
Trabajen en code/week-10/, dentro del contenedor del curso. Empiecen por make up.
Para abrir una captura en Wireshark, abran el archivo de captures/ desde su
computadora: la carpeta es la misma. Algunas actividades se basan en el laboratorio de
TCP de Kurose y Ross.
-
Sin pérdidas.
python3 scenarios.py clean. Abrancaptures/clean-a.pcapy encuentren el handshake, el cierre y la opción MSS. Busquen los números reales, y calculen a mano un par de ACK. -
Tiempo-secuencia. En Wireshark, seleccionen un segmento de datos y vayan a Statistics → TCP Stream Graphs → Time Sequence. O bien corran
python3 timeseq.py. Expliquen la forma: escalones, recta y distancia a los ACK. ¿Cuánto da la pendiente? -
2 % de pérdida.
python3 scenarios.py loss. Encuentren ACK duplicados y un fast retransmit. Filtros útiles:tcp.analysis.duplicate_ackytcp.analysis.fast_retransmission. Un timeout real no va a aparecer aquí, y conviene comprobarlo: revisenTcpExtTCPTimeouts. Para verlo, corranpython3 scenarios.py rtoy midan los intervalos. -
Receptor lento. Completen
lab/slow_reader.c, que lee de a N bytes con una pausa después de cada lectura. Compilen conmake. Corranpython3 scenarios.py slow, y encuentren en la captura la ventana cero y las sondas: filtrostcp.analysis.zero_windowytcp.analysis.keep_alive. Calculen cuánto debería tardar y compárenlo con lo medido. Con la configuración de ese escenario (8192 2048 100), su resumen se debería parecer a este:SYN-ACK seq real 4113039008; MSS 1460, ventana 7240, escala 0, SACK sí, timestamps sí datos 70 segmentos, 100000 bytes enviados, 100000 bytes distintos, el mayor de 1448 ACK de vuelta 56 sin datos, ventana máxima anunciada 7240 ventana cero 12 avisos, 6 sondas duración 5.655 s -
Puerto cerrado y puerto filtrado.
python3 scenarios.py ports. ¿Qué devuelveconnecten cada caso, y cuánto tarda? Hagan la tabla por su cuenta y comparen con la de este capítulo. Mirencaptures/filtered-a.pcap. -
ss -tin.python3 scenarios.py ss, y después por su cuenta: dejen correr una transferencia larga y consulten condocker exec clab-w10-tcp-a ss -tin. Ubiquenrtt,rtoycwnd, y comprueben sirto−rttda unos 200 ms. -
P3. Sigan con
rimayenprojects/p3-rimay-confiable. Lo de hoy les sirve para saber qué mirar en sus capturas. No se lleva hecho nada:rto_table.pyno es un emisor, y su protocolo va sobre UDP, con su propio formato. Cuando duden de su RTO, compárenlo con la fórmula del RFC 6298, no con lo que muestrass, porque ya vimos que Linux la cambia.
make test
cd code/week-10
make test
make test compila, levanta la topología, corre los escenarios y destruye todo al
final, incluso si algo falla. Tarda unos tres minutos, más si la computadora está ocupada. Lo que comprueba son las
afirmaciones de este capítulo, sobre capturas reales: que seq y ack cuentan bytes,
que SYN y FIN gastan un número, que 1448 = 1460 − 12, que el segmento descartado sale
dos veces en a y llega una en b, que el intervalo del RTO se duplica, que rto − rtt sigue a rto_min, que el emisor nunca pasa de la ventana, y varias más. Las
mediciones se revisan con márgenes amplios, porque dependen de la máquina.
La prueba de slow_reader se salta mientras lab/slow_reader.c tenga un TODO. Una
vez que lo completen, comprueba que los bytes lleguen completos, que el programa tarde
lo que debe, que SO_RCVBUF se haya puesto antes de listen y que aparezca la ventana
cero.
Resumen
- TCP es un stream de bytes confiable, ordenado, con conexión y full duplex. Numera bytes. El estado vive en los hosts.
- El MSS no incluye encabezados, cada extremo anuncia el suyo, y en Linux con timestamps los segmentos llevan 1448 bytes y no 1460.
seqes el primer byte que lleva el segmento,ackes el siguiente byte que se espera. SYN y FIN gastan un número. Wireshark muestra números relativos.- El ACK es acumulativo, y suele ir retardado: uno cada dos segmentos, o a los 40 ms aprox. en Linux, con tope de 0,5 s.
- RTO = EstimatedRTT + 4 × DevRTT, con α = 1/8 y β = 1/4, calculando DevRTT primero. Linux usa un piso de 200 ms sobre el RTT en lugar del mínimo de 1 s del RFC. Los segmentos retransmitidos no se miden, salvo con timestamps.
- Al vencer el RTO se retransmite lo más antiguo y se duplica el RTO.
- Fast retransmit actúa con tres ACK duplicados. Tres, porque el desorden también causa duplicados. SACK dice qué llegó exactamente, RACK decide por tiempo, y TLP hace probing cuando no hay quién avise.
- Las etiquetas de Wireshark son deducciones. Los contadores del kernel (
nstat) dicen la verdad. - El control de flujo protege al receptor. La ventana cero detiene al emisor, y las sondas evitan que la conexión se trabe. Throughput ≤ ventana / RTT.
- El control de flujo protege al receptor, y el de congestión, a la red. El emisor
respeta
min(rwnd, cwnd). - El handshake tiene tres pasos para descartar SYN viejos y confirmar los dos números iniciales, que no son predecibles.
- Puerto cerrado:
ECONNREFUSED, de inmediato. Filtrado:ETIMEDOUT, tras varios segundos. - Cada sentido se cierra por separado. Quien cierra primero se queda en
TIME_WAIT(60 s en Linux), para repetir el último ACK y dejar que mueran los segmentos viejos. - Un SYN flood llena la cola de SYN. Las SYN cookies guardan el estado en el número de secuencia.
Ejercicios
- Un segmento lleva
seq=1000y 500 bytes. ¿Qué ACK espera el emisor? Si antes se perdió el segmento que empieza en 500 y este llegó bien, ¿qué ACK manda el receptor? ¿Y con SACK, qué agrega? - Con EstimatedRTT = 100 ms y DevRTT = 5 ms, llegan tres muestras seguidas de 100 ms.
Calculen a mano los valores y el RTO después de cada una. ¿A qué valor tiende el RTO
si todas las muestras son iguales? Comprueben con
rto_table.py --start. ¿Por qué un RTO calculado así es peligroso sin un piso? - Una captura muestra un SYN con
Seq=0, un SYN-ACK conSeq=0, Ack=1y un ACK conSeq=1, Ack=1. Un compañero dice que TCP siempre empieza en cero, y que eso es inseguro. ¿Qué le responden? ¿Qué harían para comprobarlo en esa misma captura? - Un host con MTU de 9000 abre una conexión con otro de MTU de 1500. ¿Qué MSS anuncia
cada uno, sin timestamps? ¿De qué tamaño serán los datos en cada sentido? ¿Cambia con
timestamps? Comprueben su razonamiento en la red, con
ip link sety el escenariomsscomo guía. - Con
drop, cambien el número de paquete descartado (de 40 a 1000, por ejemplo). Antes de correrlo, predigan si habrá más o menos ACK duplicados y por qué. Comprueben contcpsum.py. - Modifiquen el escenario
tailpara que descarte solo el último segmento de datos (posición 6) y no el FIN. Predigan qué señal le llega aaantes de la sonda, y qué se va a retransmitir. Comprueben conTcpExtTCPLossProbes. - Se transfiere sobre un enlace de 1 Gbit/s con 100 ms de RTT, y el receptor anuncia una ventana de 64 KB sin escala. ¿Cuál es el throughput máximo? ¿Qué ventana se necesita para llenar el enlace? ¿Cuál es la menor escala de ventana que permite anunciarla? En una captura, ¿cómo distinguirían este caso de un enlace saturado?
- Con
slow_reader, varíenbytes_por_lecturaypausa_ms(cambien el escenarioslow). Predigan el throughput a partir de esos dos valores y comprueben. ¿De qué depende que aparezca la ventana cero? ¿Con qué valores desaparece? - Dibujen un diagrama de tiempo de un cierre de cuatro segmentos en que se pierde el
primer FIN, y otro en que se pierde el segundo. ¿Quién retransmite en cada caso?
¿Quién termina en
TIME_WAIT? Luego modifiquen la regla detimewaitpara descartar el FIN dea(posición 2) y comparen con su diagrama. - Un servidor web muestra miles de conexiones en
TIME_WAIT, y un compañero propone bajar ese tiempo a 1 s. ¿Qué podría fallar? ¿Por qué aparecen en el servidor y no en los clientes? ¿Qué cambio en quién cierra primero las movería de lugar? - El router
mhacereject with tcp reseten vez dereject with icmp. Predigan qué devuelveconnect. ¿Se puede distinguir, desde el cliente, entre este caso y un puerto cerrado? ¿Y si miran el TTL en la captura? Compruébenlo. - (Desafío) Las SYN cookies guardan el estado en los pocos bits del número de secuencia. ¿Qué le puede faltar a una conexión establecida así, si el SYN pidió opciones como la escala de ventana? Lean la sección 3.6 del RFC 4987 y discutan por qué las cookies se activan solo cuando la cola se llena.