
Apuntes · Capítulo 11Transporte y aplicaciones
Control de congestión
Control de congestión
La semana pasada vimos que TCP entrega bien: ACK, retransmisiones, ventana de recepción. Con eso, un emisor nunca desborda a su receptor. Pero nada de lo que hemos visto le dice cuánto puede enviar sin desbordar a la red. Si muchos emisores llenan el mismo enlace, los routers acumulan colas, botan paquetes, y los emisores responden retransmitiendo. Es decir: envían más justo cuando la red pide menos. En octubre de 1986 esto dejó un enlace de 32 kbit/s funcionando a 40 bit/s. La solución fue un cambio de pocas líneas en TCP, que sigue siendo la base de lo que corre hoy.
En la Sesión A definimos la congestión y lo que cuesta, y construimos el algoritmo clásico: la ventana de congestión, slow start, congestion avoidance y fast recovery. Hacemos la cuenta en papel, RTT por RTT, y luego miramos la misma curva en un kernel de verdad, con las diferencias que tiene frente al libro. Cerramos con el argumento de Chiu y Jain: por qué se suma al subir y se multiplica al bajar.
En la Sesión B vemos los límites de ese diseño. La fórmula del throughput explica por qué Reno sufre en enlaces rápidos y largos, y motiva a CUBIC. El bufferbloat muestra lo malo de usar la pérdida como única señal, y de ahí salen BBR y ECN. Terminamos con la equidad: entre flujos con distinto RTT, y entre quien abre una conexión y quien abre cuatro.
Todo lo que se mide en este capítulo sale de una topología de Containerlab que
ustedes pueden levantar. El kernel del contenedor trae reno y cubic, así
que esos dos son los que medimos. BBR lo estudiamos, pero no lo medimos. Las
cifras dependen de cada computadora, y las nuestras se tomaron mientras la
máquina hacía otras cosas: comparen tendencias, no valores exactos.
Ruta de lectura.
Antes de clase (obligatorio, unos 15 a 20 minutos). Sesión A: la introducción de Qué es la congestión con Lo que cuesta, La ventana de congestión, Slow start, Congestion avoidance, Timeout y Tres ACK duplicados: fast recovery. Sesión B: la introducción de La fórmula del throughput y, de CUBIC, La curva.
En clase. Sesión A: Ejemplo resuelto:
cwndpor RTT, La misma curva, en un kernel de verdad y Por qué AIMD. Sesión B: ¿Funciona?, Por qué Reno sufre en enlaces rápidos y largos, El tiempo manda, no el RTT, La curva, en la traza real, Bufferbloat, BBR, ECN: la red avisa sin botar y Equidad.Después de clase. Repasen con el Resumen y los Ejercicios, y preparen El laboratorio de la semana y
make test. Opcional: Octubre de 1986, Lo que el libro simplifica, La región amigable con Reno, Cuándo marca el router: RED y Varias conexiones paralelas. Para profundizar, las lecturas del libro y las gratuitas de la semana:Este capítulo acompaña a Kurose y Ross, Computer Networking: A Top-Down Approach (9.ª ed.). Para la Sesión A, las secciones 3.6 Principles of Congestion Control y 3.7.1 Classic End-End TCP Congestion Control, y los capítulos de CS168 Congestion Control Principles, Congestion Control Design y Congestion Control Implementation. Complementaria: RFC 5681. Para la Sesión B, las secciones 3.7.2 More Recent End-End TCP Congestion Control Algorithms, 3.7.3 Network-Assisted Explicit Congestion Notification y 3.7.4 Fairness, y los capítulos de CS168 TCP Throughput Model, Congestion Control Issues y Router-Assisted Congestion Control. Complementarias: RFC 9438, CUBIC, y RFC 3168, ECN. El código de la semana está en
code/week-11/.
Qué es la congestión
Definición. Hay congestión en un enlace cuando, durante un tiempo sostenido, le llega más tráfico del que puede transmitir. La diferencia se acumula en el buffer del router que alimenta ese enlace y, si el buffer se llena, se pierde.
Dos palabras de esa definición importan. Sostenido, porque una ráfaga corta la absorbe el buffer y para eso está: la semana 1 vimos que la conmutación de paquetes vive de eso. Y enlace, porque la congestión pasa en un punto preciso de la red, el cuello de botella (bottleneck): el enlace del camino que primero se queda corto.
Fíjense en la diferencia con lo de la semana pasada:
| Control de flujo | Control de congestión | |
|---|---|---|
| Protege a | El receptor | La red |
| Quién dice el límite | El receptor, en un campo del header | Nadie: el emisor lo estima |
| Variable | rwnd |
cwnd |
| Si no existiera | Se desborda un buffer en un host | Se desborda una cola en un router, y sufren todos los que la cruzan |
El control de flujo es fácil porque el receptor sabe cuánto espacio tiene. El de congestión es difícil porque nadie sabe cuánto ancho de banda está disponible: el emisor no conoce el camino, ni la capacidad de cada enlace, ni cuánta gente más lo está usando. Ni siquiera los routers conocen esto más allá de su propia cola. CS168 lo plantea como un problema de asignación de recursos sin nadie que lo dirija: millones de emisores deciden cada uno por su cuenta, y la decisión de cada uno afecta a todos los demás.
Lo que cuesta
Hagamos la cuenta con un enlace concreto: 10 Mbit/s, con un buffer de 1,5 MB, al que le llegan 12 Mbit/s de forma sostenida.
Primer costo: retardo. El buffer crece a 2 Mbit/s, es decir, 0,25 MB por
segundo. En 6 segundos se llena. Un paquete que llega en ese momento tiene 1,5
MB delante, que a 10 Mbit/s tardan 1,5 × 8 / 10 = 1,2 s. Ningún bit se
perdió todavía, y ya cualquier aplicación interactiva que pase por aquí está
muerta. Fíjense en que el retardo no empieza cuando se llega a la capacidad:
si los paquetes llegan a ráfagas, ya hay colas por debajo de ella.
Segundo costo: pérdida y trabajo inútil. Con el buffer lleno, de cada 12 Mbit/s que llegan solo salen 10. Se bota uno de cada seis paquetes. Lo que recorrió el camino hasta aquí gastó capacidad en todos los enlaces anteriores para nada. Ese gasto lo paga otra gente: esos enlaces también tienen otros usuarios.
Tercer costo: retransmisiones que no eran necesarias. Si la cola tarda 1,2 s y el temporizador del emisor estaba en 500 ms, el emisor cree que el paquete se perdió y lo envía otra vez. El original seguía en la cola. Ahora el enlace transmite dos copias del mismo dato, y el receptor bota una.
Cuarto costo: el colapso. Junten todo. Mientras más congestionada está la red, más retransmisiones hay. Mientras más retransmisiones, más congestión. El enlace sigue transmitiendo a 10 Mbit/s, pero lo que transmite son copias. Eso es un colapso por congestión (congestion collapse): el throughput total del enlace sigue alto, pero el goodput, lo que de verdad le llega a las aplicaciones, cae casi a cero, y al aumentar la carga cae todavía más.
 goodput
    ^
 C  |            ______  ideal: sube hasta la capacidad y se queda ahí
    |          /
    |        /  . - .
    |      /  .       .     con control de congestión, cerca de la línea
    |    /  .           .
    |  /  .               .
    |/ .                     . .   . . .   sin control: colapso
    +---------------------------------------> carga ofrecida
Octubre de 1986
Este no es un escenario teórico. A mediados de los 80, TCP tenía control de flujo y retransmisiones, pero no control de congestión: el emisor enviaba toda la ventana que anunciaba el receptor, y reenviaba lo perdido a la misma velocidad. En octubre de 1986 empezó una serie de colapsos. El caso famoso es un enlace entre UC Berkeley y Lawrence Berkeley Lab, dos sitios a menos de 400 metros de distancia, cuyo throughput cayó de 32 kbit/s a 40 bit/s: 800 veces menos.
Van Jacobson y Michael Karels, que trabajaban en el código de red de Berkeley Unix, vieron que la red estaba llena de copias del mismo paquete y cambiaron TCP para que el emisor ajustara su ventana según las pérdidas. No hubo que cambiar los routers ni las aplicaciones. Es el mismo principio que usamos hoy.
Idea clave. La congestión es un problema de realimentación. Sin control, la reacción natural de un protocolo confiable a la pérdida (retransmitir) empeora la causa de la pérdida. El control de congestión invierte eso: ante una pérdida, el emisor retransmite y además baja su velocidad.
Quién se encarga: los extremos o la red
Hay dos grandes familias:
- End-to-end. La red no dice nada. El emisor deduce la congestión de lo que observa: pérdidas y retardo. Es lo que hizo TCP en 1986, y es coherente con IP, que no promete nada.
- Con ayuda de la red (network-assisted). Los routers informan: con un bit en el header (ECN, en la Sesión B) o hasta con la velocidad exacta que le toca a cada emisor.
Se suele decir que TCP “no recibe información de la red”, y es casi verdad: una cola llena es una señal, solo que implícita y tardía. CS168 lo dice con precisión: en los dos casos los routers avisan, solo que en uno lo hacen explícitamente y en el otro el emisor lo deduce.
La ventana de congestión
El emisor agrega una variable: cwnd, la ventana de congestión
(congestion window). Su regla es una sola línea:
bytes en vuelo <= min(cwnd, rwnd)rwnd sigue siendo el control de flujo de la semana pasada. En este capítulo
suponemos que el receptor lee rápido, así que rwnd es grande y manda cwnd.
Es la misma ventana deslizante de la semana 9, con un tamaño que cambia.
Por qué una ventana controla una velocidad
Un emisor con ventana W envía W bytes, espera un RTT a que vuelvan los
ACK, y envía W más. En promedio:
throughput ≈ cwnd / RTTHay un mecanismo elegante detrás. Cada ACK que vuelve avisa que un paquete salió de la red, y eso le da permiso al emisor de poner otro. Por eso se dice que TCP tiene auto-reloj (self-clocking): no necesita saber la velocidad del cuello de botella, porque los ACK vuelven al ritmo que ese enlace los deja pasar.
Ejemplo con el enlace que vamos a usar en el laboratorio: cwnd de 100
paquetes de 1500 bytes y RTT de 40 ms da 100 × 1500 × 8 / 0,040 = 30 Mbit/s.
Para llenar 50 Mbit/s hace falta lo que llamamos el producto ancho de banda
por retardo (BDP, bandwidth-delay product):
BDP = rate × RTT = 50 Mbit/s × 0,040 s = 2 Mbit = 250 000 bytes ≈ 167 paquetes de 1500 bytesEs lo que “cabe” en el camino: los bits que están en vuelo cuando el enlace
está lleno y no hay cola. Lo vimos en la semana 9 con las ventanas de
Go-Back-N. Si cwnd vale menos que el BDP, se desperdicia enlace. Si vale
más, lo que sobra no va más rápido: se queda haciendo cola. Vale la pena fijar
esta idea, porque explica casi todo lo que sigue:
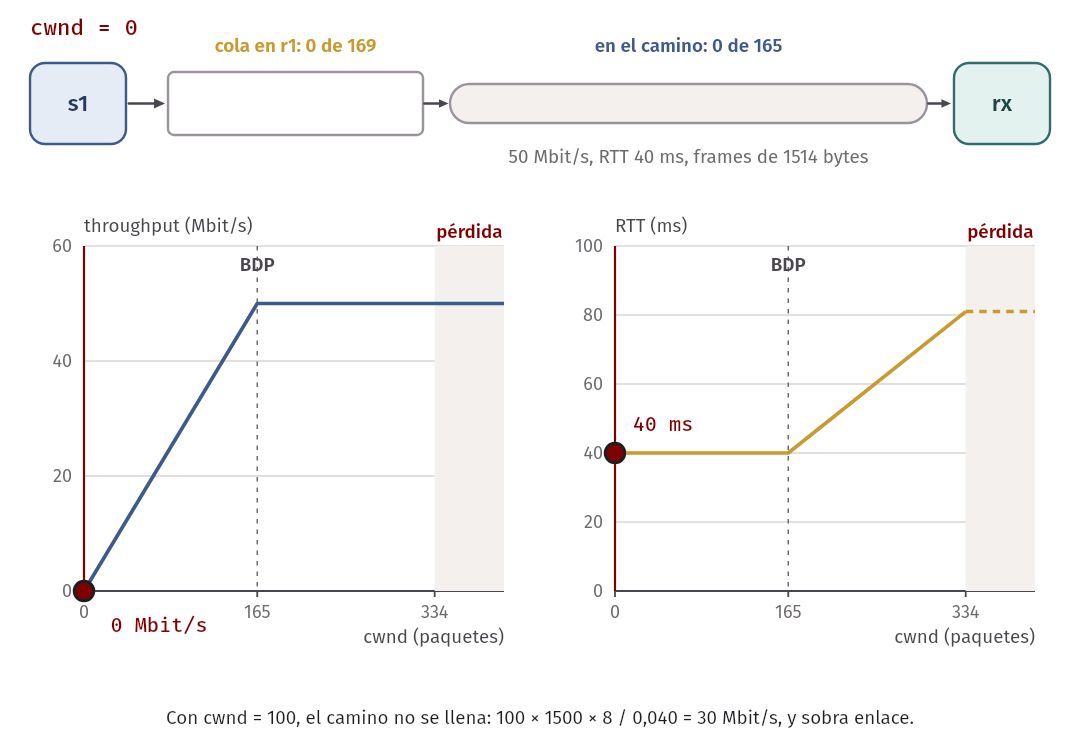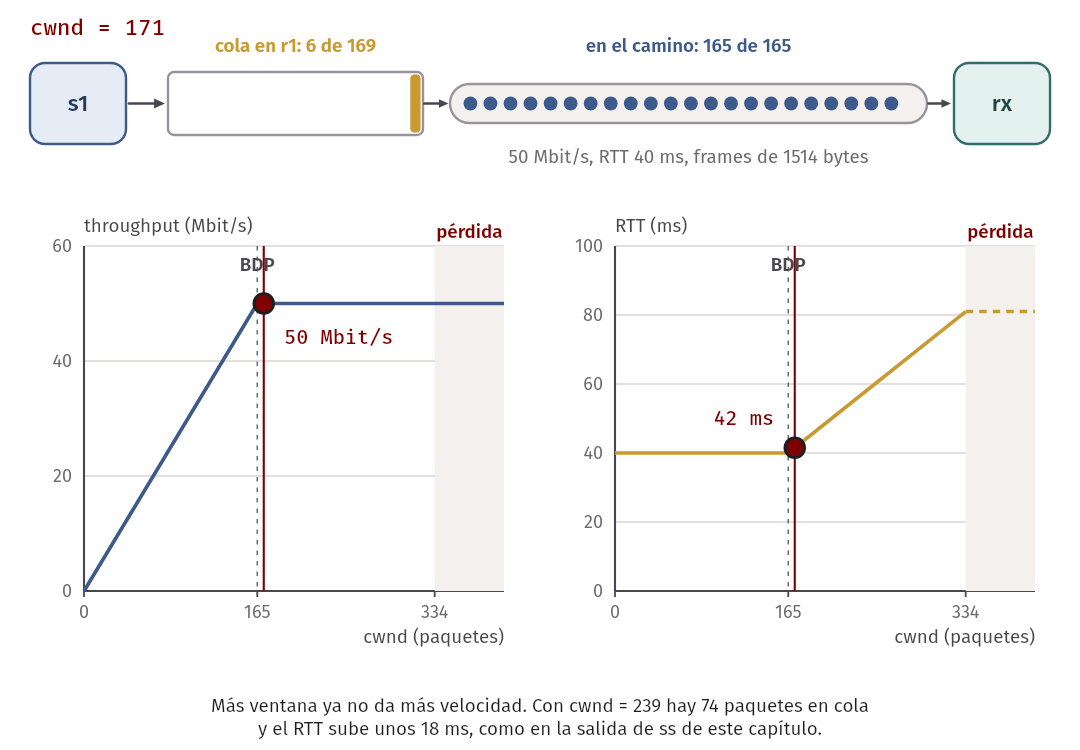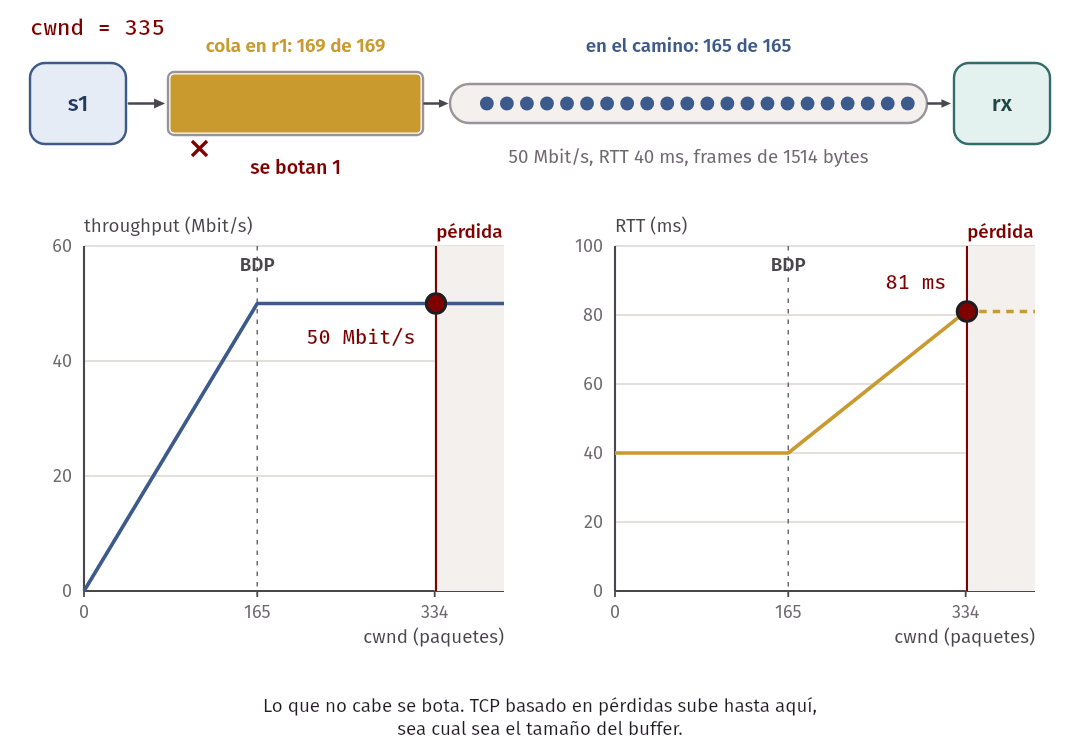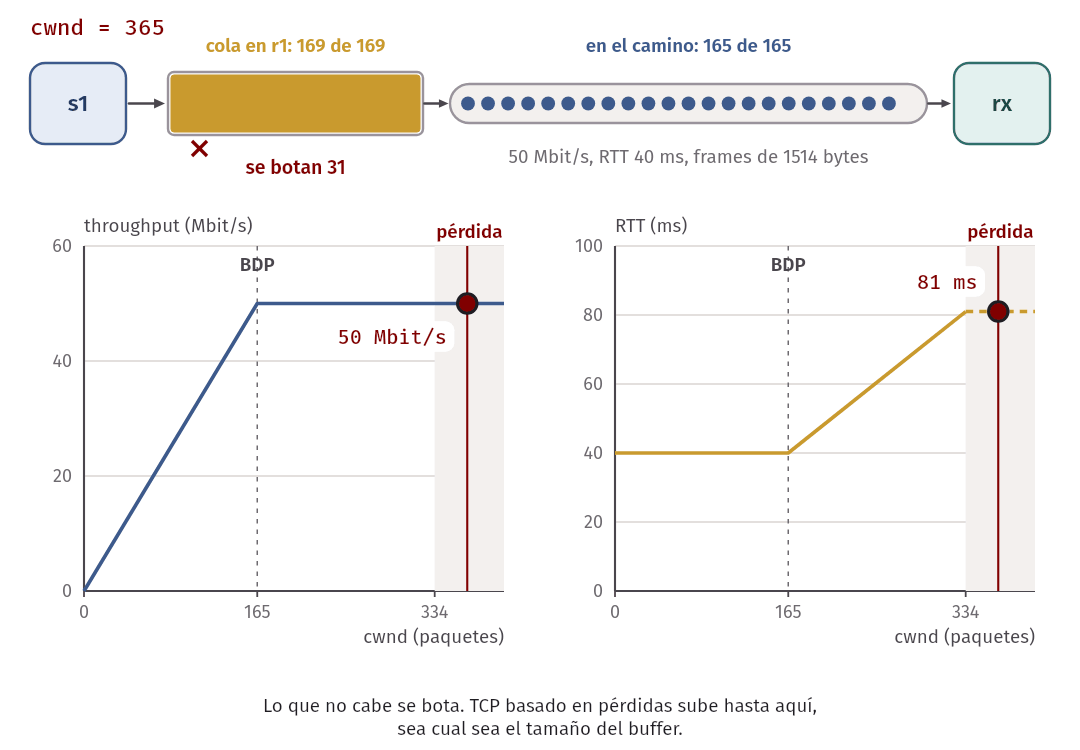
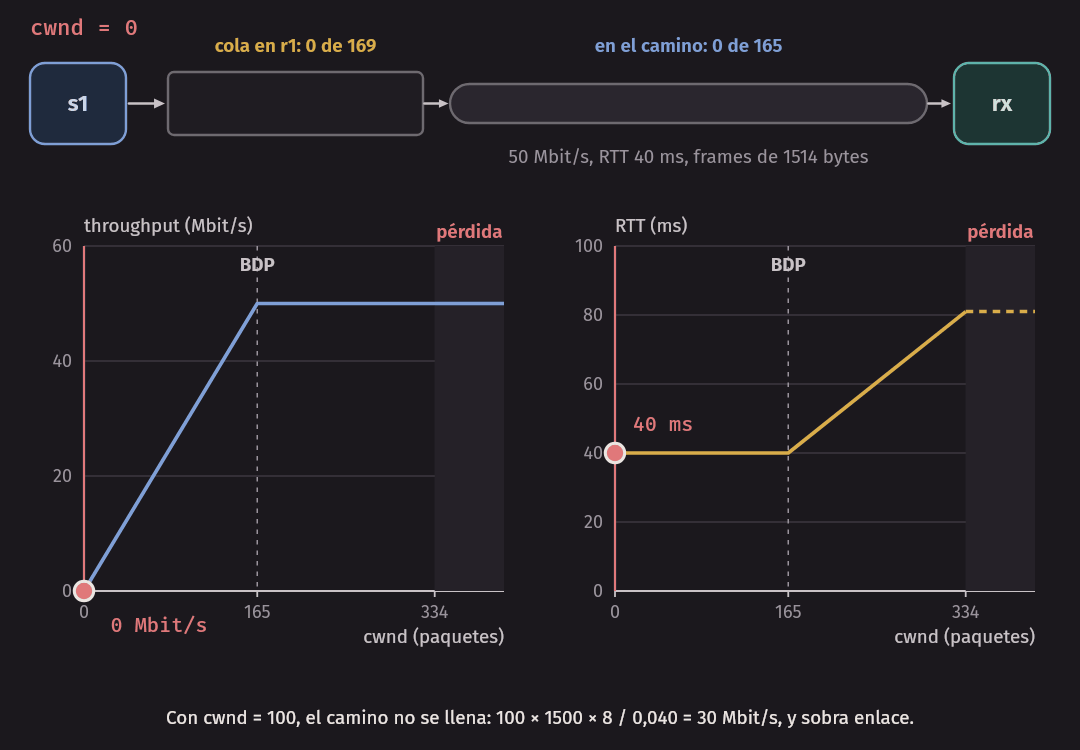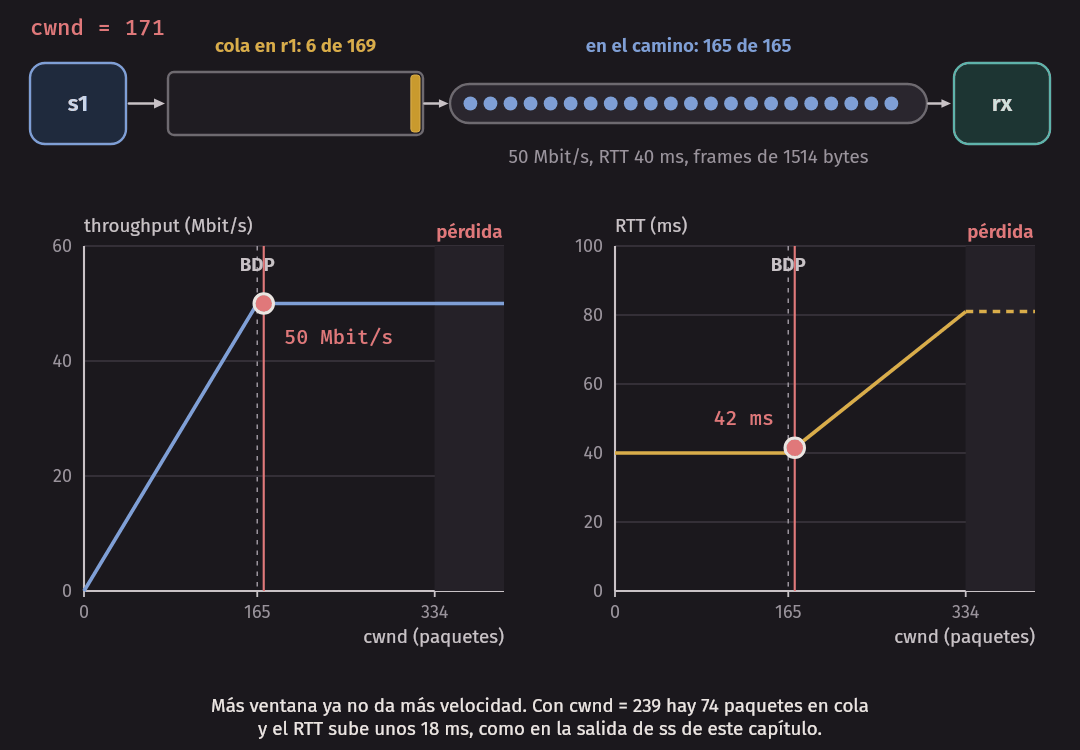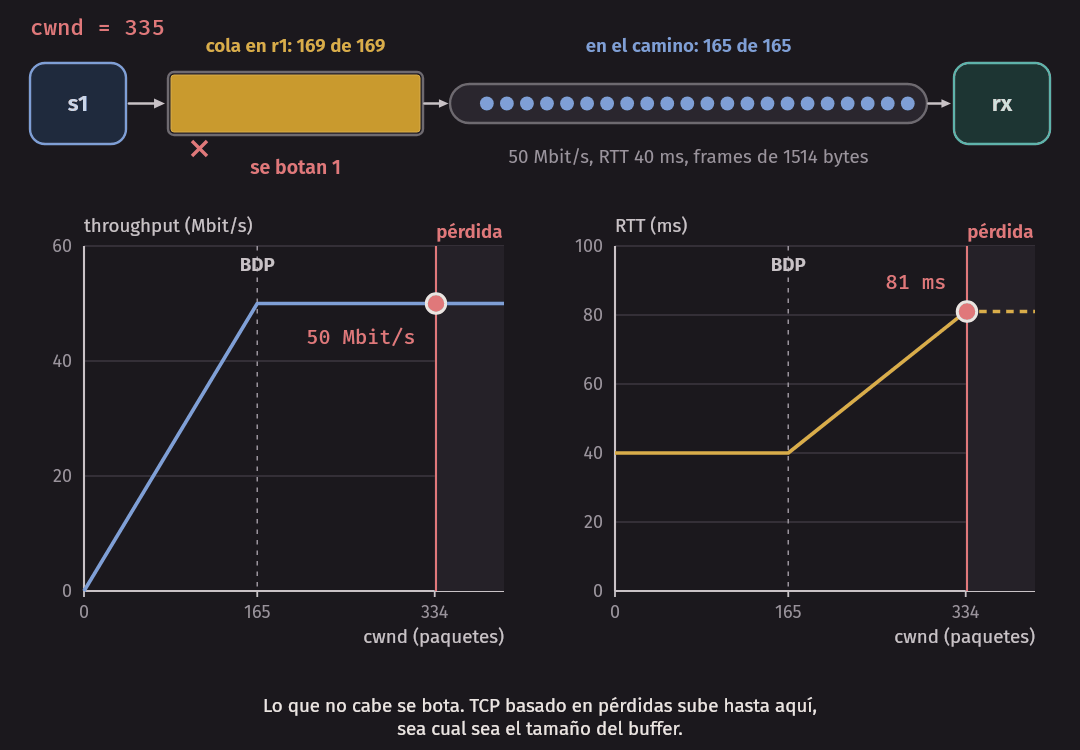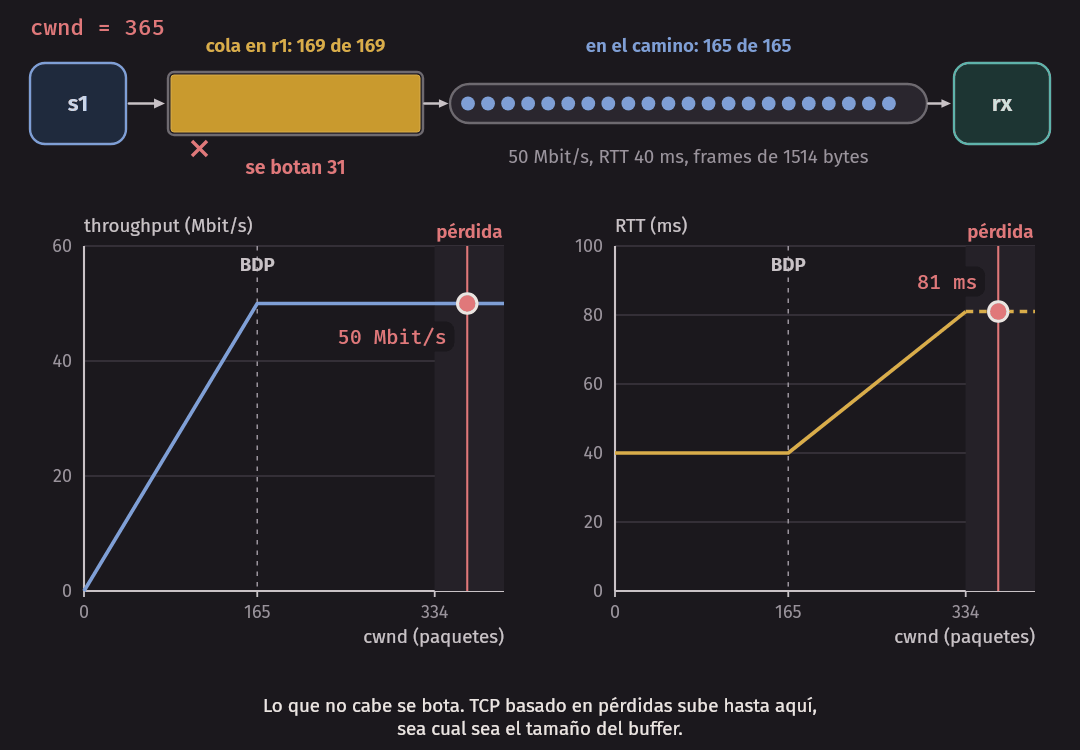
Y cuando la ventana rebasa BDP + buffer, ya no cabe y hay pérdida.
Error común. Creer que una ventana más grande siempre da más throughput. Solo sirve hasta llegar al BDP. Después, cada paquete de más agrega retardo, no velocidad: el throughput sigue en
rate, pero el RTT sube.cwnd / RTTno se rompe, porque los dos crecen en la misma proporción.
Cómo se entera el emisor
TCP clásico tiene dos señales de pérdida, de la semana pasada:
| Señal | Qué sugiere | Reacción |
|---|---|---|
| Tres ACK duplicados | Se perdió uno, pero siguen llegando otros: la red todavía funciona | Fuerte |
| Timeout | No llega nada: puede estar muy mal | Muy fuerte |
Con esto, el algoritmo tiene tres partes: cómo arrancar, cómo avanzar sin
pérdidas, y cómo reaccionar a una pérdida. A eso se le suma la variable
ssthresh, el umbral que separa las dos primeras partes.
Slow start
Al abrir una conexión, el emisor no tiene idea de la capacidad. Puede ser 1 Mbit/s o 100 Gbit/s. Si sube de a poco, tarda muchísimo en descubrir un enlace rápido: sumando un paquete por RTT a 40 ms, llegar a 167 paquetes toma casi 7 segundos, y la mayoría de las conexiones terminan mucho antes. Si empieza de golpe con mucho, ahoga un enlace lento.
Slow start resuelve eso creciendo de forma exponencial desde un valor chico:
Por cada ACK que confirma datos nuevos,
cwndaumenta en un MSS.
Parece aditivo. Sin embargo, si cwnd vale 4, en ese RTT vuelven 4 ACK y
cwnd sube a 8. Se duplica en cada RTT:
 emisor                  receptor        cwnd
   |-------- 1 -------------->|            1
   |<------- ack ------------ |
   |-------- 2 -------------->|            2
   |-------- 3 -------------->|
   |<------- ack ------------ |
   |<------- ack ------------ |
   |-------- 4,5,6,7 -------->|            4
   |<------- 4 ack ---------- |
   |-------- 8 paquetes ----->|            8
Termina en una de estas situaciones: cwnd llega a ssthresh y se pasa a
congestion avoidance; se pierde un paquete; o rwnd lo limita. La primera
vez, ssthresh es muy grande en la práctica, así que lo normal es que la
primera pérdida sea lo que lo termine.
Error común. Creer que slow start es lento. Es la fase más rápida de TCP: crece de forma exponencial. Se llama así en comparación con lo que hacía TCP antes de 1986, que era empezar enviando de una vez toda la ventana anunciada por el receptor.
¿Con cuánto se empieza? El RFC 5681 fija una ventana inicial de hasta 4 segmentos, y en la práctica Linux usa 10. Se aumentó porque, como dice CS168, la mayoría de las conexiones son cortas, y con una ventana inicial de 10 muchas terminan sin haber tenido que esperar un RTT extra. En el libro y en los ejemplos de papel se usa 1, porque así se ven mejor las cuentas.
Congestion avoidance
Cuando cwnd llega a ssthresh, el emisor ya está cerca de lo que costó
problemas la última vez, y deja de doblar. En congestion avoidance:
cwndaumenta en un MSS por RTT.
La forma usual de implementarlo sin cronómetro es por cada ACK: cwnd += MSS × MSS / cwnd. Como vuelven unos cwnd / MSS ACK por RTT, en total sube un MSS.
El RFC 5681 da esa fórmula y también permite contar bytes confirmados.
Sigue creciendo hasta encontrar una pérdida, y esto no es un descuido: es el diseño. TCP clásico no tiene otra forma de descubrir que hay más capacidad disponible, así que provoca la pérdida a propósito, una y otra vez. Eso nos va a dar problemas en la Sesión B.
Reacción a la pérdida
Tanto ssthresh como cwnd cambian. La regla depende de la señal.
Timeout
Según la ecuación (4) del RFC 5681, cuando la pérdida se detecta con el temporizador:
ssthresh = max(FlightSize / 2, 2 × MSS)
cwnd     = 1 MSS
FlightSize son los bytes en vuelo; como normalmente FlightSize = cwnd, se
suele decir “la mitad de cwnd”. Después se retransmite y se entra otra vez a
slow start, que llega rápido hasta el nuevo ssthresh y luego avanza en
congestion avoidance. Es la reacción dura: si no vuelve nada, el auto-reloj se
detuvo, y hay que volver a armarlo desde cero.
Tres ACK duplicados: fast recovery
Si llegan ACK duplicados, la red sigue entregando: cada uno es un paquete que salió. No tiene sentido volver a 1. El RFC 5681 hace esto:
- Al tercer ACK duplicado:
ssthresh = max(FlightSize / 2, 2 × MSS). - Retransmite el paquete perdido (fast retransmit, de la semana pasada) y
pone
cwnd = ssthresh + 3 MSS. Esos 3 son los paquetes que ya salieron de la red, puesto que generaron los ACK duplicados. - Por cada ACK duplicado adicional,
cwnd += 1 MSS: otro paquete salió, se puede enviar uno nuevo. A esto el RFC le llama “inflar” la ventana. - Cuando llega el ACK que confirma datos nuevos,
cwnd = ssthresh: se “desinfla” la ventana, y se sigue en congestion avoidance.
Mirado en la escala de RTT, el efecto es uno solo: cwnd queda en la mitad
y sigue creciendo de a uno, sin pasar por slow start. Por eso en los
gráficos y en las cuentas en papel solo se dibuja ese resultado.
Un poco de historia. La variante sin fast recovery se llama Tahoe: ante cualquier pérdida, vuelve a 1. Reno agregó fast recovery. Hoy, cuando se dice “Reno”, se habla de esta familia, con la mejora de seguir en recovery cuando se pierde más de un paquete por ventana (NewReno) y con SACK, de la semana pasada.
                    ACK nuevo: cwnd += MSS
                       ┌────────┐
                       ▼        │     cwnd >= ssthresh
              ┌──────────────┐  │    ┌───────────────┐
  inicio ───► │  slow start  ├──┴───►│  congestion   │◄─┐ ACK nuevo:
              └──┬────────▲──┘       │  avoidance    │──┘ cwnd += MSS×MSS/cwnd
                 │        │          └───┬───────▲───┘
         3 ACK   │        │ timeout      │ 3 ACK │ ACK nuevo:
         dup.    │        │              │ dup.  │ cwnd = ssthresh
                 ▼        │              ▼       │
              ┌───────────┴───────────────────────┐
              │          fast recovery            │◄─┐ ACK dup.:
              │  ssthresh = cwnd/2                │──┘ cwnd += MSS
              │  cwnd = ssthresh + 3 MSS          │
              └───────────────────────────────────┘
       Un timeout en cualquier estado: ssthresh = cwnd/2, cwnd = 1, a slow start.
Idea clave. Una pérdida sola no le dice al emisor qué tan mal está la red. Pero la forma en que la detecta, sí: los ACK duplicados dicen “todavía pasa tráfico” y el timeout dice “no sé nada”. Por eso la reacción es tan distinta.
Ejemplo resuelto: cwnd por RTT
Sigamos una conexión con ventana inicial de 1, ssthresh = 16, tres ACK
duplicados en el RTT 10 y un timeout en el RTT 19. Primero háganlo en papel:
es lo que se pregunta en los exámenes. Luego compárenlo con reno_trace.py,
que aplica las mismas reglas por RTT. Es un modelo para hacer la cuenta y nada
más: no tiene ACK ni temporizadores.
$ python3 reno_trace.py --ssthresh 16 --rounds 26 --dup-at-round 10 --timeout-at-round 19
RTT  cwnd ssthresh  fase                  evento
  1     1       16  slow start
  2     2       16  slow start
  3     4       16  slow start
  4     8       16  slow start
  5    16       16  congestion avoidance
  6    17       16  congestion avoidance
  7    18       16  congestion avoidance
  8    19       16  congestion avoidance
  9    20       16  congestion avoidance
 10    21       16  congestion avoidance  3 ACK dup.
 11    10       10  congestion avoidance
 12    11       10  congestion avoidance
 13    12       10  congestion avoidance
 14    13       10  congestion avoidance
 15    14       10  congestion avoidance
 16    15       10  congestion avoidance
 17    16       10  congestion avoidance
 18    17       10  congestion avoidance
 19    18       10  congestion avoidance  timeout
 20     1        9  slow start
 21     2        9  slow start
 22     4        9  slow start
 23     8        9  slow start
 24     9        9  congestion avoidance
 25    10        9  congestion avoidance
 26    11        9  congestion avoidance
Lean las transiciones:
- RTT 1 a 5. Se duplica: 1, 2, 4, 8, 16. Al llegar a
ssthresh = 16pasa a congestion avoidance. - RTT 5 a 10. Suma 1 por RTT, hasta 21.
- RTT 10. Tres ACK duplicados:
ssthresh = 21 // 2 = 10. Durante la recuperacióncwndvale10 + 3 = 13, y crece con cada ACK duplicado; cuando llega el ACK nuevo baja a 10. El modelo muestra lo que queda al final, sin pasar por slow start. - RTT 19. Timeout con
cwnd = 18:ssthresh = 9, ycwnd = 1. Slow start hasta 8, y en el siguiente RTT el crecimiento se corta en 9, porque el doble se pasaría del umbral.
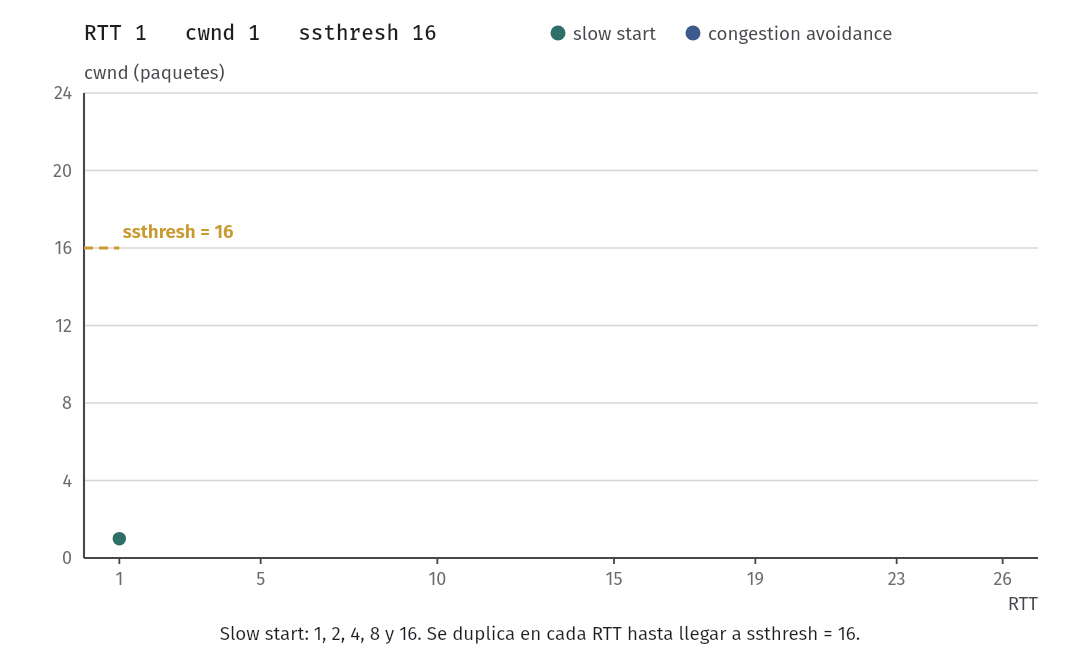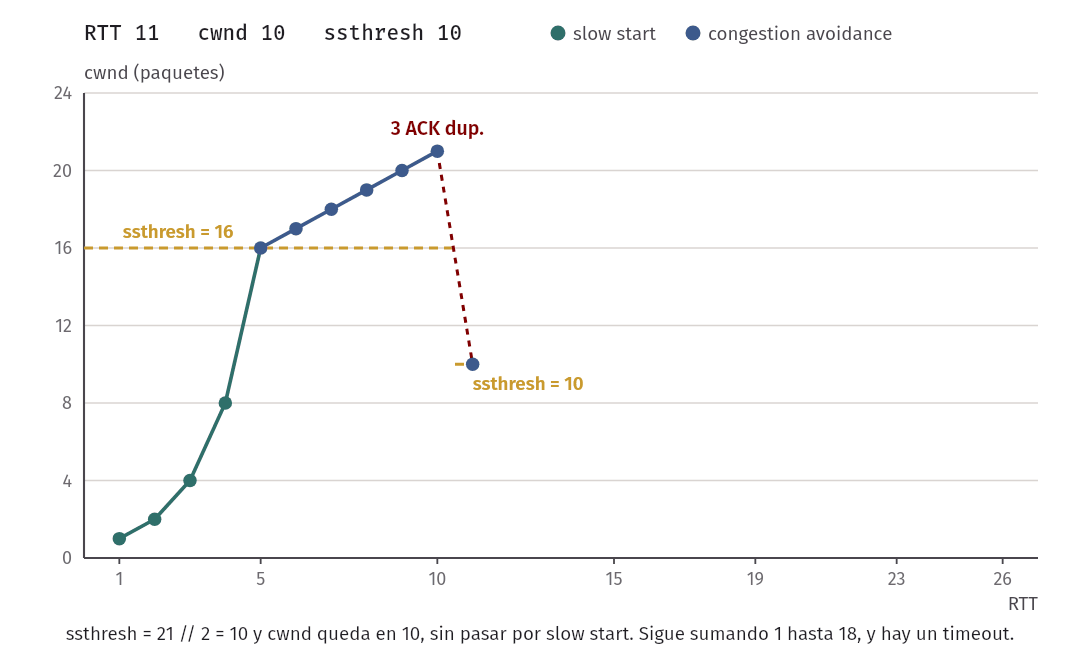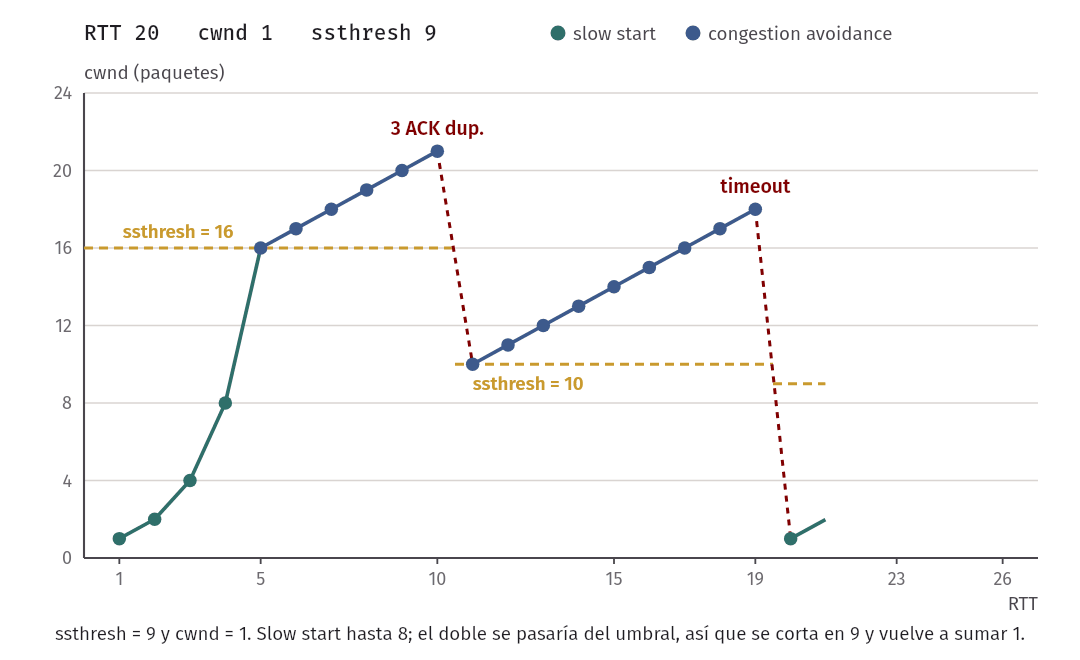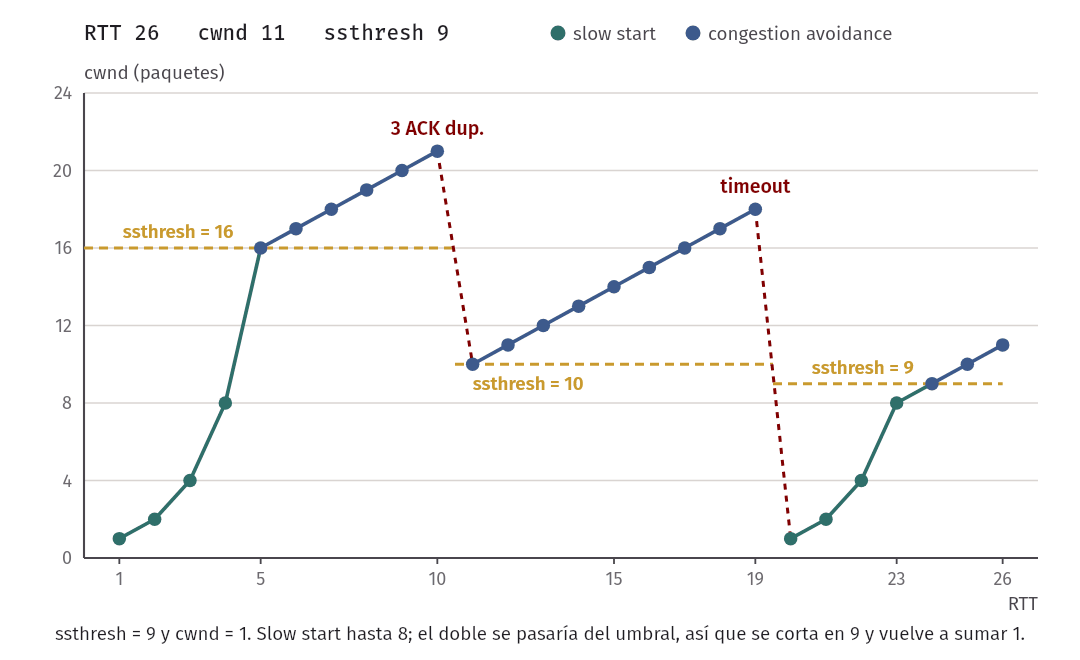
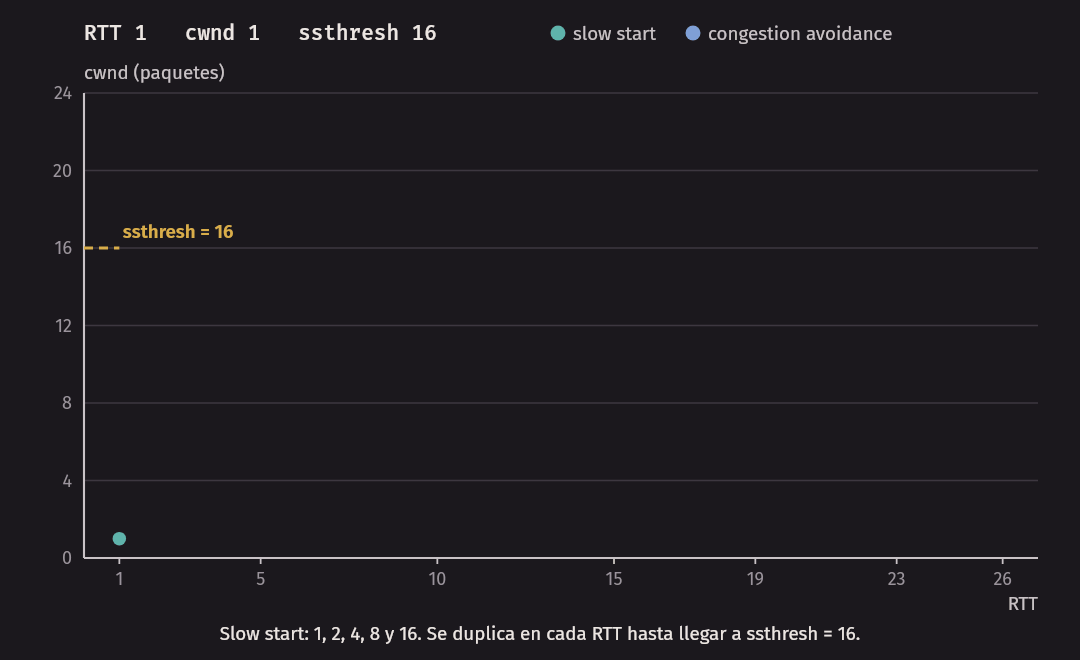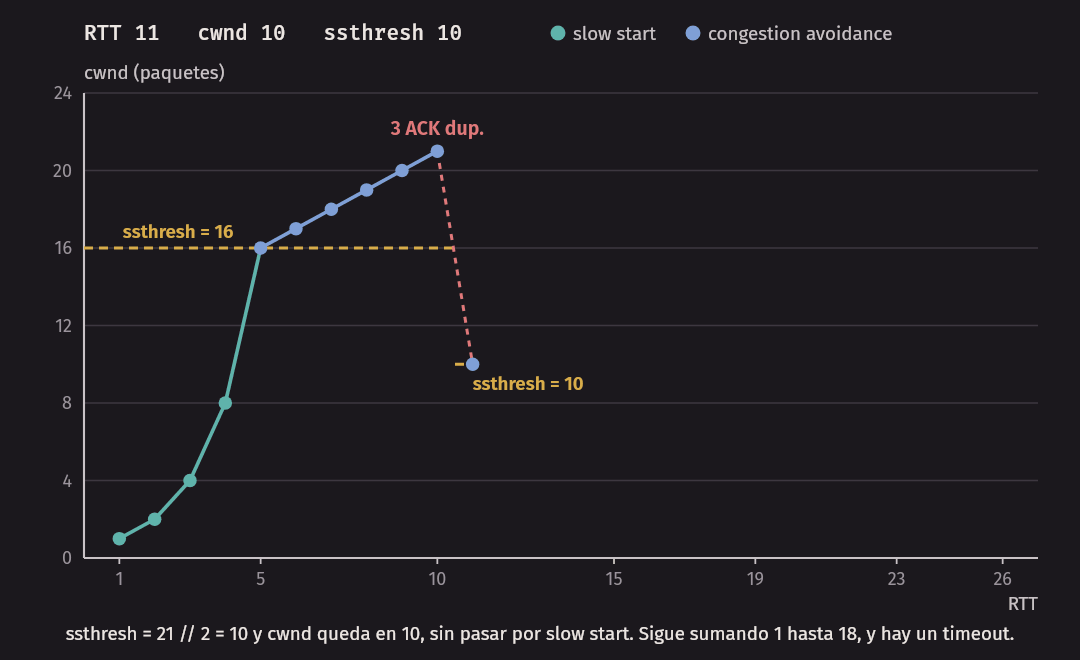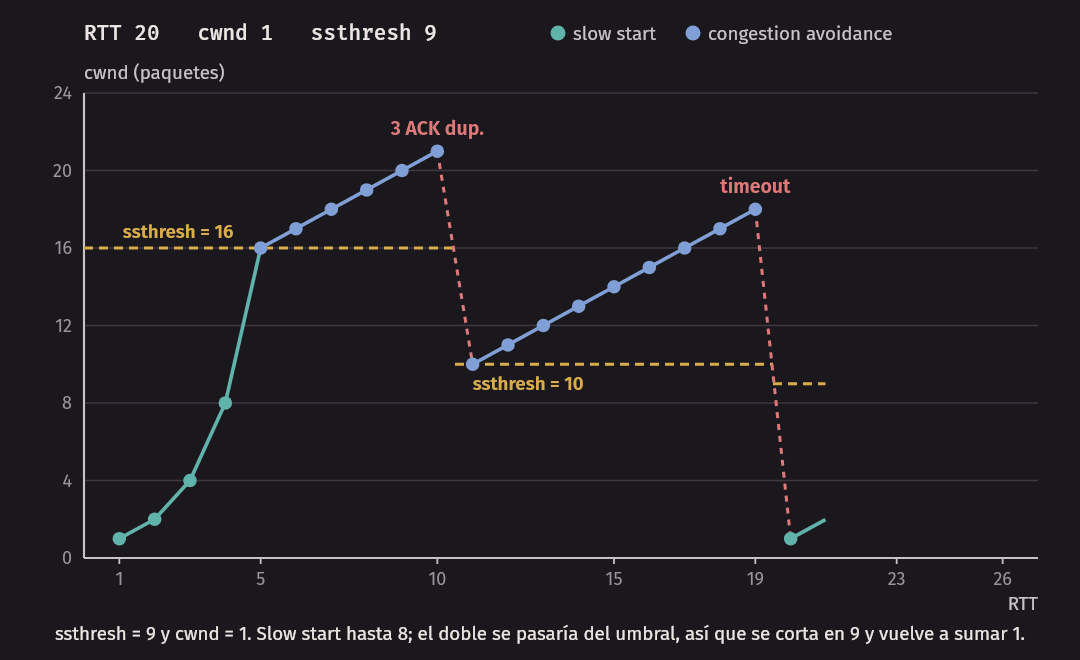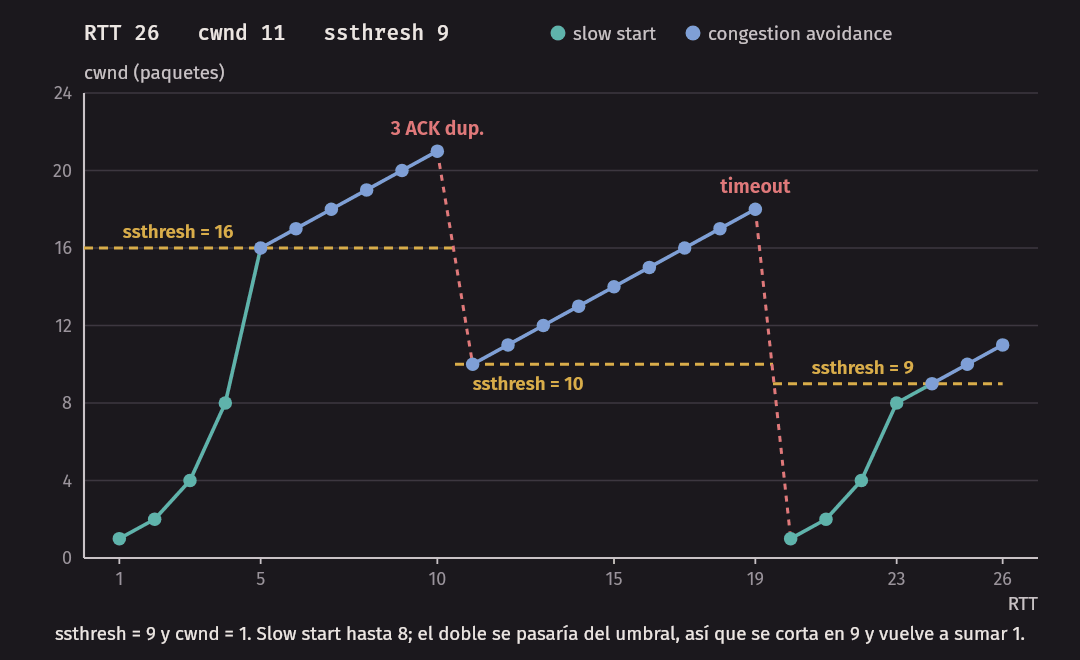
La regla simple que usa este modelo para el corte es cwnd = min(2 × cwnd, ssthresh). En una pila real el corte ocurre a mitad de un RTT: los primeros
ACK terminan slow start y los demás ya suman poco.
En la práctica. La pregunta de repaso de la guía pide lo mismo con
ssthresh = 8y tres ACK duplicados encwnd = 12: deberían obtener 1, 2, 4, 8, 9, 10, 11, 12 y luegossthresh = 6,cwnd = 6, 7, 8… Compruébenlo conpython3 reno_trace.py --ssthresh 8 --rounds 12 --dup-at-cwnd 12.
La misma curva, en un kernel de verdad
Hasta aquí, el libro. Ahora miremos una conexión real en la topología de la semana:
s1 ---\
       r1 ===== cuello de botella ===== r2 ---- rx
s2 ---/       50 Mbit/s, con una cola      40 ms
Dos emisores, s1 y s2, un cuello de botella en la salida de r1 hacia
r2, y el receptor rx. Tres detalles de cómo se arma esto con tc, que
importan para leer los resultados:
- El cuello y la cola están en
r1: untbflimita a 50 Mbit/s y tiene un buffer de 250 KiB. Es decir, tanto como el BDP. Es el tamaño de la cola, no un detalle: en la Sesión B lo vamos a cambiar. - El retardo y la pérdida están en
r2, en otra máquina y connetem, separados del cuello. Una pérdida denetemes aleatoria, no por congestión. Eso es a propósito. - El retardo de 40 ms va solo en el sentido de los datos. Los ACK vuelven sin él, y el RTT queda en 40 ms.
Se levanta con make up en el contenedor del curso, y bench.py link pone
las reglas:
cd code/week-11
make up
python3 bench.py link     # por defecto: --rate 50 --delay 40 --buffer 250
$ python3 bench.py link
qdisc tbf 85e9: root refcnt 15 rate 50Mbit burst 15Kb lat 38.5ms
qdisc netem 85ea: root refcnt 15 limit 20000 delay 40ms seed 3643269951466264977
$ docker exec clab-w11-dumbbell-s1 ping -c 4 -i 0.3 10.211.4.10
PING 10.211.4.10 (10.211.4.10): 56 data bytes
64 bytes from 10.211.4.10: seq=0 ttl=62 time=82.198 ms
64 bytes from 10.211.4.10: seq=1 ttl=62 time=40.831 ms
64 bytes from 10.211.4.10: seq=2 ttl=62 time=41.108 ms
64 bytes from 10.211.4.10: seq=3 ttl=62 time=40.884 ms
--- 10.211.4.10 ping statistics ---
4 packets transmitted, 4 packets received, 0% packet loss
round-trip min/avg/max = 40.831/51.255/82.198 msEl RTT base es de 41 ms, y el primer ping tarda el doble. Lo más probable es
que sea ARP: los nodos todavía no conocen las direcciones MAC de sus vecinos, y
la pregunta de r2 a rx también pasa por el netem.
Con tbf, limit 250kb son 250 KiB: en tc, kb significa kibibytes, no
kilobits.
Elegir el algoritmo desde C
iperf3 -C reno hace una sola llamada al sistema, y se puede hacer igual
desde cualquier programa: un setsockopt antes de conectar. Lo mismo pasa con
ss, que saca sus datos de lo que el kernel dice de cada socket. tcp_info.c
hace esas dos cosas, para que las vean en unas pocas líneas: envía datos y
cada cierto tiempo imprime lo que dice el kernel.
// Se elige antes de conectar, para que también valga durante el slow start.
if (setsockopt(fd, IPPROTO_TCP, TCP_CONGESTION, algorithm, (socklen_t)strlen(algorithm)) < 0) {
    perror("setsockopt TCP_CONGESTION");
    close(fd);
    return -1;
}
struct tcp_info info;
socklen_t size = sizeof info;
if (getsockopt(fd, IPPROTO_TCP, TCP_INFO, &info, &size) < 0) {
perror("getsockopt TCP_INFO");
return -1;
}El control de congestión lo hace el kernel: este programa solo elige cuál, y
lo observa. Se compila estático con make, porque los nodos usan otra libc, y
la topología monta la carpeta de la semana en /lab. Con una muestra cada 20
ms, una transferencia de dos segundos sobre nuestro enlace se ve así:
$ docker exec -d clab-w11-dumbbell-rx /lab/tcp_info recv 6000
$ docker exec clab-w11-dumbbell-s1 /lab/tcp_info send 10.211.4.10 6000 reno 2 20
# algoritmo: reno
#   t_ms   cwnd ssthresh   rtt_ms retrans estado
     0.0     10        -     45.1       0 open
    21.5     10        -     45.1       0 open
    47.8     10        -     45.1       0 open
    61.0     20        -     46.0       0 open
    83.6     20        -     46.0       0 open
   102.6     40        -     44.9       0 open
   127.7     40        -     44.9       0 open
   141.6     78        -     45.3       0 open
   163.4     78        -     45.3       0 open
   180.2    112        -     45.5       0 open
   204.5    156        -     51.5       0 open
   221.4    159        -     48.2       0 open
   241.7    251        -     56.4       0 open
   261.9    322        -     46.5       0 open
   281.8    404        -     50.7       0 open
   300.5    479        -     61.0       0 open
   320.7    565        -     68.3       0 open
   340.7    648        -     77.3       0 open
   360.8    724        -     81.3       0 disorder
   385.4    582      365     82.4      46 recovery
   401.7    483      365     82.7      77 recovery
   426.5    365      365     82.2     175 recovery
   444.3    365      365     82.4     302 recovery
   461.6    365      365     66.7     388 recovery
   482.1    365      365     56.4     388 recovery
   501.7    364      365     65.8     388 recovery
   522.8    362      365     76.1     388 recovery
   542.6    329      365     80.7     400 recovery
   561.7    312      365     81.3     419 recovery
   589.7    312      365     80.8     419 recovery
   606.3    312      365     79.6     419 recovery
   622.0    317      182     75.7     419 recovery
   642.6    274      182     75.3     419 recovery
   661.7    236      182     75.9     419 recovery
Comparen con las reglas de hace un rato:
- Slow start, en vivo.
cwndempieza en 10 y pasa por 20, 40, 78 y 156, aproximadamente una vez cada 40 ms, que es el RTT. No es una simulación: es la regla de “un MSS por cada ACK”. No hayssthreshtodavía: el kernel lo tiene en un valor enorme, y la columna muestra un guion. Según en qué momento caiga la muestra, a veces se ve un valor intermedio, como el 112 de arriba: la ventana crece con cada ACK, no de golpe al final del RTT. - El exceso. Este enlace aguanta unos 335 paquetes en vuelo, entre lo que
cabe en el camino y en la cola, como veremos enseguida. Pero
cwndllegó a 724. Mientras la cola se llena, los ACK siguen trayendo buenas noticias de hace un RTT, y la ventana sigue doblando. El RTT sube de 41 a 81 ms: son los 41 ms de la cola llena. - La reacción. En 361 ms el estado pasa a
disorder: hay ACK duplicados. Enseguida, arecovery, conssthresh = 365, casi la mitad de 724. Es la regla de la ecuación (4). Ese exceso tiene un costo alto: más de 400 retransmisiones. Si dejamos correr la traza, hay una segunda reducción a 182, porque todavía no se había recuperado del todo. - Sin inflar.
cwndno sube assthresh + 3: baja de a poco, 582, 483, 365. Eso se explica en seguida.
Lo que el libro simplifica
Esto vale decirlo claro, porque aquí es donde se arma confusión al comparar
una captura o un ss con las diapositivas:
| El libro | Linux, en esta máquina |
|---|---|
| Ventana inicial de 1 | 10 segmentos |
cwnd en bytes o en MSS |
ss y TCP_INFO la dan en segmentos |
En recovery cwnd = ssthresh + 3 y se infla |
No se ve ninguna inflación. Durante la recuperación cwnd baja de a poco hasta ssthresh, con una técnica llamada PRR (Proportional Rate Reduction, RFC 6937) |
| Solo se sabe del primer paquete perdido | SACK dice exactamente qué llegó |
| CUBIC sale de slow start al perder | Linux tiene además HyStart, que puede salir antes, al ver que sube el retardo |
ssthresh conocido desde el inicio |
ss no lo muestra hasta la primera pérdida |
Lo importante es que nada de esto cambia la idea. Con el RFC o con PRR, al
terminar la recuperación cwnd queda en ssthresh, y ssthresh es la mitad
de lo que había. Las reglas del libro son las correctas para razonar, para
hacer la cuenta y para implementar un primer protocolo. Solo no esperen ver
ssthresh + 3 en ss.
Linux también puede guardar el ssthresh de la conexión anterior hacia el
mismo destino, y usarlo en la siguiente. Eso arruina un experimento que se
repite. Por eso nuestra topología pone net.ipv4.tcp_no_metrics_save=1 en los
emisores. Este sysctl vale para cada nodo por separado: lo comprobamos, y en
r1 sigue en 0.
Un flujo solo, durante 30 segundos
Ahora un flujo largo. bench.py flow lanza iperf3, y dentro del nodo corre
un ciclo que le pregunta a ss cada 100 ms. Cuidado con un detalle de
iperf3: abre dos conexiones TCP al mismo puerto del servidor, una de control
y otra de datos, y la primera tiene una cwnd pequeña que no se mueve. Por
eso bench.py fija el puerto local del stream de datos con --cport 40001 y
filtra con ss -tin "sport = :40001". Esta es la salida de ss en la mitad
de una transferencia:
$ docker exec clab-w11-dumbbell-s1 ss -tin "sport = :40001"
State Recv-Q Send-Q  Local Address:Port  Peer Address:Port
ESTAB 0      3020528   10.211.1.10:40001  10.211.4.10:5201
	 reno wscale:7,7 rto:259 rtt:58.127/0.396 mss:1448 pmtu:1500 rcvmss:536 advmss:1448 cwnd:239 ssthresh:178 bytes_sent:22609109 bytes_retrans:580648 bytes_acked:21682390 segs_out:15617 segs_in:4033 data_segs_out:15615 send 47629776bps lastrcv:3840 pacing_rate 57155112bps delivery_rate 47147896bps delivered:14976 busy:3840ms unacked:239 retrans:0/401 reordering:8 reord_seen:15 rcv_space:14480 rcv_ssthresh:64088 notsent:2674456 minrtt:40.154 snd_wnd:3881600 rcv_wnd:64256
Vale la pena leer esa línea, porque aquí está casi todo el capítulo:
| Campo | Qué dice |
|---|---|
reno |
El algoritmo de este socket |
cwnd:239 |
La ventana, en segmentos |
ssthresh:178 |
El umbral: ya hubo pérdidas, y estamos en congestion avoidance |
rtt:58.127 |
RTT suavizado, en ms |
minrtt:40.154 |
El RTT más bajo visto. Los 18 ms de diferencia son la cola en r1 |
send 47629776bps |
cwnd × mss / rtt. Hagan la cuenta: 239 × 1448 × 8 / 0,058127 ≈ 47,6 Mbit/s |
unacked:239 |
En vuelo, igual a cwnd: la ventana es lo que limita |
snd_wnd:3881600 |
La ventana que anuncia el receptor, 3,9 MB: mucho más que cwnd, así que rwnd no limita |
retrans:0/401 |
401 retransmisiones acumuladas, casi todas del exceso inicial |
La fórmula throughput ≈ cwnd / RTT no es una aproximación teórica: el kernel
la calcula así.
Con --csv, bench.py guarda las muestras:
$ python3 bench.py flow --cc reno --seconds 30 --csv /tmp/reno.csv
reno: 47.5 Mbit/s, 400 retransmisiones
289 muestras en /tmp/reno.csv
$ python3 bench.py flow --cc cubic --seconds 30 --csv /tmp/cubic.csv
cubic: 47.3 Mbit/s, 524 retransmisiones
288 muestras en /tmp/cubic.csv
$ python3 plot_cwnd.py /tmp/cwnd.png /tmp/reno.csv /tmp/cubic.csv
Los dos llenan el enlace. ¿Por qué 47,5 Mbit/s y no 50? Porque tbf cuenta
los 1514 bytes del frame, y a la aplicación le llegan solo 1448 de datos: 50 × 1448 / 1514 = 47,8 Mbit/s.
Dejamos dos trazas de esa corrida en lab/trace-reno.csv y
lab/trace-cubic.csv. Estas son las filas de la de Reno en las que cambia
ssthresh, más sus primeras muestras:
t_s,cwnd_segments,ssthresh_segments,rtt_ms
0.0,20,,40.662
0.11,78,,45.078
0.21,342,,44.099
0.32,633,358,81.357
0.52,320,179,82.565
10.48,220,168,82.691
Y este es el dibujo que hay que tener en la cabeza. Sale de esa traza completa;
plot_cwnd.py hace un gráfico parecido con sus propias corridas, y conviene que
lo generen.
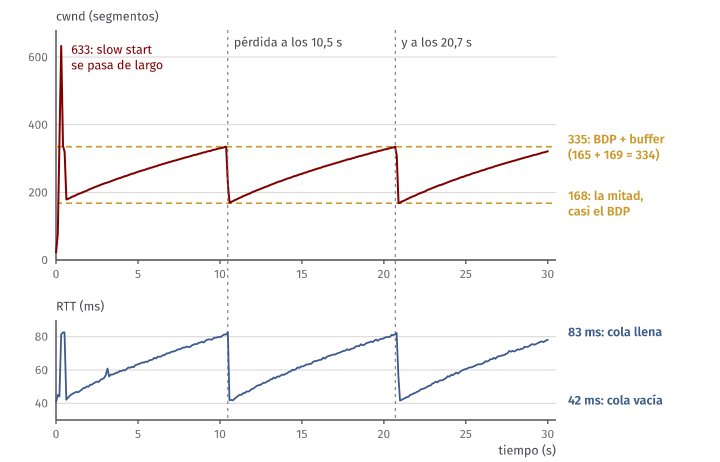
Podemos predecir toda esa figura con lo que ya sabemos, sin correr nada:
- Dónde se pierde. En el camino caben
50 Mbit/s × 40 ms / 1514 bytes ≈ 165paquetes, y en la cola250 KiB / 1514 bytes ≈ 169. En total, 334. La traza alcanza 335. - Hasta dónde baja. A la mitad, 168. Coincide casi exactamente con el BDP.
- Qué pasa con el RTT. Al bajar a 168, la cola se vacía justo, y el RTT
baja a su mínimo: la traza muestra 42 ms, y el throughput no se resiente.
Con la ventana en 335, la cola está llena: 83 ms. El RTT dibuja una sierra
igual a la de
cwnd. - Cuánto dura un ciclo. Son 167 paquetes de subida, a uno por RTT, con un
RTT medio de unos 62 ms:
167 × 0,062 ≈ 10,4 s. La traza muestra una pérdida a los 10,5 s y la siguiente a los 20,7 s.
La curva de Reno es la sierra del libro, con un periodo de 10 segundos porque la ventana es grande y crece solo de a uno por RTT. La de CUBIC tiene otra forma: la miramos en la Sesión B.
Por qué AIMD
Ya vimos el comportamiento. Ahora la pregunta de diseño: ¿por qué sumar al subir, y multiplicar al bajar? Hay cuatro combinaciones obvias: aumentar sumando o multiplicando (AI, MI) y reducir restando o multiplicando (AD, MD). El argumento clásico es de Chiu y Jain, de 1989.
El modelo. Dos flujos comparten un enlace de capacidad C, y envían a
x1 y x2. Todos reciben la misma señal: “hay congestión” si x1 + x2 > C.
Cada uno aplica la misma regla, sin saber nada del otro. Queremos dos cosas:
- Eficiencia:
x1 + x2 = C. - Equidad:
x1 = x2.
Dibujemos el estado como un punto en el plano (x1, x2). La eficiencia es una
recta; la equidad, la diagonal. Queremos llegar a donde se cruzan. La trayectoria
completa está en la animación de más abajo.
Y ahora vean qué hace cada operación con el punto:
- Sumar a los dos un mismo valor mueve el punto en una línea de pendiente
1, paralela a la diagonal. La diferencia
x1 - x2no cambia. - Multiplicar a los dos por un valor mueve el punto sobre la recta que
pasa por el origen. La razón
x2 / x1no cambia, y la diferencia se multiplica por ese mismo factor.
Con eso, el argumento sale solo. La diferencia entre los flujos solo se achica
si el reductor es multiplicativo y el aumento no la vuelve a agrandar.
Veámoslo. phase.py corre el modelo con C = 100, partiendo de un reparto
muy injusto: 10 y 70.
$ python3 phase.py aimd --steps 14
paso      x1      x2    suma  |x1-x2|   Jain
   0    10.0    70.0    80.0     60.0  0.640
   1    15.0    75.0    90.0     60.0  0.692
   2    20.0    80.0   100.0     60.0  0.735
   3    25.0    85.0   110.0     60.0  0.771
   4    12.5    42.5    55.0     30.0  0.771
   5    17.5    47.5    65.0     30.0  0.824
   6    22.5    52.5    75.0     30.0  0.862
   7    27.5    57.5    85.0     30.0  0.889
   8    32.5    62.5    95.0     30.0  0.909
   9    37.5    67.5   105.0     30.0  0.925
  10    18.8    33.8    52.5     15.0  0.925
  11    23.8    38.8    62.5     15.0  0.946
  12    28.8    43.8    72.5     15.0  0.959
  13    33.8    48.8    82.5     15.0  0.968
  14    38.8    53.8    92.5     15.0  0.974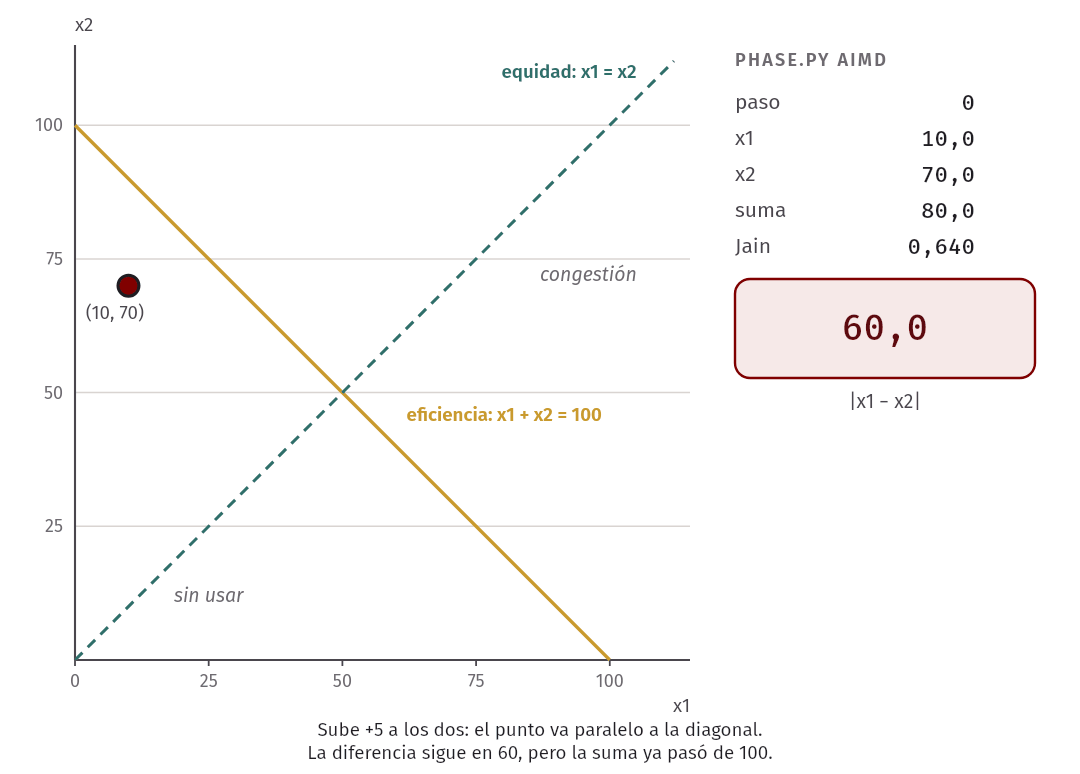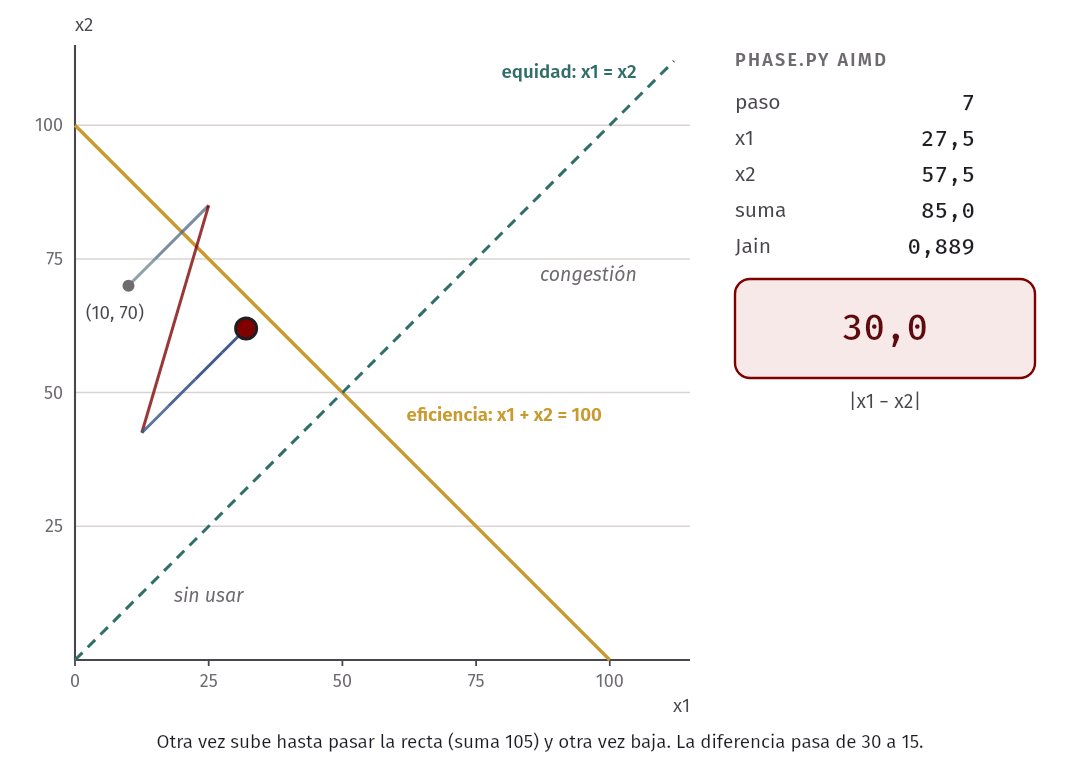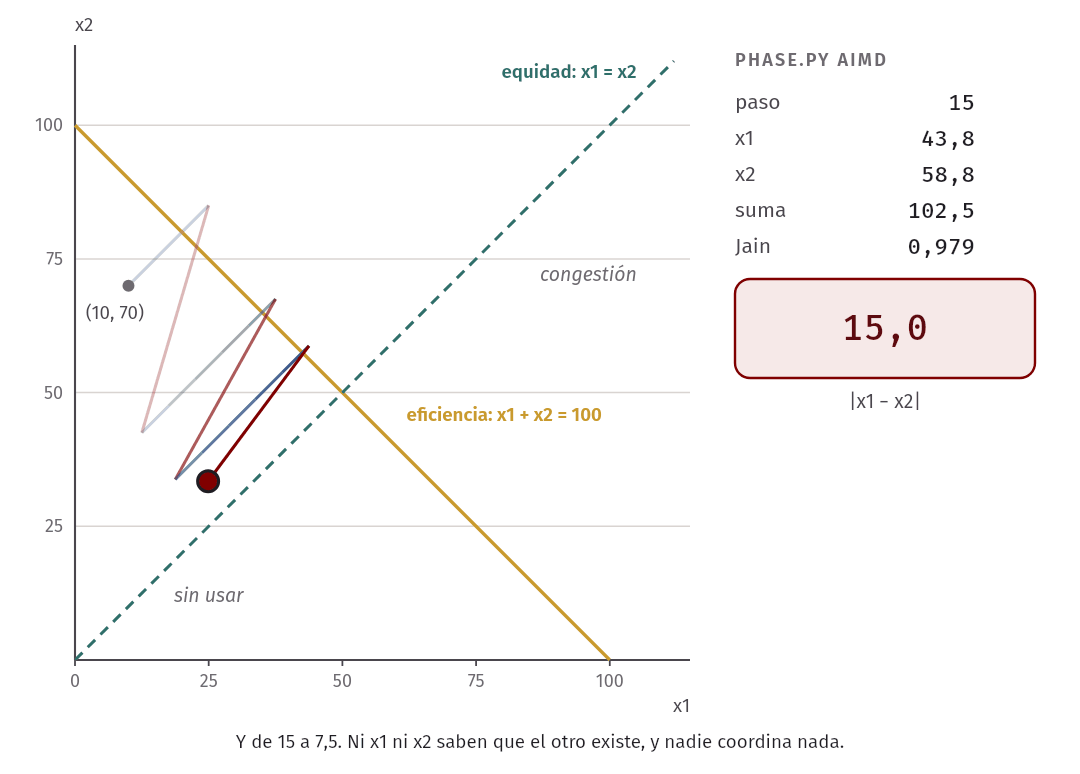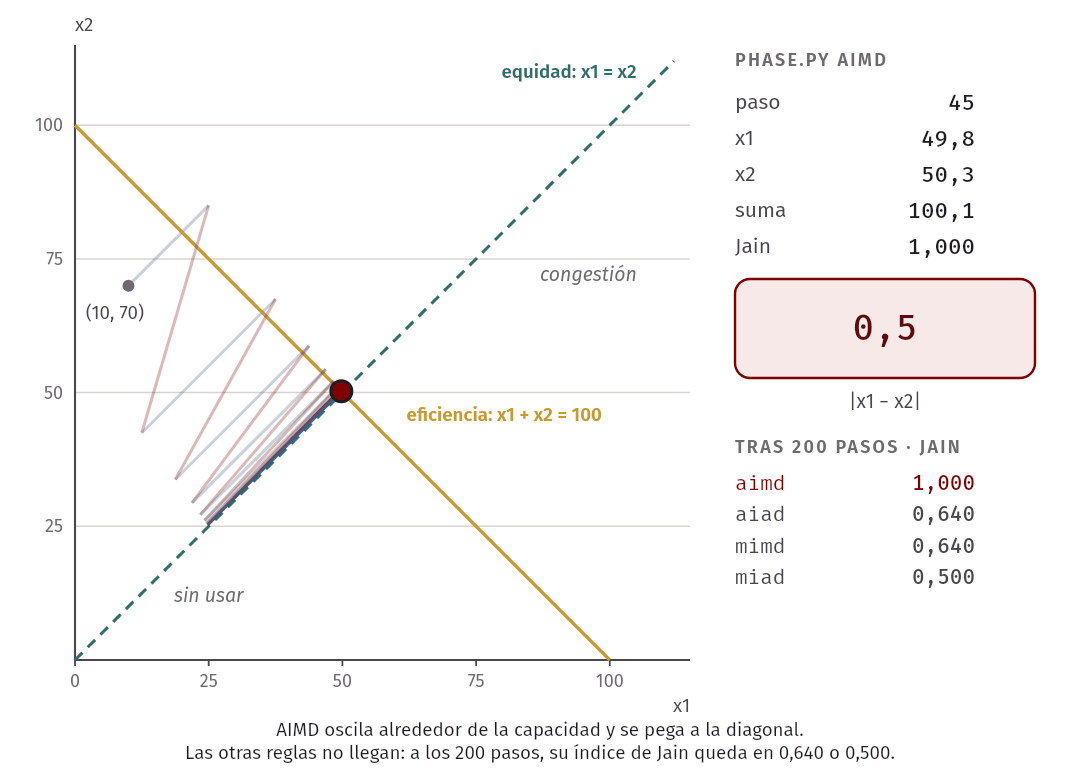
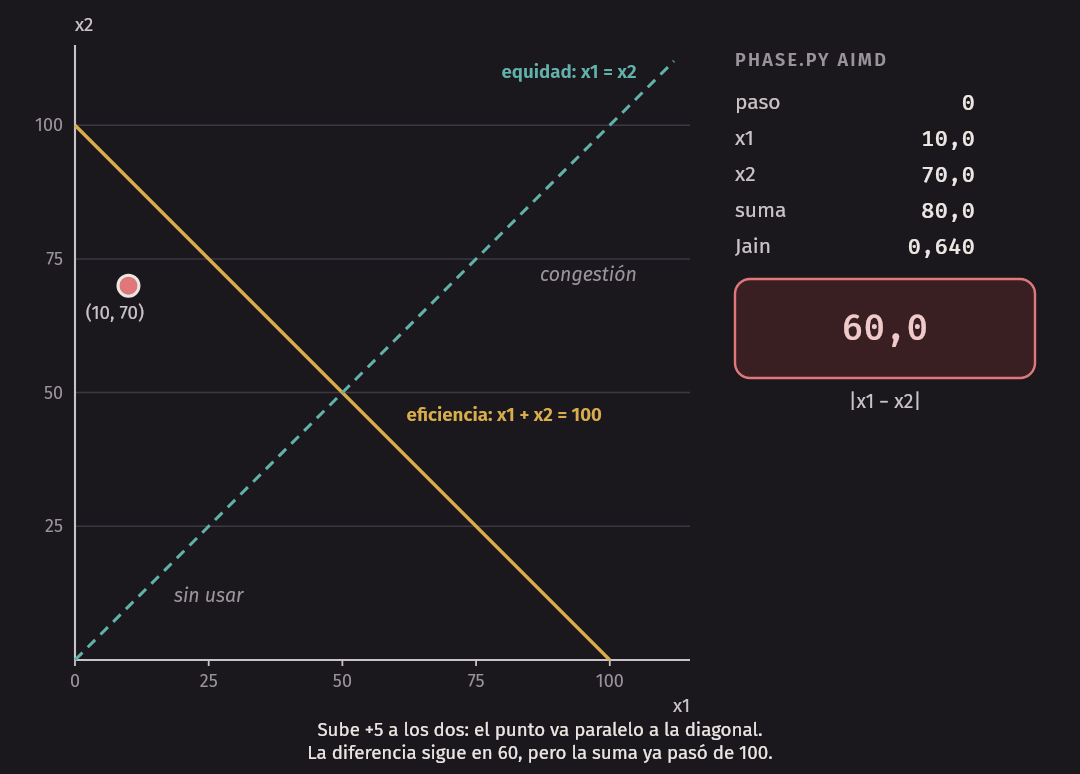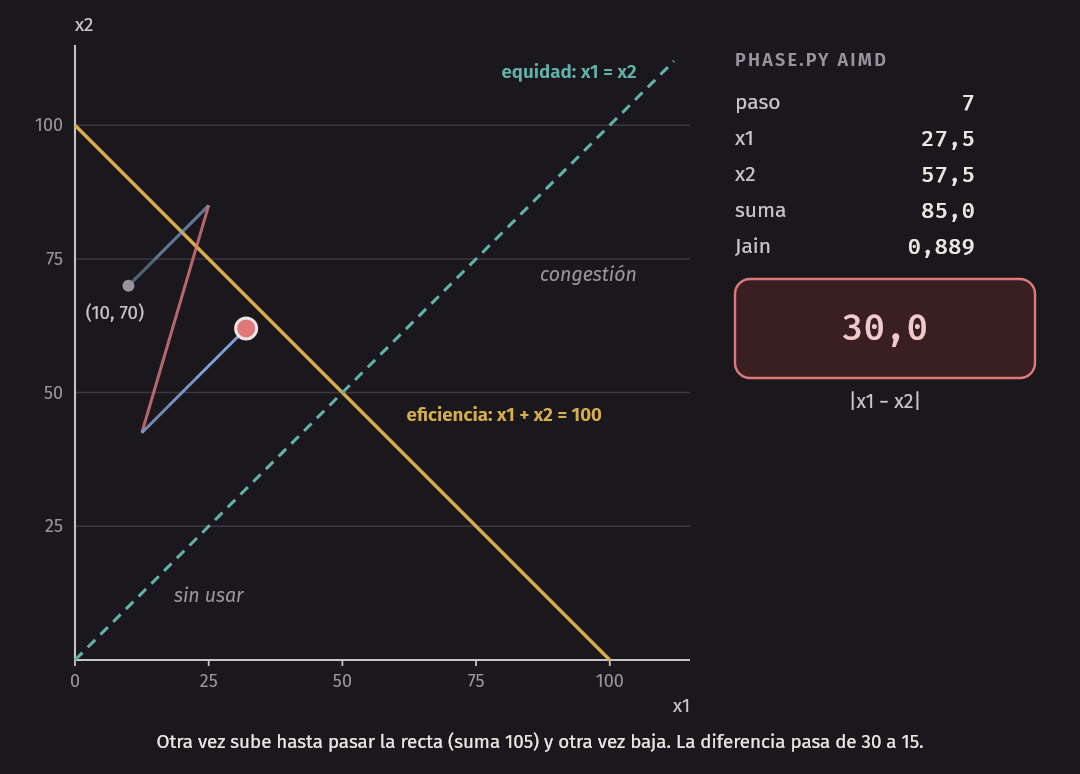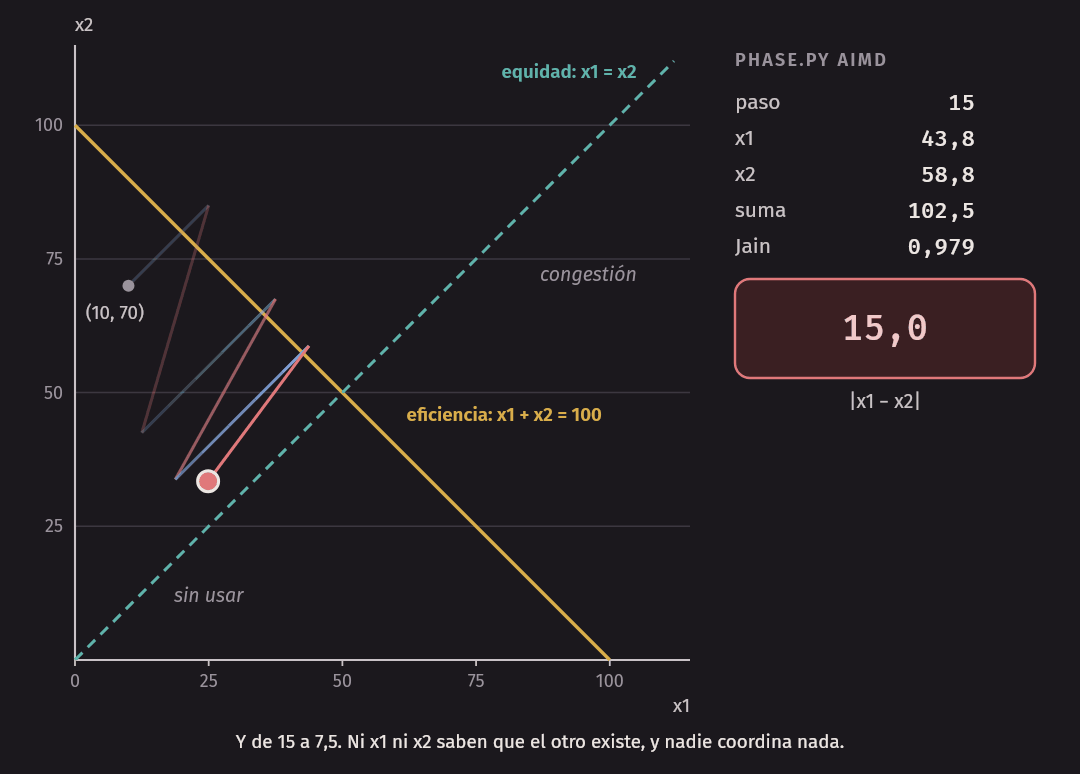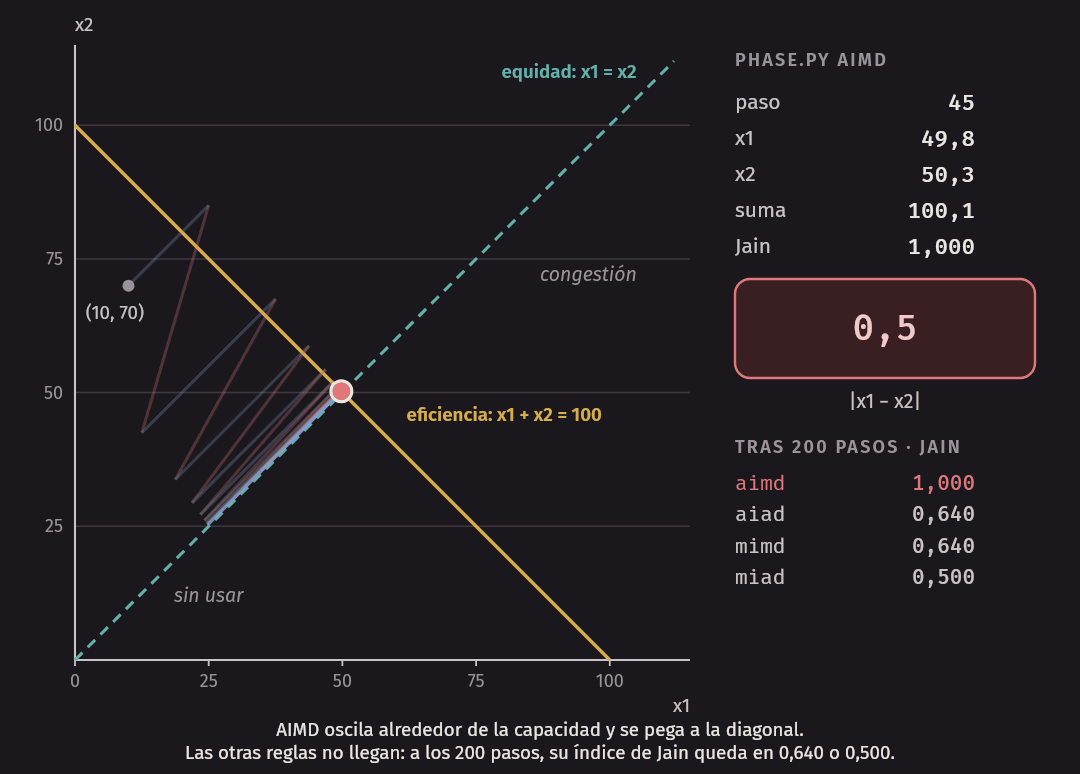
La columna |x1-x2| lo dice todo. Con AIMD (+5 al subir, ×0,5 al bajar) se
mantiene en cada aumento y se parte por la mitad en cada reducción: 60,
30, 15. Tiende a cero sin que nadie coordine nada. Ni x1 ni x2 saben que
el otro existe. Comparen con las otras:
$ python3 phase.py aiad --steps 6
paso      x1      x2    suma  |x1-x2|   Jain
   0    10.0    70.0    80.0     60.0  0.640
   1    15.0    75.0    90.0     60.0  0.692
   2    20.0    80.0   100.0     60.0  0.735
   3    25.0    85.0   110.0     60.0  0.771
   4     5.0    65.0    70.0     60.0  0.576
   5    10.0    70.0    80.0     60.0  0.640
   6    15.0    75.0    90.0     60.0  0.692
$ python3 phase.py mimd --steps 6
paso      x1      x2    suma  |x1-x2|   Jain
   0    10.0    70.0    80.0     60.0  0.640
   1    12.5    87.5   100.0     75.0  0.640
   2    15.6   109.4   125.0     93.8  0.640
   3     7.8    54.7    62.5     46.9  0.640
   4     9.8    68.4    78.1     58.6  0.640
   5    12.2    85.4    97.7     73.2  0.640
   6    15.3   106.8   122.1     91.6  0.640
Con AIAD, la diferencia no se mueve nunca del 60. Con MIMD, la razón x2 / x1
queda fija en 7 y el índice de Jain no cambia ni en el tercer decimal. El
sistema oscila alrededor de la capacidad, pero sin acercarse a la diagonal. Y
el último caso es peor. Después de 200 pasos, esto es lo que queda con cada
regla:
$ python3 phase.py all
regla       x1      x2    suma  |x1-x2|   Jain
aimd      45.0    45.0    90.0      0.0  1.000
aiad      10.0    70.0    80.0     60.0  0.640
mimd       7.6    53.5    61.1     45.8  0.640
miad       0.0   109.7   109.7    109.7  0.500
MIAD deja a un flujo en cero y al otro con todo: la multiplicación agranda la
diferencia y la resta no la reduce nunca. AIMD es la única que converge hacia
el reparto justo y, a la vez, oscila alrededor de la capacidad. python3 phase.py all --png fases.png dibuja las cuatro trayectorias en el plano.
Idea clave. AIMD no reparte: converge a un reparto. Cada reducción multiplicativa quita más al que tiene más, y cada aumento aditivo da lo mismo a los dos. Ningún flujo necesita saber cuántos otros hay, y por eso esto escala a Internet.
¿Y por qué no bajar restando, que es más suave? Hay además un argumento de
seguridad: enviar de más hace daño a todos los demás, y enviar de menos solo
le cuesta al que lo hace. Por eso la subida es prudente y la bajada, brusca.
El precio es la forma de sierra: un flujo Reno pasa la vida entre W/2 y W.
Cómo se mide la equidad
Definición. El índice de equidad de Jain de n flujos con throughputs
x1, ..., xn es:
J = (x1 + x2 + ... + xn)² / (n × (x1² + x2² + ... + xn²))Vale 1 si todos reciben lo mismo y 1/n si uno solo se lleva todo. Algunos
valores para dos flujos: 25 y 25 da 1; 35 y 15 da (50)² / (2 × (1225 + 225)) = 2500 / 2900 = 0,862; 45 y 5 da 2500 / (2 × 2050) = 0,610; 50 y 0 da 0,5.
El índice tiene una lectura útil: si k de los n flujos se reparten todo
por igual y el resto recibe cero, J = k / n. Por eso un índice de 0,8 con
cinco flujos significa algo así como “se comportan como si solo cuatro
estuvieran usando el enlace”. Tiene también un defecto: no ve la eficiencia.
Dos flujos a 1 kbit/s en un enlace de 1 Gbit/s tienen un índice perfecto.
La fórmula del throughput
Empezamos la Sesión B con una pregunta concreta: si un camino pierde una
fracción p de los paquetes, ¿cuánto puede transmitir Reno, sin importar qué
tan rápido sea el enlace?
El modelo es el de la sierra, con varias simplificaciones a propósito: un solo
flujo, RTT fijo, sin slow start, y una pérdida exactamente cuando la ventana
llega a W. Se detecta con ACK duplicados, y la ventana cae a W/2.
  cwnd
   W |      /|      /|      /|
     |    /  |    /  |    /  |
 W/2 |  /    |  /    |  /    |
     |/      |/      |/      |
     +----------------------------> tiempo
      <----->
      W/2 RTT
Saquemos la cuenta en tres pasos:
- Ventana promedio. La ventana va de
W/2aW, de forma lineal. En promedio vale3W/4, así que el throughput promedio es(3W/4) × MSS / RTT. - Paquetes por ciclo. Un ciclo dura
W/2RTT, y en cada RTT se envían, en promedio,3W/4paquetes. En un ciclo se envían(W/2) × (3W/4) = 3W²/8paquetes. - Tasa de pérdida. Se pierde uno por ciclo, entonces
p = 8 / (3W²). Despejando,W = √(8 / (3p)).
Reemplazando el paso 3 en el paso 1:
                  MSS
throughput ≈  √(3/2) ───────────    con √(3/2) ≈ 1,22
                RTT × √p
Esta se suele llamar la fórmula de Mathis, por el artículo de 1997 que la popularizó. Lean lo que dice antes de usarla:
- El throughput no depende de la capacidad del enlace. Con esa pérdida y ese RTT, da lo mismo tener 100 Mbit/s o 100 Gbit/s, siempre que el enlace no sea lo que limita.
- Es inversamente proporcional al RTT. Duplicar la distancia reduce el throughput a la mitad, con la misma pérdida.
- Es inversamente proporcional a √p. Para duplicar el throughput hay que reducir la pérdida a la cuarta parte.
¿Funciona?
Pongámosla a prueba en nuestro enlace de 50 Mbit/s y 40 ms, con una pérdida
aleatoria en r2. Aquí MSS = 1448 bytes: de los 1500 de la MTU,
52 son headers IP y TCP, con la opción de timestamps. Para p = 1 %:
1,22 × (1448 × 8 bits) / (0,040 s × √0,01) = 1,22 × 11 584 / 0,004 ≈ 3,5 Mbit/sDe un enlace de 50 Mbit/s. Tres corridas de 20 segundos para cada pérdida, en una de ellas con estos comandos:
$ python3 bench.py link --loss 1
$ python3 bench.py flow --cc reno --seconds 20
reno: 3.2 Mbit/s, 68 retransmisiones
$ python3 bench.py flow --cc cubic --seconds 20
cubic: 3.0 Mbit/s, 55 retransmisiones
Estos son todos los resultados:
| Pérdida | Fórmula para Reno | Reno medido (Mbit/s) | CUBIC medido (Mbit/s) |
|---|---|---|---|
| 1 % | 3,5 | 3,2 · 3,2 · 3,9 | 3,0 · 2,8 · 4,2 |
| 0,1 % | 11,2 | 12,6 · 11,2 · 11,7 | 14,1 · 9,5 · 10,9 |
| 0,01 % | 35,5 | 37,1 · 29,8 · 39,8 | 32,9 · 39,8 · 45,1 |
| 0 % | no aplica | 47,5 | 47,3 |
Para una cuenta de cuatro líneas, la coincidencia con Reno es notable. Un 1 %
de pérdida, que para una persona que navega parece poca cosa, le quita a TCP
más del 90 % del enlace. Y la culpa no es de la congestión: esta pérdida es
aleatoria, y la cola de r1 está casi vacía. TCP no puede distinguir una de
otra.
Error común. Creer que la pérdida siempre significa congestión. Un enlace WiFi con interferencia pierde paquetes sin ninguna cola llena, y el emisor baja su velocidad igual. CS168 trata este problema como uno de los defectos del diseño basado en pérdidas. Por eso el WiFi retransmite en su propia capa: oculta esa pérdida a TCP.
¿Cuál resiste mejor la pérdida, Reno o CUBIC?
La guía de laboratorio hace esta pregunta y la respuesta honesta sale de la tabla: con 1 % y con 0,1 %, en nuestro enlace, empatan dentro del ruido. Solo con 0,01 % CUBIC se ve un poco mejor (39,8 frente a 37,1 de mediana), y aún así dos de las tres corridas se cruzan con las de Reno. No es lo que uno esperaría si se queda con la idea de “CUBIC es el moderno”. En un momento veremos por qué tiene sentido.
Por qué Reno sufre en enlaces rápidos y largos
Volteemos la fórmula: ¿qué pérdida se necesita para sostener un throughput dado? Tomemos un enlace de 1 Gbit/s con 100 ms de RTT y paquetes de 1500 bytes. Para sostenerlo en promedio hacen falta:
ventana promedio = 1 Gbit/s × 0,100 s / (1500 × 8 bits) ≈ 8333 paquetes
p = (1,22 / 8333)² ≈ 2,1 × 10⁻⁸
Una pérdida cada 46 millones de paquetes, o una cada nueve minutos y pico a esa velocidad. Ninguna red real está tan limpia durante tanto tiempo, y menos aún si hay otros flujos. Pasa lo mismo si lo miramos en el tiempo: después de una sola pérdida, Reno tiene que recuperar miles de paquetes de ventana, de a uno por RTT.
El problema es de la regla “uno por RTT”, que estaba bien para los enlaces de 1986. Reno no escala con el BDP.
CUBIC
CUBIC cambia dos cosas de Reno: cuánto reduce y cómo crece. El RFC 9438 lo especifica, y es el algoritmo por defecto del kernel que usamos:
$ docker exec clab-w11-dumbbell-s1 cat /proc/sys/net/ipv4/tcp_available_congestion_control
reno cubic
$ docker exec clab-w11-dumbbell-s1 cat /proc/sys/net/ipv4/tcp_congestion_control
cubic
La curva
Al perder, CUBIC recuerda la ventana donde ocurrió, Wmax, la reduce por un
factor β = 0,7 (Reno usa 0,5), y empieza a contar el tiempo desde ese
evento. La ventana sale de una función del tiempo:
W(t) = C × (t − K)³ + Wmax

K = ∛( (Wmax − cwnd_inicial) / C )        C = 0,4     t en segundos
K es el tiempo que tarda en volver a Wmax. Como cwnd_inicial = 0,7 × Wmax, queda K = ∛(0,3 × Wmax / 0,4). La forma de una cúbica, entonces, es
perfecta para lo que se quiere:
 W
 |                                           *
 |                                        *
 |                                     *        tercera parte: probing
Wmax- - - - - - - - - - *  *  *  *  *  - - - - - más arriba, cada vez más rápido
 |                 *                 segunda parte: casi plano cerca de
 |             *                     donde hubo pérdida
 |          *    primera parte: subir rápido
 |       *       a recuperar lo perdido
0,7 Wmax
 +-------|----------------|-------------------> t
0 K- Lejos de
Wmaxpor debajo (región cóncava): sube rápido. - Cerca de
Wmax: casi no se mueve. Es la zona donde se sabe que hubo problemas, así que se queda ahí sin provocar una pérdida y con buen throughput. - Más allá de
Wmax(región convexa): si no pasó nada, quizá hay más capacidad. Empieza despacio y acelera.
El tiempo manda, no el RTT
Esto es lo más importante de CUBIC. En Reno, la ventana crece por RTT:
quien tiene RTT corto, crece más rápido. En CUBIC, fuera de la región que
veremos en un momento, W(t) depende del tiempo transcurrido, y el RTT no
aparece en la fórmula. K tampoco depende del RTT. cubic_curve.py compara,
en varios enlaces, cuánto tarda cada uno en recuperarse de una pérdida:
$ python3 cubic_curve.py --recovery
    enlace     RTT  BDP (paq.)         Reno      CUBIC
   50 Mbps   40 ms         167        3.3 s      5.0 s
   50 Mbps  200 ms         833       83.3 s      8.5 s
 1000 Mbps   40 ms        3333       66.7 s     13.6 s
 1000 Mbps  200 ms       16667     1666.7 s     23.2 s
10000 Mbps  100 ms       83333     4166.7 s     39.7 s
Esa columna de Reno es (Wmax / 2) × RTT, y la de CUBIC es K, con Wmax
igual al BDP de cada fila. En nuestro enlace de laboratorio, Reno se recupera
incluso antes. En el último, Reno necesita casi 70 minutos y CUBIC menos de un
minuto.
La curva, en la traza real
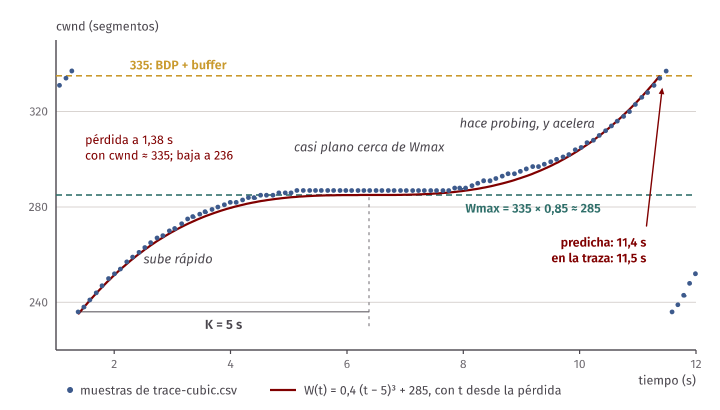
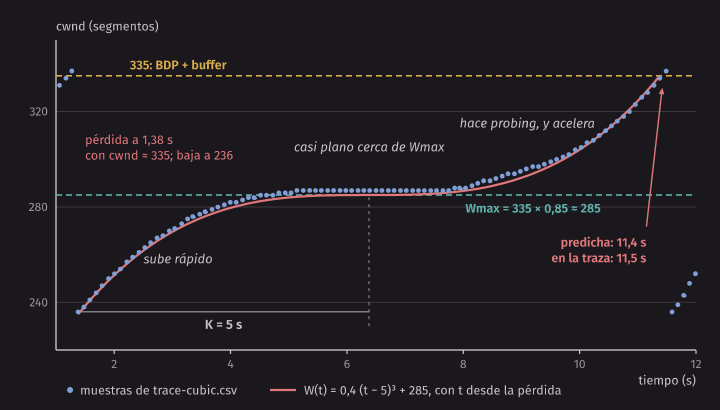
Volvamos a la traza de 30 segundos. Lean la curva de CUBIC en
lab/trace-cubic.csv, en la parte que empieza con la pérdida a los 1,38 s:
 t (s)    cwnd   ssthresh   rtt (ms)   qué pasa
  1,38     236        236       75,5   pérdida con cwnd ≈ 335; 236 / 335 ≈ 0,70
  6,4      ≈ 287                       meseta
 11,5      337                         nueva pérdida
La pérdida ocurrió con cwnd ≈ 335, que como ya vimos es el BDP + buffer de
este enlace. Se reduce a 0,7 × 335 ≈ 235. Hasta aquí, lo esperado. Pero la
meseta no quedó en 335, sino en unos 287. ¿Por qué?
Es la convergencia rápida (fast convergence) de la sección 4.7 del RFC
9438: si la pérdida llega con una ventana menor que el Wmax anterior, el
flujo interpreta que está perdiendo capacidad y deja espacio a los demás,
usando Wmax = cwnd × (1 + β) / 2. Aquí eso da 335 × 0,85 ≈ 285, y
corresponde con la meseta observada. Hagamos la predicción completa, con
cwnd_inicial = 235:
K = ∛((285 − 235) / 0,4) = ∛125 = 5,0 s          → meseta en t ≈ 1,38 + 5,0 ≈ 6,4 s
W(t) = 336  →  0,4 × (t − 5)³ = 51  →  t ≈ 10,0 s  → pérdida en t ≈ 11,4 s
La traza muestra la pérdida en 11,5 s. Una cuenta con la fórmula del RFC predice el momento de la pérdida con un error de un muestreo. El RFC recomienda desactivar esta convergencia con un solo flujo, pero el kernel la tiene activa, y por eso la vemos.
Un aviso sobre esa misma traza: a los 16,6 s hay una reducción con cwnd = 256, donde la cola todavía no debería llenarse. No la explica la fórmula. En
una computadora con otros procesos, una ráfaga o un retraso pueden hacer
perder paquetes; no investigamos ese caso en particular. Por eso comparamos
tendencias.
La región amigable con Reno
Si solo fuera por W(t), CUBIC podría ser más lento que Reno en un enlace con
RTT muy corto y ventana chica. Miren las primeras filas de nuestro enlace, con
Wmax = 167 y una columna con lo que haría Reno por su cuenta desde Wmax / 2:
$ python3 cubic_curve.py --wmax 167 --rtt 40
Wmax = 167 paquetes, K = 5.00 s
 t (s)  W cubic   W reno
   0.0      117       84
   0.5      130       96
   1.0      141      108
   1.5      150      121
   2.0      156      134
   2.5      161      146
   3.0      164      158
   3.5      166      171
   4.0      167      184
A los 3,5 segundos, Reno ya alcanzó a la curva. Para no quedar peor que Reno
en este tipo de caminos, CUBIC calcula además W_est, la ventana que tendría
un AIMD equivalente, y usa la mayor de las dos. A esa zona se le llama
región amigable con Reno (Reno-friendly region). El RFC fija ese AIMD
equivalente con un aumento α = 3 × (1 − β) / (1 + β) ≈ 0,53 paquetes por RTT
y una reducción de 0,7: con esos dos valores, a igual pérdida, tiene
aproximadamente la misma ventana promedio que Reno.
Ahora sí se explica el empate de la tabla de pérdidas. Con 1 % de pérdida, la
ventana promedio de la fórmula es 1,22 / √0,01 ≈ 12 paquetes. Hay una
pérdida cada unos 100 paquetes, unos 8 RTT, o sea unos 0,3 segundos. Con
Wmax tan chico, K sería de unos 2 segundos, y la curva nunca se aleja de
su punto de partida antes de la siguiente pérdida. CUBIC se queda siempre en
la región amigable, y está diseñado para hacer lo mismo que Reno. Empatan
a propósito.
Idea clave. CUBIC no gana en cualquier enlace con pérdida. Gana donde el BDP es grande y la pérdida es rara, que es donde Reno tardaría demasiado en recuperarse. Donde Reno anda bien, CUBIC se comporta como Reno a propósito, y por eso se puede desplegar sin dañar a los demás.
Cómo comparar las dos curvas en sus datos
Con los CSV de un flujo se puede medir directamente el factor de reducción:
ssthresh nuevo sobre el cwnd más alto antes de la pérdida. Es una de las
funciones que ustedes completan en el laboratorio. Con las trazas de la clase, redondeando a dos decimales:
reno   [0.57, 0.28, 0.5]
cubic  [0.94, 0.66, 0.7, 0.69, 0.7, 0.71]
Los dos primeros valores de cada lista son del exceso inicial de slow start: el muestreo cada 100 ms ve mal ese momento, y Reno tiene ahí dos reducciones seguidas. Los siguientes son los de régimen, y son los factores 0,5 y 0,7 que dicen los RFC.
Bufferbloat
Hasta ahora, el buffer ha sido un detalle. Pero cwnd > BDP significa una
cola. Y como TCP basado en pérdidas sigue subiendo hasta que se bota un
paquete, llena el buffer que encuentre, sea del tamaño que sea. La cuenta
del retardo es directa:
retardo de cola máximo = tamaño del buffer × 8 / rateBuffer en r1 |
Cuenta a 50 Mbit/s | Veces el BDP |
|---|---|---|
| 50 KiB | 8,2 ms | 0,2 |
| 250 KiB | 41 ms | 1 |
| 2000 KiB | 328 ms | 8 |
Midámoslo. bench.py bloat hace un ping desde s2 hacia rx, primero sin
carga, y luego mientras s1 transmite por 20 segundos. El ping cruza la
misma cola en r1, igual que cualquier otra aplicación de esa red: una
videollamada, por ejemplo.
$ python3 bench.py link --buffer 2000
$ python3 bench.py bloat --cc reno --seconds 20
reno: 46.6 Mbit/s, 926 retransmisiones
ping sin carga: 41.0 ms; con carga: mediana 196.9 ms, máximo 250.9 ms; recibidos 75 de 75
$ python3 bench.py bloat --cc cubic --seconds 20
cubic: 46.1 Mbit/s, 90 retransmisiones
ping sin carga: 42.4 ms; con carga: mediana 300.1 ms, máximo 381.0 ms; recibidos 75 de 75
$ python3 bench.py link --buffer 50
$ python3 bench.py bloat --cc reno --seconds 20
reno: 22.6 Mbit/s, 158 retransmisiones
ping sin carga: 41.1 ms; con carga: mediana 41.1 ms, máximo 84.2 ms; recibidos 75 de 75
$ python3 bench.py bloat --cc cubic --seconds 20
cubic: 12.6 Mbit/s, 80 retransmisiones
ping sin carga: 41.4 ms; con carga: mediana 41.1 ms, máximo 69.3 ms; recibidos 75 de 75
Y el cuadro completo:
| Buffer | ping con Reno (mediana) |
ping con CUBIC (mediana) |
Throughput Reno | Throughput CUBIC |
|---|---|---|---|---|
| 50 KiB | 41,1 ms | 41,1 ms | 22,6 Mbit/s | 12,6 Mbit/s |
| 250 KiB | 60,1 ms | 61,0 ms | 45,6 Mbit/s | 46,7 Mbit/s |
| 2000 KiB | 196,9 ms | 300,1 ms | 46,6 Mbit/s | 46,1 Mbit/s |
Fíjense en la última fila. Pasar de 250 KiB a 2000 KiB no sube el throughput
y multiplica el retardo. El enlace ya estaba lleno; los paquetes de más solo
hacen cola. Un ping que tardaba 41 ms ahora tarda 300, para cualquiera que
comparta ese enlace, aunque no tenga nada que ver con la descarga. Esto es el
bufferbloat: colas enormes que esconden la congestión, porque la señal de
pérdida llega tarde, y que suben el retardo de todos.
En estas corridas, CUBIC se queda con un retardo mayor que Reno porque pasa
más tiempo cerca de Wmax, es decir, con la cola casi llena, mientras que
Reno baja a la mitad y la vacía más. No tomen ese orden como una ley: en una
corrida anterior de 15 segundos, con el mismo buffer, CUBIC dio una mediana de
120 ms y un máximo de 280 ms. Lo más probable es que HyStart lo haya sacado de
slow start antes de llenar la cola y que, en ese tiempo, no llegara a subir
hasta arriba.
                       cola llena: se pierde
   ventana              |
 BDP + buffer  --------/|-------/|---------
                     /  |     /  |          <- todo esto es cola
 BDP           ----/----|---/----|---------
                 /      | /      |
                        |
          Con un buffer grande, la ventana pasa casi todo el tiempo arriba del BDP.
El otro lado de la tabla es la primera fila: con un buffer muy chico, el
retardo es excelente y el throughput cae. Si el buffer es menor al BDP, Reno
en su mínimo ((BDP + buffer) / 2) queda por debajo del BDP y el enlace se
queda sin usar parte del ciclo. Con 50 KiB esa es la cuenta en papel, pero las
mediciones son mucho más variables que eso. Al repetir el flujo de 30 segundos
tres veces con el mismo buffer obtuvimos 21,9, 14,9 y 38,3 Mbit/s con Reno, y
44,7, 23,6 y 43,7 Mbit/s con CUBIC. Con una cola de pocos paquetes, cualquier
ráfaga produce pérdidas. Cambia mucho de corrida en corrida, así que no se
queden con un solo número. Con esos valores, CUBIC se mantiene mejor, cosa
razonable porque baja solo a 0,7.
Idea clave. No existe un tamaño de buffer correcto para todo: hay un compromiso. Con un flujo, la regla clásica es
buffer ≈ BDP: justo lo que le permite a Reno reducir a la mitad sin vaciar el enlace. Lo vimos en la traza de Reno, con la ventana bajando a 168 (el BDP) y el RTT llegando a 42 ms, casi el mínimo. Pero el BDP depende del RTT de cada flujo, y el router no lo conoce. Por eso los routers y los módems de casa se fabricaban con buffers de sobra: la memoria es barata, y una prueba de velocidad se ve mejor si no se pierde nada.
En la práctica. Si en su casa una videollamada se traba cuando alguien sube un video, lo más probable no es que falte ancho de banda, sino el bufferbloat del módem: la subida suele ser el cuello de botella, y su cola se llena. Para verlo, hagan
pinga su gateway o a un servidor cercano mientras suben un archivo grande. Ustedes pueden hacer esa prueba en la terminal de su computadora, fuera del contenedor.
BBR
Si el problema es esperar a la pérdida, otra opción es no usarla como señal principal. Es lo que propone BBR (Bottleneck Bandwidth and Round-trip propagation time), de Google, publicado en 2016. Hoy lo trabaja el grupo CCWG del IETF, en un borrador de tipo experimental.
Lo vemos en clase, pero no lo medimos: como salió más arriba, el kernel
del contenedor del curso solo ofrece reno y cubic. Nada de esta sección
viene de una medición nuestra.
La idea sale de la figura de cwnd frente al BDP que vimos en la Sesión A. El
punto óptimo es cwnd = BDP: el enlace lleno y sin cola. Los algoritmos
basados en pérdidas operan bastante más allá, en el borde derecho de la figura,
cuando la cola se desborda. BBR quiere operar en el punto óptimo, y para eso
construye un modelo del camino con dos cantidades:
BtlBw, el ancho de banda del cuello: el máximo de la velocidad de entrega reciente.RTprop, el retardo de propagación: el mínimo del RTT reciente.
Con eso calcula el BDP. Y cambia también el mecanismo de envío: no controla solo con una ventana, sino con una velocidad de envío (pacing), y usa la ventana como un límite de seguridad.
El truco es que esas dos cantidades no se pueden medir a la vez: para ver el máximo ancho de banda hay que llenar el enlace, y para ver el mínimo RTT hay que tener la cola vacía. Por eso BBR alterna entre estados:
| Estado | Qué hace |
|---|---|
| Startup | Sube rápido, como slow start, hasta que la velocidad de entrega deja de crecer |
| Drain | Baja para vaciar la cola que dejó el Startup |
| ProbeBW | La mayor parte del tiempo. Envía a la velocidad estimada, haciendo probing periódicamente un poco más arriba |
| ProbeRTT | Cada cierto tiempo, baja mucho lo que tiene en vuelo para medir el RTT sin cola |
Una pérdida aleatoria de 1 % que no cambia el ancho de banda, en principio, no le cambia el modelo. Es justo el caso que hunde a Reno. El costo de usar esa señal menos es que puede convivir mal con los demás. La versión original de BBR recibió críticas por dos situaciones, reportadas en estudios de ese tiempo y que no comprobamos aquí:
- Buffers chicos: como la pérdida no lo frena, puede seguir enviando y mantener una tasa alta de pérdida. Los flujos que sí reaccionan a la pérdida, como CUBIC, retroceden y le ceden el enlace.
- Buffers grandes: CUBIC llena la cola y BBR, limitado por su ventana, puede quedarse con una parte menor.
Las versiones más recientes usan también la pérdida en su modelo: el borrador actual menciona de forma explícita la convivencia con Reno y CUBIC como un objetivo. Sobre ECN, ese borrador pide tratar las marcas CE como congestión, sin fijar una respuesta específica.
Error común. Decir que “BBR es basado en retardo”, como se resume a veces. CS168 lo presenta así, y es una buena primera aproximación: mira el RTT mínimo. Pero no reacciona al crecimiento del retardo como lo hacen los algoritmos clásicos basados en retardo. Es más preciso decir que estima un modelo del camino y envía según el modelo.
ECN: la red avisa sin botar
Hasta ahora, un router solo tiene una forma de decir “hay congestión”: botar un paquete. Eso obliga a llenar la cola, o a perder datos que ya cruzaron medio camino. ECN (Explicit Congestion Notification), del RFC 3168, le da otra: marcar el paquete en vez de botarlo.
Son dos bits en el header IP y dos flags en el header TCP:
| Bits IP (ECN) | Nombre | Significado |
|---|---|---|
00 |
Not-ECT | Este paquete no usa ECN |
10, 01 |
ECT(0), ECT(1) | Quien envió sabe reaccionar a ECN |
11 |
CE | Congestion Experienced: un router marcó congestión |
Y el recorrido completo es de ida y vuelta:
 emisor                  router congestionado                receptor
    |---- datos, ECT(0) ------>|                                |
    |                          |--- marca CE (11) ------------->|
    |<-------------------- ACK con ECE ------------------------ |   sigue enviando ECE
    | (reacciona como si fuera una pérdida, una vez por ventana)|
    |---- datos, CWR --------------------------------------->   |   "ya me enteré"
Se negocia en el handshake. En una captura del laboratorio se ve SEW en el
SYN (E es ECE y W es CWR, en la notación de tcpdump), y S.E en el
SYN-ACK:
14:22:14.049461 IP 10.211.1.10.55398 > 10.211.4.10.5201: Flags [SEW], seq 799513045, win 64240, options [mss 1460,sackOK,TS val 1249742420 ecr 0,nop,wscale 7], length 0
14:22:14.089772 IP 10.211.4.10.5201 > 10.211.1.10.55398: Flags [S.E], seq 2773480492, ack 799513046, win 65160, options [mss 1460,sackOK,TS val 2227900921 ecr 1249742420,nop,wscale 7], length 0
Y en plena transferencia, capturando en rx solo lo que tenga los dos bits en
1 (ip[1]&3==3), aparece un paquete con la marca:
14:21:59.835068 IP (tos 0x3,CE, ttl 62, id 48395, offset 0, flags [DF], proto TCP (6), length 1500)
    10.211.1.10.40001 > 10.211.4.10.5201: Flags [P.], cksum 0x33e0 (correct), seq 1782379502:1782380950, ack 1174499218, win 502, options [nop,nop,TS val 1249728157 ecr 2227886617], length 1448
Cuándo marca el router: RED
ECN solo dice cómo avisar. Cuándo lo decide el router. El ejemplo clásico
es RED (Random Early Detection): no espera a que la cola se llene, sino
que, cuando el promedio de la cola pasa de un umbral min, empieza a marcar o
a botar paquetes al azar, con probabilidad creciente hasta el umbral max. Si
los emisores reaccionan, la cola se queda corta.
Para probar, cambiamos solo lo que hay en r1: la misma velocidad, un buffer
de 1000 KiB y RED con min de 30 KiB y max de 90 KiB. Primero con ECN en
los emisores, luego sin ECN:
$ python3 bench.py link --queue red-ecn --buffer 1000 --ecn
$ python3 bench.py bloat --cc cubic --seconds 20
cubic: 43.9 Mbit/s, 0 retransmisiones
ping sin carga: 41.0 ms; con carga: mediana 41.5 ms, máximo 46.9 ms; recibidos 75 de 75
$ python3 bench.py queue
qdisc tbf 1: root refcnt 15 rate 50Mbit burst 15Kb lat 161ms
 Sent 115325495 bytes 76271 pkt (dropped 0, overlimits 58766 requeues 0)
 backlog 0b 0p requeues 0
qdisc red 10: parent 1:1 limit 1000Kb min 30Kb max 90Kb ecn
 Sent 115325495 bytes 76271 pkt (dropped 0, overlimits 125 requeues 0)
 backlog 0b 0p requeues 0
  marked 125 early 0 pdrop 0 other 0
$ python3 bench.py link --queue red-ecn --buffer 1000
$ python3 bench.py bloat --cc cubic --seconds 20
cubic: 43.7 Mbit/s, 16 retransmisiones
ping sin carga: 41.1 ms; con carga: mediana 41.9 ms, máximo 47.2 ms; recibidos 75 de 75
$ python3 bench.py queue
qdisc tbf 1: root refcnt 15 rate 50Mbit burst 15Kb lat 161ms
 Sent 114856208 bytes 75961 pkt (dropped 16, overlimits 66442 requeues 0)
 backlog 0b 0p requeues 0
qdisc red 10: parent 1:1 limit 1000Kb min 30Kb max 90Kb ecn
 Sent 114856208 bytes 75961 pkt (dropped 16, overlimits 16 requeues 0)
 backlog 0b 0p requeues 0
  marked 0 early 16 pdrop 0 other 0
Lean la última línea de cada corrida:
| Marcados | Botados por RED | Retransmisiones | |
|---|---|---|---|
| Con ECN | 125 | 0 | 0 |
| Sin ECN | 0 | 16 | 16 |
Con la misma cola, lo que era pérdida se convirtió en una marca. Y comparen el
ping con el del buffer FIFO de 2000 KiB: ambos tienen un límite grande,
pero el RTT se queda en 41-42 ms en lugar de 300. El tamaño de la memoria
dejó de importar, porque quien decide es el umbral.
Esas dos corridas salieron bien, pero conviene no confiar solo en ellas. Al repetir cuatro veces cada caso con flujos de 20 segundos, con ECN obtuvimos 16,8, 29,0, 37,6 y 43,7 Mbit/s, con 1 retransmisión en total y 250 marcas. Sin ECN, 23,9, 40,5, 22,9 y 32,0 Mbit/s, con 418 retransmisiones. Queda claro lo que hace ECN: las pérdidas prácticamente desaparecen. Pero la cola corta tiene un precio: estos umbrales de RED, de 30 a 90 KiB, están muy por debajo del BDP de 250 KiB, y el throughput cae y varía bastante. Los umbrales hay que elegirlos, y un mal valor le cuesta enlace a todos.
En la práctica. Dos ideas salen de este experimento, y conviene separarlas. La gestión activa de colas (AQM, de la que RED es el ejemplo clásico) es lo que reduce el bufferbloat; ECN es lo que evita perder el paquete al avisar. Según CS168, ECN se usa sobre todo en redes pequeñas donde todos los equipos están de acuerdo, como dentro de un data center, y en Internet solo una parte de los routers lo tiene activo.
Equidad
Ya vimos que AIMD converge a un reparto justo en el modelo de Chiu y Jain. Pero ese modelo tiene dos suposiciones: que todos reciben la señal a la vez, y que todos tienen el mismo RTT. Midamos qué pasa en una red de verdad.
Dos flujos con el mismo algoritmo
Dos emisores, s1 y s2, durante 30 segundos, sobre el mismo enlace de 50
Mbit/s y 40 ms, con un buffer de 250 KiB:
$ python3 bench.py pair --cc reno --seconds 30
s1 reno: 23.8 Mbit/s, 337 retransmisiones
s2 reno: 21.2 Mbit/s, 311 retransmisiones
Jain: 0.997| Corrida | Reno y Reno (s1, s2) | Jain | CUBIC y CUBIC (s1, s2) | Jain |
|---|---|---|---|---|
| 1 | 17,9 · 26,5 | 0,964 | 29,6 · 15,0 | 0,903 |
| 2 | 23,8 · 21,2 | 0,997 | 26,5 · 18,9 | 0,973 |
| 3 | 22,2 · 20,9 | 0,999 | 17,2 · 29,8 | 0,933 |
El reparto es razonable, sin ningún coordinador, y el ganador cambia de una corrida a otra. Treinta segundos son pocos ciclos: con Reno, en este enlace, un ciclo tarda unos 10 segundos si va solo. CUBIC reparte algo peor en estas corridas, algo coherente con lo que dice el RFC 9438: su reducción de 0,7 le da una convergencia más lenta, con la cual el equilibrio tarda más.
Reno contra CUBIC
Como s1 arranca una fracción de segundo antes, hay que correr las dos
combinaciones para no confundir el efecto del algoritmo con el del orden:
| Corrida | s1 Reno · s2 CUBIC | Jain | s1 CUBIC · s2 Reno | Jain |
|---|---|---|---|---|
| 1 | 28,0 · 14,6 | 0,910 | 29,7 · 16,9 | 0,930 |
| 2 | 22,4 · 23,8 | 0,999 | 30,8 · 16,0 | 0,909 |
| 3 | 27,6 · 17,7 | 0,955 | 28,0 · 19,0 | 0,964 |
Con estas seis corridas, CUBIC promedia 24,1 Mbit/s y Reno, 21,7. Es casi un
empate a esta escala, porque nuestro BDP no es muy grande y CUBIC pasa buena
parte del tiempo cerca de la región amigable. Lo que sí resalta es otra cosa:
en cinco de seis corridas ganó el que iba en s1, sin importar el algoritmo,
aunque ese efecto no apareció en las corridas de un solo algoritmo. No
conocemos la causa, y con tan pocas corridas podría ser casualidad. Con una
sola corrida, habríamos concluido cualquier cosa. Con un BDP mucho mayor, se
espera que CUBIC se lleve una parte más grande: inténtenlo en el ejercicio 11.
RTT distintos
Ahora el cambio importante: s2 con 80 ms extra en su camino, para que su RTT
base sea de 120 ms, contra 40 ms de s1.
$ python3 bench.py link --extra-s2 80
$ python3 bench.py pair --cc reno --seconds 30
s1 reno: 41.0 Mbit/s, 405 retransmisiones
s2 reno: 6.6 Mbit/s, 7 retransmisiones
Jain: 0.657
$ python3 bench.py pair --cc cubic --seconds 30
s1 cubic: 37.7 Mbit/s, 443 retransmisiones
s2 cubic: 10.1 Mbit/s, 14 retransmisiones
Jain: 0.750
El retardo extra está en la salida de r1 hacia s2, en el sentido de los
ACK, y no en la propia salida del emisor. Es a propósito: si la cola de
netem estuviera en la misma máquina que el socket, TCP lo notaría y
frenaría, y mediríamos otra cosa.
| Corrida | Reno: corto · largo | Razón | CUBIC: corto · largo | Razón |
|---|---|---|---|---|
| 1 | 41,0 · 6,6 | 6,2 | 37,7 · 10,1 | 3,7 |
| 2 | 38,6 · 9,1 | 4,2 | 34,8 · 12,8 | 2,7 |
| 3 | 39,0 · 8,4 | 4,6 | 34,3 · 13,4 | 2,6 |
El flujo de RTT corto gana, siempre, y con los dos algoritmos. La fórmula lo adelantó: el throughput es inversamente proporcional al RTT. Pero hay dos efectos, y los dos van en la misma dirección:
- La ventana se traduce en menos velocidad: a igual ventana,
throughput = cwnd / RTT. - La ventana crece más lento: en Reno, un paquete por RTT significa que con 120 ms crece a un tercio de la velocidad.
Combinados, si los dos flujos pierden a la vez, en Reno la razón de throughput
se acerca al cuadrado de la razón de los RTT. El RFC 9438 lo dice en esos
términos, y dice también que CUBIC mantiene una razón lineal. Nuestros
datos son compatibles con eso: si contamos una cola media de unos 20 ms en los
dos caminos, la razón de RTT es de unos 140 / 60 ≈ 2,3, y su cuadrado es
5,4. Reno da 4,2 a 6,2, y CUBIC da 2,6 a 3,7. CUBIC reduce el problema, pero
no lo resuelve. Es una lectura razonable de tres corridas, no una
demostración.
Idea clave. En Internet, “justo” nunca significó “todos reciben lo mismo”. Un usuario más lejos del servidor recibe menos, por un efecto del diseño de TCP. Esta es otra razón para tener una CDN cerca: acortar el RTT le da más throughput a la misma conexión, aunque el enlace no cambie.
Varias conexiones paralelas
El otro hueco del modelo: TCP reparte entre conexiones, no entre usuarios
ni entre máquinas. s2 abre 4 conexiones, y s1 solo una:
$ python3 bench.py pair --cc cubic --parallel2 4 --seconds 30
s1 cubic: 13.7 Mbit/s, 166 retransmisiones
s2 cubic: 32.4 Mbit/s, 380 retransmisiones
Jain: 0.858
$ python3 bench.py pair --cc cubic --parallel2 4 --seconds 30
s1 cubic: 12.8 Mbit/s, 117 retransmisiones
s2 cubic: 34.1 Mbit/s, 424 retransmisiones
Jain: 0.829
Con 5 conexiones que reciben lo mismo, a s2 le tocaría el 80 %. Se lleva
cerca del 70 %, y si sumamos los flujos el índice de Jain se ve aceptable,
aunque no lo es: habría que calcularlo por conexión o por usuario, según lo
que se quiera decidir. Este es un ejemplo de por qué la definición de “flujo”
importa.
Por eso los gestores de descargas abren varias conexiones, y HTTP/1.1 también lo hacía en los navegadores. Y no es una trampa solo teórica: nada en la red lo impide. CS168 señala que el emisor también podría hacer trampa modificando su algoritmo, y que en la práctica no se sabe bien cuánto se hace. La defensa posible está en los routers: fair queuing, una cola por flujo con turnos entre ellas. Reparte bien incluso frente a un emisor que no coopera, a costa de más trabajo en el router. Y cada proveedor debe decidir si la unidad de reparto es la conexión o el cliente.
Error común. Decir que TCP es “justo” en general. Solo tiende a serlo entre conexiones de larga duración, con el mismo RTT, con el mismo algoritmo y sin nadie que abra más conexiones.
El laboratorio de la semana y make test
Trabajen en code/week-11/, dentro del contenedor del curso.
| Archivo | Qué es |
|---|---|
dumbbell/dumbbell.clab.yml |
La topología: s1, s2, r1, r2, rx |
bench.py |
Pone las reglas de tc, y lanza los flujos y el ping, con ss cada 100 ms |
plot_cwnd.py |
Grafica cwnd y RTT desde los CSV |
tcp_info.c |
Elige el algoritmo con TCP_CONGESTION y lee TCP_INFO |
reno_trace.py, phase.py, cubic_curve.py |
Los modelos en papel de este capítulo |
lab/metrics.py |
Lo que ustedes completan |
lab/trace-reno.csv, lab/trace-cubic.csv |
Dos trazas reales que se usan en las pruebas |
test_models.py, test_lab.py, test_dumbbell.py |
Las pruebas |
Para cada paso, antes de ejecutar, predigan el resultado con una cuenta.
- Línea base.
make upypython3 bench.py link. Comprueben conpingel RTT base. Midan un flujo conpython3 bench.py flow --cc cubic --seconds 20. ¿Por qué 47 Mbit/s y no 50? cwnden el tiempo. Corranflowcon--cc reno --csv reno.csvy con--cc cubic --csv cubic.csv, y grafiquen conpython3 plot_cwnd.py cwnd.png reno.csv cubic.csv. Identifiquen slow start, las pérdidas y la sierra. También pueden lanzariperf3 -c 10.211.4.10 -C renoa mano ens1, con uniperf3 -senrx, y mirar conss -tin.- Pérdida.
python3 bench.py link --loss 1, y repitan los flujos varias veces. Comparen con la fórmula. ¿Cuál resiste mejor? Prueben también con--loss 0.01. - Bufferbloat.
python3 bench.py link --buffer 2000ypython3 bench.py bloat --cc cubic --seconds 20. Repitan con--buffer 50. Calculen primero el retardo esperado. - Dos flujos.
python3 bench.py linkypair --cc reno,pair --cc cubic, ypair --cc reno --cc2 cubicmáspair --cc cubic --cc2 reno.pairimprime el índice de Jain; compruébenlo a mano al menos una vez. - Distinto RTT.
python3 bench.py link --extra-s2 80ypair. ¿Cuál gana? ¿En qué proporción? - Las cuentas. Completen
lab/metrics.py: el BDP, el retardo de un buffer, la fórmula de Mathis y el factor de reducción de una traza. Prueben conmake test, y corrandecrease_ratiosen los CSV de ustedes. - Proyecto. Entreguen P3 y lean el enunciado de P4. Lo que
midieron aquí es el TCP del kernel: en P4, ustedes escriben el control de
congestión de
rimay, en C y en bytes, con sus propias mediciones. Nibench.pyni el modelo dereno_trace.pyles resuelven esa parte: el modelo cuenta por RTT, sin ACK, y P4 reacciona a cada ACK.
make test compila tcp_info, corre los modelos, levanta la topología, mide
lo que dicen estos apuntes y destruye todo al terminar, aunque algo falle.
Tarda unos minutos, porque mide de verdad. Las pruebas de lab/metrics.py se
saltan hasta que quiten los TODO. Las pruebas exigen tendencias con márgenes
amplios, no cifras exactas. Si la computadora está muy cargada, una medición
puede salirse de ellos: cierren otros programas y repitan. Cuando terminen,
make down destruye la topología.
Error común. Sacar conclusiones de una sola corrida de 10 segundos. Ya vieron que el ganador cambia de corrida a corrida, y que el ciclo de Reno en este enlace tarda 10 segundos. Repitan cada medición y corran más tiempo si un resultado les sorprende.
Error común. Mirar la
cwndde la conexión equivocada.iperf3abre una conexión de control y otra de datos hacia el mismo puerto. Si ven unacwndde 10 que no se mueve, están viendo la de control. Fijen el puerto con--cport, como hacebench.py.
Resumen
- Congestión es más tráfico sostenido del que un enlace puede transmitir. Cuesta retardo, pérdida, retransmisiones inútiles y, sin control, un colapso, como el de 1986.
- Control de flujo protege al receptor; control de congestión, a la red.
El emisor envía
min(cwnd, rwnd), y el throughput es aproximadamentecwnd / RTT. - BDP = rate × RTT es la ventana que llena el enlace sin cola. Más ventana agrega retardo, no throughput.
- Slow start dobla por RTT hasta
ssthresho una pérdida. Congestion avoidance suma uno por RTT. Tres ACK duplicados dejancwnden la mitad, con fast recovery; un timeout la deja en 1. - Linux empieza con 10 segmentos y reduce con PRR, sin la inflación del RFC 5681, pero el resultado es el mismo. Las reglas del libro sirven para razonar.
- AIMD es la única de las cuatro combinaciones que converge hacia la equidad: la multiplicación achica la diferencia y la suma la conserva. Se mide con el índice de Jain.
- La fórmula de Mathis es
1,22 × MSS / (RTT × √p). Explica por qué 1 % de pérdida hunde a Reno y por qué no escala en enlaces rápidos y largos. Coincidió bien con nuestras mediciones. - CUBIC crece según una función del tiempo, no por RTT, y reduce a 0,7. Gana con BDP grande y poca pérdida. Con BDP chico o mucha pérdida, su región amigable lo hace parecerse a Reno, a propósito.
- Bufferbloat: TCP basado en pérdidas llena cualquier buffer. Pasar de 250
KiB a 2000 KiB no subió el throughput, y llevó el
pingde 60 a 300 ms. Un buffer muy chico, en cambio, baja el throughput. - BBR estima un modelo del camino, ancho de banda y RTT mínimo, y usa pacing. No usa la pérdida como señal principal, y por eso su convivencia con otros algoritmos es delicada. No se midió aquí, porque nuestro kernel no lo trae.
- ECN marca en vez de botar. Con RED, los mismos paquetes que se habrían botado llevan una marca; y la cola corta, no el ECN en sí, es lo que baja el retardo.
- Equidad: el RTT corto gana, sobre todo en Reno; CUBIC lo reduce pero no lo elimina. TCP reparte entre conexiones, así que abrir más conexiones da más parte del enlace.
Ejercicios
- Con
MSSde 1 unidad, ventana inicial 1 yssthresh = 32, escribancwnden los primeros 12 RTT, con tres ACK duplicados en el RTT 9. Luego, con un timeout en el RTT 15, sigan hasta el RTT 22. Comprueben conreno_trace.py. - Calculen el BDP en paquetes de 1500 bytes de: un enlace de 100 Mbit/s con 50 ms de RTT; un enlace de 1 Gbit/s dentro de un data center, con 200 µs; y un enlace satelital de 20 Mbit/s con 600 ms. ¿En cuál de ellos importa más la ventana inicial? ¿Por qué?
- En una conexión,
ssdicecwnd:239,mss:1448yrtt:58.127, con un cuello de 50 Mbit/s. Calculencwnd / RTTy compárenlo con el valorsendde la salida de este capítulo. ¿Cuánta cola tiene el camino, si el RTT mínimo es de 40 ms? - Lean el código de
phase.py, y agreguen una regla que suba +5 y baje ×0,8. ¿Converge? ¿Más rápido o más lento que con ×0,5? ¿Por qué CUBIC paga un precio similar en convergencia al usar 0,7? - Con
phase.py, supongan que un flujo “hace trampa” y suma +10 en vez de +5. Modifiquen el código para que cada flujo tenga su propio aumento. ¿A qué razónx2 / x1llega? Comparen con lo que dice CS168 en Congestion Control Issues. - Usen la fórmula para predecir el throughput de Reno en el laboratorio con
--loss 0.5, y luego con--delay 80y la misma pérdida. Midan. Según la fórmula, ¿cuál es la razón entre los dos? ¿La cumple la medición? - Con
Wmax = 400paquetes, y sin convergencia rápida, calculenK, yW(t)para t = 0, K/2, K y 2K. Luego comparen concubic_curve.py --wmax 400. ¿A partir de qué momento, en un RTT de 20 ms, Reno, que empieza enWmax / 2, habría alcanzado a CUBIC? - Predigan el RTT durante la carga con un buffer de 1000 KiB y compárenlo con
una medición de
bloat. Si tuvieran que elegir un buffer para este enlace, para una videollamada y una descarga a la vez, ¿cuál elegirían? Justifiquen con mediciones de los dos lados. - Corran con
link --queue red-ecn --buffer 1000 --ecny capturen enrxcontcpdump -nn -v -i eth1 'ip[1]&3==3'. Encuentren los paquetes marcados, y luego busquen en una captura des1los ACK con ECE y los datos con CWR. ¿Cuánto pasa entre uno y otro? ¿Cuántas reducciones de ventana hizo el emisor? - Repitan el experimento de RTT distintos con
--extra-s2 20y--extra-s2 160. Grafiquen la razón de throughput frente a la razón de RTT, para Reno y para CUBIC. ¿Se parece a una recta o a una parábola? No olviden contar la cola en el RTT. - Busquen un BDP más alto:
link --rate 200 --delay 100 --buffer 2500. Comparen dos flujos, uno de Reno y otro de CUBIC, en las dos posiciones, durante 60 segundos, en al menos tres corridas. ¿Ahora sí gana CUBIC? Si su computadora no llega a esa velocidad, ¿cómo lo notarían? - Un compañero dice: “Podríamos resolver el bufferbloat usando BBR en todas partes, y no haría falta tocar los routers”. Discutan, con lo que vieron: ¿qué pasa con los flujos que no usan BBR? ¿Qué ventaja tiene cambiar la cola del router? ¿Qué problema de despliegue tiene cada opción?