
Apuntes · Capítulo 12Transporte y aplicaciones
DNS y HTTP: los nombres y la web por dentro
DNS y HTTP: los nombres y la web por dentro
En las tres semanas anteriores construimos el transporte: UDP, la entrega confiable, TCP
y su control de congestión. Con eso, un programa ya le puede mandar bytes a otro programa
del otro lado del mundo. Pero nadie abre el navegador para escribir 45.80.81.43. Ustedes
escriben un nombre y piden una página. Esta semana subimos a la capa de aplicación para
ver los dos protocolos que hacen posible ese gesto tan simple.
El primero es DNS, que traduce nombres a direcciones. Es una base de datos distribuida en todo el planeta, sin un servidor central, que responde en milisegundos y que casi nadie nota hasta que falla. En la semana 7 vimos lo que pasa cuando falla: en octubre de 2021, Facebook desapareció de Internet porque sus servidores DNS retiraron sus propias rutas. Ahora vamos a ver qué hacían esos servidores.
El segundo es HTTP, el protocolo de la web. Es sorprendentemente simple: texto que va y texto que vuelve. Lo interesante está en cómo se volvió rápido: conexiones que se reutilizan, caches que evitan preguntar y, con HTTP/2, muchas respuestas mezcladas en una sola conexión. Cada mejora se entiende contando idas y vueltas, y ya tenemos todo lo necesario para contarlas.
En la Sesión A seguimos una resolución desde la raíz hasta la respuesta, en una red propia y en el Internet real. Leemos los mensajes byte por byte, y vemos por qué DNS usa UDP, cuándo usa TCP y cómo se lo ataca. En la Sesión B escribimos HTTP a mano, medimos lo que cuesta cada conexión, hacemos pasar las peticiones por un proxy con cache y miramos los frames de HTTP/2.
Hay dos clases de resultados en este capítulo. Lo que sale de nuestra red de
laboratorio se repite: los RTT son los que le pusimos con tc, y los puertos, los ID y
las fechas cambian en cada corrida. Lo que sale del Internet real es una foto de un
día: los TTL, las direcciones y los servidores que ustedes vean serán otros.
Ruta de lectura.
Antes de clase (obligatorio, unos 15 a 20 minutos). Sesión A: La red de esta semana, Nombres y direcciones, La jerarquía, la introducción de Recursiva e iterativa, la de Cache y TTL, y Registros. Sesión B: la introducción de HTTP: petición y respuesta, con Métodos y Códigos de estado.
En clase. Sesión A: Glue: un problema de huevo y gallina, En el Internet real, Ver cómo baja el TTL, Elegir el TTL, El mensaje de DNS, byte por byte, Por qué UDP, y cuándo TCP y Ataques a DNS. Sesión B: Para qué sirve
Host, HTTP no guarda estado; las cookies sí, Cuánto cuesta una página, Cache de HTTP y HTTP/2.Después de clase. Repasen con el Resumen y los Ejercicios, y preparen Laboratorio: DNS paso a paso y HTTP por dentro y Archivos y
make test. Opcional: Respuestas negativas, DoH y DoT: cifrar, Otros problemas y Lo que HTTP/2 no arregló. Para profundizar, las lecturas del libro y las gratuitas de la semana:Este capítulo acompaña a Kurose y Ross, Computer Networking: A Top-Down Approach (9.ª ed.). Para la Sesión A, la sección 2.4 DNS: The Internet’s Directory Service, y el capítulo DNS de CS168. Complementarias: RFC 1034 y RFC 1035, DNS; RFC 4033, DNSSEC; y RFC 8484, DNS sobre HTTPS. Para la Sesión B, las secciones 2.2.1 a 2.2.6, de Overview of HTTP hasta HTTP/2, y el capítulo HTTP de CS168. Complementarias: RFC 9110, semántica de HTTP; RFC 9111, cache; RFC 9112, HTTP/1.1; y RFC 9113, HTTP/2. El código de la semana está en
code/week-12/.
La red de esta semana
Todo corre en una sola topología, red/red.clab.yml. Es un Internet de bolsillo, con su
propia raíz, su propio TLD y un sitio web:
  cliente    resolver     raiz      tld      auth      web     cache     killa
 10.212.1.10 10.212.2.10 .3.10     .4.10    .5.10     .6.10    .7.10     .8.10
     |           |         |         |        |         |        |         |
     +-----------+---------+---------r--------+---------+--------+---------+

 RTT desde r:  raiz, tld, auth, killa   20 ms     (con tc netem)
               web                      50 ms
               cliente, resolver, cache casi nada
Se levanta con make up, que además arranca los servidores:
| Nodo | Programa | Qué hace |
|---|---|---|
raiz |
dns_auth.py |
Autoritativo de la zona . |
tld |
dns_auth.py |
Autoritativo de test. |
auth |
dns_auth.py |
Autoritativo de wayra.test. |
resolver |
dns_resolver.py |
Resolver recursivo, con cache |
web |
mini_web.py |
Un sitio de juguete, guardado en memoria |
cache |
mini_cache.py |
Un proxy con cache |
killa |
dns_auth.py |
Vacío al inicio: es el del laboratorio |
Usamos el TLD .test porque está reservado para pruebas: nunca va a existir en el DNS
real. Los servidores de DNS y HTTP están escritos en Python, en unas pocas páginas, para
que se puedan leer. No son para producción. El único programa en C de la semana es
dns_ask.c, que arma una pregunta a mano.
Nombres y direcciones
Una dirección IP dice dónde está algo en la red: es lo que un router necesita para hacer forwarding, y por eso tiene estructura de prefijos. Un nombre dice qué es algo, y su estructura le sirve a la gente que lo administra.
Esa diferencia no es solo comodidad. Separar el nombre de la dirección permite cambiar una sin tocar la otra:
- El sitio se muda a otro proveedor y cambia de dirección, pero sigue llamándose igual.
- Un mismo nombre puede dar varias direcciones, para repartir la carga entre servidores.
- Varios nombres pueden vivir en una misma dirección, como veremos con
Host. - Un nombre puede dar respuestas distintas según quién pregunte. Así funcionan las CDN, que veremos la próxima semana.
Definición. DNS (Domain Name System) es una base de datos distribuida y jerárquica, junto con el protocolo para consultarla. Dado un nombre y un tipo de registro, devuelve los registros que corresponden.
Lo de “traducir nombres” es solo el caso más común. DNS también sirve para:
- Alias: un nombre que apunta a otro, con un registro CNAME.
- Correo: a qué servidor se le entrega el correo de un dominio, con un registro MX.
- Reparto de carga: varias direcciones para un mismo nombre.
- Datos varios: con registros TXT se publican, por ejemplo, las reglas sobre quién puede mandar correo en nombre de un dominio.
Por qué no un solo servidor
En los primeros años de ARPANET, todos los nombres estaban en un archivo, HOSTS.TXT, y
cada máquina bajaba una copia. Funcionó mientras eran pocas. Un diseño centralizado se
cae por cuatro lados: es un punto único de falla, concentra todo el tráfico, queda lejos
de casi todos, y una sola organización tendría que mantener todos los nombres del mundo.
DNS reparte el problema de dos maneras. Reparte la autoridad: cada organización administra sus propios nombres. Y reparte la carga: las respuestas se guardan en cache cerca de quien pregunta, así que la mayoría de las preguntas nunca llega lejos.
La jerarquía
Los nombres se leen de derecha a izquierda, de lo más general a lo más específico. Cada parte entre puntos es una etiqueta. El nombre completo termina en un punto, que representa a la raíz, aunque casi siempre se omite al escribirlo:
                 www.uni.edu.pe.
                                ^  raíz
                             ^^    TLD (top-level domain)
                         ^^^       edu.pe, administrado por el registro de .pe
                     ^^^           uni.edu.pe, administrado por la UNI
                 ^^^               un nombre dentro de esa zona
Se forma un árbol, y cada organización se encarga de un pedazo:
Definición. Una zona es la parte del árbol de nombres que administra una misma autoridad. Quien administra una zona puede delegar una parte de abajo a otra organización, y esa parte pasa a ser otra zona.
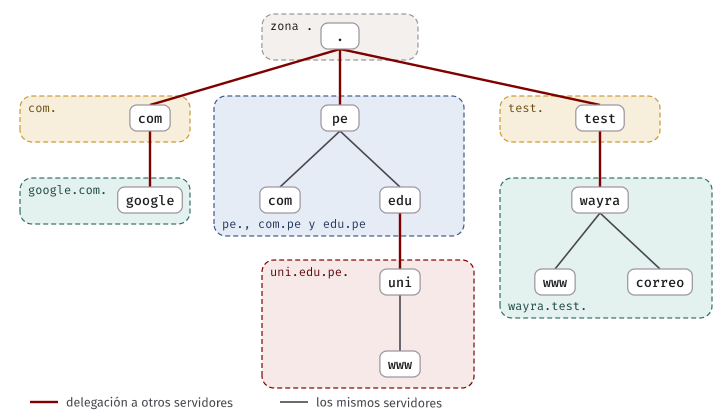
Hay tres clases de servidores en la jerarquía:
| Servidor | De qué responde | Qué contesta por www.uni.edu.pe |
|---|---|---|
| Raíz | La zona . |
“No sé; los de .pe son estos” |
| TLD | Una zona como pe. o com. |
“No sé; los de uni.edu.pe son estos” |
| Autoritativo | Los nombres de una organización | “Es 45.80.81.43”, y lo dice con autoridad |
Existen 13 nombres de servidores raíz, de a.root-servers.net a m.root-servers.net. Eso
no significa 13 máquinas. Como vimos en la semana 6, cada letra es una dirección anycast
con muchas copias repartidas por el mundo.
Error común. Creer que el servidor raíz conoce todos los nombres. Conoce muy poco: la lista de TLD y quién responde por cada uno. Su trabajo es mandarlos al siguiente nivel. Por eso una sola zona chica aguanta preguntas de todo el planeta.
El resolver
Hay un cuarto actor que no está en el árbol, y es el que hace el trabajo.
Definición. Un resolver recursivo recibe preguntas de los clientes, las responde desde su cache si puede, y si no, recorre la jerarquía preguntándole a cada nivel. No tiene autoridad sobre ningún nombre: solo busca y recuerda.
Su computadora tiene un programa mínimo, el stub resolver, que solo sabe preguntarle al
resolver configurado. Ese resolver suele ser el de su proveedor o de su universidad, y su
dirección normalmente llega por DHCP. También hay resolvers públicos, como 8.8.8.8 y
1.1.1.1.
El único dato que el resolver necesita de fábrica son las direcciones de los servidores
raíz. A partir de ahí, descubre todo lo demás. Nuestro dns_resolver.py recibe la
dirección de la raíz como argumento.
Recursiva e iterativa
Hay dos maneras de preguntar:
- Consulta recursiva: “tráigame la respuesta final”. Es lo que le pide un cliente a su
resolver, con el bit
RD(recursion desired) en 1. - Consulta iterativa: “dígame lo que sepa”. Es lo que el resolver le pide a cada servidor de la jerarquía. Si el servidor no tiene la respuesta, devuelve una referral: una remisión a quienes saben más.
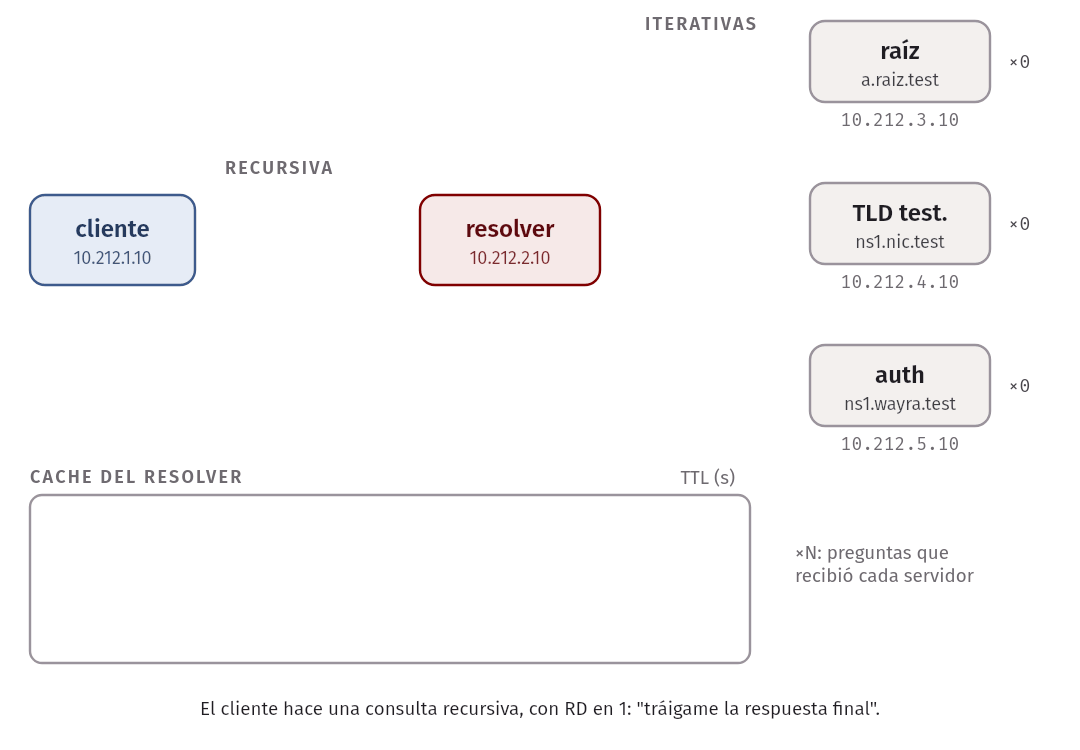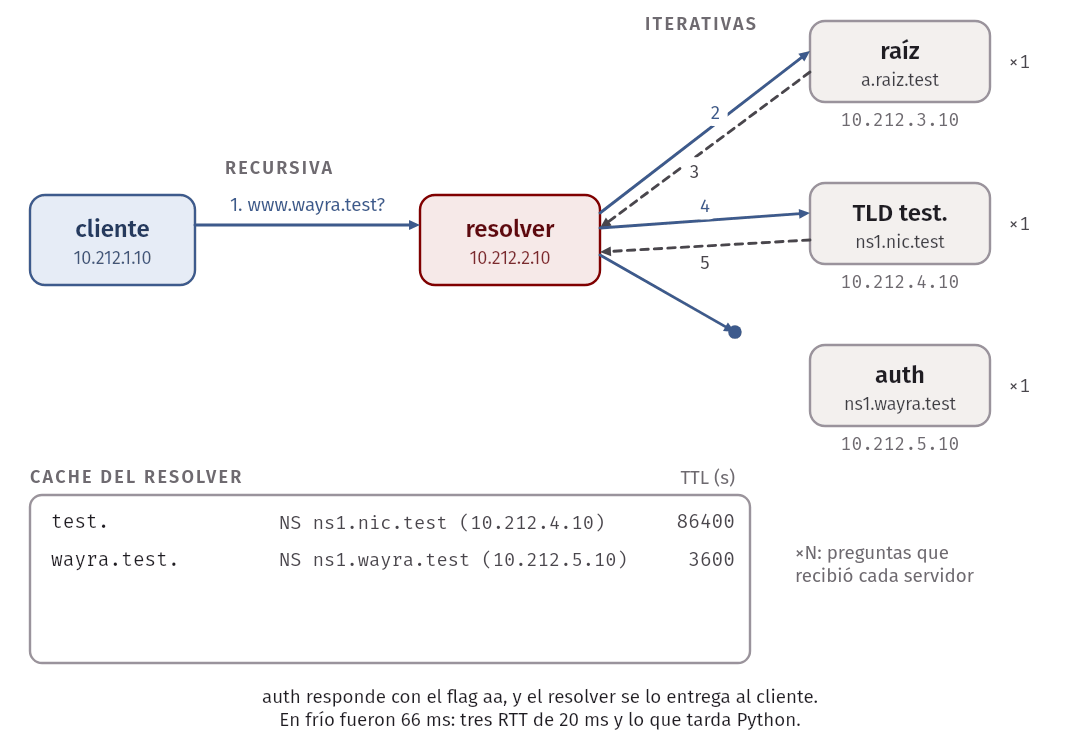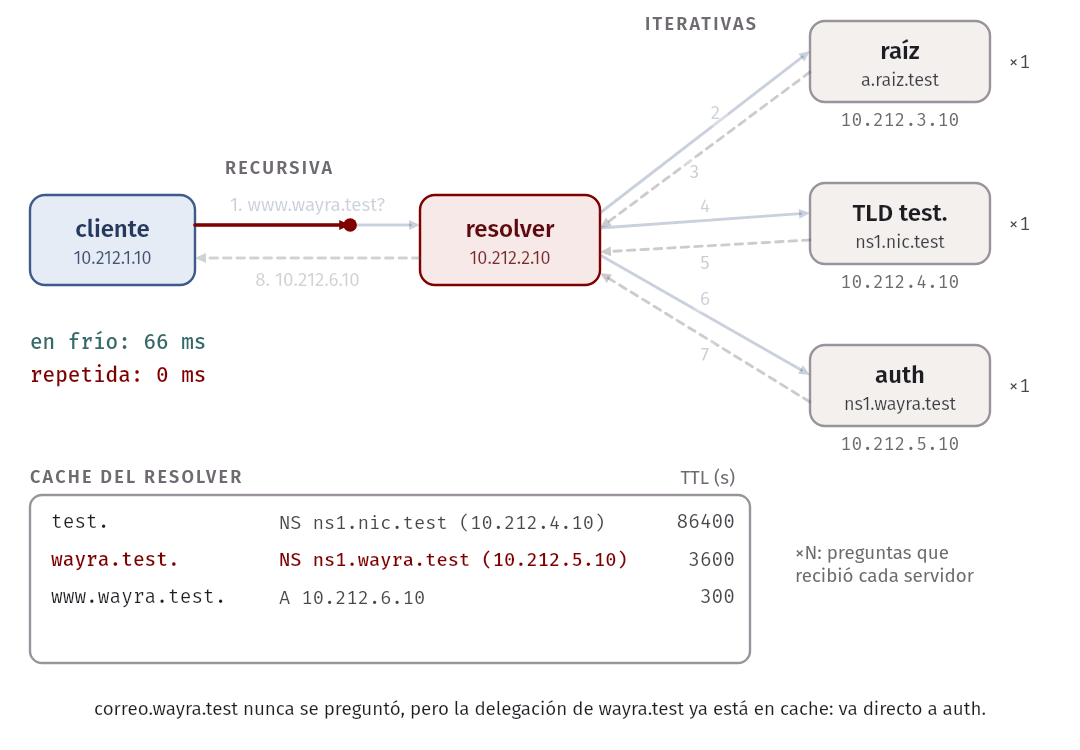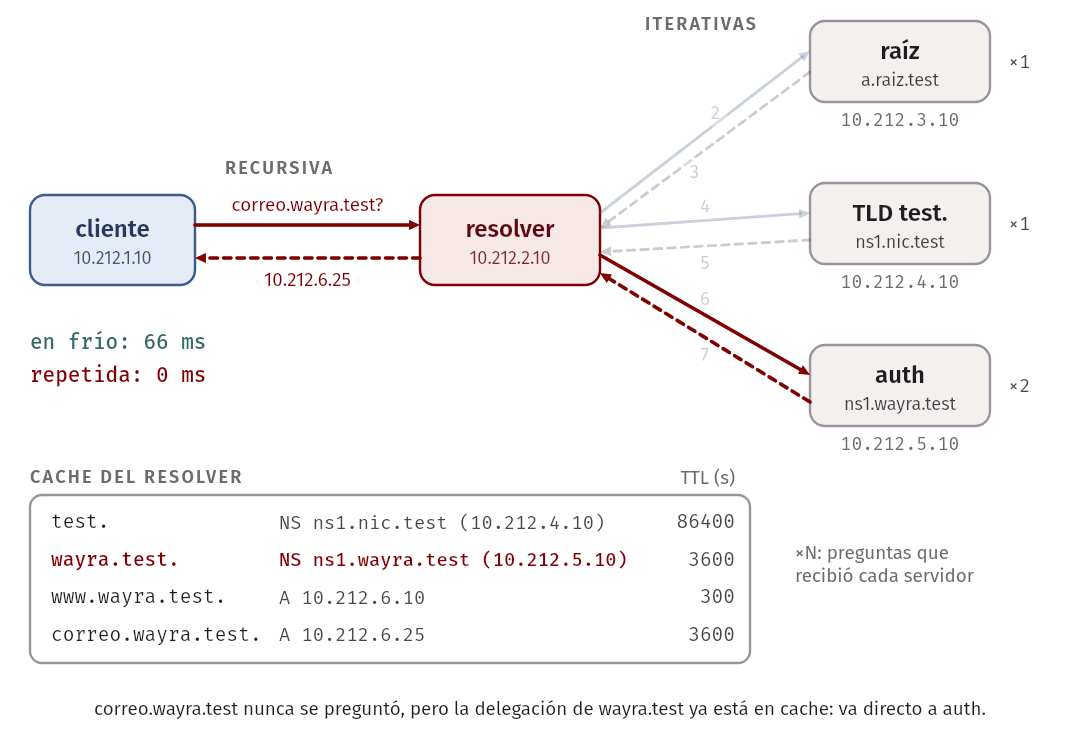
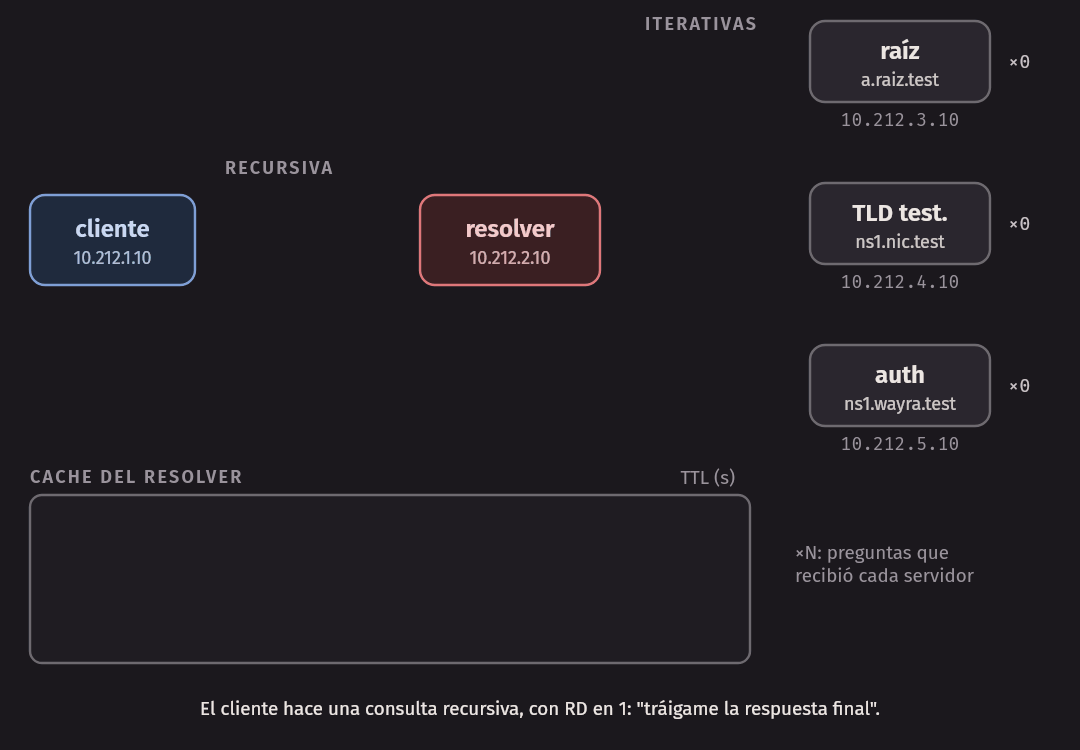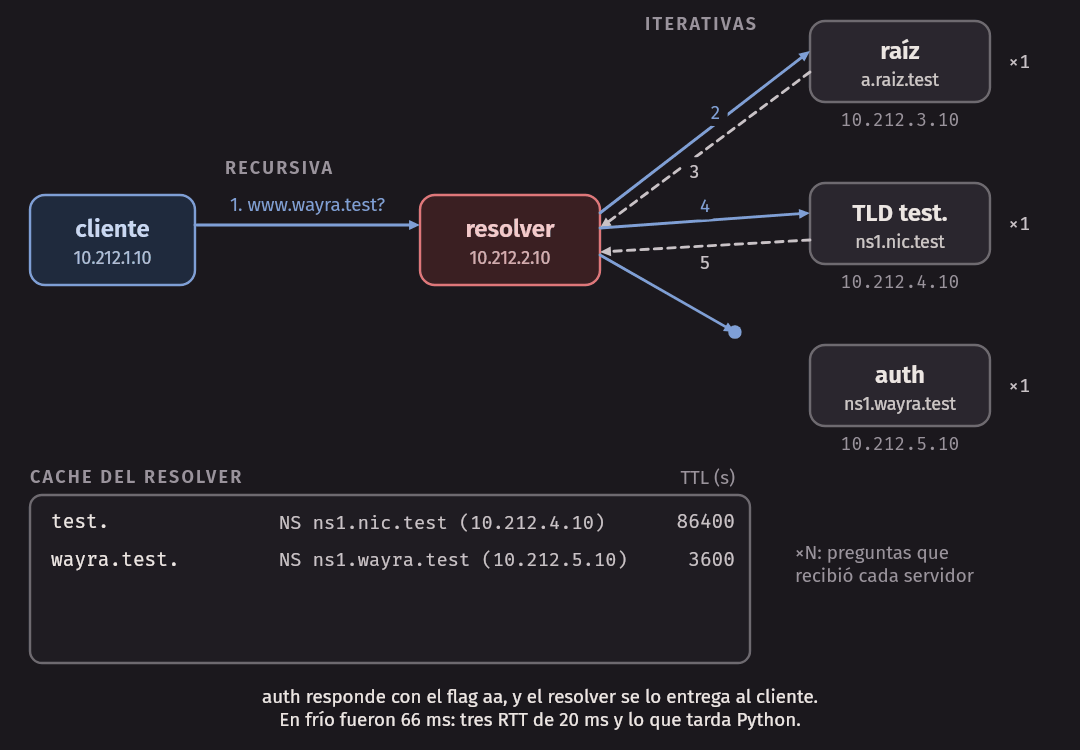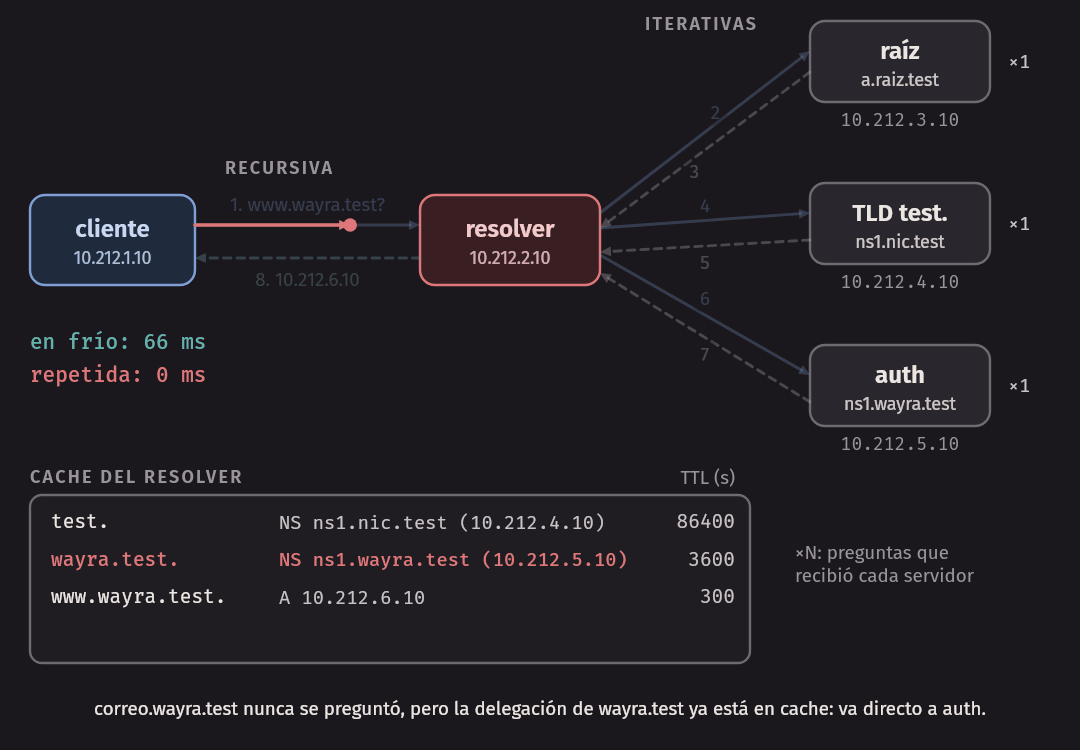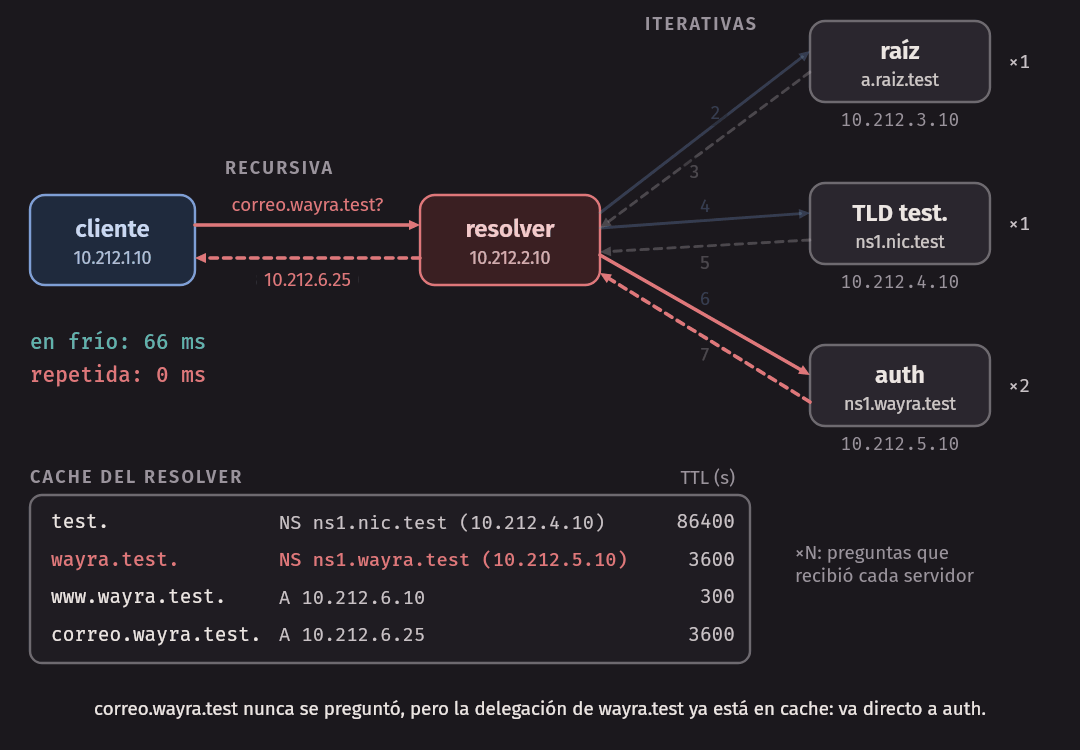
Para ver el recorrido real, seguimos el camino en nuestra red. dig +trace hace lo que
haría un resolver, y muestra cada paso. Esto se corre en cliente:
$ dig +trace www.wayra.test

; <<>> DiG 9.18.49 <<>> +trace www.wayra.test
;; global options: +cmd
.			86400	IN	NS	a.raiz.test.
;; Received 41 bytes from 10.212.2.10#53(10.212.2.10) in 44 ms

test.			86400	IN	NS	ns1.nic.test.
;; Received 70 bytes from 10.212.3.10#53(a.raiz.test) in 22 ms

wayra.test.		3600	IN	NS	ns1.wayra.test.
;; Received 66 bytes from 10.212.4.10#53(ns1.nic.test) in 22 ms

www.wayra.test.		300	IN	A	10.212.6.10
;; Received 48 bytes from 10.212.5.10#53(ns1.wayra.test) in 21 ms
Se lee de arriba abajo: el resolver le da la lista de raíces (.), la raíz manda a test.,
test. manda a wayra.test., y ese responde. Cada salto a un servidor cuesta unos 22 ms, los 20 de
netem más lo que tarda Python.
Ahora a mano, con +norecurse, pregunta por pregunta. Primero a la raíz:
$ dig @10.212.3.10 +norecurse www.wayra.test
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 48816
;; flags: qr; QUERY: 1, ANSWER: 0, AUTHORITY: 1, ADDITIONAL: 1

;; QUESTION SECTION:
;www.wayra.test.			IN	A

;; AUTHORITY SECTION:
test.			86400	IN	NS	ns1.nic.test.

;; ADDITIONAL SECTION:
ns1.nic.test.		86400	IN	A	10.212.4.10
Noten tres cosas. ANSWER: 0: no hay respuesta. No es un error: status: NOERROR. Y hay dos
secciones más: authority, que dice quién responde por test., y additional, que
regala la dirección de ese servidor. Con ella seguimos:
$ dig @10.212.4.10 +norecurse www.wayra.test
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 10521
;; flags: qr; QUERY: 1, ANSWER: 0, AUTHORITY: 1, ADDITIONAL: 1

;; AUTHORITY SECTION:
wayra.test.		3600	IN	NS	ns1.wayra.test.

;; ADDITIONAL SECTION:
ns1.wayra.test.		3600	IN	A	10.212.5.10
$ dig @10.212.5.10 +norecurse www.wayra.test
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 31625
;; flags: qr aa; QUERY: 1, ANSWER: 1, AUTHORITY: 0, ADDITIONAL: 0
;; ANSWER SECTION:
www.wayra.test. 300 IN A 10.212.6.10Aparece el flag aa, authoritative answer. Lo da solo quien administra la zona. Las
referrals anteriores no lo llevan, y las respuestas de un resolver tampoco.
Glue: un problema de huevo y gallina
Miren la delegación de wayra.test.: su servidor se llama ns1.wayra.test.. Para saber su
dirección hay que preguntarle a… el servidor de wayra.test., que es él mismo. Sin ayuda,
es un ciclo.
Definición. Un registro de glue es la dirección de un servidor de nombres, que la zona padre incluye junto con la delegación. Es indispensable cuando el nombre del servidor está dentro de la zona que se delega.
Lo probamos quitando el glue de la zona del TLD, en una delegación nueva. El padre dice quién responde, pero no cómo llegar:
$ dig @10.212.4.10 +norecurse www.killa.test +noall +authority +additional
killa.test.		3600	IN	NS	ns1.killa.test.

$ dig www.killa.test
;; ->>HEADER<<- opcode: QUERY, status: SERVFAIL, id: 53848
;; flags: qr rd ra; QUERY: 1, ANSWER: 0, AUTHORITY: 0, ADDITIONAL: 0
Si el servidor tiene un nombre de otra zona, el glue no hace falta: el resolver resuelve
ese nombre aparte, como cualquier otro. Lo comprobamos delegando killa.test. en un nombre
de wayra.test., sin glue, y la resolución funcionó: el log de auth muestra la pregunta
adicional por ese servidor.
Error común. Decir que un
SERVFAILsignifica que “el nombre no existe”. Son cosas distintas.NXDOMAINes una respuesta firme: el nombre no existe.SERVFAILdice que el resolver no pudo averiguarlo. Aquí, el nombre existe y hay un servidor que lo sabe, pero nadie puede llegar a él.
En el Internet real
Hagamos lo mismo con un nombre .pe, el 2 de noviembre de 2026, desde el contenedor:
$ dig +trace +nodnssec www.uni.edu.pe
.			4502	IN	NS	e.root-servers.net.
.			4502	IN	NS	l.root-servers.net.
                         (... las otras once letras ...)
;; Received 420 bytes from 192.168.65.7#53(192.168.65.7) in 103 ms

pe.			172800	IN	NS	a.lactld.org.
pe.			172800	IN	NS	pch.rcp.pe.
pe.			172800	IN	NS	pe1.dnsnode.net.
pe.			172800	IN	NS	quipu.rcp.net.pe.
;; Received 296 bytes from 199.7.83.42#53(l.root-servers.net) in 70 ms

uni.edu.pe.		3600	IN	NS	rngcyt.uni.edu.pe.
uni.edu.pe.		3600	IN	NS	rpcyt.uni.edu.pe.
uni.edu.pe.		3600	IN	NS	dns.uni.edu.pe.
;; Received 178 bytes from 204.61.216.85#53(pch.rcp.pe) in 6 ms

www.uni.edu.pe.		7200	IN	A	45.80.81.43
;; Received 59 bytes from 45.80.81.12#53(rngcyt.uni.edu.pe) in 8 ms
192.168.65.7 es el resolver interno de Docker Desktop; en su laptop verán otro. Noten que
el servidor de .pe que nos respondió entregó directamente la delegación de
uni.edu.pe., sin un paso aparte para edu.pe.. Eso no quiere decir que edu.pe. no sea una
zona. Tiene su propio SOA:
$ dig @quipu.rcp.net.pe +norecurse +noall +answer SOA edu.pe
edu.pe.			3600	IN	SOA	quipu.rcp.net.pe. operador.rcp.pe. 2026110221 1800 300 604800 1800
La atienden los mismos servidores que a pe., así que responden de una vez: un punto más en
el nombre no siempre es una consulta más. El árbol de nombres y las consultas que hace un
resolver no son lo mismo.
Los servidores de .pe también se pueden preguntar a mano, y traen su glue:
$ dig @199.7.83.42 +norecurse +noall +authority +additional www.uni.edu.pe A
pe.			172800	IN	NS	a.lactld.org.
pe.			172800	IN	NS	pch.rcp.pe.
pe.			172800	IN	NS	pe1.dnsnode.net.
pe.			172800	IN	NS	quipu.rcp.net.pe.
a.lactld.org.		172800	IN	A	200.0.68.10
pch.rcp.pe.		172800	IN	A	204.61.216.85
pe1.dnsnode.net.	172800	IN	A	194.146.106.82
quipu.rcp.net.pe.	172800	IN	A	200.1.176.4
Aquí se ven los dos casos de glue. pch.rcp.pe y quipu.rcp.net.pe están dentro de pe., así que
su glue es indispensable. a.lactld.org y pe1.dnsnode.net están en otras zonas: la raíz también
entrega sus direcciones, pero un resolver podría averiguarlas por su cuenta.
Cache y TTL
Si cada resolución recorriera la jerarquía, los servidores raíz no darían abasto y cada página tardaría mucho más. Por eso cada registro lleva un TTL (time to live): la cantidad de segundos durante los que se lo puede recordar.
Definición. El TTL de un registro es el tiempo máximo, en segundos, que un resolver puede guardarlo en cache. Lo decide quien administra la zona.
Error común. Confundirlo con el TTL del encabezado de IP. Tienen el mismo nombre, pero nada más. El de IP cuenta saltos y evita que un paquete dé vueltas para siempre. El de DNS cuenta segundos y dice cuánto dura un dato en cache.
Medimos el efecto de la cache con cuatro repeticiones, reiniciando el resolver antes de cada una para vaciarla. La primera columna es la pregunta en frío y la segunda, la repetición inmediata:
 en frío     repetida
  66 ms       0 ms
  66 ms       0 ms
  71 ms       1 ms
  66 ms       0 ms
Tres RTT de 20 ms dan 60 ms de piso, y el resto es Python. La primera consulta justo después de desplegar la red tardó bastante más, 129 y 132 ms en dos corridas, porque también paga el arranque de Python. Los logs de los servidores confirman la explicación: en la pregunta en frío, cada uno recibe una; en la repetida, ninguno. Estas son las últimas líneas de cada log, tras una consulta:
raiz:      udp 10.212.2.10:43857 id=14905 www.wayra.test. A -> NOERROR an=0 ns=1 ar=1
tld:       udp 10.212.2.10:42836 id=16337 www.wayra.test. A -> NOERROR an=0 ns=1 ar=1
auth:      udp 10.212.2.10:60289 id=30730 www.wayra.test. A -> NOERROR an=1 ns=0 ar=0
resolver:  10.212.1.10:46037 id=9193 www.wayra.test. A -> NOERROR an=1
La cache no guarda solo la respuesta final, sino también las delegaciones. Después de esa
consulta, al preguntar por correo.wayra.test el resolver va directo a auth, sin molestar
a la raíz ni al TLD. Así, los servidores de arriba reciben muchas menos preguntas de lo que
parece. La prueba test_after_learning_the_tld_a_new_name_skips_the_root lo comprueba.
Ver cómo baja el TTL
El registro rapido.wayra.test tiene un TTL de 4 segundos a propósito:
$ dig +noall +answer rapido.wayra.test      # primera vez
rapido.wayra.test.	4	IN	A	10.212.6.11
$ sleep 2; dig +noall +answer rapido.wayra.test
rapido.wayra.test.	2	IN	A	10.212.6.11
$ sleep 3; dig +noall +answer rapido.wayra.test
rapido.wayra.test.	4	IN	A	10.212.6.11
El número baja en el resolver: un TTL que llega a cero significa que ya no se puede usar, y
la tercera consulta lo vuelve a pedir al autoritativo. El log de auth muestra exactamente
dos preguntas por ese nombre.
En la práctica. En un resolver real, el TTL puede no bajar tan prolijamente. Le preguntamos dos veces a
8.8.8.8porwww.uni.edu.pe, separadas por 3 segundos, y vimos7123y luego2860. A1.1.1.1, tres veces en 6 segundos, y vimos7200las tres. Una sola dirección de un resolver público es un anycast con muchas máquinas detrás, y no sabemos a cuál de sus caches le toca cada pregunta. Por eso el ejemplo limpio lo hacemos en nuestra red.
Elegir el TTL
Es un compromiso entre dos costos:
| TTL | Ventajas | Riesgos |
|---|---|---|
| Corto (segundos a minutos) | Un cambio se nota rápido. Permite repartir tráfico y mudarse en caso de falla | Más preguntas, más carga en los autoritativos, y resoluciones más lentas. Si el autoritativo cae, los nombres dejan de resolver pronto |
| Largo (horas o días) | Menos carga y más rapidez. Aguanta una caída del autoritativo | Un error o una mudanza tarda en corregirse: el dato viejo sigue en caches del mundo entero |
La técnica habitual antes de una mudanza es bajar el TTL unos días antes, hacer el cambio, y volver a subirlo después.
Error común. Hablar de “propagación de DNS”, como si el cambio viajara por la red. Nada se propaga: cada resolver sigue usando su copia hasta que le venza el TTL, y recién ahí vuelve a preguntar. Quien cambia un registro con TTL de un día puede ver respuestas viejas durante hasta un día.
Respuestas negativas
“Este nombre no existe” también se guarda en cache. Si no, un nombre mal escrito haría repetir toda la consulta cada vez:
$ dig noexiste.wayra.test
;; ->>HEADER<<- opcode: QUERY, status: NXDOMAIN, id: 40207
;; flags: qr rd ra; QUERY: 1, ANSWER: 0, AUTHORITY: 1, ADDITIONAL: 0

;; AUTHORITY SECTION:
wayra.test.		60	IN	SOA	ns1.wayra.test. admin.wayra.test. 2026110201 3600 600 86400 60
El registro SOA en authority dice cuánto dura esta negativa: el menor entre su propio TTL y
su último campo, aquí 60 segundos. Hay una negativa más sutil: el nombre existe, pero no
tiene registros de ese tipo. Es NOERROR con ANSWER: 0, y a veces se la llama NODATA:
$ dig +noall +answer +comments wayra.test AAAA
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 20741
;; flags: qr rd ra; QUERY: 1, ANSWER: 0, AUTHORITY: 1, ADDITIONAL: 0
Registros
Un registro (resource record) tiene cinco campos: nombre, TTL, clase, tipo y datos. La
clase casi siempre es IN, de Internet. Por ejemplo:
 www.wayra.test.    300    IN    A    10.212.6.10
 nombre             TTL  clase  tipo  datos
Los tipos de esta semana:
| Tipo | Datos | Para qué |
|---|---|---|
| A | Una dirección IPv4 | Traducir un nombre |
| AAAA | Una dirección IPv6 | Lo mismo, en IPv6 |
| NS | El nombre de un servidor | Quién responde por esta zona |
| CNAME | Otro nombre | Este nombre es un alias de aquel |
| MX | Preferencia y nombre de un servidor | A quién entregarle el correo |
| TXT | Texto libre | Datos para otros sistemas |
| SOA | Datos de la zona | Inicio de autoridad. Sirve para la cache negativa, entre otras cosas |
Nuestra zona, red/zones/wayra.zone, está escrita en un formato simplificado:
wayra.test. 3600 SOA ns1.wayra.test. admin.wayra.test. 2026110201 3600 600 86400 60
wayra.test. 3600 NS ns1.wayra.test.
ns1.wayra.test. 3600 A 10.212.5.10
www.wayra.test. 300 A 10.212.6.10
www.wayra.test. 300 AAAA 2001:db8:212:6::10
blog.wayra.test. 300 CNAME www.wayra.test.
wayra.test. 3600 MX 10 correo.wayra.test.
correo.wayra.test. 3600 A 10.212.6.25
wayra.test. 3600 TXT "curso de redes: nombres de ejemplo"
Y así se ven al consultarlos:
$ dig +noall +answer www.wayra.test AAAA
www.wayra.test.		300	IN	AAAA	2001:db8:212:6::10
$ dig +noall +answer wayra.test NS
wayra.test.		3600	IN	NS	ns1.wayra.test.
$ dig +noall +answer wayra.test MX
wayra.test.		3600	IN	MX	10 correo.wayra.test.
$ dig +noall +answer wayra.test TXT
wayra.test.		3600	IN	TXT	"curso de redes: nombres de ejemplo"
$ dig +noall +answer blog.wayra.test
blog.wayra.test.	300	IN	CNAME	www.wayra.test.
www.wayra.test.		300	IN	A	10.212.6.10
Con un CNAME, el resolver sigue la cadena y devuelve las dos cosas: el alias y lo que encontró al final. En el MX, un número de preferencia menor significa más preferido. Veamos un caso real, el correo de la UNI, con varios servidores para tener respaldo:
$ dig +noall +answer uni.edu.pe MX
uni.edu.pe.		4502	IN	MX	5 ALT1.ASPMX.L.GOOGLE.COM.
uni.edu.pe.		4502	IN	MX	10 ALT4.ASPMX.L.GOOGLE.COM.
uni.edu.pe.		4502	IN	MX	5 ALT2.ASPMX.L.GOOGLE.COM.
uni.edu.pe.		4502	IN	MX	10 ALT3.ASPMX.L.GOOGLE.COM.
uni.edu.pe.		4502	IN	MX	1 ASPMX.L.GOOGLE.COM.
Ese mismo día, uni.edu.pe no devolvía ningún registro AAAA: no todos los nombres tienen
IPv6.
Error común. Creer que el MX da la dirección de correo de alguien o que apunta a una dirección IP. El MX da el nombre de un servidor, y ese nombre necesita su propio A o AAAA. Por eso nuestra zona tiene
correo.wayra.test.aparte. Tampoco se debe poner un CNAME donde ya hay otros registros: un nombre con CNAME no puede tener nada más, y por eso la raíz de un dominio, que siempre lleva NS y SOA, no puede ser un CNAME.
El mensaje de DNS, byte por byte
Preguntas y respuestas tienen el mismo formato, definido en la sección 4 del RFC 1035:
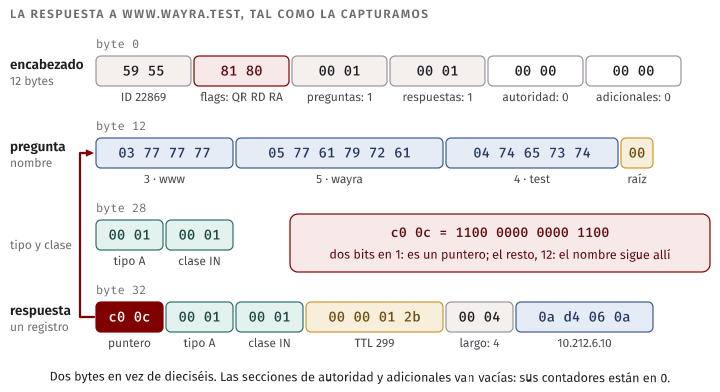
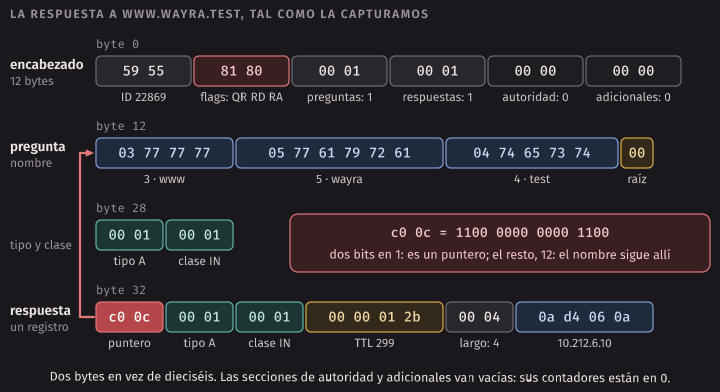
Para verlo sin ninguna biblioteca, dns_ask.c arma la pregunta a mano, campo por campo y en
orden de red, como dice la guía de estilo:
write_u16(query, id);
write_u16(query + 2, argc == 4 ? 0x0000 : 0x0100);  // RD pide recursión
write_u16(query + 4, 1);                            // una pregunta
int name_size = encode_name(argv[2], query + HEADER_SIZE, sizeof query - HEADER_SIZE - 4);
Mientras corre, capturamos en cliente:
$ /w12/bin/dns_ask 10.212.2.10 www.wayra.test
id=22869 qr=1 aa=0 tc=0 rd=1 ra=1 rcode=0
preguntas=1 respuestas=1 autoridad=0 adicionales=0
www.wayra.test. ttl=299 A 10.212.6.10
Y en la captura, leída con tshark -x, la pregunta y luego la respuesta, a partir del byte
0x2a, donde terminan los encabezados de Ethernet, IP y UDP:
pregunta (desde 0x2a):
                                 59 55 01 00 00 01
  00 00 00 00 00 00 03 77 77 77 05 77 61 79 72 61
  04 74 65 73 74 00 00 01 00 01

respuesta (desde 0x2a):
                                 59 55 81 80 00 01
  00 01 00 00 00 00 03 77 77 77 05 77 61 79 72 61
  04 74 65 73 74 00 00 01 00 01 c0 0c 00 01 00 01
  00 00 01 2b 00 04 0a d4 06 0a
Lo leemos:
| Bytes | Campo | Significado |
|---|---|---|
59 55 |
ID | 0x5955 = 22869, el mismo que imprimió dns_ask |
01 00 |
flags de la pregunta | Solo RD en 1 |
81 80 |
flags de la respuesta | QR, RD y RA en 1, rcode 0 |
00 01 |
preguntas | 1 |
03 77 77 77 |
etiqueta | Largo 3 y www |
05 77 61 79 72 61 |
etiqueta | Largo 5 y wayra |
04 74 65 73 74 00 |
etiqueta y fin | Largo 4, test, y el 0 de la raíz |
00 01 00 01 |
tipo y clase | A e IN |
c0 0c |
nombre en la respuesta | Un puntero |
00 00 01 2b |
TTL | 299 |
00 04 |
largo de los datos | 4 bytes |
0a d4 06 0a |
dirección | 10.212.6.10 |
Una lección de formato: los nombres van con el largo delante de cada etiqueta, no con
puntos. Y c0 0c es compresión: los dos primeros bits en 1 indican un puntero, y el resto
es la posición donde sigue el nombre. 0x0c es 12, justo después del encabezado, donde ya
estaba escrito. Dos bytes en vez de dieciséis.
Esto se presta a errores graves: un puntero que apunta a sí mismo haría entrar en un ciclo sin
fin a un programa descuidado. Nuestro decode_name solo acepta punteros hacia atrás, y hay una
prueba que lo verifica. La regla es general: nunca confíen en lo que llega de la red.
También comprobamos que dig y la captura dicen lo mismo, con otra consulta. El ID 64226
que muestra dig es el 0xfae2 que muestra tshark:
$ dig blog.wayra.test +noall +comments +answer
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 64226
;; flags: qr rd ra; QUERY: 1, ANSWER: 2, AUTHORITY: 0, ADDITIONAL: 0

$ tshark -r dns.pcap -T fields -e dns.id -e dns.flags.response -e dns.qry.name -e dns.a -e dns.cname
0xfae2	False	blog.wayra.test
0xfae2	True	blog.wayra.test	10.212.6.10	www.wayra.test
Por qué UDP, y cuándo TCP
DNS corre sobre el puerto 53, normalmente en UDP. La razón es la que vimos en la semana 9: una pregunta y una respuesta chicas. Con TCP habría que gastar un RTT de handshake antes de preguntar, y un resolver tendría que guardar el estado de miles de conexiones. Si se pierde un datagrama, el cliente vuelve a preguntar después de un timeout. Como la operación no cambia nada en el servidor, repetir es inofensivo: la confiabilidad la pone la aplicación, y le sale barata.
El límite histórico es de 512 bytes por UDP (RFC 1035). ¿Y si la respuesta no cabe? El servidor
manda lo que puede, marca el flag TC (truncated), y el cliente repite por TCP, también en el
puerto 53. Nuestro registro grande.wayra.test existe para eso. Sin dejar que dig reintente:
$ dig @10.212.5.10 grande.wayra.test TXT +ignore
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 23888
;; flags: qr aa tc rd; QUERY: 1, ANSWER: 0, AUTHORITY: 0, ADDITIONAL: 0
Y dejándolo, a través del resolver:
$ dig grande.wayra.test TXT
;; Truncated, retrying in TCP mode.
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 46062
;; SERVER: 10.212.2.10#53(10.212.2.10) (TCP)
;; MSG SIZE  rcvd: 1774
El log de auth muestra los dos intentos del resolver, primero por UDP y después por TCP:
udp 10.212.2.10:42285 id=32547 grande.wayra.test. TXT -> NOERROR an=1 ns=0 ar=0 TC (1774 bytes)
tcp 10.212.2.10:50308 id=29817 grande.wayra.test. TXT -> NOERROR an=1 ns=0 ar=0
Por TCP, cada mensaje lleva adelante su largo en 2 bytes. Es el “largo al inicio” que vimos en la semana 2: un stream no conserva los límites de los mensajes, y hay que marcarlos.
En la práctica. Hoy, 512 bytes es poco. EDNS es una extensión con la que el cliente anuncia que acepta respuestas más grandes por UDP. El
[1au]que muestratcpdumpen las preguntas dediges ese registro adicional, de tipo OPT. Una respuesta muy grande por UDP se puede fragmentar en IP, y varios fragmentos se pierden o se filtran con más facilidad. Por eso los valores que se usan hoy rondan los 1232 bytes, y se recurre a TCP para lo demás. Un servidor de DNS que bloquea el puerto 53 de TCP en su firewall está mal configurado: fallará justamente con las respuestas grandes. Nuestros servidores no implementan EDNS, y un servidor sin EDNS puede contestar sin él.
Ataques a DNS
El protocolo se diseñó en una red donde todos se conocían. Una respuesta de DNS no trae ninguna prueba de quién la escribió, y por UDP no hay handshake: cualquiera puede mandar un datagrama con la dirección de origen de otro (spoofing). Esto abre varios problemas.
Envenenamiento de cache
Definición. El envenenamiento de cache ocurre cuando un resolver acepta y guarda una respuesta falsa. A partir de ahí, todos sus clientes reciben la dirección equivocada hasta que venza el TTL.
La idea del ataque es una carrera. Un resolver le hace una pregunta a un autoritativo y queda esperando. Durante esos milisegundos, un atacante intenta que le llegue una respuesta falsa antes que la verdadera, con la dirección de origen del autoritativo. Lo que protege al resolver es lo que el atacante no puede ver si no está en el camino: una respuesta solo se acepta si coincide en los datos de la pregunta.
Este es el chequeo de nuestro resolver, en dns_resolver.py:
if peer[0] != server or not reply.flags & w.FLAG_QR or reply.msg_id != msg_id:
    return False
if len(reply.question) != 1:
    return False
name, rtype = reply.question[0]
return w.normalize(name) == w.normalize(question[0]) and rtype == question[1]
Y el puerto lo revisa el kernel, porque el socket está conectado al servidor.
Veamos cuánto aporta cada campo. El atacante conoce el nombre (a veces lo provoca él mismo, pidiéndolo) y las direcciones. Le falta adivinar:
| Lo que adivina | Combinaciones | Si manda 1000 respuestas falsas en la carrera |
|---|---|---|
| Solo el ID, 16 bits, con puerto fijo | 65 536 | 1000 / 65 536 = 1,5 % |
| ID y puerto al azar, entre 32768 y 60999 | 65 536 × 28 232 = 1 850 212 352 | 1000 / 1 850 212 352 = 0,000054 % |
El rango de puertos es el que usa por defecto el kernel de nuestros nodos
(/proc/sys/net/ipv4/ip_local_port_range da 32768 60999).
Esto se ve en una captura en resolver, con cuatro preguntas seguidas hacia auth. Cambian
tanto el puerto de origen como el ID:
IP 10.212.2.10.52220 > 10.212.5.10.53: 27211 A? uno.wayra.test. (32)
IP 10.212.2.10.58027 > 10.212.5.10.53: 39509 A? dos.wayra.test. (32)
IP 10.212.2.10.51143 > 10.212.5.10.53: 51393 A? tres.wayra.test. (33)
IP 10.212.2.10.33632 > 10.212.5.10.53: 20125 A? cuatro.wayra.test. (35)
Hay otra defensa, más antigua: la regla de bailiwick. Un servidor solo tiene autoridad sobre su
zona, así que nuestro resolver descarta las direcciones de nombres que estén fuera de la zona
delegada (usable_glue). Sin esa regla, cualquier respuesta podría colar de paso un dato sobre un
banco. Y mientras un dato esté en cache no hay pregunta y no hay carrera, de modo que el TTL parecía
limitar los intentos a uno cada tanto.
En 2008, Dan Kaminsky mostró cómo saltarse ese límite respetando el bailiwick. Se provocan preguntas por nombres inventados y distintos de un mismo dominio, que nunca están en cache, y la respuesta falsificada trae en su sección de autoridad una delegación falsa de ese mismo dominio. Como el dato pertenece a la zona, pasa el chequeo. Con el TTL fuera del camino, solo quedaba el tamaño de lo que había que adivinar, y por eso los resolvers del mundo adoptaron rápidamente el puerto al azar.
Idea clave. El ID y el puerto al azar no autentican nada. Solo hacen muy difícil adivinar, y solo frente a quien no ve el tráfico. Quien está en el camino, por ejemplo en una red Wi-Fi abierta, ve el ID y el puerto, y puede responder primero sin adivinar nada. Para eso hace falta criptografía.
DNSSEC: autenticar
DNSSEC agrega firmas digitales a los registros. Cada zona firma sus registros (RRSIG) con una clave que publica (DNSKEY). La zona padre firma un resumen de la clave de la hija (DS), y así se forma una cadena hasta la raíz, cuya clave ya conoce el resolver que valida. Una respuesta falsa no tendría una firma válida, sin importar por dónde llegue.
Lo vemos con un resolver público. El flag ad significa authenticated data, y la respuesta
trae su firma:
$ dig @1.1.1.1 +dnssec +noall +comments +answer pe. SOA
;; flags: qr rd ra ad; QUERY: 1, ANSWER: 2, AUTHORITY: 0, ADDITIONAL: 1
pe.			3600	IN	SOA	quipu.rcp.net.pe. operador.rcp.pe. 2026110208 1800 300 604800 1800
pe.			3600	IN	RRSIG	SOA 8 1 3600 20261202125006 20261102125006 37239 pe. tcLfh75sKDrqiRfuy0tc5JI3OOb...
delv valida la cadena por su cuenta, y hace ver que no todas las zonas están firmadas:
$ delv @1.1.1.1 pe. SOA
; fully validated
$ delv @1.1.1.1 uni.edu.pe. A
; unsigned answer
uni.edu.pe.		7200	IN	A	45.80.81.43
.pe está firmada; uni.edu.pe, ese día, no. DNSSEC solo protege lo que se firmó.
DoH y DoT: cifrar
Lo que autentica no oculta, y lo que oculta no autentica. DoT (DNS sobre TLS, puerto 853) y DoH (DNS sobre HTTPS, puerto 443) cifran el camino entre el cliente y el resolver. Veremos TLS la próxima semana; por ahora basta saber que quien mira la red ya no puede leer los mensajes.
Error común. Creer que DNSSEC da privacidad. Solo autentica las respuestas: la consulta sigue viajando sin cifrar. El RFC 4033 lo dice explícitamente. Aquí capturamos la consulta DNSSEC de arriba, en el contenedor. El nombre se lee sin ningún problema, a pesar de la firma:
eth0  Out IP 192.168.65.3.61050 > 1.1.1.1.53: 29822+ [1au] SOA? pe. (43)
eth0  In  IP 1.1.1.1.53 > 192.168.65.3.61050: 29822$ 2/0/1 SOA, RRSIG (384)
La misma pregunta por DoH, con dig +https. Da la respuesta y usa otro puerto:
$ dig @1.1.1.1 +https +noall +answer +stats pe. SOA
pe.			3600	IN	SOA	quipu.rcp.net.pe. operador.rcp.pe. 2026110209 1800 300 604800 1800
;; SERVER: 1.1.1.1#443(1.1.1.1) (HTTPS)
Durante esa consulta, los 22 paquetes capturados hacia y desde 1.1.1.1 fueron TCP al puerto
443, y ninguno al 53. Se ve el handshake y se ven los tamaños, pero no el nombre.
Tampoco es privacidad total. El observador todavía ve a qué dirección se conecta después, y el resolver ve todas sus consultas: con DoH, ustedes eligen en quién confiar, no dejan de confiar. Lo comparamos en una tabla:
| Autentica la respuesta | Cifra la consulta | Contra quién protege | |
|---|---|---|---|
| ID y puerto al azar | No | No | Un atacante que está fuera del camino |
| DNSSEC | Sí, de extremo a extremo | No | Respuestas falsas, vengan de donde vengan |
| DoT y DoH | Solo el canal hasta el resolver | Sí, hasta el resolver | Quien observa o altera la red local |
Son complementarios: un resolver puede validar DNSSEC y a la vez responder por DoH.
Otros problemas
- Amplificación: se manda una pregunta chica con la dirección de origen falsificada, la de la
víctima, y un servidor le manda a ella una respuesta mucho más grande. En la respuesta
.pede arriba, la pregunta tuvo 43 bytes de DNS y la respuesta 384. Por eso un resolver no debe aceptar preguntas de todo Internet. - Ataques a la infraestructura: los servidores de DNS son un objetivo atractivo para un DoS. El anycast y la cache son las defensas principales.
- DNS como punto único: en la semana 7, el incidente de Facebook mostró que un nombre perfecto no sirve si nadie puede llegar a sus servidores.
HTTP: petición y respuesta
Empieza la Sesión B. HTTP es un protocolo de petición y respuesta entre un cliente y un servidor,
sobre un transporte confiable. Sus mensajes de HTTP/1.1 son texto, y se pueden escribir a mano.
Con el servidor mini_web.py en la dirección 10.212.6.10, usamos nc y mandamos cada línea con
su \r\n:
$ printf 'GET / HTTP/1.1\r\nHost: www.wayra.test\r\n\r\n' | nc -w1 10.212.6.10 80
HTTP/1.1 200 OK
Server: mini_web
Date: Mon, 02 Nov 2026 14:50:16 GMT
ETag: "d8a8038111f4"
Cache-Control: max-age=60
Content-Type: text/html
Content-Length: 67

<html><img src=/a.png><img src=/b.png><img src=/c.png>wayra</html>
Esa es toda la web. La forma general:
 petición                                respuesta
 GET / HTTP/1.1            línea inicial HTTP/1.1 200 OK
 Host: www.wayra.test      headers       Content-Type: text/html
 Accept: */*                             Content-Length: 67
 (línea vacía)             separador     (línea vacía)
 (cuerpo, si hay)          cuerpo        <html>...
La línea vacía termina los headers. Y un cuerpo se separa del siguiente mensaje con
Content-Length: como TCP es un stream de bytes, sin esa cuenta el receptor no sabría dónde
termina. Es el problema de los límites de mensaje, otra vez. (Si el tamaño no se conoce al inicio,
HTTP/1.1 tiene Transfer-Encoding: chunked, que manda pedazos con el largo delante.)
Métodos
| Método | Para qué | Seguro | Idempotente |
|---|---|---|---|
GET |
Traer un recurso | Sí | Sí |
HEAD |
Lo mismo, solo los headers | Sí | Sí |
POST |
Mandar datos para que se procesen | No | No |
PUT |
Reemplazar un recurso | No | Sí |
DELETE |
Borrar un recurso | No | Sí |
Seguro significa que no pretende cambiar nada en el servidor. Idempotente significa que
repetirlo tiene el mismo efecto que hacerlo una vez. Importa en una red que pierde cosas: si se
corta la conexión antes de la respuesta, un GET se puede repetir sin miedo, pero repetir un
POST puede pagar dos veces la misma compra. Es la misma razón por la que repetir una pregunta
de DNS es inofensivo.
HEAD devuelve los mismos headers, sin cuerpo, con Content-Length diciendo cuánto habría sido:
$ curl -sI http://www.wayra.test/
HTTP/1.1 200 OK
Server: mini_web
Date: Mon, 02 Nov 2026 14:54:04 GMT
ETag: "d8a8038111f4"
Cache-Control: max-age=60
Content-Type: text/html
Content-Length: 67
Códigos de estado
El primer dígito da la clase; el cliente puede actuar con solo verlo:
| Clase | Significado | Ejemplos |
|---|---|---|
1xx |
Información, sigue | 101 Switching Protocols |
2xx |
Salió bien | 200 OK, 204 No Content |
3xx |
Hay que hacer algo más | 301 Moved Permanently, 304 Not Modified |
4xx |
Error de quien pidió | 400 Bad Request, 404 Not Found, 405 Method Not Allowed |
5xx |
Error del servidor | 500 Internal Server Error, 501 Not Implemented, 503 Service Unavailable |
Dos respuestas reales de mini_web:
$ printf 'GET /nada HTTP/1.1\r\nHost: a\r\n\r\n' | nc -w1 10.212.6.10 80
HTTP/1.1 404 Not Found
Server: mini_web
Date: Mon, 02 Nov 2026 14:54:04 GMT
Content-Length: 10

no existe

$ printf 'DELETE / HTTP/1.1\r\nHost: a\r\n\r\n' | nc -w1 10.212.6.10 80
HTTP/1.1 501 Unsupported method ('DELETE')
Server: mini_web
Date: Mon, 02 Nov 2026 14:54:04 GMT
Connection: close
No confundan 501 con 405. 501 significa que el servidor no implementa ese método en absoluto.
405 significa que lo conoce, pero que este recurso no lo permite, y debe decir cuáles sí con un
header Allow.
Para qué sirve Host
Una sola dirección IP puede servir muchos sitios. Como en el transporte solo viajan direcciones y
puertos, el servidor no sabría cuál de ellos quieren si la petición no lo dijera. Por eso HTTP/1.1
agrega el header Host:
$ printf 'GET / HTTP/1.1\r\nHost: blog.wayra.test\r\n\r\n' | nc -w1 10.212.6.10 80
HTTP/1.1 200 OK
Server: mini_web
Date: Mon, 02 Nov 2026 14:42:10 GMT
ETag: "f15455512b1f"
Cache-Control: max-age=60
Content-Type: text/html
Content-Length: 37

<html>el blog, en la misma IP</html>
Es la misma dirección y el mismo puerto de antes, con otra página. ¿Y si falta Host? El RFC 9112
es claro en su sección 3.2: un servidor debe responder 400 a una petición HTTP/1.1 sin Host.
Probemos con un servidor real, desde el contenedor:
$ printf 'GET / HTTP/1.1\r\n\r\n' | nc -w3 example.com 80
HTTP/1.1 400 Bad Request
Server: cloudflare
Date: Mon, 02 Nov 2026 14:45:14 GMT
Content-Type: text/html
Content-Length: 155
Connection: close
Y con el nuestro:
$ printf 'GET / HTTP/1.1\r\n\r\n' | nc -w1 10.212.6.10 80
HTTP/1.1 200 OK
Server: mini_web
Date: Mon, 02 Nov 2026 14:42:10 GMT
ETag: "d8a8038111f4"
Cache-Control: max-age=60
Content-Type: text/html
Content-Length: 67
mini_web no cumple el estándar, a propósito: http.server de Python no revisa eso, y es un
programa de juguete. Es un buen recordatorio. Que un servidor le conteste algo a un cliente no
demuestra que ninguno de los dos cumpla el protocolo. Un programa que se publica en la red debe
validar lo que recibe, y eso va a importar en su proyecto.
HTTP no guarda estado; las cookies sí
Definición. HTTP es un protocolo sin estado (stateless): cada petición se entiende sola, y el servidor no necesita recordar nada de las anteriores para responderla.
Esto simplifica mucho un servidor: se puede reiniciar o reemplazar por otro, y pueden atender miles de clientes sin guardar nada de cada uno. Pero una tienda necesita saber de quién es un carrito.
Una cookie resuelve eso sin cambiar el principio: el servidor pide guardar un dato con
Set-Cookie, y el cliente lo devuelve en cada petición siguiente con Cookie. El estado viaja en
los mensajes.
$ curl -s -D- http://www.wayra.test/visitas
HTTP/1.1 200 OK
Server: mini_web
Date: Mon, 02 Nov 2026 14:54:04 GMT
Set-Cookie: visitas=1; Path=/
Cache-Control: no-store
Content-Length: 9

visita 1

$ curl -s -H 'Cookie: visitas=7' http://www.wayra.test/visitas
visita 8
El servidor nos creyó el 7 sin discutir. Ese es el punto de seguridad: el cliente puede mandar lo
que quiera, y por eso una cookie real no suele llevar el dato, sino un identificador largo al azar
de una sesión que el servidor guarda aparte. Las cookies también sirven para seguir a alguien de un
sitio a otro: por ahí viene la discusión sobre privacidad.
Error común. Decir que una cookie vuelve a HTTP un protocolo con estado. El protocolo sigue igual, y cada petición se entiende sola. El estado lo llevan la aplicación y el cliente.
Cuánto cuesta una página
Una página no es un archivo: es un HTML que referencia otros objetos. La nuestra tiene tres imágenes, y son cuatro objetos en total. ¿Cuánto tarda bajarla? Contemos con RTT, sin contar el tiempo de transmisión, que para objetos chicos es despreciable.
Un objeto por TCP nuevo cuesta 2 RTT: uno para el handshake (el ACK final ya puede llevar la petición) y otro para la petición y su respuesta.
 cliente                           servidor
    |---------- SYN ---------------->|   \
    |<--------- SYN+ACK -------------|    | 1 RTT: la conexión
    |---------- ACK + GET ---------->|   /\
    |<--------- 200 OK + datos ------|     | 1 RTT: el primer byte
Lo comprobamos con curl -w, que separa las etapas. El RTT hacia web es de 50 ms:
$ curl -s -o /dev/null -H 'Connection: close' \
    -w 'dns=%{time_namelookup} con=%{time_connect} ttfb=%{time_starttransfer} total=%{time_total} conexiones=%{num_connects}\n' \
    http://www.wayra.test/
dns=0.024310 con=0.076927 ttfb=0.128040 total=0.128072 conexiones=1
dns=0.000710 con=0.052951 ttfb=0.104767 total=0.104800 conexiones=1
dns=0.000939 con=0.052268 ttfb=0.104289 total=0.104319 conexiones=1
Hay que leer los tiempos como acumulados desde el inicio, no como duraciones separadas. En todas las líneas, la conexión toma unos 52 ms y el primer byte llega unos 52 ms después: exactamente 1 RTT y 2 RTT, más lo que tome resolver el nombre.
¿Y los 24 ms de resolución de la primera línea, de tres corridas seguidas? El registro A ya estaba en
cache. Pero curl pregunta por A y también por AAAA, y el AAAA no estaba. Lo comprobamos repitiendo en
una red recién levantada: primero un dig del registro A, luego curl, y el log de auth muestra una
pregunta de cada tipo. La primera resolución volvió a tardar 25 ms, y las siguientes, un milisegundo.
udp 10.212.2.10:33316 id=63411 www.wayra.test. A -> NOERROR an=1 ns=0 ar=0
udp 10.212.2.10:51867 id=33834 www.wayra.test. AAAA -> NOERROR an=1 ns=0 ar=0
No persistente contra persistente
Definición. Con conexiones no persistentes, cada objeto usa su propia conexión TCP, que se
cierra al terminar. Con conexiones persistentes, la misma conexión queda abierta para varias
peticiones. HTTP/1.1 usa persistentes por defecto; para cerrar, alguien lo pide con Connection: close.
Con el HTML y 3 imágenes, de a uno:
| Modo | Cuenta | RTT | Con 50 ms de RTT |
|---|---|---|---|
| No persistente | 4 objetos × 2 RTT | 8 | 400 ms |
| Persistente | 1 RTT de conexión + 4 × 1 RTT | 5 | 250 ms |
Medimos los dos. Con -H 'Connection: close', y cuatro curl separados, y luego con un solo curl
y cuatro direcciones, que reutiliza la conexión. Tres corridas, sumando los tiempos de cada objeto:
separadas=0.419766 persistente=0.259841
separadas=0.435746 persistente=0.268202
separadas=0.429272 persistente=0.262072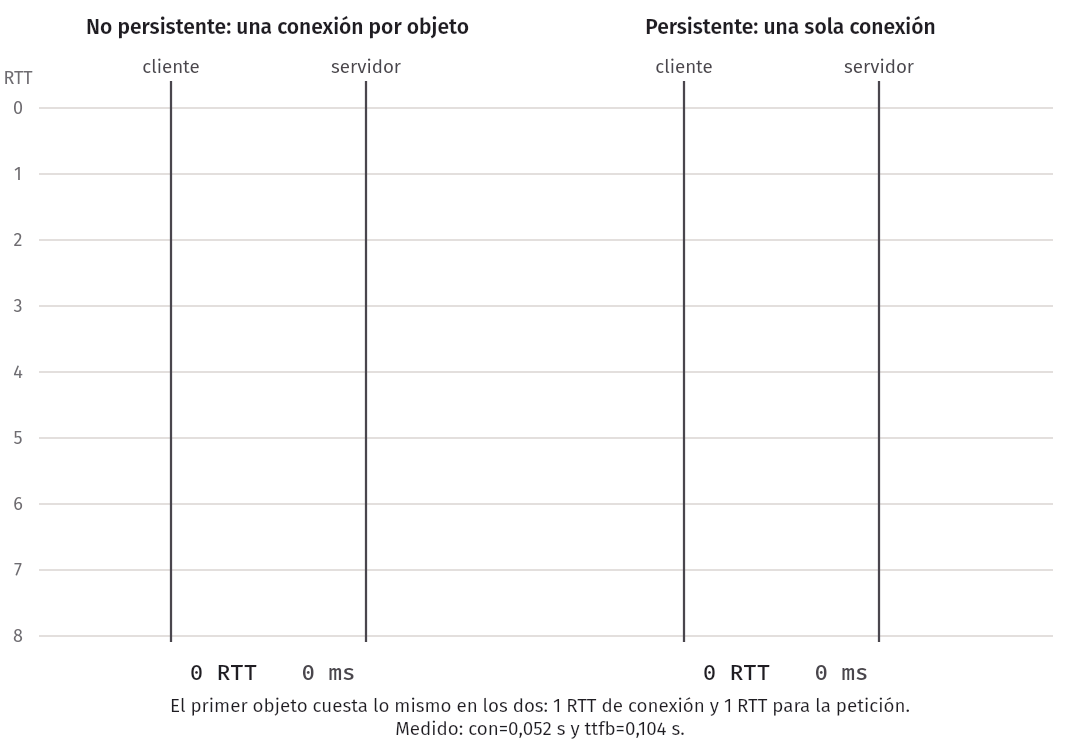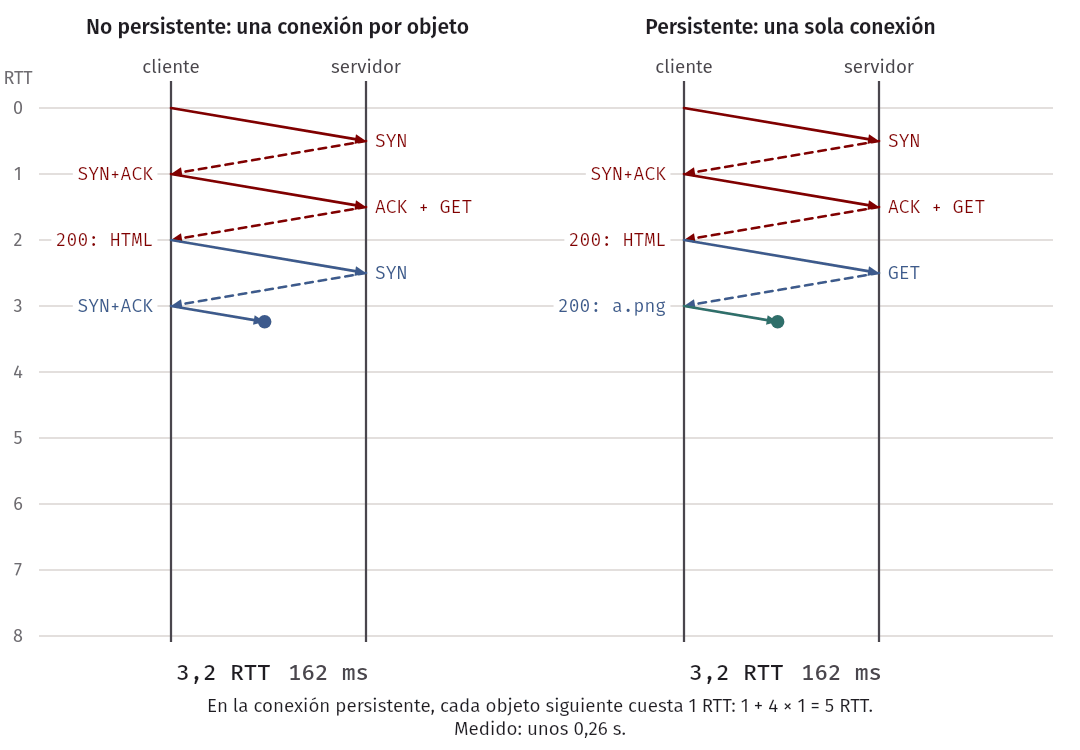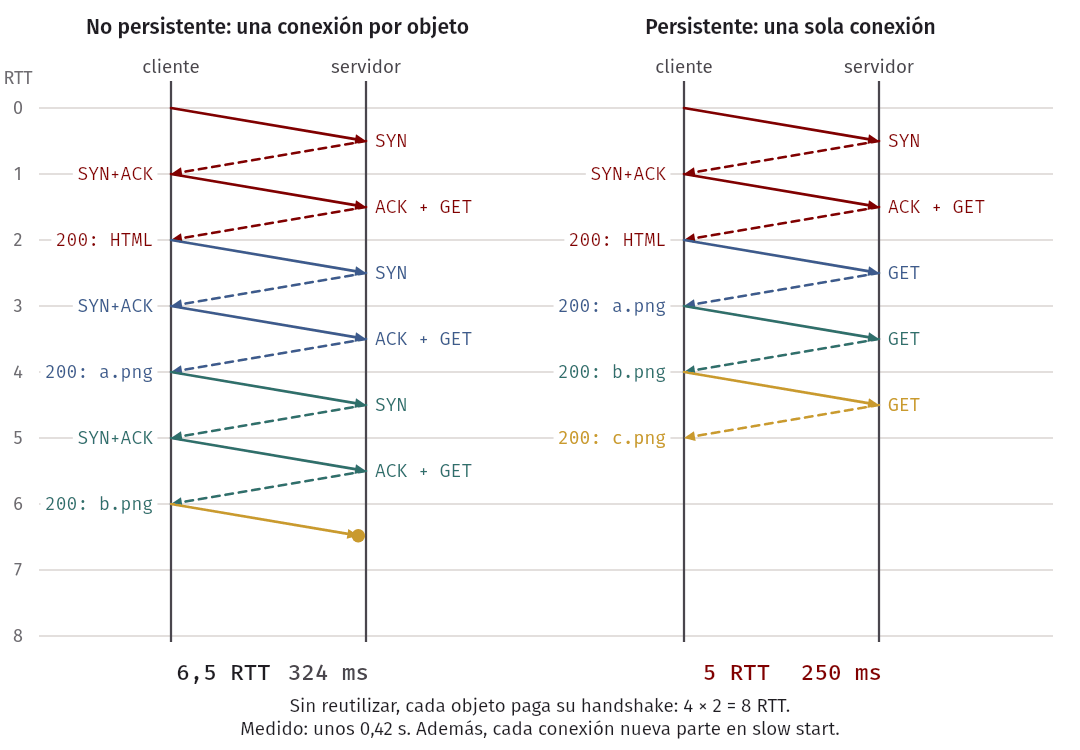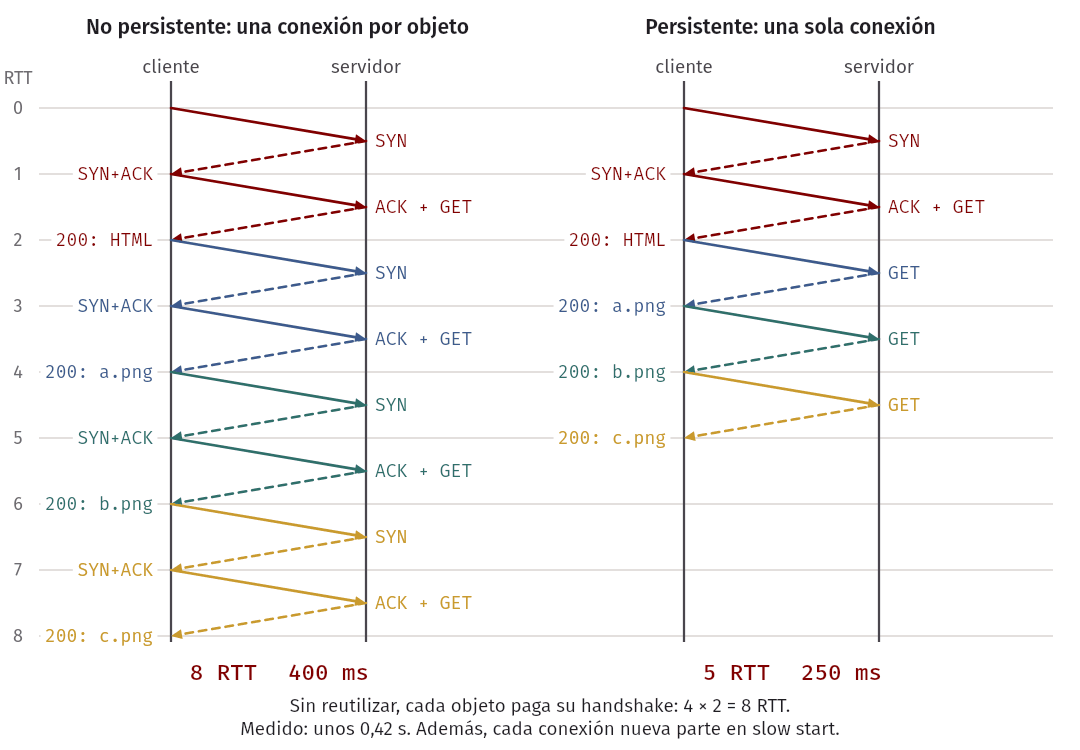
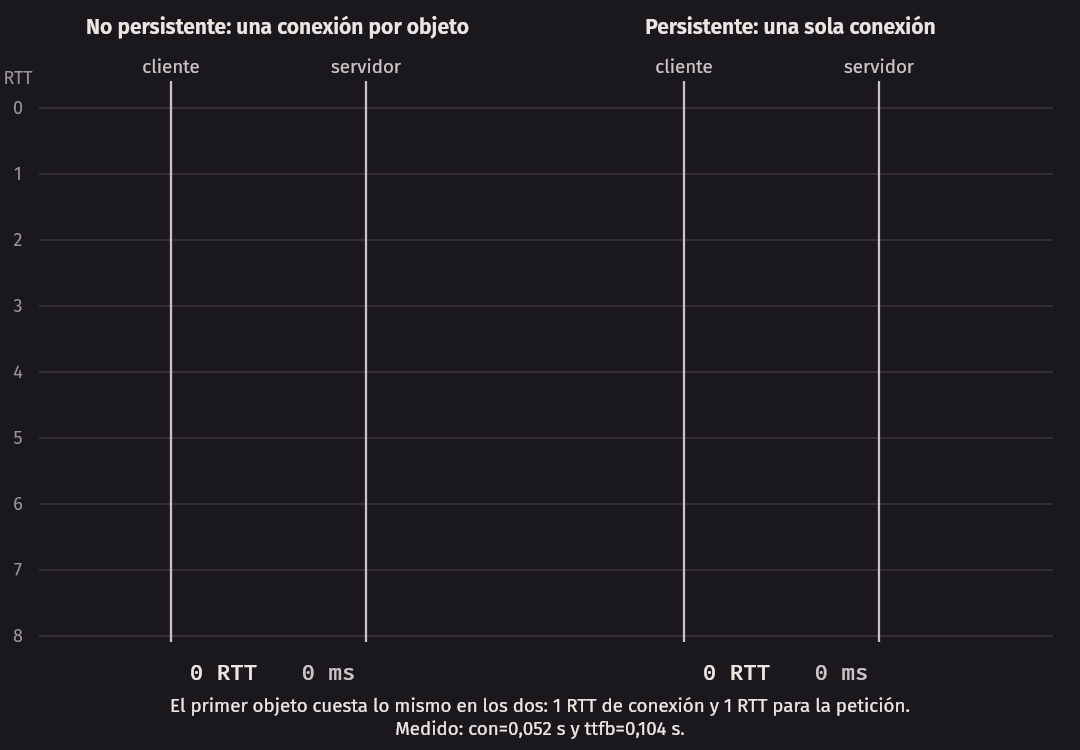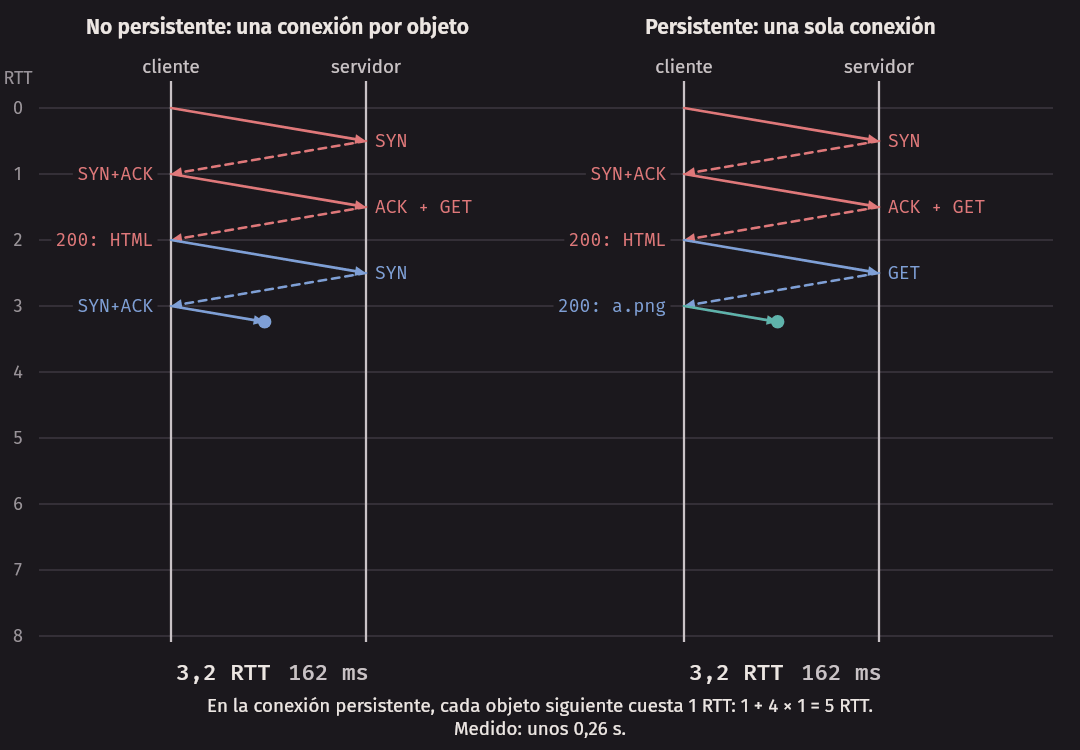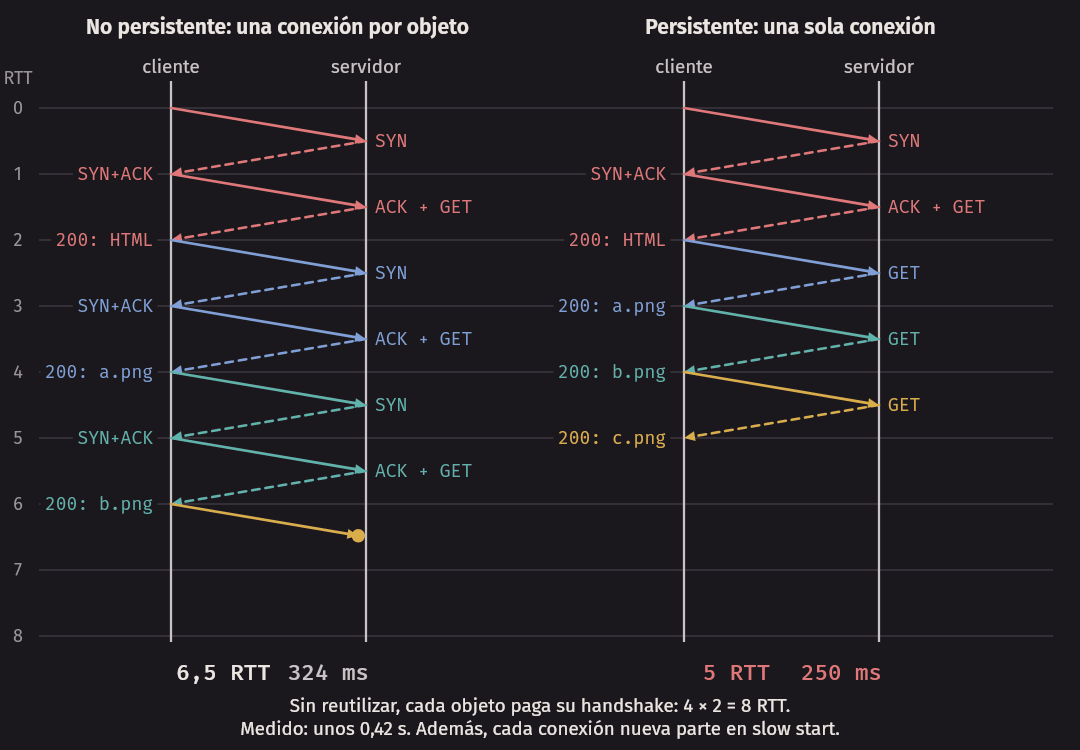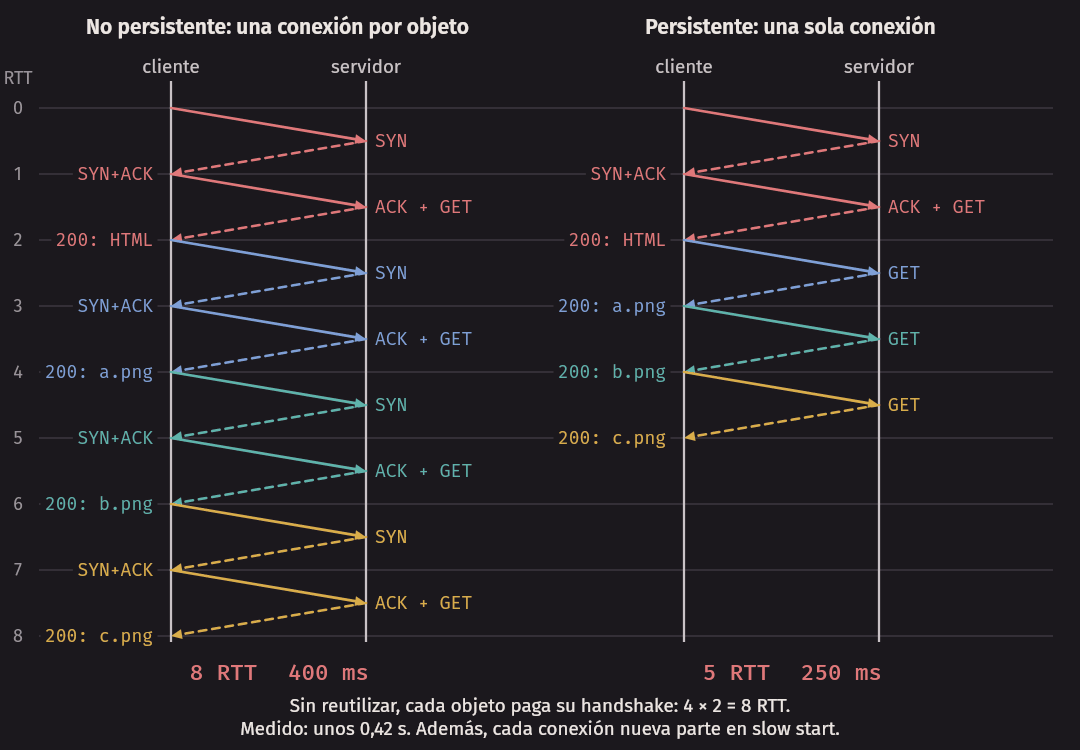
La cuenta acierta. Y así se ve objeto por objeto en la conexión reutilizada:
$ curl -s -o /dev/null -o /dev/null -o /dev/null -o /dev/null -w '...' \
    http://www.wayra.test/ http://www.wayra.test/a.png http://www.wayra.test/b.png http://www.wayra.test/c.png
dns=0.000714 con=0.052259 ttfb=0.111525 total=0.111564 conexiones=1
dns=0.000000 con=0.000000 ttfb=0.055842 total=0.055871 conexiones=0
dns=0.000000 con=0.000000 ttfb=0.052721 total=0.052739 conexiones=0
dns=0.000000 con=0.000000 ttfb=0.051877 total=0.051896 conexiones=0conexiones=0: no hizo falta conectar, y cuesta 1 RTT. No es solo el handshake lo que se ahorra.
Una conexión nueva parte en slow start (semana 11), mientras que una ya abierta conserva lo que
aprendió de la red. Además, el servidor no gasta memoria en mantener muchas conexiones cerrándose,
ni deja tantos sockets en TIME_WAIT, como vimos en la semana 10.
Para escapar de los 2 RTT por objeto, los navegadores abren también conexiones paralelas, típicamente hasta 6 por servidor. Bajan más rápido, pero cada una cuesta un handshake y compite con las demás por el enlace, como vimos con la equidad en la semana 11.
En la práctica. En el código del servidor del laboratorio encontrarán
disable_nagle_algorithm = True. Ese servidor escribe los headers y el cuerpo por separado, y sin esa línea el algoritmo de Nagle y el ACK retardado del cliente podrían agregar del orden de 40 ms que no tienen nada que ver con HTTP. Es un clásico al medir un protocolo de aplicación.
El problema de la fila
Con una conexión persistente, las respuestas deben volver en el mismo orden que las peticiones.
El cliente puede mandar varias peticiones sin esperar (pipelining), y así lo hicimos con nc,
mandando dos seguidas por la misma conexión:
$ printf 'GET / HTTP/1.1\r\nHost: www.wayra.test\r\n\r\nGET /a.png HTTP/1.1\r\nHost: www.wayra.test\r\n\r\n' \
    | nc -w1 10.212.6.10 80 | grep -E '^HTTP|Content-Length'
HTTP/1.1 200 OK
Content-Length: 67
HTTP/1.1 200 OK
Content-Length: 900
Las respuestas no llevan ninguna etiqueta que diga a qué petición corresponden: solo se puede saber por el orden. Si la primera tarda, las demás esperan aunque estén listas. Es bloqueo de la fila (head-of-line blocking) a nivel de HTTP, y por eso los navegadores casi no usaron pipelining. Recuerden este problema: es el que resuelve HTTP/2.
Cache de HTTP
La petición más rápida es la que no se hace. Igual que en DNS, una cache de HTTP guarda respuestas para reutilizarlas. Puede estar en el navegador, o en un proxy: un intermediario por el que pasan las peticiones de muchos clientes. Al guardar lo que pide uno, le ahorra el viaje a los demás, y la institución gasta menos enlace.
Dos preguntas gobiernan todo:
- ¿Sigue fresca? Si es así, se usa sin preguntarle a nadie: cuesta 0 RTT hasta el origen.
- ¿Sigue siendo válida? Si ya no está fresca, se le pregunta al origen si cambió. Si no cambió, no hace falta volver a bajarla: cuesta 1 RTT, pero casi ningún byte.
Cache-Control
| Directiva | Qué significa |
|---|---|
max-age=60 |
Está fresca durante 60 segundos |
no-cache |
Se puede guardar, pero siempre hay que revalidarla antes de usarla |
no-store |
No se debe guardar en ninguna parte |
private |
La puede guardar el navegador, pero no un proxy compartido |
Error común. Leer
no-cachecomo “no guardar en cache”. Eso esno-store.no-cachesí se guarda: solo prohíbe usarla sin preguntar. Si una página con datos personales llevano-cache, la copia sigue guardada en el disco.
ETag y la petición condicional
Un ETag es una etiqueta que identifica una versión del recurso. El servidor decide cómo la
calcula; mini_web usa un hash del contenido. Cuando un cliente tiene una copia, la pide
condicionalmente con If-None-Match, y el servidor compara. Primero, una petición normal:
$ curl -s -D- -o /dev/null http://www.wayra.test/
HTTP/1.1 200 OK
Server: mini_web
Date: Mon, 02 Nov 2026 14:42:51 GMT
ETag: "d8a8038111f4"
Cache-Control: max-age=60
Content-Type: text/html
Content-Length: 67
Y ahora con la etiqueta:
$ curl -sv -o /dev/null -H 'If-None-Match: "d8a8038111f4"' http://www.wayra.test/
> GET / HTTP/1.1
> Host: www.wayra.test
> User-Agent: curl/8.14.1
> Accept: */*
> If-None-Match: "d8a8038111f4"
>
< HTTP/1.1 304 Not Modified
< Server: mini_web
< Date: Mon, 02 Nov 2026 14:42:51 GMT
< ETag: "d8a8038111f4"
< Cache-Control: max-age=60
< Content-Type: text/html
<
Un 304 no tiene cuerpo. Se ahorran los bytes del recurso, pero no el RTT, porque de todos modos
hubo que preguntar. En un sitio con imágenes grandes es un gran ahorro; en un objeto de unos pocos
bytes no se nota. El RFC 9110 lo plantea así: la meta de un 304 es minimizar lo que se transfiere
cuando quien recibe ya tiene la copia.
Un proxy en acción
mini_cache.py es un proxy pequeño, de unas 150 líneas, que entiende justo estas reglas. Agrega un
header X-Cache para que se vea qué decidió, y Age, que es un header estándar: cuántos segundos
lleva guardada la respuesta. El recurso /noticia tiene max-age=3. Paso por paso:
$ curl -s -D- -o /dev/null -x 10.212.7.10:3128 http://www.wayra.test/noticia     # primera vez
HTTP/1.1 200 OK
ETag: "078cd7cab10a"
Via: 1.1 mini_cache
X-Cache: MISS

$ sleep 1; curl ... /noticia                                # fresca: no toca al origen
HTTP/1.1 200 OK
ETag: "078cd7cab10a"
Age: 1
Via: 1.1 mini_cache
X-Cache: HIT

$ sleep 3; curl ... /noticia                                # venció: pregunta, y recibe 304
HTTP/1.1 200 OK
ETag: "078cd7cab10a"
Age: 0
Via: 1.1 mini_cache
X-Cache: REVALIDATED

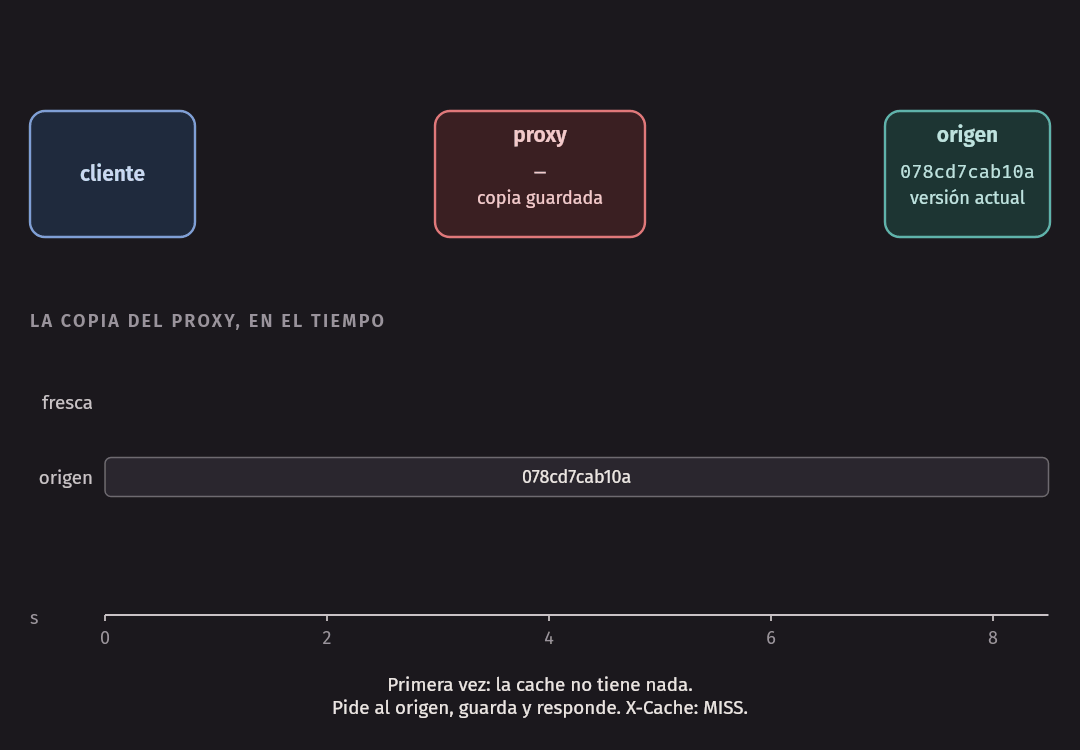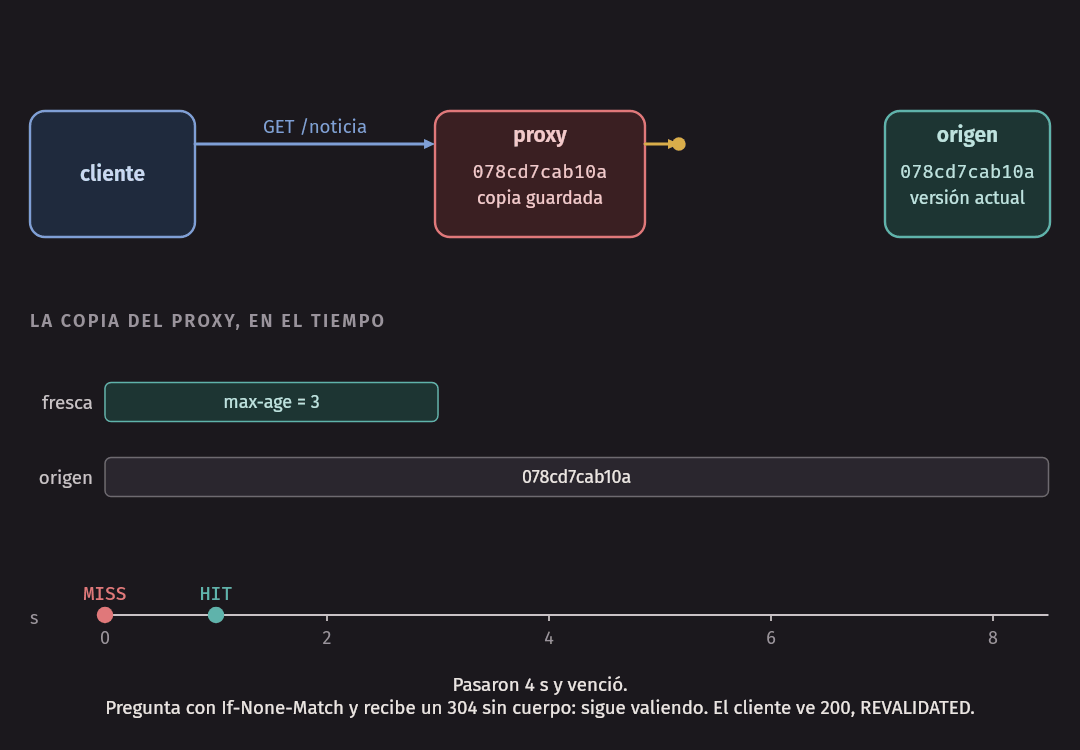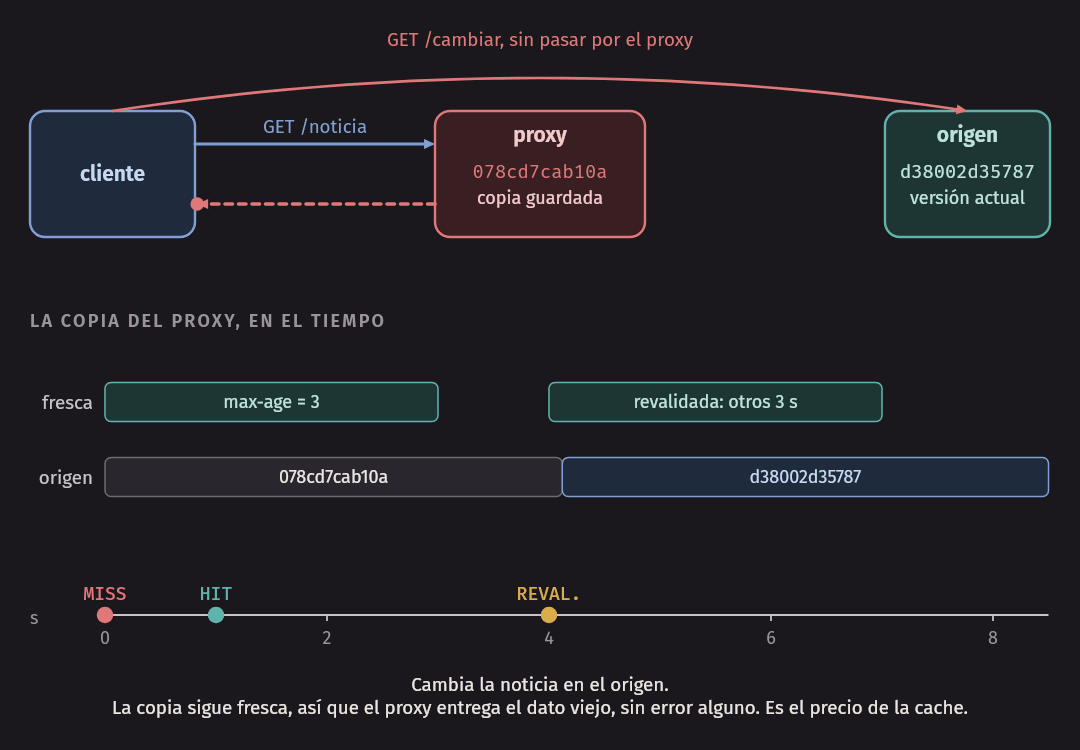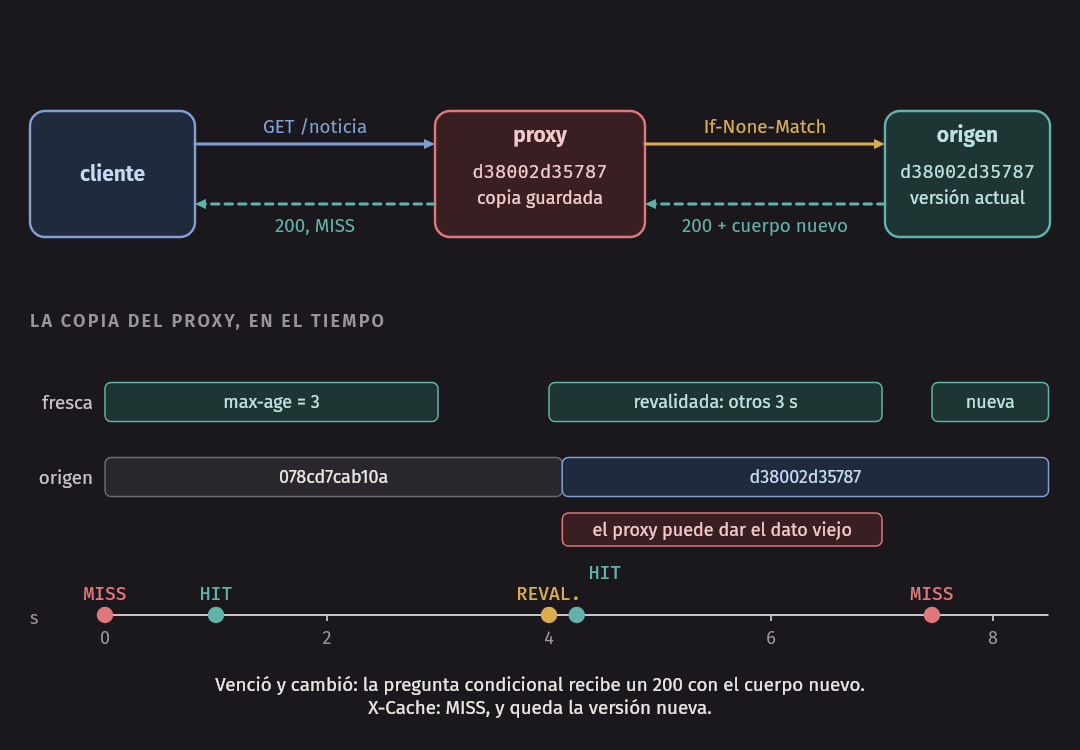
$ curl -s http://www.wayra.test/cambiar                     # cambia la noticia en el origen
cambiada
$ curl ... /noticia                                         # sigue fresca: ¡dato viejo!
HTTP/1.1 200 OK
ETag: "078cd7cab10a"
Age: 0
Via: 1.1 mini_cache
X-Cache: HIT

$ sleep 3.2; curl ... /noticia                              # venció y cambió: baja todo
HTTP/1.1 200 OK
ETag: "d38002d35787"
Via: 1.1 mini_cache
X-Cache: MISS
(Solo mostramos algunos headers de cada respuesta.) Miren el penúltimo: el origen ya cambió y el
cliente recibe el dato viejo, sin error alguno. No es una falla: es el precio de la cache, y dura
como mucho max-age. Es el mismo compromiso que el TTL de DNS.
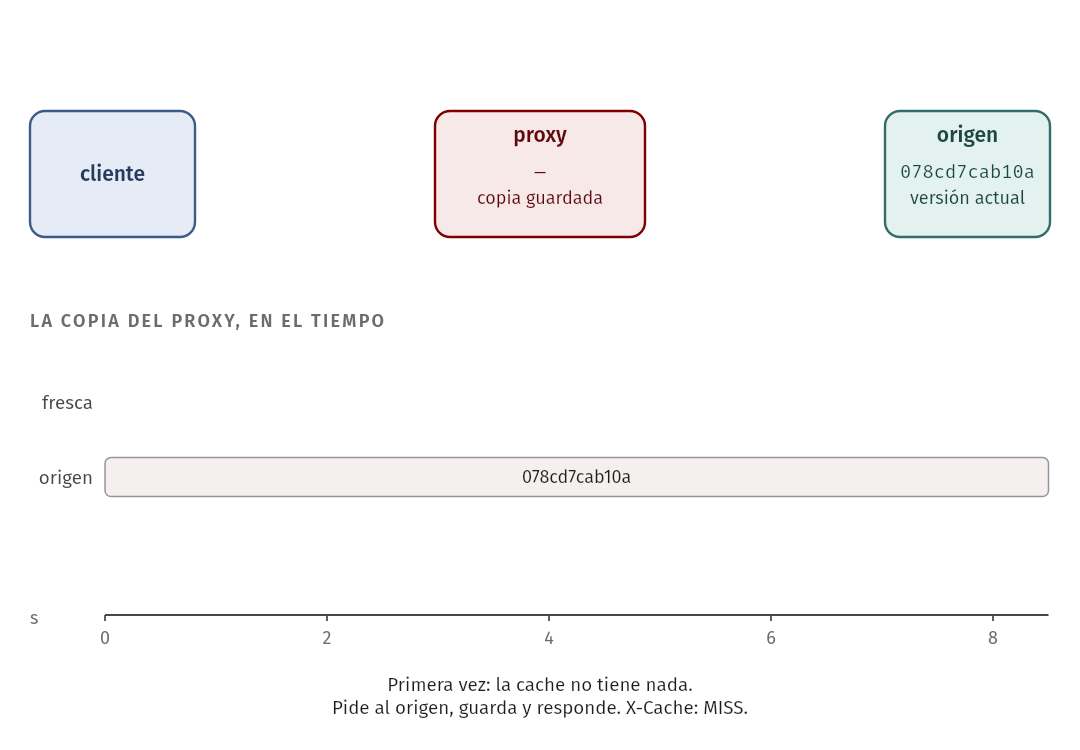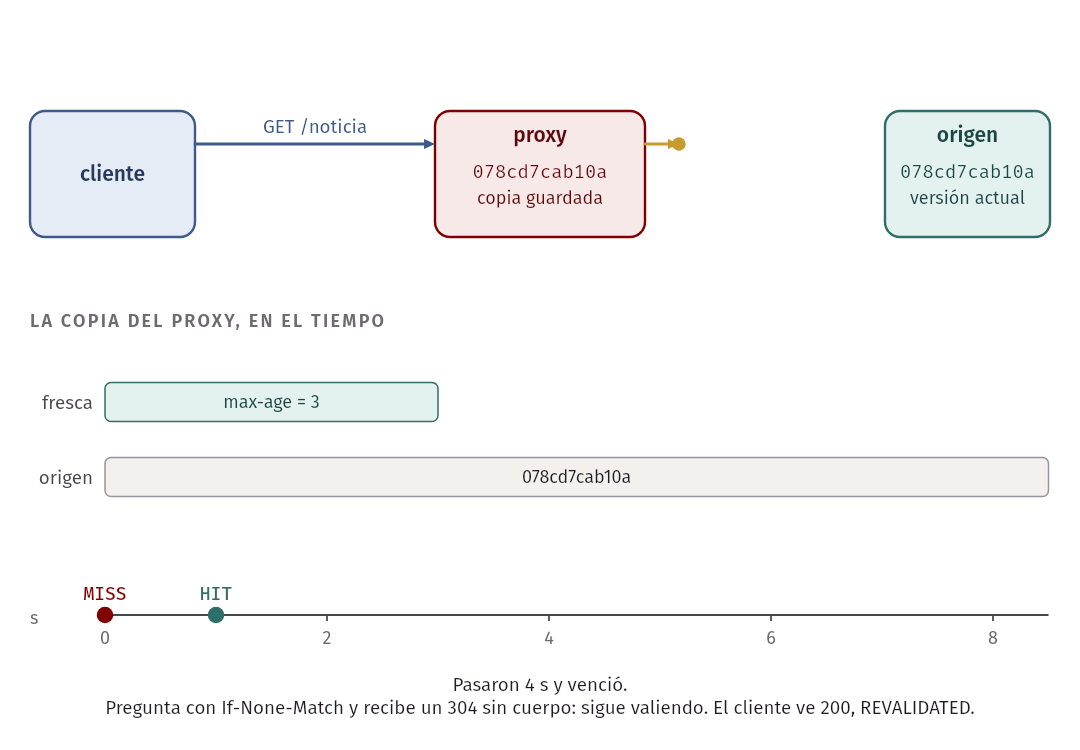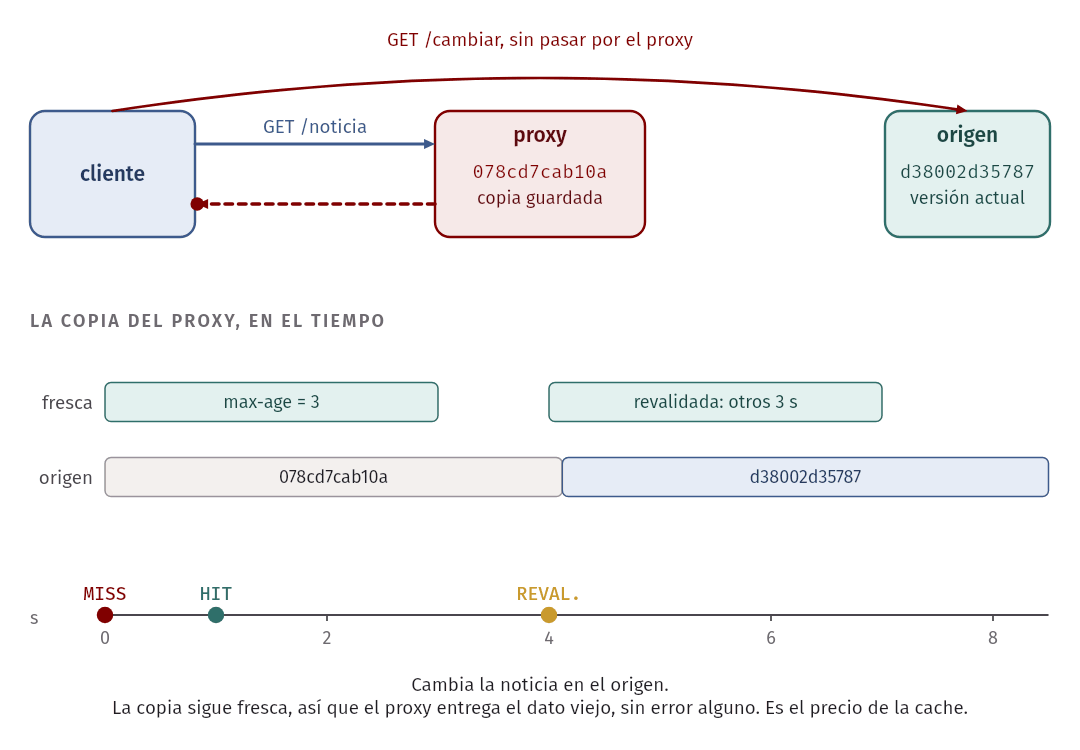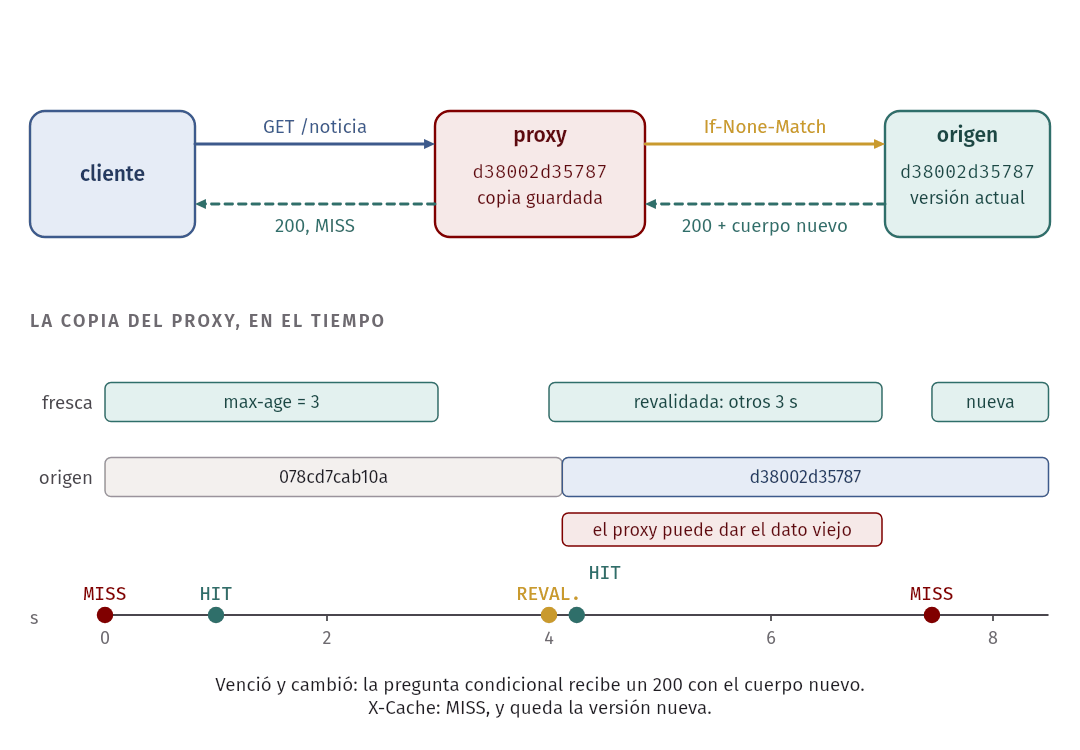
El cliente siempre ve 200, incluso en la revalidación: el 304 es entre el proxy y el origen.
Y con no-store no se guarda nada, como debe ser:
$ curl ... /privado ; curl ... /privado
HTTP/1.1 200 OK
Via: 1.1 mini_cache
X-Cache: BYPASS

HTTP/1.1 200 OK
Via: 1.1 mini_cache
X-Cache: BYPASS
¿Cuánto se gana? Medimos /a.png, en una corrida, a través del proxy y directo. La primera vía el
proxy es un MISS y paga todo el camino; la segunda es un HIT, porque el proxy está al lado del
cliente:
proxy   0.104770    (MISS)
directo 0.104980
proxy   0.000586    (HIT)
directo 0.104756
En la práctica. Las CDN, que veremos la próxima semana, son esto mismo a escala planetaria: caches cerca de los usuarios, y DNS para mandarlos a la más cercana. Hoy casi todo va cifrado con HTTPS, así que un proxy de una institución ya no puede leer las peticiones ni guardar las respuestas sin instalar certificados propios. Por eso, en la práctica, casi toda la cache se hace en el navegador y en la CDN del propio sitio.
HTTP/2
HTTP/1.1 tiene dos problemas para las páginas actuales. Las respuestas salen en fila, como vimos, y los headers se repiten casi iguales en cada petición, como texto. Para evitar la fila, los navegadores abren varias conexiones, y eso es un remedio caro. HTTP/2 resuelve ambos cambiando cómo se escriben los mensajes, sin cambiar lo que significan: los mismos métodos, códigos y headers.
Definición. En HTTP/2, una conexión TCP lleva muchos streams bidireccionales. Cada mensaje se parte en frames, y cada frame lleva el número de su stream. Los frames de streams distintos se pueden mezclar: eso es la multiplexación.
HTTP/1.1, una conexión:     | respuesta A ............... | respuesta B | respuesta C |

HTTP/2, una conexión:       |A1|B1|C1|A2|B2|C2|A3|C3|A4|A5|
                             cada pedazo lleva el número de su stream
Un frame tiene un encabezado binario de 9 bytes (sección 4.1 del RFC 9113): 3 de largo, 1 de tipo, 1
de flags y 4 con el número de stream. Los streams que inicia el cliente usan números impares, y el
cero se reserva para la conexión. Nada de esto se escribe a mano con nc. Para mirarlo, h2_frames.py
le contesta lo justo a curl y anota cada frame. No es un servidor de HTTP/2: no valida casi nada.
Manda un frame DATA por stream en cada turno, para que se vea la mezcla.
Pedimos dos objetos a la vez, sobre TCP sin cifrar, con --http2-prior-knowledge. (Los navegadores
solo hablan HTTP/2 sobre TLS.)
$ curl -s --http2-prior-knowledge --parallel -o /dev/null -o /dev/null \
    -w '%{http_version} %{http_code} conexiones=%{num_connects} %{size_download}\n' \
    http://10.212.6.10:8080/uno http://10.212.6.10:8080/dos
2 200 conexiones=1 2000
2 200 conexiones=0 2000
Una sola conexión para las dos. Si repiten esto varias veces, verán que curl a veces abre el
segundo stream recién cuando termina el primero: nos pasó en 2 de 120 corridas, y esperar más en
el servidor no cambió nada. Es una decisión de curl; HTTP/2 permite mezclar, pero no obliga a
nadie a hacerlo. Si no ven los turnos, repitan. Y esto anota el servidor cuando sí se mezclan:
<- prefacio de HTTP/2
<- SETTINGS stream=0 largo=18
<- WINDOW_UPDATE stream=0 largo=4
<- HEADERS stream=1 largo=35
-> HEADERS stream=1 largo=1
<- SETTINGS stream=0 largo=0
<- WINDOW_UPDATE stream=1 largo=4
<- WINDOW_UPDATE stream=1 largo=4
<- HEADERS stream=3 largo=10
-> HEADERS stream=3 largo=1
<- WINDOW_UPDATE stream=3 largo=4
<- WINDOW_UPDATE stream=3 largo=4
-> DATA stream=1 largo=400
-> DATA stream=3 largo=400
-> DATA stream=1 largo=400
-> DATA stream=3 largo=400
-> DATA stream=1 largo=400
-> DATA stream=3 largo=400
-> DATA stream=1 largo=400
-> DATA stream=3 largo=400
-> DATA stream=1 largo=400 END_STREAM
-> DATA stream=3 largo=400 END_STREAM
<- GOAWAY stream=0 largo=17
Hay mucho que leer aquí:
- El stream 1 y el stream 3 se turnan en la misma conexión. Ninguno espera a que termine el otro. Las respuestas ya no van en fila.
SETTINGSy elWINDOW_UPDATEen el stream 0 son de la conexión. HTTP/2 tiene control de flujo por stream, además del de TCP: es la misma idea de la semana 10, un nivel más arriba.- La petición del stream 1 ocupa 35 bytes, y la del stream 3, con casi los mismos headers, ocupa 10. Esto es la compresión.
Compresión de headers: HPACK
HPACK es la compresión de headers de HTTP/2. Tiene una tabla estática con los headers más comunes, una tabla dinámica que se llena durante la conexión, y codificación Huffman para el texto nuevo. Si un header ya se mandó, en la siguiente petición basta su índice en la tabla.
Wireshark tiene el mismo estado que los extremos y decodifica los dos mensajes:
$ tshark -r h2.pcap -d tcp.port==8080,http2 -Y 'http2.type==1 && ip.src==10.212.1.10' -O http2
    Stream: HEADERS, Stream ID: 1, Length 35, GET /uno
        Header: :method: GET
        Header: :scheme: http
        Header: :authority: 10.212.6.10:8080
        Header: :path: /uno
        Header: user-agent: curl/8.14.1
        Header: accept: */*
    Stream: HEADERS, Stream ID: 3, Length 10, GET /dos
        Header: :method: GET
        Header: :scheme: http
        Header: :authority: 10.212.6.10:8080
        Header: :path: /dos
(Recortamos la salida.) Los pseudo-headers que empiezan con : reemplazan a la línea inicial de
HTTP/1.1. Y la respuesta de nuestro servidor mide un solo byte, 0x88: es la entrada 8 de la tabla
estática, :status: 200. Comparen eso con la línea HTTP/1.1 200 OK escrita completa.
Idea clave. HTTP/2 cambia el formato del mensaje, no su significado. Una aplicación que entiende
GET,200yCache-Controlsigue igual. El costo es que ya no se lee con los ojos: hacen falta herramientas comotshark.
Lo que HTTP/2 no arregló
Todos los streams viajan en una sola conexión TCP, y TCP no sabe de streams. Para TCP hay un solo stream de bytes, que debe entregar en orden. Pensemos qué pasa si se pierde un paquete:
 enviados por TCP, en orden:     A1  B1  C1  A2  B2  C2
 se pierde B1:                   A1  --  C1  A2  B2  C2

 lo que TCP le entrega a HTTP/2: A1   ... y espera la retransmisión de B1
 mientras tanto, C1, A2, B2 y C2 ya están en el host, pero esperan en el buffer de TCP.
Este razonamiento sale de lo que sabemos sobre entrega en orden en TCP; no lo medimos aquí. El propio RFC 9113 advierte que este bloqueo de TCP no se resuelve.
Error común. Creer que HTTP/2 eliminó todo bloqueo. Eliminó el de HTTP: una respuesta lenta ya no detiene a las demás. Pero una pérdida en TCP detiene a todos los streams, aunque los datos que faltan sean de uno solo. Con mucha pérdida, una sola conexión HTTP/2 incluso puede rendir menos que varias de HTTP/1.1, porque una pérdida en una de ellas no frena a las otras. Por eso existe HTTP/3, que veremos la próxima semana: lleva los streams al transporte, sobre QUIC.
| Bloqueo | HTTP/1.1 | HTTP/2 sobre TCP |
|---|---|---|
| Una respuesta lenta detiene a las siguientes | Sí, en la misma conexión | No |
| Una pérdida de TCP detiene a todos los streams | Solo los de esa conexión | Sí, todos, porque hay una sola conexión |
Laboratorio: DNS paso a paso y HTTP por dentro
Trabajen en code/week-12/. Levanten la red y entren al cliente:
make up
docker exec -it clab-w12-red-cliente sh-
Recorrido. Corran
dig +trace www.wayra.test, y repitan el recorrido a mano condig @servidor +norecurse. Después, en la terminal de su computadora o en el contenedor del curso, hagan lo mismo con un nombre.pe. -
Registros y TTL. Lean los registros A, AAAA, NS y MX de
wayra.testy de un dominio real. Pregunten dos veces porrapido.wayra.testy vean bajar el TTL. Hagan lo mismo con un resolver público y comparen. -
Captura. Capturen una consulta en
clientey comparen condigel ID, la pregunta y la respuesta:tcpdump -i eth1 --immediate-mode -w /tmp/dns.pcap udp port 53 & dig blog.wayra.test kill %1Abran el archivo en Wireshark, después de copiarlo con
docker cp, o léanlo en el contenedor contshark. Hagan lo mismo con/w12/bin/dns_ask, y encuentren cada campo de la tabla de este capítulo. -
HTTP a mano. Con
nc, escriban una petición a10.212.6.10, puerto 80. Prueben sinHost, y prueben lo mismo contra un servidor real, comoexample.com, desde el contenedor del curso. CambienHostablog.wayra.test. ¿Qué pasa si escriben las líneas con\nen vez de\r\n? Escriban la predicción antes. -
Condicional. Con
curl -v, vean una respuesta200, copien elETag, y consigan un304conIf-None-Match. -
Tiempos. Midan con
curl -wla resolución, la conexión y el primer byte, tal como en la sección “Cuánto cuesta una página”. Repitan con una conexión reutilizada, y confirmen los 8 y los 5 RTT. -
Delegación. Es la parte que se entrega al final del laboratorio. Vean la sección siguiente.
-
P4. Sigan avanzando con el proyecto: se entrega la próxima semana.
Algunas de estas actividades se basan en los laboratorios de DNS y HTTP de Kurose y Ross.
Delegar una zona nueva
En lab/ hay dos archivos con un TODO:
lab/test.zone: la zona del TLD. Falta delegarkilla.test.en el servidorns1.killa.test., en la dirección10.212.8.10.lab/killa.zone: la zona nueva, en la que faltan sus registros. El comentario del archivo dice cuáles.
Para probar a mano, arranquen la red con sus zonas y sigan el recorrido:
make down
cd red && containerlab deploy -t red.clab.yml --reconfigure && cd ..
sh red/start.sh lab lab
docker exec clab-w12-red-cliente dig +trace www.killa.test
make test también comprueba su trabajo: mientras un archivo siga con TODO, esas pruebas se saltan con
un mensaje. Las pruebas revisan que el padre delegue con glue, que el hijo responda con autoridad y que el
resolver encuentre cada registro.
Cuando funcione, quiten el glue de lab/test.zone, reinicien y comprueben el SERVFAIL que mostramos en este
capítulo. Después expliquen por qué ocurre, con sus propias palabras.
Archivos y make test
| Archivo | Qué es |
|---|---|
dns_wire.py |
El formato de los mensajes: codificar y decodificar, con compresión |
dns_auth.py |
Servidor autoritativo, por UDP y TCP |
dns_resolver.py |
Resolver recursivo con cache, ID y puerto al azar, y chequeos de la respuesta |
dns_ask.c |
Una pregunta armada a mano, en C |
mini_web.py |
Sitio de juguete, en memoria |
mini_cache.py |
Proxy con cache |
h2_frames.py |
Lista los frames de HTTP/2 y responde lo justo |
red/ |
La topología, sus zonas y el script de arranque |
lab/ |
Las zonas que deben completar |
test_wire.py |
Pruebas sin red: formato, autoritativo, chequeos, TTL y reglas de cache |
test_net.py |
Pruebas sobre la red: cada afirmación de este capítulo que se puede comprobar corriéndola |
make            # compila dns_ask y revisa la sintaxis de los programas de Python
make test       # corre las pruebas, y siempre destruye lo que levantó
make up         # levanta la red y arranca los servidores
make down       # destruye la red y su red de Docker
make clean      # lo anterior, y borra lo generado
make test tarda menos de un minuto y usa márgenes amplios, porque los tiempos dependen de la máquina. No
pide cifras exactas: pide, por ejemplo, que una pregunta repetida tarde menos de la mitad que una en frío.
En la práctica. Estos programas son para leerlos. Para servir nombres de verdad, se usan programas como BIND, Unbound o Knot, y para la web, nginx o similares. Ninguno de los programas de Python de esta semana debería publicarse en una red real.
Resumen
- DNS es una base de datos distribuida y jerárquica. Separa los nombres de las direcciones, y también da alias, correo y reparto de carga.
- Jerarquía: raíz, TLD y autoritativos. Una zona es lo que administra una autoridad, y puede delegar partes. El árbol de nombres y el de zonas no son el mismo.
- El resolver recorre la jerarquía por sus clientes. El cliente hace una consulta recursiva, y el resolver hace consultas iterativas.
- Referral y glue: quien no sabe manda a quien sabe. Si el servidor está dentro de la zona delegada, el glue es indispensable; sin él hay
SERVFAIL. - Cache y TTL: en frío, 3 RTT en nuestra red; repetida, casi nada. También se guardan las delegaciones y las respuestas negativas. El TTL equilibra rapidez y carga contra lo rápido que se nota un cambio. Nada se “propaga”.
- Registros: A, AAAA, NS, CNAME, MX, TXT y SOA.
NXDOMAIN,NODATAySERVFAILson cosas distintas. - El mensaje: 12 bytes de encabezado y cuatro secciones. Etiquetas con su largo, y compresión con punteros, que hay que validar.
- UDP porque es una pregunta y una respuesta, y repetir es inofensivo. TCP cuando la respuesta no cabe (
TC). Por TCP, cada mensaje lleva su largo delante. - Envenenamiento de cache: con ID y puerto al azar, un atacante fuera del camino pasa de 65 536 a unos 1850 millones de combinaciones. No detiene a quien ve el tráfico.
- DNSSEC autentica y no cifra. DoH y DoT cifran hasta el resolver y no autentican el dato de origen. Son complementarios.
- HTTP/1.1 es texto: línea inicial, headers, línea vacía y cuerpo.
Hostpermite varios sitios en una dirección; sin él, un servidor debe responder400. HTTP no guarda estado; las cookies llevan el estado en los mensajes. - Costo: un objeto por conexión nueva son 2 RTT. Una página con 3 imágenes: 8 RTT no persistente y serial, 5 RTT persistente. Lo medimos: unos 420 y 260 ms con 50 ms de RTT.
- Cache de HTTP:
max-ageevita preguntar;ETageIf-None-Matchevitan volver a bajar, con un304sin cuerpo.no-cacherevalida yno-storeno guarda. Mientras esté fresca, una copia vieja se sirve sin error. - HTTP/2: frames y streams mezclados en una conexión, y HPACK (35 bytes contra 10 en nuestra captura). Elimina el bloqueo de HTTP, pero una pérdida en TCP todavía detiene todos los streams. Por eso existe HTTP/3.
Ejercicios
- Un resolver sin nada en cache busca
www.uni.edu.pe. ¿A qué servidores pregunta y en qué orden, según la salida dedig +tracede este capítulo? ¿Y la segunda vez? ¿Y si después alguien pregunta porcorreo.uni.edu.pe? - Decodifiquen a mano, byte a byte, esta pregunta:
ab cd 01 00 00 01 00 00 00 00 00 00 03 75 6e 69 04 74 65 73 74 00 00 0f 00 01. Digan el ID, los flags, el nombre, el tipo y la clase. Comprueben armándola condns_wire.py. - Una zona tiene un TTL de un día en su registro A. Deben mudar el servidor el viernes a las 18:00, y quieren que como máximo un 1 % de los clientes vea la dirección vieja pasada una hora. ¿Qué harían, y desde cuándo? ¿Qué costo tiene?
- En
dns_resolver.py,usable_gluedescarta las direcciones que no estén dentro de la zona delegada. Construyan una respuesta de ejemplo que muestre qué se podría colar sin esa regla. No hace falta ninguna red: basta una prueba como las detest_wire.py. - Repitan la cuenta de la tabla de envenenamiento con 16 bits de ID y solo 1000 puertos posibles, y luego con 100 000 respuestas falsas en la carrera, para cada fila. ¿Por qué un NAT que reescribe los puertos de forma predecible puede arruinar esta defensa?
- Un compañero dice: “ya activamos DNSSEC en nuestra universidad, así que nadie sabe qué páginas visitamos”. Corrijan esa frase. ¿Qué garantiza DNSSEC, qué agregaría DoH y qué seguiría viendo el proveedor de Internet aunque usen los dos?
- Una página tiene un HTML y 10 imágenes, con 30 ms de RTT. Calculen los RTT y el tiempo total sin transmisión: (a) no persistente y serial; (b) persistente sin pipelining; (c) con 5 conexiones paralelas no persistentes; (d) HTTP/2 con una conexión, si las 10 imágenes se piden juntas después del HTML. Comprueben (a) y (b) en la red de la semana, cambiando la lista de direcciones de
curl. - Predigan y comprueben: en el proxy, pidan
/noticia, cambien la noticia en el origen con/cambiary repitan cada segundo durante 8 segundos. Escriban primero la secuencia deX-Cache. ¿Cuánto tiempo puede ver un cliente el dato viejo, como máximo? - El recurso
/horano llevaCache-Control. Nuestro proxy no lo guarda, pero el RFC 9111 permite a una cache estimar una frescura (heurística) en ciertos casos. Lean la sección 4.2.2 de ese RFC y expliquen qué condición usa y por qué es un riesgo para un recurso así. ¿Qué header agregarían a la respuesta? - Modifiquen
mini_cache.pypara que, cuando el origen no responda, entregue una copia vencida con un aviso, en vez de un502. Lean la sección 4.2.4 del RFC 9111 antes de hacerlo. ¿Cuándo es buena idea y cuándo no? Para probarlo, detenganmini_webconpkillen el nodoweb. - Con
h2_frames.py, pidan tres objetos en vez de dos. ¿Qué número de stream recibe el tercero? ¿Cuánto mide suHEADERSy por qué? Cambien:authorityusando otra dirección en la URL: ¿cómo cambia el tamaño? - Sobre el bloqueo: hagan en un papel una tabla como la de “Lo que HTTP/2 no arregló”, con seis conexiones de HTTP/1.1 frente a una de HTTP/2, y una pérdida del 2 % en el enlace. ¿Qué ventaja de HTTP/2 se reduce? ¿Por qué un sitio podría preferir una sola conexión de todos modos? Vuelvan a este ejercicio la próxima semana, con QUIC.