
Apuntes · Capítulo 13Transporte y aplicaciones
TLS, QUIC y CDNs
TLS, QUIC y CDNs
Las semanas anteriores armaron una pila que funciona: TCP entrega bytes en orden, el control de congestión reparte la red y HTTP pide páginas por nombre. Falta decir lo incómodo. Todo eso viaja a la vista. Cada router del camino puede leer la petición, cambiar la respuesta o hacerse pasar por el servidor, y ni TCP ni HTTP tienen forma de notarlo. Tampoco está resuelto otro problema: una página sigue tardando varias idas y vueltas antes del primer byte útil, y una sola pérdida en TCP detiene todos los streams de HTTP/2.
Esta semana responde a esas dos cuestiones, y agrega una tercera. Primero, cómo se protege una conexión entre dos extremos que nunca se vieron, sobre una red en la que no confían. La respuesta es TLS. Segundo, cómo se cambia el transporte de Internet si no se puede cambiar TCP. La respuesta es QUIC. Tercero, cómo se reduce la distancia cuando la luz ya no va a ir más rápido: las CDN y el streaming adaptativo.
En la Sesión A vemos lo mínimo de criptografía para entender TLS, sin demostraciones y con números que caben en una línea. Seguimos un handshake de TLS 1.3 real, contamos sus RTT y leemos en una captura lo que puede ver quien está en el medio, que es más de lo que se suele creer.
En la Sesión B vemos por qué QUIC corre sobre UDP, qué gana con eso y cuánto de su “cifrado” protege de verdad. Después pasamos a las CDN, con selección por DNS y por anycast en una red con BGP, y a DASH, con un cliente que decide la calidad de cada segmento mientras le cortamos el ancho de banda.
Hay tres clases de resultados en este capítulo. Las trazas de los simuladores son exactas y se repiten igual. Las capturas y los mensajes muestran una ejecución real: las claves, los puertos y los IDs cambian en cada corrida. Las mediciones dependen de la computadora y de lo que esté corriendo, y las que usan Internet dependen además de su conexión y del día: comparen tendencias.
Ruta de lectura.
Antes de clase (obligatorio, unos 15 a 20 minutos). Sesión A: Qué se quiere proteger, Criptografía simétrica, la introducción de Clave pública: RSA y Diffie-Hellman con Por qué no se usa la clave pública para todo, Hash, MAC y firma digital y Certificados y autoridades de certificación. Sesión B: Por qué no se cambia TCP y la introducción de Streams independientes.
En clase. Sesión A: RSA en una cuenta, Diffie-Hellman en una cuenta, TLS 1.3, paso a paso y Lo que ve quien está en el medio. Sesión B: Los streams, en una captura real, El handshake integrado, 0-RTT y su riesgo de repetición, Migración de conexión, CDN: acercar el contenido y Streaming adaptativo con DASH.
Después de clase. Repasen con el Resumen y los Ejercicios, y preparen Laboratorio: un handshake TLS y HTTP/2 frente a HTTP/3. Opcional: Descifrar la captura, con permiso, El cifrado que no protege y Un cliente real. Para profundizar, las lecturas del libro y las gratuitas de la semana:
Este capítulo acompaña a Kurose y Ross, Computer Networking: A Top-Down Approach (9.ª ed.). Para la Sesión A, las secciones 8.2 Principles of Cryptography, 8.3 Message Integrity and Digital Signatures y 8.6 Securing TCP and HTTP Connections: TLS, y el capítulo TLS de CS168. Complementaria: RFC 8446, TLS 1.3, secciones 1 y 2. Para la Sesión B, las secciones 2.2.7 HTTP/3 and QUIC, 2.5 Video Streaming and Content Distribution Networks y 3.8 Evolution of Transport-Layer Functionality, y el RFC 9000, QUIC, secciones 1 y 2. Complementarias: RFC 9001, QUIC con TLS, y RFC 9114, HTTP/3. El código de la semana está en
code/week-13/.
Qué se quiere proteger
Antes de hablar de algoritmos hay que decir contra quién nos defendemos. En esta red, el atacante está en el camino: es un router, un access point en una cafetería o alguien que controla un enlace. Puede leer todo lo que pasa, borrar paquetes, cambiarlos, repetirlos e inventar otros. No puede romper las matemáticas de la criptografía ni entrar a las computadoras de los extremos.
Contra ese atacante se quieren tres propiedades, y conviene no mezclarlas:
| Propiedad | Pregunta que responde | Falla típica sin ella |
|---|---|---|
| Confidencialidad | ¿Solo el destinatario puede leerlo? | Alguien lee su contraseña en el Wi-Fi |
| Integridad | ¿Llegó tal como salió? | Un proxy inyecta publicidad en la página |
| Autenticación | ¿Hablo con quien creo? | Un servidor falso recibe su contraseña |
Las tres son necesarias a la vez. Un canal perfectamente cifrado con el atacante, porque no se autenticó al otro extremo, no protege nada. Y cifrar no da integridad, como veremos con un ejemplo en la siguiente sección.
Idea clave. TLS no hace que la red sea confiable. Hace que la red no importe: los extremos detectan cualquier cambio y nadie más puede leer el contenido. Lo que no impide es que el atacante corte la conexión. Contra un DoS, TLS no ayuda.
Criptografía simétrica
Definición. En el cifrado (encryption) simétrico, o de clave simétrica (symmetric key), las dos partes comparten una misma clave K.
Cifrar es aplicar E(K, texto), y descifrar es aplicar D(K, cifrado). Quien no tiene K no
debería poder sacar nada del texto cifrado, más allá de su tamaño.
El algoritmo más usado es AES, que cifra bloques de 16 bytes, y hoy también ChaCha20,
que es rápido en procesadores sin instrucciones especiales para AES. Son muy rápidos: en la
máquina donde se preparó este capítulo, con openssl speed, AES-128-GCM procesa unos 3 GB por
segundo:
$ openssl speed -seconds 1 -evp aes-128-gcm
type             16 bytes     64 bytes    256 bytes   1024 bytes   8192 bytes  16384 bytes
AES-128-GCM      37154.73k   167274.64k   534014.49k  1550361.60k  2895376.17k  3129831.62k
Las cifras son miles de bytes por segundo, y dependen de cada computadora.
El problema es obvio: ¿cómo se ponen de acuerdo en K dos máquinas que nunca se vieron, si
todo lo que se dicen pasa por el atacante? A eso volvemos enseguida.
Cifrar no es proteger la integridad
Muchos modos de cifrado funcionan así: generan una secuencia de bytes que parece azar a partir
de la clave (AES en modo contador, CTR), y hacen un XOR con el mensaje. Un atacante que no
conoce la clave no puede leer. Pero sí puede invertir bits: un XOR sobre el cifrado se vuelve el
mismo XOR sobre el texto. ctr_flip.py lo hace con el comando openssl enc. Conoce el formato
del mensaje, y cambia el primer dígito del monto sin saber la clave:
$ python3 ctr_flip.py
mensaje:          pagar 0100 soles a Ana
cifrado:          2e79b69f843d384ff0931ea45bcbf4fc3aa39f9df994
cifrado alterado: 2e79b69f843d314ff0931ea45bcbf4fc3aa39f9df994
se descifra como: pagar 9100 soles a Ana
MAC del original sobre el alterado: NO coincide, se descarta
Un solo byte cambió en el cifrado (38 por 31), y el destinatario descifra otro monto sin
ningún error. La última línea adelanta la solución: un código de autenticación, que veremos más
abajo, sí lo detecta.
Por eso TLS 1.3 solo usa cifrado autenticado (AEAD): AES-GCM o ChaCha20-Poly1305. Cifran y agregan una etiqueta en la misma operación, y si la etiqueta no coincide, se descarta el mensaje sin entregarlo.
Error común. Creer que si está cifrado, nadie lo pudo cambiar. El atacante de arriba no sabe qué dice el mensaje, y aun así eligió exactamente qué cambiar. La integridad necesita su propio mecanismo.
Clave pública: RSA y Diffie-Hellman
Definición. En la criptografía de clave pública (public key), cada parte tiene dos claves relacionadas: una pública, que le da a cualquiera, y una privada, que nunca sale de su máquina. Lo que se hace con una se deshace con la otra, y conocer la pública no permite calcular la privada en un tiempo razonable.
Esto resuelve el problema del acuerdo, y da algo más: una forma de probar quién es uno sin decir
el secreto. Veamos los dos algoritmos con números de juguete. crypto_toys.py usa números
diminutos a propósito: no protege nada, solo deja seguir las cuentas.
RSA en una cuenta
Se eligen dos primos p y q. El módulo es n = p × q. Se elige e, y se calcula d de modo
que e × d deje resto 1 al dividirlo entre (p-1)(q-1). La clave pública es (n, e), y la
privada es d. Cifrar y descifrar son la misma operación, una potencia módulo n, con distinto
exponente:
== RSA con p=61, q=53, e=17
n=3233 e=17 d=2753
cifrar con la pública:  65^17 mod 3233 = 2790
descifrar con la privada: 2790^2753 mod 3233 = 65
firmar con la privada:  65^2753 mod 3233 = 588
verificar con la pública: 588^17 mod 3233 = 65
La seguridad viene de que, dado n, encontrar p y q es muy difícil si n tiene miles de
bits. Con n = 3233 lo hacen ustedes a mano. Fíjense en que las dos últimas líneas invierten el
orden. Si uno aplica su clave privada y cualquiera puede deshacerlo con la pública, eso
prueba quién lo hizo. Esa es la idea de la firma digital (digital signature).
El RSA real no se usa así, sin más: un mensaje siempre se transforma antes, con un relleno aleatorio (padding), porque el RSA de libro es determinista y maleable. Eso queda para un curso de criptografía.
Diffie-Hellman en una cuenta
Diffie-Hellman es la idea más sorprendente de esta semana: dos personas llegan a un mismo
secreto hablando en público, sin haber compartido nada antes. Se acuerda en público un primo
p y un generador g. Cada lado elige un número secreto, y publica g elevado a ese número,
módulo p. Cada uno eleva lo que recibió a su propio secreto:
== Diffie-Hellman con p=2087, g=5
Ana elige a=731 y publica A = g^a mod p = 114
Beto elige b=1289 y publica B = g^b mod p = 2029
Ana calcula B^a mod p = 1778
Beto calcula A^b mod p = 1778
quien solo vio A y B, probando exponentes, halla a=731
Los dos llegan a 1778 porque (g^b)^a = (g^a)^b. Quien solo vio A y B debe sacar un
exponente de una potencia modular, lo que se llama el logaritmo discreto. La última línea
muestra que con p = 2087 se resuelve probando. Con un p de miles de bits, o con curvas
elípticas (como X25519, la que usa casi todo Internet hoy) no se conoce ninguna forma práctica
de hacerlo.
Una advertencia que importa más que las cuentas: Diffie-Hellman solo no autentica. Un man-in-the-middle puede hacer un intercambio con Ana y otro con Beto, y leer todo, sin romper nada. Le falta saber con quién se habla, y de eso se encargan las firmas.
Por qué no se usa la clave pública para todo
Porque es muchísimo más lenta. La misma corrida de openssl speed:
$ openssl speed -seconds 1 rsa2048
                               keygen     signs    verify keygens/s    sign/s  verify/s
                    rsa2048 0.055556s 0.000820s 0.000019s      18.0    1219.6   51373.2
$ openssl speed -seconds 1 ecdhp256
                              op      op/s
 256 bits ecdh (nistp256)   0.0001s  18781.8
Una firma RSA de 2048 bits procesa 256 bytes. A 1220 firmas por segundo son unos 0,3 MB/s, contra 3 GB/s de AES-GCM: una diferencia de unas 10 000 veces en esta máquina. La cuenta es solo para dar una idea, porque nadie cifra datos con RSA.
Por eso todo protocolo real es híbrido: la clave pública se usa pocas veces al inicio, para autenticar y acordar una clave; todos los datos van con cifrado simétrico.
| Herramienta | Para qué se usa en TLS 1.3 | Para qué no |
|---|---|---|
| Diffie-Hellman efímero | Acordar el secreto de la conexión | No autentica a nadie |
| Firma (RSA, ECDSA, Ed25519) | Probar quién es el servidor | No cifra datos |
| AEAD (AES-GCM, ChaCha20-Poly1305) | Proteger todos los datos | No sirve sin una clave acordada |
Hash, MAC y firma digital
Tres herramientas parecidas, que se confunden con frecuencia.
Definición. Una función hash criptográfica convierte cualquier cantidad de bytes en un resumen de tamaño fijo (32 bytes en SHA-256). Es fácil de calcular, pero es inviable encontrar un mensaje con un resumen dado, o dos mensajes con el mismo resumen. Un cambio mínimo en la entrada da un resumen que no se parece en nada:
== Hash: un carácter cambia cerca de la mitad de los bits
sha256('pagar 100 soles') = f5e3942bce4a5a603bf1d93471cd0d72c06c4ea5f18100c619d31e82759ddf27
sha256('pagar 900 soles') = 1a58b501c38fec2af33d38c3046340357979f7b6c552b4606f712960af0ccb35
bits distintos: 130 de 256
Un hash no tiene clave, así que no autentica nada: si el atacante cambia el mensaje, recalcula el hash, y listo.
Definición. Un MAC (message authentication code) es un resumen que depende además de una clave compartida. La construcción clásica es HMAC. Quien no tiene la clave no puede producir un MAC válido:
== MAC: el hash solo no autentica, porque cualquiera lo recalcula
hmac(clave, 'pagar 100 soles') = 00e99ba858f25a3cc2a1d86805d54ad49677e7e8cf175a69ae8e78e496060809
hmac(otra,  'pagar 100 soles') = 91749f1af1c82915c9b254f8203d6abc88cba103ac8d66cb4e2abe1e169f25f5
Ojo: “MAC” aquí nada tiene que ver con la dirección MAC de Ethernet. El nombre es una coincidencia.
Definición. Una firma digital es un resumen hecho con una clave privada, que
cualquiera verifica con la pública. Con openssl y una clave Ed25519:
$ openssl genpkey -algorithm ed25519 -out firma.key
$ openssl pkey -in firma.key -pubout -out firma.pub
$ printf "pagar 100 soles\n" > msg.txt
$ openssl pkeyutl -sign -inkey firma.key -rawin -in msg.txt -out msg.sig
$ wc -c msg.sig
64 msg.sig
$ openssl pkeyutl -verify -pubin -inkey firma.pub -rawin -in msg.txt -sigfile msg.sig
Signature Verified Successfully
$ printf "pagar 900 soles\n" > msg.txt
$ openssl pkeyutl -verify -pubin -inkey firma.pub -rawin -in msg.txt -sigfile msg.sig
20807B83FFFF0000:error:030000EA:digital envelope routines:EVP_DigestVerify:provider signature failure:../crypto/evp/m_sigver.c:781:ED25519 digest_verify:
Signature Verification Failure| ¿Tiene clave? | ¿Quién puede crearlo? | ¿Quién puede verificarlo? | |
|---|---|---|---|
| Hash | No | Cualquiera | Cualquiera |
| MAC | Compartida | Quien tenga la clave | Quien tenga la clave |
| Firma | Privada y pública | Solo el owner de la privada | Cualquiera |
La última fila es la importante. Con un MAC, cualquiera de los dos pudo haber creado el mensaje, así que no le prueba nada a un tercero. Con una firma, solo pudo ser uno. Y por eso sirve para lo siguiente.
Certificados y autoridades de certificación
La firma nos deja un problema: para verificar la firma del servidor necesito su clave pública. Si esa clave me llega por la red, el atacante puede darme la suya. ¿Cómo sé que la clave es de verdad del owner del nombre?
Definición. Un certificado (certificate) es un documento firmado que dice: “esta clave pública pertenece a este nombre, durante estas fechas”. Lo firma una autoridad de certificación (CA), una entidad que, antes de firmar, comprueba que quien lo pide controla el nombre.
Eso no resuelve el problema, lo mueve: ahora necesito la clave de la CA. La diferencia es que esa ya está en mi computadora. Los sistemas operativos y los navegadores traen una lista de CA raíz en las que confían, instalada de fábrica. Esa lista es el verdadero punto de partida de la confianza en la web.
La clase tiene su propia CA. pki.sh la crea y firma varios certificados, para el nombre de
prueba demo.redes.test:
$ make
$ cd build/pki
$ openssl x509 -in good.crt -noout -subject -issuer -dates -ext subjectAltName,basicConstraints
subject=CN=demo.redes.test
issuer=O=Curso de Redes, CN=CA de la clase
notBefore=Nov  2 14:45:13 2026 GMT
notAfter=Dec  2 14:45:13 2026 GMT
X509v3 Subject Alternative Name:
    DNS:demo.redes.test
X509v3 Basic Constraints:
    CA:FALSE
$ openssl verify -CAfile ca.crt good.crt
good.crt: OK
Lean los campos con cuidado:
subjecteissuer: de quién es y quién lo firmó.subjectAltName: los nombres que vale. Es este campo, y no elCNdesubject, el que los clientes actuales comparan con el nombre que pidió el usuario.CA:FALSE: esta clave no puede firmar otros certificados. Sin esa restricción, cualquiera que tuviese un certificado podría emitirlos para el nombre que quiera.- Fechas: un certificado vence. Cuanto menos dure, menos vale uno robado.
En Internet hay un paso más: la raíz casi nunca firma certificados de servidor directamente. Se
guarda sin conexión, y firma a CA intermedias, que son las que firman a diario. El servidor
manda su certificado y las intermedias, y el cliente arma la cadena hasta una raíz que ya
conoce. Así se ve un sitio real, con openssl s_client:
$ python3 internet.py chain
 0 s:CN=www.cloudflare.com
   i:C=US, O=Let's Encrypt, CN=YE1
   a:PKEY: EC, (prime256v1); sigalg: ecdsa-with-SHA384
   v:NotBefore: Nov  1 07:17:46 2026 GMT; NotAfter: Jan 30 07:17:45 2027 GMT
 1 s:C=US, O=Let's Encrypt, CN=YE1
   i:C=US, O=ISRG, CN=Root YE
   a:PKEY: EC, (secp384r1); sigalg: ecdsa-with-SHA384
   v:NotBefore: Sep  3 00:00:00 2025 GMT; NotAfter: Sep  2 23:59:59 2028 GMT
 2 s:C=US, O=ISRG, CN=Root YE
   i:C=US, O=Internet Security Research Group, CN=ISRG Root X2
   a:PKEY: EC, (secp384r1); sigalg: ecdsa-with-SHA384
   v:NotBefore: May 13 00:00:00 2026 GMT; NotAfter: Sep  2 23:59:59 2032 GMT
 3 s:C=US, O=Internet Security Research Group, CN=ISRG Root X2
   i:C=US, O=Internet Security Research Group, CN=ISRG Root X1
   a:PKEY: EC, (secp384r1); sigalg: sha256WithRSAEncryption
   v:NotBefore: May 13 00:00:00 2026 GMT; NotAfter: Sep  2 23:59:59 2032 GMT
Verification: OK
New, TLSv1.3, Cipher is TLS_AES_256_GCM_SHA384
Verify return code: 0 (ok)
Protocol: TLSv1.3
Cada i: (issuer) es el s: (subject) de la línea siguiente. El certificado 0 dura 90
días. Lo que ustedes vean cambiará con el tiempo: es un dato vivo, no algo para memorizar.
Idea clave. Un certificado es público. Cualquiera puede bajar el de su banco y presentarlo. Lo que un atacante no puede hacer es probar que tiene la clave privada que le corresponde. Por eso el certificado por sí solo no autentica: la prueba es la firma que el servidor hace durante el handshake, como vamos a ver.
En la práctica. El punto débil del sistema es que cualquier CA de la lista puede firmar para cualquier nombre. Ha pasado que una CA comprometida emitió certificados falsos para sitios grandes. Como defensa, hoy los certificados se publican en registros públicos de solo agregar (Certificate Transparency), donde el owner de un nombre puede ver si alguien emitió uno a su nombre.
TLS 1.3, paso a paso
Ya están todas las piezas. TLS (Transport Layer Security) corre encima de TCP, y le da a la aplicación un stream de bytes protegido. El handshake hace tres cosas a la vez: acuerda las claves, autentica al servidor y deja listo el cifrado. Y las hace en una sola ida y vuelta:
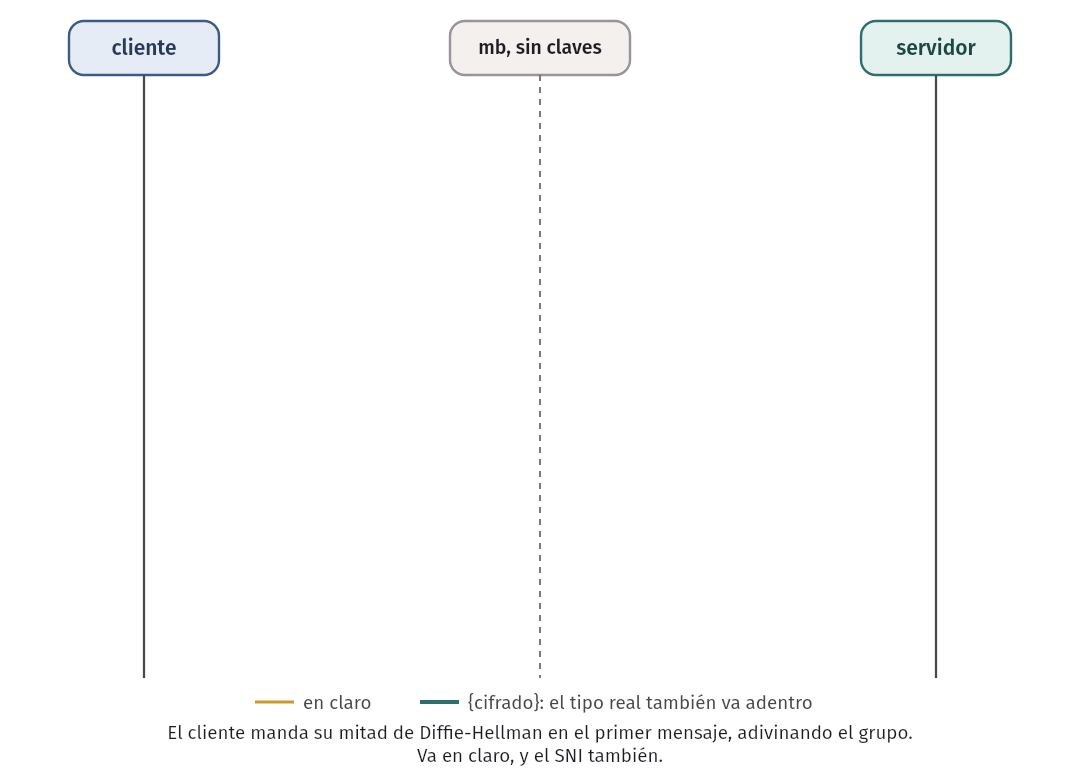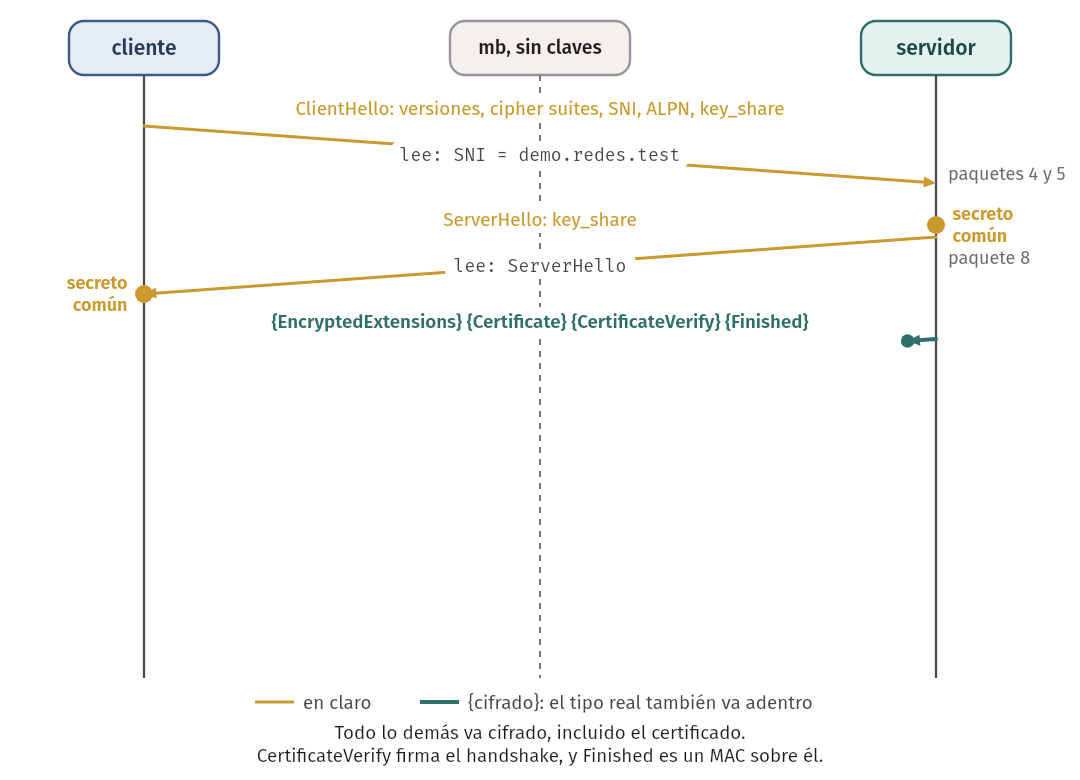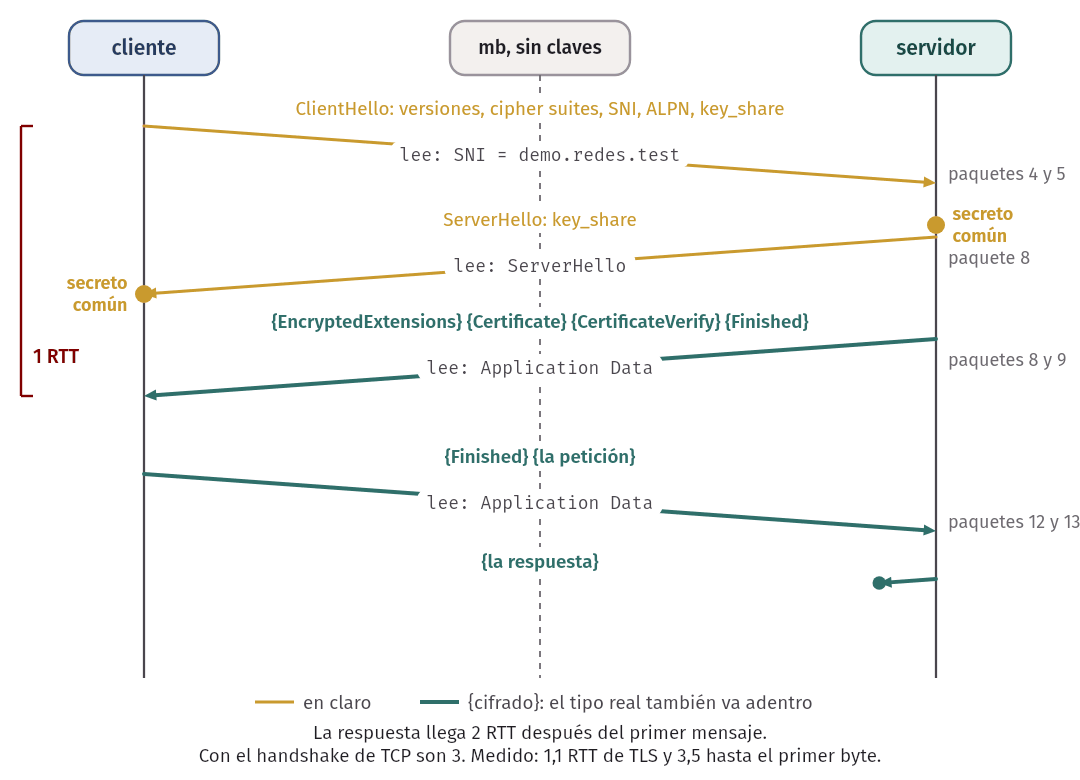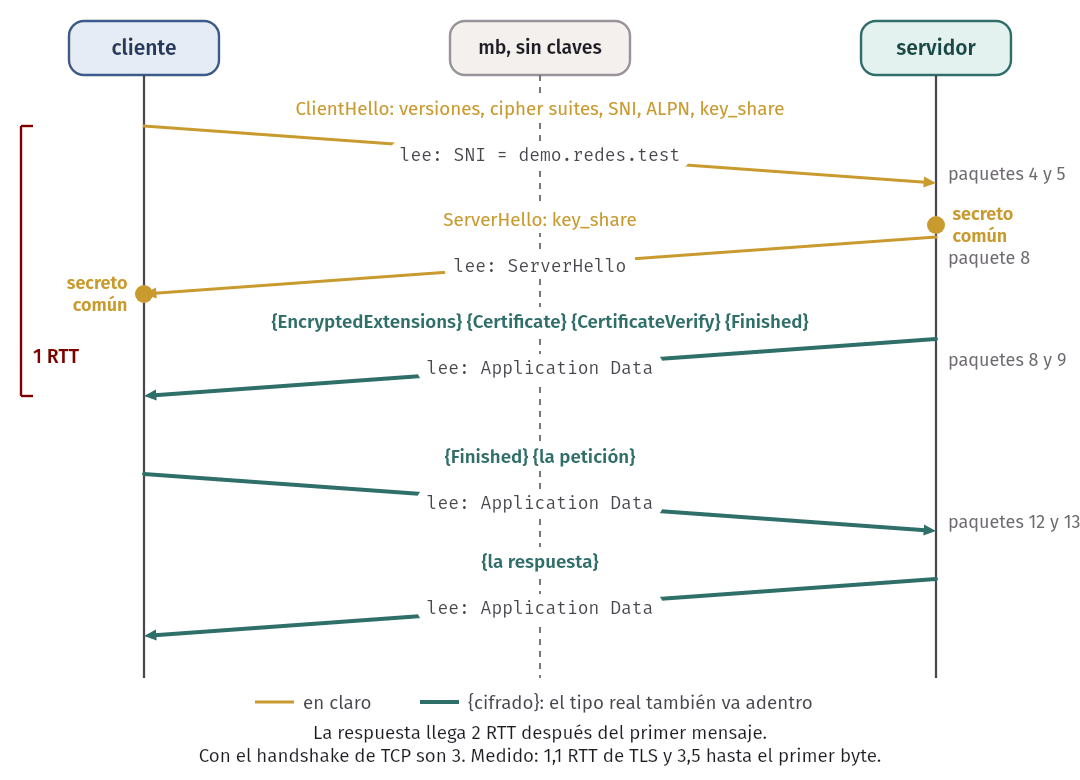
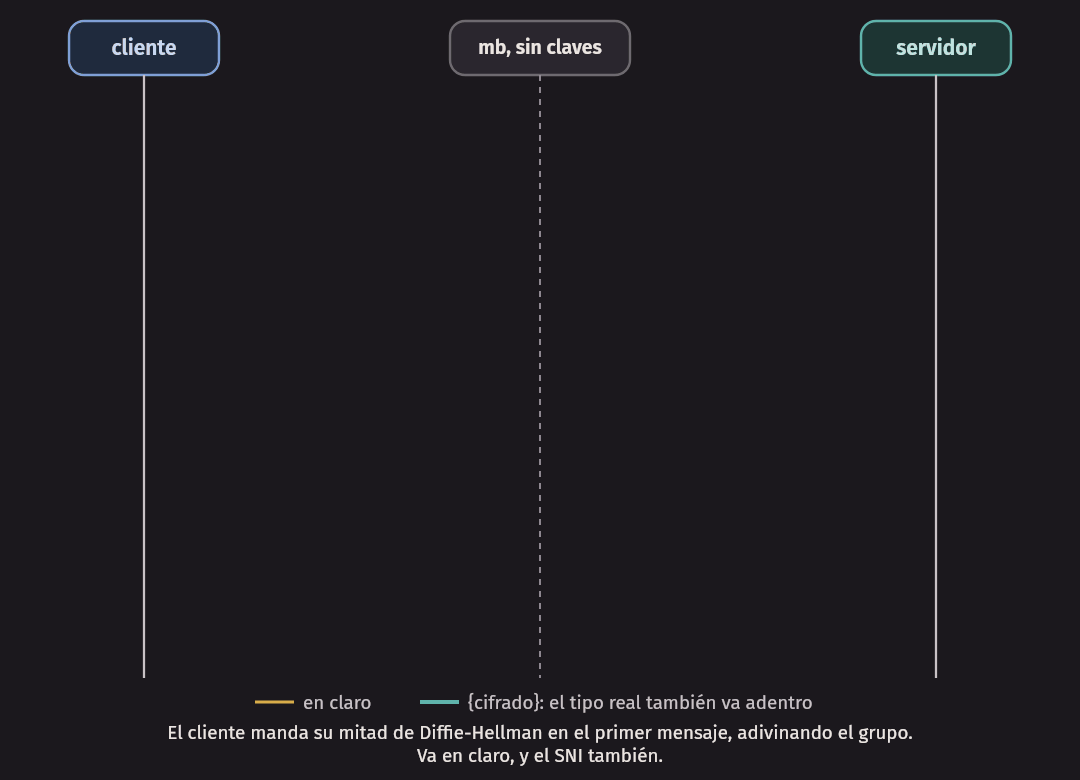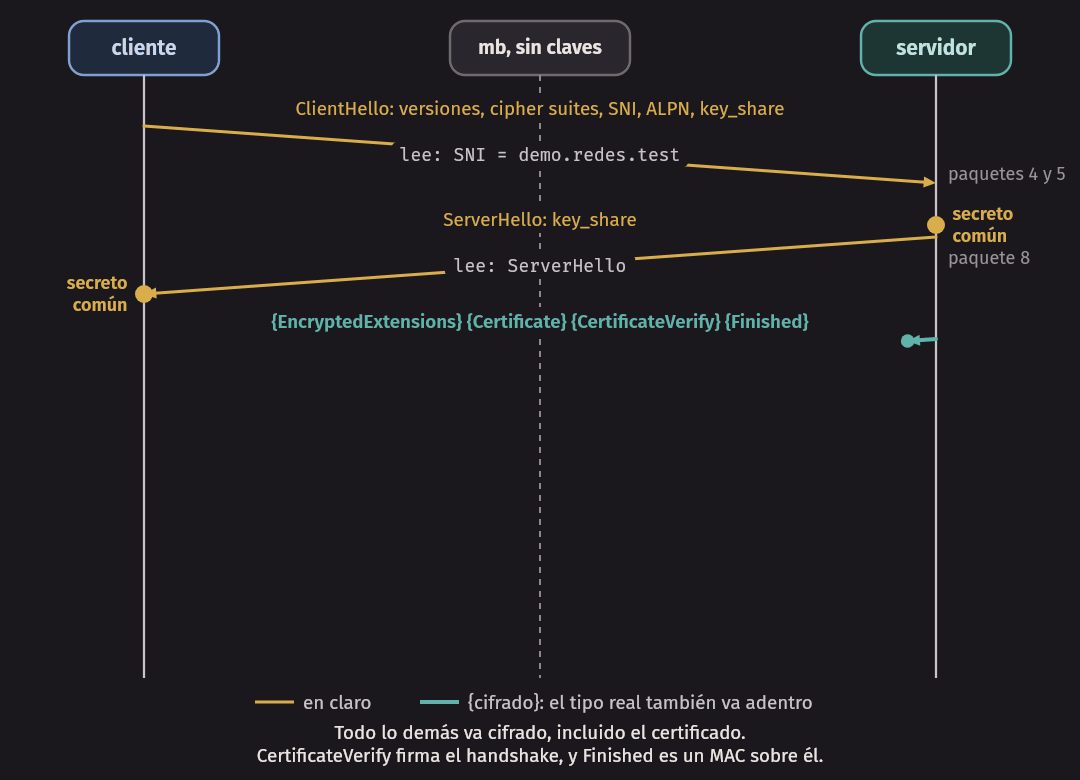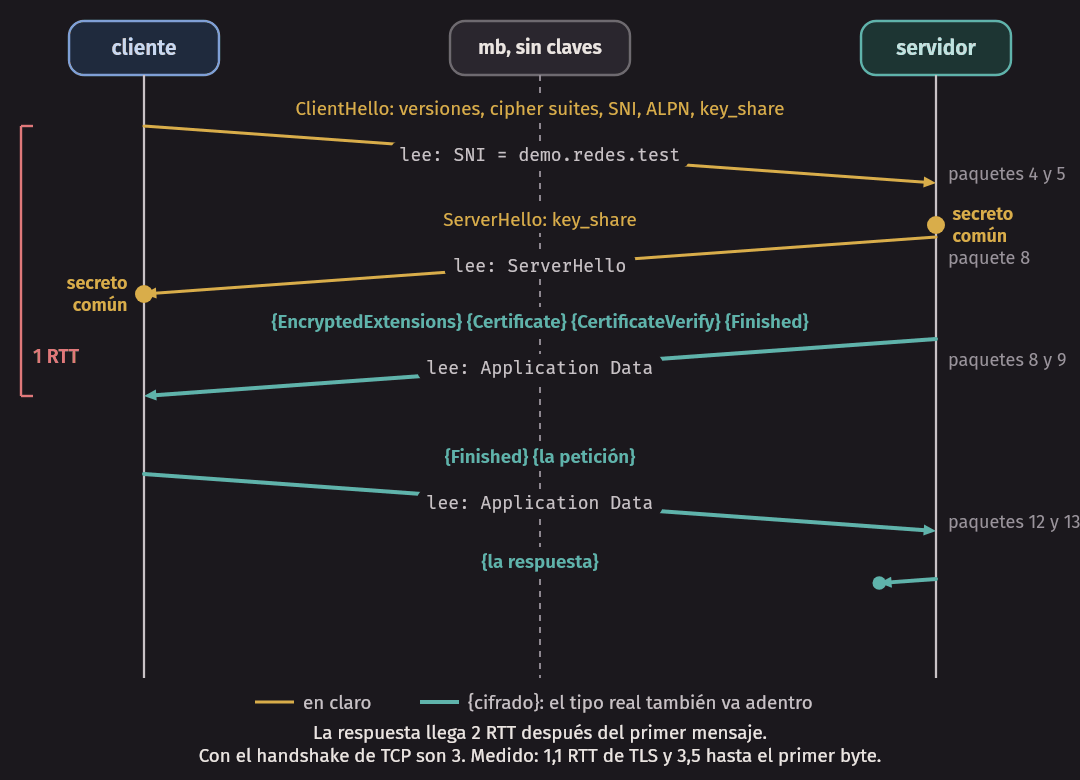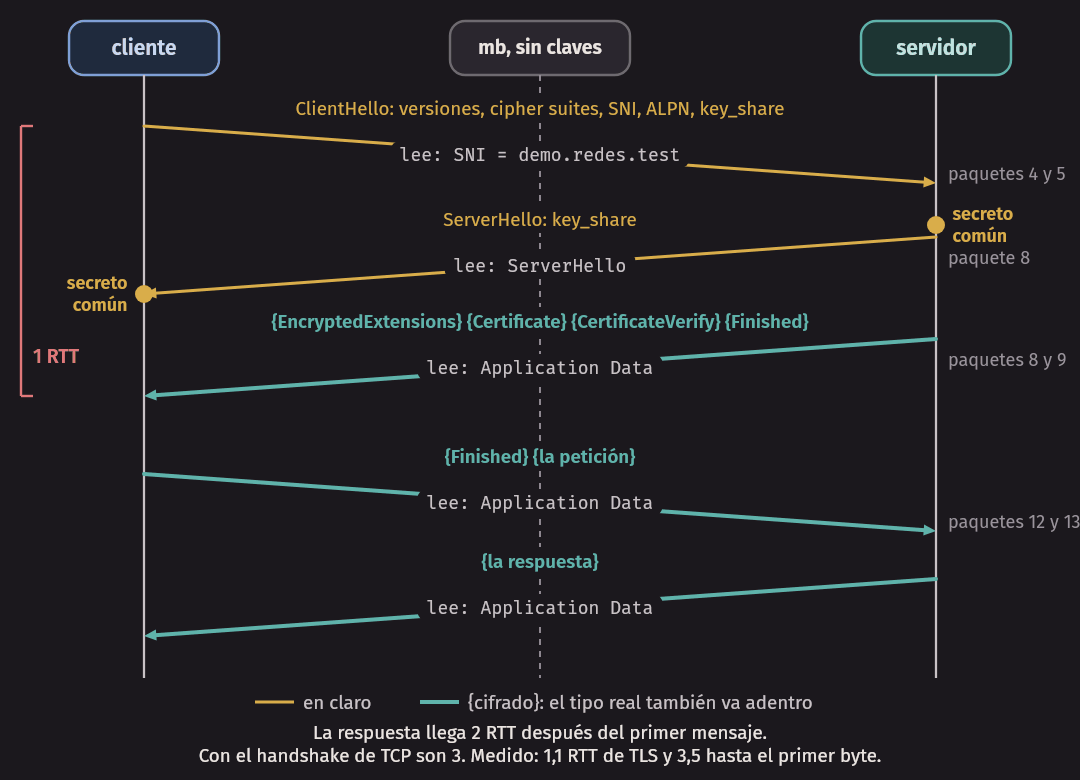
Las llaves {} marcan lo que va cifrado. Mensaje por mensaje:
ClientHello. Las versiones que el cliente entiende, las cipher suites, el nombre del servidor (SNI), los protocolos de aplicación que quiere usar (ALPN, por ejemploh2) y, lo importante, su mitad de un Diffie-Hellman adivinando el grupo que el servidor va a aceptar. Esa adivinanza es lo que ahorra una ida y vuelta frente a TLS 1.2.ServerHello. La versión y la suite elegidas, y la mitad de Diffie-Hellman del servidor. Con eso, los dos ya pueden calcular el mismo secreto, y de él derivan las claves del handshake. Todo lo que sigue va cifrado.Certificate. La cadena de certificados del servidor. A diferencia de TLS 1.2, ya no se ve desde afuera.CertificateVerify. La pieza que importa: una firma, con la clave privada del certificado, sobre el resumen de todos los mensajes anteriores del handshake. Prueba dos cosas: que el servidor tiene la clave privada, y que es él quien mandó ese Diffie-Hellman. Es lo que detiene al man-in-the-middle de la sección anterior.Finished. Un MAC sobre todo el handshake, de cada lado, con claves derivadas del secreto. Si alguien cambió un byte de un mensaje, por ejemplo para quitar las mejores cipher suites de la oferta, el MAC no coincide y la conexión se cae.
Dos consecuencias conviene ver con calma:
El cliente puede mandar datos justo después de su Finished, sin esperar otra respuesta.
Contando el handshake de TCP:
| Protocolo | RTT antes de que el cliente reciba el primer byte de respuesta |
|---|---|
| TCP solo | 2 (handshake de TCP, petición) |
| TCP + TLS 1.3 | 3 (TCP, TLS, petición) |
| TCP + TLS 1.2 | 4 (TCP, dos de TLS, petición) |
Normalmente, el servidor no autentica al cliente. El cliente sabe con quién habla, pero el servidor no. Para eso están la contraseña o la cookie, que ahora viajan protegidas. TLS permite pedir certificado al cliente, y es común entre servicios de una misma empresa, pero no en la web.
Contar los RTT
Vamos a comprobarlo en una red con un RTT conocido. net/net.clab.yml tiene un cliente c, un
servidor s y un router mb en el medio, con 20 ms de retardo en cada una de sus dos
interfaces. Con 20 ms de ida y 20 de vuelta, son 40 ms de RTT:
 c 10.213.1.10 ---- eth1 mb eth2 ---- 10.213.2.10 s
                  20 ms por interfaz
Del lado del servidor corre openssl s_server -www, que responde a cualquier GET con una
página de estado. Desde c, curl mide cada fase, y conectamos 7 veces para sacar la mediana:
$ make up
$ python3 scenarios.py rtts
RTT de la red: 40 ms (retardo de netem en mb). Medianas de 7 conexiones, en ms.
           TCP listo  TLS listo  primer byte  RTT del TLS  RTT al byte
TLS 1.3         44.1       88.7        138.0          1.1          3.5
TLS 1.2         43.2      129.1        170.9          2.1          4.3
La columna “RTT del TLS” es (TLS listo - TCP listo) / 40. Es lo que la teoría anticipa: uno
contra dos. Con TLS 1.2, el cliente no puede pedir hasta completar dos idas y vueltas después de
TCP. La última columna es el primer byte dividido entre 40: 3,5 y 4,3, es decir, los 3 y 4 RTT
de la tabla más lo que tarda s_server en armar su página y lo que cuesta correr todo en
contenedores. Estos valores son de una corrida, y varían un poco.
Error común. Creer que TLS 1.3 es más rápido porque cifra mejor. El cifrado de los datos cuesta casi lo mismo. Lo que cambió es el diseño del handshake: el cliente manda su
key_shareen el primer mensaje, en vez de negociar y luego mandarlo.
Forward secrecy
Imaginen a alguien que graba todo el tráfico cifrado de un servidor durante años, sin poder leerlo. Un día, roba la clave privada del certificado. ¿Puede descifrar lo que grabó?
Con el intercambio RSA de TLS 1.2, sí: el cliente elegía un secreto y lo mandaba cifrado con la clave pública del servidor. Con la clave privada se sacan todos los secretos de todas las conexiones viejas. Una sola clave robada abre años de tráfico. (TLS 1.2 también permitía Diffie-Hellman efímero, pero era opcional.)
Definición. Hay forward secrecy si robar las claves de larga duración no permite descifrar sesiones pasadas.
TLS 1.3 la da porque ya no existe el intercambio RSA. Cada conexión hace un Diffie-Hellman efímero: las dos mitades secretas se crean para esa conexión, y se borran al calcular la clave. La clave privada del certificado solo firma, y nunca interviene en el secreto. Quien la robe puede hacerse pasar por el servidor a partir de ese día, lo cual es grave, pero no puede abrir lo grabado: los números que hacían falta ya no existen en ninguna parte.
Idea clave. Autenticar y acordar son dos trabajos distintos, y TLS 1.3 los separa. La clave de larga duración firma, y la efímera acuerda. Separarlas es lo que hace que un robo no se propague hacia atrás.
Los tickets de reanudación, que veremos con 0-RTT, relajan esto un poco: los datos de 0-RTT no tienen forward secrecy frente al robo de la clave con la que el servidor protege sus tickets (RFC 8446, sec. 2.3).
Lo que ve quien está en el medio
Ahora capturemos ese handshake desde mb, el lugar donde estaría un atacante o el firewall de
una empresa. Sin ninguna clave:
$ python3 scenarios.py observer
Lo que ve mb, sin claves:
4	10.213.1.10
5	10.213.1.10	Client Hello (SNI=demo.redes.test)
8	10.213.2.10	Server Hello, Change Cipher Spec, Application Data
9	10.213.2.10	Application Data, Application Data, Application Data
12	10.213.1.10	Change Cipher Spec, Application Data
13	10.213.1.10	Application Data
14	10.213.2.10	Application Data
15	10.213.2.10	Application Data
16	10.213.2.10
19	10.213.2.10	Application Data
20	10.213.2.10	Application Data
23	10.213.1.10	Application Data

El nombre del servidor, leído sin claves:
demo.redes.test

Mensajes de certificado que se pueden leer: 0
Las columnas son número de paquete, origen e interpretación de tshark. Vamos línea por línea:
- Paquetes 4 y 5:
ClientHello, en claro, partido en dos segmentos TCP. Mide 1570 bytes, más que un MSS: en seguida vemos por qué. - Paquete 8:
ServerHello, en claro. Tiene que ser así, porque lleva la mitad de Diffie-Hellman. Lo que aparece como “Application Data” después es el resto del vuelo. Es un disfraz: los registros cifrados de TLS 1.3 se declaran todos del tipo Application Data, y el tipo real va adentro, cifrado. - Paquete 9: ese “Application Data” incluye el certificado. Nadie en el camino sabe a qué servidor le pertenece el certificado que se presentó.
Change Cipher Spec: no hace nada. TLS 1.3 lo manda solo para parecerse a una conexión de TLS 1.2, porque algunos middleboxes viejos cortaban lo que no reconocían (RFC 8446, apéndice D.4). Es un rastro de un problema que resolverá QUIC.
Leer el ClientHello sin saber TLS
Esa última línea es el corazón del error común de esta sesión. sni_peek.c es un programa en C
de unas 250 líneas que abre un socket TCP, lee el primer registro y recorre sus campos. No
enlaza con ninguna biblioteca de TLS, no tiene clave ni certificado, y nunca responde. Ve lo
mismo que cualquier equipo del camino:
$ python3 scenarios.py peek
escuchando en el puerto 443
conexión de 10.213.1.10
  registro: tipo 22 (handshake), versión 3.1, 1570 bytes
  cipher suites ofrecidas: 30
  SNI: demo.redes.test
  ALPN: h2 http/1.1
  versiones: TLS1.3 TLS1.2
  key_share: grupo 0x11ec (1216 bytes) grupo 0x001d (32 bytes)
Fíjense en tres cosas:
versión 3.1es lo que declara el registro, aunque el cliente ofrezca TLS 1.3. La negociación real va en la extensiónsupported_versions. Otra vez: si el campo original dijera la versión nueva, algunos middleboxes cortarían la conexión.- El grupo
0x001des X25519, con los 32 bytes que esperábamos. El grupo0x11eces X25519MLKEM768, un híbrido con un esquema resistente a computadoras cuánticas, cuya clave ocupa 1216 bytes. Por eso elClientHelloya no entra en un solo paquete. La razón de agregarlo es que alguien podría grabar tráfico hoy y descifrarlo cuando exista una computadora así. - El parser desconfía de todo. Cada campo de largo viene del otro extremo, y puede mentir. Por eso el código lee a través de un cursor que revisa los límites en cada paso, y escapa los bytes no imprimibles antes de mostrarlos. Las pruebas le mandan recortes del mensaje en doce puntos, y largos falsos. Es el mismo cuidado que van a necesitar en P5 con las peticiones mal formadas.
Veamos el cursor, porque es la idea que se lleven al leer cualquier protocolo binario:
struct cursor {
    const uint8_t *data;
    size_t left;
};

static int read_u16(struct cursor *c, unsigned *value) {
    if (c->left < 2) return -1;
    *value = ((unsigned)c->data[0] << 8) | c->data[1];
    c->data += 2;
    c->left -= 2;
    return 0;
}
Error común. Creer que HTTPS oculta todo. Quien observa la red todavía ve: las direcciones IP de los dos extremos, los tiempos y tamaños de cada mensaje (suficiente, a veces, para adivinar qué video se ve o qué página se abrió), y normalmente el nombre del servidor en el SNI. Además, si la consulta de DNS no va cifrada, también la ve. Lo que queda oculto es la ruta, los headers, las cookies y el contenido:
/banco/transferirse oculta,www.banco.peno.
El SNI no se puede cifrar con las claves de la sesión por un problema de orden: el servidor
necesita saber qué nombre le piden para elegir qué certificado presentar, y eso pasa antes
de que exista ninguna clave. Hay una extensión que resuelve esto, Encrypted Client Hello, que
cifra el ClientHello interno con una clave publicada en DNS. Su adopción todavía es parcial, y
el curl de nuestro contenedor no la usó en estas capturas.
En la práctica. Muchos firewalls filtran por SNI: no pueden ver la página, pero sí el nombre. Y algunas empresas instalan su propia CA en las laptops de los empleados para hacer un man-in-the-middle autorizado, y abrir el contenido. Lo que protege al usuario en ese caso no es la matemática: ya confía en quien lo intercepta, porque su computadora trae esa CA.
Descifrar la captura, con permiso
Los extremos sí tienen las claves. Si curl encuentra la variable SSLKEYLOGFILE, escribe los
secretos de cada conexión en ese archivo. tshark y Wireshark los pueden leer, y abrir la
captura:
$ python3 scenarios.py keylog
Etiquetas del archivo de claves:
CLIENT_HANDSHAKE_TRAFFIC_SECRET
CLIENT_TRAFFIC_SECRET_0
EXPORTER_SECRET
SERVER_HANDSHAKE_TRAFFIC_SECRET
SERVER_TRAFFIC_SECRET_0

La misma captura, ahora con las claves:
4	10.213.1.10
5	10.213.1.10	Client Hello (SNI=demo.redes.test)
8	10.213.2.10	Server Hello, Change Cipher Spec, Encrypted Extensions
9	10.213.2.10	Certificate, Certificate Verify, Finished
12	10.213.1.10	Change Cipher Spec, Finished
13	10.213.1.10	GET / HTTP/1.1
14	10.213.2.10	New Session Ticket
15	10.213.2.10	New Session Ticket
16	10.213.2.10
19	10.213.2.10	[TLS segment of a reassembled PDU]
23	10.213.1.10	Alert (Level: Warning, Description: Close Notify)

La petición, en claro:
GET	/	demo.redes.test
Comparen con la captura anterior, línea por línea. Es el diagrama de arriba, en paquetes reales.
Las etiquetas también cuentan algo: hay claves distintas para el handshake y para los datos, y
para cada sentido. Los New Session Ticket son para reanudar más tarde.
Ese archivo es tan sensible como una contraseña: quien lo tenga junto con una captura puede leerlo todo. Se usa para depurar, y nunca en producción.
Qué protege el error de curl
Ahora le presentamos a curl cuatro certificados, todos para el mismo servidor, en la misma
dirección IP. Solo cambia lo que el servidor le muestra:
$ python3 scenarios.py certs
certificado    salida  mensaje de curl
good                0  bien
selfsigned         60  curl: (60) SSL certificate problem: self-signed certificate
wrongname          60  curl: (60) SSL: no alternative certificate subject name matches target hostname 'demo.redes.test'
expired            60  curl: (60) SSL certificate problem: certificate has expired

Con la CA del sistema, sin la CA de la clase:
good               60  curl: (60) SSL certificate problem: unable to get local issuer certificate
Cada fila es un ataque que se detuvo, o un descuido que se detectó:
selfsigned. Cualquiera puede generar uno con cualquier nombre, en un segundo. Si se aceptara, la autenticación no valdría nada. Es exactamente lo que un man-in-the-middle presentaría.wrongname. Firmado por una CA de confianza, y válido… para otro sitio. Sin esta comprobación, quien compre un certificado paraotro.pepodría hacerse pasar por su banco.expired. Vencido. Limita el daño de una clave robada, y es también la causa de muchas caídas reales cuando alguien olvida renovar.- Sin la CA. El mismo
good, ahora sin--cacert. Nada ha cambiado en el servidor: lo que falta es la confianza del cliente. Es el punto del párrafo sobre raíces.
Error común. Resolver esto con
curl -ko desactivando la validación “porque es solo una prueba”. Con eso se conserva el cifrado y se pierde la autenticación: hablan en secreto con quien sea. En un script que terminó en producción, equivale a no tener TLS.
Por qué no se cambia TCP
Empieza la Sesión B. Ya saben que TCP tiene problemas de diseño para la web actual: un handshake que suma un RTT antes de TLS, un solo orden de bytes para todo (el bloqueo que vieron con HTTP/2) y conexiones atadas a cuatro campos. Las soluciones se conocen desde hace años. ¿Por qué no modificar TCP?
Por dos razones que no tienen que ver con TCP, sino con lo que lo rodea:
- El kernel. TCP vive en el sistema operativo. Cambiarlo requiere que Microsoft, Apple, los fabricantes de celulares y cada servidor actualicen su kernel. Algunos dispositivos no se actualizan nunca. Una mejora tarda una década en llegar a la mayoría.
- Los middleboxes. Firewalls, NAT y otros equipos miran los encabezados de TCP, y descartan o “corrigen” lo que no reconocen. Una opción nueva de TCP puede funcionar en el laboratorio y fallar al cruzar la red de un operador. Al protocolo se le fue quitando margen para evolucionar: se dice que se osificó. Lo vimos en TLS 1.3, que tuvo que disfrazarse de TLS 1.2 para pasar.
Lo que el libro llama la evolución de la funcionalidad del transporte (sección 3.8) se resume en esta pregunta: ¿dónde puede vivir un transporte nuevo, si no puede tocar ni el kernel ni lo que los middleboxes entienden?
QUIC responde: en espacio de usuario, dentro de una biblioteca que viene con la aplicación, y sobre UDP, que los middleboxes ya dejan pasar. Una actualización del navegador es una actualización del transporte. Y cifra casi todo, con lo que los middleboxes no tienen nada que osificar.
       HTTP/2 sobre TCP                     HTTP/3 sobre QUIC

   +----------------------+              +----------------------+
   |   HTTP/2 (streams)   |              |       HTTP/3         |   usuario
   +----------------------+              +----------------------+
   |      TLS 1.3         |              |  QUIC (streams,      |
   +----------------------+              |  confiabilidad,      |
   |        TCP           |  kernel      |  congestión, TLS 1.3)|
   +----------------------+              +----------------------+
   |         IP           |              |        UDP           |   kernel
   +----------------------+              +----------------------+
                                         |         IP           |
                                         +----------------------+
UDP aquí aporta casi nada, y justamente por eso sirve: los puertos para que el kernel entregue el datagrama, y un encabezado que todo middlebox ya entiende. El resto del transporte lo hace QUIC. Es como la semana 9 lo anticipaba: UDP es una base sobre la que uno construye lo que necesita.
Error común. Creer que UDP hace a QUIC poco confiable. QUIC implementa todo lo que TCP hace y UDP no: números de secuencia, ACK, retransmisión, control de flujo y control de congestión. Es un transporte confiable completo que usa UDP como sobre, igual que el
rimayque ustedes están terminando en P4. Si llega a la aplicación, llega completo y en orden dentro de su stream.
Una consecuencia práctica: como algunas redes bloquean o limitan UDP, QUIC no se puede dar por hecho. El cliente descubre el soporte con un header, y normalmente sigue teniendo TCP de respaldo:
$ curl -sI --http2 https://www.cloudflare.com/cdn-cgi/trace | grep -iE "^HTTP|alt-svc"
HTTP/2 404
alt-svc: h3=":443"; ma=86400
alt-svc dice: “también tengo HTTP/3 en el puerto 443 de UDP, y puedes recordarlo por un día”.
Un HEAD a esa ruta da 404, y da igual: el header es lo que nos interesa. curl --http3
intenta los dos a la vez. --http3-only, el que usamos aquí para comparar, falla si UDP está
bloqueado.
Streams independientes
QUIC tiene streams como parte del transporte. Cada uno es un flujo ordenado de bytes
independiente, y cada frame STREAM dice a qué stream y en qué offset va. Un paquete perdido
solo deja un hueco en el stream de los datos que llevaba.
El error común de la semana 12 (creer que HTTP/2 eliminó todo bloqueo) se ve exactamente aquí. HTTP/2 tiene streams para sí mismo, pero TCP no lo sabe: lo que ve es un solo stream de bytes. Si falta un segmento, TCP no le entrega a HTTP/2 nada de lo que vino después, aunque sea de otro stream. A eso se le llama bloqueo en la cabeza de la fila (head-of-line blocking).
Para verlo hay un simulador, no una medición: el contenedor del curso tiene un cliente de
HTTP/3, pero no un servidor con el que controlar pérdidas. hol_sim.py reduce el problema a lo
que importa. Tres streams se turnan, y se pierde un paquete. Lo único que cambia entre los dos
modos es qué orden respeta el receptor:
$ python3 hol_sim.py
TX=10 ms, retardo=50 ms, recuperación=100 ms, se pierde el paquete 3
paq stream llega  entrega(TCP)  entrega(QUIC)
  0 A0        50           50             50
  1 B0        60           60             60
  2 C0        70           70             70
  3 A1       180          180            180  <- perdido, llega retransmitido
  4 B1        90          180             90
  5 C1       100          180            100
  6 A2       110          180            180
  7 B2       120          180            120
  8 C2       130          180            130
  9 A3       140          180            180
 10 B3       150          180            150
 11 C3       160          180            160

          TCP: esperan, máx.     QUIC: esperan, máx.
A                3    100 ms              3   100 ms
B                3     90 ms              0     0 ms
C                3     80 ms              0     0 ms
Lean las columnas del paquete 4, de otro stream. Llegó a los 90 ms. En TCP, la aplicación lo recibe a los 180, porque antes de él hay un hueco. En QUIC, a los 90.
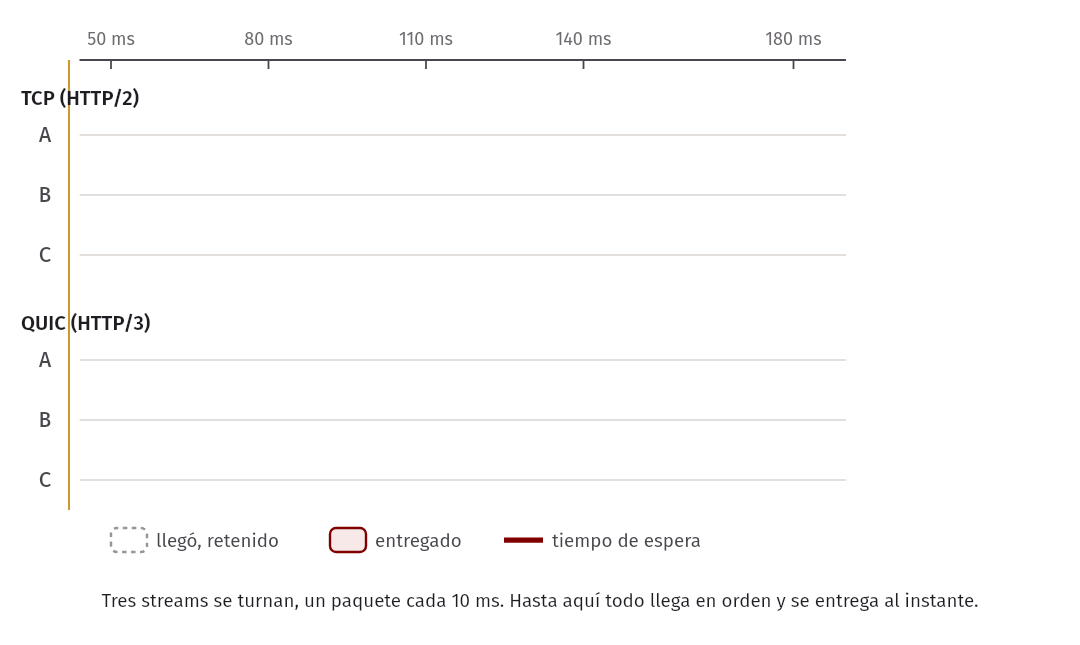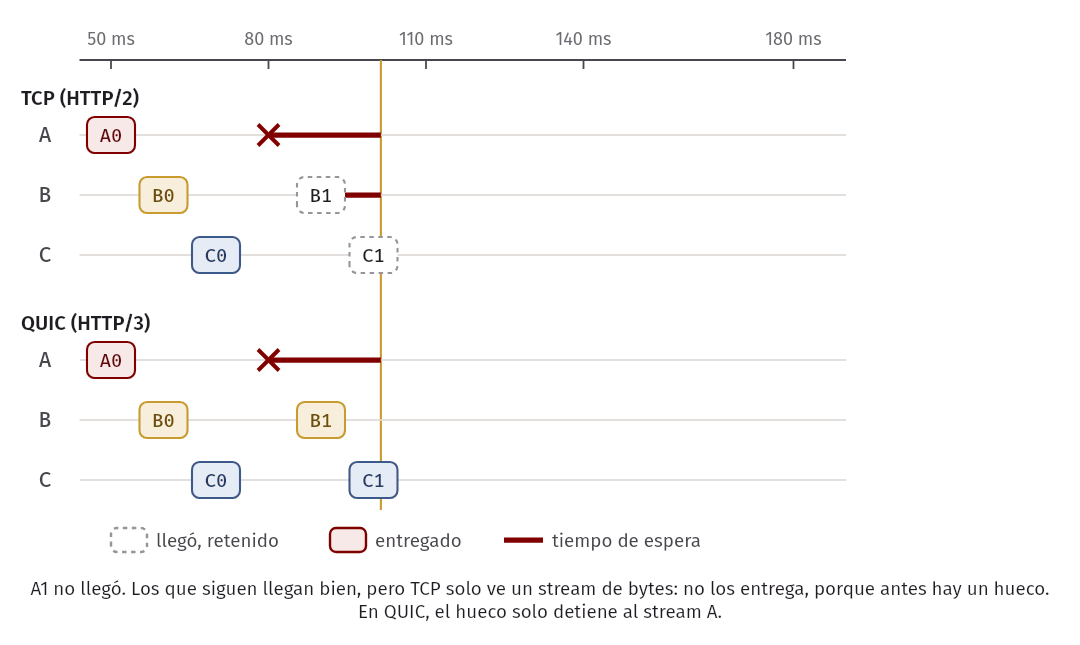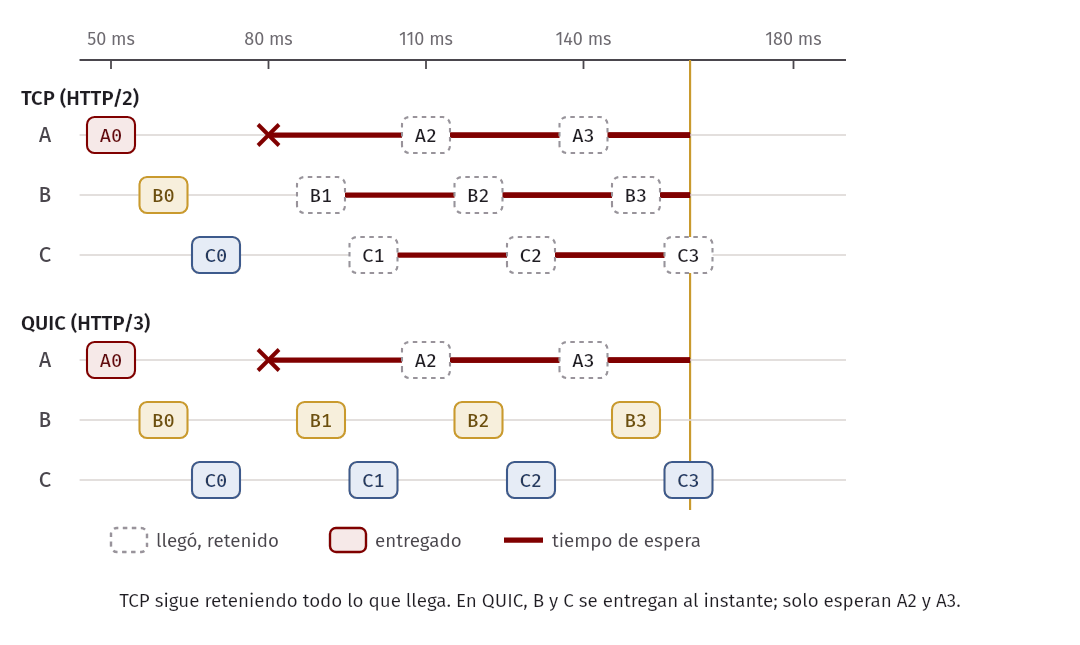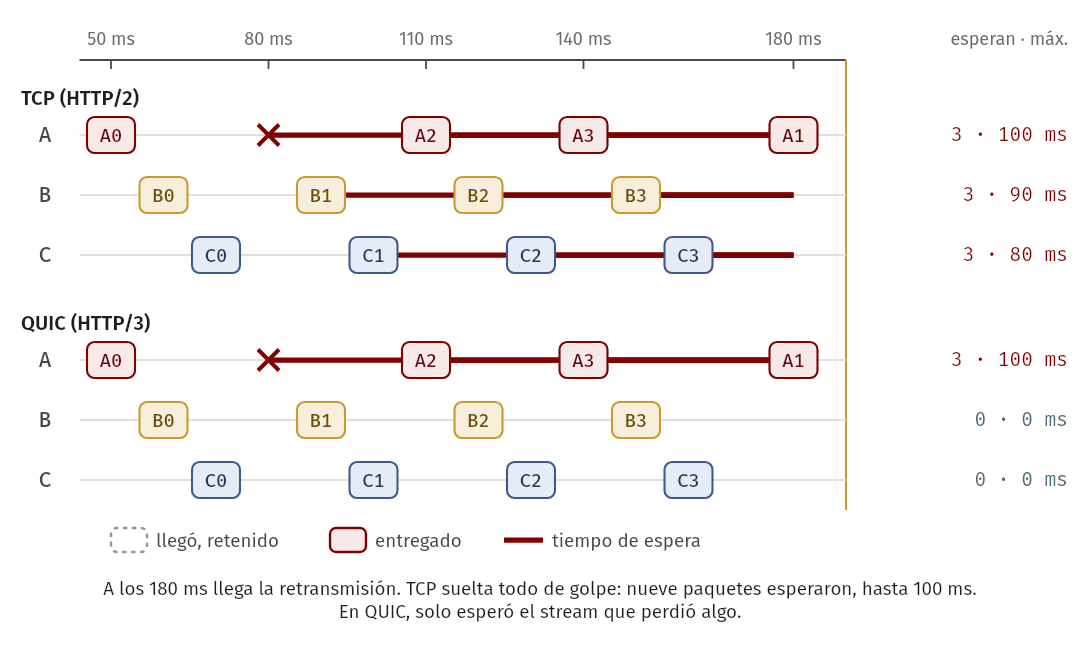
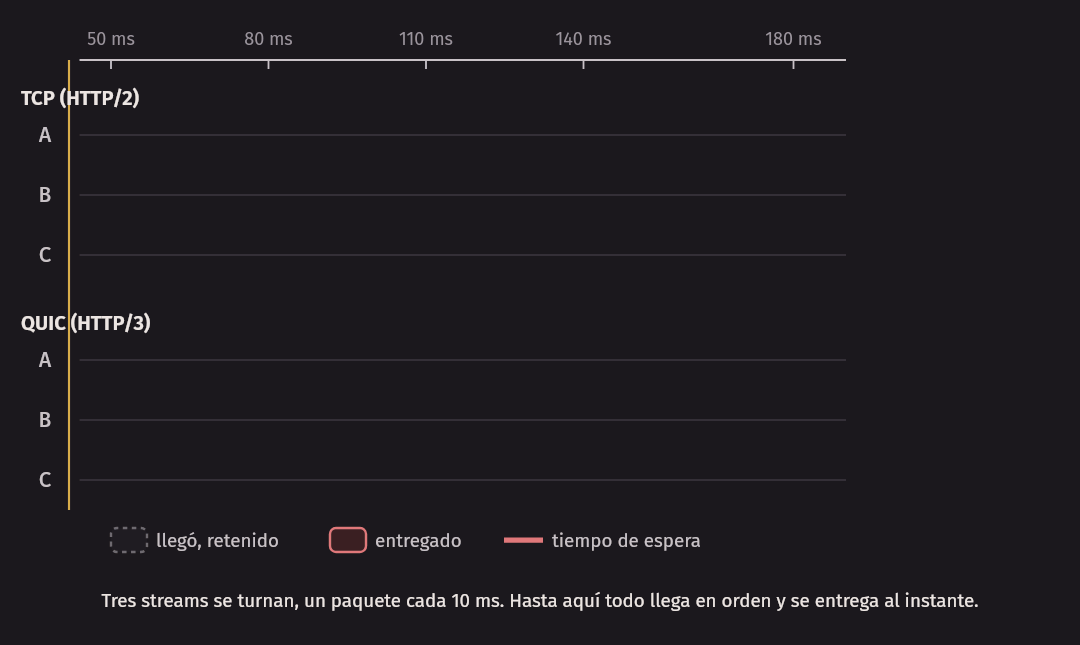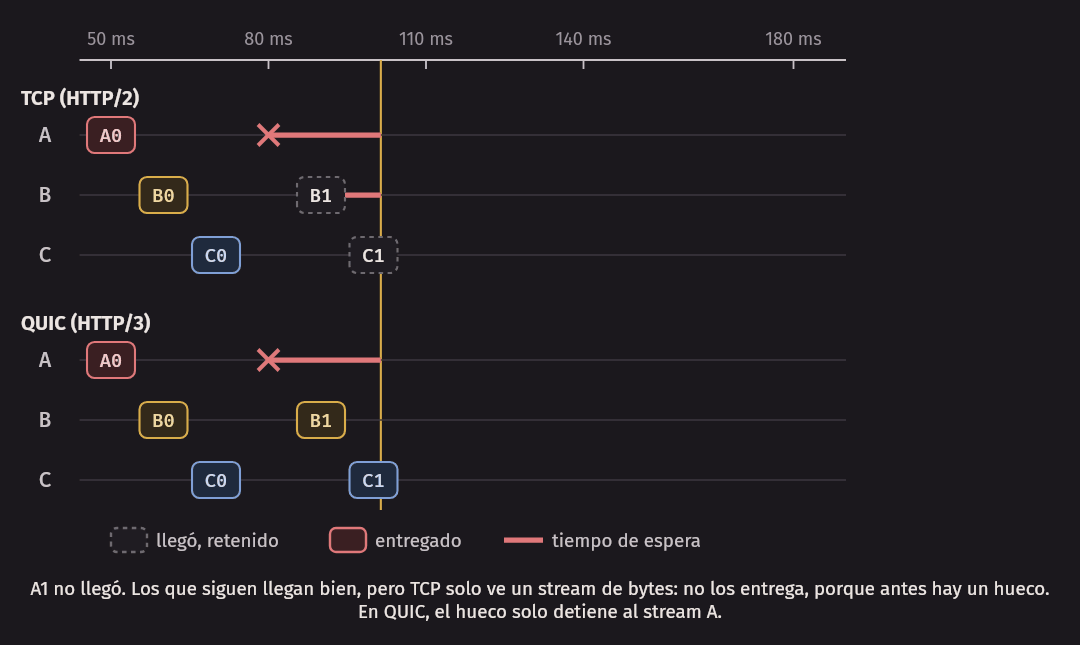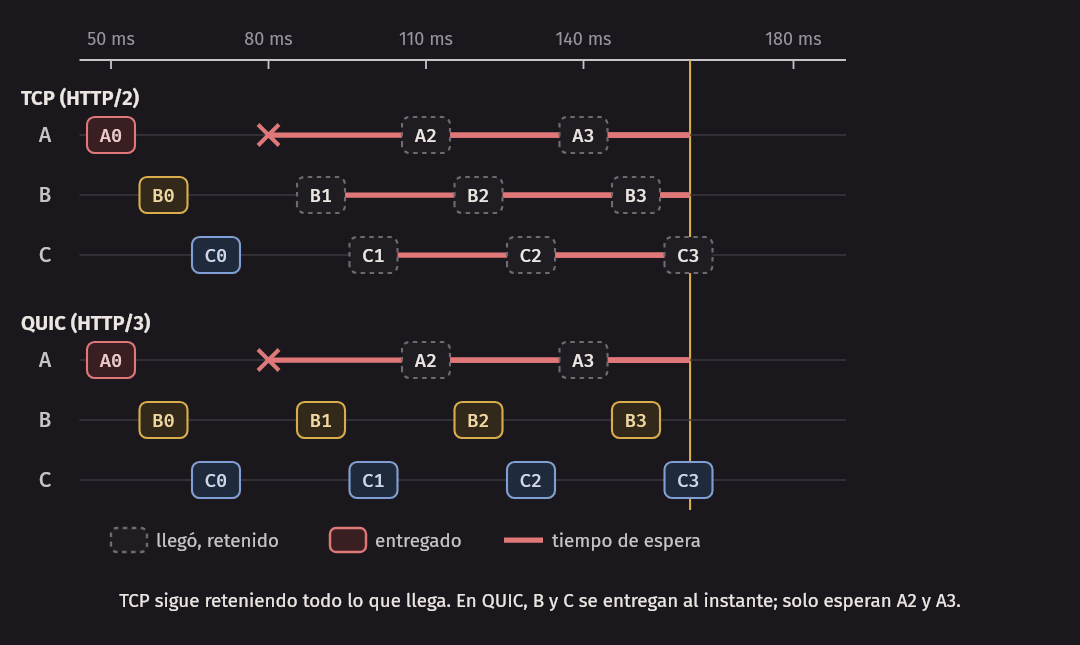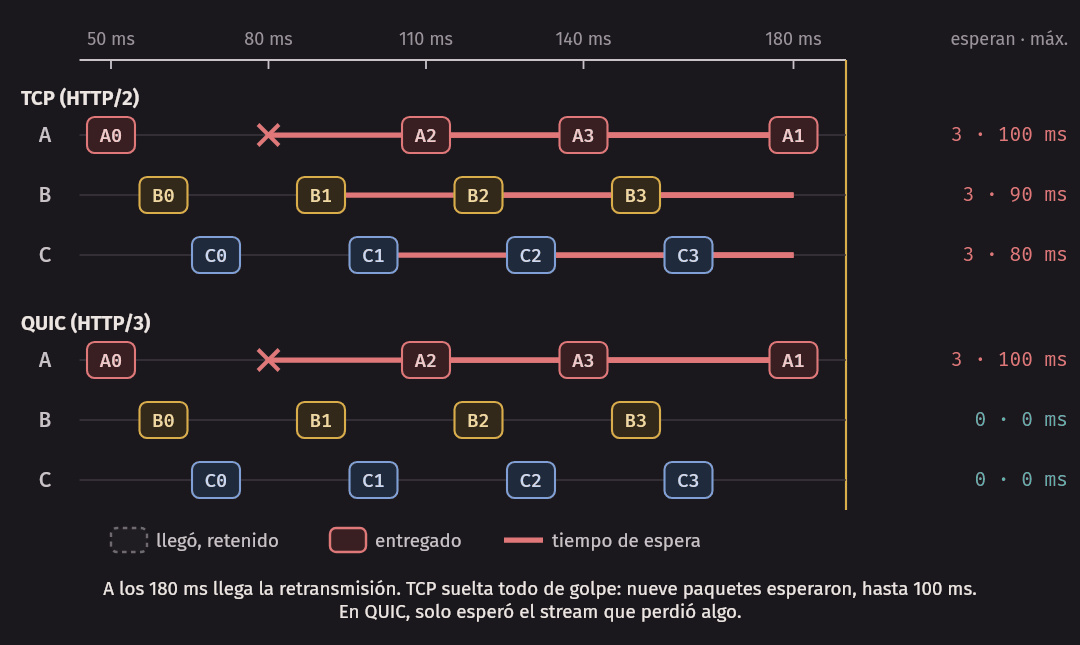
Con esto se responde la pregunta 4 de repaso, y conviene hacerlo con cuidado:
- En HTTP/2: una pérdida detiene todos los streams, hasta que llegue la retransmisión.
- En HTTP/3: detiene solo el stream que perdió algo. Los demás siguen.
- Si hay un solo stream, no hay ninguna diferencia, y las pruebas lo comprueban. Una descarga de un archivo grande no gana nada con esto. Gana una página con muchos recursos, en una red con pérdidas.
Los streams, en una captura real
Se pueden ver en la conexión real con Cloudflare, usando las claves. Cada línea es un paquete:
$ python3 internet.py quic
Sin claves:
1	1208	Initial, DCID=d698867006b8e705, PKN: 0, CRYPTO
2	1208	Initial, DCID=d698867006b8e705, PKN: 1, CRYPTO, PADDING
3	1208	Initial, SCID=01f9a53171c3575aa4fd80317dc2b55aa4c2f59d, PKN: 0, ACK, CRYPTO
4	1208	Initial, SCID=01f9a53171c3575aa4fd80317dc2b55aa4c2f59d, PKN: 1, CRYPTO
5	1208	Handshake, SCID=01f9a53171c3575aa4fd80317dc2b55aa4c2f59d
6	1208	Handshake, SCID=01f9a53171c3575aa4fd80317dc2b55aa4c2f59d
7	1208	Handshake, SCID=01f9a53171c3575aa4fd80317dc2b55aa4c2f59d
8	295	Handshake, SCID=01f9a53171c3575aa4fd80317dc2b55aa4c2f59d
9	1208	Handshake, DCID=01f9a53171c3575aa4fd80317dc2b55aa4c2f59d
10	67	Protected Payload (KP0), DCID=01f9a53171c3575aa4fd80317dc2b55aa4c2f59d
11	52	Protected Payload (KP0), DCID=01f9a53171c3575aa4fd80317dc2b55aa4c2f59d

SNI y ALPN que tshark lee sin claves:
www.cloudflare.com	h3

Con SSLKEYLOGFILE, los paquetes que llevan streams:
10	HTTP3	Protected Payload (KP0), DCID=01f9a53171c3575aa4fd80317dc2b55aa4c2f59d, PKN: 0, STREAM(2), SETTINGS
11	HTTP3	Protected Payload (KP0), DCID=01f9a53171c3575aa4fd80317dc2b55aa4c2f59d, PKN: 1, STREAM(10)
12	HTTP3	Protected Payload (KP0), DCID=01f9a53171c3575aa4fd80317dc2b55aa4c2f59d, PKN: 2, STREAM(6)
13	HTTP3	Protected Payload (KP0), DCID=01f9a53171c3575aa4fd80317dc2b55aa4c2f59d, PKN: 3, STREAM(0), HEADERS: GET /cdn-cgi/trace
15	HTTP3	Protected Payload (KP0), PKN: 7, ACK, STREAM(3), SETTINGS
16	HTTP3	Protected Payload (KP0), PKN: 8, STREAM(7)
17	HTTP3	Protected Payload (KP0), PKN: 9, STREAM(11)
18	HTTP3	Protected Payload (KP0), PKN: 10, STREAM(15)[Malformed Packet]
La segunda columna, en el primer bloque, es el largo de UDP. Los números de stream no son arbitrarios. Según el RFC 9000 (sec. 2.1), los dos bits bajos dicen de qué tipo es cada uno:
| Bits bajos | Quién lo abre | Sentido | En la captura |
|---|---|---|---|
00 |
Cliente | Dos sentidos | Stream 0: la petición GET |
01 |
Servidor | Dos sentidos | |
10 |
Cliente | Uno | Streams 2, 6 y 10: control y QPACK (compresión de headers) |
11 |
Servidor | Uno | Streams 3, 7, 11 y 15 |
Cada petición de HTTP/3 usa su propio stream de dos sentidos, y por eso la siguiente iría en el
4. El stream 15 aparece marcado como [Malformed Packet] por tshark: no lo investigamos, y no
afecta a la descarga, que terminó bien. Los números de paquete también merecen atención: el
cliente usó el 0 y el 1 en sus Initial, y vuelve a usar el 0 en su primer paquete de datos,
porque cada nivel lleva su propio espacio de números. Y fíjense en el ID: el cliente empieza con
un DCID elegido por él al azar, y en cuanto el servidor anuncia el suyo (SCID), pasa a usar
ese.
Una diferencia con TCP que vale la pena: en QUIC un paquete retransmitido lleva un número de paquete nuevo. Lo que se repite son los datos del frame, y no el número. Por eso desaparece la ambigüedad del RTT de un segmento retransmitido, que vieron con TCP en la semana 10: cada ACK dice sin dudas de qué transmisión habla.
El handshake integrado
En TCP con TLS, se hacen dos handshakes en fila, porque son dos protocolos en capas. En QUIC,
el mismo vuelo establece el transporte y la seguridad: los mensajes de TLS 1.3
(ClientHello, etc.) viajan en frames CRYPTO de QUIC. TLS no cifra los paquetes por su
cuenta, como haría sobre TCP: entrega los secretos y QUIC protege sus propios paquetes (RFC
9001).
En Internet se ve con claridad. El mismo recurso, en 11 conexiones nuevas, desde el contenedor del curso. Es una medición de un día, contra un sitio concreto:
$ python3 internet.py h2h3
www.cloudflare.com/cdn-cgi/trace: medianas de 11 conexiones nuevas, en ms
         versión    DNS  conexión  TLS listo  primer byte   total
HTTP/2         2    2.3      38.3       79.6        118.5   118.6
HTTP/3         3    1.9      46.4       46.9         86.8    86.9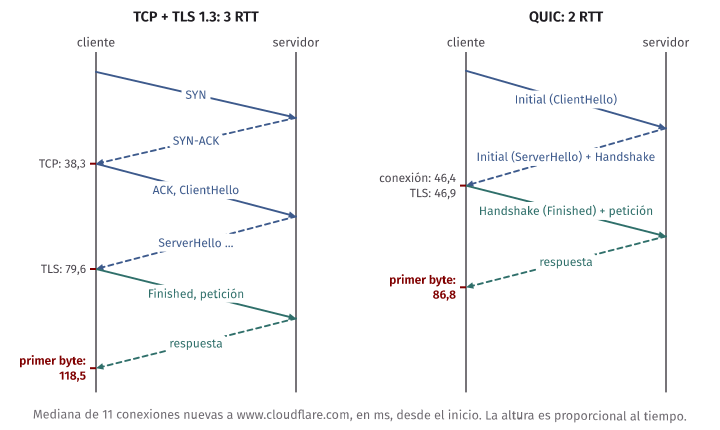
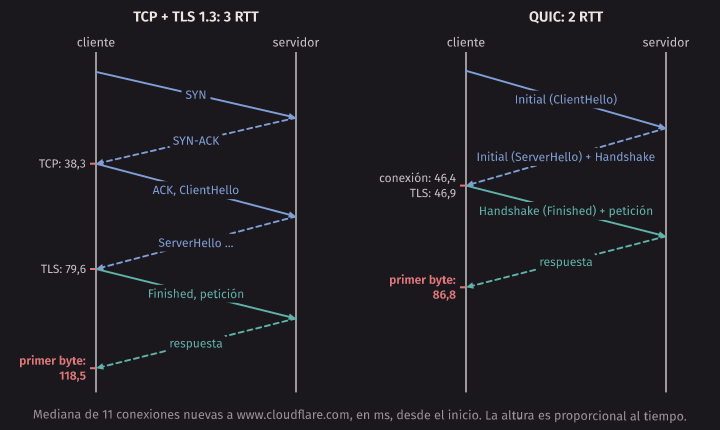
- HTTP/2: con un RTT cercano a 40 ms, cada fase suma un RTT: 38, 80, 118. Son los 3 RTT de la tabla. Medimos también desde la laptop, sin contenedor, y el resultado es el mismo. No es efecto del proxy de Docker Desktop.
- HTTP/3: la “conexión” y el “TLS listo” son casi iguales, porque son el mismo handshake. Por eso no tiene sentido comparar el 38,3 con el 46,4: el segundo incluye a TLS. El primer byte llega en 2 RTT más algo de trabajo: 87 ms.
Se ahorró un RTT completo. En un celular con 100 ms de RTT, serían 100 ms por conexión nueva. Ese es el beneficio, y es por el handshake, no por la velocidad de transferencia. En una descarga larga sobre una red estable, la diferencia se diluye.
Idea clave. Las ganancias de QUIC se concentran en tres lugares: conexiones nuevas (un RTT menos), redes con pérdidas y muchos streams (sin bloqueo entre ellos), y clientes que cambian de red (migración). En una transferencia grande, por una red buena, no hay milagro: el control de congestión es parecido, y TCP en el kernel suele gastar menos CPU.
El cifrado que no protege
La guía de esta semana dice que Wireshark “casi no puede leer nada sin las claves”. El “casi” merece toda una sección.
Miren la captura de arriba. Sin las claves, tshark muestra el SNI y el ALPN. Sin ninguna
clave, de un paquete que está cifrado. ¿Cómo? Porque las claves de los paquetes Initial se
calculan así:
initial_secret = HKDF-Extract(sal fija publicada en el RFC 9001, DCID del primer paquete)El DCID viaja a la vista, y la sal está en el RFC. Cualquiera puede repetir la cuenta.
quic_initial.py lo hace en unas pocas líneas, usando solo hashlib de Python y el comando
openssl, con el ejemplo del RFC 9001:
$ python3 quic_initial.py --vector
DCID 8394c8f03e515708
key  1f369613dd76d5467730efcbe3b1a22d
iv   fa044b2f42a3fd3b46fb255c
hp   9f50449e04a0e810283a1e9933adedd2
Esos valores son exactamente los del apéndice A del RFC 9001, y las pruebas también abren el
paquete de ejemplo completo de ese apéndice. Ahora usemos el programa con un cliente real. Con
--catch, el programa abre un socket UDP y le pide a curl que intente HTTP/3 contra él. No
hay servidor QUIC en ninguna parte, y no hace falta: el cliente habla primero:
$ python3 quic_initial.py --catch secreto.redes.test
datagrama 0: 1200 bytes, DCID=514057c04c133f34, número de paquete 0, bytes de CRYPTO: 1158
datagrama 1: 1200 bytes, DCID=514057c04c133f34, número de paquete 1, bytes de CRYPTO: 350
ClientHello de 1508 bytes
SNI:  secreto.redes.test
ALPN: h3
También funciona sobre una captura real. Con la de la sección anterior, contra Cloudflare:
$ python3 quic_initial.py --pcap captures/quic.pcap
datagrama 0: 1200 bytes, DCID=d698867006b8e705, número de paquete 0, bytes de CRYPTO: 1158
datagrama 1: 1200 bytes, DCID=d698867006b8e705, número de paquete 1, bytes de CRYPTO: 350
ClientHello de 1508 bytes
SNI:  www.cloudflare.com
ALPN: h3
Entonces, ¿para qué cifrar los Initial, si cualquiera los abre? Porque protege de otras cosas: un middlebox no puede osificarse sobre el formato sin tomarse el trabajo de implementar una versión de QUIC, y solo quien vio el primer paquete puede inyectar respuestas válidas. No da confidencialidad. Quien lea QUIC por primera vez debe tener esto claro.
El resto de la conexión sí tiene secreto de verdad:
| Paquetes | Claves | ¿Quién los lee? |
|---|---|---|
Initial (ClientHello, ServerHello) |
Del DCID y una sal pública | Cualquiera en el camino |
Handshake (certificado, Finished) |
Del Diffie-Hellman | Solo los extremos |
| 1-RTT (todo: datos, ACK, números de paquete) | Del Diffie-Hellman | Solo los extremos |
Noten la última fila. En TCP, los números de secuencia y los ACK viajan en claro, incluso con
TLS. En QUIC, los números de paquete y los ACK van protegidos. Un middlebox en el camino de
una conexión QUIC no puede ver el progreso ni medir el RTT como lo hace en TCP, y mucho menos
cambiar una ventana o forzar un cierre con un RST falso. Esa es la respuesta al paso 5 del
laboratorio: ven poco porque está hecho a propósito, para que no puedan depender de ello, y
así el protocolo pueda evolucionar.
Hay una regla más en la captura, y es la explicación de esos 1208. Todo datagrama del cliente
con un Initial debe medir al menos 1200 bytes, con relleno si hace falta (PADDING, en el
paquete 2). Esto no es por capricho, y está en el RFC 9000 (sec. 8.1 y 14.1): un atacante puede
falsificar su dirección de origen (spoofing), y provocar que el servidor le mande muchos datos a
una víctima. Por eso el servidor no puede enviar más de tres veces lo que recibió de una
dirección sin validar. Obligar al cliente a mandar bastante reduce el beneficio del ataque, y
comprueba de paso que el camino aguanta paquetes de ese tamaño.
0-RTT y su riesgo de repetición
Si un cliente ya habló antes con un servidor, tiene un ticket de sesión y un secreto que
recordar. Con ese secreto puede cifrar datos y mandarlos en su primer paquete, junto con el
ClientHello. Eso se llama 0-RTT o early data. Existe en TLS 1.3 sobre TCP, donde igual
hay que pagar antes el handshake de TCP, y en QUIC, donde va desde el primer paquete: la
respuesta llega en un solo RTT.
El precio es sutil. En un handshake normal, cada lado aporta datos aleatorios nuevos, así que los mensajes de una conexión no sirven en otra. En 0-RTT, el servidor todavía no aportó nada cuando recibe los datos. Por lo tanto, quien los grabe puede mandarlos otra vez, sin saber ninguna clave, y el servidor no puede distinguirlos solo por sus claves. Lo advierten los propios RFC 8446 (sec. 8) y RFC 9001 (sec. 9.2).
zero_rtt.py lo hace con TLS 1.3 real. El contenedor del curso no tiene un servidor QUIC, pero
el mecanismo es el mismo, porque QUIC usa el handshake de TLS 1.3. Un cliente de openssl s_client reanuda su sesión, y manda como early data una petición que hace algo: POST /transferir?monto=100. Pasa por un relay que guarda lo que ve, sin poder leerlo, y luego lo
manda otra vez, por otra conexión:
$ python3 zero_rtt.py build/pki
== protección por defecto
cliente legítimo: Early data was accepted
veces que el servidor procesó la petición: 1 antes de repetir, 1 después
== -no_anti_replay
cliente legítimo: Early data was accepted
veces que el servidor procesó la petición: 1 antes de repetir, 2 después
En la última línea, una sola transferencia del usuario se ejecutó dos veces. El atacante no
conoce las claves y no puede leer la respuesta, pero no le hace falta. Su repetición no
terminará nunca el handshake, porque no puede mandar un Finished válido. Sin embargo, el
servidor ya procesó los datos de 0-RTT cuando llegaron.
La primera corrida muestra una defensa: s_server lleva la cuenta para que cada ticket se use
una sola vez, y no procesa el early data de la repetición. Pero esa defensa no es gratis ni
universal. Un sitio con muchos servidores en muchos países tendría que compartir ese estado
entre todos, al instante. Muchos no lo hacen, y por eso la defensa real es otra:
Idea clave. En 0-RTT solo debe ir lo que sea seguro repetir. Un
GETde una página, sí. Un pago, no. Esa decisión le toca a la aplicación, porque el transporte no sabe qué significan los datos.
Migración de conexión
Una conexión TCP se identifica por cuatro campos, y uno de ellos es la dirección IP del cliente. Si un celular deja el Wi-Fi y pasa a los datos móviles, cambia de IP, y esa conexión muere, aunque el servidor y la aplicación estén bien. La aplicación debe darse cuenta, reconectar y reanudar. Algo parecido pasa con un NAT que le cambia el puerto a un flujo inactivo.
QUIC identifica la conexión con un connection ID, un número que viaja en el encabezado, y que no depende de la dirección ni del puerto. El servidor busca la sesión por ese ID. Si el cliente aparece desde otra dirección, con el mismo ID, sigue siendo la misma conexión.
Para ver la idea, sin nada más, está cid_echo.py: un eco de juguete sobre UDP, que no es
QUIC, al lado de un eco TCP. En la red c - mb - s, el cliente manda 12 mensajes, y en el
sexto se muda de 10.213.1.10 a 10.213.3.20, otra red del router, y borra la dirección vieja:
$ python3 scenarios.py migration
== TCP
0: mensaje-0
1: mensaje-1
2: mensaje-2
3: mensaje-3
4: mensaje-4
5: mensaje-5
-- el cliente cambia a 10.213.3.20; el socket sigue atado a 10.213.1.10
6: sin respuesta (timed out)
7: sin respuesta (timed out)
8: sin respuesta (timed out)
9: sin respuesta (timed out)
10: sin respuesta (timed out)
11: sin respuesta (timed out)
respondidos: 6 de 12

== UDP con connection ID
0: c0ffee 1 mensaje-0
1: c0ffee 2 mensaje-1
2: c0ffee 3 mensaje-2
3: c0ffee 4 mensaje-3
4: c0ffee 5 mensaje-4
5: c0ffee 6 mensaje-5
-- el cliente cambia a 10.213.3.20, con otro puerto y otro socket
6: c0ffee 7 mensaje-6
7: c0ffee 8 mensaje-7
8: c0ffee 9 mensaje-8
9: c0ffee 10 mensaje-9
10: c0ffee 11 mensaje-10
11: c0ffee 12 mensaje-11
respondidos: 12 de 12

== Lo que anotó el servidor
sesión c0ffee: cambió de ('10.213.1.10', 53496) a ('10.213.3.20', 49570), sigue en el mensaje 7
El contador 7 lo pone el servidor, que sigue contando en la misma sesión, después de ver
una dirección y un puerto distintos. La conexión TCP, en cambio, se queda colgada: el servidor
le contesta a una dirección que ya no existe. Con el tiempo, TCP se rendirá.
Lo real es más exigente que el juguete, y conviene saberlo, porque si no este ejemplo es inseguro (RFC 9000, sec. 9):
- Validación del camino. Cualquiera puede mandar un paquete con una dirección falsa. El
servidor debe comprobar que hay alguien allí con frames
PATH_CHALLENGEyPATH_RESPONSE, antes de mandarle mucho a esa dirección. - Varios IDs. Si el ID fuera siempre el mismo, un observador podría seguir a un celular de una red a otra. Cada lado le entrega al otro varios IDs, y al migrar se usa uno nuevo.
- El control de congestión empieza de nuevo en el camino nuevo: lo aprendido del anterior no tiene por qué valer.
- Todo eso va cifrado. Nuestro
c0ffeeviaja en claro, y cualquiera podría secuestrar la sesión.
CDN: acercar el contenido
Dejamos el transporte y pasamos a la pregunta del comienzo. Una página está en un servidor en Virginia, y el usuario está en Lima. El RTT es de 100 ms o más, y no va a bajar: esa es la velocidad de la luz en fibra, más el camino.
Ya vimos todo lo que se multiplica por ese RTT. Cada handshake lo paga. Cada ida y vuelta de slow start lo paga. Y el throughput de TCP, por la fórmula de la semana 11, es inversamente proporcional a él. Esa es la respuesta a la pregunta 5 de repaso: una CDN da menos retardo y mejor desempeño aun si el ancho de banda no cambia, porque casi todo en una conexión corta se mide en RTT.
Definición. Una CDN (content distribution network) es un conjunto de servidores repartidos por el mundo, que guardan copias del contenido de sus clientes, y que entregan cada petición desde una réplica cercana al usuario.
Da varias cosas a la vez: menos retardo, menos carga sobre el servidor original, menos tráfico
por los enlaces de tránsito (que cuestan dinero), y más capacidad para absorber picos y ataques
DoS. Una réplica en un data center local o dentro de la red de un proveedor de Internet funciona
como la caché de la semana 12: si tiene el objeto, lo sirve; si no, se lo pide al origen y lo
guarda, respetando Cache-Control.
Las CDN siguen más o menos dos estrategias: poner muchos servidores pequeños dentro de las
redes de acceso, para estar lo más cerca posible, o tener pocos sitios grandes cerca de los
IXP, lo que es más simple de operar. La pregunta difícil es otra: si todas las réplicas sirven
el mismo nombre, ¿cómo se lleva a cada usuario a la réplica adecuada? Hay dos respuestas, y
las vamos a armar con cdn/cdn.clab.yml:
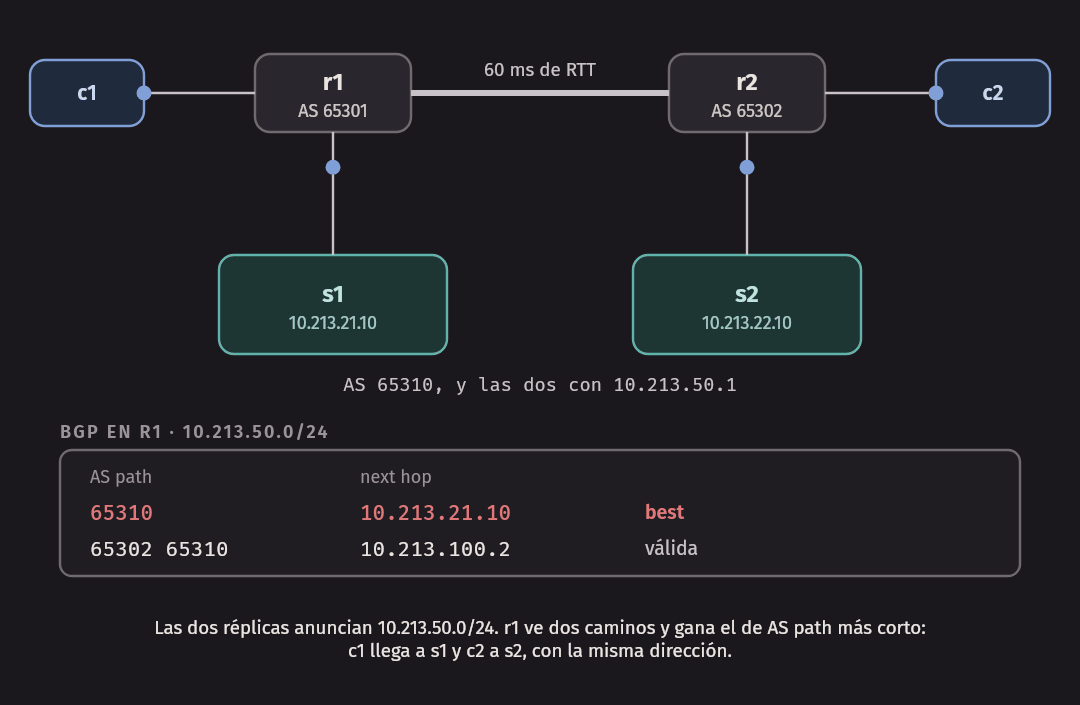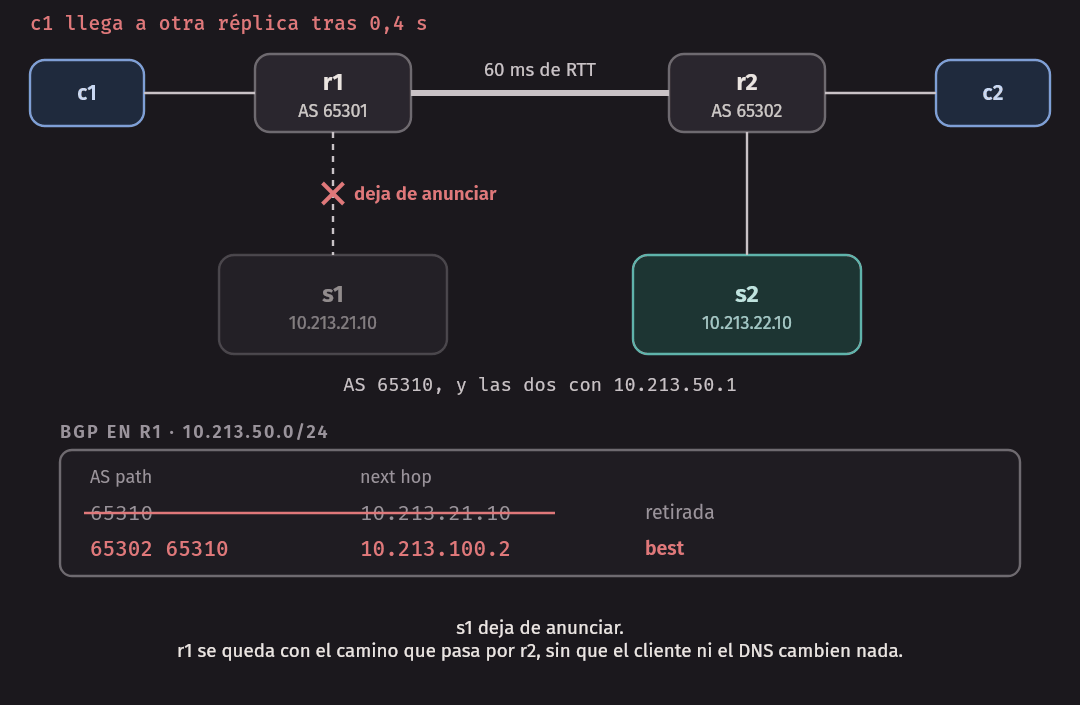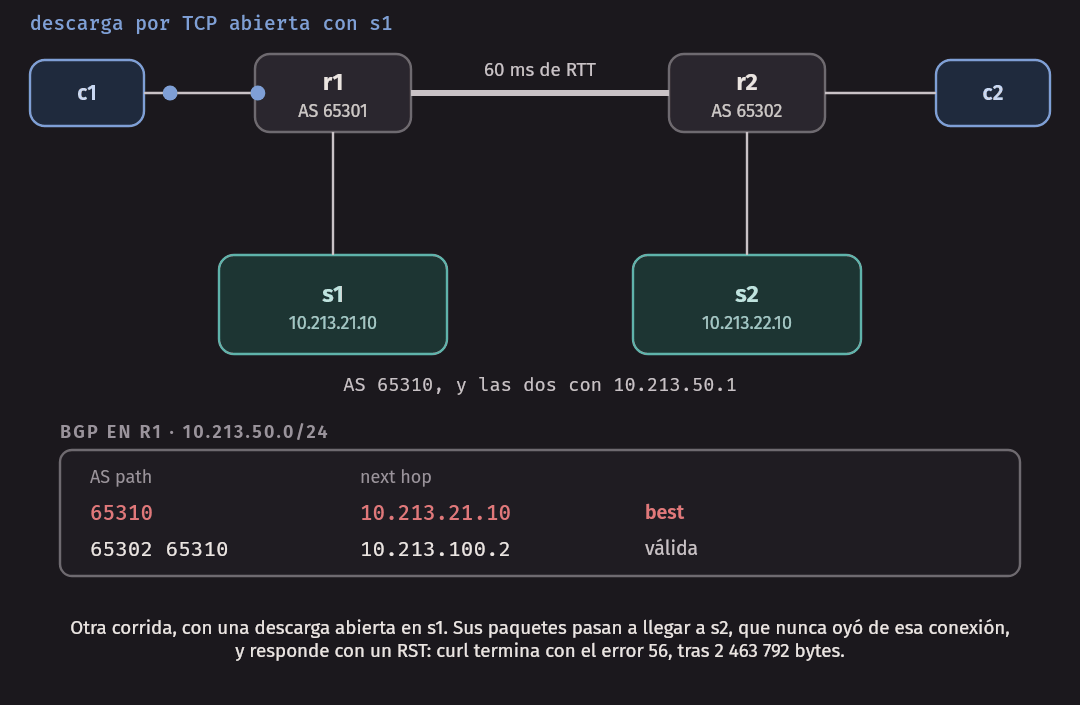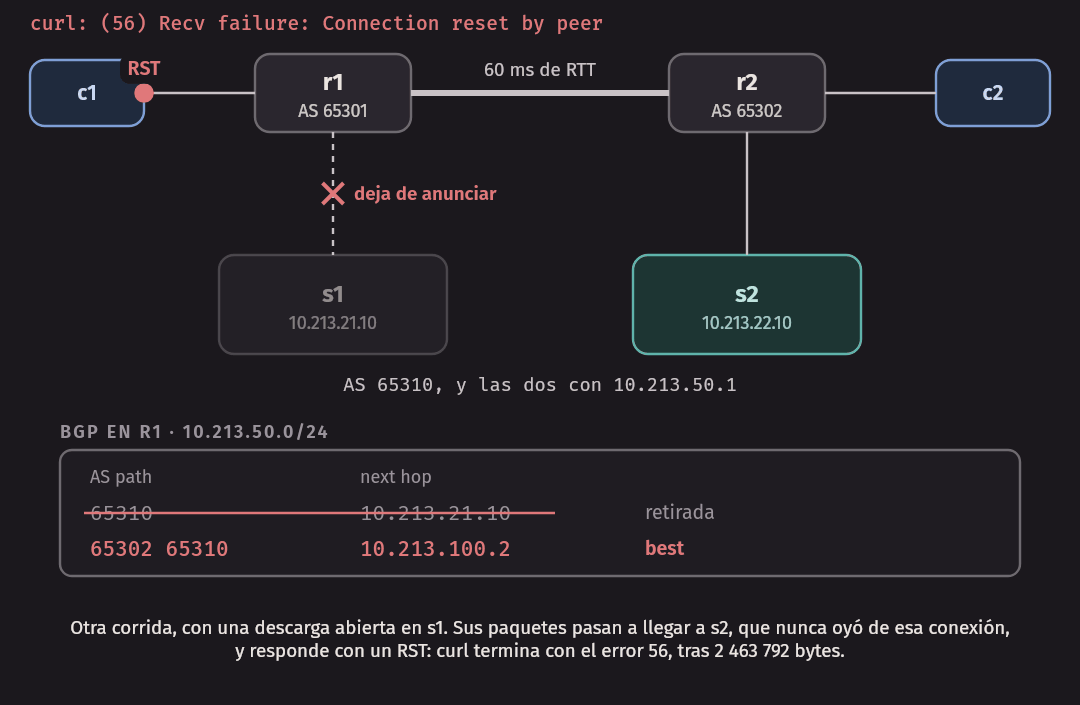
      c1 ---- r1 ==== 60 ms de RTT ==== r2 ---- c2
              | \                       |
             s1  ns                     s2

   r1 AS 65301, r2 AS 65302, s1 y s2 AS 65310 (la CDN), ns es el DNS autoritativo
Son dos regiones, unidas por un enlace largo, con una réplica en cada una. Cada réplica tiene su
dirección de unicast (10.213.21.10, 10.213.22.10) y además las dos comparten 10.213.50.1.
Selección por DNS
La más simple es que el DNS decida. El nombre del sitio apunta (con un CNAME) a un nombre
de la CDN, y el servidor autoritativo de la CDN contesta con una dirección distinta según quién
pregunta. Es lo que hace geo_dns.py, reducido a una tabla:
$ make up-cdn
$ python3 cdn_demo.py dns
c1 pregunta cdn.redes.test a 10.213.30.10: 10.213.21.10
   curl a esa dirección: réplica s1, RTT 0.1 ms
   la otra réplica, 10.213.22.10: RTT 61.7 ms
c2 pregunta cdn.redes.test a 10.213.30.10: 10.213.22.10
   curl a esa dirección: réplica s2, RTT 0.1 ms
   la otra réplica, 10.213.21.10: RTT 62.1 ms

La respuesta completa, en c1:
;; Got answer:
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 43406
;; flags: qr aa; QUERY: 1, ANSWER: 1, AUTHORITY: 0, ADDITIONAL: 0

;; ANSWER SECTION:
cdn.redes.test.		30	IN	A	10.213.21.10
El mismo nombre, el mismo servidor de DNS, y dos respuestas. El flag aa dice que el servidor
es autoritativo, y el TTL es de 30 s, para poder cambiar de opinión rápido: es el mismo
compromiso que el TTL corto de la semana 12.
En este laboratorio, los clientes preguntan directamente. En Internet el autoritativo no ve al usuario, sino a su resolver, que puede estar en otro país. La CDN adivina por la ubicación del resolver y se puede equivocar. Una extensión de DNS (EDNS Client Subnet) permite que el resolver pase un pedazo de la dirección del cliente, a costa de contar algo más sobre él.
Eso se ve en Internet. Mismo nombre, tres resolvers públicos, desde el mismo contenedor:
$ python3 internet.py dns
www.akamai.com         @1.1.1.1   2.18.21.198 2.18.21.202
www.akamai.com         @8.8.8.8   190.98.161.48 190.98.161.67
www.akamai.com         @9.9.9.9   190.98.161.48 190.98.161.67
www.cloudflare.com     @1.1.1.1   104.16.123.96 104.16.124.96
www.cloudflare.com     @8.8.8.8   104.16.123.96 104.16.124.96
www.cloudflare.com     @9.9.9.9   104.16.123.96 104.16.124.96
Para www.akamai.com, la respuesta depende de qué resolver se use. Para www.cloudflare.com,
no. Sus propios resultados pueden diferir en otra red, u otro día. Una dirección idéntica no
prueba por sí misma que un sitio use anycast, pero es lo que hay que esperar si lo usa, como
veremos:
Selección por anycast
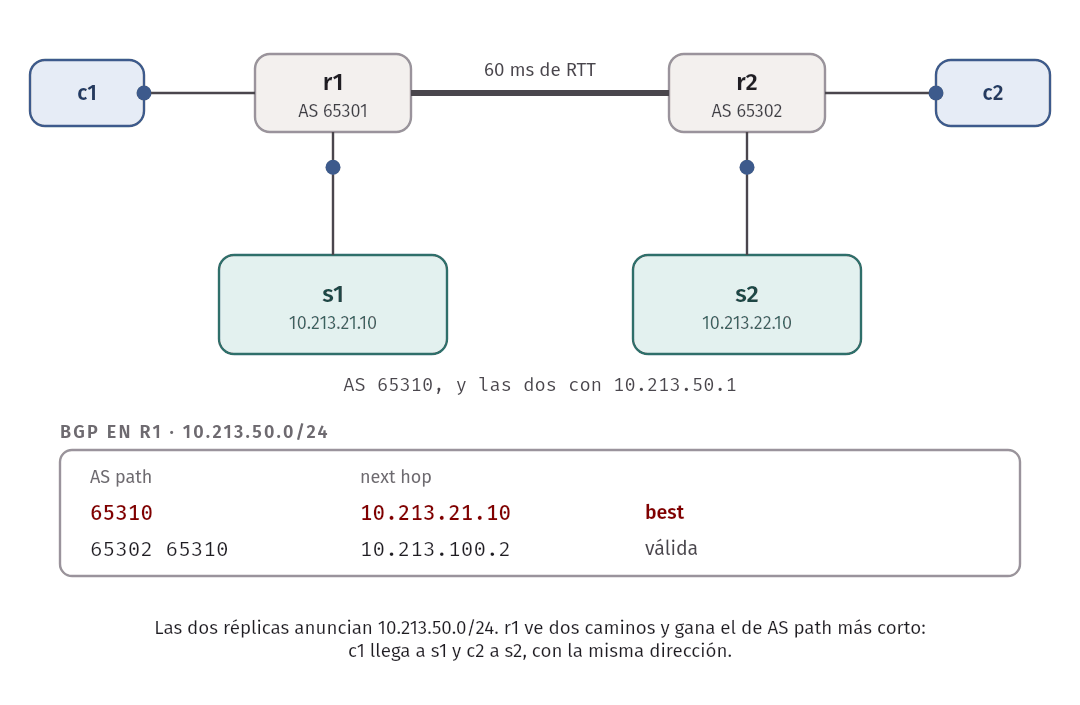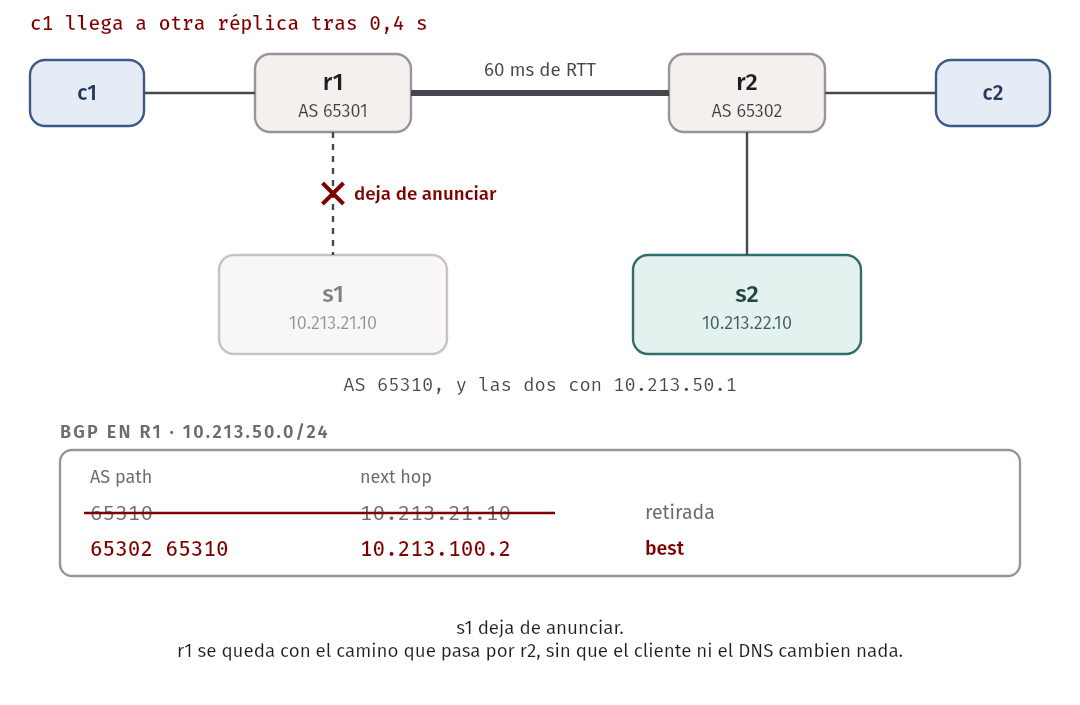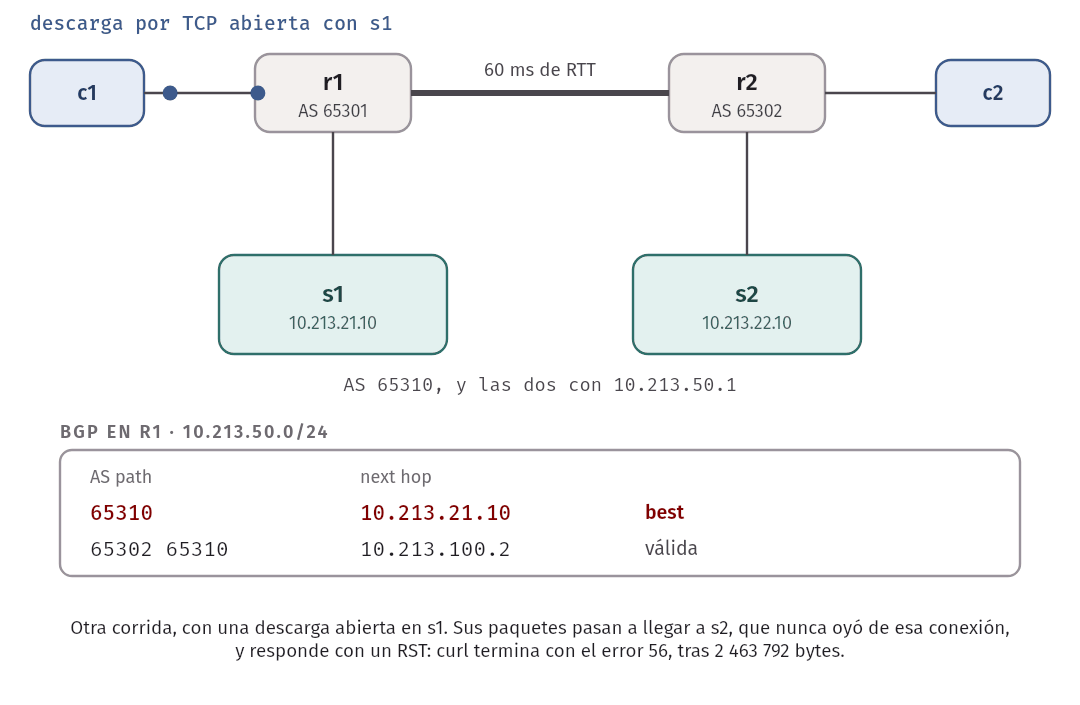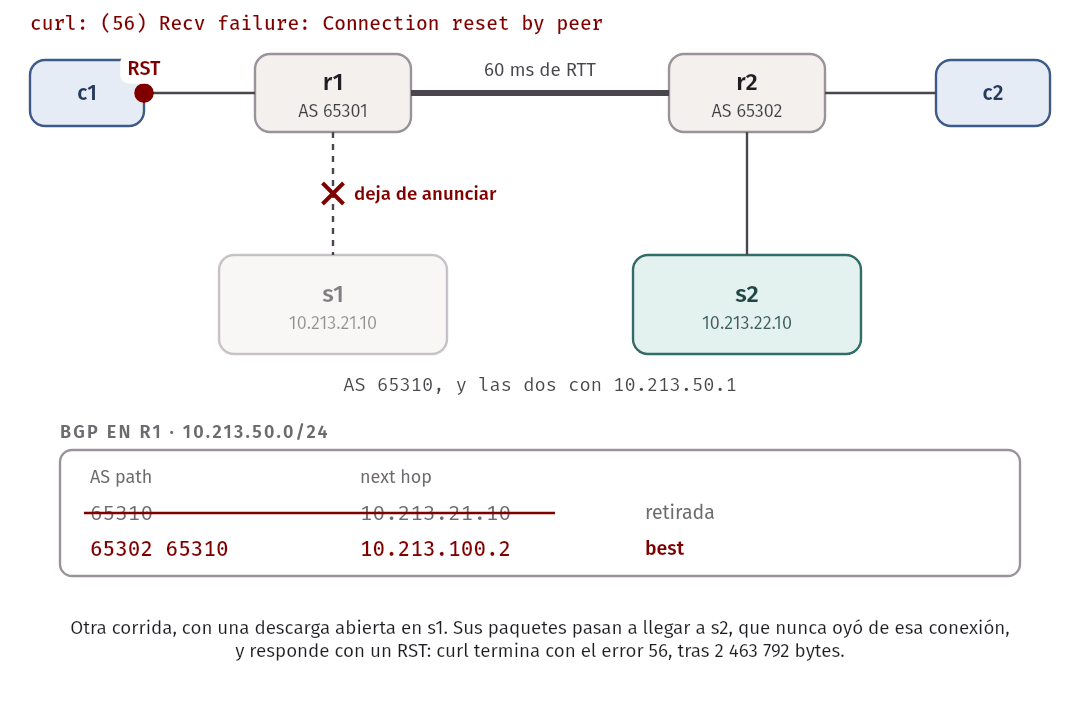
Definición. En anycast, varios servidores anuncian el mismo prefijo por BGP. Los routers no saben que son varios: cada uno ve caminos hacia un mismo prefijo y elige el mejor, como siempre. Cada usuario llega a la réplica que su red considere más cercana.
En nuestra topología, s1 y s2 anuncian 10.213.50.0/24 desde el mismo AS. Miren la tabla de
BGP de r1:
$ python3 cdn_demo.py anycast
Rutas de r1 hacia el prefijo de anycast:
BGP routing table entry for 10.213.50.0/24, version 7
Paths: (2 available, best #1, table default)
  Advertised to non peer-group peers:
  10.213.21.10 10.213.100.2
  65310
    10.213.21.10 from 10.213.21.10 (10.213.21.10)
      Origin IGP, metric 0, valid, external, best (AS Path)
      Last update: Mon Nov  2 15:02:07 2026
  65302 65310
    10.213.100.2 from 10.213.100.2 (10.213.100.2)
      Origin IGP, valid, external
      Last update: Mon Nov  2 15:02:07 2026

c1 -> 10.213.50.1: réplica s1, RTT 0.0 ms
c2 -> 10.213.50.1: réplica s2, RTT 0.0 ms
Dos caminos para el mismo prefijo. Gana el de AS path más corto, tal como en la semana 6. (Como
allá, no bgp ebgp-requires-policy está puesto a propósito, porque aquí no nos interesan las
políticas.) Una misma dirección, dos servidores, sin que los clientes hagan nada.
¿Y si se cae una réplica? Las peticiones siguientes se van a la otra, solo con que deje de anunciar:
$ python3 cdn_demo.py failover
antes:   c1 -> réplica s1, RTT 0.0 ms
s1 deja de anunciar; c1 llega a otra réplica tras 0.4 s
después: c1 -> réplica s2, RTT 61.7 ms
s1 vuelve: c1 -> réplica s1
Medio segundo, sin cambiar ni un DNS. Eso es lo que hace atractivo al anycast. El tiempo depende mucho de la red y de los temporizadores de BGP. El truco tiene una trampa: lo que ocurre con una conexión ya abierta:
$ python3 cdn_demo.py cut
curl en c1, descargando mientras s1 deja de anunciar:
curl: (56) Recv failure: Connection reset by peer
2463792 bytes
código de salida: 56
Los paquetes de esa conexión TCP ahora llegan a s2, que nunca ha oído de ella y responde
con un RST. La descarga se pierde tras 2,4 MB. Lo mismo pasa si BGP cambia de ruta por
cualquier otra razón: anycast funciona porque las rutas de Internet suelen ser estables en la
duración de una conexión corta. Por eso, históricamente, se usó sobre todo para DNS, sobre UDP y
con preguntas de un paquete, y la mayoría de sus usos para contenido cuida mucho este riesgo.
Idea clave. BGP no sabe nada de latencia, ni de carga. “Más cercana” significa “camino de BGP preferido”, que no siempre es la réplica con menor RTT. El DNS permite elegir con más información, a costa de confiar en la caché y en el resolver. Las CDN reales combinan los dos.
| Por DNS | Por anycast | |
|---|---|---|
| Quién decide | El autoritativo de la CDN | La red, con BGP |
| Qué información usa | Lo que sepa del resolver, carga, mediciones | Solo la política y el AS path |
| Reacción a una falla | Lenta, limitada por el TTL y las cachés | Rápida en la red |
| Riesgo | El resolver está lejos del usuario | Un cambio de ruta corta conexiones TCP |
Streaming adaptativo con DASH
El video es la mayor parte del tráfico de Internet. ¿Cómo se manda un video a personas que tienen 2 Mbps en un celular y 500 Mbps en su casa, y cuyo ancho de banda cambia cada minuto?
La idea antigua era una sola calidad, y un servidor especial que empujaba los datos a ritmo fijo. La idea actual invierte todo:
Definición. En DASH (Dynamic Adaptive Streaming over HTTP), el video se corta en segmentos de unos segundos, y cada segmento se codifica en varias calidades. Son archivos comunes, con URL comunes, servidos por HTTP. Un manifiesto (MPD) los describe. El cliente decide, para cada segmento, cuál pedir.
Es una decisión de diseño muy fuerte. El servidor no tiene ningún estado de sesión, y es un servidor web común. Los segmentos se guardan en cualquier caché, y por eso una CDN los sirve sin esfuerzo. Y la inteligencia queda en el extremo, que es el que ve lo que le pasa a su propia red: el mismo principio de la semana 9, ahora en la aplicación.
make_dash.py arma un “video” con bytes al azar y un MPD real:
<?xml version="1.0"?>
<MPD xmlns="urn:mpeg:dash:schema:mpd:2011" type="static" mediaPresentationDuration="PT50S"
     minBufferTime="PT2S" profiles="urn:mpeg:dash:profile:isoff-on-demand:2011">
  <Period>
    <AdaptationSet mimeType="video/mp4" segmentAlignment="true">
      <SegmentTemplate timescale="1" duration="2" startNumber="0"
                       media="$RepresentationID$/seg-$Number$.m4s"/>
      <Representation id="400k" bandwidth="400000"/>
      <Representation id="1000k" bandwidth="1000000"/>
      <Representation id="2500k" bandwidth="2500000"/>
      <Representation id="5000k" bandwidth="5000000"/>
    </AdaptationSet>
  </Period>
</MPD>
bandwidth no es lo que hay en el enlace: es lo que pide esa calidad. El nombre de cada
segmento sale del template: 2500k/seg-7.m4s.
El bucle del cliente
El cliente mide lo que puede, y lleva la cuenta de un número fundamental: el buffer, los segundos de video ya bajados que todavía no se reprodujeron. Mientras haya buffer, la imagen sigue. Si llega a cero, se congela: el rebuffering que tanto molesta al usuario.
mientras queden segmentos:
    si el buffer está lleno, esperar
    calidad = choose(calidades, throughput medido, buffer)
    bajar el segmento de esa calidad por HTTP
    medir: bits / tiempo
    actualizar el buffer: -tiempo que tardó, +duración del segmento
Todo se decide en choose. Empecemos con dos estrategias sencillas. fixed pide siempre la
mejor. last pide la mejor que cabe en la última medición. dash_sim.py las prueba sobre una
red que va a 6 Mbit/s, cae a 1,2 entre los segundos 40 y 70, y se recupera. Primero, siempre la
mejor:
$ python3 dash_sim.py fixed
  22   37.7s   5000k   1.7s  6.00M     8.3s      0.0s
  23   39.7s   5000k   7.0s  1.43M     3.0s      0.0s
  24   46.7s   5000k   8.3s  1.20M     2.0s      5.3s
  25   55.0s   5000k   8.3s  1.20M     2.0s      6.3s
  26   63.3s   5000k   7.0s  1.43M     2.0s      5.0s
  27   70.3s   5000k   1.7s  6.00M     2.3s      0.0s
bitrate promedio: 5.00 Mbit/s; cambios: 0; congelado: 16.7 s
(Las columnas son segmento, inicio, calidad, tiempo de descarga, throughput medido, buffer después y tiempo congelado.) Cada segmento de 2 s tarda 8,3 s en bajar. Con la calidad fija, la imagen se congela durante casi 17 s. El promedio es perfecto, y la experiencia es horrible.
Y aquí está el resumen de las dos estrategias, sobre esa red y sobre una que oscila cada 3 s entre 6 y 3 Mbit/s:
$ python3 dash_sim.py last | tail -1
bitrate promedio: 3.65 Mbit/s; cambios: 3; congelado: 0.3 s
$ python3 dash_sim.py last --oscillating | tail -1
bitrate promedio: 3.56 Mbit/s; cambios: 27; congelado: 0.0 s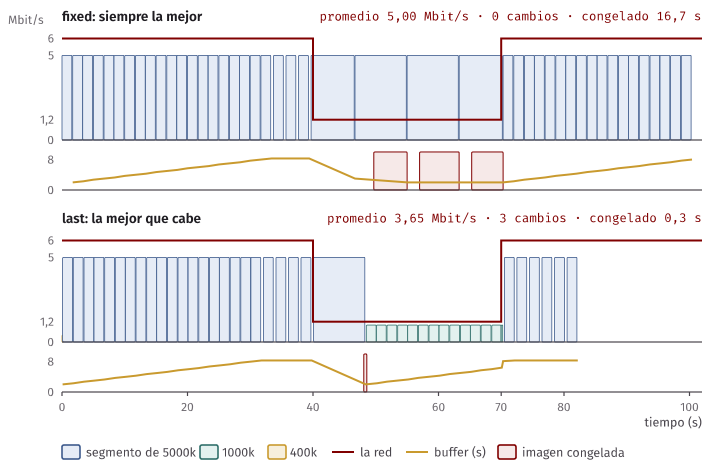
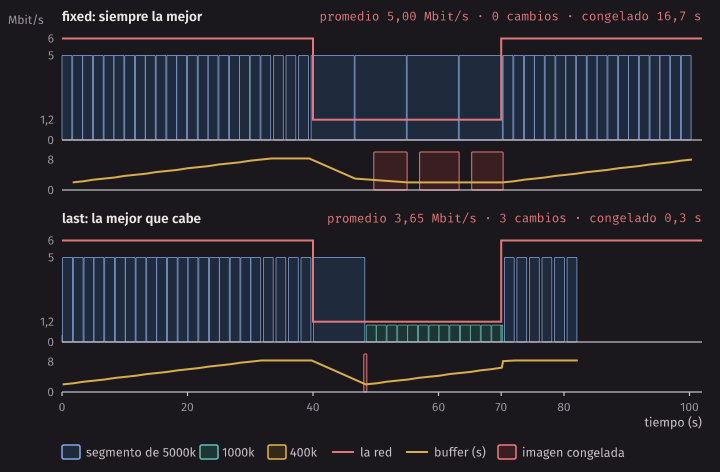
last sobrevive a la caída con solo 0,3 s congelado, pero, en la red que oscila, salta de
calidad 27 veces en 45 segmentos. Una imagen que cambia cada pocos segundos también molesta.
Ahí está la tensión de todo ABR (adaptive bitrate): más calidad, sin congelarse y sin
saltar. Son tres metas que chocan, y escribir una función mejor es el laboratorio de esta
semana.
Un cliente real
dash_client.py hace lo mismo con la red de verdad: lee el MPD por HTTP desde s, baja cada
segmento, y mide. Mientras tanto, scenarios.py le baja el enlace a mb, de 6 Mbit/s a 1,2
Mbit/s, entre los segundos 10 y 22. Del lado del servidor hay un python3 -m http.server, y eso
es todo, porque cualquier servidor web sirve:
$ python3 scenarios.py dash last
 seg      t  calidad   medido   buffer  congelado
   0   0.3s    400k   3.15M     2.0s      0.0s
   1   1.2s   2500k   5.10M     3.0s      0.0s
   2   3.1s   5000k   5.40M     3.2s      0.0s
   3   4.9s   5000k   5.39M     3.3s      0.0s
   4   6.8s   5000k   5.39M     3.5s      0.0s
   5   8.7s   5000k   5.40M     3.6s      0.0s
   6  12.3s   5000k   2.75M     2.0s      0.0s
   7  16.7s   2500k   1.12M     2.0s      2.4s
   8  18.6s   1000k   1.09M     2.2s      0.0s
   9  20.4s   1000k   1.09M     2.3s      0.0s
  10  22.2s   1000k   1.13M     2.6s      0.0s
  11  22.6s   1000k   4.35M     4.1s      0.0s
  12  23.6s   2500k   5.09M     5.1s      0.0s
  13  25.5s   5000k   5.40M     5.3s      0.0s
...
congelado total: 2.5 s
La forma es la que predijo el simulador, y hay dos cosas que el simulador no tenía:
- Medir está sesgado por el tamaño. El primer segmento, de 400 kbit/s, mide 3,15 Mbit/s en un enlace de 6. No es que la red sea lenta: es un archivo pequeño, sobre una conexión TCP nueva, y una parte importante del tiempo se va en slow start. Una calidad baja se mide peor, lo que hace más difícil subir. Es un problema real en los ABR.
- Nunca llega a 6. Mide 5,4 Mbit/s, porque
netemcuenta los encabezados en la tasa, y porque el cliente abre una conexión para cada segmento. Es la diferencia entre throughput y goodput.
Comparen con la calidad fija, sobre la misma red:
$ python3 scenarios.py dash fixed
 seg      t  calidad   medido   buffer  congelado
   ...
   4   9.3s   5000k   5.39M     2.6s      0.0s
   5  15.2s   5000k   1.70M     2.0s      3.3s
   6  23.2s   5000k   1.24M     2.0s      6.1s
   7  25.1s   5000k   5.36M     2.1s      0.0s
   ...
congelado total: 9.4 s
9,4 s contra 2,5 s. Las cifras exactas cambian en cada corrida, y lo que importa es esa diferencia.
En la práctica. Los segmentos de los servicios reales duran entre 2 y 10 s, y los buffers son mucho más grandes (decenas de segundos), porque una calidad un poco más baja molesta menos que una imagen congelada. Hay dos familias de ABR: los que miran el throughput, y los que miran sobre todo el buffer, que es un dato seguro y no una estimación. Los buenos clientes combinan los dos. Y este bucle corre encima del control de congestión de TCP o QUIC: dos lazos de control, uno dentro del otro, que no siempre se llevan bien.
Laboratorio: un handshake TLS y HTTP/2 frente a HTTP/3
Trabajen en code/week-13/, dentro del contenedor del curso. Con make se compila sni_peek y
se crean los certificados de la clase, en build/pki/. Con make up se levanta la red `c - mb
- s
. Los resultados contra Internet dependen de su conexión. Si en su red no hay salida por UDP, el paso 4 y el 5 fallarán con—http3-only`: eso también es un resultado.
-
Con
openssl s_client, conéctense a un sitio con TLS 1.3 y lean su cadena.python3 internet.py chain www.uni.edu.peo el sitio que quieran, o directamenteopenssl s_client -connect sitio:443 -servername sitio -tls1_3. ¿Cuántos certificados manda? ¿Quién firma a quién? ¿Cuándo vence? ¿Qué pasa si el sitio no admite TLS 1.3? -
Capturen el handshake.
python3 scenarios.py observerdejacaptures/handshake.pcap, y esa carpeta se ve desde su computadora. Ábranla en Wireshark. EncuentrenClientHello,ServerHelloy el SNI. ¿Qué parte ya va cifrada? ¿Dónde está el certificado? -
Usen
SSLKEYLOGFILE.python3 scenarios.py keylogdejacaptures/keylog.pcapycaptures/keys.log. En Wireshark, vayan a Preferences → Protocols → TLS → (Pre)-Master-Secret log filename, elijan el archivo, y comparen con el paso anterior. -
Comparen
curl --http2ycurl --http3-only.python3 internet.py h2h3, o con otro sitio que tenga HTTP/3. ¿Cuántos RTT hay en cada caso? Estimen el RTT con la columna de conexión de HTTP/2. ¿Coincide con la tabla de la sección sobre el handshake integrado? -
Capturen la conexión QUIC.
python3 internet.py quic, y luegopython3 quic_initial.py --pcap captures/quic.pcap. ¿Qué se puede leer sin claves, y por qué justamente eso? ¿Qué falta? Expliquen por qué los middleboxes ven tan poco, y qué ganan con ello los que diseñan el protocolo. -
Certificado propio. Corran
python3 scenarios.py certs, y expliquen qué ataque detiene cada error. Después hagan su propio certificado, con elopenssldepki.sho con su propio comando, y prueben. -
Comparen direcciones de un sitio con CDN.
python3 internet.py dns, y agreguen sus propios nombres condig @resolver nombre A. Revisen en la salida completa dedigla líneaSERVER, para confirmar quién contestó. Luego levantenmake up-cdny corrancdn_demo.py, con sus cuatro comandos. -
Entreguen P4 y lean el enunciado de P5. P5 es un servidor HTTP/1.1 sobre su
rimay; el enunciado no pide TLS.
Algunas actividades se basan en el laboratorio de TLS de Kurose y Ross.
Lo que van a completar
Hay dos archivos con un TODO. Las pruebas los revisan, y se saltan hasta que los completen:
lab/abr.py. Escriban la funciónchoosede un cliente DASH. Debe cumplir tres cosas en el simulador: no congelarse nunca en la redNETWORK, promediar más de 1,2 Mbit/s (quedarse siempre en la mínima no vale), y cambiar de calidad menos veces quelast_sampleen la redOSCILLATING. Ideas: promediar varias muestras, dejar un margen, y bajar con más decisión si el buffer se vacía. Pista para promediar: la media armónica le da más peso a las muestras bajas. Luego pruébenla de verdad, conpython3 scenarios.py dash lab/abr.py.lab/mkchain.sh. Armen una cadena de tres niveles: raíz, intermedia y servidor, con las restricciones correctas. Las pruebas comprueban queopenssl verifyla acepta, y quecurlrechaza a un servidor que olvide mandar la intermedia. Es uno de los errores de configuración más comunes de la vida real. Muchas veces no se nota en el navegador, que puede tener la intermedia en su caché.
$ make test
...
setUpClass (test_lab.Abr) ... skipped 'falta completar lab/abr.py'
setUpClass (test_lab.Chain) ... skipped 'falta completar lab/mkchain.sh'
...
Ran 51 tests in 158.186s

OK (skipped=2)
Qué comprueba make test
make test levanta y destruye las dos topologías una tras otra, y no deja nada corriendo, ni
siquiera si algo falla. Lo que revisan las pruebas:
- Criptografía: Diffie-Hellman y RSA de juguete, y que
ctr_flipcambie exactamente lo que dice. - QUIC: las claves y el paquete del RFC 9001, y el SNI de un
curlreal. - TLS en la red: 1 RTT contra 2, con márgenes amplios; el SNI se lee, el certificado no; las
claves abren todo; los cuatro errores de certificado;
sni_peekcon recortes y largos falsos. - 0-RTT: una repetición con y sin la protección.
- Migración y DASH real: TCP se detiene, el connection ID sigue; la calidad baja durante la caída y vuelve a subir.
- CDN: las respuestas de DNS, anycast, el cambio de réplica y la conexión que se corta.
- Internet: solo protocolos, nunca tiempos, y se saltan si no hay salida.
Resumen
- Tres metas distintas: confidencialidad, integridad y autenticación. Cifrar solo da la
primera:
ctr_flip.pycambia un monto sin conocer la clave. - Simétrica para los datos, rápida y con clave compartida. Clave pública para ponerse de acuerdo y autenticar, miles de veces más lenta. Todo protocolo real es híbrido. TLS 1.3 solo usa AEAD.
- Diffie-Hellman da un secreto común hablando en público, pero no autentica. RSA (o ECDSA, Ed25519) firma. En TLS 1.3 ya no se usa RSA para intercambiar claves.
- Hash sin clave; MAC con clave compartida; firma con clave privada, que cualquiera verifica.
- Certificado: una CA firma “esta clave es de este nombre”. La confianza nace en la lista de
raíces del cliente. Un certificado es público: la prueba de identidad es
CertificateVerify. - TLS 1.3:
ClientHelloyServerHelloen claro, con su Diffie-Hellman. El resto va cifrado, incluido el certificado.CertificateVerifyyFinishedatan todo el handshake. Un RTT, contra dos de TLS 1.2: 1,1 y 2,1 en nuestra medición. - Forward secrecy: el Diffie-Hellman es efímero y la clave del certificado solo firma, así que robarla no abre lo ya grabado.
- HTTPS no oculta todo: IP, tamaños, tiempos y normalmente el SNI se ven.
sni_peeklo lee sin ninguna clave. Se ocultan la ruta, los headers y el contenido. - Los errores de certificado detienen ataques concretos.
curl -kconserva el cifrado y pierde la autenticación. - QUIC corre en espacio de usuario sobre UDP, porque el kernel y los middleboxes osificaron a TCP. Implementa confiabilidad y congestión. No es poco confiable.
- Streams independientes: una pérdida solo detiene su stream. En HTTP/2 sobre TCP, detiene a todos. Con un solo stream, no hay diferencia.
- Handshake integrado: 2 RTT al primer byte contra 3. En Internet medimos 87 ms contra 118 ms.
- Los Initial se abren sin claves secretas, con el DCID y una sal pública:
quic_initial.pylee el SNI. Desde los paquetes Handshake, sí hay secreto. Los ACK y los números de paquete también van protegidos, para que nada se osifique. - 0-RTT gana un RTT, a cambio de que los datos se puedan repetir. Solo lo seguro de repetir debe ir ahí.
- Connection ID: la conexión sobrevive a un cambio de dirección. Requiere validar el camino y cambiar de ID.
- CDN: menos RTT mejora todo lo que depende de él, aun con el mismo ancho de banda. Se elige con DNS (más información, pero cachés y resolver) o con anycast (rápido y simple, pero una conexión abierta se puede cortar).
- DASH: archivos comunes en varias calidades, y el cliente decide. El ABR equilibra calidad, congelamiento y saltos.
Ejercicios
-
Con
p = 23,g = 5,a = 6yb = 15, calculen a manoA,By el secreto compartido. Comprueben concrypto_toys.dh_shared. ¿Cuántos exponentes tendría que probar un atacante? ¿Cuántos, siptuviera 2048 bits? -
Con
p = 11,q = 17ye = 7, calculennyd, cifren el mensaje 42 y descífrenlo, concrypto_toys. ¿Qué pasa si intentan cifrar 200? ¿Por qué? -
Modifiquen
ctr_flip.pypara que el destinatario leapagar 0100 soles a Eva. ¿Qué necesita saber el atacante, y qué no? ¿Funcionaría este ataque contra AES-GCM? Expliquen qué pasaría en el receptor. -
Un compañero dice: “Si el servidor manda su certificado, ya sé que es él”. Expliquen por qué está mal, y qué mensaje del handshake lo prueba en realidad. Describan el ataque si el cliente no verificara esa firma.
-
Un servidor usa TLS 1.3 y, en 2030, le roban la clave privada del certificado. Un atacante tiene grabado todo su tráfico desde 2026. ¿Qué puede leer? ¿Qué puede hacer de ahí en adelante? ¿Qué cambiaría si hubiese usado TLS 1.2 con intercambio RSA? ¿Qué debe hacer el dueño del servidor?
-
Abran
captures/handshake.pcap. ¿Cuántos segmentos TCP ocupa elClientHello, y por qué? Prueben ahora concurl --curves x25519en el nodoc, y confirmen consni_peekqué grupos se ofrecen. ¿Cuántos segmentos ocupa ahora? ¿Qué se pierde con ese cambio? -
En la tabla de RTT, agreguen una fila para una conexión reanudada con 0-RTT, en TCP con TLS 1.3 y en QUIC. Dibujen el diagrama de cada uno. ¿Cuál gana, y por cuánto?
-
Cambien
hol_sim.pypara que la recuperación tarde 300 ms en lugar de 100, y haya 30 paquetes, con 2 y con 8 streams. Antes de correrlo, anoten su predicción. ¿Cómo cambia la ventaja de QUIC? ¿Con cuántos streams es máxima? -
Supongan un servidor que, como el de P5, solo acepta
GETyHEAD, y al que le agregan TLS 1.3 con 0-RTT. ¿Es entonces inofensivo repetir el early data? Busquen un caso en que no lo sea: piensen en unGETque cuente visitas, o en lo que un observador aprende viendo la respuesta repetida. -
Agreguen un tercer cliente
c3acdn.clab.yml, conectado ar2por una red nueva, y una fila para él engeo_dns.py, que lo mande as1a propósito. Midan el RTT. ¿Puede el DNS mandar a un cliente lejos de su réplica? ¿Y anycast? Expliquen qué decide cada uno. (Reporten también lo que tuvieron que anunciar por BGP.) -
En
cdn_demo.py cut, la conexión se corta con unRST. Predigan qué pasaría sis2tampoco anunciara el prefijo ys1dejara de anunciarlo: ¿qué ve elcurl, y cuándo? Modifiquen la demostración para comprobarlo. -
Diseñen un ABR basado solo en el buffer, sin ninguna medición: una función que elija la calidad según
buffer_s. Comparen con el suyo delab/abr.pyendash_sim.py, en las redesNETWORKyOSCILLATING, por promedio, cambios y tiempo congelado. ¿En qué casos gana cada uno? ¿Qué hace su función al comienzo, con el buffer vacío?